[논문 연구] Self-Supervised Learning for ASD - MIMII Dataset : 판단 근거 시각화 비교 (260905)
Deep Learning
목록 보기
34/41
SSL 기반 ASD 알고리즘(이 논문 포함)은 원칙적으로 결함의 위치를 시각화하지 않습니다. 실제로 위치 정보를 얻으려면 무엇이 필요한가?
왜 SSL-ASD는 원래 위치를 알려주지 않는가
이 논문 계열(임베딩 학습 + 거리 기반 백엔드)의 목적함수 자체가 "이 클립 전체가 정상이냐 비정상이냐"라는 이진 판정 하나만 잘하도록 설계되어 있습니다.
- Mixup/StatEx/FeatEx는 전부 클립 전체 단위로 적용되는 증강(파형 전체를 보간하거나, 클립 전체의 통계량을 교환)
- 최종 출력도 클립 하나당 임베딩 벡터 1개, 점수 1개
- 즉 애초에 "시간/주파수별 점수"라는 개념 자체가 모델 구조 안에 존재하지 않습니다
이것은 이 논문만의 한계가 아니라, DCASE Task2 계열의 판별적 임베딩(discriminative embedding) 기반 ASD 시스템 전체의 공통적 특징입니다.
그럼 ASD 분야에서 위치 정보를 얻는 실제 방법들
| 방법 계열 | 위치 정보 제공 방식 | 비고 |
|---|---|---|
| 오토인코더 기반 ASD (이 논문 계열과 다른 축) | 입력과 복원 결과의 시간-주파수별 차이(reconstruction error map)가 자연스럽게 위치 정보가 됨 | 가장 "내장된(built-in)" 방식. 다만 이 논문의 임베딩 방식보다 보통 성능은 낮음 |
| 어텐션 메커니즘을 추가한 임베딩 모델 | Mori et al. (EUSIPCO 2021) "Anomalous sound detection based on attention mechanism"; DCASE2023 우승팀[16]도 이 논문의 베이스라인에 어텐션을 추가함 | 학습된 어텐션 가중치 자체를 시각화 → 모델이 "설계상" 위치를 보여주도록 만든 것. 사후 설명이 아니라 아키텍처에 내장됨 |
| 사후 설명(post-hoc XAI) | Grad-CAM, Occlusion, SLIME(Mai et al., DCASE2022 — 지금까지 만든 것들) | 학습이 끝난 모델에 외부에서 "왜 그렇게 판단했는지" 근사적으로 캐내는 방식. 이 논문(SSL-ASD)처럼 원래 위치 정보가 없는 모델에 사후적으로 적용 |
| 오디오 변화 캡셔닝 | Tsubaki et al. (DCASE2023) "Audio-change captioning to explain machine-sound anomalies" | 위치가 아니라 "무엇이 어떻게 달라졌는지"를 자연어 문장으로 설명 (예: "회전 소음이 더 커짐") |
결론
이 논문(FeatEx/StatEx/Mixup 기반 SSL-ASD)은 위치 정보를 전혀 만들어내지 않는 알고리즘입니다. 지금까지 만들어드린 Grad-CAM / Occlusion / SLIME은 전부 사후적으로 외부에서 근사한 것이며, 이것이 사실상 이 계열 알고리즘에서 위치를 얻을 수 있는 유일한 실질적 방법입니다.
만약 "모델 자체가 학습을 통해 위치를 알려주도록" 만들고 싶으시다면, 앞서 말씀드렸던 대로 SpectrogramBranch에 어텐션 레이어를 추가하고 재학습하는 방향이 진짜 "알고리즘에 내장된" 위치 정보를 얻는 유일한 길입니다. 원하시면 이 어텐션 기반 버전으로 모델을 수정해드릴까요?
측정값 기반의 객관적 수치 및 시각화
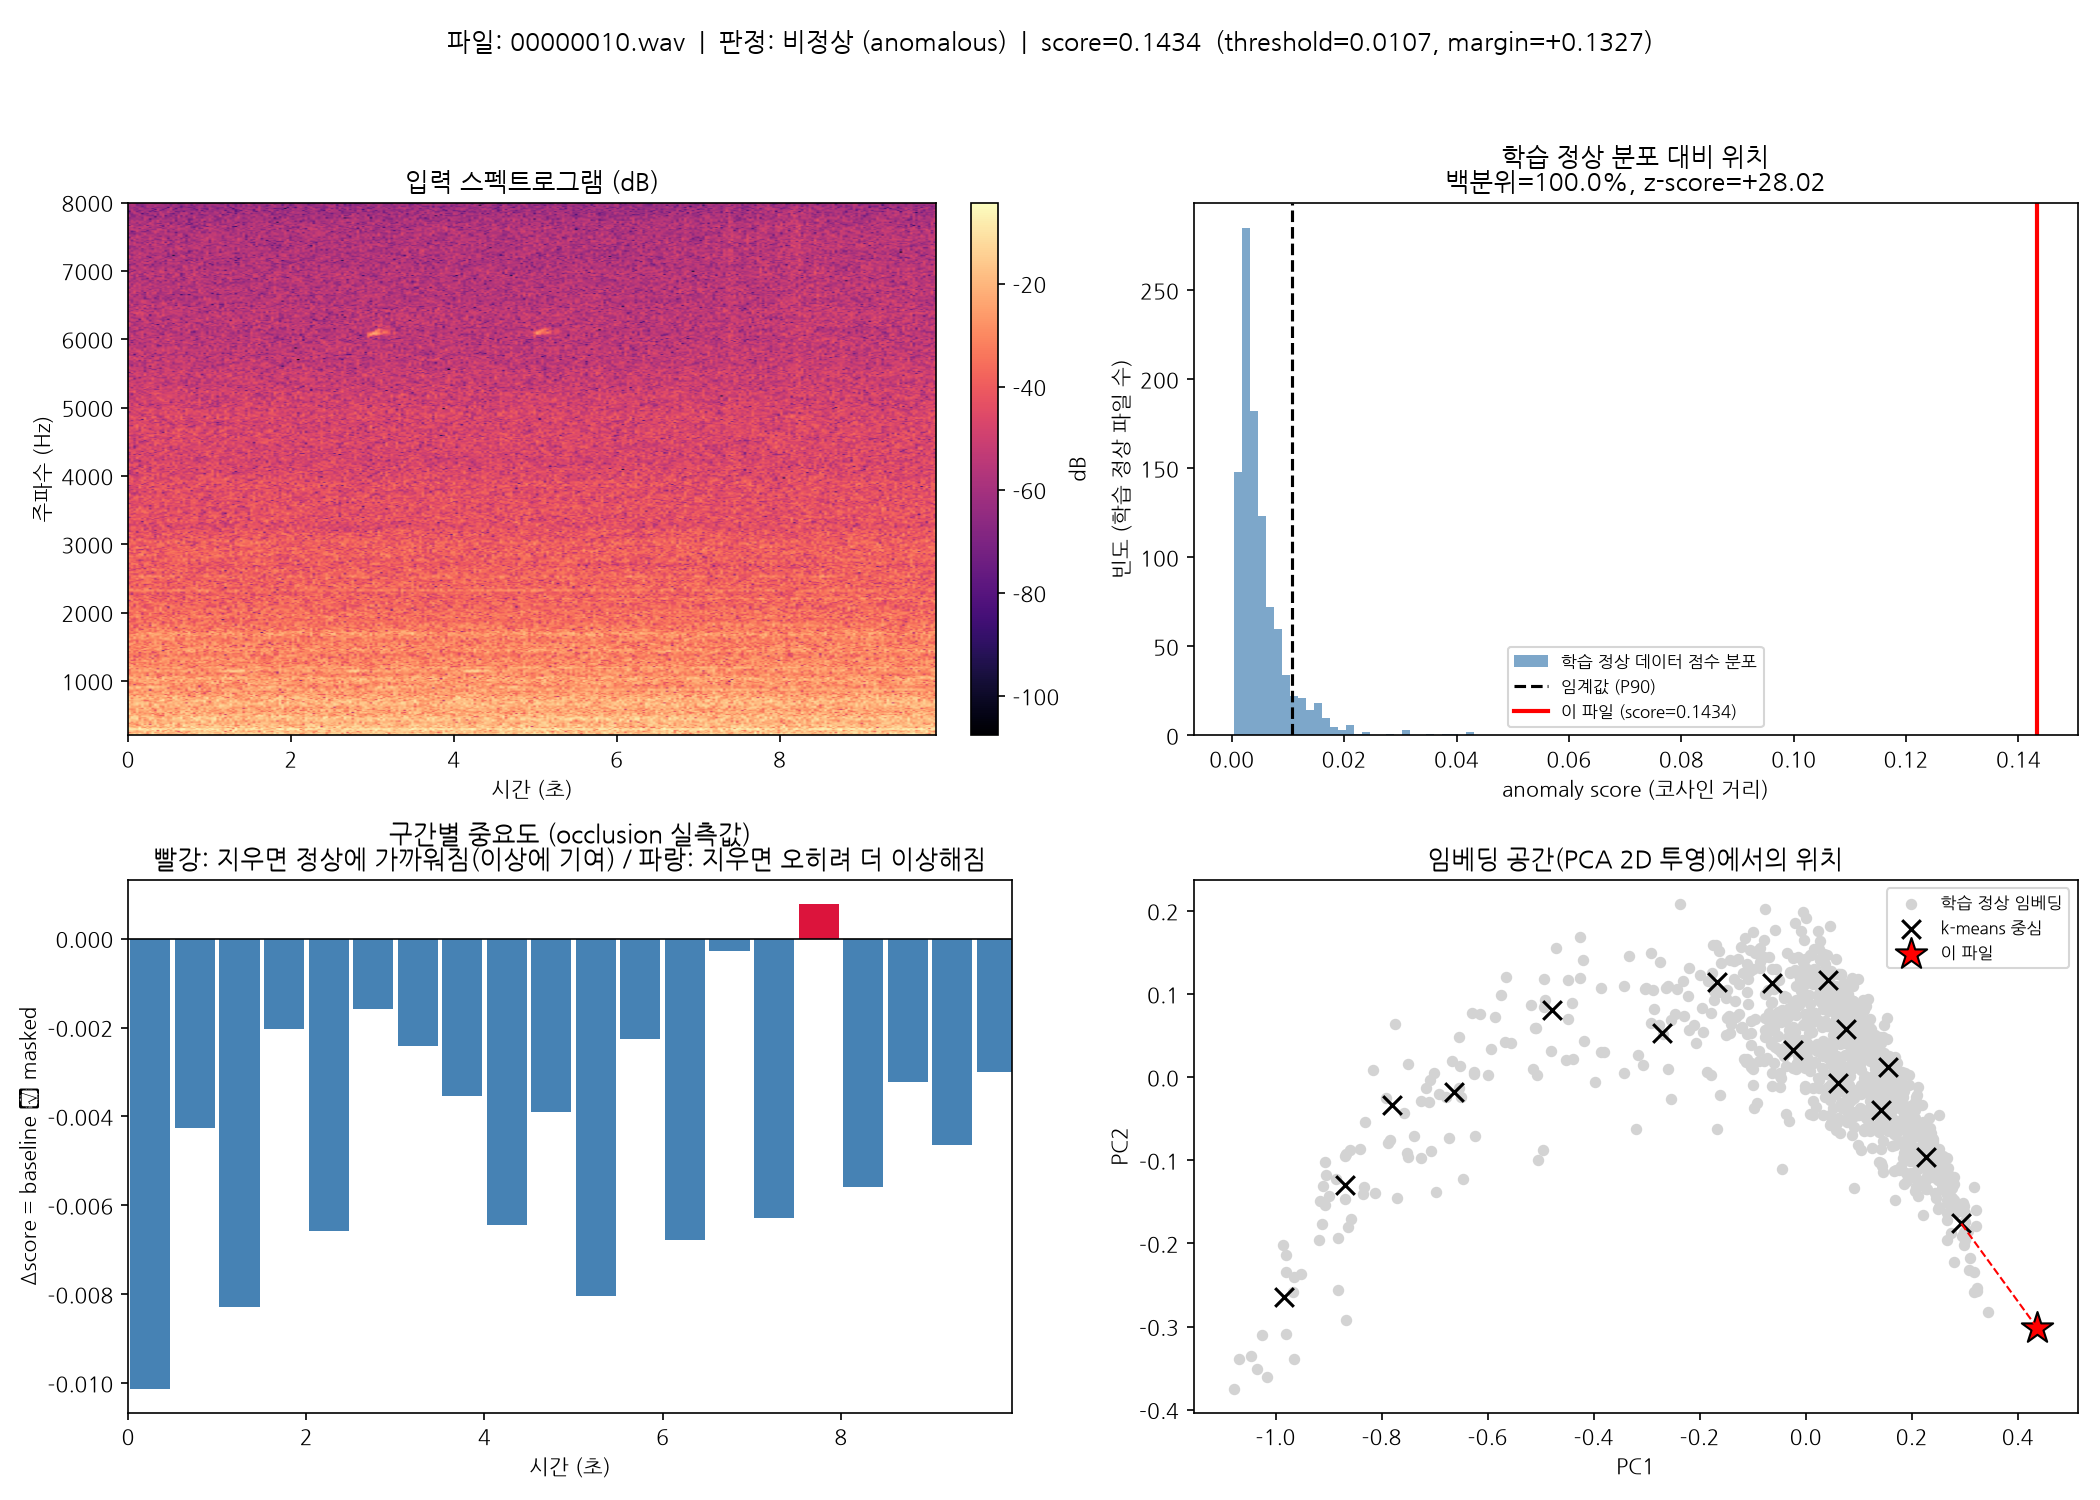
- 점수 히스토그램: 학습 정상 데이터의 점수 분포 대비 이 파일의 점수가 몇 백분위/몇 표준편차에 해당하는지 (정확한 수치)
- 임베딩 공간 PCA 시각화: 실제 판정에 쓰이는 256차원 공간을 2D로 투영해, 이 파일이 정상 군집들과 얼마나 떨어져 있는지 직접 확인
- Occlusion(가림) 기반 구간별 중요도: 파형을 구간별로 하나씩 지워보며 "그 구간이 없으면 점수가 얼마나 바뀌는가"를 실제로 재계산 — Grad-CAM처럼 근사치가 아니라 실측값
"""
Grad-CAM은 그래디언트 기반의 "근사적" 설명 방법이라 판정 근거를 명확히 보여주기
어려울 수 있다. 이 스크립트는 대신 다음 세 가지 "직접 측정된" 객관적 근거를 계산한다.

1) 점수 히스토그램: 학습 정상 데이터 점수 분포 대비 이 파일 점수의 백분위/표준편차
2) 임베딩 공간 PCA 시각화: 실제 판정 공간(256차원)을 2D로 투영해 위치 확인
3) Occlusion 기반 구간별 중요도: 파형 구간을 하나씩 지워가며 점수 변화를 실측
   (근사치가 아닌, 실제로 모델을 다시 돌려서 얻은 값)

실행 예:
    python explain_decision.py
    python explain_decision.py --file ./data/MIMII/abnormal/xxx.wav
    python explain_decision.py --n_segments 30 --output explain.png
"""
import argparse
import json
import os

import numpy as np
import torch
import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt
import matplotlib.font_manager as fm

for _font_name in ["Noto Sans CJK KR", "Noto Sans CJK JP", "NanumGothic", "Malgun Gothic"]:
    if any(_font_name.lower() in f.name.lower() for f in fm.fontManager.ttflist):
        plt.rcParams["font.family"] = _font_name
        break
plt.rcParams["axes.unicode_minus"] = False

from sklearn.decomposition import PCA

from mimii_dataset import load_wav_fixed_length, _list_wavs
from asd_model import TwoBranchEmbeddingNet
from test_asd_pytorch import extract_embeddings, length_normalize
from visualize_test_result import pick_random_abnormal_file


def parse_args():
    p = argparse.ArgumentParser()
    p.add_argument("--config", type=str, default="asd_config.json")
    p.add_argument("--model_path", type=str, default="asd_model_pytorch.pt")
    p.add_argument("--centers_path", type=str, default="kmeans_centers.npy")
    p.add_argument("--data_root", type=str, default=None)
    p.add_argument("--file", type=str, default=None)
    p.add_argument("--threshold_percentile", type=float, default=90.0)
    p.add_argument("--n_segments", type=int, default=20,
                    help="occlusion 분석 시 파형을 나눌 구간 수")
    p.add_argument("--seed", type=int, default=None)
    p.add_argument("--output", type=str, default="anomaly_explanation.png")
    p.add_argument("--device", type=str,
                    default="cuda" if torch.cuda.is_available() else "cpu")
    return p.parse_args()


def compute_score(model, wav: torch.Tensor, centers_n: np.ndarray, device) -> tuple:
    """wav: (1, L) -> (score, center_idx, embedding(256,) numpy)"""
    model.eval()
    with torch.no_grad():
        emb_fft, emb_mel = model.embed_clean(wav.to(device))
        emb = torch.cat([emb_fft, emb_mel], dim=-1).cpu().numpy()
    emb_n = length_normalize(emb)
    cos_dist = 1 - emb_n @ centers_n.T
    idx = int(cos_dist.argmin(axis=-1)[0])
    return float(cos_dist[0, idx]), idx, emb_n[0]


def compute_occlusion_importance(model, wav: torch.Tensor, centers_n: np.ndarray,
                                  device, n_segments: int):
    """
    파형을 n_segments개 구간으로 나눠 하나씩 0으로 지운 뒤 점수 변화를 측정.
    importance[i] = baseline_score - masked_score(i)
      → 값이 클수록 "그 구간을 지웠을 때 이상 점수가 크게 떨어짐" = 그 구간이
        이상 판정에 크게 기여했다는 실측 증거.
    """
    baseline_score, base_idx, _ = compute_score(model, wav, centers_n, device)

    L = wav.shape[-1]
    seg_len = L // n_segments
    importances = np.zeros(n_segments, dtype=np.float32)
    for i in range(n_segments):
        start = i * seg_len
        end = L if i == n_segments - 1 else (i + 1) * seg_len
        wav_masked = wav.clone()
        wav_masked[:, start:end] = 0.0
        masked_score, _, _ = compute_score(model, wav_masked, centers_n, device)
        importances[i] = baseline_score - masked_score

    return baseline_score, base_idx, importances, seg_len


def compute_train_normal_scores(model, device, centers_n, data_root, sample_rate,
                                 num_samples, batch_size=64):
    normal_files = _list_wavs(os.path.join(data_root, "normal"))
    if len(normal_files) == 0:
        return np.array([]), np.zeros((0, centers_n.shape[1]))
    wavs = np.stack([
        load_wav_fixed_length(f, sample_rate, num_samples, random_crop=False)
        for f in normal_files
    ], axis=0)
    wav_t = torch.from_numpy(wavs).float()
    embs = length_normalize(extract_embeddings(model, device, wav_t, batch_size))
    cos_dist = 1 - embs @ centers_n.T
    scores = cos_dist.min(axis=-1)
    return scores, embs


def main():
    args = parse_args()
    device = torch.device(args.device)

    with open(args.config, "r") as f:
        config = json.load(f)
    sample_rate = config["sample_rate"]
    num_samples = config["num_samples"]
    data_root = args.data_root or config["data_root"]

    model = TwoBranchEmbeddingNet(num_samples=num_samples).to(device)
    model.load_state_dict(torch.load(args.model_path, map_location=device))
    model.eval()
    centers = np.load(args.centers_path)
    centers_n = length_normalize(centers)

    target_file = args.file or pick_random_abnormal_file(data_root, seed=args.seed)
    print(f"선택된 파일: {target_file}")

    wav_np = load_wav_fixed_length(target_file, sample_rate, num_samples, random_crop=False)
    wav = torch.from_numpy(wav_np).float().unsqueeze(0)

    # ---- 학습 정상 데이터 점수 분포 (객관적 기준점) ----
    train_scores, train_embs = compute_train_normal_scores(
        model, device, centers_n, data_root, sample_rate, num_samples)
    threshold = float(np.percentile(train_scores, args.threshold_percentile)) \
        if len(train_scores) > 0 else None
    mean_s, std_s = (float(train_scores.mean()), float(train_scores.std())) \
        if len(train_scores) > 0 else (None, None)

    # ---- 이 파일의 점수 / 임베딩 ----
    score, center_idx, emb = compute_score(model, wav, centers_n, device)
    percentile_rank = float((train_scores <= score).mean() * 100) if len(train_scores) > 0 else None
    z_score = (score - mean_s) / (std_s + 1e-8) if mean_s is not None else None
    decision = "비정상 (anomalous)" if (threshold is not None and score > threshold) else "정상 (normal)"
    margin = score - threshold if threshold is not None else None

    # ---- 수치 리포트 출력 ----
    print("=" * 60)
    print(f"파일             : {target_file}")
    print(f"anomaly score    : {score:.6f}")
    print(f"임계값 (P{args.threshold_percentile:.0f})   : {threshold:.6f}")
    print(f"판정             : {decision}  (margin = {margin:+.6f})")
    print(f"학습 정상 분포 내 백분위 : 상위 {100 - percentile_rank:.1f}% "
          f"(percentile rank={percentile_rank:.1f})")
    print(f"z-score          : {z_score:+.2f}  (정상 분포 평균 대비 표준편차 배수)")
    print(f"가장 가까운 정상 중심 : center #{center_idx}")
    print("=" * 60)

    # ---- occlusion 기반 구간별 중요도 (실측) ----
    _, _, importances, seg_len = compute_occlusion_importance(
        model, wav, centers_n, device, args.n_segments)
    seg_times = (np.arange(args.n_segments) + 0.5) * seg_len / sample_rate

    # ---- PCA 임베딩 공간 ----
    if len(train_embs) >= 2:
        pca = PCA(n_components=2).fit(train_embs)
        train_2d = pca.transform(train_embs)
        centers_2d = pca.transform(centers_n)
        test_2d = pca.transform(emb.reshape(1, -1))
    else:
        train_2d = centers_2d = test_2d = None

    # ==================== 시각화 ====================
    fig, axes = plt.subplots(2, 2, figsize=(14, 10))

    # (0,0) 스펙트로그램
    with torch.no_grad():
        spec = model.raw_spectrogram(wav.to(device)).squeeze().cpu().numpy()
    spec_db = 20 * np.log10(spec + 1e-8)
    n_fft, hop = model.n_fft, model.hop
    all_freqs = np.fft.rfftfreq(n_fft, d=1.0 / sample_rate)
    freqs = all_freqs[13:13 + spec_db.shape[0]]
    times = np.arange(spec_db.shape[1]) * hop / sample_rate
    im0 = axes[0, 0].imshow(spec_db, origin="lower", aspect="auto", cmap="magma",
                              extent=[times[0], times[-1], freqs[0], freqs[-1]])
    axes[0, 0].set_title("입력 스펙트로그램 (dB)")
    axes[0, 0].set_xlabel("시간 (초)")
    axes[0, 0].set_ylabel("주파수 (Hz)")
    fig.colorbar(im0, ax=axes[0, 0], fraction=0.046, pad=0.04, label="dB")

    # (0,1) 점수 히스토그램
    if len(train_scores) > 0:
        axes[0, 1].hist(train_scores, bins=30, color="steelblue", alpha=0.7,
                          label="학습 정상 데이터 점수 분포")
        axes[0, 1].axvline(threshold, color="black", linestyle="--",
                             label=f"임계값 (P{args.threshold_percentile:.0f})")
        axes[0, 1].axvline(score, color="red", linewidth=2,
                             label=f"이 파일 (score={score:.4f})")
        axes[0, 1].set_title(f"학습 정상 분포 대비 위치\n"
                               f"백분위={percentile_rank:.1f}%, z-score={z_score:+.2f}")
        axes[0, 1].set_xlabel("anomaly score (코사인 거리)")
        axes[0, 1].set_ylabel("빈도 (학습 정상 파일 수)")
        axes[0, 1].legend(fontsize=8)
    else:
        axes[0, 1].text(0.5, 0.5, "학습 정상 데이터를 찾을 수 없습니다",
                          ha="center", va="center")

    # (1,0) occlusion 구간별 중요도 (스펙트로그램과 시간축 정렬)
    colors = ["crimson" if v > 0 else "steelblue" for v in importances]
    axes[1, 0].bar(seg_times, importances, width=seg_len / sample_rate * 0.9,
                    color=colors)
    axes[1, 0].axhline(0, color="black", linewidth=0.8)
    axes[1, 0].set_xlim(times[0], times[-1])
    axes[1, 0].set_title("구간별 중요도 (occlusion 실측값)\n"
                           "빨강: 지우면 정상에 가까워짐(이상에 기여) / "
                           "파랑: 지우면 오히려 더 이상해짐")
    axes[1, 0].set_xlabel("시간 (초)")
    axes[1, 0].set_ylabel("Δscore = baseline − masked")

    # (1,1) PCA 임베딩 공간
    if train_2d is not None:
        axes[1, 1].scatter(train_2d[:, 0], train_2d[:, 1], c="lightgray", s=20,
                             label="학습 정상 임베딩")
        axes[1, 1].scatter(centers_2d[:, 0], centers_2d[:, 1], c="black", marker="x",
                             s=80, label="k-means 중심")
        axes[1, 1].scatter(test_2d[:, 0], test_2d[:, 1], c="red", marker="*", s=250,
                             edgecolors="black", label="이 파일")
        nearest = centers_2d[center_idx]
        axes[1, 1].plot([test_2d[0, 0], nearest[0]], [test_2d[0, 1], nearest[1]],
                          "r--", linewidth=1)
        axes[1, 1].set_title("임베딩 공간(PCA 2D 투영)에서의 위치")
        axes[1, 1].set_xlabel("PC1")
        axes[1, 1].set_ylabel("PC2")
        axes[1, 1].legend(fontsize=8)
    else:
        axes[1, 1].text(0.5, 0.5, "학습 임베딩이 부족해 PCA를 계산할 수 없습니다",
                          ha="center", va="center")

    fname = os.path.basename(target_file)
    fig.suptitle(f"파일: {fname}  |  판정: {decision}  |  score={score:.4f}  "
                  f"(threshold={threshold:.4f}, margin={margin:+.4f})", fontsize=12)
    fig.tight_layout(rect=[0, 0, 1, 0.95])
    fig.savefig(args.output, dpi=150)
    print(f"결과 저장: {args.output}")


if __name__ == "__main__":
    main()
Hello, I'm Terry! 👋 Enjoy every moment of your life! 🌱 My current interests are Signal processing, Machine learning, Python, Database, LLM & RAG, MCP & ADK, Multi-Agents, Physical AI, ROS2...