[논문 연구 - 모두의 연구소] Wk_8_Exploring_Large_Scale_Pre-Trained_Models_for_Robust_Machine_Anomalous_Sound_Detection (260910)
Deep Learning
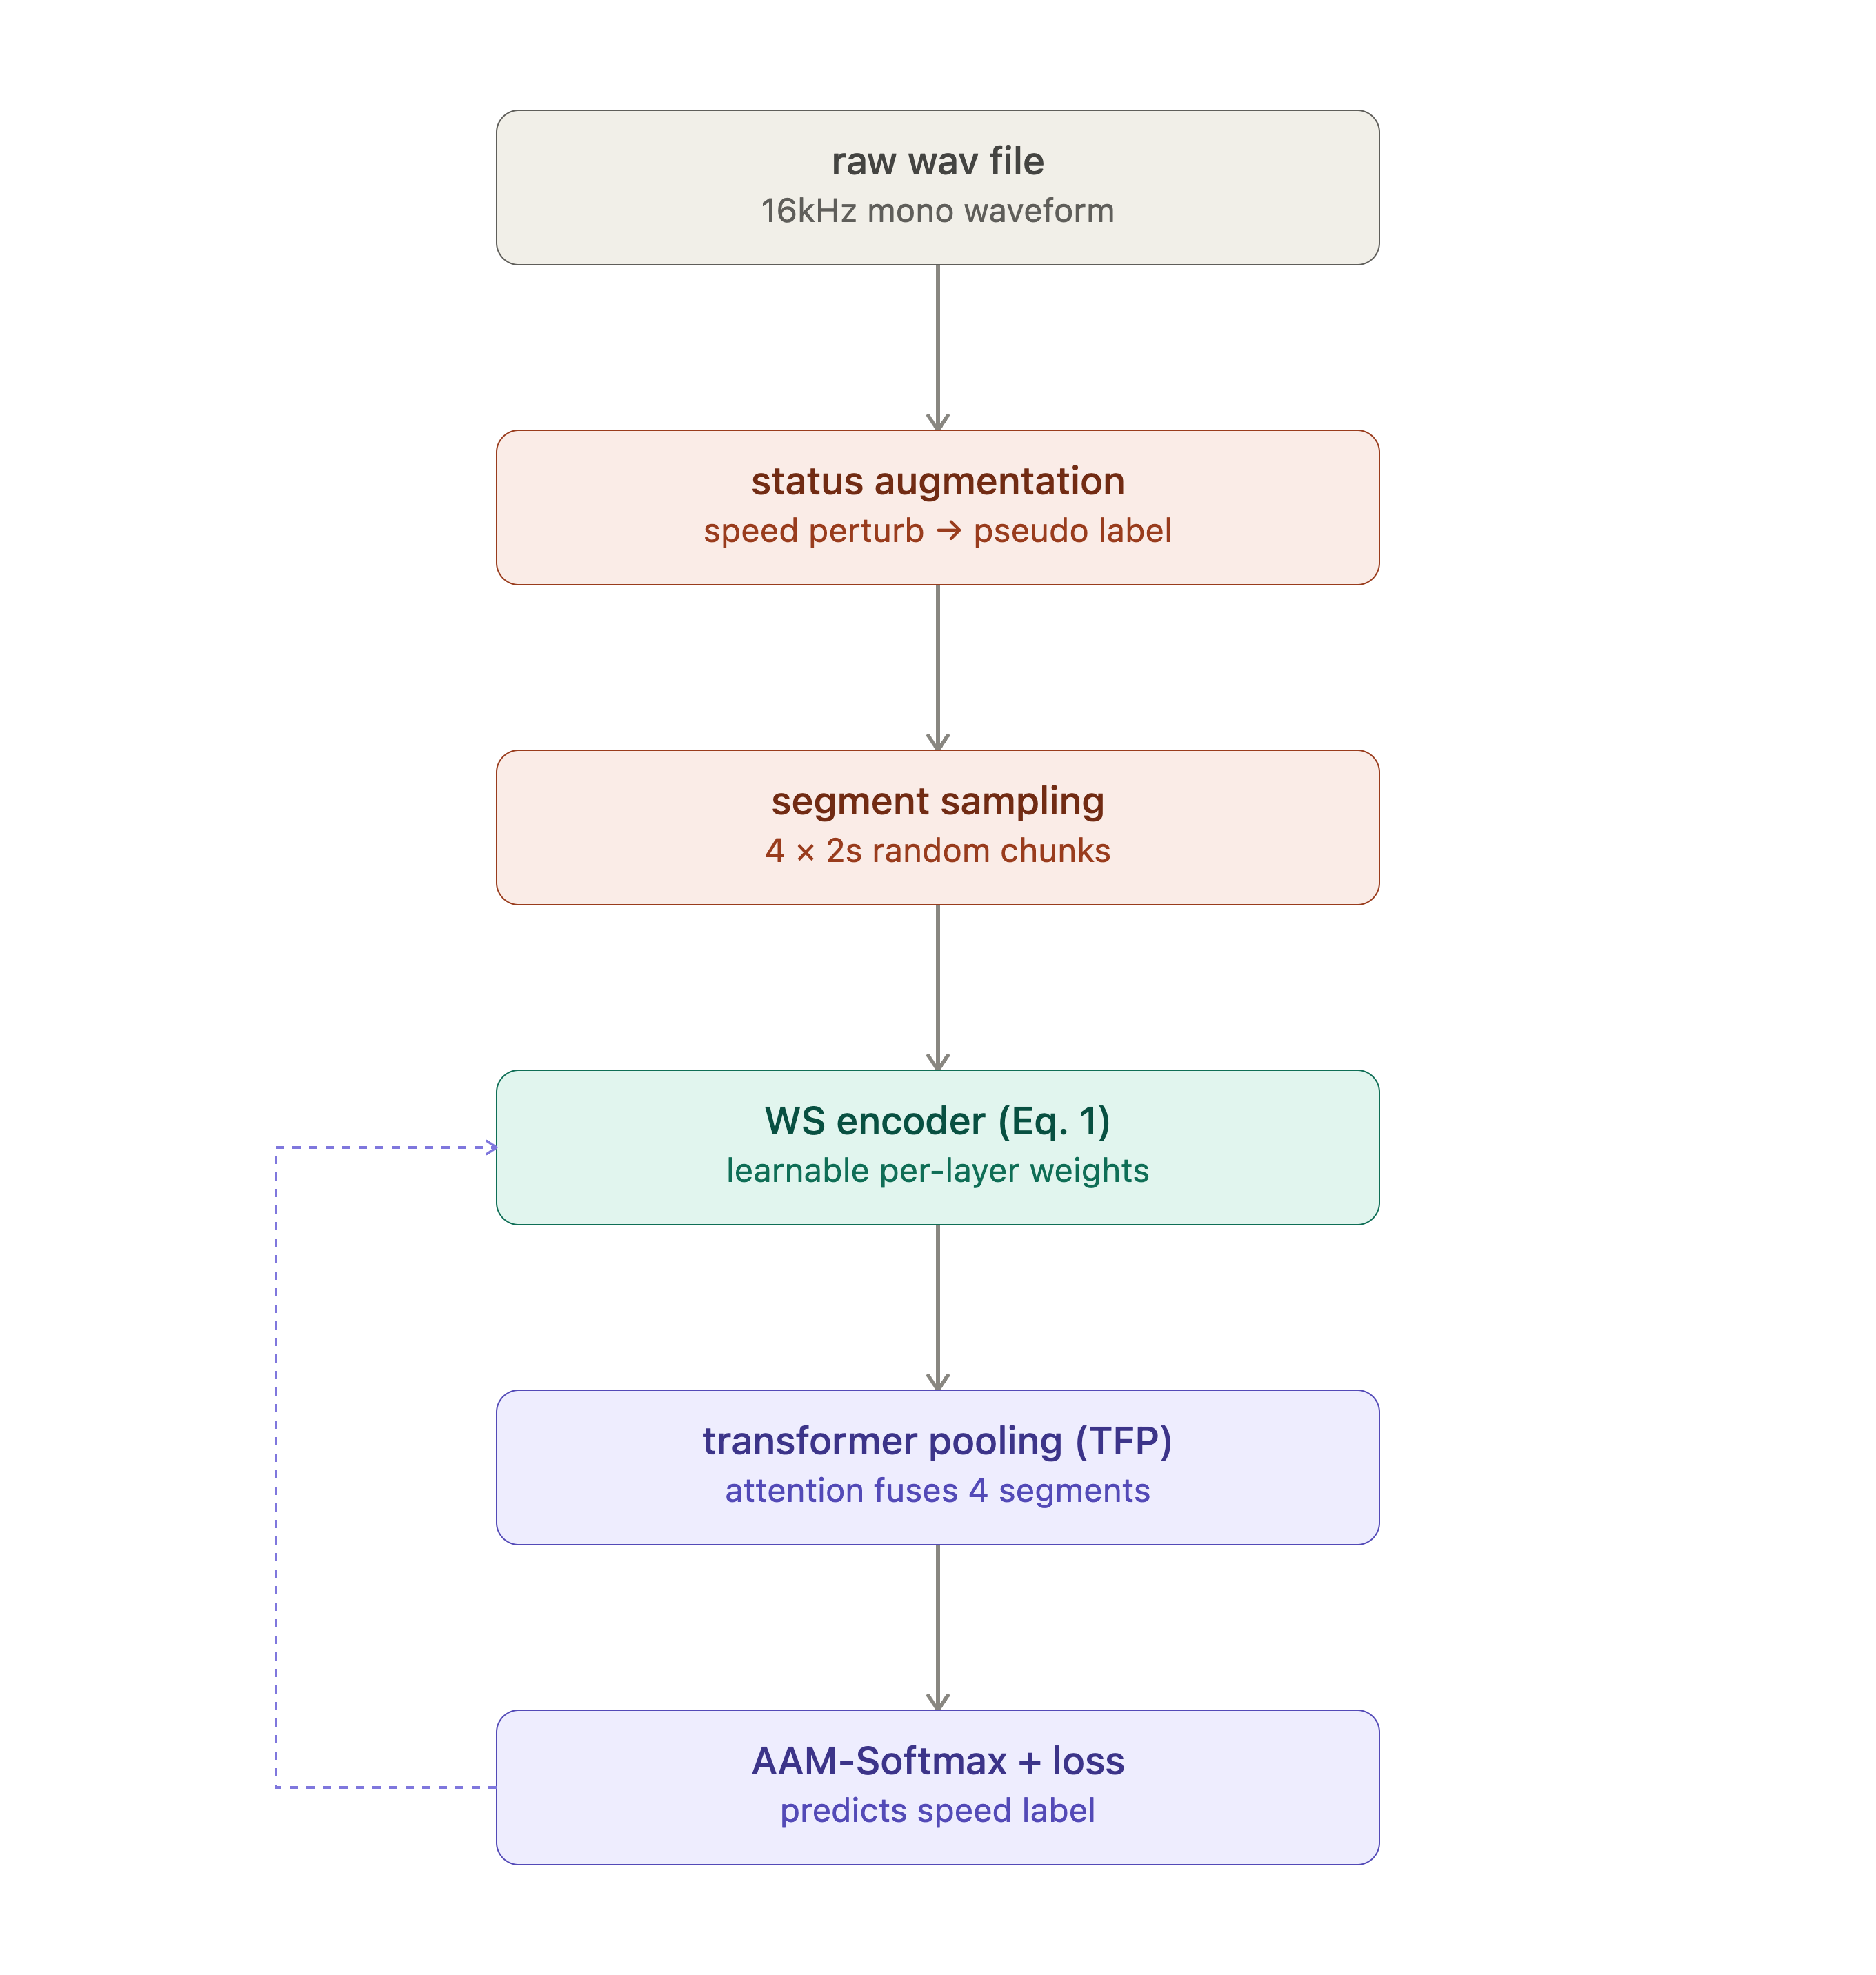
학습 과정에서 wav 파일이 어떻게 흘러가는지 정리해서, 마지막에 파이프라인 다이어그램을 하나만 그려드리겠습니다.
데이터 흐름 (코드 기준)
① wav 파일 로딩 (dataset.py: _load_mono)
./data/MIMII/normal/00000XXX.wav를 soundfile로 읽고, 스테레오면 모노로 평균, target_sr(16kHz)과 다르면 torchaudio.functional.resample로 맞춥니다. 학습에는 normal 폴더만 사용합니다(비지도 학습 전제, 논문 Sec. 2).
② Status Augmentation (augmentation.py: status_augment)
로드된 파형을 config.SPEED_FACTORS = [0.9, 0.95, 1.0, 1.05, 1.1] 중 하나로 리샘플링해 속도를 바꿉니다(논문 3.1절). 이때 선택된 speed factor의 인덱스가 분류 레이블이 됩니다 — 실제 attribute 메타데이터가 없는 이 프로젝트에서는 이 인덱스 자체를 self-supervised 레이블로 씁니다.
③ Segment sampling (dataset.py: _sample_segments)
증강된 파형에서 2초짜리 청크를 num_segments=4개 무작위 슬라이딩 윈도우로 샘플링합니다(논문 3.3절 "chunk the recording into several shorter segments"). 한 아이템의 shape은 [4, 32000], DataLoader가 배치로 모으면 [B, 4, 32000]입니다.
④ WS 인코더 (model.py: WeightedSumEncoder)
[B*4, T]로 펼쳐서 사전학습 backbone(wav2vec2 등)에 넣고, 모든 Transformer 레이어의 hidden_states를 학습 가능한 가중치 layer_weights로 softmax 정규화 후 가중합합니다(Eq. 1). 시간축 평균 풀링 후 Dense로 투영해 세그먼트별 임베딩 [B, 4, embed_dim]을 얻습니다.
⑤ Transformer Pooling (model.py: TransformerPooling)
4개 세그먼트 임베딩에 CLS 토큰을 붙여 self-attention으로 융합, 녹음 전체를 대표하는 임베딩 [B, embed_dim] 하나로 만듭니다(논문 3.3절).
⑥ AAM-Softmax + Loss (model.py: AAMSoftmax, train.py)
녹음 임베딩과 status 레이블로 ArcFace 스타일 각도 마진 손실(Eq. 2)을 계산하고, CrossEntropyLoss로 최종 loss를 구합니다.
⑦ 역전파 / 파라미터 업데이트 (점선 화살표)
loss.backward() → AdamW.step()으로 layer_weights(WS), dense, TransformerPooling, AAMSoftmax의 가중치, 그리고 backbone의 Transformer 레이어(단, CNN feature extractor는 고정)가 업데이트됩니다. 이 과정이 --steps만큼 반복되며(기본 10k), 모델은 "이 청크에 어떤 속도 변조가 가해졌는가"를 맞히도록 학습되고, 그 과정에서 정상 기계음의 특징 공간을 학습하게 됩니다. 이후 test.py에서 이 임베딩들을 k-NN으로 이상탐지에 사용합니다.
model.py
"""
Model architecture reproducing Fig. 1 / Sec. 3.2 / Sec. 3.3 of the paper.

Pipeline per recording:

    waveform
      -> Status Augmentation (train time only, see augmentation.py)
      -> pre-trained SSL backbone (CNN feature encoder + Transformer layers)
      -> Weighted Sum over all layer hidden states (Eq. 1)          [WS]
      -> mean pooling over time -> per-segment chunk embedding
      -> Dense projection -> `embed_dim` chunk embedding
      -> (repeat for `num_segments` sliding-window chunks)
      -> Transformer Pooling with attention fusion                  [TFP]
      -> recording-level embedding
      -> AAM-Softmax classifier (training) / raw embedding (inference)
"""

from typing import Optional, Tuple

import torch
import torch.nn as nn
import torch.nn.functional as F
from transformers import AutoModel

from config import AAM_MARGIN, AAM_SCALE, EMBED_DIM, MODEL_ZOO, NUM_STATUS_CLASSES


class WeightedSumEncoder(nn.Module):
    def __init__(self, model_key: str = "wav2vec2", freeze_feature_extractor: bool = True):
        super().__init__()
        model_name = MODEL_ZOO[model_key]
        self.backbone = AutoModel.from_pretrained(model_name)
        self.backbone.config.output_hidden_states = True
        self.hidden_size = self.backbone.config.hidden_size

        # Disable LayerDrop. Some SSL checkpoints (e.g. wav2vec2-xls-r) ship
        # with config.layerdrop > 0, which stochastically skips transformer
        # layers *during training only*. In current `transformers` versions
        # a skipped layer's state is also omitted from `hidden_states`, so
        # the length of that tuple becomes random and unstable between
        # eval/train and between batches. That's incompatible with the
        # paper's Weighted-Sum (Eq. 1), which assigns one fixed learnable
        # weight per layer, so we force a stable, deterministic layer count.
        if hasattr(self.backbone.config, "layerdrop"):
            self.backbone.config.layerdrop = 0.0

        # The number of tensors in `outputs.hidden_states` is not always
        # exactly `config.num_hidden_layers + 1` for every checkpoint/
        # architecture. Probe it directly with a tiny dummy forward pass.
        self.num_layers = self._probe_num_layers()
        self.layer_weights = nn.Parameter(torch.ones(self.num_layers))

        if freeze_feature_extractor:
            feat_ext = getattr(self.backbone, "feature_extractor", None)
            if feat_ext is not None:
                for p in feat_ext.parameters():
                    p.requires_grad = False

    def _probe_num_layers(self) -> int:
        was_training = self.backbone.training
        self.backbone.eval()
        with torch.no_grad():
            dummy = torch.zeros(1, 16000)  # 1s of silence @ 16kHz
            outputs = self.backbone(dummy, output_hidden_states=True)
            n_layers = len(outputs.hidden_states)
        if was_training:
            self.backbone.train()
        return n_layers

    def forward(self, waveforms: torch.Tensor) -> torch.Tensor:
        """waveforms: [B, T] raw audio -> weighted-sum hidden states [B, T', D]."""
        outputs = self.backbone(waveforms, output_hidden_states=True)
        hidden_states = outputs.hidden_states  # tuple of [B, T', D], length num_layers
        stacked = torch.stack(hidden_states, dim=0)  # [L, B, T', D]
        if stacked.size(0) != self.layer_weights.numel():
            raise RuntimeError(
                f"Backbone returned {stacked.size(0)} hidden-state layers but "
                f"layer_weights has {self.layer_weights.numel()} entries. "
                "This can happen if the checkpoint's layer count is not "
                "stable across calls; please report this model_key."
            )
        w = F.softmax(self.layer_weights, dim=0).view(-1, 1, 1, 1)
        weighted = (stacked * w).sum(dim=0)  # [B, T', D]
        return weighted


class AAMSoftmax(nn.Module):
    """Additive Angular Margin softmax (Eq. 2 / ArcFace)."""

    def __init__(self, embed_dim: int, num_classes: int, margin: float = AAM_MARGIN, scale: float = AAM_SCALE):
        super().__init__()
        self.weight = nn.Parameter(torch.randn(num_classes, embed_dim))
        nn.init.xavier_uniform_(self.weight)
        self.margin = margin
        self.scale = scale

    def forward(self, embeddings: torch.Tensor, labels: Optional[torch.Tensor] = None) -> torch.Tensor:
        x = F.normalize(embeddings, dim=1)
        w = F.normalize(self.weight, dim=1)
        cosine = F.linear(x, w).clamp(-1 + 1e-7, 1 - 1e-7)  # [B, C]

        if labels is None:
            return cosine * self.scale

        theta = torch.acos(cosine)
        target_logit = torch.cos(theta + self.margin)
        one_hot = F.one_hot(labels, num_classes=cosine.size(1)).float()
        logits = cosine * (1 - one_hot) + target_logit * one_hot
        return logits * self.scale


class TransformerPooling(nn.Module):
    """Fuses multiple per-segment embeddings from one recording into a
    single embedding using self-attention (Sec. 3.3)."""

    def __init__(self, embed_dim: int, num_heads: int = 4, num_layers: int = 1):
        super().__init__()
        layer = nn.TransformerEncoderLayer(
            d_model=embed_dim, nhead=num_heads, batch_first=True, dim_feedforward=embed_dim * 2
        )
        self.transformer = nn.TransformerEncoder(layer, num_layers=num_layers)
        self.cls_token = nn.Parameter(torch.randn(1, 1, embed_dim) * 0.02)
        self.attn_pool = nn.Linear(embed_dim, 1)

    def forward(self, segment_embeddings: torch.Tensor) -> torch.Tensor:
        """segment_embeddings: [B, S, D] -> pooled [B, D]."""
        B = segment_embeddings.size(0)
        cls = self.cls_token.expand(B, -1, -1)
        x = torch.cat([cls, segment_embeddings], dim=1)  # [B, S+1, D]
        x = self.transformer(x)
        attn_logits = self.attn_pool(x).squeeze(-1)  # [B, S+1]
        attn_weights = torch.softmax(attn_logits, dim=1).unsqueeze(-1)
        pooled = (x * attn_weights).sum(dim=1)  # [B, D]
        return pooled


class ASDModel(nn.Module):
    """Full model: WS encoder -> Dense -> (Transformer Pooling) -> AAM head."""

    def __init__(
        self,
        model_key: str = "wav2vec2",
        embed_dim: int = EMBED_DIM,
        num_classes: int = NUM_STATUS_CLASSES,
        use_transformer_pooling: bool = True,
        margin: float = AAM_MARGIN,
        scale: float = AAM_SCALE,
    ):
        super().__init__()
        self.encoder = WeightedSumEncoder(model_key)
        self.dense = nn.Linear(self.encoder.hidden_size, embed_dim)
        self.use_tfp = use_transformer_pooling
        if use_transformer_pooling:
            self.tfp = TransformerPooling(embed_dim)
        self.classifier = AAMSoftmax(embed_dim, num_classes, margin, scale)

    def encode_chunk(self, waveform_chunk: torch.Tensor) -> torch.Tensor:
        """waveform_chunk: [N, T] -> chunk-level embedding [N, embed_dim]."""
        h = self.encoder(waveform_chunk)      # [N, T', hidden]
        h = h.mean(dim=1)                       # simple average pooling over time
        return self.dense(h)                    # [N, embed_dim]

    def _pool_recording(self, segments: torch.Tensor) -> torch.Tensor:
        """segments: [B, S, T] -> recording-level embedding [B, embed_dim]."""
        B, S, T = segments.shape
        flat = segments.reshape(B * S, T)
        chunk_emb = self.encode_chunk(flat).view(B, S, -1)
        if self.use_tfp:
            return self.tfp(chunk_emb)
        return chunk_emb.mean(dim=1)

    def forward(
        self, segments: torch.Tensor, labels: Optional[torch.Tensor] = None
    ) -> Tuple[torch.Tensor, torch.Tensor]:
        rec_emb = self._pool_recording(segments)
        logits = self.classifier(rec_emb, labels)
        return rec_emb, logits

    @torch.no_grad()
    def get_embedding(self, segments: torch.Tensor) -> torch.Tensor:
        """Inference-time embedding extraction (used by k-NN back-end)."""
        was_training = self.training
        self.eval()
        rec_emb = self._pool_recording(segments)
        if was_training:
            self.train()
        return F.normalize(rec_emb, dim=1)