CREATE INDEX idx_xxx ON table (column) — 이 한 줄은 써봤다. "쿼리가 느리면 인덱스를 걸면 된다"는 것도 안다. 근데 막상 "인덱스가 정확히 뭘 하길래 빨라지는 거야?"라고 물으면 말이 막힌다. "빠르게 찾아주는 것" 정도로 뭉뚱그려 알고 있었다면, 이 글은 그 뭉뚱그림을 걷어내기 위한 글이다.
1. 왜 인덱스가 필요한가
내가 만든 서비스의 student_course 테이블은 학생들의 이수내역을 담고 있고, 행이 60,024개다. 특정 학생 한 명의 이수내역을 찾는 쿼리를 생각해보자.
SELECT * FROM student_course WHERE student_profile_id = 1288;인덱스가 없으면 MySQL은 이 60,024행을 전부 읽으면서 student_profile_id가 1288인지 하나하나 확인한다. 학생 한 명당 이수 과목이 40~80개 정도니, 결과는 많아야 80행인데 그걸 찾겠다고 6만 행을 다 읽는 것이다. 이게 풀 테이블 스캔(full table scan) 이고, 인덱스가 존재하는 근본적인 이유는 이 낭비를 없애기 위해서다.
인덱스를 설명할 때 제일 흔히 쓰는 비유가 "책 색인 찾아보기"다. 이 비유는 절반만 맞다. 책의 색인은 "빠르게 찾을 수 있는 목록"이라는 결과만 보여줄 뿐, 왜 빠른지는 설명하지 못한다. 책 색인이 빠른 이유는 단 하나 — 정렬돼 있기 때문이다. 가나다순으로 정렬된 목록에서 "ㅅ"으로 시작하는 단어를 찾을 때, 우리는 처음부터 한 장씩 넘기지 않는다. 대충 중간을 펼쳐서 "ㅇ"이 나오면 앞쪽으로, "ㄷ"이 나오면 뒤쪽으로 — 이렇게 범위를 반씩 좁혀가며 찾는다.
인덱스의 본질은 "컬럼 값을 정렬된 상태로 별도로 유지하는 것"이다. 정렬돼 있으면 이런 식으로 범위를 좁혀가며 찾을 수 있고(이걸 자료구조 용어로 이진 탐색에 가까운 방식이라고 한다), 그래서 60,024행이든 6억 행이든 몇 번 비교하지 않고 원하는 지점 근처로 바로 갈 수 있다. 반대로 정렬돼 있지 않으면 "찾았다"고 확신할 방법이 하나뿐이다 — 처음부터 끝까지 다 보는 것. 그게 풀 테이블 스캔이다.
그럼 "정렬된 상태를 유지"한다는 게 실제로는 어떤 자료구조로 구현돼 있을까?
2. 인덱스는 실제로 어떻게 생겼나 — B-Tree
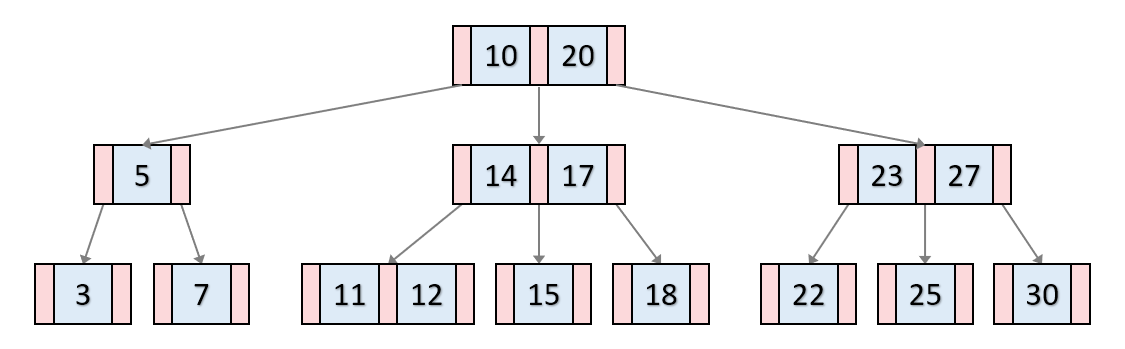
MySQL(InnoDB)의 기본 인덱스 구조는 B-Tree(정확히는 B+Tree)다. 핵심 특징 세 가지만 기억하면 된다.
- 정렬된 키: 모든 노드 안의 값은 정렬돼 있다.
- 균형 잡힌 트리: 루트에서 리프까지의 깊이가 어디를 가든 거의 같다. 그래서 행이 아무리 많아도 루트→중간 노드→리프까지 몇 번의 이동으로 원하는 값 근처에 도달한다(6만 행이든 600만 행이든 트리 깊이는 3~4단 정도밖에 안 늘어난다).
- 리프 노드끼리 연결: 리프 노드들이 양방향 연결 리스트로 이어져 있어서,
BETWEEN이나>같은 범위 조건일 때 한 번 찾은 지점부터 옆으로 쭉 훑기만 하면 된다.
여기서 MySQL(InnoDB)만의 중요한 특징이 하나 있다. Primary Key가 곧 테이블 자체다. 이걸 클러스터드 인덱스라고 부르는데, PK로 만든 B-Tree의 리프 노드에 그 행의 모든 컬럼 데이터가 통째로 들어있다는 뜻이다. 테이블이 디스크에 저장되는 순서 자체가 PK 정렬 순서라고 보면 된다. (AUTO_INCREMENT를 PK로 즐겨 쓰는 이유가 여기 있다 — 값이 항상 증가하니 새 행이 항상 트리의 맨 끝에 추가되고, 기존 페이지를 뒤섞을 일이 없다.)
반면 우리가 나중에 만드는 세컨더리 인덱스(CREATE INDEX로 추가하는 것들)는 다르다. 세컨더리 인덱스의 리프 노드에는 그 행의 전체 데이터가 아니라, "인덱스 건 컬럼 값 + 그 행의 PK 값" 딱 이 두 개만 들어있다.
그래서 세컨더리 인덱스로 뭔가를 찾으면 2단계를 거친다.
1단계: 세컨더리 인덱스에서 조건에 맞는 걸 찾는다 → (컬럼 값, PK 값)을 얻는다
2단계: 그 PK 값을 들고 클러스터드 인덱스(=테이블 본체)로 다시 찾아간다 → 나머지 컬럼들을 가져온다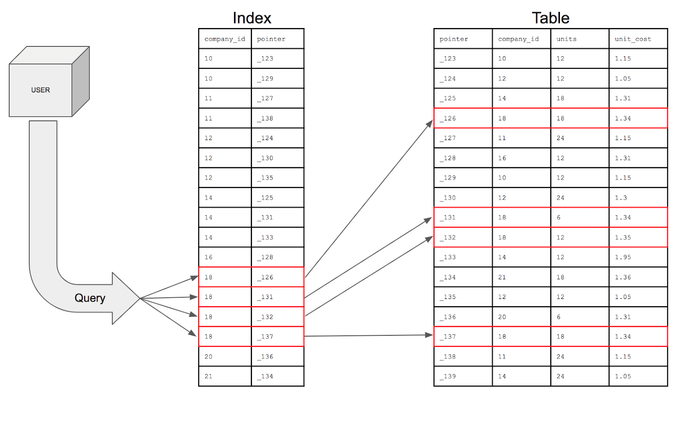
그림의 Index 테이블이 세컨더리 인덱스, pointer가 PK 값, Table이 클러스터드 인덱스(테이블 본체)다. company_id = 18로 쿼리하면 인덱스에서 4개 행(빨간 테두리)을 먼저 찾고, 그 pointer 값들로 오른쪽 Table을 다시 찾아가 나머지 컬럼(units, unit_cost)을 가져온다 — 화살표 두 번이 곧 위에서 말한 1단계·2단계다.
SELECT *처럼 인덱스에 없는 컬럼까지 필요하면 이 2단계를 거칠 수밖에 없다. 반대로 세컨더리 인덱스에 있는 컬럼만으로 쿼리가 끝난다면 2단계를 건너뛸 수 있는데 — 이게 바로 2부에서 다룰 커버링 인덱스의 원리다. 지금은 "세컨더리 인덱스로 찾으면 보통 한 번 더 찾아가야 한다"는 사실만 기억해두자.
3. 인덱스를 만들었는데도 못 타는 경우들
1, 2번을 이해하고 나면 "인덱스가 있다"와 "이 쿼리가 그 인덱스를 탄다"가 왜 다른 얘기인지 설명할 수 있다. 정렬된 순서를 이용해서 범위를 좁힐 수 있어야만 인덱스가 의미가 있다. 좁힐 방법이 없으면 결국 리프 노드를 처음부터 끝까지 훑어야 하고, 그럼 B-Tree를 타는 의미가 없어진다.
선행 와일드카드 LIKE '%키워드%'. name 컬럼에 인덱스가 있어도 소용없다. 인덱스는 name을 가나다순으로 정렬해뒀을 뿐인데, "어딘가에 이 글자가 포함된 것"은 그 정렬 순서로 좁힐 수가 없다. LIKE '디자인%'(뒤 와일드카드만)이라면 "디자인"으로 시작하는 구간으로 바로 뛰어들 수 있지만, LIKE '%디자인%'은 "디자인"이 앞에 올지 중간에 올지 끝에 올지 알 수 없으니 정렬 순서가 아무 도움이 안 된다.
컬럼에 함수를 씌운 조건. WHERE YEAR(created_at) = 2024 같은 쿼리는 created_at에 인덱스가 있어도 못 탄다. 인덱스는 created_at 원본 값 기준으로 정렬돼 있지, YEAR(created_at) 결과 기준으로 정렬된 게 아니기 때문이다. 이 조건이 참인 행을 찾으려면 모든 행에 대해 YEAR()를 계산해봐야 하고, 그건 결국 풀 스캔이다.
암묵적 타입 변환. 문자열 컬럼을 숫자와 비교하는 식으로 타입이 안 맞으면, MySQL이 비교 전에 컬럼 값을 변환해야 할 수 있다. 이것도 위와 같은 이유(정렬된 원본 값과 실제 비교 대상이 어긋남)로 인덱스를 무력화시킬 수 있다.
세 가지 다 원인은 하나다 — 인덱스가 정렬해둔 기준과, 쿼리가 실제로 찾으려는 기준이 어긋난다. 이 어긋남이 있으면 인덱스는 그냥 "존재하지만 안 쓰이는" 상태가 된다.
4. EXPLAIN으로 인덱스 제대로 읽기
지금까지는 머릿속 모델이었다. 실제로 어떤 쿼리가 인덱스를 타는지 안 타는지는 추측하지 말고 직접 확인해야 한다. 그 도구가 EXPLAIN이다.
EXPLAIN SELECT * FROM student_course WHERE student_profile_id = 1288;결과에서 눈여겨봐야 할 필드들.
type: 접근 방식의 등급.const/eq_ref(PK나 유니크 키로 단건) →ref(인덱스로 여러 건 좁힘) →range(범위 조건) →index(인덱스 전체를 훑음) →ALL(풀 테이블 스캔) 순으로 대체로 뒤로 갈수록 느리다.ALL이 보이면 일단 의심한다.possible_keys/key:possible_keys는 "쓸 수도 있었던" 인덱스 후보 목록이고,key는 옵티마이저가 실제로 선택한 인덱스다.possible_keys에 인덱스가 있어도key가 비어있으면 결국 안 쓴 것이다.rows: 이 단계에서 읽을 것으로 예상하는 행 수. 어디까지나 통계 기반 추정치라 실제와 다를 수 있다.filtered: 그rows중에서 WHERE 조건까지 실제로 만족할 것으로 예상하는 비율(%).rows가 크고filtered가 낮으면 "많이 읽어놓고 대부분 버린다"는 뜻이다.Extra: 추가 정보가 나온다.Using index는 커버링 인덱스로 테이블 접근 없이 끝났다는 뜻(좋음).Using filesort는 인덱스 순서로 정렬이 안 돼서 별도 정렬 작업이 붙었다는 뜻(주의).Using temporary는 임시 테이블을 만들어야 했다는 뜻(주의).
MySQL 8.0.18부터는 EXPLAIN ANALYZE도 쓸 수 있는데, 이건 추정치가 아니라 실제로 쿼리를 실행하고 나온 진짜 수치(actual time, actual rows)를 보여준다. 옵티마이저의 추정(rows, filtered)은 통계가 오래됐거나 데이터 분포가 특이하면 틀릴 수 있어서, 확신이 필요할 땐 EXPLAIN ANALYZE로 실측하는 게 안전하다. 2부와 3부에서 보여줄 결과도 전부 이 실측값이다.
5. 공짜가 아니다 — 인덱스의 비용
여기까지 보면 "그럼 그냥 모든 컬럼에 인덱스 걸면 되는 거 아닌가?"라는 생각이 들 수 있다. 그렇지 않다.
2번에서 얘기했듯 인덱스는 "정렬된 상태를 유지하는" 구조다. 그 말은 곧, 행을 추가(INSERT)하거나 인덱스 건 컬럼 값을 바꾸면(UPDATE), 그 정렬 순서도 같이 맞춰줘야 한다는 뜻이다. 인덱스가 하나면 한 번 더 쓰기 작업이 늘어나는 거고, 인덱스가 다섯 개면 다섯 번 더 늘어난다. 읽기는 빨라지지만 쓰기는 그만큼 느려지는, 전형적인 트레이드오프다. 여기에 인덱스 자체가 차지하는 디스크 용량도 무시할 수 없다 — 인덱스는 결국 원본 컬럼 값의 "정렬된 사본"이기 때문이다.
그래서 "일단 다 걸어두면 안전하다"는 생각은 틀렸다. 안 쓰이는 인덱스도 쓰기 비용은 똑같이 낸다. 인덱스 설계는 "얼마나 많이 거느냐"가 아니라 "어떤 컬럼 조합을, 어떤 순서로, 하나만 제대로 만드느냐"의 문제다.
여기까지가 인덱스의 기본 뼈대다. 정리하면:
- 인덱스는 정렬된 사본이고, 정렬돼 있어야 범위를 좁혀서 빠르게 찾을 수 있다.
- MySQL(InnoDB)은 PK가 곧 테이블이고(클러스터드 인덱스), 세컨더리 인덱스는 보통 한 번 더 테이블을 찾아가야 한다.
- 정렬 기준과 쿼리 조건이 어긋나면(선행 와일드카드, 함수, 타입 변환) 인덱스는 무용지물이 된다.
EXPLAIN/EXPLAIN ANALYZE로 추측 대신 실제로 확인한다.- 인덱스는 읽기와 쓰기를 맞바꾸는 트레이드오프다.
다음 2부에서는 이 뼈대 위에서 실전 질문들을 다룬다 — 컬럼이 여러 개일 땐 인덱스를 어떤 순서로 만들어야 하는지, 인덱스를 여러 개 걸어두면 MySQL이 알아서 잘 섞어 쓰는지(index_merge), 그리고 애초에 B-Tree로는 안 되는 것(부분 문자열 검색)은 어떻게 해결하는지.