1부에서 인덱스가 정렬된 B+Tree라는 것, 정렬 기준과 쿼리 조건이 어긋나면 못 탄다는 것, EXPLAIN으로 확인하는 법까지 봤다. 근데 아직 궁금증이 풀리지 않은 부분이 있다. — "WHERE 조건에 컬럼이 두 개 이상이면 인덱스를 어떻게 걸어야 하나?" 컬럼마다 인덱스를 하나씩 걸어야 하나, 아니면 묶어서 하나로 걸어야 하나. 이번 글은 이 질문에 답한다.
6. 복합 인덱스와 컬럼 순서
컬럼 두 개(A, B)를 묶어서 인덱스를 걸면 — CREATE INDEX idx ON table (A, B) — 이건 "A에 인덱스 하나 + B에 인덱스 하나"가 아니다. A로 먼저 정렬하고, 같은 A값 안에서 다시 B로 정렬한 딱 하나의 구조다. 전화번호부를 "성"으로 먼저 정렬하고, 같은 성 안에서 "이름"으로 다시 정렬해두는 것과 같다.
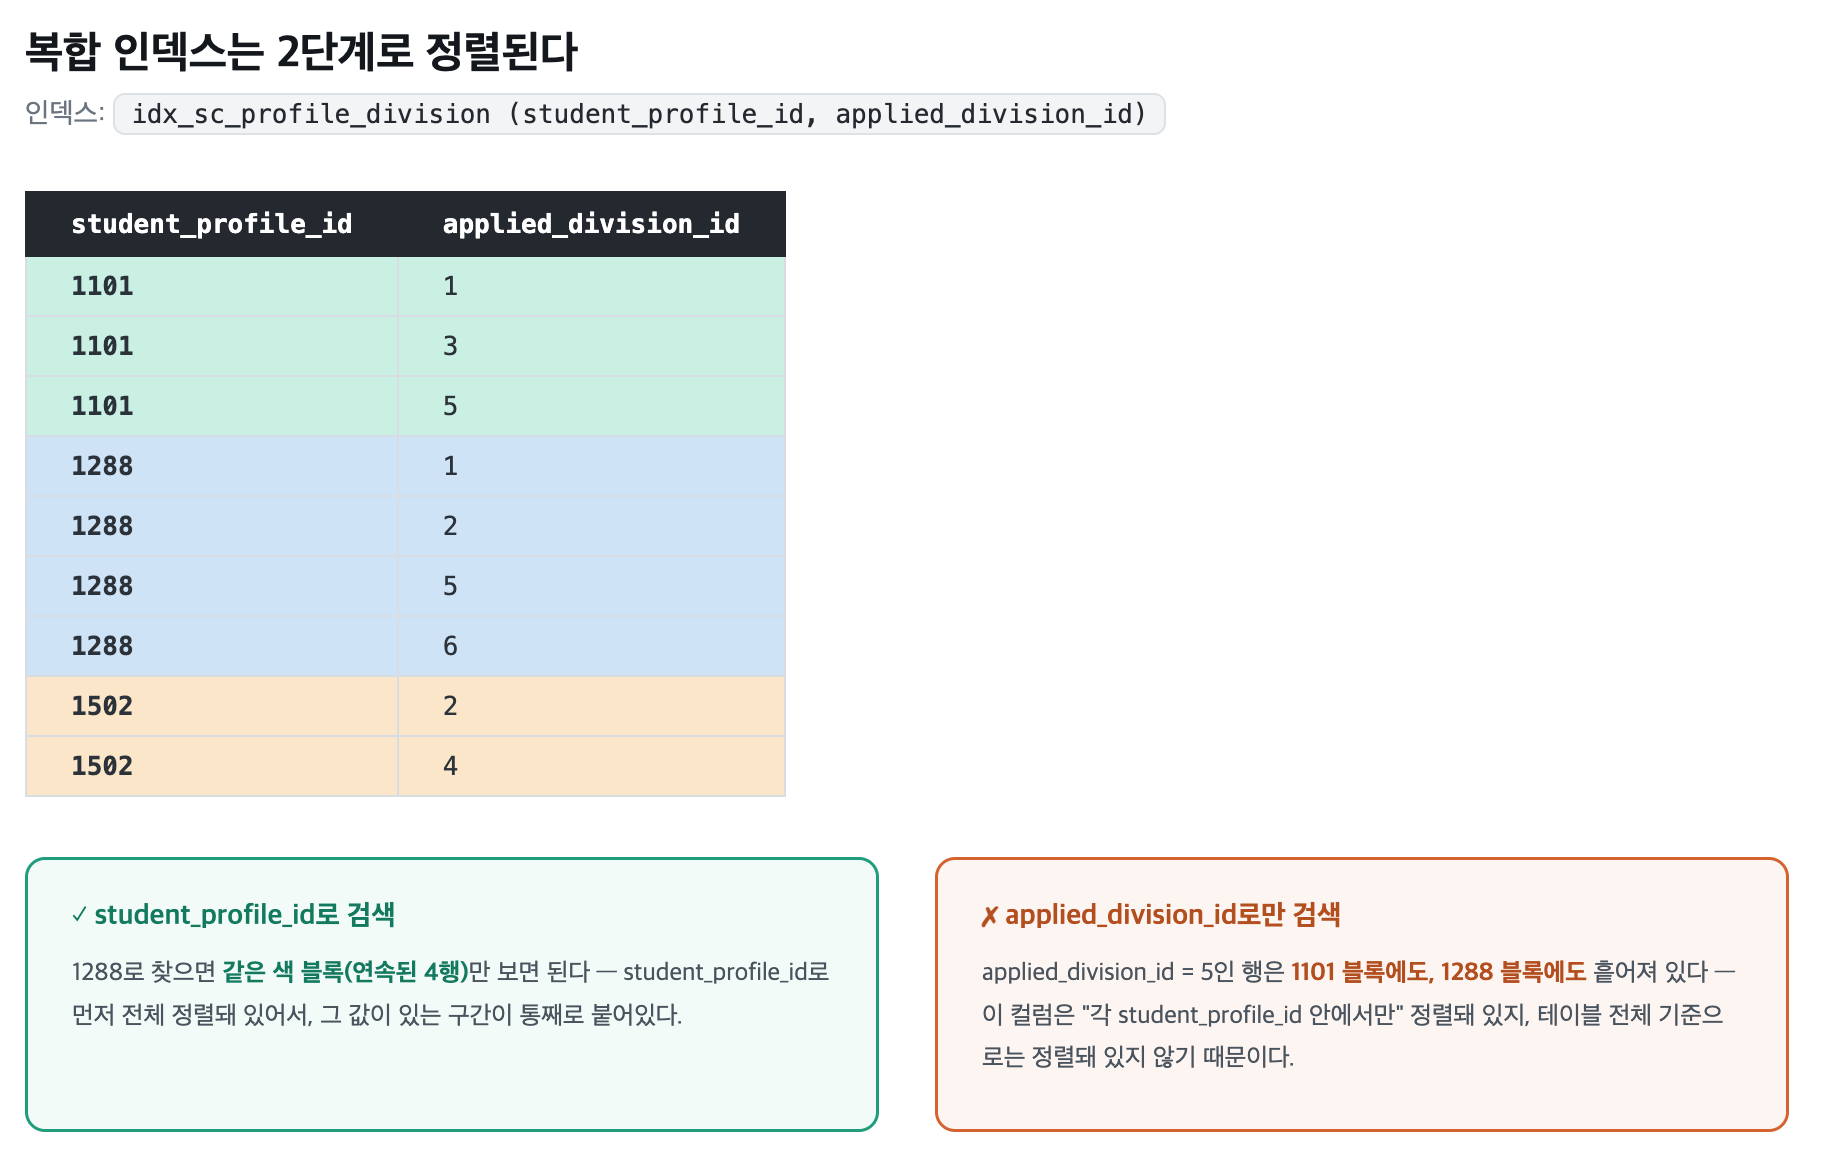
이 구조에서 중요한 규칙이 leftmost prefix(최좌측 접두) 다. (A, B) 인덱스는 "A로 검색"하거나 "A와 B로 같이 검색"할 땐 쓸 수 있지만, "B로만 검색"할 땐 못 쓴다. B는 전체적으로 정렬돼 있는 게 아니라 "각 A값 안에서만" 정렬돼 있기 때문이다. 성 없이 이름만으로 전화번호부를 찾으려는 것과 같다 — 정렬 기준(성)을 모르니 처음부터 다 훑어야 한다.
그럼 A와 B 중 뭘 앞에 둬야 할까? 내 프로젝트의 실제 사례로 보자. student_course 테이블(60,024행)에서 "학생 한 명의 이수구분별 이수과목"을 찾는 쿼리다.
SELECT sc.id FROM student_course sc
WHERE sc.student_profile_id = 1288 AND sc.applied_division_id IN (1, 3, 5);
여기 걸린 복합 인덱스는 idx_sc_profile_division (student_profile_id, applied_division_id) — student_profile_id가 앞이다. 이유는 선택도(cardinality) 다.
student_profile_id: 학생 한 명당 40~80행. 전체 60,024행 중 한 값이 차지하는 비중이 0.1%대 — 선택도가 매우 높다.applied_division_id: 값 하나가 전체의 45.6%를 차지할 만큼 치우쳐 있다 — 선택도가 낮다.
선택도 높은 컬럼을 앞에 두면, 인덱스 탐색 한 번으로 먼저 "이 학생의 행"(수십 개)까지 확 좁혀지고, 그 좁은 범위 안에서 applied_division_id로 다시 거르는 건 설령 치우침이 있어도 비용이 거의 안 든다. 반대로 순서를 바꿔서 (applied_division_id, student_profile_id)로 걸었다면? 치우친 값 하나만으로 이미 27,000행 가까이(45.6% × 60,024)를 걸러야 하는 상황부터 시작하게 된다. "어떤 컬럼을 인덱스에 넣을까"만큼 "어떤 순서로 넣을까"도 결과를 완전히 바꾼다.
7. 인덱스가 여러 개면 다 좋은 거 아닌가? — index_merge
그럼 애초에 컬럼마다 단일 인덱스를 따로따로 걸어두면 되는 거 아닌가? 두 조건을 같이 쓰는 쿼리가 오면 MySQL이 알아서 두 인덱스를 섞어서 쓰지 않을까?
실제로 그런 기능이 있다 — index_merge. 옵티마이저가 각 인덱스를 따로 스캔해서 나온 두 결과(행 포인터 집합)를 교집합(intersect) 내는 방식이다. "두 인덱스를 다 쓴다"니까 그럴듯하게 들리지만, 실제로 직접 두 방식을 비교해보니 문제가 있었다. course 테이블(5,000행)의 "학과별 개설 과목 조회" 쿼리로 확인했다.
SELECT c.id FROM course c
WHERE c.offering_department_id = 3 AND c.is_active = 1;
단일 인덱스 2개(offering_department_id, is_active 각각)일 때
→ index_merge (intersect) 사용
→ offering_department_id 인덱스 스캔: 620행 + is_active 인덱스 스캔: 4,481행
→ 실제로 읽은 행(합계): 5,101행
→ 최종 반환된 행: 536행
복합 인덱스 idx_course_dept_active (offering_department_id, is_active) 하나로 교체
→ 실제로 읽은 행: 536행 (Covering index lookup)536행을 돌려주기 위해 5,101행을 읽었다. 9.5배 차이다. 왜 이렇게 벌어질까?
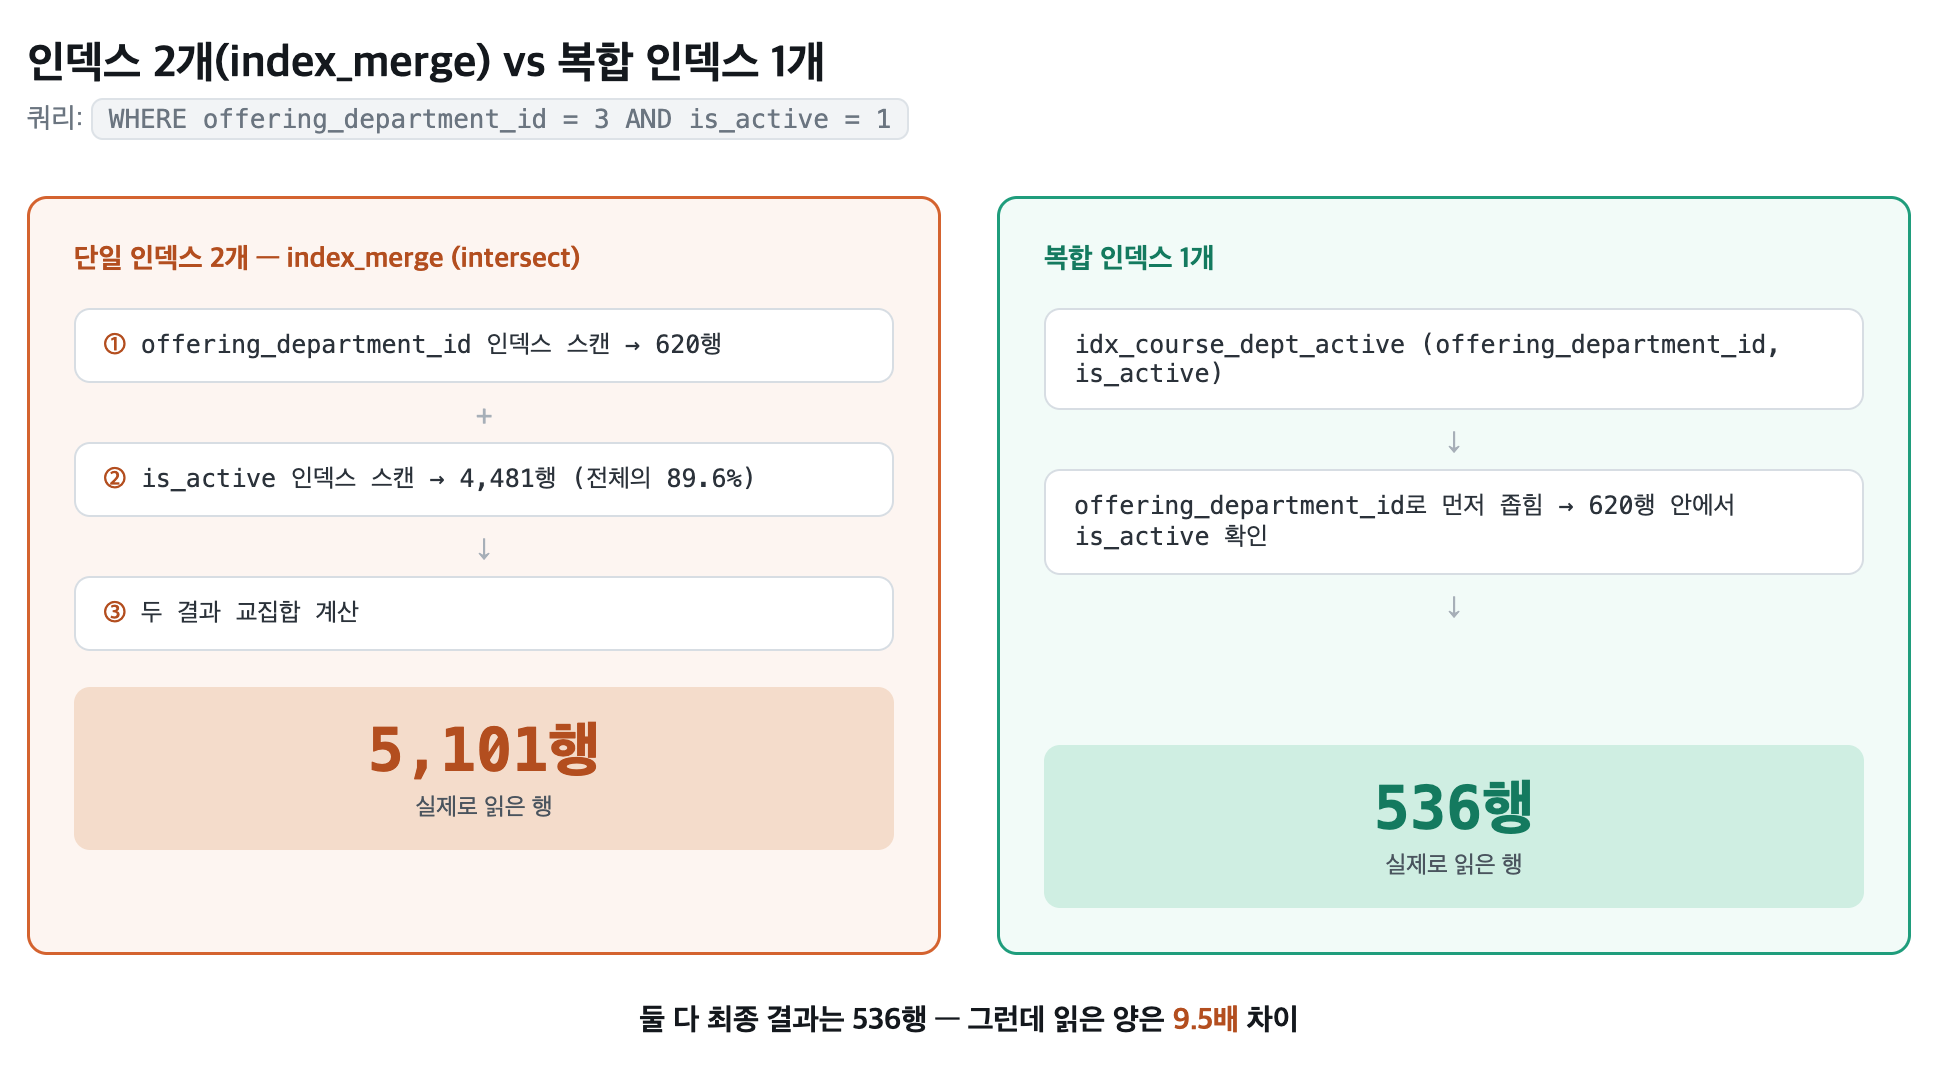
index_merge는 각 인덱스를 "그 컬럼 조건만으로" 따로 스캔한다. is_active 인덱스는 자기 조건에 맞는 행을 전부 찾아야 하는데, 값 하나(true)가 전체의 89.6% — 4,481행이다. 이 4,481개 포인터를 전부 모은 다음에야 offering_department_id 인덱스가 찾은 결과(620개)와 교집합을 낼 수 있다. 최종적으로 필요한 건 536행뿐인데, 그 전에 5,101개(4,481+620)를 각각 모으는 단계 자체가 이미 낭비다.
복합 인덱스는 이 낭비 자체가 없다. offering_department_id로 먼저 좁혀서 애초에 "이 학과의 620행"만 보게 되고, 그 안에서 is_active를 확인하는 건 그 범위 안에서 바로 끝난다. 인덱스를 몇 개 걸었느냐가 아니라, 쿼리가 실제로 컬럼을 조합하는 방식과 인덱스 구조가 맞느냐가 핵심이다.
8. 커버링 인덱스 — Using index
1부에서 세컨더리 인덱스는 보통 2단계(인덱스에서 찾기 → PK로 테이블 재조회)를 거친다고 했다. 그런데 쿼리가 필요한 컬럼이 전부 인덱스 안에 이미 들어있다면, 2단계를 건너뛸 수 있다. 이걸 커버링 인덱스(covering index) 라고 부르고, EXPLAIN의 Extra에 Using index로 나타난다.
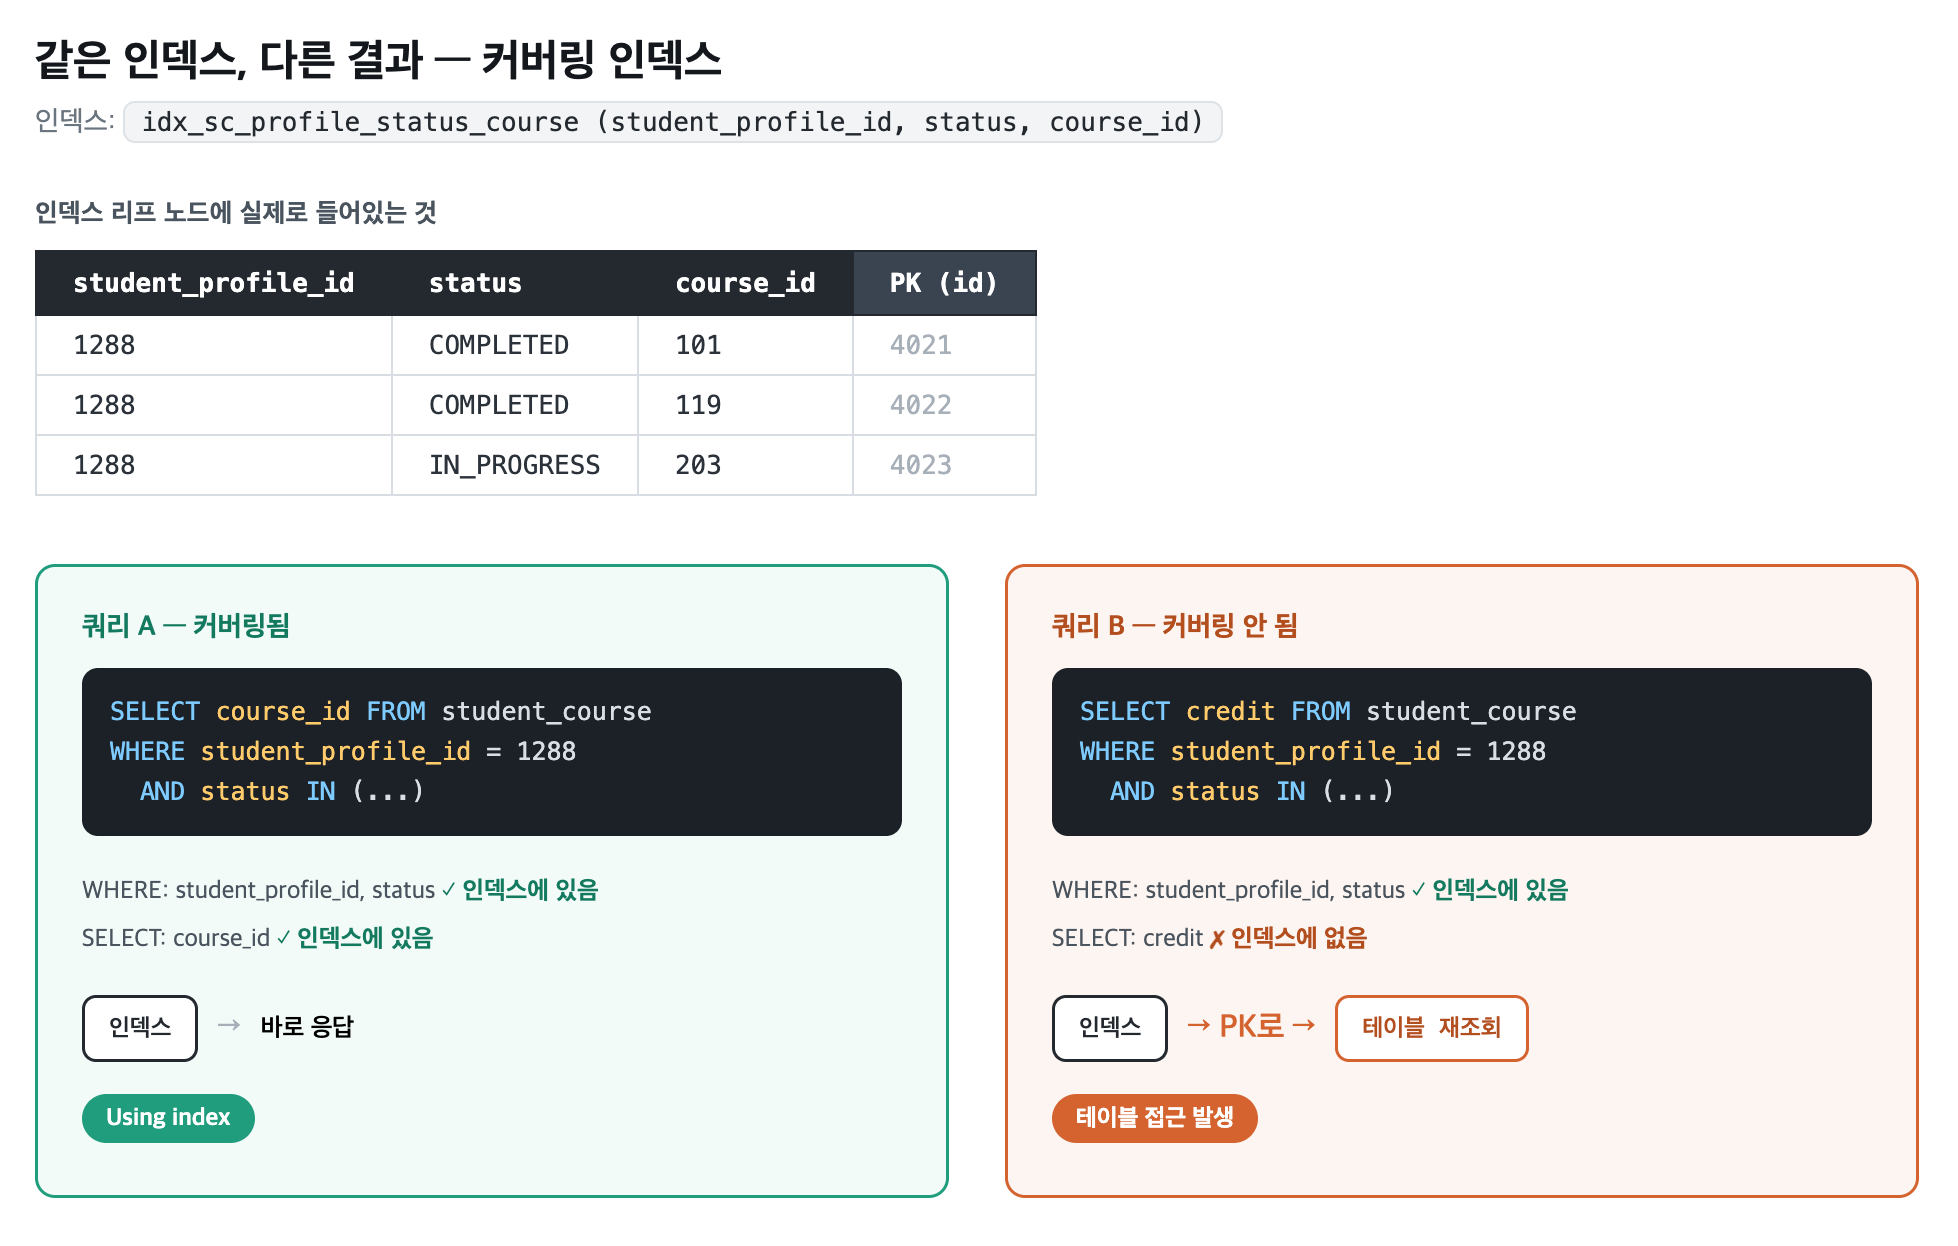
내 프로젝트의 예시. "학생이 이수완료/수강중인 과목의 course_id 목록"을 찾는 쿼리는 course_id 하나만 있으면 된다.
SELECT sc.course_id FROM student_course sc
WHERE sc.student_profile_id = ? AND sc.status IN ('COMPLETED', 'IN_PROGRESS');
여기 걸린 인덱스가 idx_sc_profile_status_course (student_profile_id, status, course_id)다. course_id를 일부러 세 번째 컬럼으로 같이 넣어뒀다 — 정렬 기준으로 안 쓰이더라도, 인덱스 리프 노드 안에 이미 들어있는 값이면 그냥 거기서 읽으면 되기 때문이다. 그 결과 이 쿼리는 테이블(클러스터드 인덱스) 접근을 아예 안 하고 인덱스만으로 끝난다.
실측 결과가 흥미롭다. 읽은 행 수는 인덱스 적용 전후로 80행 → 80행, 변화가 없다. 그런데 응답시간은 0.351ms → 0.108ms로 줄었다. 읽는 행 수는 똑같은데 왜 빨라졌을까 — 답은 "몇 번 읽었냐"가 아니라 "어디까지 갔다 왔냐"였다. 전에는 80행마다 클러스터드 인덱스까지 왕복(2단계)했는데, 커버링 인덱스로 바뀌면서 그 왕복 자체가 사라졌다. "읽은 행 수가 같다고 성능도 같은 게 아니다" — 1부에서 배운 2단계 조회 개념이 실제로 측정 가능한 차이를 만든 사례다.
9. 특수한 상황을 위한 인덱스 — Full-Text
1부 3번에서 LIKE '%키워드%'가 구조적으로 B-Tree를 못 탄다고 했다. 값 전체를 정렬해봤자 "어딘가에 포함된 것"은 정렬 순서로 못 찾기 때문이다. 그럼 부분 문자열 검색이 필요한 경우(과목 이름 검색처럼)엔 어떻게 해야 할까 — B-Tree가 아닌 다른 종류의 인덱스가 필요하다.
MySQL의 Full-Text 인덱스는 B-Tree와 발상 자체가 다르다. "행을 값 기준으로 정렬"하는 대신, "단어(토큰) 하나가 어느 행들에 나타나는지"를 거꾸로 매핑해둔다(그래서 역색인, inverted index). "디자인"이라는 단어를 찾으면, "디자인"이 등장하는 행 목록을 바로 얻는 식이다.
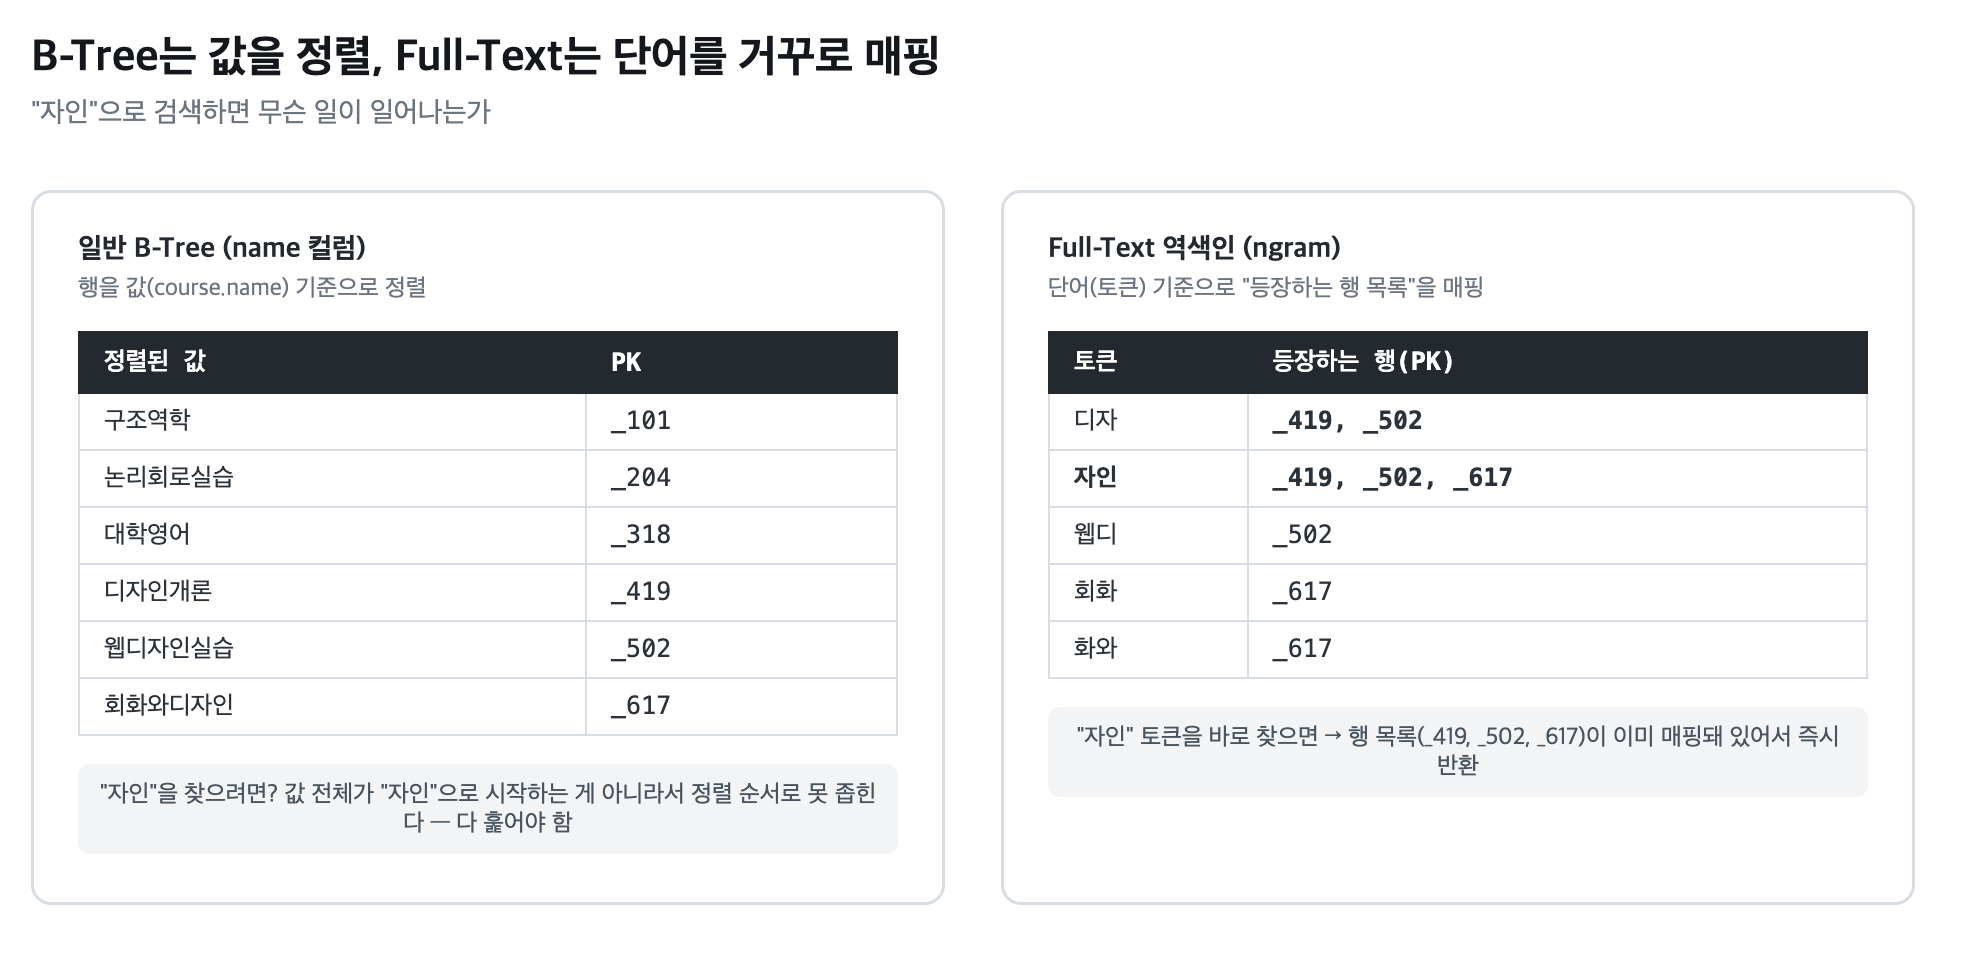
문제는 한국어가 영어처럼 띄어쓰기로 깔끔하게 단어가 안 나뉜다는 것. 그래서 ngram 파서를 쓴다 — 텍스트를 N글자씩 겹치게 잘라서 각 조각을 토큰으로 삼는다(기본값 N=2). "디자인"은 "디자", "자인" 두 토큰으로 쪼개져 색인된다. 그래서 "자인"(디자인의 뒷부분)으로 검색해도 "디자인"이 포함된 행을 정확히 찾아낸다 — 실제로 156건 전부 일치하는 걸 확인했다. 반대로 1글자 검색어는 토큰 자체가 안 만들어져서 원천적으로 검색이 안 된다 — ngram이 최소 2글자 단위이기 때문이다. (그래서 이 프로젝트의 검색 API는 2글자 미만 검색어를 아예 요청 단계에서 막는다.)
Full-Text 인덱스를 여러 컬럼에 걸어야 할 때(예: 과목명과 학수번호를 동시에 검색) 어떤 식으로 걸어야 하는지는 — 사실 B-Tree 복합 인덱스와는 또 다른 함정이 있다. 이건 3부에서 실제로 겪은 얘기로 풀어본다.
여기까지 정리하면:
- 복합 인덱스는 앞 컬럼 기준으로 정렬되고, 그 안에서 뒤 컬럼이 다시 정렬된다. 선택도 높은 컬럼을 앞에 둔다.
- 단일 인덱스 여러 개를
index_merge로 섞어 쓰는 것보다, 애초에 복합 인덱스 하나가 낫다 — 각 인덱스가 "자기 조건만으로" 먼저 넓게 훑기 때문이다. - 쿼리에 필요한 컬럼이 인덱스 안에 다 있으면 테이블 재조회 자체를 생략할 수 있다(커버링 인덱스). 읽은 행 수가 같아도 이것 때문에 빨라질 수 있다.
- B-Tree로 안 되는 것(부분 문자열 검색)은 아예 다른 구조(역색인, Full-Text)로 풀어야 한다.