가장 기본적인 이미지 분류기에 대한 수업이다.
K-nn과 linear classifier이다.
먼저 컴퓨터가 바라보는 이미지는 숫자로 이루어져 있다.
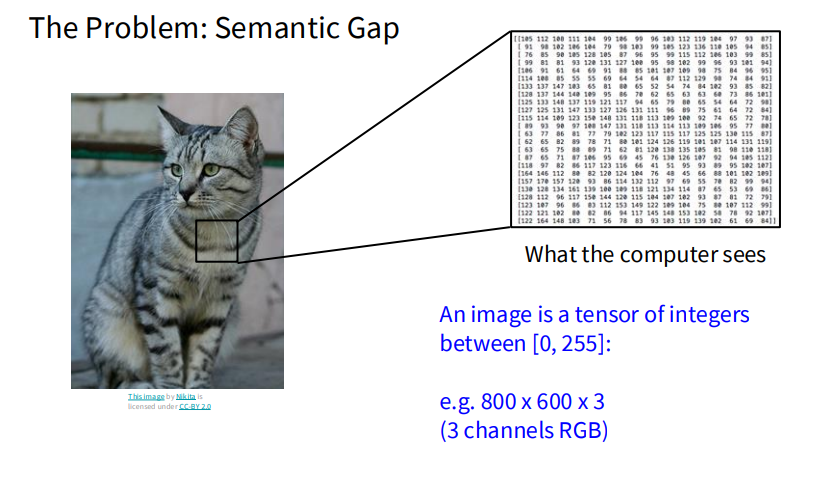
물체는 가만히 있지만 카메라가 움직이는 경우에 픽셀 값은 변하는 것을 알 수 있다.
이러한 상황에서 challenges로는 빛의 변화(illumination), rotation, occlusion 등이 있다.
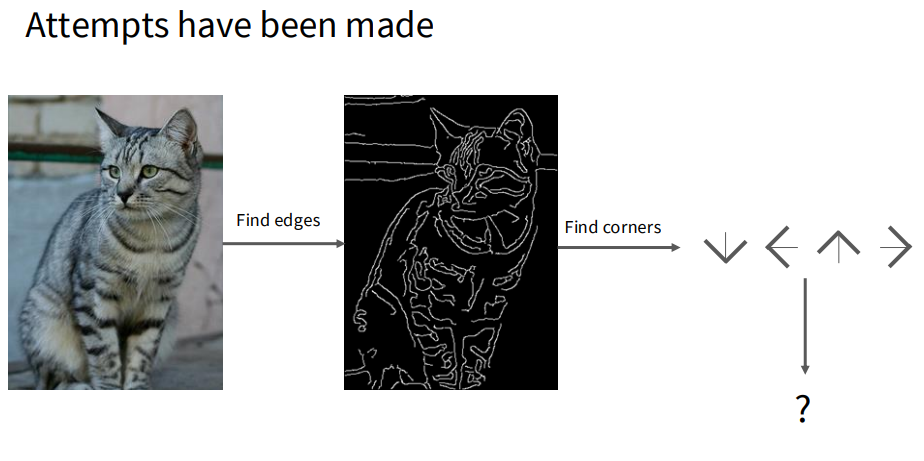
하드코딩해서 if-else, for문에 의한 rule-based 알고리즘으로는 edges를 이용해 corners 기반으로 이미지를 분류하는 방식이 있지만, 확장성이 너무 떨어지는 단점이 있다.
첫 번째 접근으로는 데이터 기반 접근이 있다.
데이터와 라벨을 모으고, ML algorithm으로 분류기를 학습시킨 후, 새 이미지로 평가를 하는 방식이다.
nn Classifier
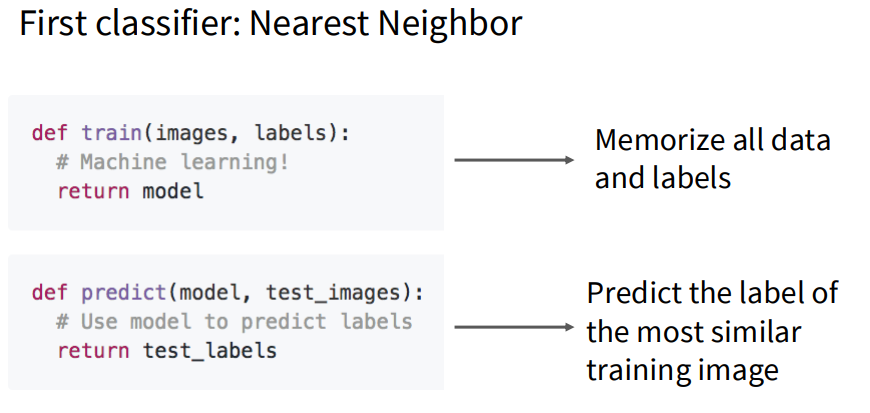
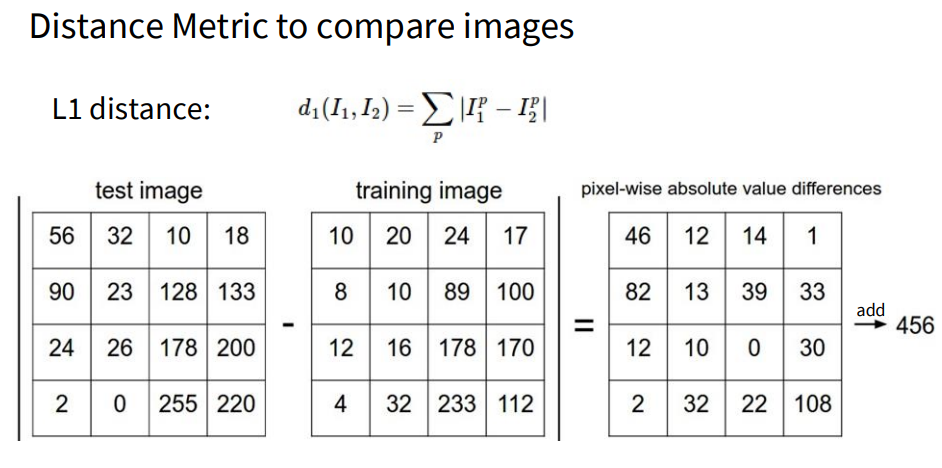
NN classifier의 구조이다. train 단계에서 데이터와 라벨을 모두 기억하고, predict 단계에서 train set에서 가장 유사한 것을 고르는 방식이다. 이미지는 숫자로 구성되어 있기 때문에 유사한 것을 알 수 있는 정도는 두 이미지의 픽셀 값 계산이다. 첫 번째 방식이 L1 방식이다.
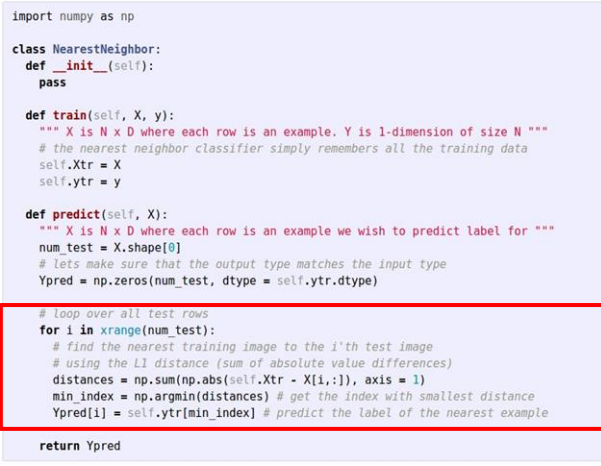
위 사진이 NN classifier의 코드이다. train 단계에서는 train set의 이미지를 전부 저장하고 predict 단계에서는 input 이미지와 train set의 모든 이미지의 거리를 계산한다. train 단계의 time complexity는 O(1)이고 predict 단계의 time complexity는 O(N)이다. 가장 이상적인 부분은 training 과정은 offline으로 진행하기 때문에 시간이 오래 걸려도 되지만, prediction 단계는 online으로 진행되기 때문에 시간을 줄이는 것이 이상적이다.
K-nn Classifier
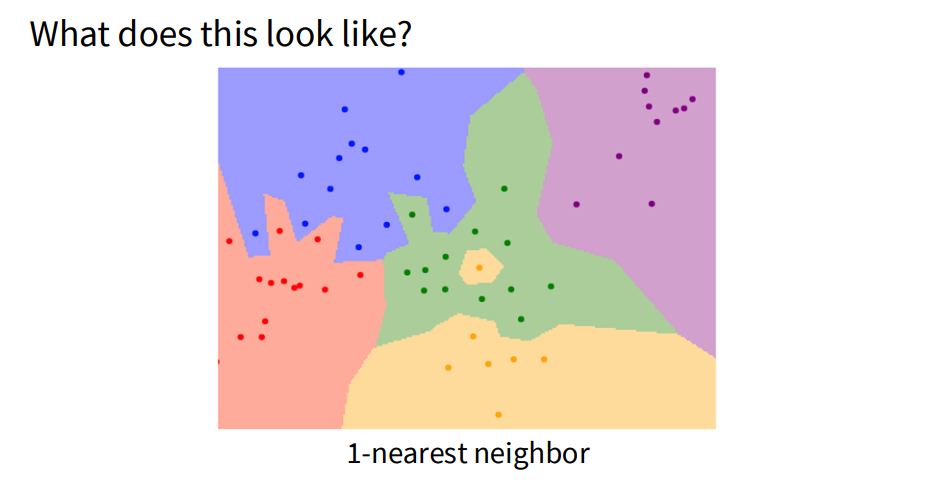
K = 1인 경우의 결과이다. 초록색 부분 한 가운데에 노란색이 있는데, 이 부분은 outlier일 가능성이 높다.
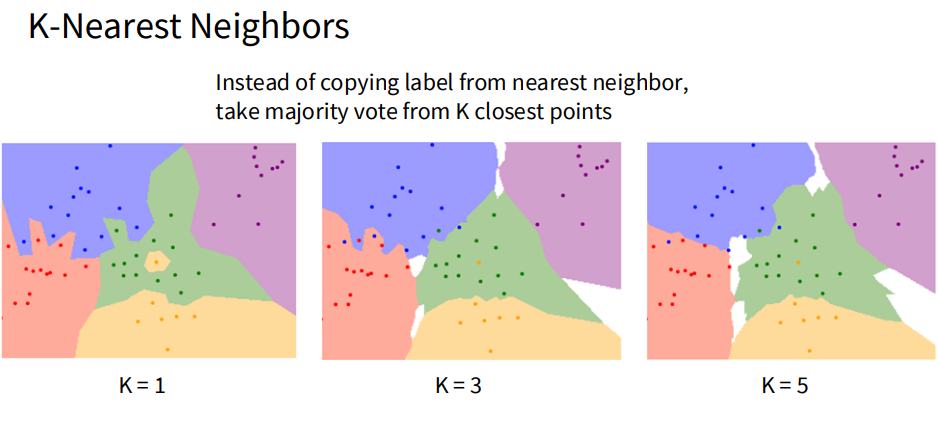
K의 값을 높일수록 엄격하게 판정이 되기 때문에 흰색 부분의 면적이 넓어지는 것을 볼 수 있다.
거리를 계산하는 방식으로는 L1, L2 2가지를 소개했다.
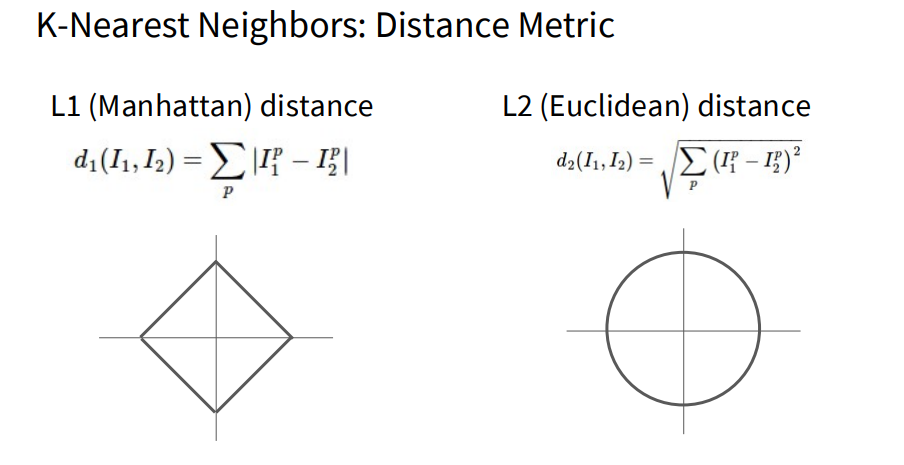
L1 같은 경우에는 원점에서의 거리가 일정하지 않기 때문에 특징을 보존할 수 있다. 즉 특징에 민감하는 것이다. L2의 경우에는 원점에서의 거리가 일정하기 때문에 특징을 보존할 수 없다. 경우에 따라 L1, L2를 잘 선택해야 한다.
k-nn의 경우에는 hyperparameter가 k, distance 거리이다.
모델에서는 결국에 최선의 결과를 내는 hyperparameter를 선택하는 것이 중요하다. 데이터의 수가 너무 많은 때에는 직관으로 initialization을 하는 경우도 있다.
Hyperparameter
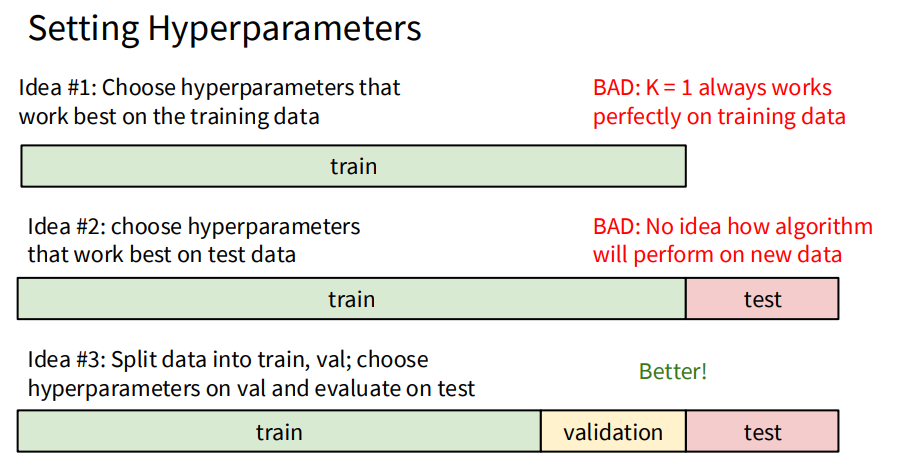
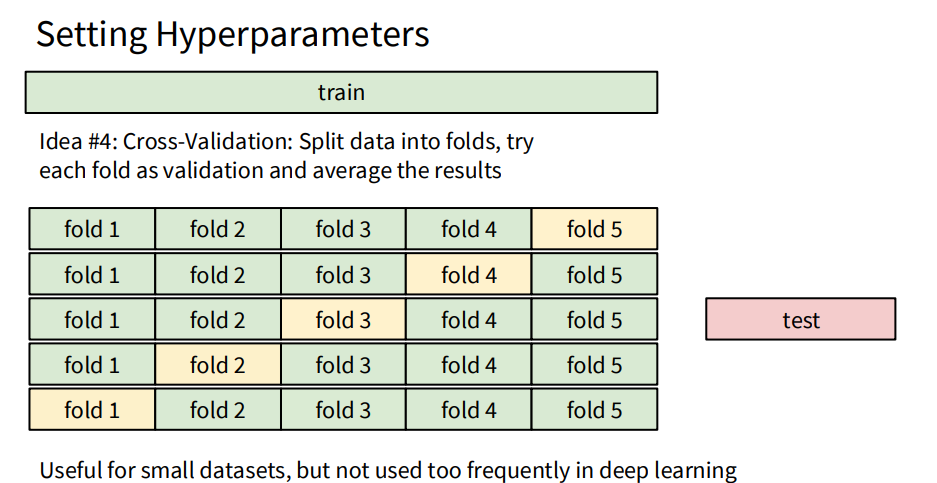
1번과 2번은 최악이다. 절대 하지 마라. 특히 2번은 치팅이기 때문에 안된다. 3번의 경우에는 validation으로 hyperparameter를 결정한다. 하지만 split된 data의 편향을 방지하기 위해 4번과 같이 하는 경우도 있지만, 요즘에 딥러닝 train data들을 보면 4번처럼 할 수 없는 경우가 대다수이다. (너무 방대하기 때문)
Pixel distance를 사용한 K-nn classifier는 성능이 좋지 않다. 이미지의 왜곡이 조금만 있어도 성능이 매우 나빠지기 때문이다.
Linear Classifier
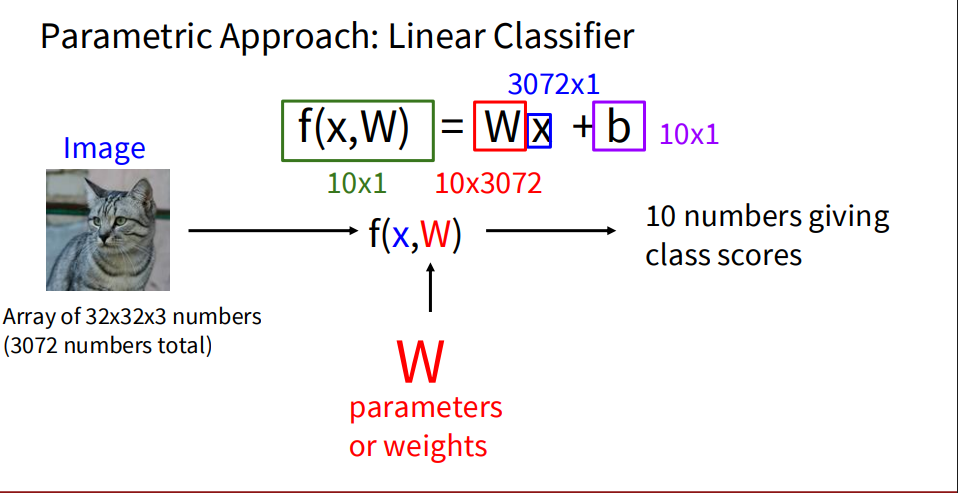
이게 끝이다. Weight와 bias로 class score를 계산하는 것이다. 이러한 것들을 여러 개 연결하면 Neural Network가 되는 것이다.
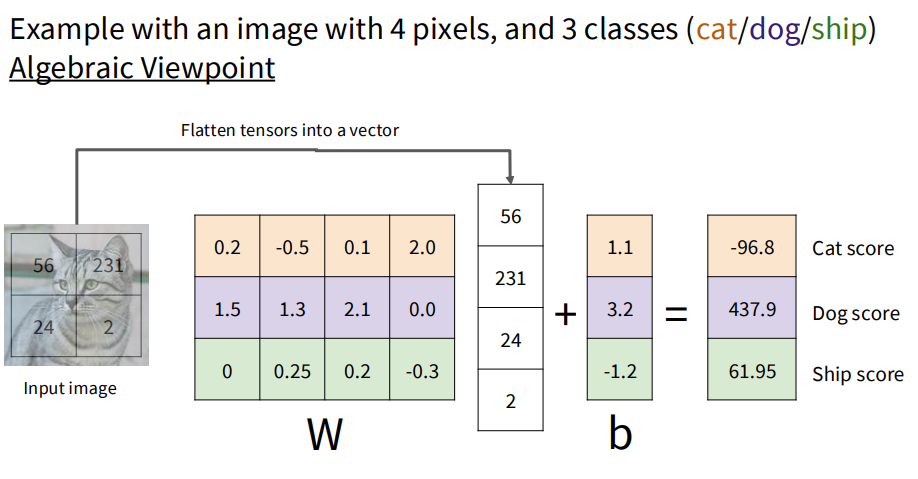
input image에 맞게 linear classifier한 예시이다.
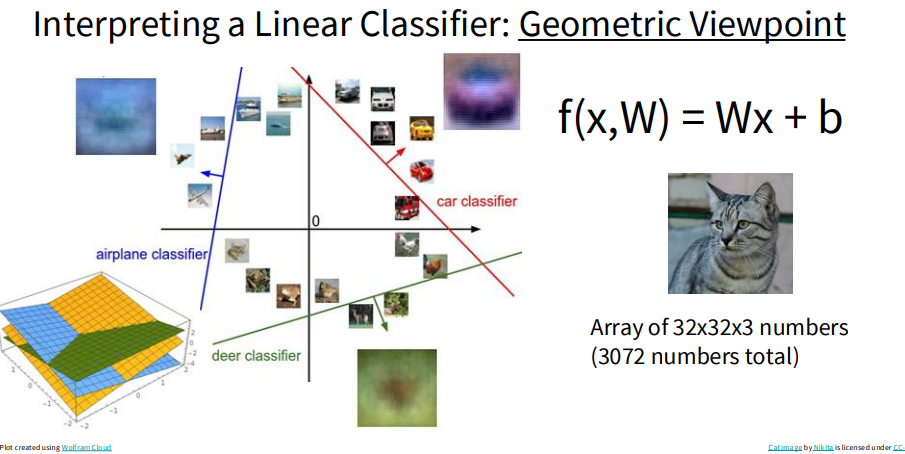
space 관점에서 보게 된다면 아래와 같게 된다. bias가 필요한 이유를 알 수 있다. bias가 없다면 모든 plane이 원점을 지나기 때문에 분류의 성능이 떨어진다.
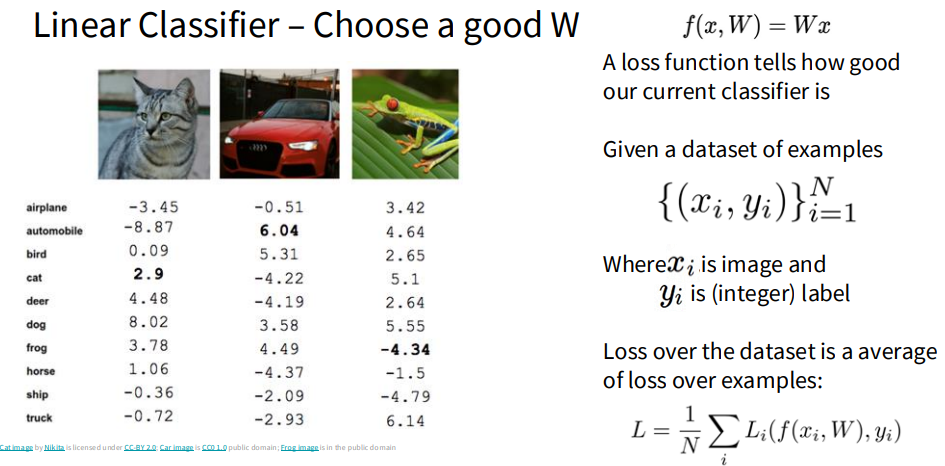
classifier의 성능을 높이기 위해서는 좋은 weight를 정해야 한다. 최적화를 하기 위해서는 Loss function(Objective function)도 있어야 한다.
Softmax classifier
대표적으로 softmax가 있다. 딥러닝을 공부한다면 무조건 알아야하는 부분이다.
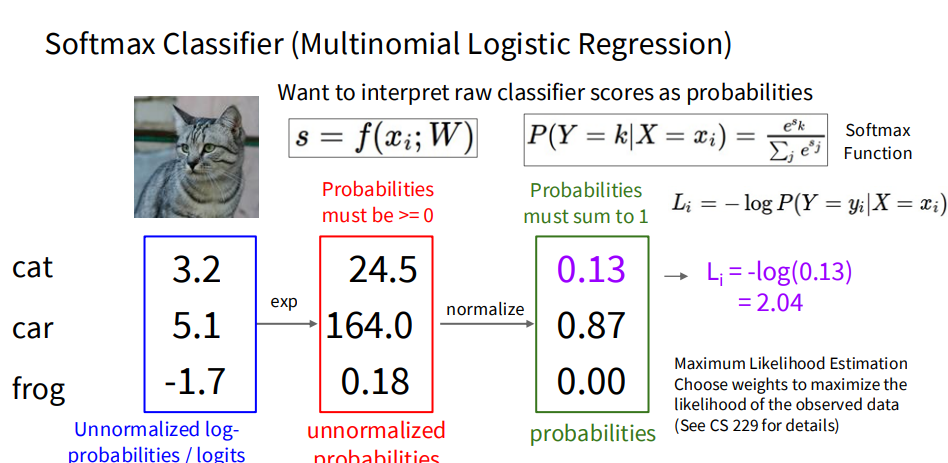
ML의 학습 목표는 MLE로, 우리가 관측한 데이터가 정답이 되는 최적의 W를 찾는 것이다.
Softmax 함수의 특징으로는 3가지가 있다.
- 모든 출력값이 0~1이고, 총합은 반드시 1이다.
- 값이 높을수록 높은 확률이 나오지만, 관계는 유지된다.
- 큰 값과 작은 값의 차이가 강조된다.
이후에 역전파에서 역으로 편미분하는 과정에서 자연상수가 큰 역할을 하게 된다. Attention is all you need도 softmax를 기반으로 만들었다.