3강은 2강에서 배운 loss function에 대한 내용입니다.
지난 시간 내용
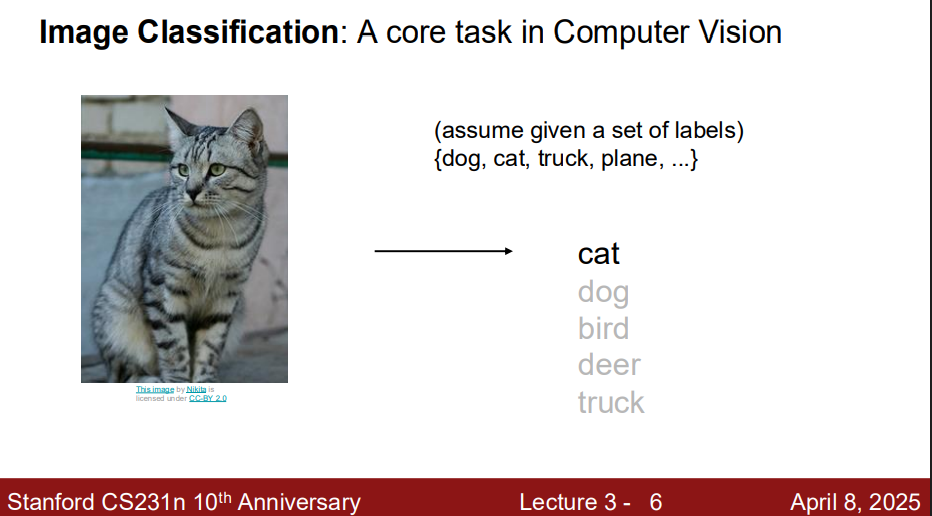
image classification에 대해 배웠습니다.
이미지를 다룰 때 여러 상황들(illumination, Occluasion, Deformation 등 여러 제약사항)에 대한 challenge가 있는 것을 배웠습니다.
이에 대한 방법으로 data-driven approach를 배웠고 가장 간단한 알고리즘은 kNN과 Linear Classifier에 대해 배웠습니다.
이후 train 과정에서 softmax로 0~1의 확률로 변환하고 총합을 무조건 1로 만드는 방식과 loss를 최소화하는 개념에 대해서도 배웠습니다.
Regularization
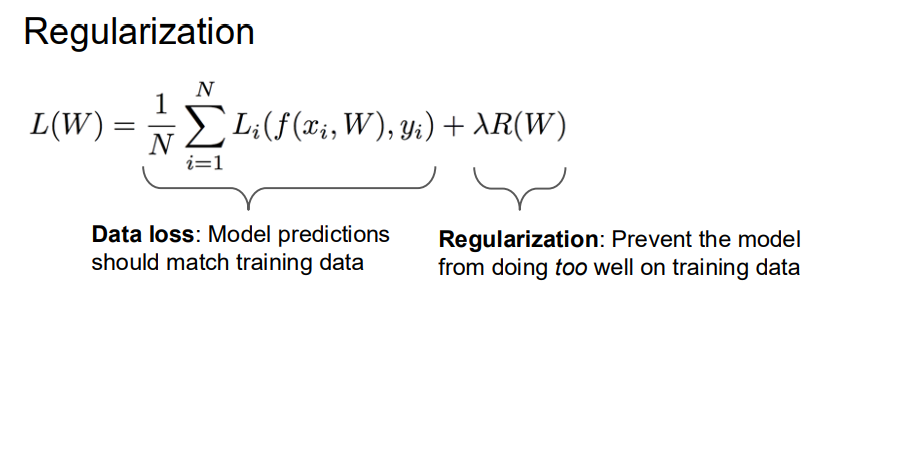
이번 시간에 배울 내용 중 하나인 정규화(regularization)입니다.
모델의 과적합을 막는 것이 목표입니다.
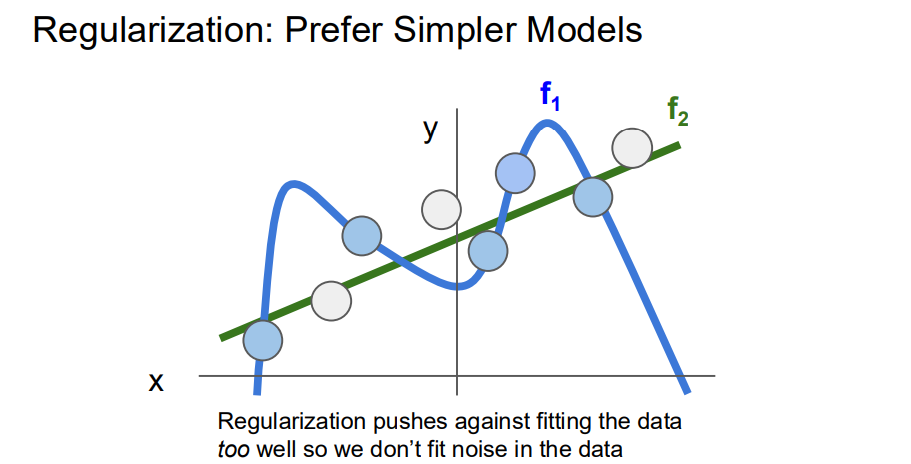
예시입니다.
f1과 f2 두 함수 중에 train dataset에 대해서는 f1이 더 fit하지만, 과적합하기 때문에 test set이나 unseen dataset에 대해서는 f2에 비해 loss가 클 확률이 큽니다. train 과정에서는 loss가 더 크더라도 목표는 test set, unseen dataset에 대해 잘 대응하는 것이기 때문에 과적합을 막는 것입니다. (단순한 데 더 잘 작동한다면 그것을 선택해야 하는 게 당연!!)
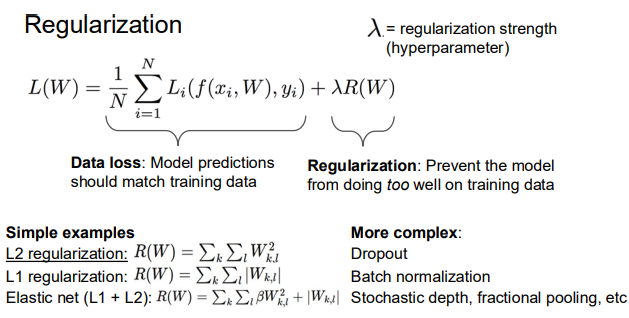
대표적으로 L1, L2 정규화 방법이 있다.
L2의 경우에는 제곱을 하기 때문에 W에 0.001같은 숫자의 경우에는 더 작아지기 때문에 regularization항에서 페널티를 조금밖에 줄 수 밖에 없습니다. weight decay라고도 합니다. L1의 경우에는 weight matrix가 sparse matrix인 경우에 많이 사용합니다. 는 정규화를 얼마나 강하게 할 지를 정하는 hyperparameter로, 실험적으로 정하는 경우가 많습니다.
L(w) 식은 Loss function으로 loss를 최소화하는 것이 이상적이기 때문인 것을 생각해야합니다.
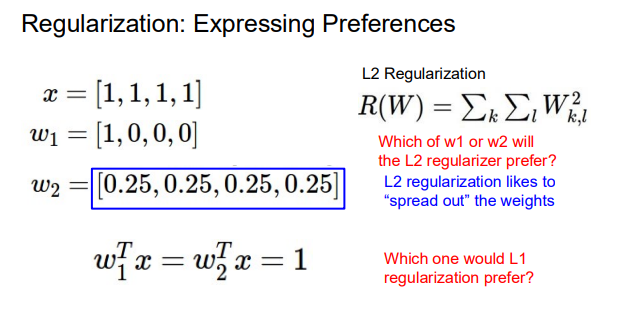
상황마다 어떤 정규화 방법을 선택해야 하는지 예시입니다.
w1, w2 모두 동일한 예측 결과인 1을 가지고 있습니다.
w2의 경우에는 같은 가중치를 갖고 있습니다. 정규화 항을 추가하더라고 loss function의 값을 최소화하는 것이 목표이므로 L2 정규화를 적용했을 때 w2는 0.25배가 되고 w1은 1이 되기 때문에 L2 정규화에는 w2가 더 적합합니다.
Optimization
최적의 w를 찾는 방법입니다. loss function(SVM, Softmax loss)과 score function(Linear function)이 있으니 이를 이용해 w를 찾습니다.
가장 쉽게 생각할 수 있는 방법은 random search입니다. 하지만 이 방식은 너무 비효율적이고 성능도 좋게 나오는 것은 아니기 때문에 (사실상 찍기) 다른 방법을 선택합니다.
Follow the scope
각 parameter별로 gradient를 계산해 음의 방향, 즉 값이 낮아지는 방향으로 이동하는 방법입니다. 컴퓨터에서는 실제 계산보다는 수치적으로(numerical) 계산하는 방식을 선택합니다. 이런 방식은 모든 parametr별로 numerical gradient를 계산하기 때문에 시간이 너무 오래 걸립니다. 따라서 analytic gradient 방식을 사용합니다.
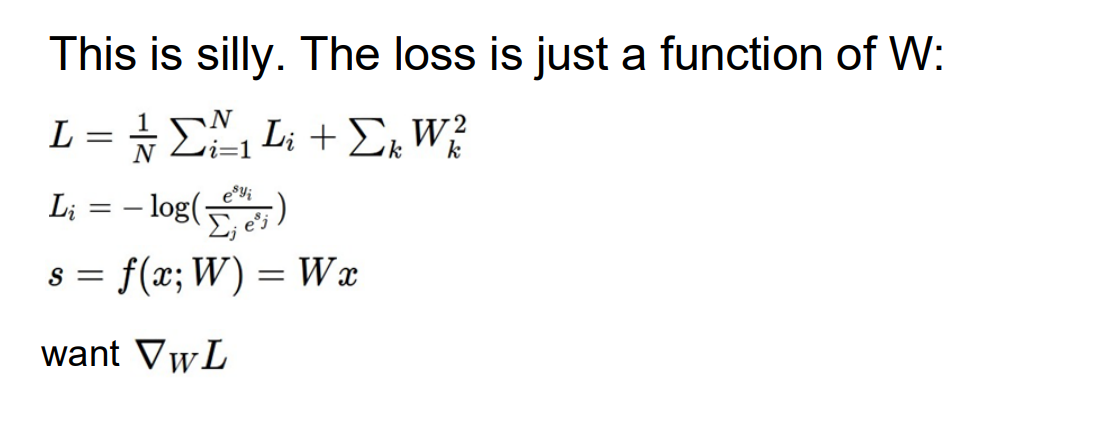
하지만 analytic gradient가 맞는지 체크하기 위해, numerical gradient로 확인하는 걸 추천합니다. (gradient check)
Gradient Descent
앞에서 말한 analytic gradient으로 하강하는 방식입니다.
Stochastic Gradient Descent (SGD)
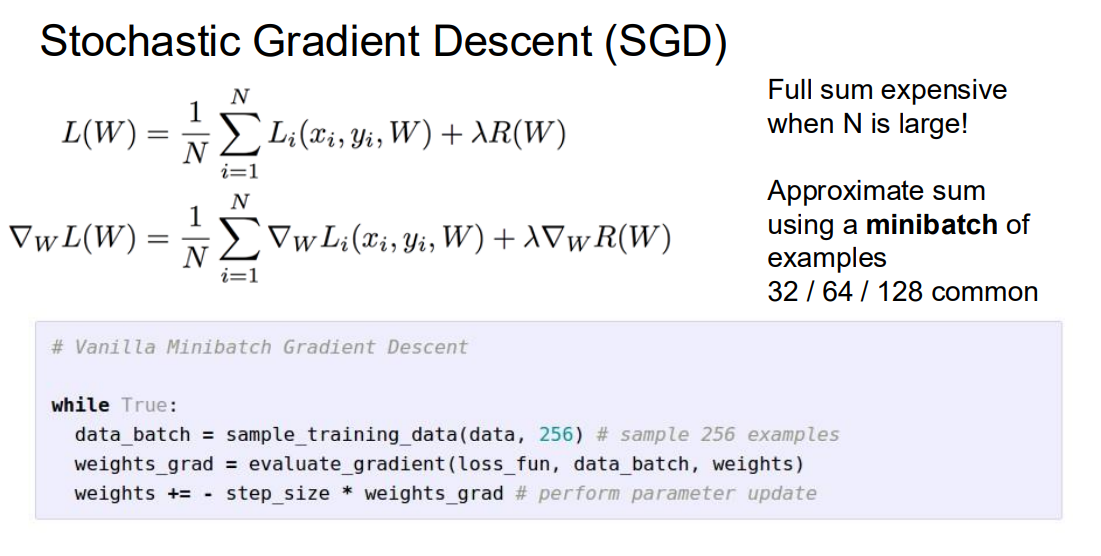
데이터의 수가 너무 많은 경우, GD를 실행하게 되면 시간이 너무 오래 걸린거나 OOM이 발생할 수 있기 때문에 minibatch로 데이터의 수를 샘플링해서 진행합니다.
여러 optimization 방법
SGD
step마다 learning rate 크기로 gradient 이동하는 방식으로, local minimum에 빠질 수 있는 단점이 있습니다.
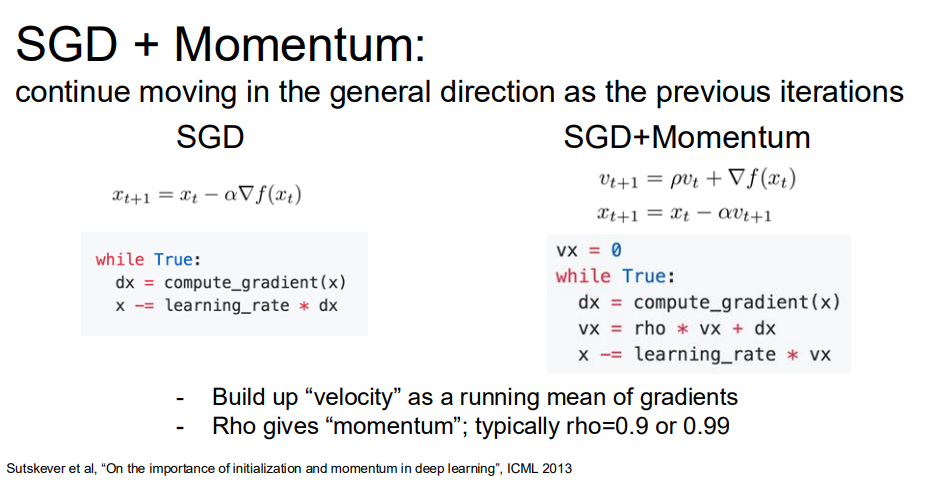
SGD + Momentum
local minima에 빠지는 것을 방지하기 위해 velocity라는 개념을 더해 이전에 이동하는 관성을 SGD에 더한것입니다.
RMSProp
Loss function의 변수마다 다른 learning rate를 적용하는 방법입니다. 앞의 SGD는 모든 변수에 동일한 learning rate를 적용하기 때문에, Hessian matrix를 계산하면 변수 개수만큼 matrix의 eigenvalue가 나오게 되고, 각 eigenvalue는 matrix의 방향과 변하는 정도를 나타냅니다. eigenvalue 값이 다르기 때문에 같은 learning rate를 적용하면 step별로 가는 크기도 다르기 때문에 진동하면서 가는 현상이 발생합니다. 변수마다 다른 learning rate를 적용하면 이런 진동현상을 방지할 수 있습니다.
Adam
가장 많이 사용되는 optimizer입니다.
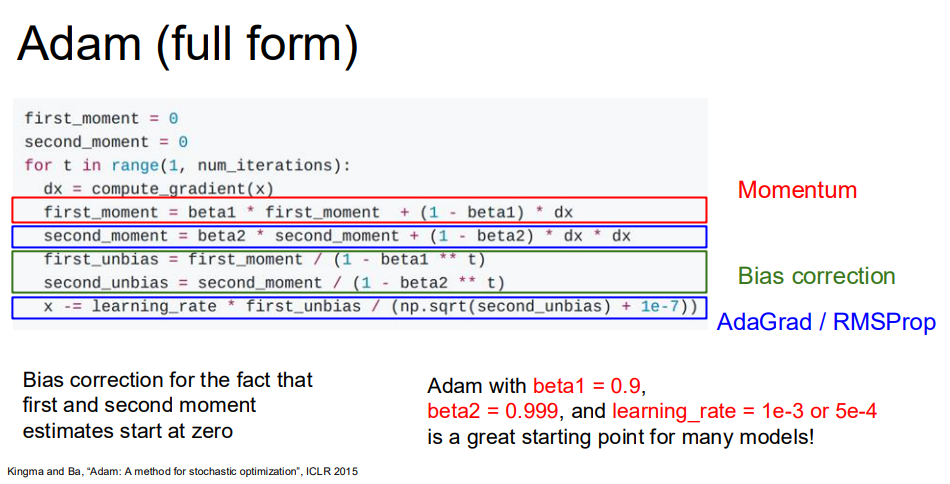
Momentum과 RMSProp을 합친 방법입니다.