📝 NEURAL MACHINE TRANSLATION BY JOINTLY LEARNING TO ALIGN AND TRANSLATE
Abstract
-
신경망 기계 번역(NMT)은 번역 성능을 극대화하기 위해 하나의 신경망을 공동 최적화하는 방식으로, 기존 인코더-디코더 모델은 고정된 길이의 벡터 사용으로 인해 성능에 제한이 생김
-
이를 해결하기 위해, 특정 단어를 예측할 때 원문에서 관련된 부분을 자동으로 탐색하는 메커니즘을 도입함
-
그 결과, 기존 구 기반 번역 시스템과 유사한 성능을 보였으며, 모델이 찾아낸 정렬이 인간의 직관과도 잘 맞는 것으로 나타남
1 Introduction
-
신경망 기계 번역(NMT)은 기존의 구 기반 번역과 달리 하나의 신경망을 학습하여 문장을 번역하는 방식
-
기존 인코더-디코더 모델은 원문을 고정된 길이의 벡터로 변환하는데,
긴 문장에서 성능이 저하되는 문제가 있음 -
이를 해결하기 위해 번역 중 중요한 부분을 자동으로 선택하는 정렬 기법을 도입한 새로운 모델을 제안함
-
제안된 모델은 긴 문장에서도 성능이 향상되었으며, 기존 구 기반 번역 시스템과 유사한 수준의 번역 품질을 달성함
2 BACKGROUND: NEURAL MACHINE TRANSLATION
2.1 RNN ENCODER–DECODER
Encoder-Decoder 프레임워크에서, 인코더는 입력 문장(벡터의 시퀀스 을 하나의 벡터 𝑐로 인코딩한다. 가장 일반적인 방법은 RNN을 사용하는 것이며, 이를 식으로 표현하면 다음과 같다.
여기서 는 시점 에서의 은닉 상태이고, 는 은닉 상태들의 시퀀스로부터 생성된 벡터이다.
디코더는 맥락 벡터 와 이전에 예측된 단어들 {}을 바탕으로, 다음 단어 를 예측하도록 학습된다. 즉, 디코더는 번역문 에 대한 확률을 다음과 같이 분해해 모델링한다.
여기서 이고, RNN을 사용하면 각 조건부 확률은 다음과 같이 표현할 수 있다.
는 에 대한 확률을 출력하는 비선형(다층) 함수이며, 는 RNN의 은닉 상태이다.
3 LEARNING TO ALIGN AND TRANSLATE
3.1 DECODER: GENERAL DESCRIPTION
-
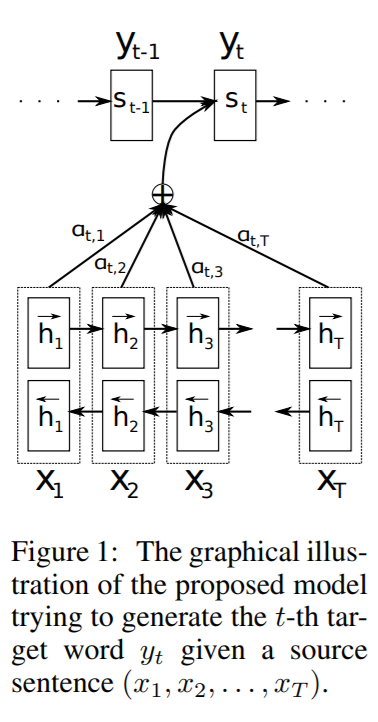
기존 인코더-디코더와 달리, 새 모델은 각 타겟 단어마다 고유한 맥락 벡터
를 적용함 -
맥락 벡터는 인코더가 만든 어노테이션 들의 가중합으로, 타겟 단어와 관련된 원문 위치를 자동 정렬함
-
정렬 모델 은 RNN 은닉 상태와 어노테이션을 비교해 가중치 를 결정함
-
이 방식을 통해 디코더가 주목해야 할 원문 부분에 집중할 수 있으며, 전체 정보를 한 벡터에 압축해야 하는 부담을 줄임
3.2 ENCODER: BIDIRECTIONAL RNN FOR ANNOTATING SEQUENCES

일반적인 RNN은 입력 시퀀스 를 처음 단어 부터 마지막 단어 까지 순서대로 읽는다. 그러나 제안된 방식에서는 각 단어에 대한 어노테이션이 앞쪽 단어뿐 아니라 뒤쪽 단어의 정보까지 요약하길 원한다. 따라서 양방향 RNN을 사용한다.
이렇게 하면, 어노테이션 는 해당 단어 앞뒤로 위치한 단어들의 요약을 모두 포함한다. RNN 특성상 최근 단어 정보가 더 잘 반영되므로, 는 주변 단어들에 더욱 집중된 표현이 된다.
4 EXPERIMENT SETTINGS
4.1 DATASET
-
WMT ’14의 영어-프랑스어 병렬 코퍼스를 데이터 선택 기법으로 3억4,800만 단어로 축소해 사용함
-
각 언어에서 상위 3만 개 단어를 뽑아, 나머지는 [UNK] 토큰으로 대체함
4.2 MODELS
-
RNN Encoder–Decoder(RNNencdec)와 RNNsearch 모델을 문장 길이 30/50 단어 제한 조건으로 각각 학습함
-
학습 완료 후, 빔 서치를 사용해 번역문을 생성함
5 RESULTS
-
RNNsearch는 RNNencdec보다 BLEU 점수가 더 높고, 특히 긴 문장에서 성능 저하가 적음
-
소프트 정렬(soft alignment)을 통해 어느 원문 단어에 주목해야 하는지 시각적으로 확인 가능함
-
긴 문장 예시에서도 RNNsearch가 원문의 전체 의미를 유지하며 정확히 번역하는 반면, RNNencdec는 일부 정보를 잘못 번역함
-
이는 RNNsearch가 특정 단어 주변 정보를 선택적으로 인코딩함으로써, 고정 길이 벡터 한계에서 벗어났기 때문
