데이터베이스의 캐싱 계층
자주 사용하는 데이터를 메모리 기반 저장소(In-Memory DB)에 저장해 두고 성능을 올리는 계층
데이터베이스 시스템을 구축할 때도 메인 데이터베이스 위에 redis 데이터 베이스 계층을
캐싱 계층으로 둬서 성능을 향상시키도 한다.
DB 를 직접 조회하는 대신, 캐시에 데이터가 있는지 확인하고 있으면 빠르게 응답하고, 없으면 DB에서 가져온 후 캐시에 저장하는 구조
[Flow]
[사용자 요청]
        ↓
[서버 or API]
        ↓
[🧠 캐싱 계층: Redis, Memcached 등] ← 자주 쓰는 데이터
     ↓       ↑ (캐시 미스 시)
[📦 실제 데이터베이스: MySQL, PostgreSQL, MongoDB 등]
Redis 동작 방식 (Cache 전략)
1. 읽기 전략 : Read-through
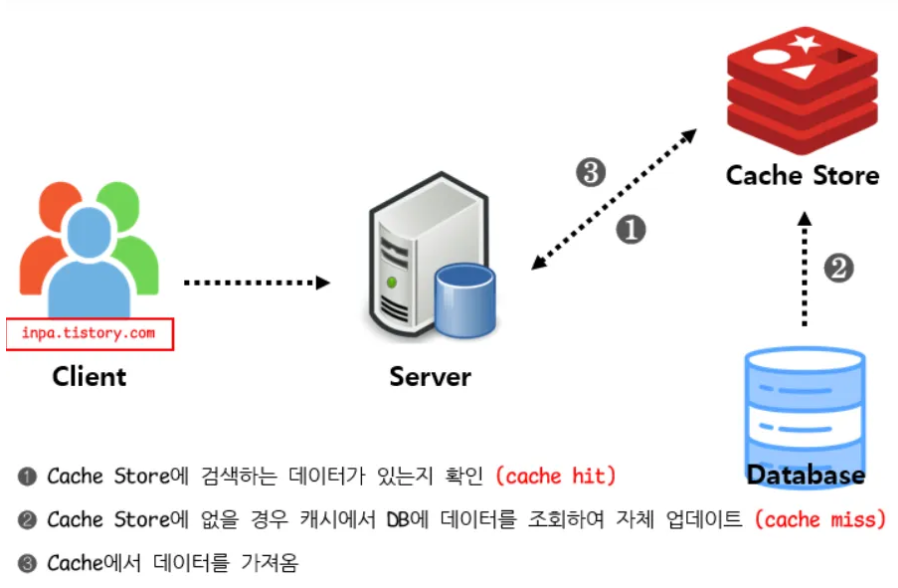
캐시에 데이터가 없으면 DB에서 가져오고 캐시에 저장 후 리턴
앱은 모든 데이터를 캐시로만 읽어온다.
- 만약 Cache Miss가 발생하면?
⇒ DB에서 해당 데이터를 캐시에 바로 저장
즉, 캐시는 앱과 DB 중간에 위치해 앱 → 캐시만 **바라보게 되고 DB → 캐시**만 바라보게 된다.
- 데이터 동기화를 라이브러리 또는 캐시 제공자에게 위임하는 방식
1. 사용자가 데이터 조회 요청

2. 캐시에서 key 조회 (hit 시 바로 응답)

3. miss 시:
→ DB에서 조회
→ 캐시에 저장
→ 응답 반환

✅ 예시: Spring Cache, Caffeine, EHCache, Redis + Spring Data Redis 등에서 `@Cacheable` 어노테이션을 붙이면 내부적으로 Read-Through 방식으로 작동합니다.
코드
@Cacheable(value = "userCache", key = "#id")
public User getUserById(Long id) {
    return userRepository.findById(id).orElse(null);  // RDB에서 가져옴
}
⇒ 실제로 Redis는 자체적으로 DB 에서 데이터를 가져오지 못함.
Java의 @Cacheable 같은 캐시 공급자 라이브러리-고수준 API는 마치 "Redis가 알아서 DB에서 가져오는 것처럼 보이게" 동작하기 때문
2. 읽기 전략 : Cache Aside = Look Aside (Lazy Loading)
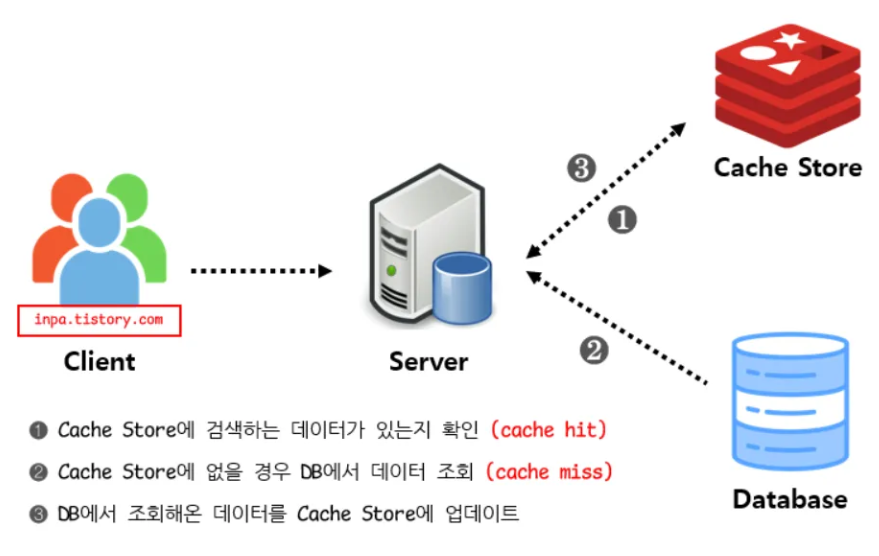
- 앱은 데이터를 찾을 때 캐시를 먼저 확인한다.
- 캐시에 데이터가 있으면?
⇒ 해당 데이터를 읽어오는 작업을 반복한다.- 만약 Redis에 해당 키가 존재하지 않는다면 (Cache miss)?
⇒ 앱은 DB에 접근해서 데이터를 직접 가지고 온 뒤 다시 Redis에 저장하는 과정을 거친다.
그래서 동일 데이터에 대한 후속 읽기 결과Cache Hit이 된다.
1. Read 요청 →
	1.1 캐시 Hit → 바로 응답
	1.2 캐시 Miss → DB에서 조회 → 캐시에 저장 → 응답

2. Write/Update 요청 →
	DB에 먼저 저장 → 캐시 삭제 (or 갱신)

| 캐시에는 이미 오래된 데이터가 있을 수 있으니 삭제하거나 갱신해줘야 한다는 뜻
코드
import redis
import time

# Redis 연결
r = redis.Redis(host='localhost', port=6379, decode_responses=True)

# 가상 DB
fake_db = {
    1: "홍길동",
    2: "이몽룡",
    3: "성춘향"
}

# Cache Aside 방식으로 사용자 조회
def get_user(user_id):
    key = f"user:{user_id}"

    # 1. 캐시 조회
    cached = r.get(key)
    if cached:
        print(f"✅ [CACHE HIT] {key} → {cached}")
        return cached

    # 2. 캐시 미스 → DB 조회
    print(f"❌ [CACHE MISS] {key} → DB 조회")
    data = fake_db.get(user_id)
    if data:
        r.setex(key, 60, data)  # 캐시에 저장 (TTL 60초)
        print(f"📦 캐시에 저장됨: {key} → {data}")
    return data

# 테스트
print(get_user(1))  # 캐시 미스 → DB 조회
print(get_user(1))  # 캐시 히트 → Redis 조회
3. 쓰기 전략 : Write-through
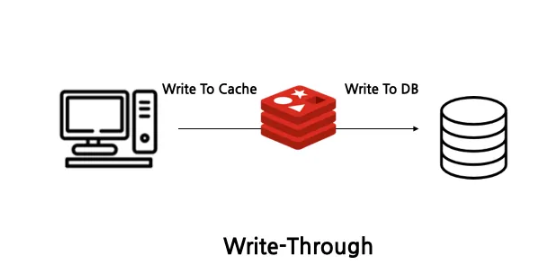
데이터를 저장할 때 캐시와 DB에 동시에 저장
클라이언트 → 저장 요청
└→ 캐시에 저장 (즉시)
└→ DB에도 저장 (즉시)
코드
import redis

# Redis 연결
r = redis.Redis(host='localhost', port=6379, decode_responses=True)

# 가상의 DB (딕셔너리로 시뮬레이션)
fake_db = {}

def save_user(user_id, user_data):
    key = f"user:{user_id}"

    # [1] 캐시에 먼저 저장
    r.set(key, user_data)
    print(f"✅ Redis에 저장: {key} → {user_data}")

    # [2] DB에도 즉시 저장
    fake_db[user_id] = user_data
    print(f"✅ DB에도 저장: {user_id} → {user_data}")

# 테스트 실행
save_user(1, "홍길동")
print("🔍 Redis:", r.get("user:1"))
print("🔍 DB:", fake_db[1])
4. 쓰기 전략 : Write-back
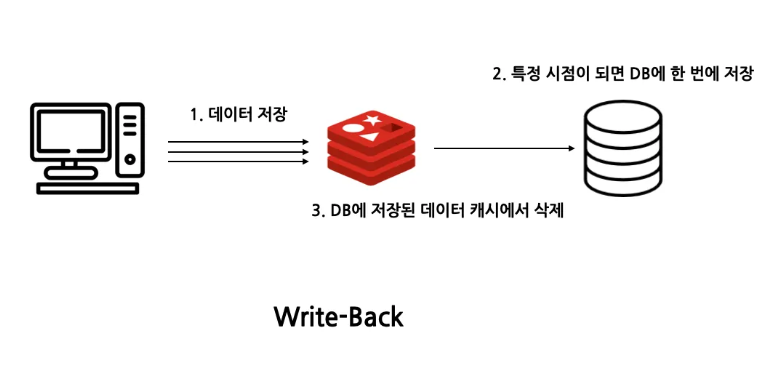
캐시에 먼저 저장하고, 나중에 DB에 반영
사용자 쓰기 요청
→ Redis에만 저장 (write-back queue 또는 TTL)
→ 일정 시간마다 또는 조건에 따라 ⇒ daemon thread
Redis → DB 로 동기화
코드
import redis
import threading
import time

# Redis 연결
r = redis.Redis(host='localhost', port=6379, decode_responses=True)

# 가상 DB (실제로는 MySQL, PostgreSQL 등을 대신함)
fake_db = {}

# ✅ 변경된 사용자 ID를 담아둘 Set (동기화 예약 리스트)
pending_sync = set()

# 🧠 캐시에 먼저 저장하고, DB 반영은 나중에 (Write-back)
def save_user_write_back(user_id, user_data):
    key = f"user:{user_id}"
    r.set(key, user_data)  # Redis에 저장
    pending_sync.add(user_id)  # 동기화 예약
    print(f"🧠 Redis에만 저장 + sync 예약 (user:{user_id} → {user_data})")

# 🔁 주기적으로 Redis → DB로 데이터 반영
def sync_to_db():
    while True:
        for user_id in list(pending_sync):  # 예약된 ID만 반복
            key = f"user:{user_id}"
            value = r.get(key)
            if value:
                fake_db[user_id] = value  # DB 저장
                pending_sync.remove(user_id)  # 예약 제거
                print(f"✅ [SYNC] DB에 저장됨: {user_id} → {value}")
        time.sleep(10)  # 10초마다 동기화 시도

# 🔧 동기화 스레드 시작 (백그라운드로 동작)
threading.Thread(target=sync_to_db, daemon=True).start()

# 🚀 테스트: 사용자 저장 (DB에는 아직 반영되지 않음)
save_user_write_back(1, "홍길동")
save_user_write_back(2, "이몽룡")

# 🕐 아래 코드를 테스트할 경우, 동기화 후 DB 상태 확인 가능
time.sleep(12)  # 10초 기다리면 동기화됨

print("\n📦 최종 DB 상태:")
for k, v in fake_db.items():
    print(f"{k} → {v}")
TTL
Redis에서 TTL-Time To Live (생존 시간)?
Redis에서 TTL은 특정 키가 만료되기까지의 시간(초 단위)이며, TTL이 끝나면 Redis는 자동으로 해당 키를 삭제합니다.
⏳ 자동 만료 자주 쓰이지 않는 데이터를 메모리에서 자동 제거 💾 메모리 절약 오래된 데이터를 자동 삭제하여 메모리 공간 확보 🔄 최신성 유지오래된 정보가 오래 남아있지 않게 하기 위함 📦 캐시 관리캐시로 사용 시 TTL은 핵심 전략 (짧게 or 상황별 조정)
WannaB.E/D.E