저자: Srivatsan Srinivasan, Venkat Krovi, Matthias J. Schmid
소속: School of Mechanical and Automotive Engineering, Clemson University, Greenville, SC 29607
게재 정보: IFAC PapersOnLine 59-30 (2025), 1072–1077, DOI: 10.1016/j.ifacol.2025.12.382
Abstract 요약
본 논문은 불확실성이 존재하는 자율주행 차량의 횡방향 궤적 추종을 위한 Model Reference Adaptive Control(MRAC) 프레임워크를 제시함. 기존 steer-by-wire용 MRAC를 전체 상태 궤적 추종 문제로 확장하고, 시스템 식별 없이 미지의 동역학과 외란을 직접 보상하는 제어식을 구성함. 비교 기준으로 표준 적응형 Model Predictive Control(MPC)을 사용하며, Closed Circuit과 Figure Eight 등 횡가속도가 0.3g를 넘는 고기동 조건에서 두 제어기를 고충실도 차량 모델로 평가함. 실험 결과 MRAC는 경쟁력 있는 추종 성능을 유지하면서 MPC 대비 계산 비용을 100배 이상 줄여 실시간 자율주행 제어에 대한 가능성을 보임.
이 글의 핵심 질문
타이어 코너링 강성과 횡방향 동역학을 정확히 식별하기 어려운 고기동 상황에서, 매 순간 복잡한 MPC 최적화와 파라미터 추정을 수행하지 않고도 기준 궤적을 안정적으로 추종할 수 있는지가 핵심 질문임. 논문은 기준 모델과 실제 차량의 오차를 이용해 제어 이득을 직접 갱신하는 MRAC로 답하고, EKF 기반 adaptive MPC와 정확도·계산시간을 비교함.
1. INTRODUCTION
- Model Reference Adaptive Control(MRAC)은 파라미터 불확실성과 외란이 존재하더라도 시스템이 사전에 정한 기준 모델의 거동을 추종하도록 제어 파라미터를 실시간으로 조정하는 적응제어 기법임.
- 최악 조건의 불확실성을 미리 감싸도록 설계하는 강건제어와 달리, MRAC는 운전 중 변하는 동역학에 맞춰 제어기를 갱신하므로 시변 특성이 큰 시스템에 적합함.
- 항공우주와 로봇 분야에서는 MRAC가 널리 활용되었으나, 고속 자율주행 차량의 횡방향 제어에 적용한 연구는 상대적으로 제한적이었음.
- 저자들의 선행 연구는 steer-by-wire 시스템의 요 안정화를 목표로 MRAC를 적용했으나, 고정된 기준 궤적에 대한 보상 제어에 한정되었다는 제약이 있었음.
- 본 연구는 이를 고횡방향 동역학과 구조화되지 않은 불확실성이 존재하는 자율주행 차량의 전체 상태 궤적 추종 문제로 확장함.
- 기존 MRAC 기반 경로 추종 연구는 command filter, parallel learning, state predictor 등을 활용했지만 상당한 오프라인 학습을 요구하는 경우가 있었음.
- MPC는 제약 처리 능력으로 궤적 추종에 널리 사용되지만, 계산량이 크고 모델 부정확성에 민감하다는 한계가 있음.
- 논문은 EKF로 차량 파라미터를 추정하는 표준 적응형 MPC를 비교 기준으로 사용하여, MRAC를 기존의 검증된 구조와 직접 비교함.
- CarSim 기반 고충실도 시뮬레이션에서 Closed Circuit(CC)과 Figure Eight(F8) 기동을 적용하며, 두 조건 모두 시스템을 빠른 동역학과 비선형 영역에 노출하도록 구성함.
- 제어기는 100Hz, 차량 플랜트와 시뮬레이션은 1000Hz로 실행함.
이해를 돕기 위한 설명
MPC가 매 제어 주기마다 미래 거동을 예측하고 최적화 문제를 다시 푸는 방식이라면, MRAC는 원하는 응답을 나타내는 기준 모델과 실제 차량의 오차를 관찰해 제어 이득을 직접 갱신하는 방식임. 따라서 복잡한 최적화 대신 행렬 연산과 적응법칙을 사용하여 계산 시간을 줄이는 구조임.
2. PRELIMINARIES
-
이 절은 MRAC 유도에 필요한 세 층을 준비함. 먼저 어떤 불확실성을 다룰지 구분하고, 다음으로 자율주행 궤적 추종 시스템에서 제어기가 받는 기준 신호를 정의하며, 마지막으로 실제 적응법칙이 적용될 횡방향 오차 모델을 구성함.
-
본 절은 제안 제어기를 구성하는 데 필요한 불확실성 표현, 자율주행 차량의 궤적 추종 구조, 횡방향 오차 동역학을 정리함.
Table 1. Nomenclature
| Symbol | Description | Unit |
|---|
| lf | 무게중심에서 전륜 차축까지의 거리 | m |
| lr | 무게중심에서 후륜 차축까지의 거리 | m |
| m | 차량 질량 | kg |
| Iz | z축 기준 관성모멘트 | kgm2 |
| Cαf,Cαr | 전·후륜 코너링 강성 | N/rad |
| δ,δ˙ | road-wheel 조향각과 조향각속도 | rad,rad/s |
| δc | road-wheel 조향각 명령 | rad |
| X,Y | 전역 좌표 | m |
| Xr,Yr | 기준 전역 좌표 | m |
| ψ,ψ˙ | yaw/orientation angle과 yaw rate | rad,rad/s |
| ψr | 기준 yaw/orientation angle | rad |
| β,β˙ | sideslip angle과 변화율 | rad,rad/s |
| vx,vy | body frame의 종·횡속도 | m/s |
| vr | body frame의 기준 속도 | m/s |
| κr | 기준 곡률 | m−1 |
| ax,ay | 관성좌표계의 종·횡가속도 | m/s2 |
| ac | 가속도 명령 | m/s2 |
| τs,τd,τb | 조향·구동·제동 토크 | Nm |
| g | 중력가속도 | m/s2 |
2.1 Uncertainty
- 일반적인 비선형 시스템의 affine 형태를 다음과 같이 정의함.
x˙=f(x)+g(x)u(1)
- 여기서 x는 상태 벡터, u는 입력 벡터이며, f(x)와 g(x)는 국소 Lipschitz 연속인 함수임.
- 현재 동작점 xˉ(t)에서 선형화하면 다음 식을 얻음.
x˙=∂x∂f(x)∣∣∣∣∣x=xˉ(t)x+∂x∂g(x)∣∣∣∣∣x=xˉ(t)u(2)
- 이를 일반적인 Linear Time-Varying(LTV) 시스템 x˙(t)=A(t)x(t)+B(t)u(t)으로 표현할 수 있음.
- 모델링 오차와 묶음 불확실성을 고려하면 다음과 같음.
x˙(t)=A(t)x(t)+B(t)u(t)+Δ(3)
- 여기서 Δ는 유계 불확실성 항임.
- Δ=ΘTΦ처럼 알려진 기저함수 Φ와 미지 파라미터 Θ의 선형결합으로 표현할 수 있으면 구조화된 불확실성으로 분류함.
- 시스템 파라미터 Θ(t)에 대한 의존성을 명시한 LPV 형태는 다음과 같음.
x˙(t)=A(Θ(t))x(t)+B(Θ(t))u(t)(4)
- 그러나 식 (3)의 Δ가 알려진 기저함수로 표현되지 않으면 구조화되지 않은 불확실성에 해당함.
- 차량 조향은 불확실성이 큰 문제이며, 기존 연구가 식 (4)의 구조화된 형태를 주로 사용한 것과 달리 본 연구는 식 (3)의 구조화되지 않은 불확실성을 대상으로 함.
이해를 돕기 위한 설명
구조화된 불확실성은 미지의 크기만 추정하면 되는 정해진 모양의 오차이며, 구조화되지 않은 불확실성은 타이어 비선형성·노면 변화·미모델링 동역학처럼 오차의 형태 자체를 정확히 특정하기 어려운 경우임. 본 논문의 MRAC는 후자의 영향을 오차 피드백 적응항으로 묶어 보상하려는 접근임.
2.2 Trajectory Tracking in Autonomous Vehicles
- 일반적인 자율주행 궤적 추종 구조는 예측·행동 계획·운동 계획을 통합해 기준 궤적을 생성하는 supervisory module, 상태 추정기, 차량 제어기, 액추에이터 제어기, 차량 플랜트로 구성됨.
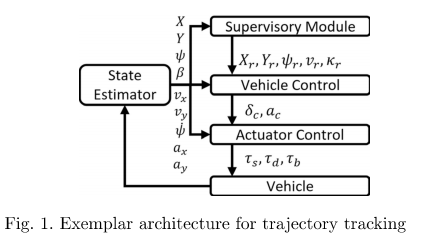
- 본 연구의 mock trajectory generator는 MATLAB Automated Driving Toolbox의
waypointTrajectory를 사용하여 5–10초의 look-ahead를 갖는 C2 연속 궤적을 재귀적으로 생성함.
- 생성 궤적은 10Hz로 이산화되며, 장애물 회피와 액추에이터 제어 자체는 연구 범위에서 제외함.
- 차량 제어 모듈은 기준 위치 (Xr,Yr), 기준 자세각 ψr, 기준 속도 vr, 기준 곡률 κr를 받아 조향각과 가속도 명령을 출력함.
- 종방향 속도 제어에는 속도 오차를 피드백하는 표준 PI 제어기를 사용함.
ac(t)=−kp(vx−vr)−ki∫0T(vx−vr)dt
- 여기서 ac는 가속도 명령, vx는 차량 종방향 속도, vr는 기준 속도, kp와 ki는 각각 비례·적분 이득임.
- 엔진과 제동 사이의 명령 배분은 CarSim의 액추에이터 제어 계층에서 수행함.
2.3 Lateral Dynamics
왜 전역 위치 대신 오차 상태를 사용하는가
제어 목표는 차량의 절대 좌표 자체가 아니라 기준 경로와의 차이를 줄이는 것이므로, 횡오차·자세각 오차와 그 변화율을 상태로 사용하면 목적함수와 안정성 분석을 직접 연결할 수 있음. 다만 선형화와 일정 종속도 가정 때문에 고기동에서는 모델 불일치가 커지며, 이것이 적응제어가 필요한 이유임.
- 횡방향 제어기는 bicycle model 기반의 횡방향 오차 동역학을 사용함.
- 직접 측정되지 않는 오차 상태는 실제 차량 상태와 기준 궤적을 이용해 다음과 같이 계산함.
eyeψe˙ye˙ψ=(Y−Yr)cosψ−(X−Xr)sinψ,=ψ−ψr,=vxsin(eψ)+vycos(eψ),=ψ˙−vrκr(5)
- 여기서 ey는 횡방향 위치 오차, eψ는 자세각 오차, (X,Y)와 (Xr,Yr)는 실제·기준 전역 좌표, vy는 횡속도, ψ˙는 요율임.
- 종방향 속도가 일정하고 조향각이 작다는 가정 아래 선형화를 수행하며, roll과 pitch는 무시함.
- 조향 액추에이터는 시정수 T2를 갖는 1차 지연으로 모델링함.
- 전체 상태 벡터를 e=[ey,e˙y,eψ,e˙ψ,δ]T로 두면 다음의 상태공간 모델을 얻음.
e˙(t)=Aee(t)+beδc(t)+deψ˙des(t)(6)
Ae=⎣⎢⎢⎢⎢⎢⎢⎡000001mvx−2Cαf−2Cαr0Izvx−2Cαflf+2Cαrlr00m2Cαf+2Cαr0Iz2Cαflf−2Cαrlr00mvx−2lfCαf+2lrCαr1Izvx−2Cαflf2−2Cαrlr200m2Cαf0Iz2lfCαf−T21⎦⎥⎥⎥⎥⎥⎥⎤
be=[0000T21]T,de=⎣⎢⎢⎢⎢⎢⎢⎡0mvx−2lfCαf+2lrCαr−vx0−Izvx2Cαflf2+2Cαrlr20⎦⎥⎥⎥⎥⎥⎥⎤
- 여기서 δc는 제어기가 계산하는 road-wheel 조향각 명령, Cαf와 Cαr는 전·후륜 코너링 강성, lf와 lr는 무게중심에서 전·후 차축까지의 거리, m은 차량 질량, Iz는 요 관성모멘트임.
- Ae는 vx에 따라 변하는 LPV 시스템 행렬이며, 급격한 기동에서는 코너링 강성도 빠르게 변해 모델 불일치를 유발함.
3. MODEL PREDICTIVE CONTROL
-
이 절의 MPC는 논문의 최종 제안이 아니라 비교 기준임. EKF가 코너링 강성을 추정하고, 갱신된 LPV 모델로 QP를 다시 구성하는 간접 적응 방식이므로 모델 파라미터 추정과 최적화 계산이 모두 필요함.
-
MPC는 제약조건을 직접 처리하고 예측구간에 걸쳐 제어입력을 최적화할 수 있으나, 높은 속도에서 비선형성이 커지면 선형 MPC의 성능이 저하될 수 있음.
-
본 연구는 OSQP solver를 사용하는 횡방향 MPC를 구현해 MRAC의 비교 기준으로 사용함.
-
식 (6)의 오차 동역학을 이용한 조절 문제는 다음의 quadratic program(QP)으로 표현함.
zminimizesubject tosubject tozTHz+eN+1TQeeN+1γ≤Γz≤ρ,γt≤ΓteN+1≤ρt(7)
- 여기서 z는 상태 e1,…,eN과 제어입력 δc1,…,δcN으로 구성된 최적화 변수, N은 예측구간임.
- H는 상태와 입력의 stage penalty를 나타내는 block diagonal 행렬, Qe는 terminal penalty 행렬임.
- Γ와 Γt는 등식·부등식 제약을 구성하며, γ,ρ,γt,ρt는 상태와 종단 제약의 하한·상한임.
- ψ˙des는 알려진 외란으로 취급하여 예측구간의 전체 시퀀스를 동역학 제약에 제공함.
- 횡방향 MPC의 LPV 모델은 다음과 같이 구성함.
e˙(t)=Ae(Φ(t))e(t)+beδc(t)+de(Φ(t))ψ˙des(t)(8)
- 여기서 Φ(t)=[vx(t),Cαf,Cαr]는 시변 파라미터 벡터임.
- vx는 측정 가능하지만 Cαf와 Cαr는 직접 측정할 수 없으므로 EKF로 추정함.
- EKF의 추정 상태와 측정 벡터는 각각 x^=[β,ψ˙,β˙,ψ¨,Cαf,Cαr]T와 ym=[ay,vy,ψ˙,δ]T임.
- Ae가 매 주기 갱신되므로 QP의 Γ와 Γt도 다시 구성해야 하며, KKT 조건 확인과 Hessian 정규화까지 필요해 계산 부담이 증가함.
이해를 돕기 위한 설명
본 논문의 MPC는 코너링 강성을 EKF로 추정한 뒤 해당 값을 예측모델에 다시 넣는 간접 적응 구조임. 반면 MRAC는 파라미터를 물리량으로 정확히 식별하기보다 기준 모델과 실제 시스템의 오차를 줄이도록 제어 이득을 직접 적응시키는 구조임.
4. MODEL REFERENCE ADAPTIVE CONTROL
MRAC 유도의 흐름
이상적인 기준 모델을 정하고 실제 플랜트와의 오차를 정의한 뒤, 상태·기준입력·오차에 곱해지는 적응이득을 제어입력으로 구성함. 이후 오차와 이득 추정오차를 함께 포함한 Lyapunov 함수를 선택하고, 시간 미분의 교차항이 상쇄되도록 적응법칙을 정함. 결과적으로 특정 파라미터를 정확히 식별하지 않아도 추종오차의 수렴과 신호 유계성을 보장하는 구조임.
- 높은 운전 속도에서는 부정확한 횡방향 모델 때문에 MPC 계산 시간이 순간적으로 증가할 수 있으므로, 논문은 횡방향 제어 문제를 직접 적응제어 문제로 재구성함.
- 식 (6)에 기반한 선형 기준 모델을 다음과 같이 정의함.
eˉ˙(t)=Aˉeeˉ(t)+bˉeδˉc(t)+dˉeψ˙des(t)(9)
- 여기서 위첨자 또는 overbar는 이상적인 기준 동역학과 기준 신호를 의미함.
- 실제 플랜트가 기준 모델과 다르다고 가정한 실제 동역학은 다음과 같음.
e˙(t)=Aee(t)+beδc(t)+deψ˙des(t)(10)
- 고차 비선형 항과 미지 동역학을 포함하는 구조화되지 않은 불확실성 Δ를 추가하면 최종 플랜트는 다음과 같음.
e˙(t)=Aee(t)+beδc(t)+deψ˙des(t)+Δ(11)
- 실제 상태와 기준 상태 사이의 모델 불일치 오차는 ε=eˉ−e로 정의함.
- 이상적인 조향입력이 존재해 t→∞에서 ε→0이 되는 model matching 가능성을 가정함.
- 보상 제어입력은 다음과 같이 상태 피드백, feedforward, 오차 피드백의 조합으로 구성함.
u=λδ−λeTe−λ^εTε(12)
- 여기서 λ^δ는 feedforward 적응이득, λ^e는 상태 피드백 적응이득, λ^ε는 묶음 불확실성을 보상하는 오차 피드백 적응이득임.
- 추정이득과 이상적인 참이득의 차이는 다음과 같이 정의함.
⎣⎢⎡ΔλeΔλδΔλε⎦⎥⎤=⎣⎢⎡λ^e−λeλ^δ−λδλ^ε−λε⎦⎥⎤(13)
- 이득 추정오차를 포함한 플랜트의 폐루프 동역학은 다음과 같음.
ε˙=(Aˉe−beλε)e+be(Δλδδˉc−Δλee−Δλεε)(14)
- 추정오차가 존재해도 폐루프 안정성을 보이기 위해 다음 Lyapunov 후보함수를 사용함.
V(ε,Δλe,Δλδ,Δλε)=εTPε+tr(ΔλeTΓe−1Δλe)+ΔλδΓδ−1Δλδ+tr(ΔλεTΓε−1Δλε)+tr(λεTΓε−1λε)(15)
- Γe, Γδ, Γε와 P는 대칭 양의 정부호 행렬이며, P는 다음 대수적 Lyapunov 방정식의 해임.
PAˉe+AˉeTP=−Q(16)
- 여기서 Q는 임의의 대칭 양의 정부호 행렬임.
- Lyapunov 후보함수의 시간 미분은 다음과 같이 정리됨.
V˙=−εTQε+2tr((Δλε+λε)T(−εεTPbe+Γe−1(Δλ˙ε+λ˙ε)))+2tr(ΔλeT(−eεTPbe+Γe−1Δλ˙e))+2tr(ΔλδT(δˉcεTPbe+Γδ−1Δλ˙δ))(17)
- V˙를 negative semidefinite로 만들어 V˙≤0을 보장하기 위한 적응법칙은 다음과 같음.
λ^˙eλ^˙δλ^˙ε=ΛeeεTPbˉe,=ΛδδˉcεTPbˉe,=−ΛεεεTPbˉe(18)
- 여기서 Λe, Λδ, Λε는 각각 상태 피드백, feedforward, 오차 피드백 적응이득의 조정 가능한 학습률임.
- 이 적응법칙을 적용하면 V˙=−εTQε≤0이 되어 추종오차의 점근적 수렴과 신호의 유계성을 보장함.
- MRAC의 기준 조향입력 δˉc는 차량 속도 vx, 기준 곡률 κr, 차량 파라미터의 feedforward 함수로 구성함.
δr=(lf+lr)κr+Kvvx2κr−K3(lrκr−2Cαr(lf+lr)lfmvx2κr)(19)
- K3는 상태 피드백 제어기의 yaw error gain이며, Kv는 다음 understeer gradient임.
Kv=2Cαfmf−2Cαrmr(20)
- 여기서 mf와 mr는 전·후 차축에 분배된 질량임.
- 식 (19)의 feedforward 조향은 불확실성과 초기 오차가 없을 때 deψ˙des의 영향을 상쇄하여 횡오차를 0으로 유지하도록 설계함.
- Aˉe가 vx에 의존하므로 최신 속도에 맞춰 Lyapunov 방정식을 반복해서 풀어야 함.
- 모든 vx에서 기준 시스템의 Hurwitz 안정성이 항상 보장되지 않으므로, 논문은 현재 상태 피드백 이득 λek를 포함한 다음 형태로 식 (16)을 정규화함.
(Aˉe−bˉeλekT)TP+P(Aˉe−bˉeλekT)=−Q
- bˉe는 측정 가능한 vx에 기반해 매 주기 갱신하는 straightforward한 과정임.
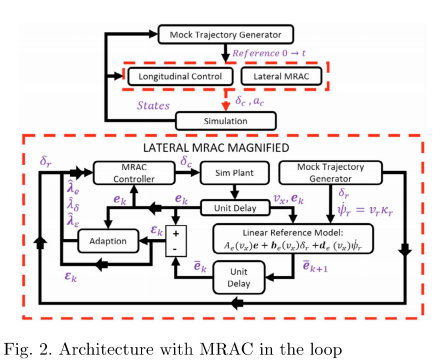
- 이 구조는 Lyapunov 안정성에 의해 양의 정부호 P,Q에 대해 점근적 추종과 유계성을 보장하며, 횡방향 MPC를 대체하는 전체 MRAC 구조는 Fig. 2와 같음.
이해를 돕기 위한 설명
Lyapunov 함수 V는 추종오차와 적응이득 추정오차를 합친 에너지 척도임. 적응법칙을 선택해 V˙의 교차항을 상쇄하면 남는 항이 −εTQε이 되므로, 시간이 지날수록 오차 에너지가 증가하지 않는다는 안정성 논리임.
5. IMPLEMENTATION AND RESULTS
실험이 답하려는 두 질문
첫째는 모델 불일치가 큰 고횡가속도 조건에서 MRAC가 adaptive MPC보다 작은 추종오차를 내는지이며, 둘째는 실시간 적용에 필요한 계산시간을 충분히 줄이는지임. CC와 F8은 곡률 변화의 강도가 달라 두 질문을 서로 다른 난이도에서 확인하는 시나리오임.
- 제어 성능은 제한된 트랙을 나타내는 Closed Circuit(CC)과, 공격적인 횡방향 동역학을 유도하는 Figure Eight(F8) 두 시나리오에서 평가함.
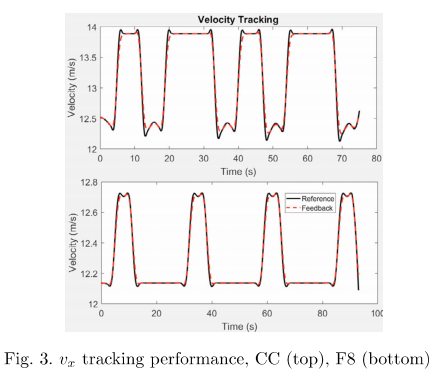
- CC는 45km/h, F8은 60km/h로 주행하며, 속도 기준은 실제 운전보다 공격적인 거동을 만들도록 설정함.
- 두 조건에서 횡가속도는 0.3g를 초과하므로 일반 도로보다 높은 동역학 영역을 시험함.
- 실제 환경에서 코너링 강성을 정확히 알기 어렵다는 상황을 재현하기 위해 Vorotović 등의 근사식으로 초기값을 정하고, 참 코너링 강성은 제어기에서 의도적으로 숨김.
- MPC의 EKF는 플랜트에서 측정한 요율만으로 보정하므로, 측정하기 어려운 sideslip과 코너링 강성을 추정해야 하는 현실적 조건을 반영함.
- 종방향 속도 추종 결과는 감쇠된 응답으로 기준 속도를 안정적으로 추종하며, 이는 횡방향 제어 비교에서 일관된 주행 조건을 제공함.
- MPC와 MRAC 모두 CC와 F8의 기준 경로와 자세각을 추종하지만, Fig. 4만으로는 성능 차이를 명확히 판단하기 어려워 Fig. 6과 Table 2에서 오차를 정량 비교함.
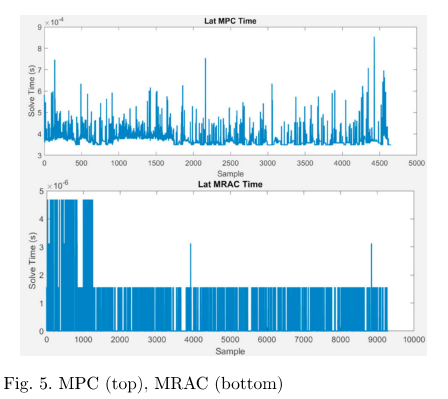
- MRAC의 계산 시간에는 모델 불일치 계산, 적응이득 전파, Lyapunov 방정식 해 계산, 최종 입력 계산이 모두 포함됨.
- 그럼에도 MRAC는 MPC보다 100배 이상 빠른 계산 시간을 보이며, 안전 필수 실시간 시스템에서 중요한 처리 여유를 확보함.
- 초기 적응이득이 최적이 아니면 과도구간 진동이 나타날 수 있으나, MRAC는 오차가 발생하면서 빠르게 적응하고 안정화함.
- 수렴한 이득을 다음 실행의 초기값으로 사용하면 반복되는 과도응답을 줄일 수 있음.
- MPC에서도 H와 Qe의 부적절한 조정이 수렴을 저해하므로, 두 제어기 모두 충분한 시뮬레이션과 튜닝이 필요함.
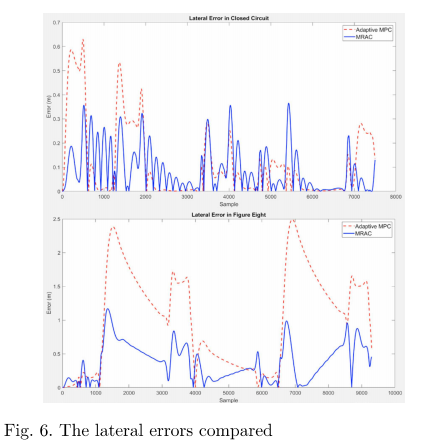
- 횡오차 비교에서 MRAC는 CC와 F8 모두 adaptive MPC보다 낮은 평균·최대 오차를 보임.
- CC 조건에서 사전 이득값을 주입하지 않아도 적응이득이 최종값으로 수렴하며, 수렴 이후 다양한 시나리오에서 일관된 성능을 보임.
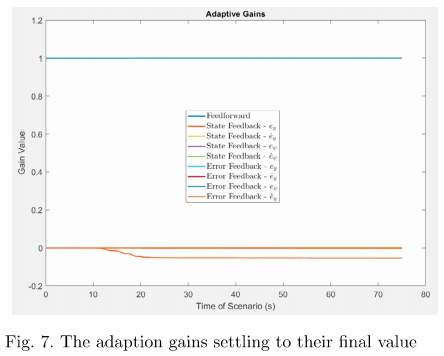
Table 2. Results of all the controllers
| Type | Scenario | Avg lateral error | Peak lateral error | Improvement |
|---|
| MPC w/o EKF | CC | 0.17m | 0.4m | N/A |
| MPC w/o EKF | F8 | 0.81m | 1.5m | N/A |
| MPC w/ EKF | CC | 0.14m | 0.3m | 34% |
| MPC w/ EKF | F8 | 0.79m | 1.5m | 2% |
| MRAC | CC | 0.11m | 0.3m | 50% |
| MRAC | F8 | 0.40m | 1.0m | 71% |
- CC에서 MRAC의 평균 횡오차는 0.11m로 EKF 없는 MPC 대비 50% 개선되며, F8에서는 0.40m로 71% 개선됨.
- EKF를 적용한 MPC는 CC에서 34% 개선되지만 F8에서는 2% 개선에 그쳐, 빠른 비선형 기동에서 파라미터 추정 기반 보상의 한계가 나타남.
- MRAC는 F8의 최대 횡오차도 1.0m로 낮춰 adaptive MPC의 1.5m보다 작은 오차를 기록함.
이해를 돕기 위한 설명
F8은 곡률 방향이 반복해서 바뀌므로 타이어 횡력과 요 동역학의 변화가 크며, 모델 파라미터 추정이 늦으면 오차가 누적되기 쉬운 조건임. 이 조건에서 MRAC의 개선 폭이 더 큰 결과는 기준 모델 오차를 직접 이용하는 적응 구조의 장점이 크게 나타난 경우임.
결과 해석의 범위
보고된 100배 이상의 계산시간 감소와 오차 개선은 논문이 사용한 CarSim 모델, 두 트랙, 주어진 튜닝 조건에서 얻은 결과임. 외란·센서 잡음·불충분한 excitation과 실제 차량에서의 성능은 후속 검증 대상이므로, 실차 전반에 대한 우월성으로 확대 해석할 수 없음.
6. CONCLUSION
- 본 연구는 기존의 요 안정화 보조용 MRAC를 곡률 기준을 조향 명령으로 변환하는 전체 궤적 추종 제어기로 확장함.
- MRAC는 adaptive MPC보다 높은 추종 정확도를 달성하면서 계산량을 100배 이상 줄여 실시간 시스템에 적합한 결과를 보임.
- 고충실도 CarSim 시뮬레이션을 통해 모델 불일치와 동역학 변화에 대한 강건성을 확인함.
- 향후 연구는 외란, 센서 잡음, 충분한 excitation이 없는 궤적에서의 성능을 검토하고, CarSim RT 기반 Hardware-in-the-Loop 시험으로 실시간 적용 가능성을 평가하는 방향임.
핵심 정리
본 논문의 기여는 코너링 강성을 매 순간 정확히 식별해 복잡한 최적화 문제를 푸는 대신, 기준 모델과 실제 차량 사이의 오차를 이용해 제어이득을 직접 적응시키는 횡방향 MRAC 설계임. Lyapunov 기반 안정성 보장, 공격적인 기동에서의 오차 감소, MPC 대비 100배 이상의 계산시간 절감이 핵심 결과임.