1. 인공지능 기반 영상처리의 중요성
영상 데이터는 자율주행, 의료, 보안 등 다양한 분야에서 핵심 정보를 담고 있다. 기존의 영상처리 방식은 사람이 설계한 특징과 규칙 기반으로 작동했으나, 복잡한 실제 환경에서는 한계가 뚜렷했다.
딥러닝 기반 인공지능 기술은 이러한 한계를 극복하며, 영상에서 유의미한 정보를 자동으로 학습하고 추론할 수 있게 해준다. 특히, 2012년 ILSVRC 대회에서 딥러닝 모델이 기존 방식보다 월등한 성능을 보인 이후, 인공지능은 영상처리 분야의 핵심 기술로 자리잡았다.
이제는 분류(Classification), 검출(Detection), 분할(Segmentation) 등 다양한 영역에서 인간 이상의 정확도를 달성하고 있으며, 실시간 처리와 실용화를 위한 연구도 활발히 진행 중이다.
2. Task
가. 분류(Classification)
분류(Classification)는 입력된 이미지를 하나의 정해진 클래스(카테고리)로 구분하는 작업이다. 예를 들어, ‘개’와 ‘고양이’를 분류하거나, 의료 영상에서 ‘정상’과 ‘이상’을 판별하는 등의 문제가 이에 해당한다.
-
이진 분류(Binary Classification): 두 개의 클래스 중 하나 선택 (예: 정상/비정상)
-
다중 클래스 분류(Multi-class Classification): 세 개 이상의 클래스 중 하나 선택 (예: 고양이/개/말)
분류 작업은 주로 CNN(Convolutional Neural Network) 기반 모델에서 마지막 출력층의 Softmax 함수를 통해 각 클래스에 대한 확률 값을 도출하여 수행된다.
나. 위치 추정 및 객체 검출(Localization & Object Detection)
이 작업의 핵심은 영상 속에 어떤 객체가 어디에 있는지를 정확히 파악하는 것이다. 단순히 객체가 존재하는지만 판단하는 것이 아니라, 객체의 위치까지 함께 예측하는 것이 중요하다.
-
위치 추정 (Localization): 이미지에 단 하나의 주요 객체가 있다고 가정하고, 해당 객체를 감싸는 바운딩 박스(Bounding Box)의 좌표 예측
-
객체 검출 (Object Detection): 여러 객체가 존재하는 상황에서, 각각의 클래스와 위치를 동시에 식별하는 작업
객체 검출은 분류(Classification)와 위치 추정(Localization)을 결합한 형태로, 기술적으로 더 복잡하지만 실제 응용에서 매우 널리 사용된다. 대표적인 알고리즘으로는 YOLO(You Only Look Once), SSD(Single Shot MultiBox Detector), Faster R-CNN 등이 있으며, 이들은 정확도와 처리 속도 간의 균형을 고려하여 설계되었다.
다. 분할(Segmentation)
분할(Segmentation)은 이미지를 픽셀 단위로 해석하여, 각 픽셀이 어떤 클래스에 속하는지를 판단하는 작업이다. 기존 분류·검출보다 더 정밀한 정보가 요구된다.
-
Semantic Segmentation: 동일한 클래스에 속하는 모든 픽셀을 하나로 간주하여 분할 (예: 모든 ‘사람’ 픽셀)
-
Instance Segmentation: 같은 클래스 내에서도 객체별로 구분 (예: 사람 1, 사람 2 구분)
-
Panoptic Segmentation: Semantic Segmentation과 Instance Segmentation을 결합하여, 모든 픽셀을 완전하게 분할하면서도 객체별 정보까지 제공
이 작업은 자율주행 차량의 차선 인식, 로봇의 경로 계획, 의료 영상의 병변 분석 등에서 매우 중요한 역할을 한다.
3. 학습 방식 분류
영상처리 분야에서 인공지능 모델을 훈련시키기 위한 학습 방식은 크게 다섯 가지로 나눌 수 있다. 각각의 방식은 데이터의 구성과 문제의 성격에 따라 선택되며, 다음과 같은 특징을 가진다.
가. 지도 학습(Supervised Learning)
지도 학습은 입력 데이터()와 정답 레이블()이 쌍으로 제공되는 방식이다. 모델은 이 정답을 기준으로 오차를 계산하고, 이를 줄이는 방향으로 학습한다.
- 예시: 고양이/강아지 사진과 해당 레이블이 함께 주어졌을 때, 새로운 이미지의 동물 종류를 예측하는 모델을 학습
장점: 정확도 높고 안정적인 성능 기대 可
단점: 레이블된 대규모의 데이터 필요
나. 비지도 학습(Unsupervised Learning)
비지도 학습은 정답 레이블 없이 입력 데이터만을 기반으로 데이터 간의 구조나 패턴을 파악하는 방식이다. 대표적인 기법으로 클러스터링(k-means), 차원 축소(PCA 등) 등이 있다.
- 예시: 이미지들을 자동으로 유사한 그룹으로 묶는 작업
장점: 레이블이 없는 데이터에도 활용 가능
단점: 결과 해석이 어렵고, 평가 지표가 명확하지 않을 수 있음
다. 자기지도 학습(Self-supervised Learning)
자기지도 학습은 입력 데이터 자체에서 학습에 필요한 라벨을 생성해, 지도 학습처럼 모델을 훈련하는 방식이다. 최근 큰 주목을 받는 방법으로, 특히 대규모 비정형 데이터에 효과적이다.
- 예시: 이미지의 일부를 가려놓고 나머지를 보고 복원하도록 학습시키는 방식(Masked Autoencoder 등)
장점: 레이블 없이도 지도학습 수준의 성능 가능
단점: 사전학습(pretext task)의 설계가 성능에 큰 영향을 미침
라. 반지도 학습(Semi-supervised Learning)
반지도 학습은 소량의 라벨 데이터와 대량의 非라벨 데이터를 함께 활용하는 방식이다. 현실에서는 레이블링 비용이 크기 때문에, 실용성이 높다.
- 예시: 100 장의 라벨된 의료 영상과 1000 장의 라벨 없는 영상을 동시에 이용해 학습
장점: 데이터 라벨링 부담 감소, 성능 향상 가능
단점: 라벨이 적절히 분포되지 않으면 효과 제한
마. 강화 학습(Reinforcement Learning)
강화 학습은 정답 레이블이 아닌 보상(reward)을 기반으로 학습하는 방식이다. 에이전트는 환경과 상호작용하며 최적의 행동을 학습한다.
-
예시: 자율주행 차량이 주행 경로를 스스로 학습하는 상황
-
구성 요소: 상태(state), 행동(action), 보상(reward), 정책(policy)
장점: 순차적 의사결정 문제에 적합
단점: 학습 속도가 느리고, 보상 설계가 어려움
각 학습 방식은 독립적으로 활용되기도 하지만, 실제 응용에서는 여러 방식을 결합한 하이브리드 접근이 점점 더 중요해지고 있다. 예를 들어, 자기지도 학습으로 사전학습을 한 뒤, 지도 학습으로 파인튜닝하는 방식이 대표적이다
4. 대표적인 고전 기계학습 기법
딥러닝이 대세가 된 현재에도, 고전적인 기계학습 알고리즘들은 데이터가 적거나 연산 자원이 제한된 환경, 혹은 해석 가능성(explainability)이 중요한 경우에 여전히 유효하다.
가. Minimum Distance Classifier
Minimum Distance Classifier는 지도 학습 방식에 속하는 간단하고 직관적인 분류 알고리즘이다. 각 클래스의 대표적인 특징을 나타내는 prototype vector를 기준으로, 입력 데이터가 어떤 클래스에 속하는지 판단한다.
1) 핵심 아이디어
① 데이터 전처리 및 특징 벡터 구성
먼저, 레이블이 부여된 학습 데이터를 바탕으로 각 샘플의 특징(feature)을 추출하고 정규화하여 pattern vector(feature vector)를 구성한다. 이 vectors은 좌표 공간상에서 데이터 분포를 나타낸다.
② 클래스별 대표 벡터(prototype) 계산
각 클래스에 속한 학습 데이터들의 특징 벡터 평균을 구해, 해당 클래스의 대표 벡터로 사용한다. 이때 클래스 의 prototype 는 다음과 같이 계산된다:
여기서 는 클래스 에 속하는 학습 샘플 수를 의미한다.
③ 거리 계산 및 분류 결정
테스트 데이터 가 주어지면, 이 샘플과 각 클래스의 prototype 사이의 유클리드 거리를 계산한다.
가장 가까운 prototype을 가진 클래스가 예측 결과가 된다.
2) 특징 및 활용
① 장점
-
구현이 매우 간단하고 계산이 빠르다.
-
다차원 공간에서의 직관적인 분류 기준을 제공한다.
② 단점
-
클래스 간 분포가 비선형이거나, 평균 벡터만으로 대표되기 어려운 경우 정확도 저하
-
클래스 내 분산이나 공분산 정보는 고려하지 않음
③ 활용 예시
패턴 인식, 초기 이미지 분류 실험, 저차원 데이터에 대한 간단한 분류 문제 등에서 baseline 모델로 자주 활용된다.
나. k-Nearest Neighbor(k-NN) 모델
k-NN 모델은 가장 직관적인 형태의 지도 학습 기반 분류 알고리즘 중 하나로, 새로운 데이터가 기존 데이터 중 어떤 것들과 가까운지를 기준으로 분류를 수행한다. 모델 학습 단계가 사실상 없고, 예측 시점에 거리 기반 계산을 수행하는 점이 특징이다.
1) 작동 원리
① 특징 벡터화
먼저 학습 데이터에 대해 feature을 추출하고 정규화하여, 각 데이터를 벡터 형태로 표현한다.
② 예측 시점에 거리 계산
테스트 샘플이 주어지면, 학습 데이터들과의 거리를 계산하여 가장 가까운 개의 이웃을 선택한다. 일반적으로 유클리드 거리를 사용한다.
③ 이웃의 클래스 기반 분류
선택된 개의 이웃 중 가장 많이 등장한 클래스를 예측 결과로 결정한다.
여기서 는 번째 이웃의 클래스, 은 indicator 함수.
2) 예시
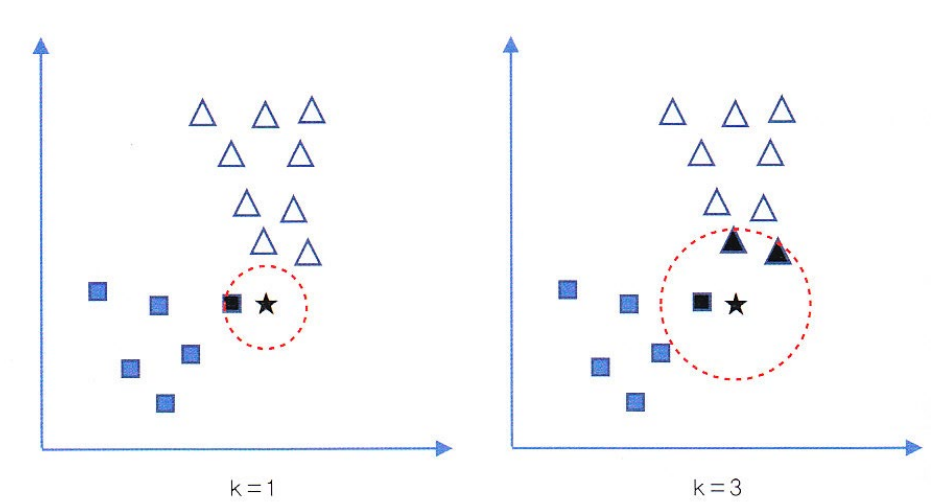
- : 테스트 샘플과 가장 가까운 한 개의 이웃만 보고 결정 → 매우 민감
- : 세 개의 이웃을 보고 다수 클래스를 선택 → 더 안정적
는 일반적으로 홀수를 사용하여 동률을 피한다. 그리고 값이 다르면 분류 결과도 달라질 수 있다.
3) Overfitting and Underfitting
① 가 너무 클 때
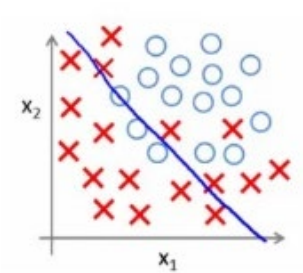
모델이 너무 둔감해져서 일반적인 패턴을 놓치는 Underfitting이 발생할 수 있다.
② 가 너무 작을 때
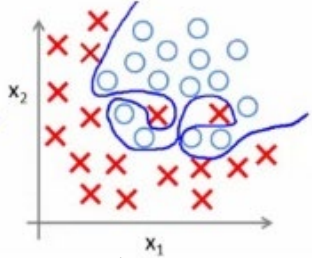
모델이 너무 민감해져서 훈련 데이터에 overfitting될 수 있다.
☞ 일반적으로 적절한 값을 교차검증 등을 통해 선택하는 것이 중요하다.
4) 특징 요약
① 장점
-
구현이 매우 간단하고, 학습 단계가 사실상 없음
-
비선형 경계도 자연스럽게 대응 가능
② 단점
-
계산량이 많고, 전체 데이터를 저장해야 함
-
차원의 저주(curse of dimensionality)에 취약
-
거리 척도 및 값 설정에 민감함
다. Support Vector Machine(SVM)
SVM(Support Vector Machine)은 지도 학습 방식에 속하는 분류 알고리즘으로, 특히 binary classification 문제에서 높은 성능을 보인다. 다만, 다중 클래스 문제에도 One-vs-One 또는 One-vs-Rest 방식으로 확장 가능하다.
1) 핵심 아이디어
SVM은 주어진 데이터를 선형으로 구분할 수 있다고 가정할 때, 가능한 모든 결정 경계 중에서 두 클래스 간의 margin이 가장 큰 결정 경계를 찾는 방식이다. 이렇게 하면 일반화 성능이 높아지는 경향이 있다.
-
데이터 공간에 여러 개의 가능한 경계선이 존재하지만, SVM은 margin을 기준으로 가장 최적인 경계를 선택한다.
-
여기서 margin이란, 결정 경계와 각 클래스의 가장 가까운 데이터들 간의 거리이며, 이들을 support vector라고 부른다.
2) 결정 경계와 초평면 구조
- SVM은 두 클래스를 나누는 결정 경계(decision boundary)를 다음과 같은 초평면(hyperplane)으로 표현한다.
-
이 결정 경계와 평행한 두 개의 초평면을 정의하면 다음과 같다.
Positive hyperplane:
Negative hyperplane: -
이 두 초평면 사이의 거리가 margin이며, 그 수식은 다음과 같다.
따라서 SVM의 목표는 을 최소화하여 margin을 최대화하는 것이다.
3) 최적화와 학습 방식
이러한 결정 경계를 찾기 위해 SVM은 최적화 문제를 푼다. 특히, 라그랑주 승수법(Lagrange multiplier method)을 이용해 제약 조건 하에서 최적의 와 을 계산한다.
4) Advanced SVM: 비선형 문제 대응
실제 데이터는 선형적으로 구분되지 않는 경우가 많다. 이런 경우 SVM은 다음과 같은 방법으로 확장된다.
① 커널 트릭(Kernel Trick)
-
데이터를 저차원에서 고차원 공간으로 매핑하여, 선형적으로 분리 가능한 형태로 변형
-
예: RBF 커널, 다항식 커널 등
② Soft Margin(유연한 경계)
-
일부 오차를 허용하면서도 최대한 margin을 확보하는 방식
-
slack variable를 도입해, 노이즈나 이상치에 대해 유연하게 대응
라. HOG(Histograms of Oriented Gradients)
HOG는 이미지 내에서 윤곽선, 가장자리(edge), 방향성 패턴과 같은 구조 정보를 추출하는 대표적인 특징 추출 기법이다. 특히, 보행자 검출(pedestrian detection) 등의 객체 인식 작업에서 많이 활용된다.
1) 핵심 아이디어: Gradient 기반 특징 추출
이미지에서 픽셀 간 밝기(intensity)의 변화를 바탕으로 gradient를 계산하여, 변화 방향(orientation)과 변화의 크기(magnitude)를 얻는다.
-
Gradient 방향(orientation): 픽셀 밝기가 어느 방향으로 가장 많이 변하는지
-
Gradient 크기(magnitude): 변화의 강도
이러한 gradient 정보는 해당 픽셀이 포함된 local shape를 효과적으로 표현할 수 있게 해준다.
2) HOG의 처리 과정 요약
HOG는 보통 다음과 같은 절차를 따라 특징 벡터를 생성한다.
① 이미지를 작은 셀로 분할
- 예: 64×128 크기의 이미지 패치를 8×8 셀로 분할
② 각 셀 내 모든 픽셀의 gradient 계산
- 각 셀에서 모든 픽셀의 방향성과 크기를 계산
③ Gradient 방향을 히스토그램으로 정리
-
하나의 셀에서 추출된 gradient 방향을 9개의 방향(bin)으로 양자화
-
각 방향(bin)에는 해당 방향의 gradient 크기를 누적해서 기록
④ 블록 정규화
- 여러 셀을 묶은 블록 단위로 정규화 수행하여 조명 변화에 강인한 특징 구성
⑤ 전체 이미지에 대해 feature vector 생성
-
모든 블록의 히스토그램을 이어붙여 하나의 벡터로 만듦
-
예: 64×128 이미지에서 약 3,780 차원의 벡터 생성
3) HOG + SVM = 강력한 검출기
-
생성된 HOG 벡터는 이후 SVM Classifier 등의 지도학습 모델에 입력되어, 객체 존재 여부를 학습하고 예측하는 데 사용된다.
-
특히, 사람을 포함하는 이미지와 포함하지 않는 이미지를 학습시켜, 테스트 이미지에서 보행자 여부를 판단하게 된다.
4) 다양한 응용 기법
-
Sliding Window: 이미지를 일정 간격으로 잘라가며 여러 위치에서 검출 수행
-
Scaling: 다양한 크기의 객체를 검출하기 위해 이미지 크기를 여러 해상도로 조정하며 분석
마. k-Means Clustering
k-means는 비지도 학습에 속하는 대표적인 클러스터링 알고리즘으로, 데이터에 대한 사전 레이블이 없는 상태에서 유사한 데이터끼리 그룹화하는 데 활용된다.
1) Clustering vs Classification
-
분류(Classification)는 사전에 라벨이 있는 데이터를 바탕으로 새로운 데이터의 레이블을 예측하는 지도학습(supervised learning) 방식이다.
-
반면, 클러스터링은 라벨이 없는 데이터를 자동으로 그룹화하는 비지도학습(unsupervised learning) 방식이다.
2) k-means 알고리즘의 핵심 개념
-
알고리즘의 이름에서 는 클러스터의 수를 의미하며, 사전에 클러스터 개수를 지정해야 한다는 제약이 있다.
-
각 데이터는 개의 중심점(centroid) 중에서 가장 가까운 중심에 속하게 되며, 이 과정을 반복하여 클러스터의 중심이 수렴할 때까지 갱신한다.
3) 알고리즘 절차
① 초기 중심 설정
임의의 방식(랜덤 등)으로 개의 초기 중심점(centroids)을 설정한다.
② 클러스터 할당
각 데이터 포인트와 모든 중심점 간의 거리를 계산하고, 가장 가까운 중심점에 데이터를 할당한다.
③ 중심점 갱신
각 클러스터에 속한 데이터의 평균을 계산하여 새로운 중심점을 갱신한다.
④ 수렴 조건 확인 및 반복
클러스터의 구성이나 중심점이 더 이상 변하지 않으면 알고리즘을 종료하고, 그렇지 않으면 2~3단계를 반복한다.
<참고 자료>
유성욱 교수님, 지능형 영상처리, 중앙대학교 전자전기공학부, 2024