1. 정리 범위
이번 내용은 두 데이터셋을 통해 머신러닝 전처리와 회귀 분석의 흐름을 익힌다.
| 데이터셋 | 주요 내용 |
|---|---|
| 주택 임대료 | 날짜·층수 피처 엔지니어링, Pipeline, 선형 회귀, 로그 변환 |
| 서울 자전거 공유 수요 | 데이터 품질 점검, 날짜·순환 피처, 수요 패턴 탐색, 시간 순서 분할 |
핵심은 모델을 단순히 호출하는 데 있지 않다. 데이터의 구조를 모델이 이해할 수 있는 피처로 바꾸고, 학습 데이터와 테스트 데이터를 섞지 않으며, 문제에 맞는 평가 방식을 선택하는 과정이 중요하다.
2. 주택 임대료 데이터 전처리
주택 임대료 데이터셋의 Rent를 목표값으로 사용한다. 이전 탐색에서 확인했듯이 임대료는 고가 매물 때문에 오른쪽 꼬리가 긴 분포를 가진다.
2.1 날짜를 파생 변수로 분리하기
Posted On은 문자열 상태로 모델에 넣기보다 날짜 자료형으로 변환한 뒤 연도, 월, 요일을 분리하는 편이 유용하다.
rent_df["Posted On"] = pd.to_datetime(
    rent_df["Posted On"]
)

rent_df["Posted_Year"] = (
    rent_df["Posted On"].dt.year
)
rent_df["Posted_Month"] = (
    rent_df["Posted On"].dt.month
)
rent_df["Posted_DayOfWeek"] = (
    rent_df["Posted On"].dt.dayofweek
)dayofweek은 월요일이 0, 일요일이 6이다. 날짜 자체보다 계절성이나 요일 효과처럼 모델에 도움이 될 수 있는 의미 단위로 나눠 사용하는 것이 피처 엔지니어링의 한 예다.
2.2 층수 문자열 분리하기
Floor 컬럼에는 3 out of 10, Ground out of 2처럼 현재 층과 전체 층수가 하나의 문자열에 섞여 있다. 정규표현식의 이름 있는 그룹(named group)을 사용하면 두 정보를 분리할 수 있다.
floor_pattern = (
    r"(?P<Current_Floor>"
    r"Upper Basement|Lower Basement|Ground|"
    r"Upper|Lower|Basement|\d+)"
    r"\s+out of\s+"
    r"(?P<Total_Floors>\d+)"
)

floor_split = (
    rent_df["Floor"]
    .astype(str)
    .str.extract(floor_pattern)
)

print(floor_split.head())| Floor | Current_Floor | Total_Floors |
|---|---|---|
Ground out of 2 | Ground | 2 |
1 out of 3 | 1 | 3 |
23 out of 34 | 23 | 34 |
문자열 층수는 분석을 위해 숫자로 바꾼다. 아래 매핑은 이 데이터셋을 위한 규칙이며, 실제 서비스에서는 건물의 층수 표기 기준을 확인해야 한다.
import numpy as np

floor_map = {
    "Upper Basement": -1,
    "Lower Basement": -1,
    "Basement": -1,
    "Ground": 0,
    "Lower": 0,
    "Upper": np.nan,
}

rent_df["Current_Floor"] = (
    floor_split["Current_Floor"]
    .replace(floor_map)
)

rent_df["Current_Floor"] = pd.to_numeric(
    rent_df["Current_Floor"],
    errors="coerce",
)

rent_df["Total_Floors"] = pd.to_numeric(
    floor_split["Total_Floors"],
    errors="coerce",
)
노트북에서는 정규표현식으로 분리하지 못한 값이 1, 3, Ground처럼 4개 있었다. 변환하지 못한 값은 NaN이 되며, 이후 Pipeline의 결측치 처리 단계에서 학습 데이터 기준 중앙값으로 채운다.
Upper out of 5처럼 현재 층을 정확히 알 수 없는 경우는 전체 층수로 보정한다.
upper_mask = (
    floor_split["Current_Floor"].eq("Upper")
    & rent_df["Current_Floor"].isna()
)

rent_df.loc[upper_mask, "Current_Floor"] = (
    rent_df.loc[upper_mask, "Total_Floors"]
)
2.3 층 위치 비율 만들기
단순한 현재 층뿐 아니라 전체 층수 대비 어디에 위치하는지를 나타내는 비율 피처를 만들 수 있다.
rent_df["Floor_Ratio"] = (
    rent_df["Current_Floor"]
    / rent_df["Total_Floors"]
)

rent_df["Floor_Ratio"] = (
    rent_df["Floor_Ratio"]
    .replace([np.inf, -np.inf], np.nan)
)

rent_df = rent_df.drop(
    columns=["Floor", "Posted On"]
)
예를 들어 1 out of 3은 약 0.33, 4 out of 5는 0.8이 된다. 다만 저층·고층 선호는 지역과 건물 유형에 따라 다를 수 있으므로, 이 비율이 항상 임대료와 선형 관계를 가진다고 가정하면 안 된다.
3. 학습 데이터와 테스트 데이터 분리
목표값과 입력 변수를 분리한 뒤, train_test_split()으로 70%의 학습 데이터와 30%의 테스트 데이터를 만든다.
from sklearn.model_selection import train_test_split

X = rent_df.drop(columns="Rent")
y = rent_df["Rent"]

X_train, X_test, y_train, y_test = train_test_split(
    X,
    y,
    test_size=0.3,
    random_state=2026,
)| 구분 | 역할 |
|---|---|
X_train, y_train | 전처리 기준과 모델 파라미터를 학습한다. |
X_test, y_test | 학습에 사용하지 않은 데이터로 최종 성능을 평가한다. |
random_state를 고정하면 동일한 데이터 분할을 재현할 수 있다. 재현성은 모델 간 비교와 오류 분석에서 중요하다.
4. Pipeline과 ColumnTransformer
4.1 Pipeline이 필요한 이유
숫자형과 범주형 변수는 서로 다른 전처리가 필요하다. 또한 전처리 기준은 반드시 학습 데이터에서만 학습해야 한다.
X_train -> 결측치 처리 -> 범주형 인코딩 -> 모델 학습
X_test  -> 학습된 전처리 규칙 적용 -> 예측
각 단계를 따로 실행하면 테스트 데이터의 중앙값이나 범주 정보를 실수로 학습에 사용해 데이터 누수(data leakage)가 발생할 수 있다. Pipeline은 fit()과 predict()에서 동일한 전처리 순서를 적용하도록 보장한다.
4.2 숫자형과 범주형 전처리 구성
from sklearn.compose import ColumnTransformer
from sklearn.impute import SimpleImputer
from sklearn.linear_model import LinearRegression
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import OneHotEncoder

numeric_features = X.select_dtypes(
    include=["number"]
).columns.tolist()

categorical_features = X.select_dtypes(
    include=["str", "object", "category", "bool"]
).columns.tolist()

numeric_transformer = Pipeline(
    steps=[
        ("imputer", SimpleImputer(strategy="median")),
    ]
)

categorical_transformer = Pipeline(
    steps=[
        (
            "imputer",
            SimpleImputer(strategy="most_frequent"),
        ),
        (
            "onehot",
            OneHotEncoder(handle_unknown="ignore"),
        ),
    ]
)

preprocessor = ColumnTransformer(
    transformers=[
        ("num", numeric_transformer, numeric_features),
        ("cat", categorical_transformer, categorical_features),
    ]
)

lr_model = Pipeline(
    steps=[
        ("preprocessor", preprocessor),
        ("model", LinearRegression()),
    ]
)| 단계 | 숫자형 컬럼 | 범주형 컬럼 |
|---|---|---|
| 결측치 처리 | 중앙값으로 대체 | 최빈값으로 대체 |
| 변환 | 그대로 사용 | 원-핫 인코딩 |
| 학습 기준 | X_train에서만 계산 | X_train에서만 범주 목록을 학습 |
handle_unknown="ignore"는 학습 데이터에 없던 범주가 테스트 데이터에 나타났을 때 오류를 내지 않고, 해당 범주에 대한 원-핫 값을 모두 0으로 처리한다.
Area Locality는 고유값이 2,235개인 고카디널리티(high-cardinality) 변수다. 이 예제에서는 원-핫 인코딩을 사용했지만, 데이터가 더 커지면 빈도 인코딩이나 다른 인코딩 방법도 비교할 수 있다. 어떤 인코딩을 사용하더라도 빈도나 범주 규칙은 반드시 X_train에서만 학습해야 데이터 누수를 막을 수 있다.
4.3 fit과 predict의 차이
lr_model.fit(X_train, y_train)
pred = lr_model.predict(X_test)fit()은 학습 데이터의 중앙값, 최빈값, 원-핫 인코딩 범주 목록을 계산하고 선형 회귀 모델의 계수를 학습한다. predict()는 새 기준을 다시 계산하지 않고, 학습 때 저장한 기준으로 X_test를 변환한 뒤 예측한다.
전처리 후 만들어진 전체 특성 수는 1,775개였다. Area Locality처럼 고유값이 많은 범주형 컬럼이 원-핫 인코딩되면서 특성 수가 크게 늘어난 결과다.
5. 선형 회귀와 평가 지표
LinearRegression은 실제값과 예측값의 차이인 잔차(residual)의 제곱합을 최소화하는 선형 모델이다.
from sklearn.metrics import (
    mean_absolute_error,
    mean_squared_error,
    root_mean_squared_error,
    r2_score,
)

lr_model.fit(X_train, y_train)
pred = lr_model.predict(X_test)

mae = mean_absolute_error(y_test, pred)
rmse = root_mean_squared_error(y_test, pred)
mse = mean_squared_error(y_test, pred)
r2 = r2_score(y_test, pred)

print(f"MAE: {mae:,.2f}")
print(f"RMSE: {rmse:,.2f}")
print(f"MSE: {mse:,.2f}")
print(f"R2: {r2:,.2f}")| 지표 | 의미 |
|---|---|
| MAE | 실제값과 예측값 차이의 절댓값 평균이다. 원래 임대료 단위로 해석하기 쉽다. |
| MSE | 오차를 제곱한 평균이다. 큰 오차에 민감하다. |
| RMSE | MSE에 제곱근을 적용한 값이다. 원래 임대료 단위로 해석할 수 있다. |
| R² | 평균만 예측하는 기준 모델과 비교해 얼마나 잘 설명하는지 나타낸다. |
R²는 다음과 같이 계산한다.
R² = 1 - (잔차 제곱합 / 전체 제곱합)원본 임대료로 학습한 노트북 결과는 다음과 같았다.
MAE: 23,455.48
RMSE: 88,973.43
MSE: 7,916,271,434.30
R²: -1.26
R²가 음수라는 것은 이 모델이 테스트 데이터에서 단순히 임대료 평균을 예측하는 기준보다도 성능이 낮았다는 뜻이다. 선형 회귀 모델의 한계라기보다, 목표값의 긴 꼬리, 고가 매물, 높은 범주 수, 선형성 가정이 함께 영향을 미쳤을 가능성을 확인해야 한다.
원본 예측값에는 음수 임대료도 일부 나타났다. 일반 선형 회귀는 예측값의 최솟값을 0으로 제한하지 않으므로, 실제로 음수가 될 수 없는 목표값에서는 결과 해석과 후처리에 주의해야 한다.
6. 로그 변환으로 고가 임대료 영향 줄이기
임대료처럼 큰 값이 일부 존재하는 목표값은 로그 변환을 고려할 수 있다. np.log1p(x)는 log(1 + x)를 계산하므로 값에 0이 있어도 사용할 수 있다.
y_train_log = np.log1p(y_train)

lr_model.fit(X_train, y_train_log)
y_pred_log = lr_model.predict(X_test)

# 로그 단위 예측값을 원래 임대료 단위로 복원한다.
log_pred = np.expm1(y_pred_log)

# 임대료가 음수가 되는 비현실적인 예측을 제한한다.
log_pred = np.clip(log_pred, a_min=0, a_max=None)
중요한 점은 모델이 로그 단위로 학습되었기 때문에, 평가 전에 np.expm1()으로 원래 단위로 되돌려야 한다는 것이다.
| 학습 방식 | MAE | RMSE | R² |
|---|---|---|---|
| 원본 임대료 | 23,455.48 | 88,973.43 | -1.26 |
log1p 변환 임대료 | 10,449.76 | 39,079.33 | 0.56 |
이 데이터에서는 로그 변환 후 성능이 개선됐다. 다만 로그 변환이 항상 성능을 높이거나 데이터를 정규분포로 만드는 것은 아니다. 여러 모델과 평가 지표로 검증해야 한다.
7. 서울 자전거 공유 수요 데이터셋
서울 공공자전거 따릉이의 시간별 대여 수요를 예측하기 위한 데이터셋이다. 시간, 날씨, 계절, 공휴일, 운영 여부가 대여량에 어떤 관계가 있는지 탐색한다.
7.1 데이터 불러오기와 인코딩
CSV 파일이 Windows 한글 인코딩인 CP949로 저장되어 있어 encoding="CP949" 옵션을 사용한다.
from pathlib import Path

import pandas as pd

DATA_PATH = Path("./data/SeoulBikeData.csv")

bike_raw = pd.read_csv(
    DATA_PATH,
    encoding="CP949",
)

bike_df = bike_raw.copy()
bike_df.columns = [
    "Date",
    "Rented Bike Count",
    "Hour",
    "Temperature",
    "Humidity",
    "Wind speed",
    "Visibility",
    "Dew point temperature",
    "Solar Radiation",
    "Rainfall",
    "Snowfall",
    "Seasons",
    "Holiday",
    "Functioning Day",
]| 항목 | 값 |
|---|---|
| 행 수 | 8,760 |
| 컬럼 수 | 14 |
| 날짜 수 | 365 |
| 시간 값 | 24개 |
| 결측치 | 0개 |
| 완전 중복 행 | 0개 |
8,760은 365일 × 24시간으로, 1년 동안의 시간 단위 관측치임을 알 수 있다.
7.2 데이터 품질 확인
quality_report = pd.DataFrame(
    {
        "missing_count": bike_df.isna().sum(),
        "missing_ratio": bike_df.isna().mean(),
        "nunique": bike_df.nunique(),
    }
)

print(quality_report)
print(bike_df.duplicated().sum())
수집된 데이터에는 결측치와 완전 중복 행이 없었다. 하지만 Functioning Day가 No인 행은 실제로 자전거를 대여할 수 없는 시점을 의미하므로, 수요 예측 모델을 만들 때는 별도로 처리해야 한다.
8. 날짜와 순환 피처 만들기
8.1 날짜 파생 변수
bike_df["Date"] = pd.to_datetime(
    bike_df["Date"],
    format="%d/%m/%Y",
)

bike_df["year"] = bike_df["Date"].dt.year
bike_df["month"] = bike_df["Date"].dt.month
bike_df["day"] = bike_df["Date"].dt.day
bike_df["dayofweek"] = bike_df["Date"].dt.dayofweek
bike_df["is_weekend"] = (
    bike_df["dayofweek"].isin([5, 6]).astype(int)
)
날짜를 연도·월·일·요일·주말 여부로 분리하면 계절성과 주중·주말 패턴을 모델이 학습할 수 있다.
8.2 시간과 월의 순환 인코딩
시간은 23시와 0시가 서로 가깝지만, 숫자만 보면 23과 0의 차이가 크게 보인다. 이를 해결하기 위해 시간을 원 위의 좌표로 바꾸는 순환 인코딩을 사용한다.
import numpy as np

bike_df["hour_sin"] = np.sin(
    2 * np.pi * bike_df["Hour"] / 24
)
bike_df["hour_cos"] = np.cos(
    2 * np.pi * bike_df["Hour"] / 24
)

bike_df["month_sin"] = np.sin(
    2 * np.pi * bike_df["month"] / 12
)
bike_df["month_cos"] = np.cos(
    2 * np.pi * bike_df["month"] / 12
)| 시간 | sin | cos |
|---|---|---|
| 0시 | 0 | 1 |
| 6시 | 1 | 0 |
| 12시 | 0 | -1 |
| 18시 | -1 | 0 |
| 24시 | 0 | 1 |
sin만 사용하면 같은 값을 가진 시간이 생길 수 있으므로 cos를 함께 사용해야 원 위의 위치를 구분할 수 있다. 노트북 원본에서는 hour_cos, month_cos에도 np.sin()이 사용되어 있었는데, 순환 인코딩이 되려면 np.cos()로 수정해야 한다.
9. 자전거 대여 수요 탐색
9.1 시간대별 평균 대여량
import matplotlib.pyplot as plt
import seaborn as sns

hourly_demand = (
    bike_df.groupby("Hour", as_index=False)
    ["Rented Bike Count"]
    .mean()
)

sns.lineplot(
    data=hourly_demand,
    x="Hour",
    y="Rented Bike Count",
    marker="o",
)
plt.title("시간대별 평균 자전거 대여량")
plt.show()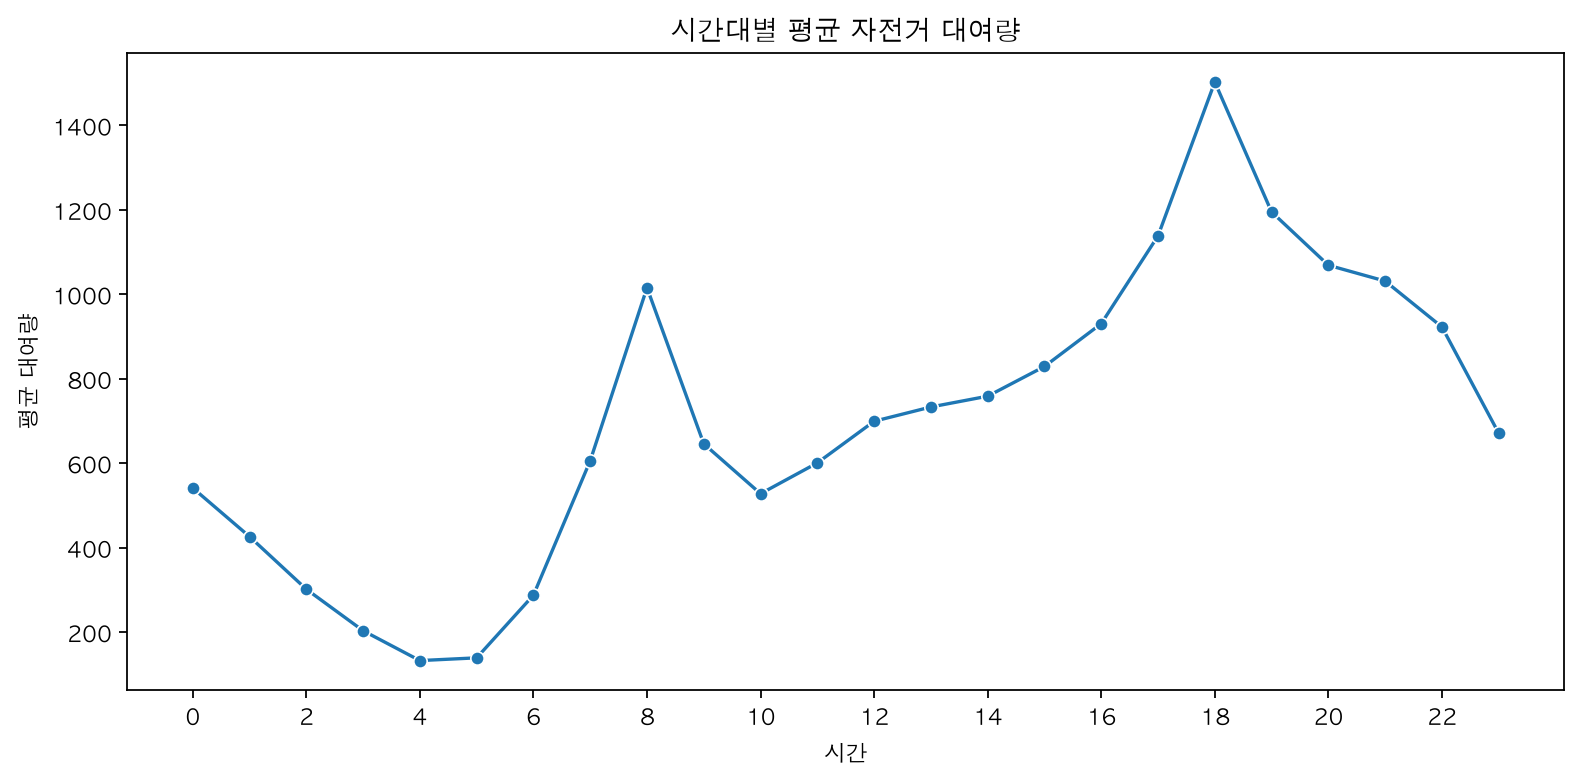
평균 대여량은 18시에 약 1,502.93대로 가장 높고, 4시에 약 132.59대로 가장 낮다. 오전 8시와 저녁 18시의 상승은 출퇴근 수요와 관련이 있을 가능성이 있지만, 이 그래프만으로 원인을 단정할 수는 없다.
9.2 월별 평균 대여량
monthly_demand = (
    bike_df.groupby("month", as_index=False)
    ["Rented Bike Count"]
    .mean()
)

sns.lineplot(
    data=monthly_demand,
    x="month",
    y="Rented Bike Count",
    marker="o",
)
plt.title("월별 평균 자전거 대여량")
plt.show()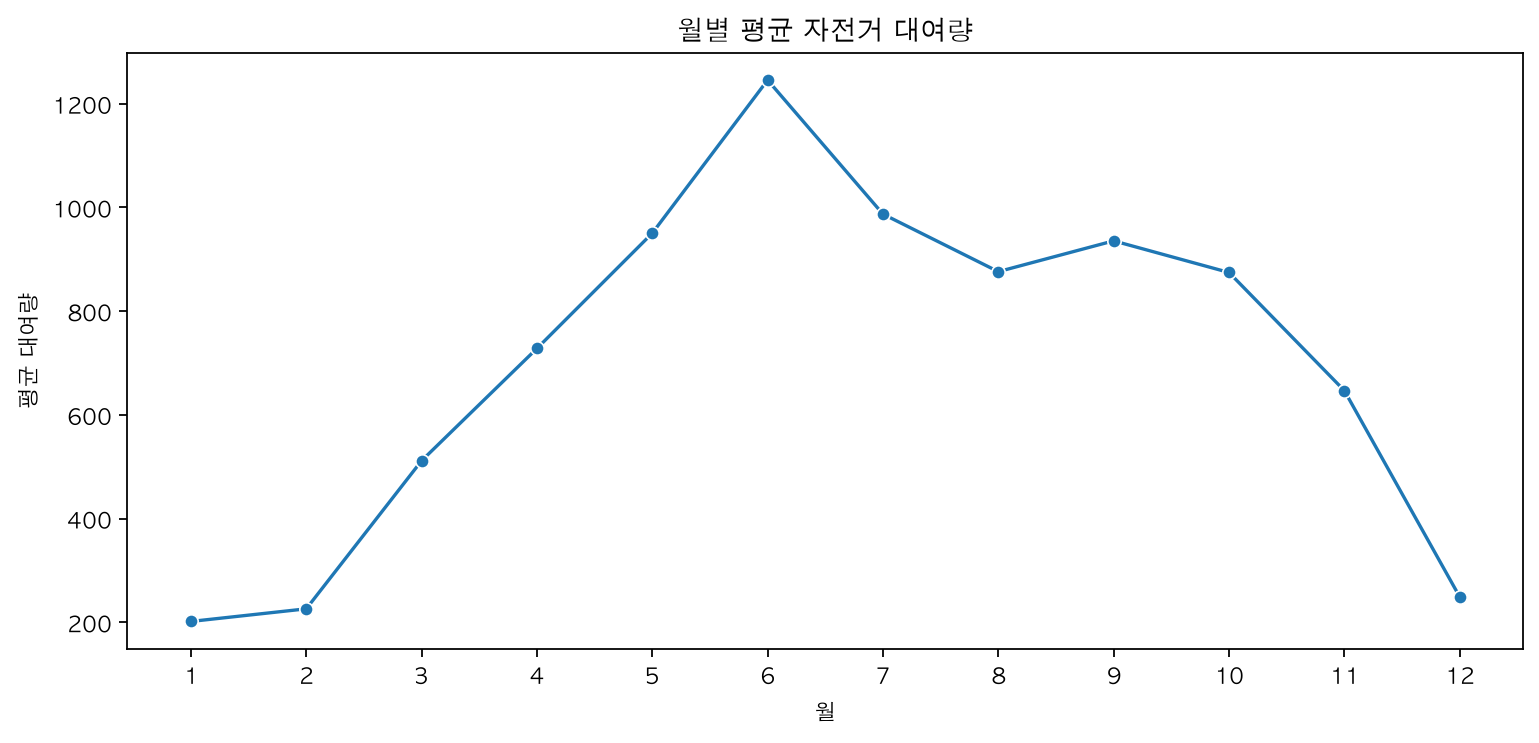
6월의 평균 대여량은 약 1,245.68대로 가장 높고, 1월은 약 201.62대로 가장 낮다. 기온과 계절, 강수량이 함께 변하므로 월별 차이는 여러 요인이 결합된 결과로 해석해야 한다.
9.3 계절·공휴일·운영일별 평균 대여량
for column in ["Seasons", "Holiday", "Functioning Day"]:
    sns.barplot(
        data=bike_df,
        x=column,
        y="Rented Bike Count",
    )
    plt.title(f"{column}별 평균 자전거 대여량")
    plt.xticks(rotation=20)
    plt.show()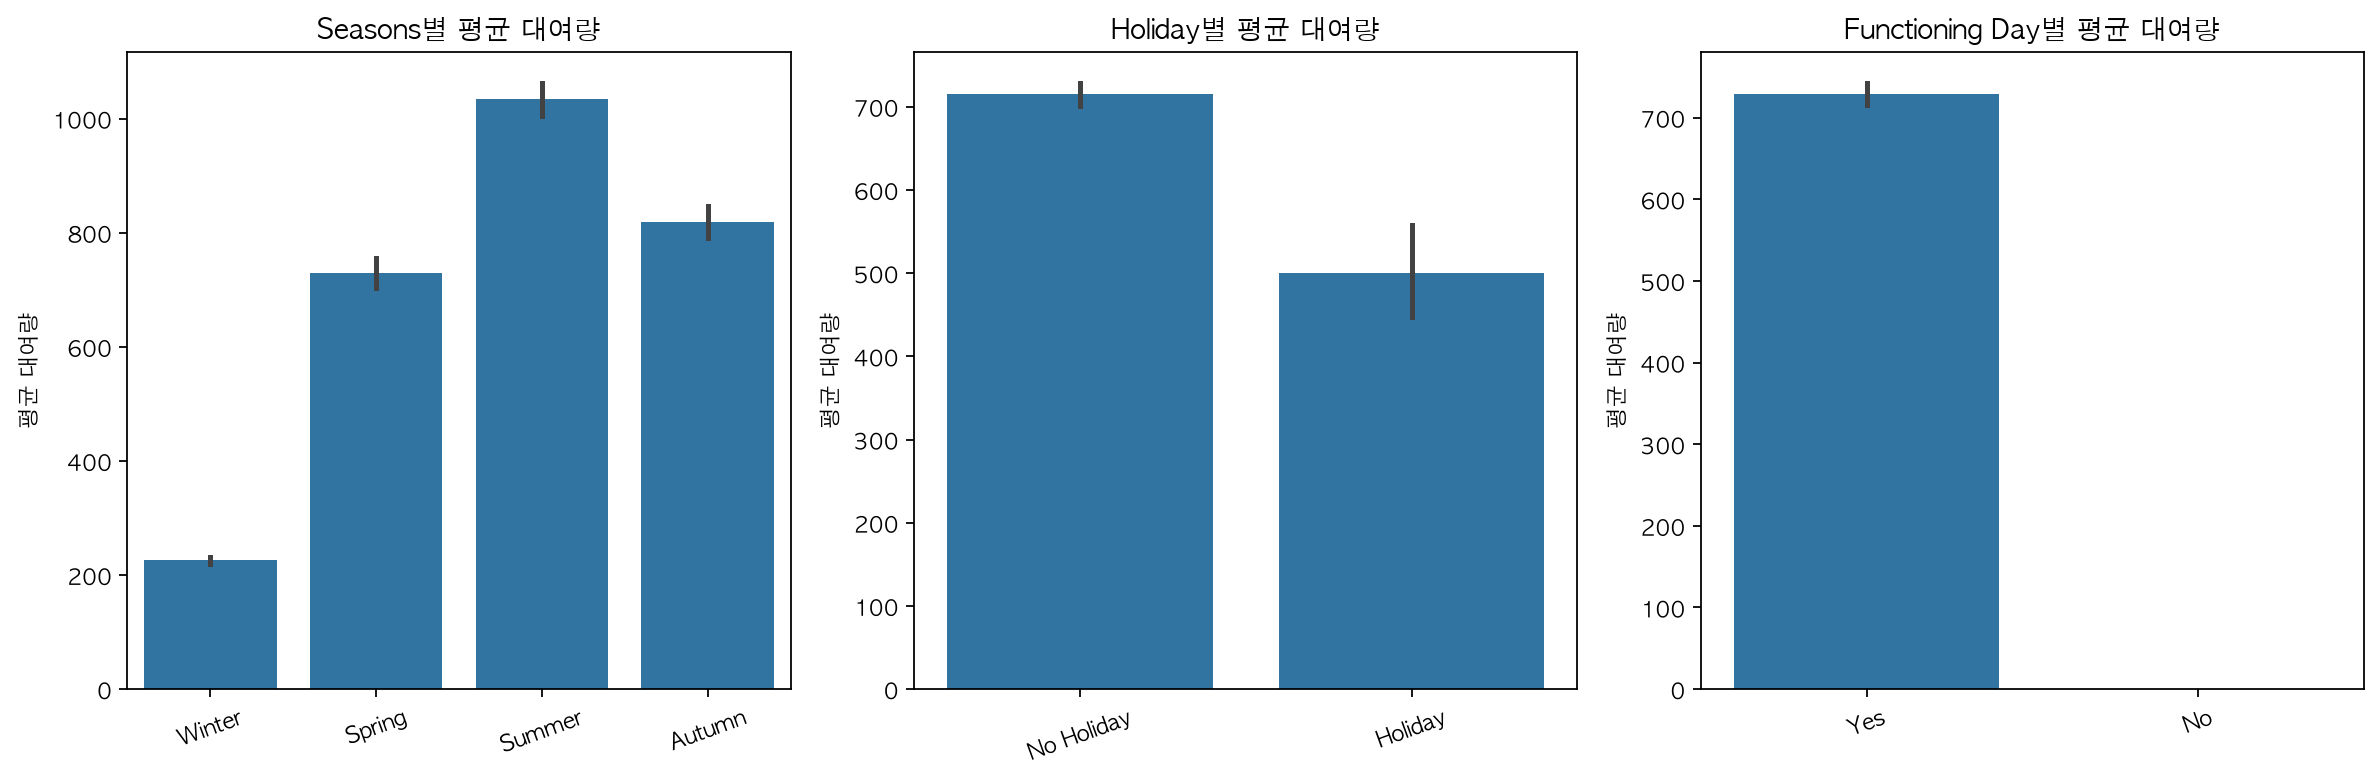
| 구분 | 평균 대여량 |
|---|---|
| 여름 | 1,034.07 |
| 가을 | 819.60 |
| 봄 | 730.03 |
| 겨울 | 225.54 |
| 휴일 | 499.76 |
| 휴일 아님 | 715.23 |
| 운영일 아님 | 0.00 |
| 운영일 | 729.16 |
Seaborn의 barplot()은 기본적으로 범주별 평균을 막대 높이로 표시한다. 에러바는 평균 추정치의 불확실성을 보여주며, 표시 방식은 Seaborn 버전과 설정에 따라 달라질 수 있다.
9.4 날씨 변수와 대여량
weather_columns = [
    "Temperature",
    "Humidity",
    "Wind speed",
    "Visibility",
    "Solar Radiation",
    "Rainfall",
    "Snowfall",
]

for column in weather_columns:
    sns.scatterplot(
        data=bike_df,
        x=column,
        y="Rented Bike Count",
        alpha=0.3,
    )
    plt.title(f"{column}와 자전거 대여량의 관계")
    plt.show()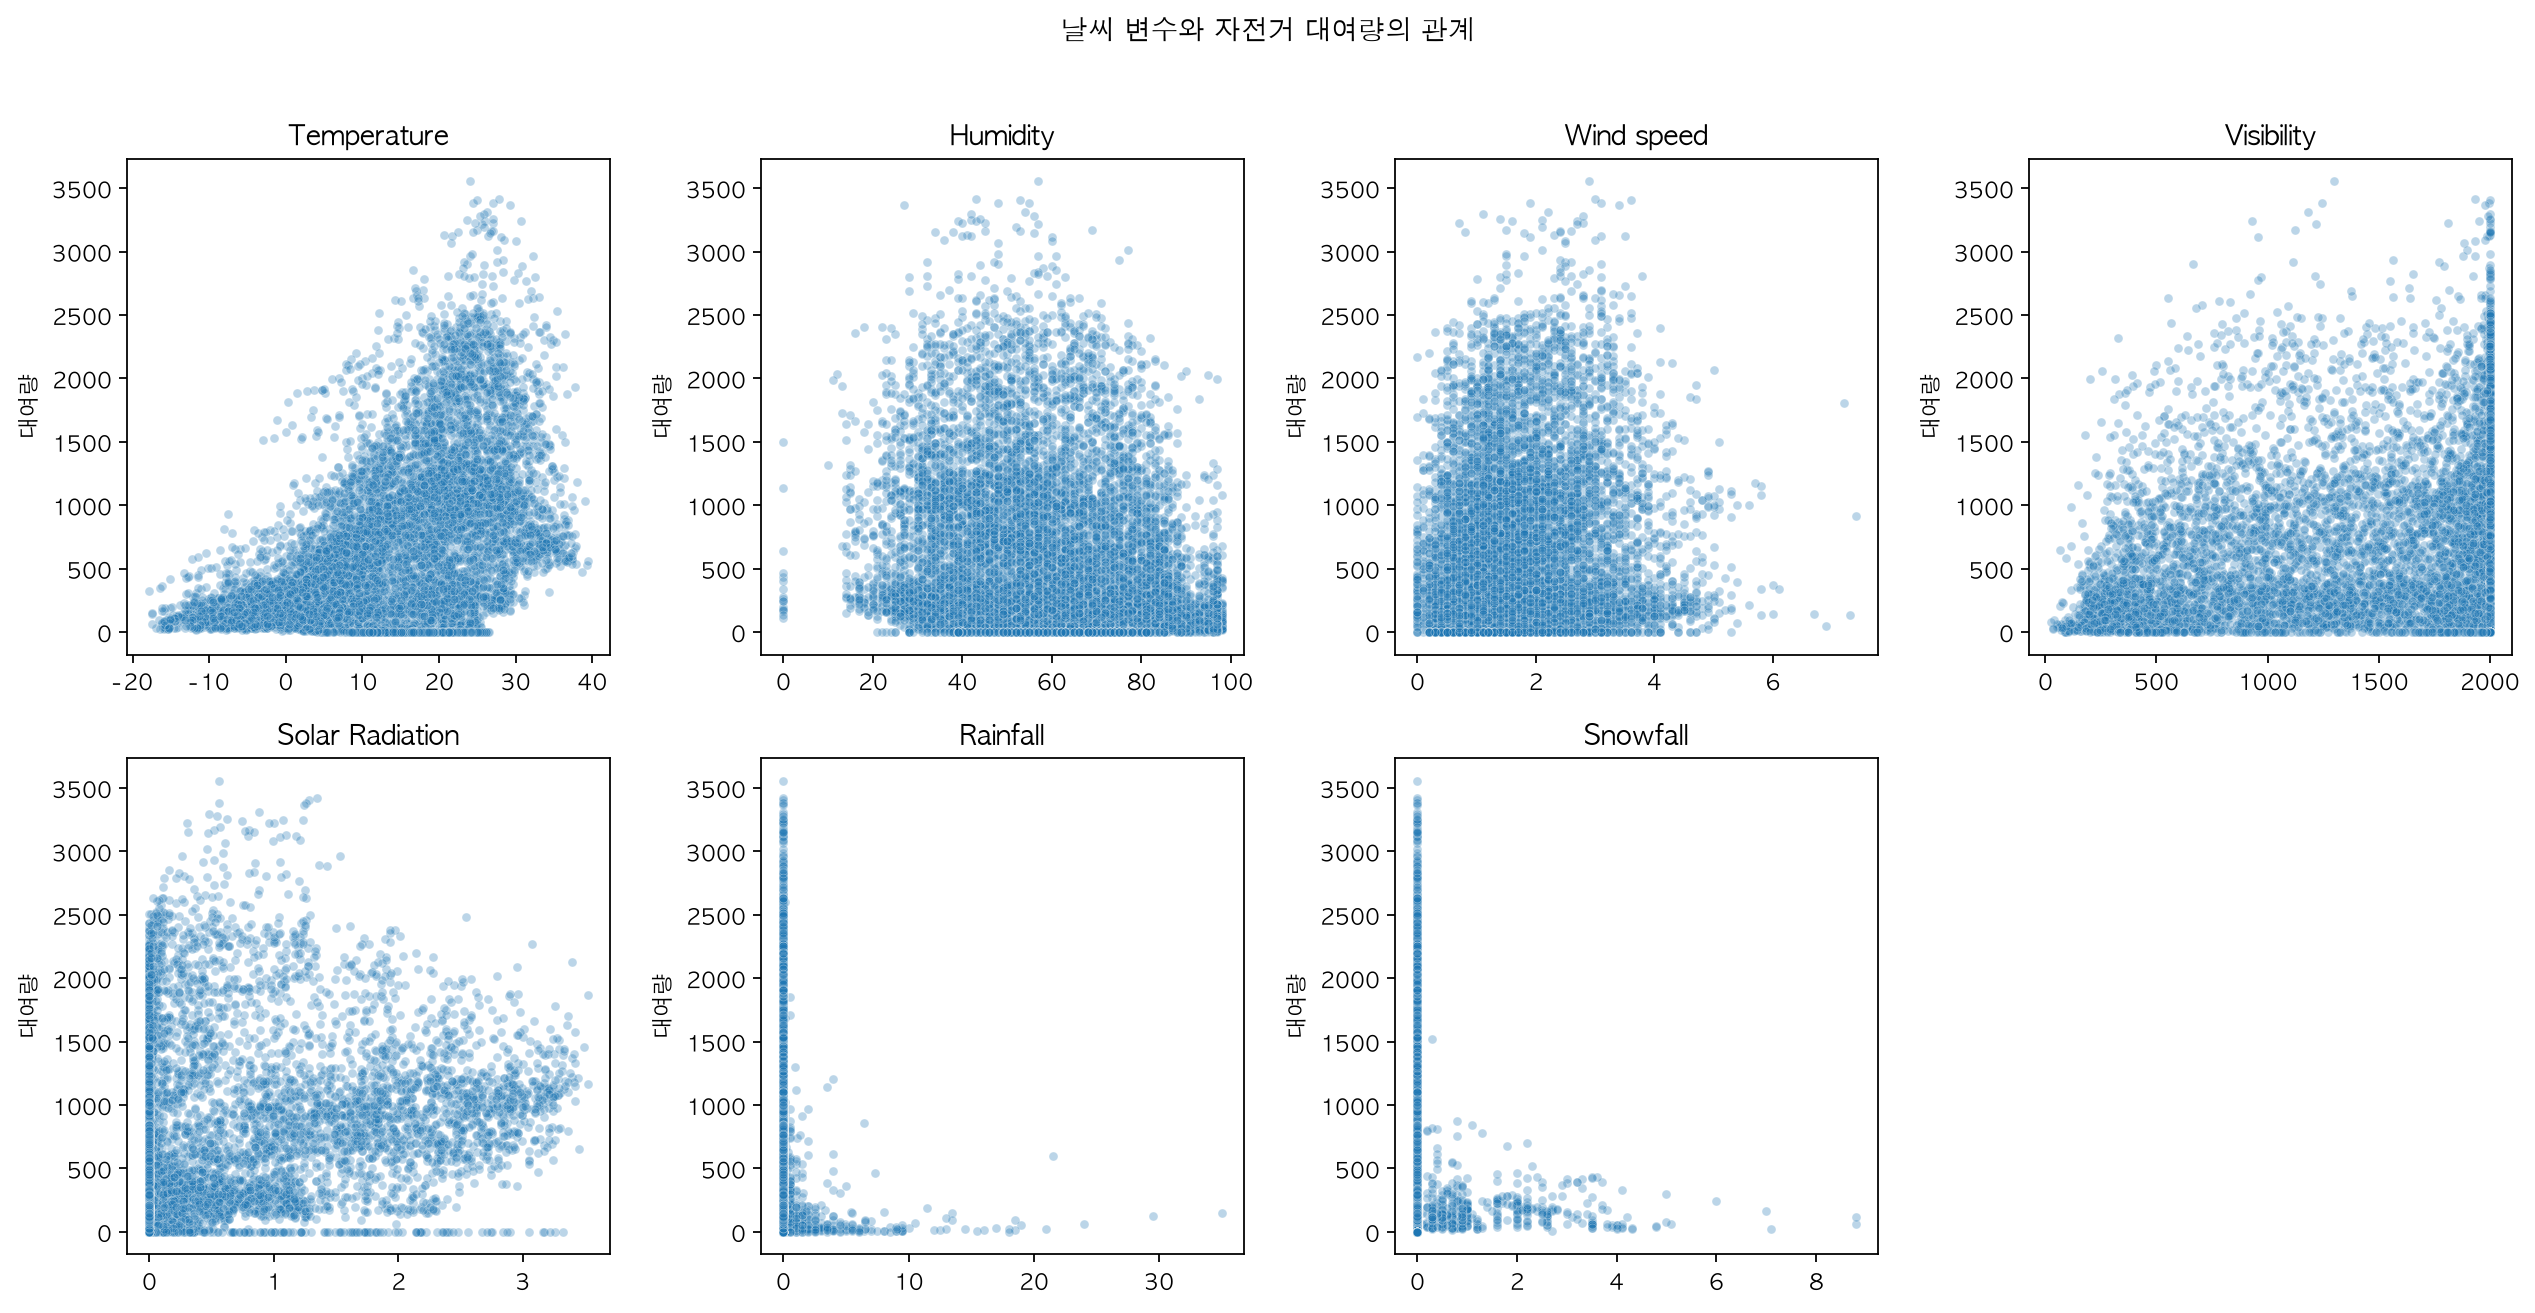
온도·일사량·가시거리는 대여량과 일정한 관계가 있어 보이지만, 시간대와 계절 같은 다른 변수의 영향도 함께 섞여 있다. 반대로 비와 눈은 대부분 0에 몰려 있어 단순 선형 관계로 설명하기 어렵다. 산점도는 관계를 탐색하는 출발점이며, 인과관계를 증명하지는 않는다.
10. 운영일만 사용하고 시간 순서로 분할하기
운영하지 않은 날에는 대여량이 0이므로, 일반적인 수요를 예측하려면 운영일 데이터만 사용한다.
model_df = bike_df[
    bike_df["Functioning Day"] == "Yes"
].copy()

model_df = model_df.drop(
    columns=["Functioning Day"]
)

print(bike_df.shape)   # (8760, 23)
print(model_df.shape)  # (8465, 22)
시간 데이터는 무작위로 섞어 분할하면 미래의 정보가 과거 학습 데이터에 섞일 수 있다. 날짜와 시간 순으로 정렬한 뒤 앞 80%를 학습 데이터, 뒤 20%를 테스트 데이터로 사용한다.
target = "Rented Bike Count"

model_df = (
    model_df.sort_values(["Date", "Hour"])
    .reset_index(drop=True)
)

feature_columns = [
    column
    for column in model_df.columns
    if column not in [target, "Date"]
]

X = model_df[feature_columns]
y = model_df[target]

split_index = int(len(model_df) * 0.8)

X_train = X.iloc[:split_index].copy()
X_test = X.iloc[split_index:].copy()
y_train = y.iloc[:split_index].copy()
y_test = y.iloc[split_index:].copy()

print("학습 데이터:", X_train.shape, y_train.shape)
print("테스트 데이터:", X_test.shape, y_test.shape)
print(
    "학습 기간:",
    model_df.loc[:split_index - 1, "Date"].min(),
    model_df.loc[:split_index - 1, "Date"].max(),
)
print(
    "테스트 기간:",
    model_df.loc[split_index:, "Date"].min(),
    model_df.loc[split_index:, "Date"].max(),
)| 구분 | 크기 |
|---|---|
| 학습 데이터 | 6,772행 |
| 테스트 데이터 | 1,693행 |
노트북 원본에는 y_trian 오타와 테스트 기간을 loc[:split_index]로 출력하는 부분이 있었다. 위 코드처럼 y_train으로 통일하고 테스트 기간은 split_index 이후를 조회해야 올바른 시간 구간을 확인할 수 있다.
11. 핵심 정리
- 문자열 날짜와 층수 정보는 의미 있는 수치형 피처로 변환할 수 있다.
- Pipeline과 ColumnTransformer를 사용하면 데이터 누수를 막고 숫자형·범주형 전처리를 일관되게 적용할 수 있다.
- 주택 임대료는 긴 꼬리를 가진 목표값이므로, 로그 변환 후 평가 지표가 실제로 개선되는지 확인해야 한다.
- 자전거 수요는 시간대, 계절, 공휴일, 날씨와 함께 변한다.
- 시간·월처럼 주기적인 변수는
sin과cos를 함께 사용해 순환 구조를 표현한다. - 시계열 성격의 데이터는 미래 정보가 학습에 섞이지 않도록 시간 순서를 유지해 학습·테스트 데이터를 분할해야 한다.
