1. 문서 정보
- 제목: An Image is Worth 16×16 Words: Transformers for Image Recognition at Scale
- 저자: Alexey Dosovitskiy et al. (Google Research)
- 형식: 학술 논문 (ICLR 2021)
- 발행: 2020 (arXiv), 2021 (ICLR)
한 줄 요약
ViT는 CNN 없이 Transformer만으로 이미지를 처리할 수 있음을 보인 최초의 비전 모델로, 이미지 패치를 토큰처럼 취급하여 대규모 사전학습 시 CNN을 능가하는 성능을 달성했다.
2. 배경 및 동기
비전 분야에서는 오랫동안 CNN이 사실상의 표준 아키텍처였다.
CNN은 다음과 같은 강한 inductive bias를 내장한다:
- locality (국소성)
- translation equivariance (이동 불변성)
- 2D grid 구조
반면 NLP에서는 Transformer가 CNN/RNN을 대체하며 범용 모델로 자리 잡았다.
ViT의 핵심 질문은 다음과 같다:
“이러한 이미지 특화 inductive bias 없이도
Transformer가 이미지 인식을 잘할 수 있을까?”
ViT는 이 질문에 대해:
- 아키텍처 단순화
- 대규모 데이터 사전학습
을 통해 답을 제시한다.
3. 아키텍처 및 기술 구성
3.1 전체 구조 개요
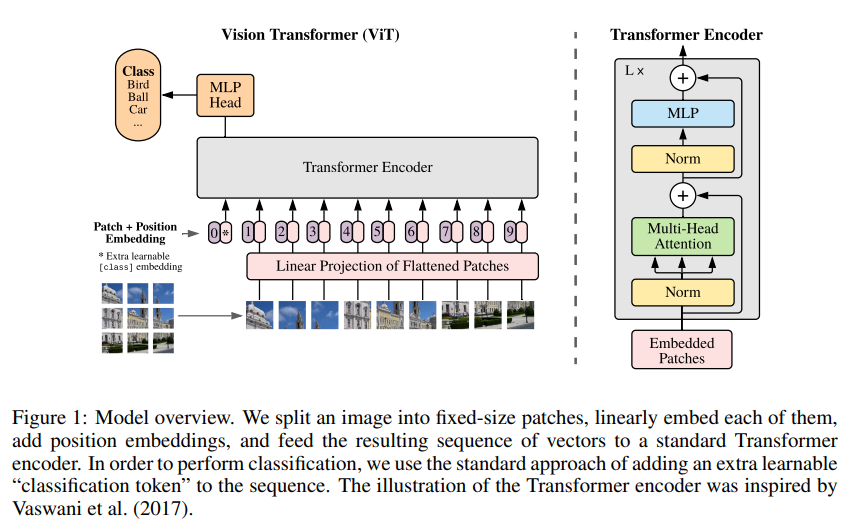
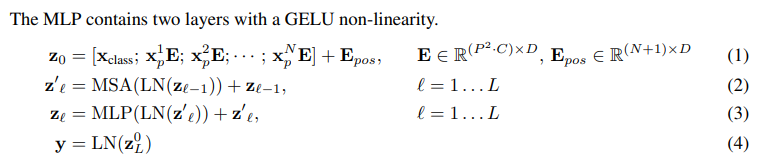
ViT는 표준 Transformer Encoder를 거의 그대로 사용한다.
Image → Patch Embedding → [CLS] Token + Position Embedding
      → Transformer Encoder (L layers)
      → MLP Head → Classification
CNN backbone ❌
Attention 기반 글로벌 처리 ⭕
3.2 Patch Embedding (핵심 아이디어)
이미지를 고정 크기 패치로 분할한다.
- 입력 이미지: H × W × C
- 패치 크기: P × P
- 패치 수: N = HW / P²
각 패치는:
- flatten → linear projection
- 하나의 token으로 취급
📌 논문의 핵심 통찰:
이미지는 2D 신호가 아니라
“패치들의 시퀀스”로 볼 수 있다
3.3 Position Embedding
Transformer는 순서 개념이 없으므로:
- 각 패치 토큰에 learnable position embedding 추가
- 2D 구조는 암묵적으로만 사용
👉 ViT는 공간 구조를 거의 강제하지 않음
3.4 Classification Token
- BERT의
[CLS]토큰과 동일 - 전체 패치 정보를 attention으로 집약
- 최종 classification은 이 토큰 기반
3.5 ViT는 이미지를 ‘이해’하는가, 아니면 ‘인코딩’하는가?
ViT를 처음 접하면 다음과 같은 근본적인 의문이 든다:
“이미지를 그냥 패치로 쪼개서
Transformer에 넣었을 뿐인데,
이게 정말 ‘이해’라고 부를 수 있는가?”
ViT는 객체, 엣지, 코너와 같은 시각적 개념을 명시적으로 모델링하지 않는다.
CNN처럼 계층적으로 feature를 쌓지도 않는다.
대신 ViT가 수행하는 것은 다음에 가깝다:
- 이미지를 패치 단위 토큰 시퀀스로 변환
- 각 패치를 의미 있는 벡터 표현(embedding)으로 인코딩
- 패치 간 관계를 self-attention으로 학습
즉 ViT에서의 “이해”란:
시각적 구조를 해석하는 것이 아니라,
패치 임베딩들이 downstream task에
유용한 관계를 맺도록 표현되는 것
이다.
이 관점에서 ViT는
- perception-driven 모델 ❌
- representation-driven 모델 ⭕
로 이해하는 것이 정확하다.
4. Inductive Bias 관점 분석 (논문의 핵심 메시지)
4.1 CNN vs ViT 비교
| 항목 | CNN | ViT |
|---|---|---|
| Locality | 강함 | 약함 |
| Translation equivariance | 내장 | 없음 |
| Global context | 제한적 | 기본 |
| Spatial bias | 강함 | 최소 |
논문에서 직접 언급:
ViT는 CNN보다 훨씬 적은 image-specific inductive bias를 가진다
4.2 Inductive Bias 주입 지점 (중요)
ViT에서 2D 이미지 구조가 수동으로 주입되는 유일한 지점은:
- Patch extraction
- Fine-tuning 시 position embedding 보간
👉 그 외에는 모든 공간 관계를 데이터로부터 학습
4.X ViT는 왜 2D 구조를 거의 강제하지 않는가?
ViT는 CNN과 달리
2D grid 구조를 모델 내부에 거의 반영하지 않는다.
논문에서 명시하듯,
ViT에서 이미지의 2D 구조가 수동으로 주입되는 지점은 오직:
- Patch extraction
- Position embedding (및 해상도 변경 시 보간)
뿐이다.
그 외 모든 공간적 관계는
attention을 통해 데이터로부터 학습된다.
이는 ViT가 다음 가설을 전제로 한다는 뜻이다:
“공간 관계는
하드코딩하지 않아도
충분한 데이터로 학습 가능하다.”
단, 이 가설은:
- ❌ 소규모 데이터
- ⭕ 대규모 사전학습
이라는 조건 하에서만 성립하며,
이 한계가 이후 Swin, Conv-ViT 계열이 등장한 이유이기도 하다.
5. 훈련 전략과 스케일링
5.1 대규모 사전학습의 중요성
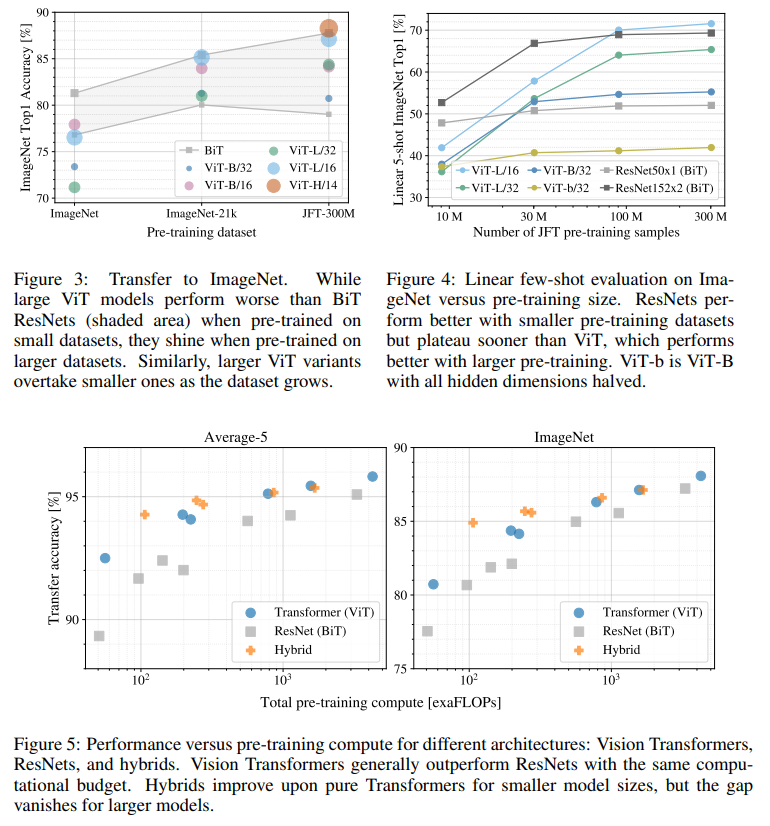
ViT는 소규모 데이터에서는 CNN보다 성능이 낮음
하지만:
- ImageNet-21k
- JFT-300M
같은 대규모 데이터에서 사전학습 시:
CNN을 명확히 능가
📌 핵심 결론:
Inductive bias ↓ → Data requirement ↑
5.2 Fine-tuning과 해상도 확장
사전학습 후 downstream task에서는:
- 기존 prediction head 제거
- 새로운 D × K classifier head 부착
- 더 높은 해상도로 fine-tuning 가능
이때:
- patch size는 고정
- position embedding은 2D interpolation으로 보정
5.3 “그냥 데이터랑 학습의 힘 아닌가?”에 대한 ViT의 입장
ViT를 둘러싼 가장 솔직한 질문은 이것이다:
“이게 구조가 뛰어나서라기보단
그냥 데이터랑 연산량 덕분에 되는 거 아닌가?”
놀랍게도 ViT 논문은 이 질문을 부정하지 않는다.
오히려 논문은 매우 명확히 다음을 인정한다:
- ViT는 소규모 데이터에서는 CNN보다 성능이 낮다
- 강한 inductive bias를 포기했기 때문에
더 많은 데이터가 필요하다
즉 ViT가 선택한 전략은:
| 선택 | 결과 |
|---|---|
| 구조적 bias 최소화 | 표현 자유도 증가 |
| 표현 자유도 증가 | 데이터 요구량 증가 |
논문의 핵심 메시지는 다음 한 문장으로 요약된다:
“이 정도의 inductive bias는
구조가 아니라 데이터로 대체할 수 있다.”
이 사고방식은 이후
CLIP → LLaVA → GPT-4V로 그대로 이어진다.
6. 실험 결과 및 성능
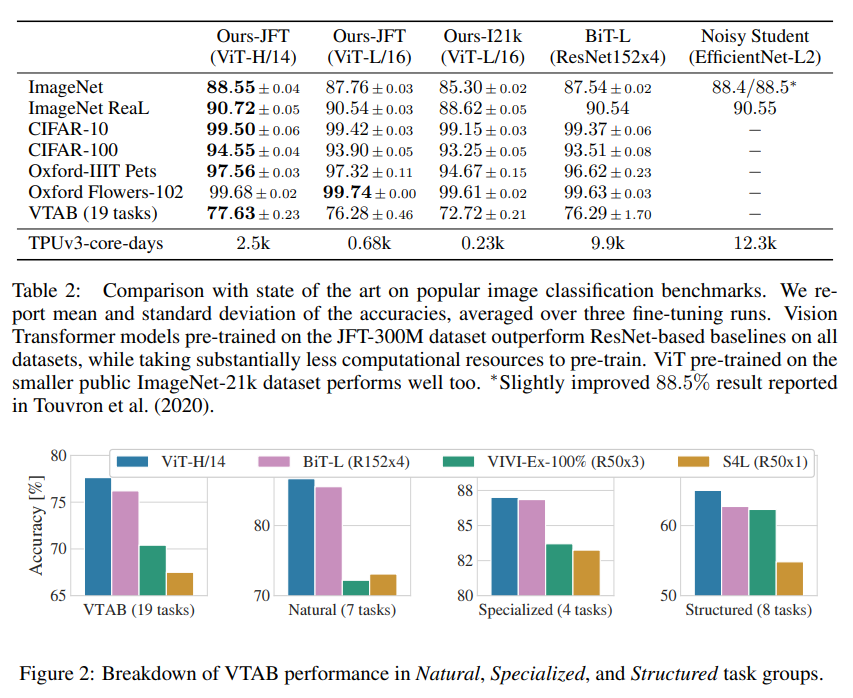
6.1 Image Classification
-
ViT-L/16, ViT-H/14 모델은
- ImageNet, CIFAR, VTAB 등에서
- ResNet 계열을 능가
특히:
- 대규모 데이터 + 큰 모델일수록 격차 확대
6.2 Transfer Learning
ViT는:
- classification
- detection
- segmentation
등 다양한 태스크로 잘 전이됨 → 범용 백본 가능성
7. 장점 및 한계
✔ 장점
-
아키텍처 단순성
- CNN 제거, Transformer 단일 구조
-
글로벌 컨텍스트 처리 능력
-
확장성 (scaling law 친화적)
-
NLP–Vision 아키텍처 통합 가능성 제시
⚠ 한계
-
데이터 의존성 매우 큼
- 소규모 데이터에서는 취약
-
학습 비용 큼
-
공간적 inductive bias 부족
→ detection / segmentation 초기 성능 저조
👉 이후 연구들이 이 한계를 보완:
- DeiT
- Swin Transformer
- Conv-ViT hybrid
8. 한 문장 요약
ViT는 이미지를 패치 시퀀스로 처리하는 Transformer 기반 비전 모델로,
이미지를 Transformer 친화적인 의미 표현으로 변환하는 인코더 역할을 수행하며,
강한 CNN inductive bias 없이도 대규모 사전학습을 통해
이미지 인식에서 SOTA 성능을 달성할 수 있음을 입증한 기념비적 연구다.
🔑 ViT 논문에서 반드시 가져가야 할 인사이트
- Vision도 결국 sequence modeling 문제
- Inductive bias는 구조가 아니라 데이터로 대체 가능
- 멀티모달·LLM 기반 비전 모델의 출발점
- LLaVA, CLIP, GPT-4V의 근본 토대
ViT가 이후 멀티모달 모델에 남긴 가장 중요한 유산
ViT의 가장 큰 공헌은
“Transformer를 비전에 썼다”는 사실이 아니다.
진짜 유산은 다음 사고 방식이다:
“이미지는 적절한 인코더를 통해
Transformer가 다룰 수 있는
의미적 시퀀스로 변환될 수 있다.”
이 전제 위에서:
- CLIP
- 이미지 인코더 + 텍스트 인코더
- 의미 공간에서 alignment
- LLaVA
- 이미지 인코더 출력 → LLM 입력 공간으로 projection
- 추론은 전적으로 LLM이 담당
이라는 구조가 가능해졌다.
즉 ViT는:
- 이미지를 “보는 방법”이 아니라
- 이미지를 ‘다음 모델이 이해할 수 있게 만드는 방법’
을 제시한 논문이다.