0. 3줄 요약
- 기본 정보: 본 논문은 "NATURE-INSPIRED POPULATION-BASED EVOLUTION OF LARGE LANGUAGE MODELS"라는 제목으로 Yiqun Zhang 등(Northeastern University, Shanghai AI Lab)이 2025년 3월 4일에 발표한 연구입니다.
- 핵심 목적 및 제안 방법: 자연계의 집단 진화(Population-based Evolution) 원리에서 착안하여, 다수의 전문가 LLM 가중치를 유전자처럼 취급해 그래디언트 업데이트 없이 교차, 변이, 계승 연산을 통해 새로운 태스크에 동적으로 적응시키는 GENOME 및 GENOME+ 프레임워크를 제안합니다.
- 주요 성과 및 학술적 의의: 200개의 적은 샘플만으로 기존 최고 모델 대비 최대 54.8%의 정확도 향상을 기록했으며, 단일 24GB 메모리의 4090 GPU 환경에서도 원활하게 동작하여 대규모 모델 튜닝에 드는 막대한 비용을 절감하고 파운데이션 모델 개발의 민주화를 앞당겼습니다.
1. 배경 및 문제 정의
- 연구 배경: LLM 생태계에는 특정 도메인에 미세 조정된 수많은 전문가 모델(Expert Models)이 존재합니다. 최근 연구들은 이러한 다양한 모델의 가중치를 병합(Merging)하여 새로운 역량을 이끌어내거나 미학습 태스크에 일반화하려는 시도를 이어가고 있습니다.
- 기존 방법의 접근 방식: 기존 방식은 TIES, DARE와 같이 사전 정의된 규칙에 따라 정적으로 가중치를 병합하거나, LoRAHub, Model Swarms와 같이 적은 양의 검증 데이터를 활용해 동적인 융합 가중치를 탐색하는 방식으로 발전해 왔습니다.
- 기존 방법의 한계: 기존의 병합 방식들은 궁극적으로 '단일 모델'을 만들어내는 데 집중합니다. 이는 추론 과정에서 다수 모델이 가진 앙상블 및 협력적 집단지성을 상실하게 만들며, 탐색 과정에서도 자연계가 보여주는 다각적인 진화 메커니즘(단순 유전자 교차를 넘은 경험의 계승 및 집단 의사결정)을 온전히 활용하지 못한다는 구조적 한계를 가집니다.
- 문제 정의: 본 연구는 비용이 많이 드는 역전파(Backpropagation) 과정 없이, 자연계의 집단 진화 원리를 빌려와 다수의 LLM 개체군(Population)이 협력적으로 파라미터를 최적화하고 완전히 새로운 태스크에 효과적으로 적응할 수 있는 프레임워크를 설계하는 것을 목표로 합니다.
2. 제안 방법 (Method)
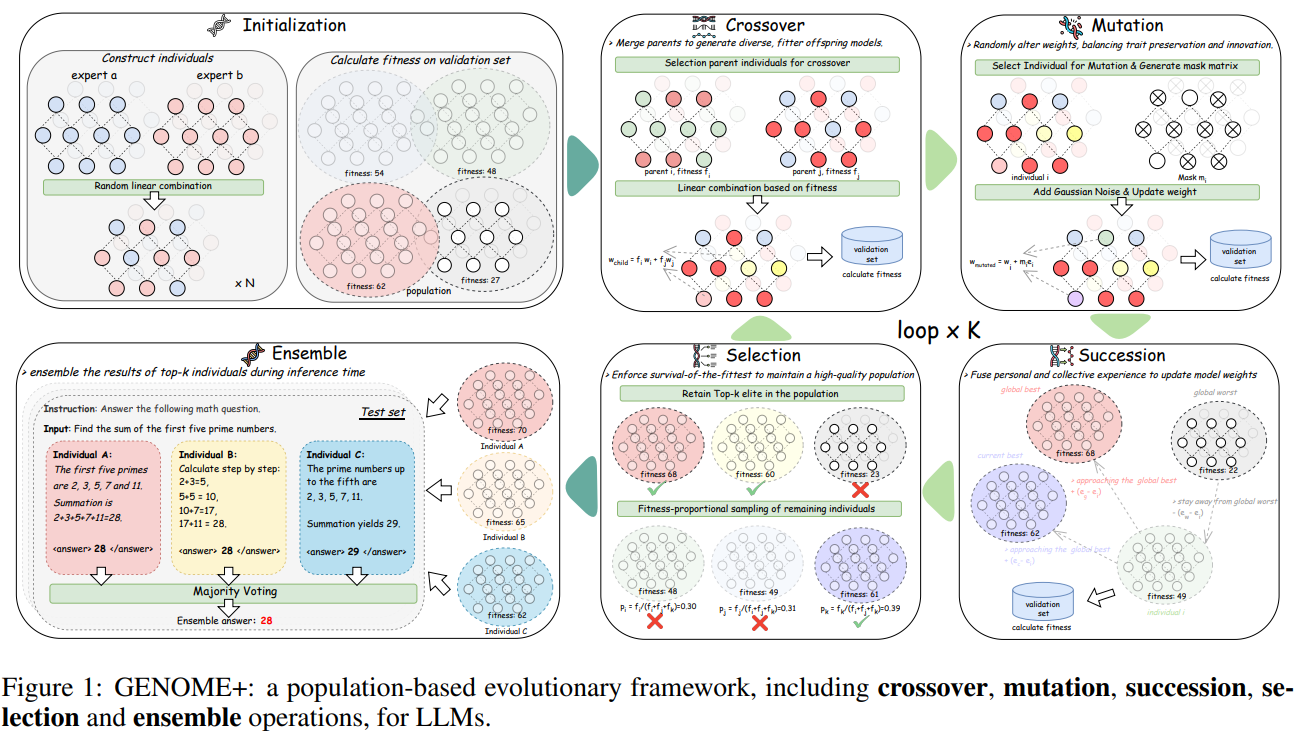
본 논문은 LLM의 가중치(구체적으로 LoRA 파라미터)를 유전자(Gene)로, 검증 세트에서의 성능을 적합도(Fitness)로 간주하여 최적화를 수행하는 GENOME 프레임워크와 이를 확장한 GENOME+를 제안합니다.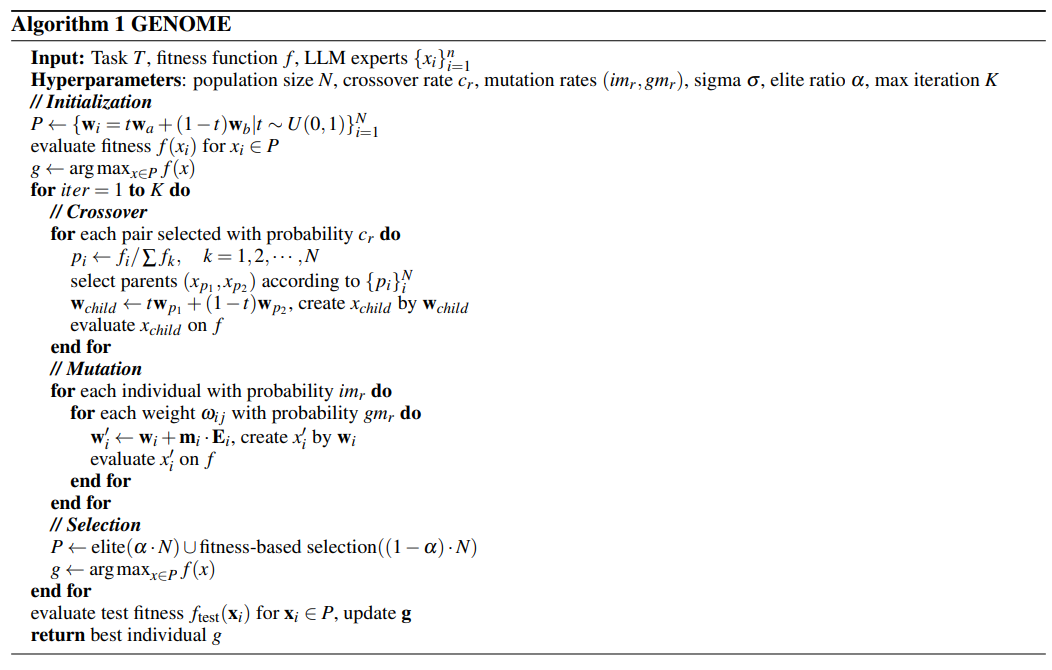
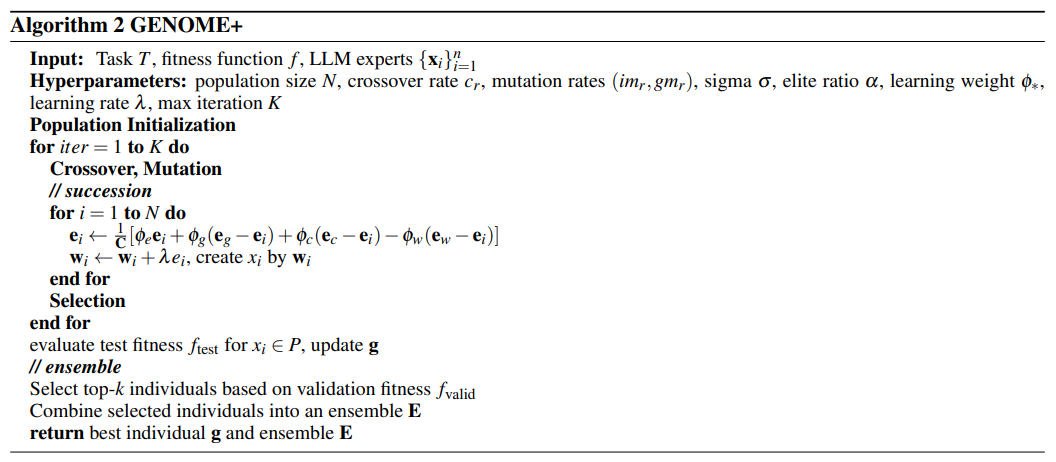
학습 (Training / Evolution) 파이프라인
데이터가 네트워크에 주입되고 진화하는 과정은 크게 초기화, 교차, 변이, 계승, 선택의 단계로 이루어집니다. 이 과정은 모델 내부의 LoRA 가중치 공간에서 직접적인 행렬 연산을 통해 이루어지며, 손실 함수에 기반한 미분이 전혀 개입되지 않습니다.
- 초기화 (Initialization): 사전에 훈련된 개의 전문가 모델 풀에서 무작위로 2개의 모델 를 추출합니다. 이들의 LoRA 가중치 와 를 랜덤 스칼라 를 사용하여 선형 결합()하는 방식으로, 개의 개체로 이루어진 초기 개체군(Population)을 구성합니다.
- 교차 (Crossover): 우수한 특성을 결합하기 위해 개체군 내에서 적합도 비례 확률 에 따라 부모 쌍을 선택합니다. 선택된 부모 모델 의 적합도를 기반으로 가중치 스칼라 를 구한 뒤, 새로운 자식 개체의 가중치를 로 병합하여 다양성을 확보합니다.
- 변이 (Mutation): 탐색 공간의 확장을 위해 설정된 확률(imr)에 따라 개체를 선택하고, 선택된 개체의 개별 가중치에 확률(gmr)적으로 이진 마스크 를 적용합니다. 마스킹된 가중치에는 가우시안 노이즈 가 더해져 파라미터가 섭동()되며, 이를 통해 국소 최적점(Local minima) 탈출을 유도합니다.
- 계승 (Succession, GENOME+ 전용): 입자 군집 최적화(PSO)에서 영감을 받아 각 개체가 경험을 벡터 형태로 누적합니다. 전체 최우수 모델(), 현재 세대 최우수 모델(), 전체 최악 모델(), 그리고 본인의 과거 경험()을 조합하여 다음 수식으로 경험 벡터를 업데이트합니다.업데이트된 경험은 학습률 를 곱해 현재 가중치에 직접 더해집니다 (). 이는 실패를 피하고 성공을 벤치마킹하는 엔지니어링 구조를 가중치 공간에 수학적으로 이식한 것입니다.
- 선택 (Selection): 평가를 마친 개체군 중 상위 비율의 엘리트 모델을 무조건 생존시키고, 나머지 공간은 전체 개체군을 대상으로 적합도 기반의 룰렛 휠 선택(Fitness-proportional sampling)을 적용하여 세대를 갱신합니다.
추론 (Inference) 파이프라인
- 앙상블 (Ensemble, GENOME+ 전용): 단일 최적 모델만 사용하는 기존 방법과 달리, GENOME+는 테스트 시점에서 가장 적합도가 높은 상위 개의 개체를 모두 활용합니다. 객관식의 경우 '다수결(Majority Voting)'을 채택하고, 생성형 태스크의 경우 텍스트 임베딩 후 BERTScore 기준 유사도가 가장 높은 결과를 도출하는 방식으로 집단지성 메커니즘을 완성합니다.
3. 실험 결과 (Experiments)
- 실험 환경 및 비교 대상: 7개 능력 범주(수학, 코딩, 논리적 추론 등)에 걸친 12개 데이터셋이 사용되었습니다. Gemma-2-2b-it 기반으로 훈련된 10개의 전문가 모델을 초기 풀로 활용하였으며, Model Swarms, LoraHub, DARE TIES 등 7개의 융합 및 최적화 베이스라인과 200개의 적응(Adaptation) 샘플이라는 동일 조건 하에서 비교되었습니다.
- 핵심 성능 결과: GENOME+는 모든 베이스라인을 압도했습니다. 평가 대상 중 '최우수 단일 모델(Best Single)' 대비 평균 24.06%, 직전 SOTA인 Model Swarms 대비 평균 10.75% 향상된 정확도를 기록했습니다.
- 심층 분석 및 어블레이션:
- 추론(Reasoning) 능력 강화: DROP 데이터셋에서 54.80%, MGSM 데이터셋에서 19.31% 성능 향상을 보이며 수학 및 논리적 추론처럼 복잡성을 띠는 태스크에서 집단 진화 메커니즘이 크게 기능함을 입증했습니다.
- 다중 태스크 및 제로샷 일반화: 모델 개체군이 두 개의 독립적인 태스크에 동시 적응해야 하는 상황이나, 추가 학습 샘플이 주어지지 않은 제로샷 전이(Zero-shot Transfer) 상황에서도 타 방법들과 달리 성능 저하 없이 안정적인 우위를 지켰습니다.
- 어블레이션 스터디: 각 연산자를 제거하며 평가한 결과, 추론 단계에서의 앙상블(Ensemble) 연산 제거 시 성능 하락폭(-11.27%)이 가장 컸으며, 올바른 선택(Selection) 연산과 계승(Succession) 연산 역시 높은 적합도를 유지하는 데 필수적임이 정량적으로 증명되었습니다.
4. 한계점 및 시사점
- 이론 및 성능적 한계:
- 지식 집약적 태스크의 한계: 법률이나 역사 등 외부 지식을 묻는 태스크(Knowledge-based)에서는 추론 태스크 대비 성능 향상 폭이 상대적으로 미미했습니다. 파라미터 조합만으로는 모델이 학습하지 않은 팩트를 새롭게 창출할 수 없기 때문입니다.
- 하이퍼파라미터 민감도: 교차율(Crossover Rate)과 개체 변이율(Individual Mutation Rate)이 극단적으로 높아지면 탐색 공간이 지나치게 커져 최적화(진화)에 소요되는 연산 시간이 급격하게 증가하는 트레이드오프가 존재합니다.
- 엔지니어링 고려 사항:
- 완전히 새로운 태스크에 적응하기 위해 여전히 최소 200개 규모의 정답 라벨이 포함된 검증(Validation) 데이터셋이 요구됩니다.
- 상위 개 모델을 활용하는 앙상블 시스템 특성상 추론 단계에서 다중 모델을 VRAM에 로드하거나 병렬로 실행해야 하므로, 메모리 대역폭 관리 및 추론 지연 시간(Latency) 방어를 위한 시스템 엔지니어링이 필수적입니다.
- 연구의 시사점:
본 연구는 그래디언트 업데이트라는 병목 현상 없이, 단순한 행렬 스칼라 연산(교차/변이/경험 계승)만으로 파라미터 공간을 최적화할 수 있음을 증명했습니다. 24GB VRAM을 지닌 소비자용 단일 GPU(RTX 4090)에서도 무리 없이 구현이 가능하다는 점은, 막대한 자본이 투입되는 파운데이션 모델 개발 패러다임 속에서 기학습된 모델 리소스를 재활용하고 커뮤니티 주도의 모델 발전을 가능케 하는 매우 실무적이고 가치 있는 접근입니다.
AI 공부합니다