0. 3줄 요약
- 기본 정보: ICLR 2019에서 발표된 Jonathan Frankle과 Michael Carbin(MIT CSAIL)의 논문 "The Lottery Ticket Hypothesis: Finding Sparse, Trainable Neural Networks"입니다.
- 목적 및 제안 방법: 무작위로 초기화된 빽빽한(dense) 신경망 내부에 원본 네트워크와 동일하거나 더 높은 성능을 내는 희소한(sparse) 부분 신경망인 '당첨 티켓(Winning Ticket)'이 존재함을 밝히고, 반복적 가지치기(Iterative Pruning)와 초기화 가중치 복원(Reset) 기법을 통해 이를 추출하는 방법을 제안합니다.
- 의의: 기존 방법론이 학습 완료 후 추론 단계의 모델 압축에만 집중했던 한계를 극복하고, 학습 초기부터 효율적으로 훈련될 수 있는 구조와 초기화의 결합을 증명함으로써 신경망 최적화 및 일반화(Generalization) 이론에 대한 새로운 통찰을 제공합니다.
1. 배경 및 문제 정의
- 연구 배경 및 분야의 흐름: 딥러닝 분야에서는 모델 압축 및 가지치기(Pruning) 기법을 통해 학습된 네트워크의 파라미터를 90% 이상 줄이면서도 정확도를 유지해 왔습니다. 이를 통해 모델의 저장 공간을 줄이고 추론(Inference) 단계의 연산 효율을 크게 향상시켰습니다.
- 기존 방법들의 핵심 접근 방식: 일반적인 가지치기 기법은 전체 네트워크를 먼저 완전히 학습시킨 후, 가중치의 크기(magnitude)가 작은 연결들을 제거하고, 남은 가중치들을 기반으로 모델을 미세 조정(fine-tuning)하는 파이프라인을 따릅니다.
- 기존 방법의 한계: 가지치기로 생성된 희소한 네트워크 구조를 처음부터 다시 학습(Train from scratch)시키고자 할 경우, 원래의 네트워크보다 학습 속도가 크게 느려지며 최종 정확도 또한 하락합니다. 즉, 압축된 구조는 추론 시에는 효율적이지만, 학습 단계 자체의 연산량을 줄이는 데는 활용되지 못하는 문제가 있었습니다.
- 핵심 문제 정의: 본 연구는 "처음부터 독립적으로 학습시킬 수 있으면서도 원본 모델과 동등한 성능을 내는, 작고 희소한 부분 네트워크(Subnetwork)를 사전에 식별해낼 수 있는가?"라는 문제를 제기하고, 이를 해결하는 복권 가설(Lottery Ticket Hypothesis)을 검증합니다.
2. 제안 방법 (Method)
- 전체 방법의 핵심 아이디어: 거대하게 과매개변수화(Overparameterized)된 신경망 안에는 초기화 당시부터 학습에 매우 유리한 가중치와 구조의 결합, 즉 '초기화 복권에 당첨된 부분 네트워크(Winning Ticket)'가 숨어 있다는 것입니다.
- 입력 데이터의 표현 및 전처리 방식: 입력 데이터 는 전체 파라미터 를 가진 피드포워드 신경망 에 주입됩니다. 본 논문에서는 이진 마스크 을 도입하여 특정 연결을 활성화 또는 비활성화합니다. 데이터는 물리적으로 삭제된 가중치를 건너뛰고, 요소별 곱 연산이 적용된 형태인 구조를 통과하며 변환됩니다.
- 모델 및 알고리즘의 세부 구조:
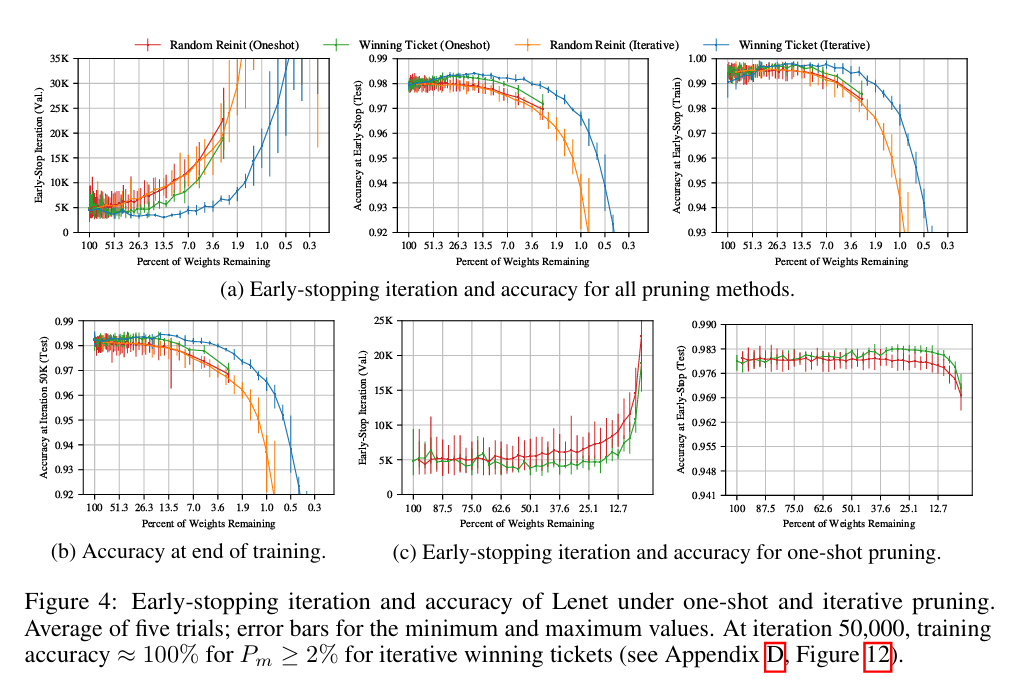
단일 단계로 파라미터를 크게 잘라내는 일회성 가지치기(One-shot pruning)보다, 회에 걸쳐 점진적으로 잘라내는 반복적 가지치기(Iterative Pruning) 알고리즘을 핵심 메커니즘으로 사용합니다. 이 메커니즘은 다음과 같은 구체적인 학습 및 추론 파이프라인을 따릅니다.
학습(Training) 파이프라인
- 신경망 를 무작위로 초기화합니다. (초기 가중치 )
- 주어진 훈련 데이터셋에 대해 SGD 또는 Adam 최적화기를 사용하여 반복(iterations) 동안 네트워크를 학습시켜 도출된 파라미터 를 얻습니다.
- 에서 가중치 크기가 가장 작은 파라미터 중 를 가지치기하여 이진 마스크 을 생성합니다.
- [핵심 디테일] 마스크에 의해 살아남은 나머지 파라미터들의 값을 학습된 가 아닌, 1단계의 초기화 값 로 완전히 초기화(Reset)합니다. 도출된 가 당첨 티켓이 되며, 목표한 압축률에 도달할 때까지 2~4단계를 반복합니다.
추론(Inference) 파이프라인
학습 파이프라인을 통해 식별된 희소 마스크 과 이에 대응하는 초기화 가중치 집합만을 사용하여 모델을 훈련시킨 후, 추론 단계에서는 가지치기된 빈 공간의 연산을 생략한 형태로 평가를 수행합니다.
- 기존 방법론과의 기술적 차별성: 기존 기법은 가지치기 후 '살아남은 현재 가중치 값'을 유지하여 미세 조정을 진행하지만, 본 연구는 '살아남은 연결 구조(마스크 )'만 유지한 채 가중치 값 자체는 학습 이전의 원본 초기화 값()으로 반드시 되돌린다는 점에서 구조적, 이론적으로 명확한 차별성을 가집니다.
3. 실험 결과 (Experiments)
- 사용된 데이터셋 및 평가 환경: 완전 연결망(Lenet)은 MNIST 데이터셋에서 평가되었고, 합성곱 신경망(VGG 기반의 Conv-2/4/6, Resnet-18, VGG-19)은 CIFAR10 데이터셋에서 평가되었습니다.
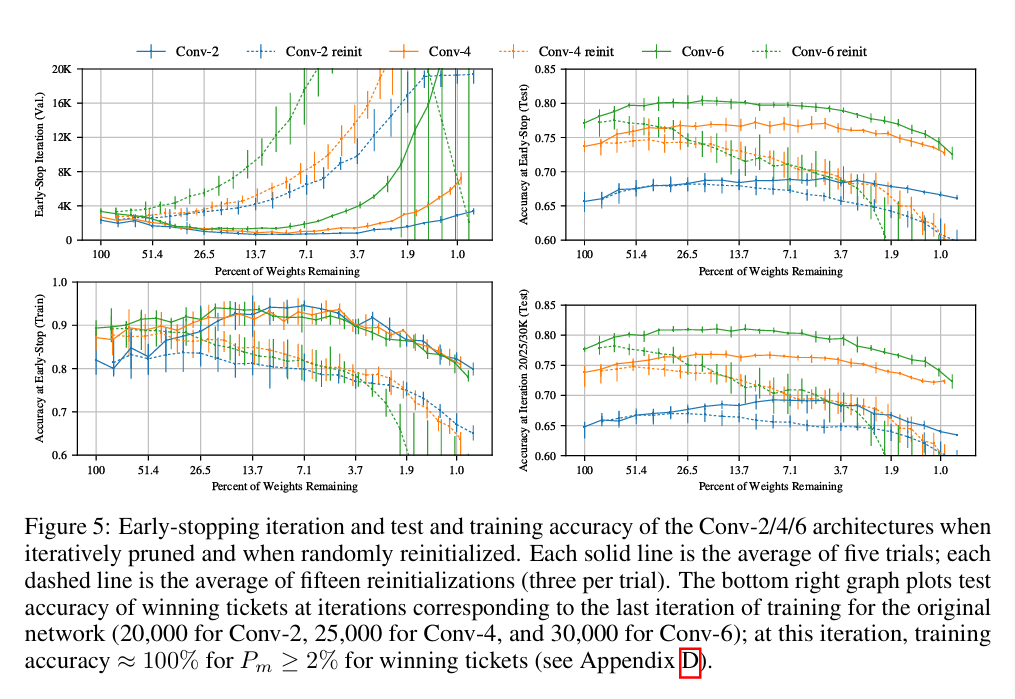
- 비교 대상 및 실험 세팅: 제안된 초기화 값을 유지하는 당첨 티켓(Winning Ticket) 방법론과, 구조(마스크 )는 동일하게 유지하되 가중치를 완전히 새로운 무작위 값으로 재초기화(Random Reinit)한 하위 네트워크를 원본 모델(Unpruned Network)과 정량적으로 비교하였습니다.
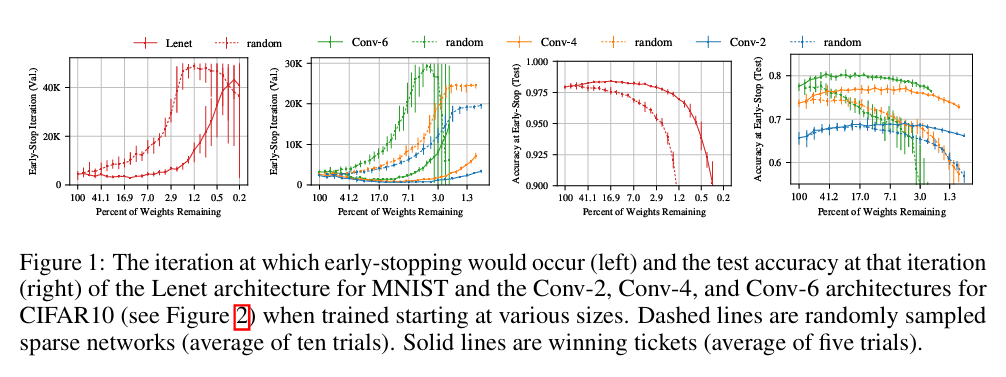
- 핵심 성능 결과: 발견된 당첨 티켓들은 원본 파라미터 수의 10% ~ 20%(혹은 그 이하)에 불과한 크기임에도 불구하고, 원본 네트워크와 동등하거나 최대 3.5%p 더 높은 테스트 정확도를 기록했습니다. 또한, 최소 검증 손실에 도달하는 조기 종료(Early-stopping) 시점이 최대 3.5배 더 빨라졌습니다.
- 어블레이션 스터디 및 성능 향상 해석: 당첨 티켓의 구조를 유지한 채 가중치만 무작위로 재초기화한 실험(Random Reinit)에서는 네트워크의 학습 속도가 현저히 느려지고 최종 정확도가 크게 하락했습니다. 이는 부분 신경망의 성능이 단순한 '희소 구조' 덕분이 아니라 '특정 초기화 값'과의 결합에 기인함을 강력하게 증명합니다. 또한 Dropout을 함께 적용했을 때 티켓 추출의 시너지 효과가 발생함을 확인했습니다. 깊은 네트워크(Resnet-18, VGG-19)의 경우 층별(layer-wise) 가지치기 대신 전체 가중치를 기준으로 하는 전역 가지치기(Global pruning)를 적용하고, 높은 학습률에서는 학습률 웜업(Warmup) 스케줄링을 동반해야만 당첨 티켓을 온전히 추출할 수 있음이 실험적으로 해석되었습니다.
4. 한계점 및 시사점
- 방법의 한계점:
- 연산량 제약: 당첨 티켓을 찾기 위한 핵심 기법인 '반복적 가지치기'는 네트워크를 목표 압축률에 도달할 때까지 매번 처음부터 끝까지 재학습시켜야 하므로 탐색 과정의 컴퓨팅 비용이 기하급수적으로 높습니다. 이로 인해 본 논문에서는 Imagenet과 같은 대용량 데이터셋까지 연구를 확장하지 못했습니다.
- 하드웨어 엔지니어링 한계: 사용된 가지치기 방식이 가중치 개별 단위의 비구조적 가지치기(Unstructured magnitude pruning)이므로, 이론적인 연산량은 줄어들지만 실제 현대 GPU 하드웨어나 라이브러리 구조상 즉각적인 추론 가속이나 메모리 감소 효과로 직결되지는 않는다는 제약 조건이 존재합니다.
- 실제 환경 적용 시 고려 과제: 깊은 모델 환경에서 당첨 티켓을 찾기 위해서는 학습률 웜업과 같은 섬세한 하이퍼파라미터 튜닝이 필수적이며, 탐색 연산 비용을 줄일 수 있는 One-shot 기법이나 대안적 알고리즘의 개발이 선행되어야 실제 상용 훈련 파이프라인에 적용할 수 있습니다.
- 연구가 가지는 의미: 딥러닝 모델이 왜 수많은 파라미터를 가져야만(Overparameterization) 학습이 잘 되는지에 대한 이론적 해답을 제시합니다. 즉, 파라미터가 많을수록 최적의 구조와 가중치를 가진 '당첨 티켓'을 포함할 확률이 높아지기 때문이라는 해석을 가능케 합니다. 이는 차후 학습을 완료하고 압축하는 것이 아니라, 학습 초기 단계부터 극도로 효율적인 희소 네트워크를 훈련시키는 새로운 아키텍처 설계와 최적화 이론의 기반이 됩니다.
AI 공부합니다