04 이미지 분할과 객체 인식(2)
실전! 프로젝트로 배우는 딥러닝 컴퓨터비전 (영상분석 이론부터 엔비디아 젯슨 나노를 활용한 자율주행 실습까지) 도서를 바탕으로 작성된 글입니다.
4.3 YOLO: 최초의 실시간 객체 인식 네트워크
앞에서 설명한 Faster R-CNN의 객체 검출 기본 기능은 분류와 바운딩 박스 회귀를 수행하는 Fast R-CNN과 후보 영역에 객체가 있는지 판단해 제안해 주는 RPN의 두 가지로 네트워크가 구성된다. 따라서 정확도는 뛰어나지만, 작업 시간은 길어질 수밖에 없다는 단점이 있다. 즉, 실시간 객체 인식을 하기 어려운 구조이다.
YOLO가 제안하는 실시간 객체 인식 방안은 이 두 가지 네트워크를 하나로 합해 효율성을 극대화하는 것이다. YOLO 이후의 네트워크가 대부분 YOLO와 같이 하나의 네트워크에서 객체 인식을 처리하는 방식을 채택하게 됨으로써, 객체 인식 네트워크는 크게 Faster R-CNN으로 대표되는 투 스테이지(2-stage) 네트워크와 YOLO와 SSD로 대표되는 원 스테이지(1-stage) 네트워크로 분류된다. 대락 투 스테이지는 정확한데 느리고, 원 스테이지는 빠르지만 정확도가 다소 떨어진다는 평가를 받지만, 근래 들어 원 스테이지의 경우에도 정확도가 크게 향상되었다.
YOLO: You Only Look Once
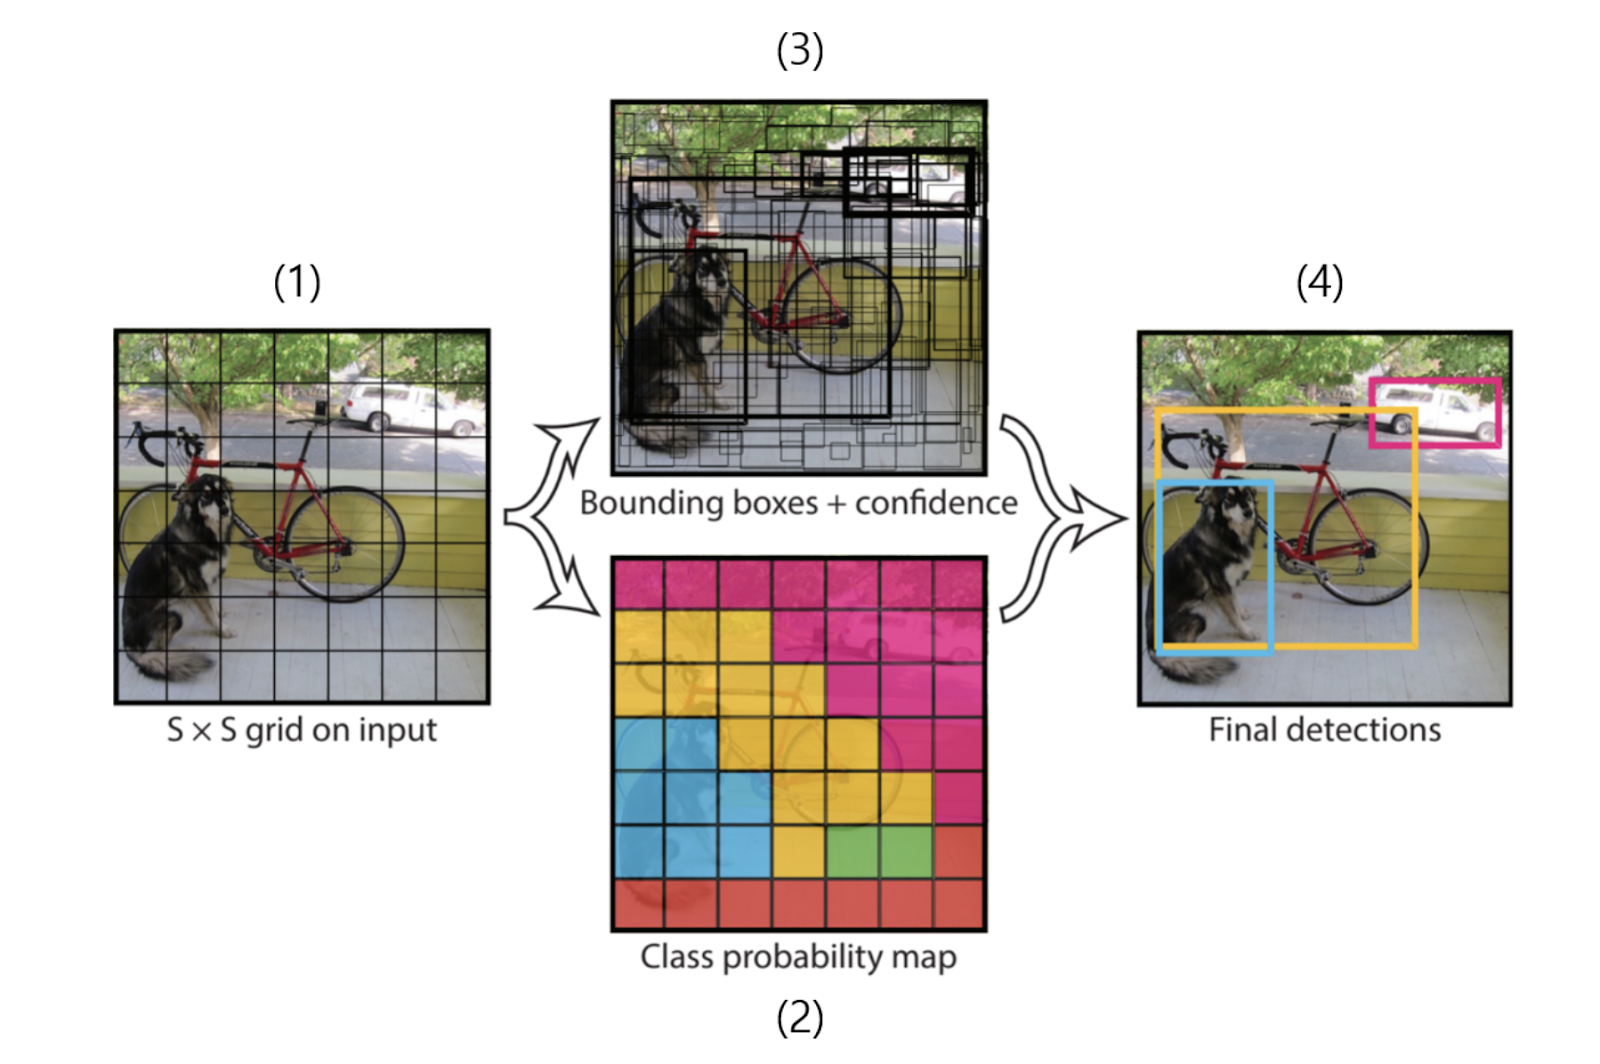
조셉 레드몬(Joseph Redmon)이 2016년에 발표한 YOLO는 'You only look once'의 줄임말로, 이미지를 한 번에 단일 신경망에 통과시켜 바운딩 박스의 위치와 크기, 신뢰도 점수(confidence score), 그리고 클래스를 예측하는 방법이다. 즉, 하나의 네트워크에서 후보 영역에 객체가 있는지 판단하는 객체성(objectness)을 이미지 분류와 바운딩 박스 회귀와 함게 진행하는 것이다.
-
모델
입력 이미지를 S X S 그리드 영역으로 나눈 후(논문은 S=7) 각 그리드 영역에서 먼저 물체가 있을 만한 후보 바운딩 박스 B개(논문에서는 2개)를 예측한다.각 후보 박스에서 신뢰도(confidence)를 계산한다. 신뢰도 점수(confidence score)는 해당 그리드에 물체가 있을 확률 Pr(Object)과 예측한 박스와 정답(ground truth) 박스가 겹치는 영역의 비율을 나타내는 IoU를 곱해서 계산한다. (바운딩 박스 회귀)
그리드마다 C개의 클래스에 대해(논문은 20개) 해당 클래스가 될 확률을 계산하며, 수식은 다음과 같다. (이미지 분류)
이렇게 YOLO는 입력 이미지를 그리드(grid)로 나누고, 그리드별로 바운딩 박스 회귀와 분류를 동시에 수행한다. 바운딩 박스는 다음과 같이 구성된다.
(x, y 좌표: 바운딩 박스의 중심점 좌표로 그리드 cell 안에서 정의되며 0~1로 정규화된다.)
(width, height: 전체 이미지의 너비, 높이의 비율로 정의되는데 바운딩 박스의 크기를 나타내며 역시 0~1로 정규화됨)
(confidence: 예측된 바운딩 박스와 정답 바운딩 박스의 IoU) -
네트워크 설계
224X224 크기의 GoogLeNet 분류 모델로 사전 학습시키고, 이후에는 입력 이미지로 448X448 크기의 이미지만 받는다. 그리고 앞쪽 20개의 콘볼루션 레이어는 고정한 채 뒷단의 4개의 레이어만 객체 인식 태스크에 맞게 학습시킨다.YOLO 네트워크는 24개의 Conv 레이어와 2개의 FC 레이어로 구성된다. 하지만 GoogLeNetd의 인셉션 모듈 대신 3X3 Conv 레이어 뒤에 1X1 Conv 레이어를 활용해 이전 레이어의 feature map 부피를 줄인다.
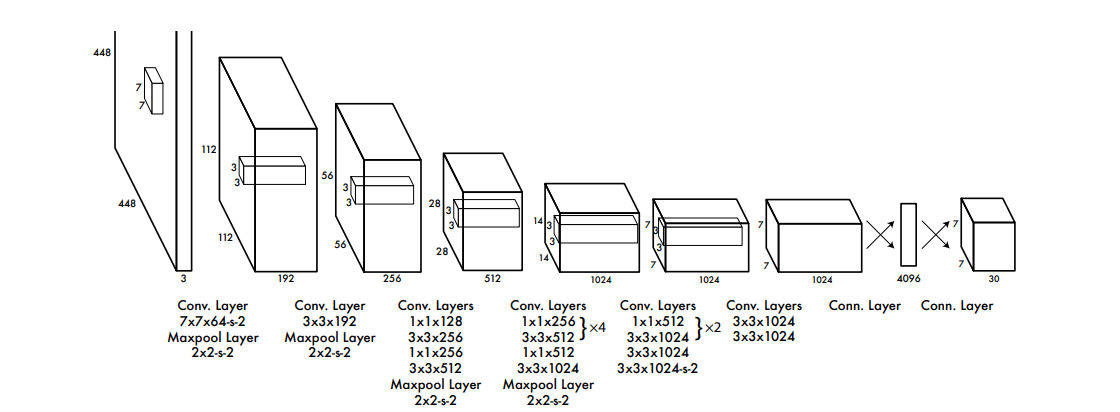
이 모델의 마지막 레이어의 결과는 7X7X30 텐서가 된다. 마지막 레이어의 텐서를 좀 더 자세히 살펴보면, 하나의 박스는 바운딩 박스 좌푯값 4개(x, y, w, h)와 신뢰도(confidence) C를 포함해 (x, y, w, h, C)라는 5차원 벡터이며 박스가 2개이기 때문에 10차원 벡터가 된다.
그 다음에 오는 20차원 벡터는 해당 클래스가 특정 클래스일 확률값이며, 여기서는 클래스가 20인 dataset을 사용했기 때문에 20차원 벡터로 표현된다.
이제 클래스 점수(Class Score)를 구한다. 특정 클래스일 확률값은 각 박스의 신뢰도를 클래스별 확률값과 곱하면 얻을 수 있으므로, $Pr(class_i) * IoU$가 된다.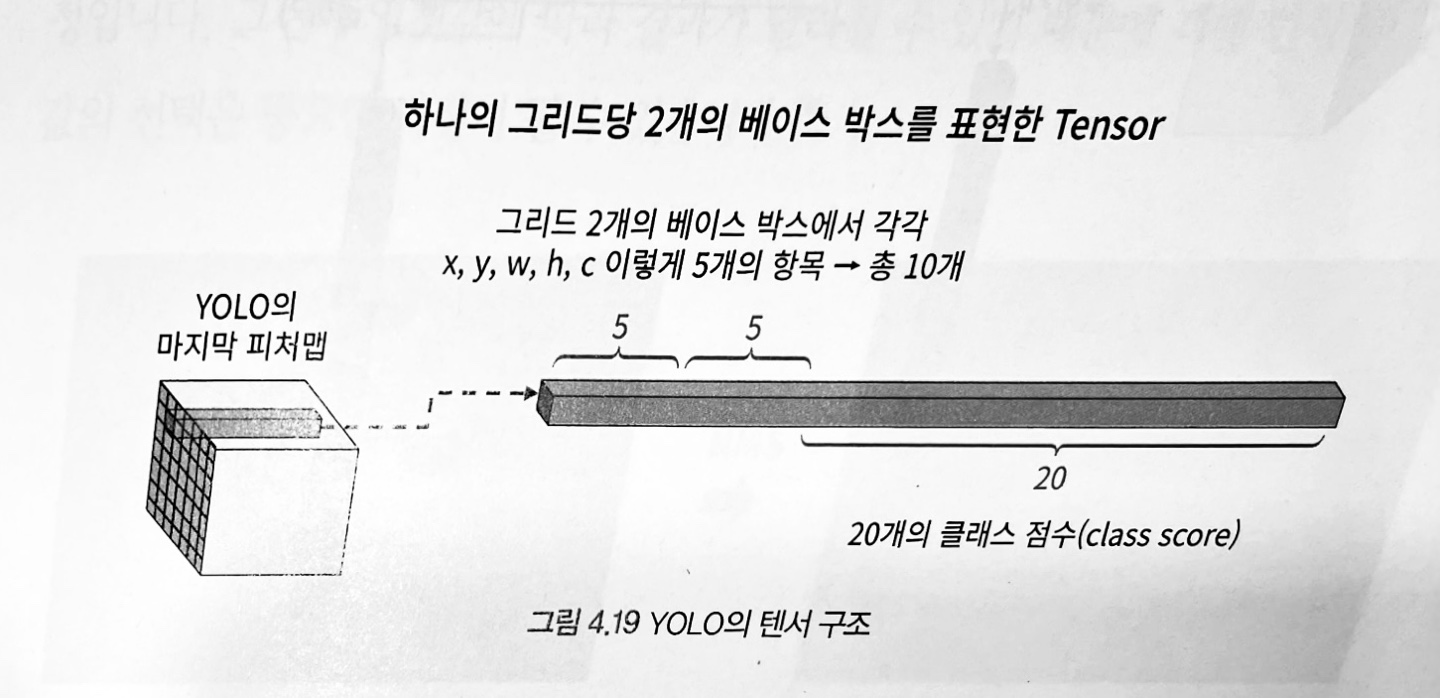
각 박스의 신뢰도() x 클래스별 확률값()
= 클래스 점수()이제 이 작업을 그림과 같이 모든 베이스 박스(Base Box)마다 적용하면 된다.
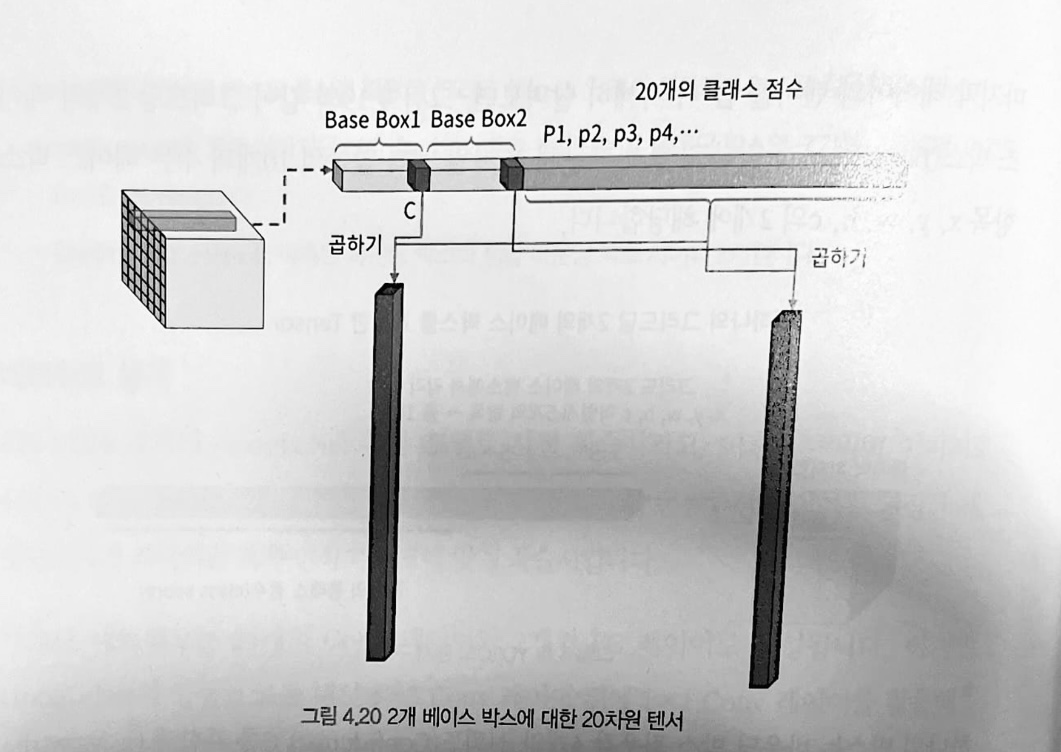
이러한 베이스 박스의 클래스 점수 벡터를 7x7 그리드 숫자만큼 시행하면, 2x7x7'개'의 벡터를 얻는다. 이제 내림차순 정렬을 한 후 마지막으로 NMS 과정을 거치면 각 그리드별, 클래스별 가장 높은 박스 정보를 얻어낼 수 있다.
NMS (non-max suppression)
입력: 제안된 바운딩 박스 목록 B, 해당 신뢰도 점수 S, 중첩 임곗값 N
출력: 필터링된 영역 목록 D. (초깃값은 비어 있는 상태)- 신뢰도 점수가 가장 높은 바운딩 박스를 선택하고 B에서 제거하고 D에 추가한다.
- 이제 D에 있는 바운딩 박스의 IoU를 다른 모든 바운딩 박스와 함께 계산한다. 그 결과 IoU가 임곗값 N보다 큰 경우 B에서 제거한다.
- 다시 B의 나머지 영역 중 가장 신뢰도가 높은 것을 B에서 제거하고 D에 추가한다.
- 다시 한번 이 바운딩 박스와 B의 모든 바운딩 박스와의 IoU를 계산한다. 그리고 임곗값보다 큰 경우 B에서 제거한다.
- 손실 함수
YOLO의 손실 함수는 매우 세밀하게 구성돼 있다. 객체 인식에 사용되는 여러 가지 성분에 대한 오차를 별도로 구한 후 모두 더해 총손실(total loss)을 구하는 방식이다.
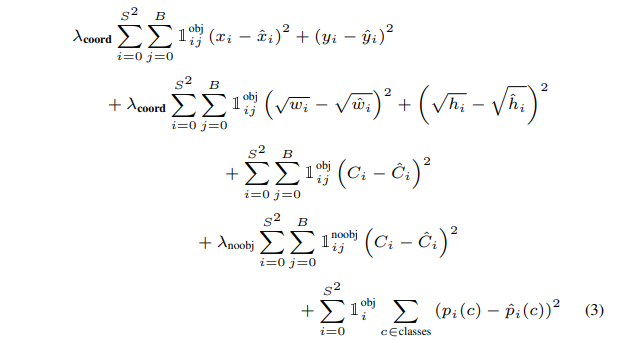 첫 줄부터 보면
(1): 그리드에 있는 객체의 바운딩 박스 중 x, y 좌표의 오차
(2): 그리드에 있는 객체의 바운딩 박스 중 w, h 좌표의 오차
(3): 객체가 있는 경우에 대한 신뢰도 오차
(4): 객체가 있는 경우에 대한 신뢰도 오차
(5): 클래스별 확률값 오차
- 단점
YOLO의 단점으로는 '겹치는 물체에 대한 검출이 가장 잘 안 된다'가 가장 많이 알려져 있다. 논문에는 다음과 같은 내용이 언급돼 있다.- 각 그리드 셀은 하나의 클래스만을 예측하기 때문에 객체가 겹쳐 있으면 제대로 예측하기 어렵다.
- 바운딩 박스의 형태가 트레이닝 데이터를 통해서만 학습되므로 새로운 형태의 경우 정확히 예측하지 못한다.
- 박스의 위치가 다소 부정확하다.
YOLOv2: 더 좋은, 더 빠른, 더 강력한
YOLO의 다음 버전인 YOLO2는 논문에서 성능과 속도를 모두 개선하여 SSD(Single Shot MultiBox Detector)보다 뛰어나다고 강조하고 있다. YOLOv2는 네트워크의 크기를 조절해 FPS(Frames Per Second)와 mAP(Mean Average Precision)을 균형 있게 조절할 수 있다.
SSD300은 이미지 입력 데이터의 크기가 300X300이고 SSD512는 512X512인 네트워크이다. SSD300은 빠르지만 성능이 낮고, SSD512는 느리지만 성능이 높다.
하지만 YOLOv2는 네트워크를 키우면 SSD512보다 더 빠르면서 성능이 좋고, 네트워크를 작게 해도 SSD300보다 느리지만 성능이 좋기 때문에 어떤 경우에서 SSD의 성능을 능가한다.
YOLOv2의 성능 향상 요인은 다음과 같다.
-
배치 정규화
배치 정규화의 핵심은 정규화된 feature map을 다시 한번 채널별로 를 곱해주고 를 더해주는 식을 만든 다음, 이것을 배치 정규화 레이어(Batch Normalization Layer)로서 CNN 네트워크에 추가한 후 역전파 과정을 통해 훈련 시간 동안 최적화한다는 데 있다.
YOLOv2에서는 모든 convolution layer에 배치 정규화를 추가해 mAP가 2% 향상됐다. -
고해상도 이미지 분류
객체 인식 네트워크에서 크게 권장되는 방법으로 2단계 학습 방법이라고 한다. 먼저 뒤에서 나올 Darknet-19를 이미지 분류 네트워크로 사용해 이미지넷 데이터를 10에포크로 학습시킨다. 학습시킨 마지막 conv 레이어와 평균 풀링(Avgpool), 소프트맥스(Softmax)를 제거하고 객체 인식 네트워크를 4개 추가한다. 이 최종 네트워크로부터 2단계 학습인 바운딩 박스와 객체 검출에 대한 학습이 되는 형태이다.
이렇게 학습을 2단계로 나눠서 하는 것은 처음부터 바운딩 박스와 클래스 분류를 같이 학습시키기 어려워 전이학습 기법을 사용하는 것이다.
YOLOv2에서는 이 고해상도 이미지 분류(High Resolution Classifier)를 적용해 mAP를 4% 향상했다. -
convolutional과 멀티 스케일링 훈련
YOLOv2는 FCN 방식을 도입해 입력 레이어와 feature map의 크기를 원하는 방식으로 조절할 수 있게 했다. 추가로 추론 속도도 향상되고, 더불어 최종 그리드 셀들의 수용 영역(receptive field, 출력 레이어의 뉴런 하나에 영향을 미치는 입력 뉴런들의 공간 크기)이 더 커지는 효과도 생겼다고 한다.특히 최종 feature map의 크기가 홀수가 되게 했는데, 이로써 그리드 셀이 feature map의 중앙 부분에 위치할 수 있게 되었다(예를 들어, 7×7 크기의 feature map에서는 (4,4) 위치가 중앙에 해당). 이 중앙 그리드 셀은 이미지에서 중앙의 객체를 검출하는 데 효과적이라고 한다. 예를 들어 객체의 크기가 매우 큰 경우 그 위치가 영상의 중앙인 경우가 많기 때문이다.
YOLOv2는 FCN이기 때문에 다양한 해상도로 입력 이미지를 취할 수 있다. FCN에서는 CNN 최종 feature map까지 진행하면서 이미지를 1/32로 줄이는 구조이므로 입력 이미지가 커지면 최종 그리드의 셀 크기가 커진다. 그러므로 네트워크는 다양한 해상도의 입력 데이터를 소화할 수 있다. 입력 이미지의 큰 범위는 320X320 ~ 608X608인데, 다양한 학습을 위해 10번의 배치마다 학습 데이터는 {320, 352, ..., 608}의 크기로 resize 된다.
-
앵커 박스와 차원 클러스터(Anchor Boxes & Dimension Clusters)
앵커 박스를 이용하면 학습 초기 단계에서 모델이 불안정해지는 문제를 해결할 수 있다. 학습 불안정의 주요 원인은 학습 초기에 박스의 (x, y) 위치가 너무 랜덤하게 예측되기 때문이다.YOLO v1은 각 grid cell의 bounding box의 좌표가 0~1 사이의 값을 가지도록 랜덤으로 설정한 뒤 학습을 통해 최적의 값을 찾아가는 과정을 거칩니다. 반면 Faster R-CNN 모델은 사전에 9개의 anchor box를 정의한 후 bounding box regression을 통해 x, y 좌표와 aspect ratio(offset)을 조정하는 과정을 거칩니다. 좌표 대신 offset을 예측하는 문제가 보다 단순하고 네트워크가 학습하기 쉽다는 장점이 있습니다.
https://herbwood.tistory.com/17바운딩 박스 예측 과정은 다음과 같다. 각 그리드 셀에서는 5개의 앵커 박스가 사용한다. 앵커 박스는 고정된 비율과 크기를 가지며, 다양한 크기와 비율의 객체를 더 잘 탐지하기 위해 설정된다. 각 앵커 박스마다 YOLOv2는 4개의 바운딩 박스 좌표 와 신뢰도(Confidence)를 예측한다. 각 그리드 셀에서 5개의 바운딩 박스가 예측되면, YOLOv2는 그 중에서 신뢰도(Confidence score)가 높은 바운딩 박스를 우선적으로 선택한다. 또한, NMS(Non-Maximum Suppression)를 적용해 중복되는 바운딩 박스를 제거한다. 이렇게 해서 최종적으로 각 그리드 셀에서 가장 신뢰도 높은 바운딩 박스가 남는다. 이 바운딩 박스들이 최종 출력에서 객체의 위치와 크기를 나타낸다.
이러한 앵커 박스를 사용하면 mAP에 대한 성능은 조금 떨어지지만(69.5->69.2), 재현율(recall)이 크게 상승하게 되었다(81->88).
Object detection task에서 recall 값이 높다는 것은 모델이 실제 객체의 위치를 예측한 비율이 높음을 의미합니다. YOLO v1이 recall 값이 낮은 이유는 region proposal 기반의 모델에 비해 이미지 당 상대적으로 적은 수의 bounding box를 예측하기 때문입니다. 하지만 YOLO v2에서 anchor box를 통해 더 많은 수의 bounding box를 예측하면서 실제 객체의 위치를 보다 잘 포착하게 됩고, 이를 통해 recall 값이 상승하게 됩니다.
https://herbwood.tistory.com/17YOLOv2는 훈련 과정에서 객체가 있는 위치를 나타내는 바운딩 박스가 이미 레이블된 데이터셋을 사용한다. 이 데이터를 기반으로 유클리드 거리 기반 K-평균 클러스터링을 적용하면 다음과 같은 문제가 있다.
바운딩 박스의 크기가 커질수록 조금의 차이가 유클리드 거리상 큰 차이로 반영된다. 즉, 큰 박스들이 작은 박스에 비해 클러스터링을 할 때 centroid와 충분히 유사한 거리에 있더라도 유클리드 거리 계산에서 더 많은 오류가 발생한다. 또 단순한 유클리드 거리 기반 클러스터링은 두 상자 사이의 절대적인 크기 차이에만 초점을 맞춘다(두 바운딩 박스가 모두 작은 경우, 크기의 작은 차이만으로도 중요한 객체 구별이 가능할 수 있음에도).따라서 이를 해결하기 위해 YOLOv2에서는 유클리드 거리 대신 IoU(Intersection over Union)를 사용한 K-평균 클러스터링를 사용한다. 이렇게 함으로써 더 정확한 앵커 박스를 정의할 수 있는 이유는 객체의 겹침 정도를 고려할 수 있기 때문이다. IoU를 사용하면 크기가 큰 바운딩 박스와 작은 바운딩 박스가 있다 하더라도, 만약 두 바운딩 박스가 비슷한 객체(크기와 모양이 유사한 객체)를 감싸고 있고, 그 바운딩 박스들이 클러스터 중심(앵커 박스)과 유사한 IoU 값을 가진다면, 이 둘은 같은 클러스터에 속할 수 있다. 논문에 의하면 k=5는 모델 복잡성과 높은 재현율 간에 적절한 균형을 유지하는 최상의 값이다.
-
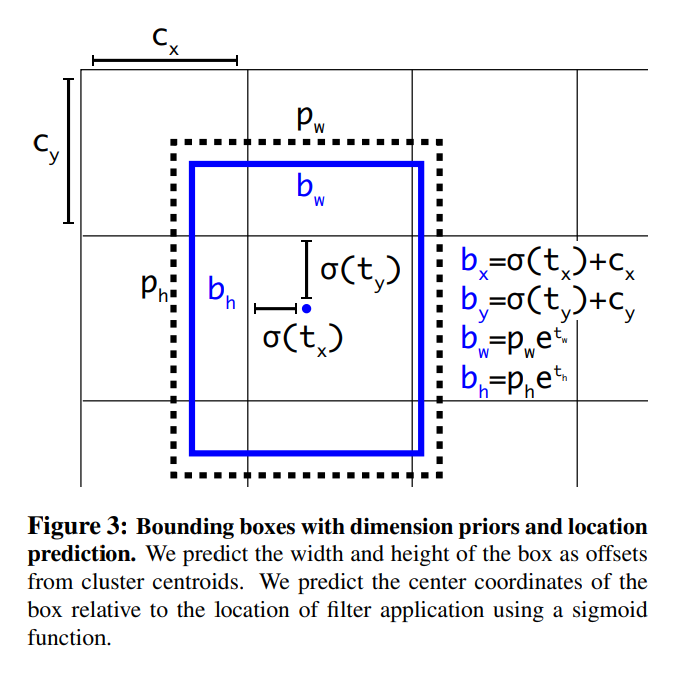
Direct location prediction
YOLOv1에는 위치 예측에 대한 제약이 없기 때문에 초기 훈련에서 불안정성이 있어 예측된 바운딩 박스가 실제 위치에서 멀리 떨어져 있다. 그래서 YOLOv2에서는 아래와 같이 예측 식을 업그레이드해서 mAP를 증가시켰다.bounding box regression을 통해 얻은 값에 logistic regression 함수 를 적용하여 0~1 사이의 값을 가지도록 조정했습니다. 예측하는 위치의 범위가 정해짐으로써 네트워크는 안정적으로 학습을 진행하는 것이 가능해집니다. https://herbwood.tistory.com/17
-
새로운 네트워크와 패스스루 네트워크(New network & Pass-through)
YOLOv2는 자체 개발된 Darknet-19를 백본 네트워크로 사용해 특징을 추출(feature extraction)을 했다. Darknet-19는 VGG-19와 유사하지만, 연산량이 훨씬 적다.
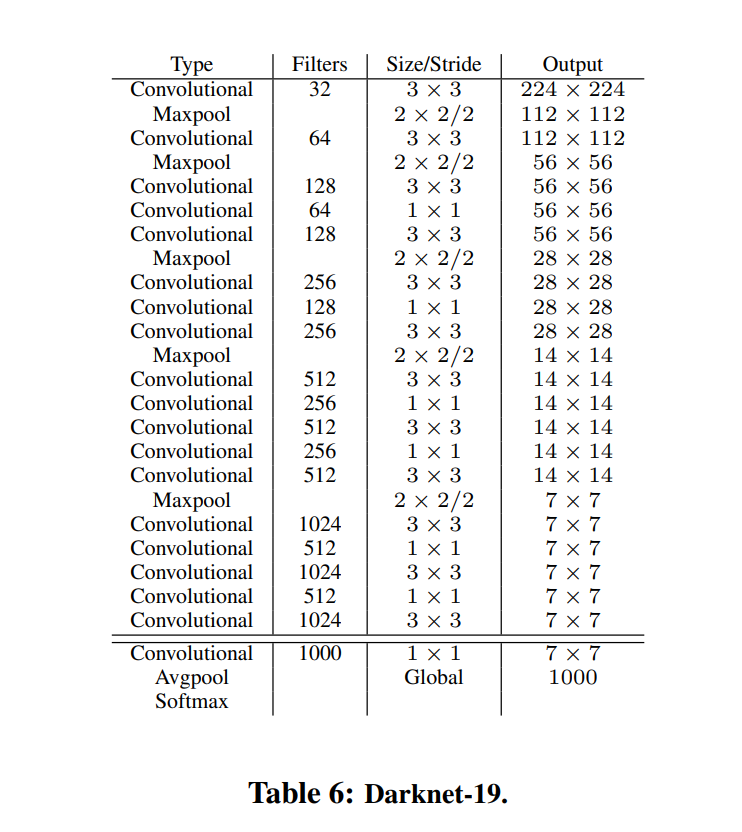
YOLO는 바운딩 박스 후보를 제안하기 위해 마지막 feature map만 사용했는데, 하나의 feature map은 검출하고자 하는 대상의 크기에 따라 정보가 불충분할 수 있으므로 SSD의 경우에는 크기가 다른 feature map에서 크기가 다른 바운딩 박스 후보를 제안하는 것으로 이 문제를 해결했다.
YOLOv2는 이러한 문제에 대한 해결 방법으로 아래와 같이 패스스루 레이어(pass-through layer)를 이용했는데, 이것은 26X26 크기의 상위 레이어의 feature map을 하위 레이어의 feature map 13X13 레이어에 병합(concatenate)하는 방식을 사용했다.
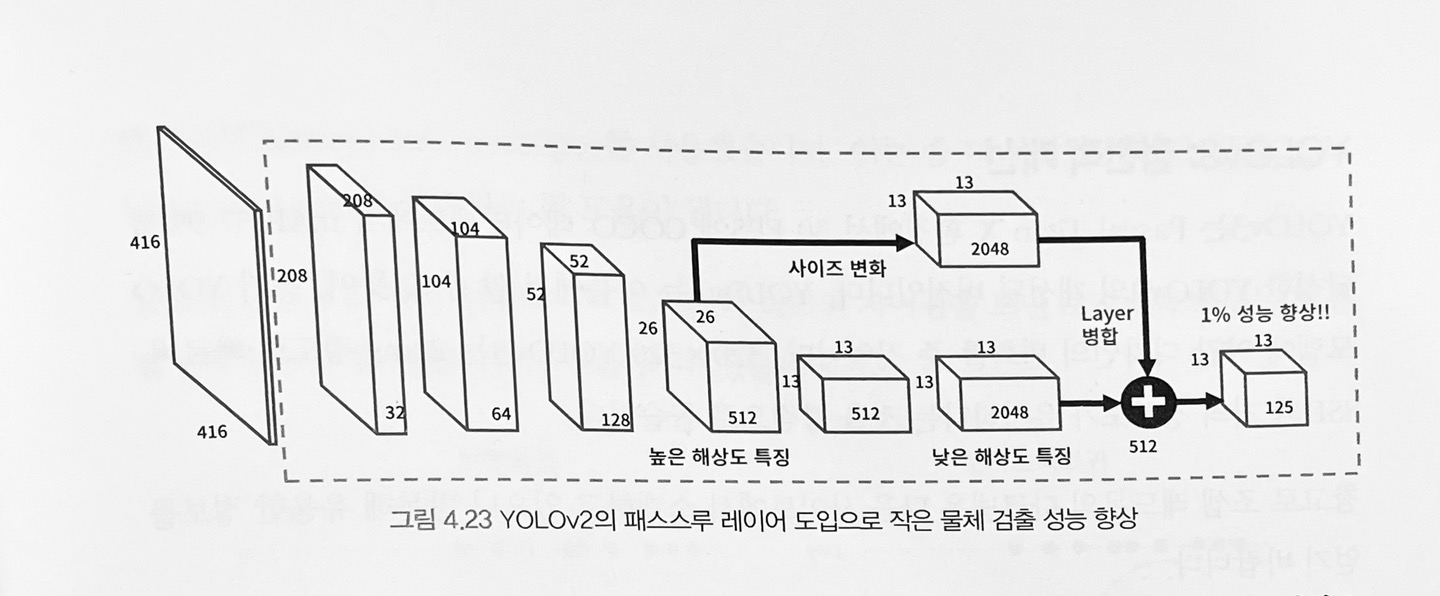
26X26 feature map에는 13X13 feature map에 비해 고해상도의 특징이 포함돼 있으므로 concatenate하여 효과를 높이고자 하는 것이며, 두 개의 크기가 다른 feature map을 그냥 붙을 수는 없어서 26X26의 feature map을 13X13X(2048) feature map으로 변환한 후 26X26 feature map의 한 포인트에서 주위 2X2 데이터를 4채널로 모양을 바꿔주도록 했다. 이러한 pass-through layer의 효과로 1%의 성능 향상을 이루었다.
YOLOv3: 점진적 개선
YOLOv3는 이름에서 알 수 있듯이, 초기 YOLO 모델에 약간 디자인의 변화를 준 것이다. 320X320 YOLOv3는 22ms 정도로 빠르며, SSD와 거의 정확도가 유사하다는 것을 장점으로 꼽는다.
- 바운딩 박스 예측(Bounding Box Prediction)
YOLOv3에서는 바운딩 박스의 4개 좌표 tx, ty tw, th를 예측한다. 이 예측은 주로 클러스터 중심으로부터의 오프셋을 기반으로 한다. 박스의 중심 좌표를 예측할 때는 시그모이드 함수를 사용한다. 이 점은 YOLOv2와 같다.
-
클래스 예측(Class Prediction)
YOLOv3에서는 class 예측에 있어서 소프트맥스 함수 대신 independent logistic regression을 사용한다. 여러 클래스 중에서 각 클래스의 확률을 출력하는 것이 아니라 각 클래스의 확률을 독립적으로 예측한다는 것이다. 예를 들어, 이미지 안에 고양이와 개가 동시에 있을 경우, 소프트맥스는 하나의 클래스만 선택할 수 있지만, independent logistic regression은 두 클래스 모두 예측할 수 있다. 훈련 중에는 클래스 예측을 위해 바이너리 교차 엔트로피(binary cross-entropy)를 사용했다. 이는 Open Image Dataset과 같이 복잡하고 다양한 클래스가 포함된 데이터셋을 학습하는 데 유리하다. -
어크로스 스케일 예측(Predictions Across Scales)
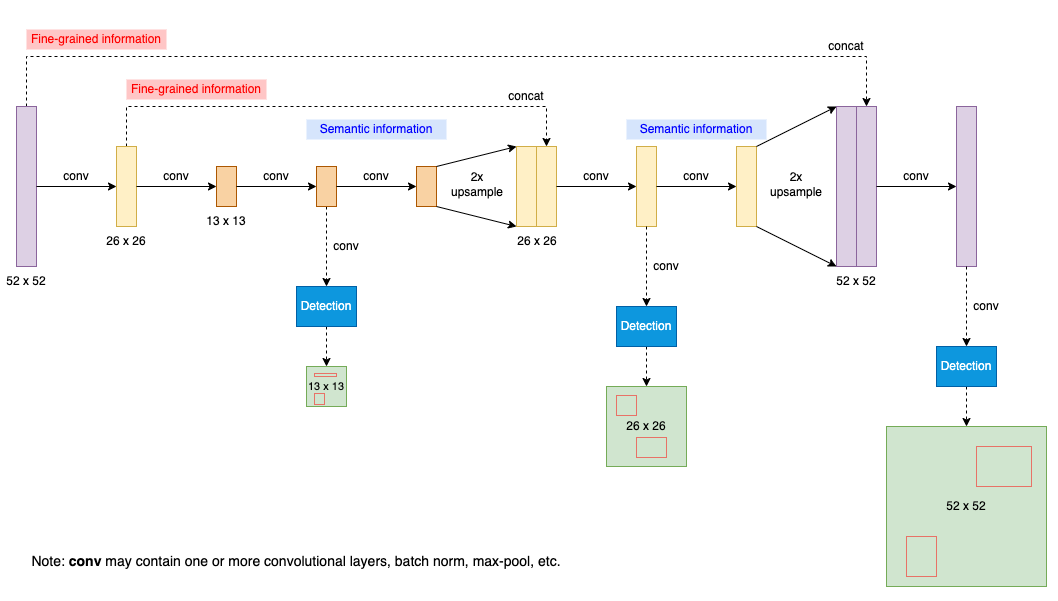
YOLOv3은 3가지 scale의 feature map을 사용해 각각에서 3개의 다른 스케일 박스를 예측한다. 이러한 어크로스 스케일 예측은 FPN과 유사하다.YOLOv3는 3차원 텐서를 출력값으로 얻는데, 거기에는 박스에 대한 정보와 객체성, 클래스에 대한 정보가 있다.
COCO 데이터셋에서 실험한 경우를 살펴보면 각 스케일에서 3개의 박스를 예측하므로 N x N X [3*(4+1+80)]의 형태로 출력된다. N은 feature tensor의 그리드 개수(13 or 26 or 52)이고, 3개의 앵커 박스의 개수, 4는 4개의 박스 시프트와 스케일링 값(box shifh and scaling value), 1개의 객체성(objectness) 점수, 80개의 클래스 정보이다.
각 feature map은 서로 다른 해상도를 가지며 는 객체의 크기와 위치에 대한 정보를 다르게 나타낸다. 예를 들어, 작은 객체는 52x52 피처 맵에서 잘 탐지되고, 큰 객체는 13x13 피처 맵에서 잘 탐지된다.
이후 YOLOv3는 업샘플링(up-sampling) 기법을 사용하여 더 낮은 해상도의 피처 맵을 더 높은 해상도의 피처 맵과 결합한다. 이를 통해 세부 정보를 보완하고 객체 탐지 성능을 향상시킨다.
-
특징 추출기(Feature Extractor): Darknet-53
YOLOv3에서 가장 큰 변화는 백본 네트워크를 Darknet-53으로 변경했다는 것이다. 이전 YOLOv2에서는 VGG 모델이 지나치게 복잡하다는 점에 착안해 훨씬 적은 파라미터를 사용하면서도 성능이 좋은 Darknet-19 아키텍처를 선보였다. Darknet-53에서는 Darknet-19에 ResNet에서 제안된 skip connection 개념을 적용해 레이어를 훨씬 더 많이 쌓은 모습을 보여준다.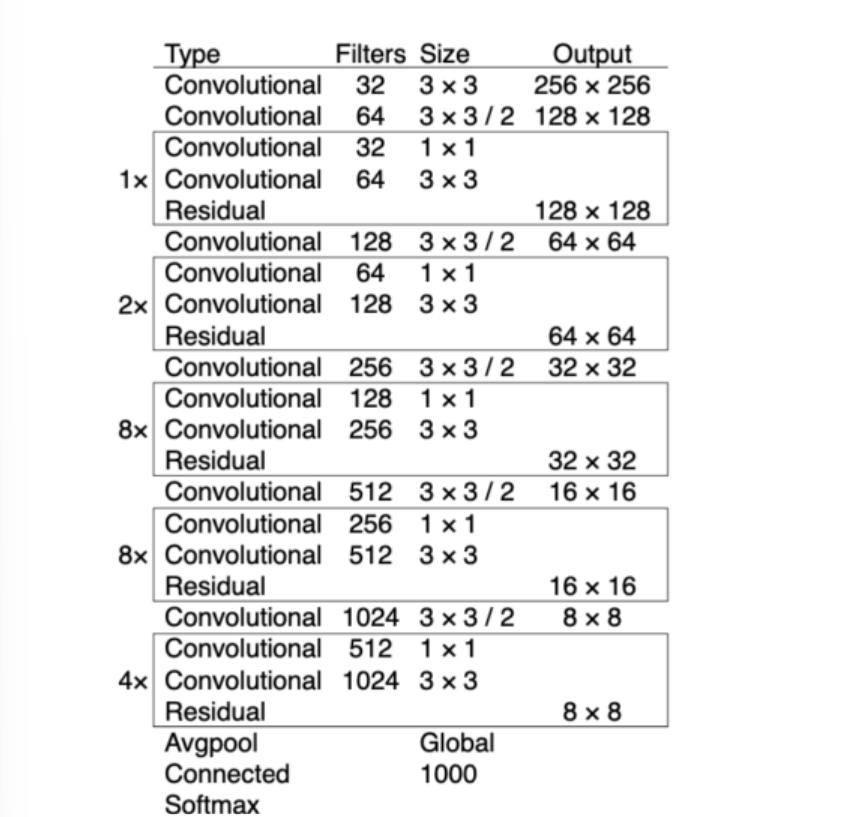
그리고 맥스 풀링(Max Pooling) 대신에 convolution의 stride를 2로 취해 feature map의 해상도를 줄여 나간다. 또한 skip connection을 활용해 residual 값을 전달하고 마지막 layer에서 Average Pooling과 Fully Connected layer를 통과한 뒤, softmax를 거쳐 분류 결과를 출력한다.
YOLOv3은 전반적으로 (작은 크기 객체 검출 정확도)에서 상대적으로 좋은 성능을 보이지만, (중간 크기 객체 검출 정확도)과 (큰 크기 객체 검출 정확도)에서는 상대적으로 나쁜 성능을 보이는 것으로 타나났다.
책을 읽고 내용을 정리하며 찾아본 자료들이 되게 많았다. 책만으로는 깊은 이해가 어려웠다. 따라서 다음 포스팅은 4.4절의 내용 정리 대신 YOLO~YOLOv4 논문을 읽고 정리하고자 한다.
2024-10-26 논문 리뷰를 다 마치고 YOLOv4-tiny 실습을 진행하였다.
- YOLO - https://velog.io/@jeoooes/You-Only-Look-Once-Unified-Real-Time-Object-Detection
- YOLO9000 - https://velog.io/@jeoooes/YOLO9000-Better-Faster-Stronger
- YOLOv3 - https://velog.io/@jeoooes/YOLOv3-An-Incremental-Improvement
- YOLOv4 - https://velog.io/@jeoooes/YOLOv4-Optimal-Speed-and-Accuracy-of-Object-Detection
YOLOv4-tiny: 소형 장치용 tiny 버전
YOLOv4-tiny는 YOLOv4의 압축 버전이다. 사실 YOLO의 tiny 버전은 YOLOv2부터 꾸준히 공개돼 왔고 기본 YOLO를 기반으로 네트워크 구조를 단순화하고 매개변수를 줄여 모바일 및 임베디드 장치 개발이 가능하도록 제안됐다.
YOLOv4-tiny는 더 빠른 훈련과 더 빠른 감지가 가능하다. YOLOv4에는 3개의 YOLO 헤드(각기 다른 해상도의 3개의 피처 맵을 사용하여 다양한 크기의 객체를 탐지)가 있지만 YOLOv4-tiny는 2개뿐이다. 그리고 사전 훈련된 137개의 컨볼루션 계층에서 훈련된 YOLOv4와 달리 YOLOv4-tiny는 29개의 사전 훈련된 컨볼루션 계층에서 훈련됐다.
1080ti GPU 장치에서 실험했을 때 YOLOv4-tiny의 FPS는 YOLOv4의 약 8배이다. 그러나 MS COCO 데이터셋 테스트 기준으로 YOLOv4-tiny의 정확도는 YOLOv4의 2/3으로 떨어진다. 그러므로 소형 장치에서 추론용으로 YOLO 버전을 선택한다면, 개발자는 속도와 성능 중 중요한 쪽을 택해야 한다. 일반적으로 실시간 객체 감지에는 YOLOv4보다 YOLOv4-tiny가 낫다. 실시간 객체 감지 환경에서는 정밀도나 정확성보다 추론 속도가 더 중요하기 때문이다.