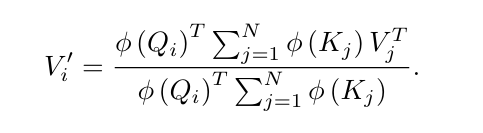
Summary
-
Attention의 similarity를 feature map 를 이용한 kernel 로 나타내면, 를 에 대한 합 밖으로 분리할 수 있다. 그러면 와 를 한 번만 계산해 모든 query가 재사용할 수 있어, 연산 시간과 memory가 이 된다.
-
Causal masking을 걸면 를 누적합(state) 으로 들고 가면 되고, 이는 곧 Transformer layer = 고정 크기 hidden state를 가진 RNN이라는 뜻이다.
-
최종적으로 autoregressive 생성에서 KV cache 없이 매 step 상수 시간·상수 메모리로 추론하며, CIFAR-10 이미지 생성에서 softmax 대비 약 4,462배 빠르다.
1. Problem & Motivation
Transformer는 자연어를 비롯한 다양한 task에서 좋은 성능을 보였고, autoregressive / masked LM objective로 pre-training하면 label이 없는 데이터로도 강력한 표현을 얻을 수 있다. 하지만 self-attention은 모든 key-query 쌍의 유사도를 계산하기 때문에 입력 길이 에 대해 시간 복잡도 , 메모리 이며 이에 따라 context length가 제한된다. 특히 autoregressive inference에서는 token 하나를 만들 때마다 지금까지의 모든 token들에 대해 attention을 적용하므로 생성이 길어질수록 step당 비용이 계속 커진다.
기존의 시간복잡도와 메모리를 줄이기 위하여 해당 논문에서는 Linear transformer 구조를 도입한다.
Linear Transformer는 Similarity를 Kernel based formulation으로 계산하며 Memory와 연산이 모두 이 되도록 한다.
2. Related Work
2.1. Efficient Transformers
기존에도 학습 및 추론 속도를 높이기 위한 몇 가지 방법이 제시되었다. Weight pruning, factorization, quantization 등은 학습 및 추론 속도는 높이지만 attention 연산의 시간복잡도는 여전히 이다.
복잡도를 줄여 context를 늘리기 위한 시도들은 다음과 같다. 두 방법 모두 각 query가 일부 key만 보게 해서 복잡도를 낮춘다.
- Sparse Transformer (Child et al.): attention matrix를 sparse하게 factorize해서 각 query가 정해진 패턴의 위치만 보게 하며, 복잡도는 이다.
- Reformer: 유사한 vector들을 같은 bucket에 넣고 bucket 안에서만 attention을 계산한다. 이때 hashing을 위해 제약이 필요하며, 복잡도는 이다.
Context란 self-attention을 계산할 때 쓰일 수 있는 sequence의 최대 범위다. attention에서는 sequence가 길어질수록 연산량과 attention matrix를 저장할 메모리가 제곱으로 늘어나 context 길이가 제한된다. 복잡도를 줄이면 같은 자원으로 더 긴 sequence를 처리할 수 있으므로, 결국 복잡도를 줄인다는 것은 long sequence를 처리하기 위함이라고 볼 수 있다.
기존 방법들과 달리 Linear Transformer는 query와 key에 아무 제약 없이 sequence 길이에 Linear로 scale한다.
2.2. Understanding Self-Attention
Kernel 관점에서 Attention은 비슷한 데이터일수록 가중치를 높게 두어 평균을 내는 kernel smoother를 입력에 적용한 것으로 생각할 수 있다. 이때 kernel 값은 입력 간 유사도다.
해당 논문에서는 위 관점을 확장하여 positive similarity score를 주는 kernel이라면 attention으로 쓸 수 있다는 아이디어를 적용한다. 추가적으로 autoregressive objective로 학습된 self-attention layer를 RNN으로 볼 수 있음을 보인다.
3. Linear Transformers
3.1. Transformers
입력 는 차원 feature vector 개의 sequence다. Transformer layer 은 self-attention 과 feedforward 로 이루어진다.
여기서 , , 다. Softmax attention의 번째 출력은 similarity 함수 을 써서 일반화할 수 있다.
이면 기존 softmax attention이 된다. 즉 이 non-negative이기만 하면 어떤 함수든 attention으로 쓸 수 있다.
3.2. Linearized Attention
Kernel 를 feature map 로 표현해 로 두면,
는 와 무관하므로 합의 밖으로 뺄 수 있다. 를 분리할 수 있기에 에 대한 연산은 한번만 진행할 수 있다.
- 기존 방식은 행렬을 먼저 만든다 →
- 를 빼낸 방식은 ( 행렬)를 먼저 만든다 →
와 를 한 번만 계산해 두고 모든 query가 재사용하기 때문에 시간·메모리가 에 linear이 된다.
3.3. Feature Maps and Computational Cost
해당 논문에서는 아래의 feature map을 선정하였다.
의 함수는 다음의 특징을 갖는다
- 덕분에 이 되어 similarity가 항상 양수
- 가 음수일 때 gradient가 0이 되는 것을 방지할 수 있다.
3.4. Causal Masking
하나의 token씩 생성해나가는 autoregressive model에서는 번째 position이 인 position에만 영향을 받아야 한다. 와 같이 나타낸 linearized attention에 causal masking을 적용하기 위해서는 합의 범위만 에서 로 바꾸면 된다.
이때, 으로 묶여있는 항은 첫번째부터 번째 position까지에 대한 합으로 가 증가함에 따라 하나씩 증가한다. 즉, 매번 부터 계산할 필요 없이 누적합으로 생각하여 새로운 position 마다 값을 하나씩 더해나가는 것으로 생각할 수 있다.
누적합을 다음처럼 정의하면
이고, , 로 이전 값에서 상수 시간에 갱신된다. 따라서 causal attention 전체가 sequence 길이에 선형이다.
3.5. Gradient Computation
만약 모든 를 저장해 두고 autograd로 미분하면 메모리가 이 되어, 오히려 softmax보다 메모리를 더 쓸 수 있다. 그렇기에 논문은 gradient 자체도 누적합으로 표현해서 이를 해결한다.
위와 같은 방식으로 forward와 backward 모두 선형 시간,메모리로 처리할 수 있다.
3.6. Transformers and RNNs
Linear attention을 RNN으로 해석하는 핵심 아이디어는 다음과 같다.
Causal masking을 건 모든 Transformer layer는, 입력을 받아 내부 state를 갱신하고 출력을 내는 모델, 즉 RNN으로 쓸 수 있다.
- Hidden state: (attention memory), (normalizer memory)
- 새 토큰 가 들어오면 state를 갱신하고, 현재 query로 state를 읽어 출력한다.
- 학습 때는 모든 position을 병렬로 처리하는 Transformer처럼, 추론 때는 state만 들고 가는 RNN처럼 쓸 수 있다.
Softmax Transformer는 과거 토큰의 K, V를 모두 KV cache로 저장해야 해서 생성 step마다 비용이 으로 늘어나지만, Linear Transformer는 고정 크기 state 하나만 유지하면 되므로 step당 비용과 메모리가 상수다.
4. Experiments
4.1. Setup
비교 대상은 다음 세 가지다.
- Softmax: 기존 full attention Transformer
- LSH-X: Reformer. X는 hashing round 수
- Linear: 을 쓰는 Linear Transformer
실험은 synthetic task, 이미지 생성(MNIST, CIFAR-10) 등을 다룬다.
4.2. Synthetic Task: Convergence
Sequence duplication과 비슷한 copy task(기호 sequence를 그대로 복사)로 수렴 양상을 비교했다.
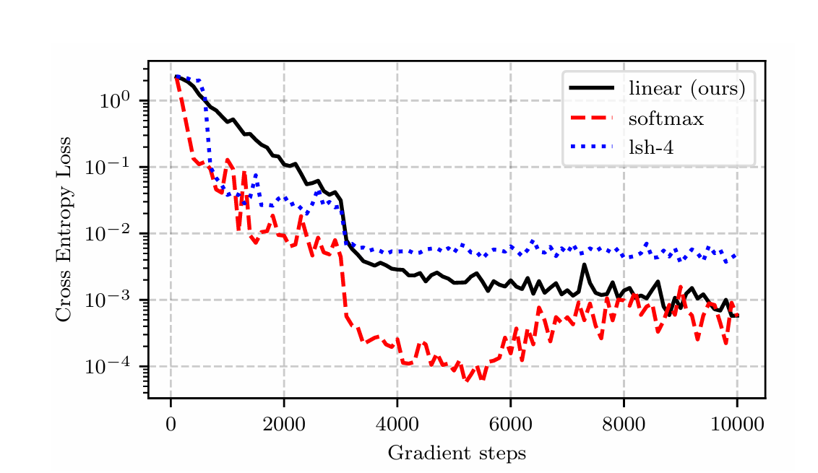
- Linear는 안정적으로(smoothly) 수렴하고, LSH-4보다 낮은 loss에 도달한다.
- 최종적으로는 softmax와 비슷한 loss에 도달한다. 다만 중간 구간(약 4,000~7,000 step)에서는 softmax가 낮은 loss를 보인다.
4.3. Synthetic Task: Memory & Computation
Sequence 길이를 부터 까지 바꿔 가며 GPU peak memory와 forward/backward 시간을 측정하였다.
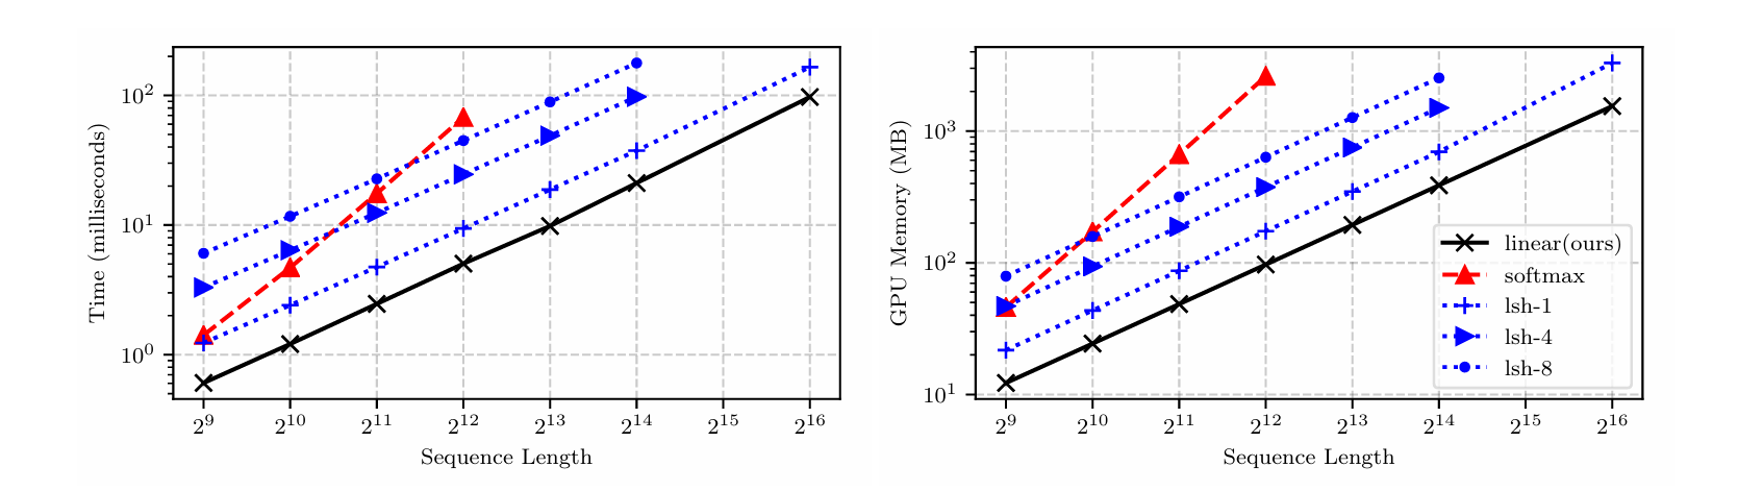
- Softmax는 길이에 따라 quadratic으로 증가해 이후로는 측정이 불가능하다(GPU 메모리 부족).
- LSH와 Linear는 모두 선형으로 증가하지만, Linear가 모든 길이에서 가장 빠르고 메모리도 가장 적다.
4.4. Image Generation: MNIST & CIFAR-10
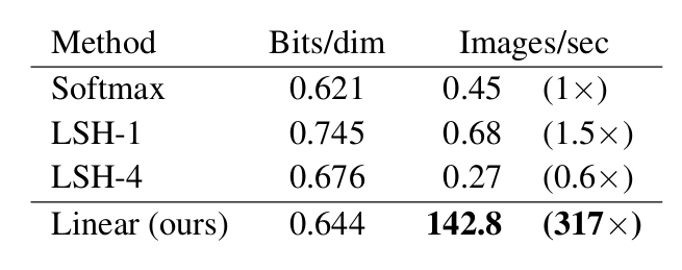
이미지를 픽셀 단위로 autoregressive하게 생성한다. 평가 지표는 bits/dim(낮을수록 좋음)과 초당 생성 이미지 수다.
MNIST
CIFAR-10
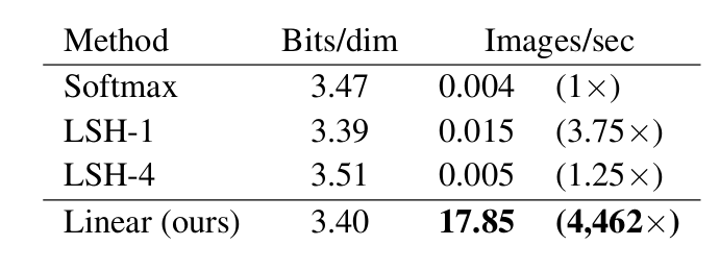
- Linear는 softmax와 비슷한 품질을 내면서 생성 속도는 MNIST에서 317배, CIFAR-10에서 4,462배 빠르다. 즉 softmax가 CIFAR-10 이미지 한 장을 만드는 동안 Linear는 약 4,460장을 만든다.
- Sequence가 더 긴 CIFAR-10에서 속도 차이가 훨씬 커진다. Softmax는 step마다 비용이 커지지만, Linear는 RNN처럼 step당 비용이 일정하기 때문이다.
5. Conclusion
Linear Transformer는 attention을 kernel feature map의 내적으로 바꾸고 행렬곱 결합법칙을 이용해, 시간·메모리 복잡도를 에서 으로 줄였다. 또한 causal attention을 RNN으로 해석하여, autoregressive inference를 상수 시간·상수 메모리로 수행할 수 있게 했다. 실험에서는 softmax에 가까운 성능을 유지하면서 autoregressive 생성에서 수백~수천 배의 속도 향상을 보였다.
6. My Take
1. MQA → GQA → MLA와는 다른 방향의 최적화
지금까지 읽은 MQA, GQA, MLA는 모두 "KV cache를 얼마나 작게 저장할 것인가"에 대한 답이었다. Head를 공유하거나(MQA, GQA), latent로 압축하거나(MLA) 해도 cache는 여전히 토큰 수 에 비례해서 늘어난다. Linear Transformer는 아예 과거 토큰별 K, V를 버리고 크기의 state 하나로 요약한다. KV cache 크기가 과 무관해진다는 점에서 근본적으로 다른 접근이다.
2. 고정 크기 state에 모든 과거를 압축한다는 것
Softmax attention은 과거 토큰을 모두 들고 있다가 필요한 것을 정확히 꺼내 볼 수 있다. 반면 Linear attention의 는 모든 를 그냥 더하기만 하므로, 길이가 길어질수록 정보가 섞이고 특정 토큰을 정확히 복원하기 어렵다. Copy task 중간 구간에서 softmax가 훨씬 낮은 loss를 보인 것, MNIST bits/dim이 약간 나쁜 것도 이 한계와 연결해서 볼 수 있다고 생각한다.
References
- Katharopoulos, A., Vyas, A., Pappas, N., & Fleuret, F. (2020). Transformers are RNNs: Fast Autoregressive Transformers with Linear Attention. ICML 2020. arXiv:2006.16236
- Vaswani, A. et al. (2017). Attention Is All You Need. arXiv:1706.03762
- Child, R. et al. (2019). Generating Long Sequences with Sparse Transformers. arXiv:1904.10509
