1. 딥러닝이란?
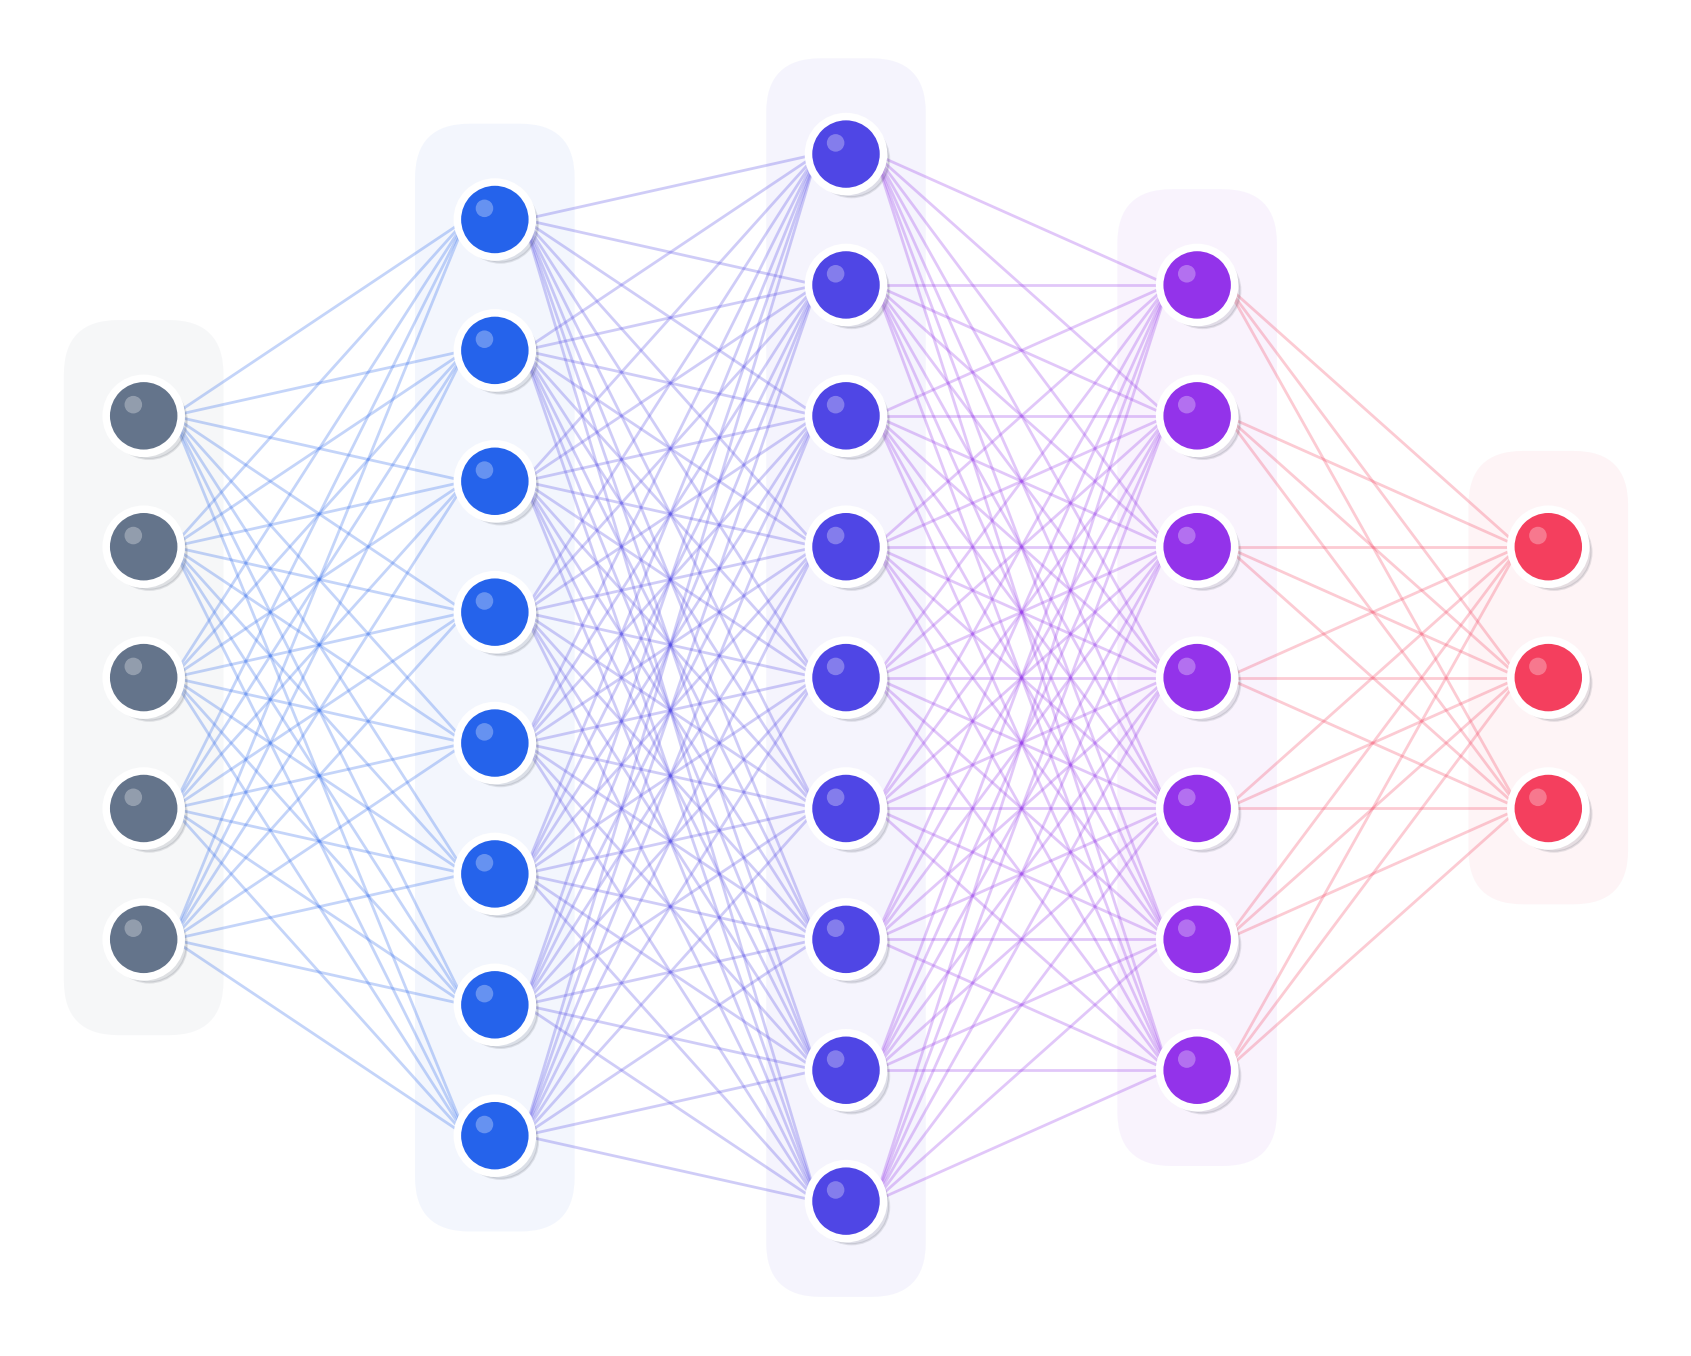
앞서 구현한 단일층 신경망은 입력과 출력 사이의 관계가 단순한 선형 문제에서는 효과적이지만
실제 데이터에서 나타나는 선형으로 구분할 수 없는 복잡한 패턴은 학습하기 어렵습니다.
딥러닝은 이러한 한계를 극복하기 위해 여러 개의 은닉층을 사용합니다. 각 층은 이전 층에서 전달된 정보를 바탕으로 데이터의 특징을 단계적으로 학습하며, 활성화 함수를 통해 비선형적인 관계를 표현합니다.
모델은 예측값과 실제값의 차이를 손실 함수로 계산하고, 역전파를 통해 가중치와 편향을 수정합니다. 이러한 과정을 반복하면서 이미지, 음성, 자연어와 같은 복잡한 데이터의 패턴을 학습합니다.
모델은 순전파를 통해 예측값을 계산하고, 예측값과 실제값의 차이를 손실 함수로 측정합니다. 역전파에서는 연쇄법칙을 이용하여 출력층에서 계산한 기울기를 이전 층으로 전달합니다.
두 층이 ()로 연결되어 있다면 이전 층의 기울기는 다음과 같이 계산합니다.
즉, 다음 층에서 전달된 기울기에 두 층을 연결하는 가중치와 활성화 함수의 미분값을 곱합니다. 옵티마이저는 이렇게 계산한 기울기를 이용하여 손실이 감소하는 방향으로 가중치와 편향을 수정합니다.
2. 텐서플로와 케라스
TensorFlow는 머신러닝 모델의 구축, 학습, 평가 및 배포를 지원하는 오픈소스 플랫폼입니다. 다차원 배열인 텐서(Tensor)를 기반으로 연산하며, 자동 미분과 GPU 가속 등을 지원하여 복잡한 신경망을 효율적으로 학습할 수 있습니다.
Keras는 딥러닝 모델을 간편하게 구현할 수 있도록 만든 파이썬 기반의 고수준 API입니다. 신경망의 층을 순서대로 추가하고, 손실 함수와 옵티마이저를 설정한 뒤 모델을 학습하는 과정을 직관적인 코드로 작성할 수 있습니다.
구현 과정
Keras에서는 일반적으로 모델 생성, 층 추가, 학습 설정, 모델 학습, 예측 및 평가 순서로 딥러닝 모델을 구현합니다.
1. keras 불러오기
from tensorflow.keras import Sequential
from tensorflow.keras.layers import Dense
Sequential은 신경망의 층을 순서대로 쌓아 모델을 만드는 클래스입니다. 이전 층의 출력이 다음 층의 입력으로 전달되는 단순한 구조에 적합합니다.
Dense는 이전 층의 모든 뉴런과 현재 층의 모든 뉴런이 연결되는 완전 연결층입니다. 다음과 같은 연산을 수행합니다.
dense = Dense(16, activation="relu")
units(16) 에는 해당 층의 뉴런 수를 지정하고, activation에는 사용할 활성화 함수를 지정합니다. 따라서 위 코드는 뉴런 16개와 ReLU 활성화 함수로 구성된 층을 생성합니다.
2. .add [층 추가]
dense = Dense(16, activation="relu") model.add(dense)별도의 dense 변수를 만들지 않고 다음과 같이 바로 층을 추가할 수 있습니다.
model.add(Dense(16, activation="relu"))3. .compile [학습방법 설정]
model.compile(
	optimizer="sgd",
	loss="binary_crossentropy",
	metrics=["accuracy"]
)
optimizer: 가중치를 수정하는 방법을 제시합니다.
"sgd"는 기울기를 이용하여 손실이 감소하는 방향으로 가중치를 수정하는 확률적 경사하강법입니다.
loss: 손실함수를 정의합니다.
"binary_crossentropy"는 정답이 0 또는 1인 이진 분류 문제에서 사용하는 손실 함수입니다.
metrics: 학습 중 평가 지표를 설정합니다.
["accuracy"]는 전체 데이터 중 모델이 정답을 올바르게 예측한 비율인 정확도를 계산합니다.
4. .fit() [모델 학습]
history = model.fit(
	x_train,
	y_train,
	epochs=20,
	batch_size=32,
	validation_data=(x_val, y_val)
)
x_train: 모델에 입력할 훈련 데이터
y_train: 훈련 데이터에 대한 정답
epochs: 학습 반복 횟수
batch_size: 가중치 업데이트 한 번에 사용할 데이터 개수
validation_data: 검증 데이터
5. .predict() [새로운 데이터에 대한 예측값 계산]
predictions = model.predict(x_test)이진 분류에서 출력층에 sigmoid를 사용했다면 0과 1 사이의 확률이 반환됩니다.
predict()는 예측값만 계산하며 모델의 가중치를 변경하지 않습니다.
6. .evaluate() [모델의 성능 평가]
loss, accuracy = model.evaluate(x_test, y_test)compile()에서 지정한 손실값과 평가 지표가 반환됩니다.
테스트 데이터는 모델의 일반화 성능을 확인하기 위해 훈련에 사용하지 않은 데이터를 사용해야 합니다.
