✅ ESM-2 이란
단백질 서열만 보고 구조나 기능을 예측하는 언어 모델
Transformer 기반 BERT 같은 모델을 사용
사람의 문장 대신, 단백질 서열(아미노산 나열)을 입력
훈련할 때는 “이 마스킹된 아미노산은 뭘까?”를 맞히는 식으로 학습 (= Masked Language Modeling)
🖐 왜 마스킹(Masked Language Modeling, MLM) 방식으로 학습시키는가
자기지도학습(self-supervised learning) 때문
단백질은 정답(구조)이 부족하지만 서열(sequence)은 많음
그래서 일부 아미노산을 가리고(mask), 그걸 맞추도록 훈련
이렇게 하면 서열 간의 패턴이나 규칙을 자연스럽게 배우게 됨
-> 구조 정보가 반영된 서열 패턴을 스스로 학습
모델이 “이 자리에 올 아미노산은 이럴 것 같아”라고 문맥을 이해하게 돔
따라서, 서열 정보를 학습하면 구조나 기능까지도 추론할 수 있게 발전
✅ 단백질 구조를 어떻게 알 수 있는가
Transformer가 사용하는 “Attention Map”
→ "이 단어가 저 단어에 얼마나 주목했는지"를 나타내는 지도
단백질에선 이게
“이 아미노산이 저 아미노산과 가까운 구조로 연결되어 있는지”와 관련 있는 정보를 담고 있음
즉, 구조 정보가 포함되어 있음
→ 이를 이용해 contact map (접촉 행렬)을 예측
🖐 Attention Map에 구조 정보가 담긴다는 건 어떻게 아는가
별도로 구조 정보를 주지 않았는데도, attention만으로 구조를 암시하는 정보를 스스로 배웠다는 걸 실험적으로 확인
🖐 Contact Map (접촉 행렬)이란?
단백질 구조에서 어떤 아미노산끼리 가까이 붙어 있는지를 보여주는 2D 지도
단백질은 3D 구조인데, 이걸 2D로 표현한 것
i번 아미노산과 j번 아미노산이 8Å 이하로 가까우면 contact 라고 판단
   A  B  C  D ...
A  0  1  0  0
B  1  0  0  1
C  0  0  0  0
D  0  1  0  0
...
위처럼, A와 B가 가까우면 (A,B) = 1.
1️⃣ 서열을 주고 attention map을 얻음
2️⃣ 이 map을 가지고 두 아미노산이 가까이 붙어 있는지 예측하는 로지스틱 회귀 모델을 훈련
3️⃣ 실제 단백질 구조와 비교해서 잘 맞는지를 확인
단백질의 두 잔기 i, j 가 접촉하고 있는지를 판단하는 확률을 아래와 같은 로지스틱 회귀식으로 계산
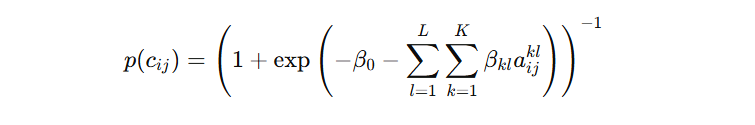
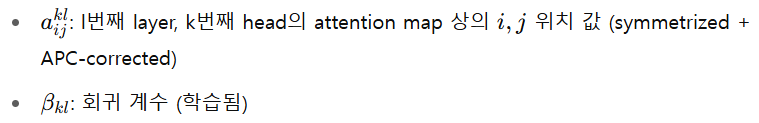
20개의 훈련 단백질을 사용하여 contact prediction 로지스틱 회귀 모델을 학습
-> attention map을 통해 구조 예측 신호가 존재하는지를 정량화
🖐 로지스틱 회귀 모델이란?
두 아미노산이 붙어있는지(0 또는 1)를 예측하는 간단한 분류기
- 입력: attention map의 값들 (다층 / 다 head 값들)
- 출력: 1 또는 0 (붙어 있으면 1)
이걸 학습시키면, Attention map만 보고 구조적 접촉을 예측할 수 있음
✅ Perplexity: 얼마나 잘 예측하는지 보는 점수
언어 모델이 다음 아미노산을 얼마나 확신 있게 맞추는지를 수치로 표현한 것 (언어 모델의 예측 정확도)
perplexity는 구조 예측 능력과 강하게 상관됨
→ 주요 평가 지표
🛑 문제는?
우리는 일부 아미노산을 가리고(Mask) 맞히게 하여, 정확한 예측 확률을 계산하는 게 어려움
Masked Language Modeling에서는 정확한 likelihood를 계산하기 어려움
그래서 두 가지 방식이 존재
1️⃣ Approximate Perplexity
무작위 마스킹 M을 사용하고, 한 번의 forward pass로 전체 sequence에 대해 perplexity를 추정
→ 무작위로 일부를 가리고 한 번만 예측해봄 (근사값 사용, 빠르지만 정확도는 떨어짐)
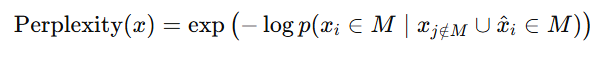
실제 마스킹 비율:
80% 마스크 토큰, 10% 랜덤 토큰, 10% 원래 토큰 유지
🖐 “80% 마스크, 10% 랜덤, 10% 원래 토큰 유지” ?
마스킹할 때의 세부 규칙
-> 서열 일부를 무작위로 골라서 “가리기” 작업을 하는 것
ex)
마스킹 대상으로 뽑힌 100개의 아미노산 중80개는 [MASK] 로 바꿈 → “진짜 숨김”
10개는 엉뚱한 아미노산으로 바꿈 → “헷갈리게”
10개는 그대로 둠 → “속임수”
이렇게 하면 모델이 진짜 이해하고 있는지 확인할 수 있음
(단순히 MASK 토큰을 외우는 걸 방지)
2️⃣ Pseudo-perplexity:
각 token을 하나씩 마스킹하여 L개의 forward pass 필요
→ 아예 하나씩 순서대로 가려가면서 예측 (정확하지만 느림)
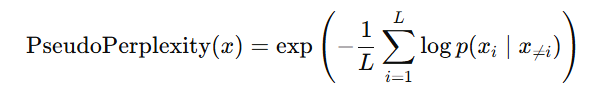
- CASP 같은 개별 sequence에는 pseudo-perplexity 사용
- 대규모 데이터셋에는 approximate perplexity 사용
✅ ESM-2 모델 구조
ESM-2는 BERT 스타일의 Transformer (입력만 받고 출력은 X)
ESM-2에서는 RoPE(Rotary Positional Embedding) 방식 사용
RoPE는 긴 서열도 잘 처리할 수 있어서 더 강력
(extrapolation 가능하고 효율적)
→ RoPE를 통해 더 긴 context에서의 일반화 가능성 확보
🖐 RoPE (Rotary Positional Embedding) 이란?
Transformer는 서열만 보니까, 각 아미노산의 위치 정보를 따로 넣어줘야 함
이전엔 단순히 sin/cos 함수 기반 위치 인코딩을 사용
그런데 이건 훈련 중 본 범위 밖의 서열(더 긴 서열)에선 잘 작동하지 않음
그래서 나온 게 RoPE (Rotary Positional Embedding)
각 토큰의 위치 정보를 회전 연산으로 표현해서
훨씬 더 멀리 있는 서열도 잘 일반화함 (extrapolation)
🖐 Extrapolation 이란?
훈련에서 본 범위를 넘어서도 잘 작동하는 능력
✅ ESM-2 학습 방식
2억 개 이상 단백질 서열을 넣고 학습
BERT-style 모델의 장점을 활용하여 한 번에 200만 토큰(batch)을 처리할 수 있도록 분산 학습 사용
Optimizer는 Adam 사용 (β₁=0.9, β₂=0.98, ε=1e−8)
weight decay: 0.01 (단, 15B 모델은 0.1)
learning rate: warm-up + decay (15B 모델은 4e-4 → 0.1× over 90%)
각 모델은 50만 step 학습 (15B는 27만)
BOS/EOS token 삽입으로 단백질 단위 분리
FSDP를 통해 2.8B/15B 모델 분산 학습
ESM-1b 대비 dropout 제거 → 더 큰 모델을 만들 수 있게 함
모델 크기는 8M ~ 15B 파라미터까지 다양하게 실험
🖐 Adam의 (β₁=0.9, β₂=0.98, ε=1e−8) ?
Adam Optimizer의 하이퍼파라미터
β: 이전 gradient를 얼마나 참고할지
(보통 0.9)
β: 변동성(분산)을 얼마나 참고할지
(보통 0.999인데 여기선 0.98로 더 빠르게 업데이트)
ε: 너무 작거나 0으로 나누는 걸 방지하는 작은 수
(안정성용)
🖐 weight decay 란?
과적합을 방지하는 방법
모델 파라미터가 너무 커지는 걸 막기 위해
Loss에 "파라미터 크기" 항목을 추가로 넣어서 패널티를 줌
-> L2 정규화
🖐 BOS/EOS token 란?
BOS = Begin Of Sequence
EOS = End Of Sequence
→ 하나의 단백질이 어디서 시작되고 끝나는지를 명확히 알려주는 특수 토큰
🖐 FSDP 란?
Fully Sharded Data Parallel (FSDP)
여러 GPU에 모델 파라미터를 잘게 쪼개서 나눠 저장/계산하는 기술
🖐 Dropout을 제거해도 되는가?
보통 Dropout은 과적합 방지용
ESM-2는 데이터가 너무 많고, 모델이 아주 크기 때문에
과적합 위험이 적어서 Dropout을 제거해도 괜찮았음
대신 그만큼 훈련 속도와 메모리 효율이 더 좋아짐
즉, 실험해보니 성능이 나빠지지 않아서, 최종적으로 dropout을 없앤 것
✅ ESM 1 논문
Biological structure and function emerge from scaling unsupervised learning to 250 million protein sequences
✅ 표현 공간에서 나타난 생물학적 구조 (Multi-scale Representation Analysis)
1️⃣ 아미노산 수준
Transformer 모델의 output embedding (마지막 hidden layer 출력)에서
하나의 특정 아미노산 위치 (i)에 대한 임베딩 벡터
Transformer의 output embedding을 t-SNE로 시각화하니,
아미노산들이 극성, 방향족, hydrophobic, 전하, 분자량 등 화학적 특성에 따라 클러스터링됨
학습을 통해 아미노산의 생화학적 대체 가능성을 모델이 스스로 학습
2️⃣ 단백질 수준
전체 서열 길이 T에 대해, 각 residue의 hidden representation 을 평균내어 만든 하나의 벡터
1 × 1280 크기의 단백질 전체 표현 벡터
서열 전체를 평균(mean pooling) → 1개의 1280-d 벡터로 압축하면,
같은 ortholog group (기능은 같고, 종이 다른 단백질) 끼리 클러스터됨
PCA 분석에서 종 간 차이와 기능 차이가 정직선 방향으로 드러남
PCA 결과:
- 1축은 species 차이 (e.g. 인간 vs 효모)
- 2축은 기능 차이 (e.g. kinase vs receptor)
→ 직교하는 두 개의 생물학적 정보가 표현 공간에서 선형 축으로 분리됨
Transformer는 단백질의 전체 서열에서 기능적 유사성, 진화적 관계, 종 분화 정보를 학습함
학습 전에는 이런 구조 없음 → 학습을 통해 표현 공간이 생물학적으로 정돈됨
✅ 표현 벡터에서 생물학적 정보가 추출되는가?
1️⃣ 원거리 상동성 (Remote Homology)
단백질 구조가 유사하지만 서열은 다른 경우에도, 표현 벡터 상에서 가까이 위치.
2️⃣ MSA 정렬 정보 암묵적 학습
MSA에서 align되는 residue 쌍은 representation의 cosine similarity가 높음.
ESM의 Transformer는 MSA를 입력으로 받은 적이 없음
훈련 전에는 차이가 없었으나, 훈련 후 aligned/unaligned pair를 명확히 구분.
즉, Transformer는 MSA를 직접 입력으로 받지 않았음에도, alignment 정보를 representation에 내재화하고 있다는 증거
학습 중 각 residue의 진화적 위치(보존, 변이 가능성 등)를 간접적으로 학습함
3️⃣ 구조 정보가 representation에 선형적으로 인코딩됨 (Linear Probing)
학습된 Transformer representation에 대해 단순한 로지스틱 회귀(Linear Projection)만 사용해도
- 2차 구조 (secondary structure): 8-class 분류 정확도 70% 이상
- 3차 구조 (contact map): Top-L long-range precision 49% (ESM-1b 기준)
→ 즉, 구조 정보가 nonlinear model 없이도 표현에 자연스럽게 학습되어 있음