LIKE '%두글자%'는 왜 trigram GIN 인덱스를 타지 못하는가
앞 글에서 WHERE name LIKE '%공원%'이 GIN trigram 인덱스를 만들어놨는데도 5만 건을 전부 후보로 올려버리는 걸 확인했음. 그때는 "공백 패딩 때문인 것 같다"까지만 알아내고 끝냈는데, 계속 걸리는 게 하나 있었음.show_trgm('공원')은
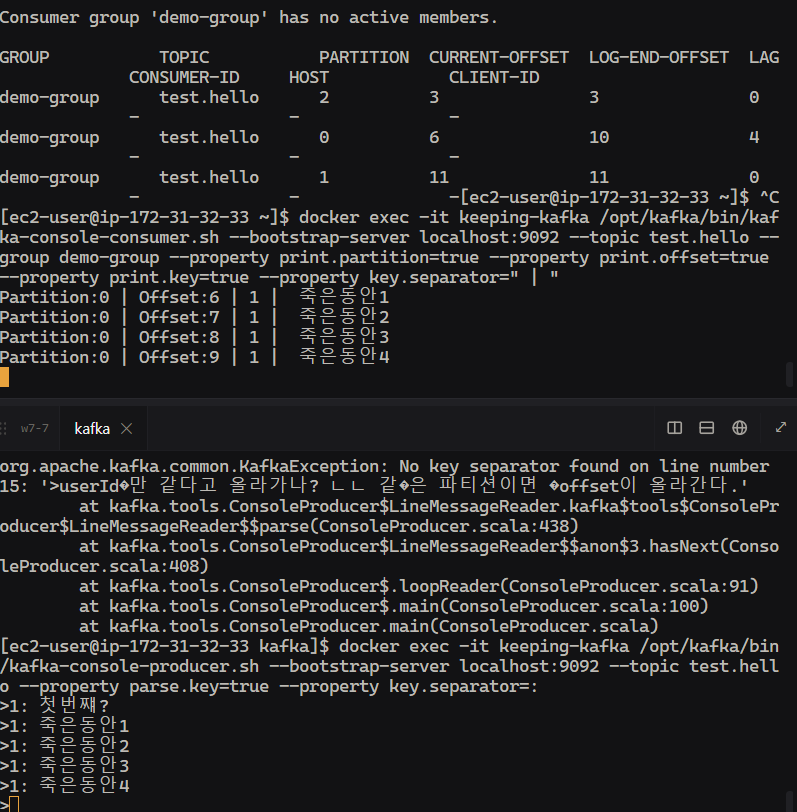
카프카 개념 정리
카프카는 여러 시스템 사이에서 데이터(메시지)를 비동기로 주고받게 해주는 메시지 중계 시스템임.A 서버가 이벤트를 카프카에 던지면, B, C 서버가 각자 원하는 시점에 그걸 받아가는 구조임.핵심은 Producer와 Consumer가 서로를 직접 알 필요가 없다는 것.
전략패턴 / 팩토리패턴
검색 기능 구현하다가 PostSearchStrategy라는 인터페이스를 이미 쓰고 있었는데, 정작 "이게 왜 전략패턴인지", "if-else로 짜면 왜 안 되는지"는 제대로 설명 못 하는 상태였음. 그래서 개념부터 다시 정리해봄.행위(알고리즘)를 인터페이스로 통일해서,
Spring AI
기존 Spring 환경에서 LLM/AI 기능을 추가하려면 Python 기반 환경을 따로 띄워야 했음. 싸피 프로젝트에서도 이렇게 AI를 직접 구현하고(내용은 잘 기억 안 남) 연동해서 띄웠던 걸로 기억함.근데 이제는 이미 만들어진 AI를 불러다 쓸 수 있음. 또한 직접
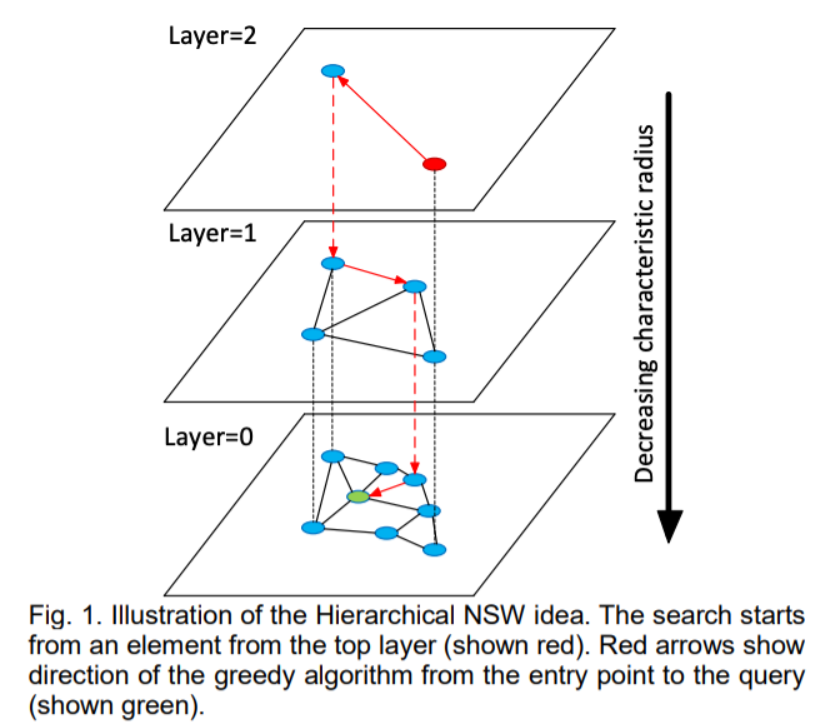
시멘틱검색
로컬 PostgreSQL(Windows, 18.1)에 pgvector를 설치하려고 했으나, 소스 빌드에 Visual Studio Build Tools(cl, nmake)가 필요한데 없었음. 새로 설치하기엔 용량/시간이 부담스러워서 Docker로 우회.기존 로컬 Post
GIN(2)
similarity()는 이런 식으로 계산됨:결과:손으로 검증:결과:word_similarity(): 긴 문자열 안에서 검색어와 가장 잘 맞는 부분 구간만 잘라내서 유사도를 계산하는 함수. 짧은 검색어로 긴 텍스트를 부분 검색할 때 사용됨.결과:결과:결론: simila
GIN(1)
결과:결과:pg_trgm은 있는데 설치가 안 된 상황임. 설치해줌.결과:결과:결과:한글 로케일임. 로케일이란 정렬/문자 판단의 규칙이라고 볼 수 있음. 해당 글자를 기반으로 판단 규칙을 정하는 거라고 보면 됨.결과:인코딩은 그 글자를 컴퓨터 메모리/디스크에 실제로 몇
하네스 설계 (2) — 모든 결정의 "왜"
하네스 설계 (2) — 모든 결정의 "왜" 이전 글에서는 개인 하네스가 무엇을 하는지를 정리했다. 이 글은 그 각각의 결정이 왜 그렇게 내려졌는지를 다룬다. 설계 문서는 결론만 적기 마련이다. "블랙리스트로 간다", "토큰은 한 턴만 유효하다", "보호 브랜치는 토

하네스 설계 (+ omc)
나는 Claude Code를 단순한 코드 생성 도구가 아니라, OMC(oh-my-claudecode)와 결합된 AI 개발 워크플로우의 일부로 사용한다.Claude Code: 코드 읽기, 파일 수정, 명령 실행, hook, transcript 등 AI 개발 런타임 제공O
Claude 를 팀프로젝트에 적용시키기
AI 코딩 도구가 쏟아지는 시대, "팀 전체가 일관되게 쓰는 것"이 진짜 경쟁력이다.AI의 발전 속도가 무섭다. 불과 1년 전만 해도 "AI가 코드를 짜준다"는 말이 과장처럼 들렸는데, 지금은 Claude Code, Cursor, Copilot 같은 도구들이 실무 개발
GIN을 만드느 기준
난 문자열을 검색할 예정이기에 문자열을 나누는 기준을 알아보겠다.: 세글자씩 잘라서 역색인 구조로 만들기: 토큰으로 잘라서 역색인 구조로 만들기의미를 가진 최소 단위무엇을 토큰으로 볼지는 토크나이저가 정함PostgreSQL의 ts_parse가 실제로 이렇게 동작함. 2
PostgreSQL은 null을 받지 못한다?
< 기존 인기순 쿼리 >cursorScore이 없으면 바로 true 되는거로 생각되었는데 첫 페이지에 제대로 반영 못함.< Hibernate가 PostgreSQL에 보내는 실제 SQL >:cursorScore 같은 이름 있는 파라미터가 $1, $2 같은 위치
GIN / GIST
데이터 규모가 작음 (게시글 수백~수천 건 수준)후보가 적으니 similarity() 전체 계산해도 빠름인덱스 크기가 작고 쓰기 부담 없음구현이 단순 — % 연산자 + ILIKE로 필터링하고 similarity()로 점수 매기면 끝 검색 응답이 체감될 정도로 느려질
트러블 슈팅 (2)
커서 기반 페이지네이션 (무한스크롤)최신 기반과 인기 기반으로 무한스크롤이 가능하다.근데 안에서 커서를 지정하는게 인코딩방식으로 한다.내가 필요한건 인기Scroe와 PostId인데, 이걸 넘겨주면 되지 않나?하지만 문제는 인기순으로만 한다면 문제가 없겠지만 전에 다른
트러블 슈팅 (1)
Native Query로 similarity() 계산 -> 정렬 -> ID만 반환함 (Join 없이 ID만)JPQL + EntityGraph 활용: ID 목록으로 author 자동 Join fetch 함.: JPA는 세 가지 종류가 있음1\. 메서드 이름으로 자동 생성
공부할 것 (설정)
그럼 지금 어떤 테스트들을 한거야? 자세하게 설명좀해줘그리고 DB를 어떻게 들어갔어? -> 이거도 뭐한건지 자세히 설명해줘아까 dev와 .env를 본 이유가 뭔지 자세하게 알려줘. 이게 목적이 뭔지오전 5:021\. 어떤 테스트를 한 거야?목적: 구현한 검색 기능이 실
GIN (+ trigram)
관련도 검색을 하려고 한다. 검색은 게시글 검색우리 서비스에선 제목, 본문, 치료영역, 나이 이렇게 내용이 있음.: 역인덱스 저장 + 역인덱스 탐색<일반 인덱스><역인덱스>: 글자를 세글자씩 쪼개는 것Ex. 개발의 신이 될거예요=> 개발의 / 발의" " /
페이지네이션
크게 세가지 방법이 있음Offset커서Keyset방식 : LIMIT와 OFFSET SQL 구문을 사용하여 특정 페이지 번호를 지정해 데이터를 가져옴.특징 : 구현이 간단, 사용자가 특정 페이지로 직접 이동하는 UI에 적합함단점 : 뒤로 갈수록 이전 행들을 모두 읽고 버
SSE (EventSource 객체)
이 내용에 대해 쓰는 이유는 토큰이 URL상 노출되어 어떤 원리가 적용되는지 공부하고자 씀HTTP : 웹에서 클라이언트와 서버가 데이터를 주고받기 위해 사용하는 가장 기초적인 약속(프로토콜) -> 요청과 응답이 존재구조: 해더(여기에 토큰), 바디(데이터-JSON,HT