Paper: RISE - RISE: Randomized Input Sampling for Explanation of Black-box Models
🔍1. Introduction
최근 딥러닝의 발전으로 다양한 분야에서 뛰어난 성능을 보이고 있지만, 모델이 왜 그런 예측을 내렸는지는 여전히 설명하기 어려움.
특히 의료 진단, 자율주행, 사법 시스템처럼 잘못된 판단이 큰 문제로 이어질 수 있는 분야에서는 모델의 예측 결과뿐 아니라 판단 근거를 함께 제공하는 Explainable AI(XAI)가 매우 중요함.
기존 XAI의 한계
기존의 대표적인 설명 기법(CAM, Grad-CAM 등)은 입력 이미지에서 어떤 영역이 예측에 중요한지 Saliency Map(Importance Map) 형태로 시각화함.
하지만 대부분 Gradient, Feature Map, Weight 등 모델 내부 정보를 필요로 하는 White-box 방식이라는 한계가 있음.
이러한 한계를 해결하기 위해, 본 논문에서는 Black-box 기반 설명 기법인 RISE를 제안함.
아래 Figure 1은 RISE를 이용해 생성한 Importance Map으로, 모델이 특정 클래스를 예측할 때 실제로 어떤 영역을 근거로 사용했는지를 보여줌.
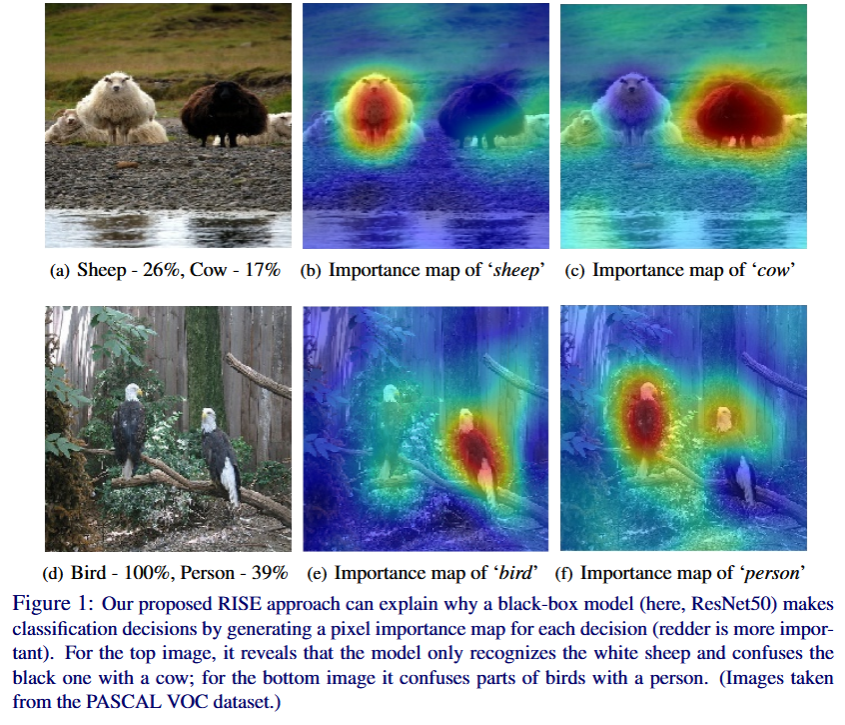
첫 번째 예시에서는 ResNet50이 여러 마리의 양이 있는 이미지에서 Cow 클래스도 함께 높은 확률로 예측했음.
RISE가 생성한 Importance Map을 확인해 보면, (a)에서 Cow 클래스의 근거가 검은 양에 집중되어 있음을 확인할 수 있음.
= 모델이 검은 양을 소처럼 인식해서 오분류가 발생했구나.
(b)에서는 Bird와 Person을 동시에 예측했는데, Person 클래스의 Importance Map이 왼쪽 새를 강하게 강조하는 것을 확인할 수 있음. 이를 통해 모델이 왼쪽 새의 일부 특징을 사람의 특징으로 잘못 해석했음을 알 수 있음.
기존 XAI 방식들은 White-box 방식임
기존 XAI 기법들은 대부분 모델 내부 정보를 필요로 함.
- Gradient
- Feature Map
- Network Weight
등을 이용해서Saliency Map을 생성함.
모델 내부 구조를 알아야만 설명을 생성할 수 있는 White-box 방식.
그리고 일부 기법은 특정 네트워크 구조나 Layer에서만 사용할 수 있다는 한계도 존재.
그래서 RISE는?
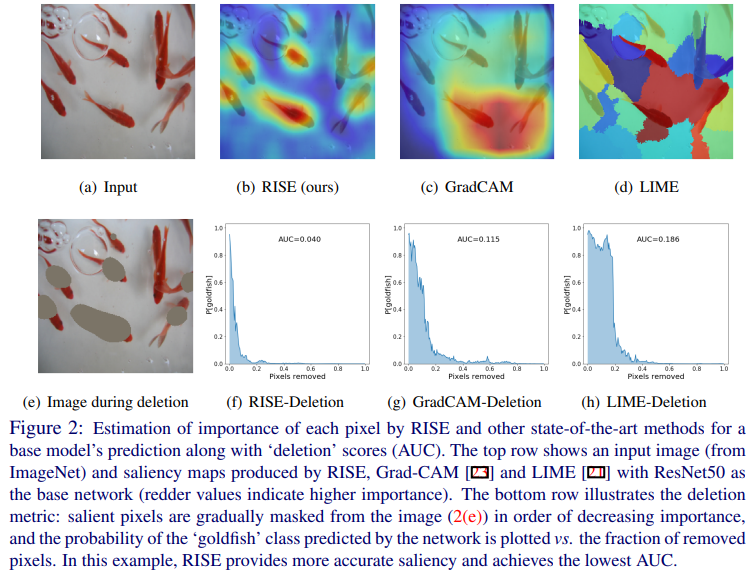
논문에서는 이러한 한계를 해결하기 위해 RISE(Randomized Input Sampling for Explanation)를 제안함.
RISE는 모델 내부를 전혀 사용하지 않는 Black-box XAI 방법임.
- Gradient를 계산하지 않고
- Feature Map도 사용하지 않고
- Weight에도 접근하지 않는다는 것.
대신 입력 이미지를 랜덤한 Binary Mask로 여러 번 가려 모델에 입력하고,
각 Mask에 대한 모델의 출력 확률을 이용해서 Pixel Importance를 추정함.
원본 이미지
        ↓
랜덤 Mask 생성
        ↓
가려진 이미지 입력
        ↓
모델 출력 확률 확인
        ↓
중요한 Pixel 추정
이 과정을 반복해서 최종 Importance Map을 생성함.
따라서 RISE는 어떤 이미지 분류 모델이든 내부 구조를 몰라도 그대로 적용할 수 있는 범용적인 Black-box 설명 기법임.
기존 Black-box 방법(LIME)과의 차이
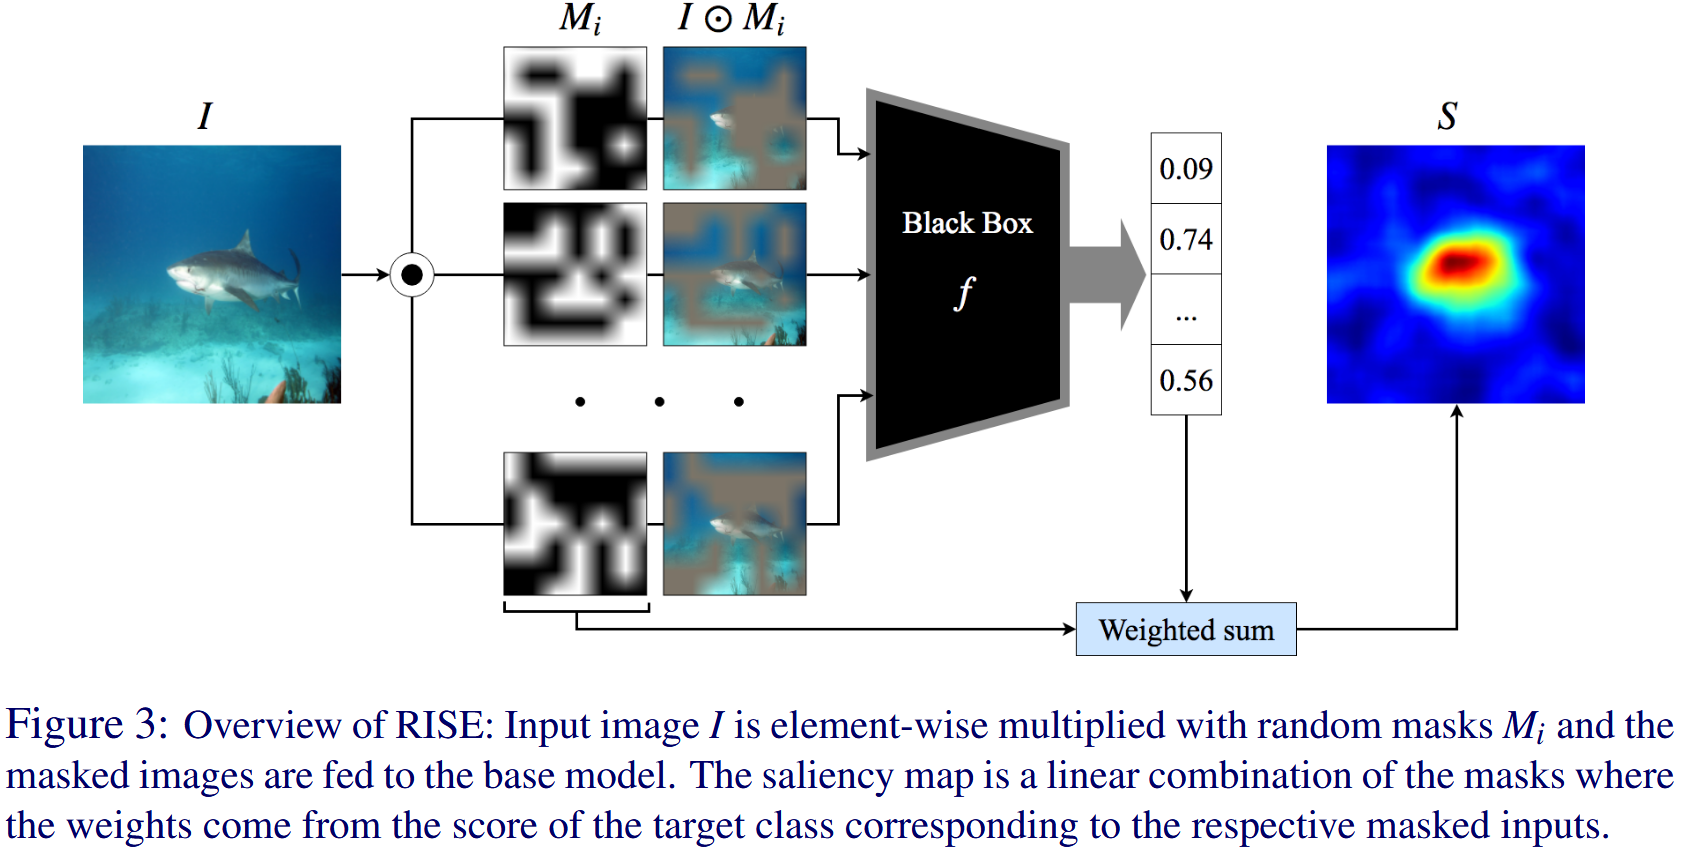
기존에도 Black-box explanation 기법인 LIME이 존재함.
하지만 LIME은 이미지를 Superpixel 단위로 분할한 뒤 중요도를 계산함.
이 경우 Superpixel 경계가 실제 객체와 맞지 않으면 중요한 영역을 정확하게 표현하지 못하는 문제가 있음.
반면 RISE는 Pixel 단위 Importance를 추정하기 때문에 더욱 세밀한 설명이 가능함.
기존 평가 방법의 한계
기존 XAI 연구들은 생성된 Saliency Map을
- Bounding Box
- Object Segmentation
- 사람의 주관적 평가
등과 비교하여 성능을 평가함.
근데 이거는 사람이 중요하다고 생각하는 영역과 얼마나 비슷한지를 평가하는 거고,
실제로 모델이 해당 영역을 근거로 판단했는지는 확인하지 못함.
(이게 중요 포인트)
ex. 사람이 소를 볼 때는 소 자체를 중요하게 생각하지만,
모델은 학습 과정에서 잔디(Grass)를 Cow의 중요한 특징으로 학습했을 수도 있음.
이 경우 사람 기준으로는 틀린 Explanation처럼 보이지만,
모델 입장에서는 실제 판단 근거일 수도 있음.
사람 기준의 평가는 모델의 실제 의사결정을 평가하는 데 한계가 있다는 것...
새로운 평가 방법 제안
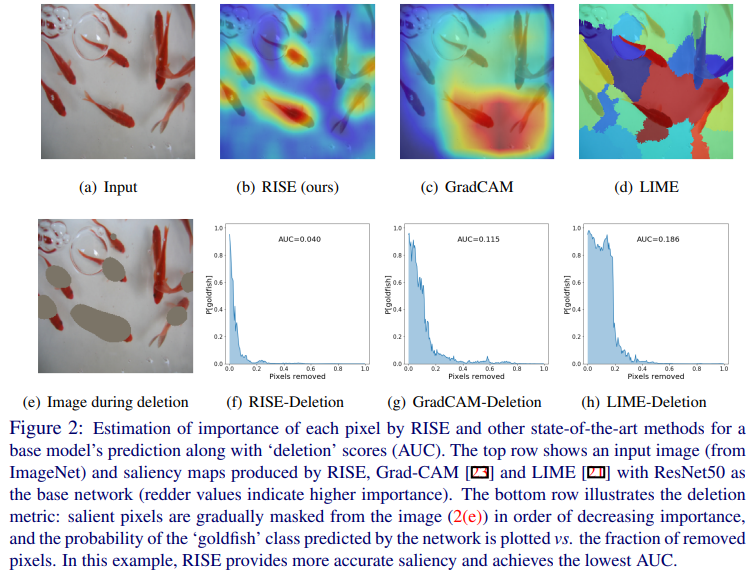
이를 해결하기 위해 논문에서는 Deletion과 Insertion이라는 두 가지 자동 평가 지표를 제안함.
-
Deletion Metric- 중요하다고 판단된 Pixel부터 제거했을 때 모델의 Confidence가 얼마나 빠르게 감소하는지 측정
- 빠르게 감소할수록 좋은 Explanation
-
Insertion Metric- 중요 Pixel부터 순서대로 추가했을 때 모델의 Confidence가 얼마나 빠르게 증가하는지 측정
- 빠르게 증가할수록 좋은 Explanation
두 지표 모두 사람이 직접 정답을 만들어 줄 필요가 없고,
모델의 실제 출력 변화를 이용하기 때문에 모델의 의사결정을 더 직접적으로 평가할 수 있는 Causal Metric임.
- 기존 XAI는 대부분 Gradient나 Feature Map 등 모델 내부 정보를 사용하는
White-box 방식임.- RISE는 모델 내부를 전혀 사용하지 않고
랜덤 Mask를 이용해 Pixel Importance를 추정하는Black-box XAI를 제안함.- 입력 이미지를 여러 번 랜덤하게 가려 모델의 출력 변화를 관찰하여 Importance Map을 생성함.
- 기존의 사람 중심 평가 대신
Deletion과Insertion이라는 자동 평가 지표를 제안하여 모델의 실제 판단 근거를 더욱 객관적으로 평가하고자 함.
✅2. Related work
본 논문에서는 기존 XAI 연구를 크게 네 가지 범주로 구분함.
1. Interpretable Model
2. Black-box Approximation
3. Neural Justification
4. Importance Map 기반 설명 기법
그리고 기존 방법들의 한계를 분석한 뒤, RISE가 왜 필요한지를 설명함.
1. Interpretable Model
초기 Explainable AI 연구에서는 모델 자체를 사람이 이해하기 쉬운 형태로 만드는 방법이 많이 연구되었음.
- Rule-based Model
- Decision Tree 등
이런 모델은 사람이 추론 과정을 직접 확인할 수 있기 때문에 높은 해석 가능성을 가짐.
하지만 복잡한 문제에서는 딥러닝보다 성능이 낮다는 한계가 존재함.
2. Black-box Approximation
또 다른 접근은 복잡한 모델을 단순한 모델로 근사(Approximation) 하는 방법임.
대표적으로 전에 읽었던 LIME(Local Interpretable Model-Agnostic Explanations)이 있음.
LIME은 설명하려는 입력 주변에서 여러 샘플을 생성한 뒤,
이를 이용해서 Sparse Linear Model을 학습하여 원래 모델을 국소적으로 근사하는 방식임.
복잡한 모델 자체를 설명하는 것이 아니라,
해당 입력 주변에서만 단순한 선형 모델을 만들어 설명하는 방식.
LIME 또한 Black-box 모델에 적용할 수 있다는 장점이 있음.
하지만 이미지에서는 Superpixel 단위로 중요도를 계산하기 때문에,
객체의 실제 경계와 맞지 않는 경우 정확한 Importance Map을 생성하지 못하는 문제가 있음.
3. Explainable CNN
이미지 분류에서는 모델의 판단 근거를 설명하기 위한 다양한 연구가 진행되어 왔음.
- 이미지의 중요한 영역을 시각적으로 표시하는 방법
- 모델의 판단 이유를 텍스트로 설명하는 방법 등.
이 중 대부분은 Saliency Map(Importance Map) 형태로
각 Pixel이 예측에 얼마나 기여했는지를 시각화함.
4. Interpretable Architecture
일부 연구에서는 처음부터 설명이 가능한 구조의 신경망을 설계함.
ex.
- Attention 기반 Image Captioning
- Neural Module Network 등.
이런 방법은 모델 내부 구조 자체를 변경해서 해석 가능성을 높임.
하지만
- 특정 네트워크 구조에서만 사용 가능하고
- 기존 모델에 그대로 적용하기 어렵다는 한계가 있음.
5. Neural Justification
기존 모델의 판단 근거를 설명하는 방법은 크게 두 가지로 나뉨.
i) Third-person Justification
추가적인 설명 모델을 학습해서
사람이 만든 Saliency Map이나 Text Annotation을 모방하는 방식.
입력 이미지
      ↓
기존 CNN
      ↓
예측 결과

+

추가 설명 모델
      ↓
설명 생성
이 방법은 사람이 직접 만든 Ground Truth Explanation이 필요하며,
explanation 품질도 해당 데이터에 크게 의존함.
ii) First-person Justification
추가 모델 없이
기존 모델 자체의 판단 근거를 직접 설명하는 방법임.
ex.
- CAM
- Grad-CAM 등.
RISE도 이 범주에 속함.
추가 모델 없이 기존 모델의 실제 판단 과정을 설명하는 것이 목적.
+ Importance Map 기반 설명 기법
Importance Map을 생성하는 대표적인 방법들도 소개함.
1. DeconvNet
CNN 내부 Feature를 시각화하는 초기 연구.
2. CAM
Feature Map의 Weighted Sum을 이용해서
Class별 Importance Map을 생성함.
하지만
Global Average Pooling(GAP) 구조에서만 사용할 수 있다는 제약이 있음.
3. Grad-CAM
CAM을 일반화해서
Feature Map의 Gradient를 이용해 Importance Map을 생성함.
대부분의 CNN에서 사용할 수 있다는 장점이 있음.
4. Perturbation 기반 방법
일부 연구에서는 입력 이미지의 일부를 변경(Perturbation)하면서
모델 출력이 얼마나 변하는지를 이용하여 중요도를 계산함.
ex.
- Fong et al.
- Cao et al. 등
근데 이런 방법들 또한
Gradient나 Feature Map 등
모델 내부 정보에 접근할 수 있어야 함.
RISE와의 차이는
기존 Importance Map 생성 방법들의 공통점은
모두
- Gradient
- Feature Activation
- Weight
등 모델 내부 정보를 필요로 한다는 것.
대부분 White-box 방식이라는 것.
반면 RISE는
모델 내부 정보를 전혀 사용하지 않음.
RISE에게 필요한 건
- 입력 이미지
- 모델의 출력 확률 뿐.
Input Image
        ↓
Black-box Model
        ↓
Output Probability
만으로 Importance Map을 생성할 수 있다는 것.
=> RISE는
모델 구조와 관계없이 그대로 적용 가능한 범용적인 Black-box XAI Framework.
- 기존 XAI는
Interpretable Model,Black-box Approximation,Neural Justification등 다양한 방향으로 연구되어 왔음.- LIME은 대표적인 Black-box 방법이지만 Superpixel 기반이라 세밀한 Importance Map 생성에 한계가 있음.
- CAM과 Grad-CAM은 대표적인 Importance Map 생성 기법이지만 Gradient나 Feature Map 등 모델 내부 정보가 필요함.
- 기존 대부분의 설명 기법은 White-box 방식으로 모델 내부 접근을 전제로 함.
- 이에 RISE는 입력 이미지와 출력 확률만 이용해서 Importance Map을 생성하는 범용적인 Black-box 설명 기법을 제안함.
✅3. Randomized Input Sampling for Explanation (RISE)
이미지 영역의 중요도를 측정하는 대표적인 방법 중 하나는 특정 영역을 가리거나 변형한 다음,
모델 출력이 얼마나 달라지는지 확인하는 것.
이거를 Perturbation이라고 함!
대표적인 Perturbation 방법:
- Pixel 값을 0으로 변경
- 특정 영역을 Blur 처리
- 입력에 Noise 추가
RISE는 이미지 내 여러 영역을 random한 조합으로 가리고,
각 입력에 대한 모델의 출력 변화를 이용해서 Pixel Importance를 추정함.
이를 위해 원본 이미지에 범위의 값을 가지는 Mask를 Element-wise Multiplication함.
- : 원본 이미지
- : 랜덤 Mask
- : 같은 위치의 원소끼리 곱하는 Element-wise Multiplication
Mask 값이 1에 가까우면 해당 영역이 그대로 유지되고, 0에 가까우면 해당 영역이 어두워지거나 완전히 가려짐.
    원본 이미지
        ⊙
    랜덤 Mask
        ↓
일부 영역이 가려진 이미지
        ↓
 Black-box Model 입력
        ↓
Target Class Confidence 기록
이 과정을 여러 번 반복하면서
어떤 Pixel이 보일 때 Target Class의 Confidence가 높아지는지 분석함.
3.1. Random Masking
Black-box Model 정의
논문에서는 Black-box Model을 다음과 같이 정의함.
- : 모델에 입력되는 이미지 공간
- : 설명하려는 Black-box Model
- : 입력 이미지 에 대한 Scalar Confidence Score
모델 는 이미지 한 장을 입력받아 특정 Target에 대한 숫자 하나를 출력함.
ex. Image Classification Model이라면
   입력 이미지 I
        ↓
Black-box Model f
        ↓
Dog Class Probability = 0.87
Image Captioning Model에서는 현재까지 생성된 문장과 이미지를 바탕으로 다음 단어가 등장할 확률을 출력할 수도 있음.
이미지 공간의 정의
크기가 인 Color Image를 다음과 같이 정의함.
여기서 이미지의 좌표 집합 는 다음과 같음.
- : 이미지 높이
- : 이미지 너비
- : 이미지의 특정 Pixel 위치
- : 각 Pixel이 RGB 세 개의 값을 가짐을 의미
이미지 는 각 위치 를 RGB 값으로 대응시키는 함수로 표현한 것.
Random Binary Mask
랜덤 Mask는 다음과 같이 정의함.
각 Pixel 위치에서 Mask 값은 0 또는 1.
- : 위치 의 Pixel 유지
- : 위치 의 Pixel 제거
원본 이미지에 Mask를 곱하면 다음과 같음.
[Mask 값이 1인 위치]

원본 Pixel × 1
= Pixel 유지
[Mask 값이 0인 위치]
원본 Pixel × 0
= Pixel 제거이 Mask는 특정 확률분포 에서 무작위로 생성됨.
Pixel Importance 정의
RISE는 특정 Pixel 의 중요도를 다음과 같이 정의함.
Pixel 가 보이는 모든 랜덤 Mask 상황에서 모델의 평균 Confidence를 계산한다는 뜻.
ex. 특정 Pixel이 강아지 얼굴에 있다고 가정하면,
해당 Pixel이 보이는 Mask들에서 Dog Confidence가 계속 높게 나타난다면, 그 Pixel은 Dog 예측에 중요한 것으로 판단함.
         Pixel λ가 보임
               ↓
Dog Confidence가 자주 높게 나타남
               ↓
   Pixel λ의 Importance가 높음
반대로 Pixel 가 보이더라도 Confidence가 낮거나 변화가 없다면 중요도가 낮다고 판단함.
왜 조건부 기대값을 사용하는가?
RISE는 Pixel을 하나씩 제거한 결과만 확인하지 않음.
한 Pixel은 여러 다른 Pixel과 함께 랜덤하게 보이거나 가려짐.
따라서 Pixel 가 보이는 여러 조합에서 모델의 출력을 평균내서 중요도를 추정함.
예를 들어 다음과 같은 결과가 있다고 가정했을 때,
| Mask | Pixel 유지 여부 | Dog Confidence |
|---|---|---|
| 1 | 0.92 | |
| 1 | 0.85 | |
| 0 | 0.10 | |
| 1 | 0.88 |
Pixel 가 보인 경우(값이 1일 때)만 선택하면 다음과 같음.
=> 해당 Pixel은 Dog 예측과 높은 관련성을 가진다고 판단할 수 있음.
Equation (1)의 합 형태
모든 가능한 Mask 에 대한 합으로 Equation (1)을 표현하면 다음과 같음.
각 Mask 에 대해
- Masked Image의 Confidence
- 해당 Mask가 발생할 조건부 확률
을 곱해서 모두 더한 것.
조건부 확률을 전개하면 다음과 같음.
Mask 에서 Pixel 가 가려져 있다면
이므로, 동시에 일 수 없음.
따라서 결합확률은 다음과 같이 표현됨.
이걸 더 간단히 쓰면,
가 0이면 전체 값이 0이 되고, 1이면 이 그대로 남게 됨.
Pixel 가 보이는 Mask만 계산에 포함시키는 역할을 함.
Equation (3)을 Equation (2)에 대입하면
이 식에서 각 Mask의 기여도는 다음 요소로 결정됨.
해당 Mask를 적용했을 때의 모델 Confidence.
해당 Mask에서 Pixel 가 보이는지 나타냄.
해당 Mask가 생성될 확률.
전체 Saliency Map으로 표현하면
Pixel 하나가 아닌 이미지 전체 위치의 중요도를 한 번에 표현하면 다음과 같음.
여기서
이므로 Pixel이 유지될 기대 확률을 으로 표현함.
Saliency Map은 Random Mask들의 Weighted Sum으로 계산된다는 것.
각 Mask에 곱해지는 Weight는 해당 Masked Image에 대한 모델의 Confidence임.
Confidence가 높은 Mask
        ↓
최종 Saliency Map에 크게 반영
Confidence가 낮은 Mask
↓
최종 Saliency Map에 작게 반영Ex.
Target Class가 Dog이라면,
세 개의 Mask에 대한 결과가 다음과 같음.
| Mask | 남겨진 영역 | Dog Confidence |
|---|---|---|
| 강아지 얼굴 | 0.95 | |
| 배경 | 0.08 | |
| 강아지 몸 | 0.80 |
최종 Saliency Map은 개념적으로 하단과 같이 계산됨.
- 강아지 얼굴을 남긴 과 몸을 남긴 은 큰 Weight를 받음.
- 배경만 남긴 는 낮은 Confidence를 출력했으니 최종 Map에 거의 반영되지 않음.
여러 랜덤 Mask에 대해 이 과정을 반복하면 강아지 영역에 높은 값이 누적됨.
Monte Carlo Sampling
실제로는 가능한 모든 Mask를 계산할 수 없음.
크기의 Binary Mask에서 가능한 조합 수는 다음과 같음.
ex. 이미지라면 가능한 Mask 수가 지나치게 많아 전체를 계산할 수 없다는 것.
=> 따라서 논문에서는 Random Mask를 유한 개만 Sampling해서 기대값을 근사하는 Monte Carlo Sampling을 사용함.
분포 에서 다음과 같이 개의 Mask를 Sampling함.
각 Mask에 대해 다음 Masked Image를 모델에 입력함.
그다음 Target Class Confidence를 계산함.
최종 Importance Map은 다음과 같이 근사됨.
식의 계산 흐름은 하단과 같음.
Random Mask Mᵢ 생성
        ↓
Masked Image I ⊙ Mᵢ 생성
        ↓
Model Confidence f(I ⊙ Mᵢ) 계산
        ↓
Mask Mᵢ에 Confidence를 곱함
        ↓
모든 결과 합산
        ↓
Mask 개수와 유지 확률로 정규화
        ↓
최종 Importance Map 생성
Equation (6)은 각 Mask를 모델의 Confidence만큼 가중해서 평균내는 방식.
특정 영역이 포함된 Mask에서 Target Class Confidence가 반복적으로 높게 나타나면 해당 영역의 값이 계속 누적됨.
반대로 특정 영역이 보이더라도 Confidence가 낮다면 해당 영역은 최종 Saliency Map에서 약하게 나타나게 됨.
RISE가 Black-box인 이유
RISE가 모델로부터 사용하는 정보는 다음 두 가지뿐.
- Masked Image 입력
- Target Class의 Output Confidence
그렇기 때문에 하단 같은 모델 내부 정보는 사용하지 않음.
- Gradient
- Feature Map
- Network Weight
- Layer 구조
그러니 모델 내부 구조를 알 수 없는 경우에도 적용 가능하다는 것.
RISE가 필요한 정보

Input
+
Output
이 때문에 RISE는 Model-agnostic한 Black-box Explanation Method로 볼 수 있음.
3.2. Mask Generation
RISE의 성능은 Random Mask를 어떻게 생성하는지에 크게 영향을 받음.
가장 단순한 방법은 원본 이미지와 같은 크기의 Mask에서 각 Pixel을 독립적으로 0 또는 1로 설정하는 것임.
하지만 이 방식에는 두 가지 문제가 존재함.
문제 1. Adversarial Effect
Pixel을 개별적으로 무작위 제거하면 이미지에 매우 sharp하고 불규칙한 Pattern이 생길 수 있음.
1 0 1 0 1
0 1 0 1 0
1 0 1 0 1
이렇게 Pixel 단위로 값이 급격하게 변하면 원본 이미지에 존재하지 않는 고주파 Pattern이나 인위적인 경계가 만들어지게 됨.
ㄱ,리고 모델은 이런 Pattern에 민감하게 반응할 수 있음.
모델 Confidence 변화가 원래 객체 영역을 제거해서가 아니라, 인위적인 Noise 때문일 수 있다는 것.
문제 2. 너무 큰 Mask Space
각 Pixel이 0 또는 1 중 하나의 값을 가질 수 있으므로 가능한 Mask 수는
그러니 이미지 해상도가 커질수록 Mask Space가 기하급수적으로 증가함.
따라서 Equation (6)의 기대값을 안정적으로 근사하려면 지나치게 많은 Sample이 필요해짐.
해결해 보자
논문에서는 원본 이미지 크기의 Binary Mask를 바로 만들지 않음.
먼저 작은 크기의 Binary Mask를 생성한 다음, 이거ㅏㄹ Bilinear Interpolation으로 확대함.
작은 Binary Mask 생성
        ↓
Bilinear Upsampling
        ↓
부드러운 큰 Mask 생성
        ↓
Random Shift 및 Crop
이 방법을 통해
- Mask의 차원을 줄여 가능한 조합 수를 줄일 수 있고,
- sharp한 edge를 완화할 수 있고,
- 최종 Importance Map을 부드럽게 생성할 수 있음.
- 그리고 다양한 공간 위치를 더 유연하게 Sampling할 수 있음.
위 solution을 단계별로 살펴보자
Step 1. 작은 Binary Mask 생성
먼저 원본 이미지보다 작은 크기인
의 Binary Mask를 개 생성함.
각 Mask Element는 독립적으로 다음 확률을 가짐.
- : 각 Mask Cell이 유지될 확률
- : 각 Mask Cell이 제거될 확률
ex. 라면 각 Cell이 1 또는 0이 될 확률이 동일함.
Step 2. Bilinear Upsampling
작은 Mask를 Bilinear Interpolation을 이용해서 큰 크기로 확대함.
Cell 크기는 하단과 같이 정의할 수 있음.
Mask를 다음 크기로 Upsampling함.
Bilinear Interpolation을 적용하면 0과 1 사이가 부드럽게 연결됨.
그래서 Upsampling 이후 Mask는 더 이상 완전한 Binary 값만 가지지 않음.
예를 들어 작은 Binary Mask가 다음과 같다고 가정함.
1 0
0 1
이거를 Bilinear Upsampling하면 개념적으로 다음과 같은 부드러운 값이 생성됨.
1.0  0.7  0.3  0.0
0.7  0.6  0.4  0.3
0.3  0.4  0.6  0.7
0.0  0.3  0.7  1.0
Mask에 원본 이미지를 곱하면 영역 사이의 급격한 경계가 완화됨.
왜 , 로 확대하는 걸까
최종 단계에서 Mask를 공간적으로 Random Shift한 뒤 영역을 Crop해야 함.
그래서 이걸 위해서 원본 이미지보다 조금 더 큰 Mask를 먼저 생성하는 것임.
Mask가 더 크게 생성돼야 위치를 옮겨도 항상 원본 이미지 크기만큼 Crop할 수 있기에.
Step 3. Random Shift와 Crop
Upsampling된 Mask에서 최종적으로 크기의 영역을 Crop함.
Crop의 시작 위치는 다음 범위에서 무작위로 선택함.
Mask를 가로·세로 방향으로 조금씩 Random Shift한 효과를 만듦.
Upsampled Mask

┌───────────────────┐
│   ┌───────────┐   │
│   │H × W Crop│   │
│   └───────────┘   │
└───────────────────┘
이 과정을 통해서 같은 저해상도 Mask Pattern도 서로 다른 위치에 적용될 수 있음.
그렇기에 이미지 영역을 더욱 다양하고 연속적으로 Sampling할 수 있음.
전체 Mask 생성 과정을 정리해보면
RISE의 Mask 생성 과정은 하단과 같음.
1. N개의 h × w Binary Mask 생성

↓

2. 각 Cell을 확률 p로 1, 확률 1-p로 0 설정

↓

3. Bilinear Interpolation으로 큰 크기로 Upsampling

↓

4. 가로·세로 방향으로 Random Shift

↓

5. H × W 크기로 Crop

↓

6. 원본 이미지와 Element-wise Multiplication
- RISE는 이미지의 여러 영역을 랜덤하게 가린 뒤 모델 Confidence 변화를 관찰함.
- 특정 Pixel이 보이는 상황에서 Target Class Confidence가 높게 유지되면 해당 Pixel의 중요도가 높다고 정의함.
- 최종 Saliency Map은 Random Mask를 모델 Confidence로 가중합해서 계산함.
- 가능한 모든 Mask를 계산할 수 없으므로 Monte Carlo Sampling으로 기대값을 근사함.
- 원본 해상도에서 Pixel별 Binary Mask를 생성하면 Adversarial Pattern과 지나치게 큰 Mask Space 문제가 발생함.
- 이를 해결하기 위해 작은 Binary Mask를 생성한 뒤 Bilinear Upsampling함.
- 마지막으로 Random Shift와 Crop을 적용하여 다양한 위치의 부드러운 Mask를 생성함.
- RISE는 모델의 입력, 출력만 사용하기에 Gradient나 Feature Map에 접근할 수 없는 Black-box Model에도 적용 가능함.
✅4. Experiments
Dataset and Base Model
RISE의 성능을 평가하기 위해 다음 3개의 공개 Object Classification Dataset을 사용함.
PASCAL VOC 2007MSCOCO 2014ImageNet
PASCAL VOC와 MSCOCO에서는 이미지에 존재하는 특정 Object Category를 Target Class로 설정해서 Importance Map을 생성함.
ImageNet에서는 모델이 가장 높은 확률로 예측한 Top-1 Class를 대상으로 Explanation을 생성함.
Base Model로는 하단 두 CNN Architecture를 사용함.
VGG16ResNet50
PASCAL VOC와 MSCOCO에서는 기존 연구와 공평하게 비교하기 위해 같은 학습 모델을 사용했고,
ImageNet에서는 PyTorch Model Zoo의 Pretrained Model을 사용함.
4.1. Evaluation Metrics
XAI 분야에서는 모델 설명의 품질을 어떻게 측정해야 하는지에 대한 통일된 기준이 아직 존재 X.
기존에는 하단 같은 Human-centered Evaluation을 사용했음.
- 사람이 Explanation을 얼마나 쉽게 이해하는지
- Explanation이 모델에 대한 신뢰를 높이는지
- Saliency Map이 Ground Truth Bounding Box와 얼마나 잘 겹치는지
하지만 이런 평가는 사람이 중요하다고 생각하는 영역과 모델이 실제로 사용한 영역을 동일하게 본다는 문제가 있음.
ex. 자동차가 도로 위에 있는 이미지에서 모델이 자동차를 예측할 때,
자동차 자체뿐 아니라 도로도 중요한 근거로 사용했을 수 있음.
하지만 Bounding Box 같은 것만 기준으로 평가하면 도로 영역을 강조한 Explanation은 잘못된 설명으로 평가될 수 있다는 것.
사람이 중요하다고 생각하는 영역과 모델이 실제로 판단에 사용한 영역은 서로 다를 수 있음.
=> 논문에서는 사람의 Annotation에 의존하지 않고 모델의 출력 변화를 직접 확인하는 자동 평가 방법을 제안함.
Deletion Metric
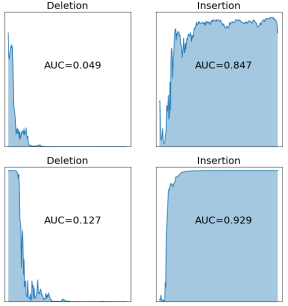
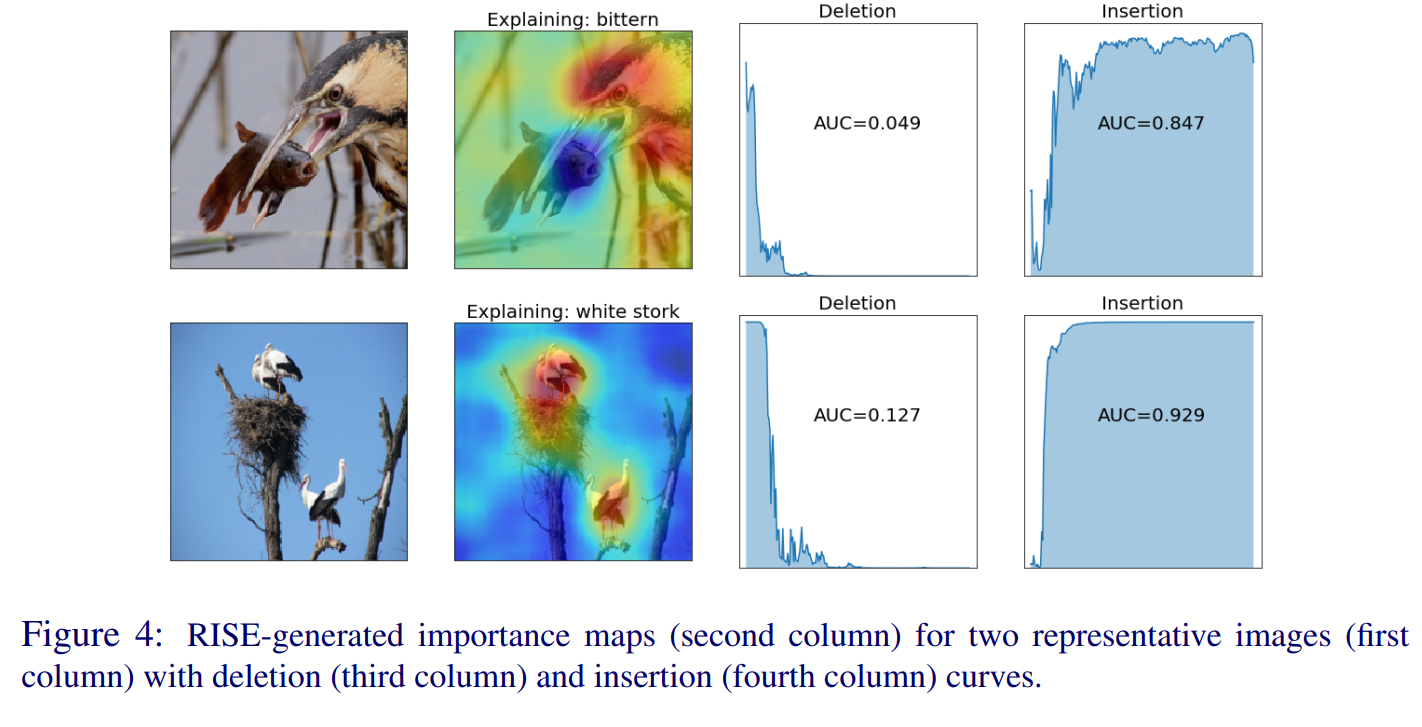
Deletion은 Saliency Map에서 중요도가 높은 Pixel부터 순서대로 제거하면서 Target Class Probability가 얼마나 빠르게 감소하는지 측정함.
중요 Pixel부터 제거
        ↓
모델의 Class Probability 측정
        ↓
Probability가 얼마나 빠르게 감소하는지 확인
좋은 Explanation이라면 실제로 모델이 중요하게 사용한 Pixel을 높은 순위에 배치해야 함.
=> 해당 Pixel들을 제거하면 모델의 Confidence가 빠르게 감소해야겠지.
Deletion Curve에서
- 가로축: 제거한 Pixel 비율
- 세로축: Target Class Probability
를 나타냄.
Probability가 빠르게 감소할수록 Curve 아래 면적인 AUC도 작아지는 것.
Deletion AUC는 낮을수록 좋음.
[좋은 Explanation]

중요 Pixel을 먼저 제거
        ↓
Confidence 급격히 감소
        ↓
     낮은 AUC
논문에서는 Pixel을 제거할 때 해당 값을 일정한 Constant Value로 변경함.
Blur를 적용하면 주변 정보와 남아 있는 저주파 정보로 모델이 제거된 부분을 어느 정도 추론할 수 있기 때문에,
중요 영역을 제거해도 Confidence가 충분히 감소하지 않을 수 있음.=> Deletion에서는 모델의 예측을 빠르게 무너뜨리기 위해 Constant Value를 사용함.
Insertion Metric
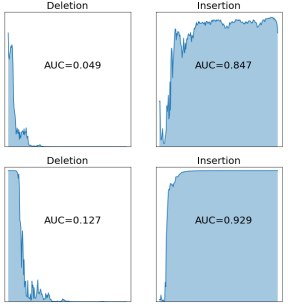
Insertion은 Deletion과 반대로 동작하는 개념임.
처음에는 원본 이미지를 강하게 Blur 처리한 상태에서 시작하지만,
그 다음 Saliency Map에서 중요도가 높은 Pixel부터 원본 값으로 복원함.
Blurred Image
        ↓
중요 Pixel부터 원본 값으로 복원
        ↓
Target Class Probability 측정
좋은 Explanation이라면 중요한 Pixel이 먼저 복원되므로
모델의 Confidence가 빠르게 증가해야 함.
Insertion Curve에서는
- 가로축: 복원한 Pixel 비율
- 세로축: Target Class Probability
Probability가 빠르게 증가할수록 AUC가 커지게 되는 것.
Insertion AUC는 높을수록 좋음.
[좋은 Explanation]

중요 Pixel을 먼저 복원
        ↓
Confidence 급격히 증가
        ↓
높은 AUC
논문에서는 Constant Canvas가 아니라 Blurred Image에서 시작함.
Constant Canvas에 일부 Pixel만 추가하면 인위적인 모양이나 날카로운 경계가 생성되어 모델이 이를 새로운 객체로 잘못 인식할 수 있기 때문임.
예를 들어 복원된 영역이 타원형으로 보이면 모델이 이를 Balloon으로 오인할 수도 있음.
Blurred Image를 사용하면 이러한 Spurious Evidence를 줄일 수 있음. :contentReference[oaicite:3]{index=3}
Deletion VS Insertion
| Metric | 평가 방식 | 좋은 방향 |
|---|---|---|
| Deletion | 중요한 Pixel부터 제거 | AUC가 낮을수록 좋음 |
| Insertion | 중요한 Pixel부터 복원 | AUC가 높을수록 좋음 |
두 Metric은 서로 반대 방향에서 Explanation의 Faithfulness를 평가함.
Deletion: 중요한 원인을 제거하면 예측이 무너지는지Insertion: 중요한 원인을 추가하면 예측이 복원되는지
Pointing Game
논문에서는 자동 평가 외에도 Human Annotation 기반 Metric인 Pointing Game을 함께 사용함.
Saliency Map에서 가장 높은 값을 가진 Pixel이 Ground Truth Bounding Box 내부에 존재하면 Hit로 판단함.
가장 중요한 Saliency Point
          ↓
객체 Bounding Box 내부
          ↓
         Hit
값이 높을수록
Saliency Map의 가장 강한 위치가
실제 객체 영역에 존재하는 경우가 많다는 의미.
다만 Pointing Game은 사람의 Bounding Box를 기준으로 하기 때문에 모델의 실제 인과적 판단 근거와 항상 일치하지는 않음.
4.2. Experimental Results
Experimental Settings
Random Binary Mask의 각 Cell은 하단처럼 같은 확률로 생성함.
모델별 Mask 개수는 다음과 같음.
VGG16: 4,000개ResNet50: 8,000개
저해상도 Binary Mask 크기는
입력 이미지 크기는
크기의 작은 Binary Mask를 생성하고
이거를 크기로 Upsampling하여 사용함.
Deletion 및 Insertion 결과
ImageNet Validation Set에서 다음 방법들과 성능을 비교함.
Grad-CAMSliding WindowLIMERISE
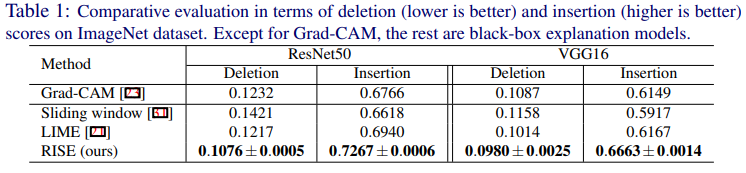
RISE는 두 Base Model 모두에서
- 가장 낮은 Deletion Score
- 가장 높은 Insertion Score
를 보임.
RISE가 중요하다고 판단한 Pixel을 제거하면
모델 Confidence가 가장 빠르게 감소했고,
해당 Pixel을 복원하면 Confidence가 가장 빠르게 증가했다는 것.
특히 RISE는 Black-box Method임에도 White-box Method인 Grad-CAM보다 높은 성능을 보였음.
Sliding Window와의 차이
Sliding Window 방식은
고정된 크기의 Window를 이미지 전체에서 이동시키면서
각 영역을 가리고 출력 변화를 확인한 것.
논문에서는 다음 설정을 사용함.
Window Size:Stride: 8
하지만 고정된 크기의 Patch를 사용하므로 객체 크기가 다양할 때 유연하게 대응하기 어려움.
하지만 RISE는 Random Mask를 사용하므로 서로 다른 크기와 위치의 영역을 다양한 조합으로 Sampling할 수 있음.
LIME과는 어떤 차이가 있을까
LIME은 1,000개의 Sample을 사용함.
이미지를 Superpixel로 나누고
각 Superpixel의 포함 여부를 변경해서
Local Linear Model을 학습함.
하지만 Superpixel 경계가 실제 모델이 중요하게 본 영역과 맞지 않을 수 있음.
반면 RISE는 부드러운 Random Mask를 사용하여 Pixel-level Importance를 추정하므로 더 세밀한 Map을 생성할 수 있음.
RISE의 계산량 문제
RISE는 수천 개의 Masked Image를 모델에 입력해야 함.
VGG16에서는 4,000번ResNet50에서는 8,000번
의 Forward Pass가 필요하다는 것.
=> Gradient 기반 방법보다 계산량이 많다는 단점이 있음.
그레서 논문에서는 더 적은 Mask로 안정적인 결과를 얻을 수 있는 Sampling 방법을 Future Work로 제시함.
Noisy Importance Map
RISE는 Monte Carlo Sampling으로 기대값을 근사하기 때문에 일부 경우에는 Noise가 포함된 Importance Map이 생성될 수 있음.
특히 이미지 속 객체들의 크기가 크게 다를 경우,
제한된 Random Mask만으로 모든 크기의 객체를 충분히 Sampling하지 못할 수 있음.
제한된 Mask Sample
        ↓
Monte Carlo Approximation Error
        ↓
Background Noise 발생 가능
논문의 Appendix에서는 이런 Failure Case도 함께 제시함.
Pointing Game 결과
PASCAL VOC 2007과 MSCOCO 2014에서 Pointing Game Accuracy를 비교함.
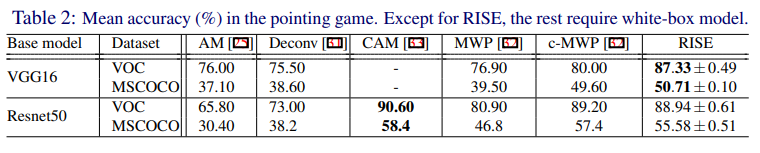
VGG16에서는 RISE가 모든 White-box Method보다 높은 성능을 기록함.
ResNet50에서는 가장 높은 성능은 아니었지만,
CAM과 c-MWP에 근접한 결과를 보였음.
RISE는 표에 포함된 방법 중 유일한 Black-box Method임에도 높은 경쟁력을 보였음.
또한 3번의 독립적인 실행에서
Standard Deviation이 낮게 나타나서
Random Mask 사용에도 비교적 안정적인 결과를 생성함을 확인함.
Pointing Game 한계
Pointing Game Accuracy가 높다고 해서
Explanation이 모델의 실제 판단 근거를 정확하게 설명한다고 단정할 수는 없음.
Saliency의 가장 높은 Pixel이
객체 Bounding Box 내부에 존재하는지만 확인하기 때문.
ex. 모델이 객체와 배경을 동시에 판단 근거로 사용했더라도,
최고점만 객체 내부에 있으면 Hit로 계산됨.
=> 논문에서는 Pointing Game보다
Deletion과 Insertion을 더 직접적인 Causal Evaluation으로 봄.
4.3. RISE for Captioning
RISE는 Image Classification뿐 아니라 Image Captioning Model에도 적용 가능함.
기존 Caption Explanation 방법은 하단과 같은 내부 정보가 필요했음.
- Attention Network
- Feature Activation
- Gradient
반면 RISE는 입력 이미지와 특정 단어의 출력 확률만 있으면 Explanation을 생성할 수 있음!
Captioning Model의 출력
Captioning Model은 입력 이미지 와 이전까지 생성된 단어들의 Partial Sentence를 바탕으로 다음 단어 의 확률을 출력함.
- : 입력 이미지
- : 이전까지 생성된 Partial Sentence
- : 설명하려는 다음 단어
- : 해당 단어의 출력 확률
Caption이 하단과 같다면(fig. 5)
A horse and carriage on a city streethorse라는 단어를 설명하고 싶다면, 이미지 영역이 horse의 출력 확률에 얼마나 영향을 주는지 계산하는 것임.
Word-specific Importance Map
입력 이미지에 Random Mask 를 적용함.
그리고 Masked Image에서 단어 의 확률을 계산함.
최종 Saliency Map은 Classification과 동일한 방식으로 계산함.
특정 Mask가 적용되었을 때 horse의 확률이 높게 유지된다면
해당 Mask 영역이 horse의 Importance Map에 크게 반영됨.
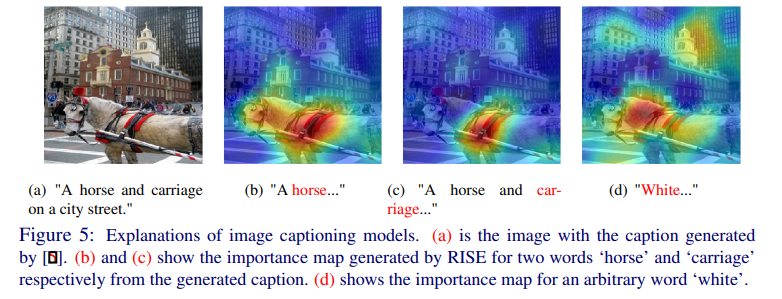
Figure 5에서는 하단 Caption이 생성된 이미지를 사용함.
A horse and carriage on a city street.단어별 Importance Map은 하단과 같음.
horse: 말이 위치한 영역을 강조함carriage: 마차 영역을 강조함white: 실제 Caption에 포함되지 않은 임의의 단어이며, 이미지 내 관련 영역에 대한 모델 반응을 분석함
RISE는 문장 전체에 대한 Explanation뿐 아니라
각 단어가 이미지의 어느 영역과 연결되는지 시각화할 수 있음.
기존 Patch 기반 방법과의 차이
기존의 유사한 연구에서는
고정된 크기의 Image Patch를 사용해 단어별 중요도를 계산했음.
하지만 고정 크기 Patch는 객체 크기가 달라질 때 적절한 영역을 잡지 못할 수 있음.
근데 RISE는 다양한 형태와 위치의 Random Mask를 사용하기 때문에
- 서로 다른 크기의 객체에 대응하기 쉬움
- 객체 주변 Context까지 함께 포착 가능함
- 특정 Patch Size에 제한되지 않음
이라는 장점을 가짐.
- 사람 중심 평가의 한계를 보완하기 위해 Deletion과 Insertion Metric을 사용함.
- Deletion은 중요 Pixel 제거 시ㅇ에 Confidence가 얼마나 빠르게 감소하는지 평가. AUC가 낮을수록 좋음.
- Insertion은 중요 Pixel 복원 시 Confidence가 얼마나 빠르게 증가하는지 평가. AUC가 높을수록 좋음.
- ImageNet 실험에서 RISE는 Grad-CAM, Sliding Window, LIME보다 우수한 Deletion 및 Insertion 성능을 기록함.
- Pointing Game에서도 Black-box Method임에도 White-box Method들과 경쟁력 있는 결과를 보임.
- 근데 수천 번의 Forward Pass가 필요해 계산량이 크고, Monte Carlo Approximation으로 인해 Noise가 발생할 수 있음.
- RISE는 Image Captioning에도 적용할 수 있고, Caption의 각 단어와 관련된 이미지 영역을 Word-specific Importance Map으로 설명 ㄱㄴ.
🔚5. Conclusion
논문에서는 RISE(Randomized Input Sampling for Explanation)를 제안함.
RISE는 모델 내부 정보를 전혀 사용하지 않고,
입력 이미지에 다양한 Random Mask를 적용해서
모델의 출력 변화를 분석함으로써 Pixel Importance를 추정하는 Black-box XAI 기법임.
기존 White-box 기반 설명 기법들과 달리 Gradient, Feature Map, Weight 등에 접근할 필요가 없기 때문에,
모델 구조와 관계없이 다양한 이미지 분류 모델에 적용할 수 있음.
실험을 통해서,
RISE는 제안한 Deletion과 Insertion이라는 Causal Metric에서 기존 설명 기법보다 우수한 성능을 보였고,
Human-centered Evaluation인 Pointing Game에서도 White-box 기법들과 경쟁력 있는 성능을 확인함.
향후에는 이런 범용성을 활용해서
비디오 등 더욱 복잡한 딥러닝 모델에도 RISE를 적용하는 방향을 Future Work로 제시함.
