Paper: Grad-CAM++ - Improved Visual Explanations for Deep Convolutional Networks
🔍1. INTRODUCTION
최근 딥러닝
:객체 인식(Object Detection), 음성 인식(Speech Recognition), 기계 번역(Machine Translation) 등 다양한 분야에서 뛰어난 성능을 보이며 실제 산업에 폭넓게 활용되고 있음.
하지만 기존의 규칙 기반(Symbolic AI) 시스템과 달리,
딥러닝 모델은 왜 그런 예측을 내렸는지 설명하기 어려운 '블랙박스(Black Box)'라는 한계 O.
기존 AI 시스템은 추론 과정을 논리적으로 기록할 수 있었기에,
사람이 그 과정을 따라가며 의사결정을 이해할 수 있었음.
반면 딥러닝 모델
: 무수히 많은 파라미터를 이용해 학습하기 때문에,
내부 동작 과정을 사람이 직접 이해하기 어려움.
특히 보안(Security), 의료 진단(Clinical Decision Support), 자율주행(Autonomous Navigation)처럼 높은 신뢰성이 요구되는 분야에서는 이런 문제가 더더욱 중요하게 작용.
Explainable AI(XAI)
이런 문제를 해결하기 위해
최근에는 Explainable AI(XAI) 분야가 활발하게 연구되고 있음.
논문에서는 대표적인 접근 방법을 크게 두 가지로 소개함.
i) 설명을 생성하는 별도의 모델을 학습하는 방법
기존 딥러닝 모델과 별도로 또 다른 모델을 학습시켜서,
왜 이런 예측을 했는지를 자연어 또는 설명 형태로 생성하는 방법.
ii) 입력을 변화시키면서 모델의 반응을 분석하는 방법
입력 이미지의 일부를 제거하거나 변경한 다음,
모델의 출력이 어떻게 변하는지를 분석해서 중요한 영역을 찾는 방법.
ex. Saliency Map, CAM, Grad-CAM 등.
하지만 이러한 연구들이 활발하게 진행되고 있음에도 불구하고...
딥러닝 모델의 의사결정을 완전히 설명하는 방법은 아직까지도 해결해야 할 과제
CNN 설명 기법의 발전
CNN(Convolutional Neural Network)의 내부 동작을 이해하기 위한 연구는 지속적으로 발전해 왔음.
Zeiler & Fergus (2014)
CNN 내부 Feature가 무엇을 학습하는지를 시각화하는 방법을 최초로 제안했음.
다만 계산량이 매우 크다는 단점 존재.
CAM (Class Activation Mapping)
이후 CAM(Class Activation Mapping)이 제안되면서,
CNN이 특정 클래스를 예측할 때 이미지의 어느 영역을 중요하게 사용했는지를 Heatmap으로 시각화할 수 있게 되었음.
CAM은 마지막 Convolution Layer의 Feature Map을 Global Average Pooling(GAP)한 다음,
각 Feature Map의 중요도를 이용햐서 Class Activation Map을 생성함.
덕분에 CNN이 어떤 영역을 보고 판단했는지를 직관적으로 확인할 수 있었음.
단, CAM은 Global Average Pooling(GAP) 구조를 반드시 사용 必.
클래스마다 별도의 Linear Classifier를 다시 학습해야 한다는 한계 존재.
Grad-CAM
이후 Selvaraju 등은 CAM을 일반화한 Grad-CAM을 제안함.
Grad-CAM은
- CAM의 클래스별(Localization) 특성과
- Guided Backpropagation 및 Deconvolution의 Gradient 정보를 결합
=> 기존 CNN 구조를 변경하거나 재학습하지 않고도 Heatmap을 생성할 수 있도록 개선.
기존 CAM보다 훨씬 다양한 CNN 모델에 적용 가능
더 높은 해상도의 시각적 설명(Visual Explanation) 제공 가능.
하지만 Grad-CAM에도 한계는 존재
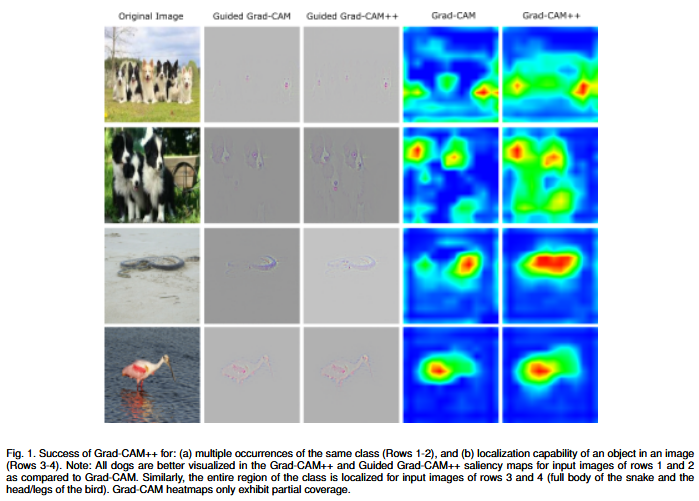
i) 동일한 객체가 여러 개 존재하는 경우(Localizing Multiple Object Instances)
이미지 안에 같은 클래스의 객체가 여러 개 존재하면,
Grad-CAM은 일부 객체만 강조하고 나머지 객체는 제대로 탐지하지 못하는 경우가 발생함.
ii) 객체 전체를 충분히 강조하지 못함
객체가 하나만 존재하는 이미지에서도,
Heatmap이 객체 전체를 설명하지 못하고 일부 영역만 활성화되는 경우 多
모델이 실제로 객체 전체를 활용해서 예측했음에도,
Grad-CAM은 일부 특징적인 영역만 강조하는 경우 존재.
이런 문제
=> 객체 Localization 성능 저하로 이어질 수 있음.
Grad-CAM++
한계 해결을 하기 위해,
본 논문에서는 Grad-CAM++을 제안함.
Grad-CAM++
: 기존 Grad-CAM을 일반화한 방법.
- 여러 개의 동일 객체를 더욱 잘 탐지하고,
- 객체 전체를 더 완전하게 Localization하며,
- 이미지뿐 아니라 영상(Video)과 같은 시공간 데이터에도 적용 가능하도록 설계됨.
주요 Contribution
논문에서 제시한 주요 Contribution은
i) Pixel-wise Gradient Weight 제안
기존 Grad-CAM은 Feature Map 전체의 Gradient를 평균내서 하나의 Weight를 계산했음.
반면 Grad-CAM++은
Feature Map 내부 각 Pixel마다 서로 다른 Weight를 계산해서
더 정확한 Importance를 반영하도록 개선했음.
그리고,
Softmax와 Exponential 출력 함수 모두에 대해
Pixel-wise Weight를 계산할 수 있는 Closed-form Solution을 유도하였음.
ii) New 평가 지표 제안
기존 Explainability 연구들은
- 사람의 주관적인 평가
- Bounding Box 기반 Localization 성능
등을 이용해서 설명 품질을 평가했음.
다만 이런 평가는
실제로 모델이 중요하게 활용한 영역과 반드시 일치하지 않을 수 있음.
=> Explanation이 모델의 실제 의사결정을 얼마나 충실하게 반영하는지(Faithfulness)를 평가할 수 있는 새로운 정량적 지표(Objective Metric)를 제안함.
iii) Human Trust 평가
사람을 대상으로 한 실험 수행
-> Grad-CAM++가 생성한 Heatmap이
기존 Grad-CAM보다
사용자가 모델을 더욱 신뢰하도록 만든다는 결과를 제시함.
iv) Weakly Supervised Localization 성능 향상
Bounding Box 없이 학습하는
Weakly Supervised Localization 환경에서도
Grad-CAM++가 기존 Grad-CAM보다
더 정확하게 객체를 Localization할 수 있음을 보였음.
v) Knowledge Distillation 활용
논문에서는 Explainability를
단순히 모델을 설명용으로만 사용하지 않았음.
Teacher 모델이 생성한 Grad-CAM++ Heatmap을 Student 모델의 학습 과정에 활용해서,
Knowledge Distillation 성능까지 향상시킬 수 있음을 제안함.
vi) 다양한 응용 분야 확장
Grad-CAM++는 이미지 분류뿐만 아니라
- Image Captioning
- 3D Action Recognition 같은
다양한 Vision Task에서도 효과적으로 활용될 수 있음을 실험을 통해 확인함.
특히,
기존 Explainability 연구가 대부분 2D 이미지에 집중되었던 것과 달리,
본 논문는 3D CNN 기반 Video 이해(Task)에도 Grad-CAM++를 적용한 몇 안 되는 연구 중 하나임.
정리해 보자면
- 딥러닝 모델은 높은 성능에도 불구하고 내부 동작을 설명하기 어려운 블랙박스라는 한계를 가짐.
- 이러한 문제를 해결하기 위해 Explainable AI(XAI)가 활발히 연구되고 있고, CAM과 Grad-CAM이 대표적인 CNN 설명 ㅣ기법으로 제안되었음.
- 하지만 Grad-CAM은 동일 객체가 여러 개 존재하는 경우와 객체 전체를 충분히 Localization하지 못하는 문제를 가지고 있었음.
- 본 논문에서는 이러한 한계를 해결하기 위해 Grad-CAM++를 제안했고, Pixel-wise Gradient Weight를 이용해 더욱 정확한 시각적 설명을 생성함.
- 또한 Faithfulness 평가, Human Trust, Weakly Supervised Localization, Knowledge Distillation, Image Captioning, 3D Action Recognition 등 다양한 분야에서 Grad-CAM++ 우수성 입증 완.
✅2. RELATED WORK
논문에서는 CNN의 의사결정을 이해하기 위한 기존 XAI 연구들을 소개하고,
기존 방법들의 한계를 분석하고, 이를 개선하기 위해 Grad-CAM++를 제안하게 된 배경을 설명함.
i) Deconvolution Network (DeconvNet)
CNN을 해석하기 위한 초기 연구 중 하나는
Zeiler & Fergus(2014)의 Deconvolution Network(DeconvNet).
: CNN의 상위 Layer에서 활성화된 뉴런(Neuron)으로부터 역방향으로 정보를 전달해서,
어떤 입력 이미지 영역이 해당 뉴런을 강하게 활성화시켰는지를 시각화하는 방법.
Input Image

↓

CNN

↓

특정 Neuron 활성화

↓

역방향(Deconvolution)

↓

어떤 이미지 영역이 해당 Neuron을 활성화했는지 확인
이를 통해 CNN 내부 Feature가 무엇을 학습했는지 확인할 수 있었음.
다만,계산량이 크고 모델 내부를 해석하는 데 많은 연산이 필요하다는 단점 존재.
ii) Guided Backpropagation
이후 Springenberg 등은 Guided Backpropagation을 제안.
Guided Backpropagation은
Backpropagation 과정에서 음수 Gradient를 제거해서,
입력 이미지에서 각 픽셀이 예측에 얼마나 영향을 줬는지를 더 선명하게 시각화하는 방법.
덕분에 DeconvNet보다 더욱 세밀한(High-resolution) Visualization이 가능해짐.
iii) Activation Maximization
Yosinski 등은
특정 뉴런이 가장 크게 활성화되도록 입력 이미지를 생성하는 방법을 제안함.
ex. 이 뉴런이 가장 좋아하는 이미지는 무엇인가??를 찾는 방식.
이후 Simonyan 등은
Gradient Ascent를 이용해서 특정 클래스의 출력을 최대화하는 이미지를 생성하고,
이를 통해 클래스별 Saliency Map을 생성하는 방법을 제안함.
iv) LIME
Ribeiro 등은 LIME(Local Interpretable Model-Agnostic Explanations)을 제안함.
LIME은 복잡한 딥러닝 모델 자체를 설명하려는 건 아니고,
예측하려는 입력 주변인 Local Region만 단순한 선형 모델이나 결정트리로 근사하여 설명하는 방법.
그러니, 복잡한 모델을 직접 해석하는 대신,
국소적인(Local) 영역에서 해석 가능한 모델을 만들어서
해당 예측의 원인을 설명하는 것임.
v) DeepLIFT
Shrikumar 등은 DeepLIFT를 제안함.
기존 Gradient 기반 방법은
입력 지점에서의 순간 Gradient만 이용하기 때문에,
Gradient가 0이 되는 경우 중요한 Feature도 설명하지 못하는 문제가 있었음.
DeepLIFT는
Gradient 대신 Discrete Gradient(Activation Difference)를 사용해서
각 입력 Feature의 중요도를 계산함.
덕분에 Gradient Saturation 문제를 일부 해결할 수 있었음.
그 외 XAI 연구
논문에서는 이외에도 다양한 Explainability 연구를 소개함.
- CEN(Contextual Explanation Networks) : 예측과 설명을 동시에 학습하는 모델
- Neuron Localization : 특정 예측에 중요한 뉴런과 입력 영역을 함께 탐색
- Representation Analysis : 은닉 표현(Hidden Representation)과 모델 예측의 관계를 통계적으로 분석
- Visual Attention 기반 자율주행 모델 : 실제 의사결정에 영향을 준 입력 영역만을 찾기 위한 연구
물론... 아직도 Explainable AI는 해결해야 할 과제가 많음
위에서 다양한 설명 기법이 제안되었지만,
논문에서는 아직까지도
딥러닝 모델의 의사결정을 충분히 설명할 수 있는 일반적인 방법은 존재하지 않는다고 설명함.
Explainable AI의 궁극적인 목적은
사람이 딥러닝 모델을 신뢰하고,
실제 산업에 안전하게 활용할 수 있도록 만드는 것...
CAM(Class Activation Mapping)
본 논문의 가장 큰 기반이 되는 방법은 CAM(Class Activation Mapping).
CAM은 마지막 Convolution Layer 뒤에 Global Average Pooling(GAP)을 적용한 CNN에서
Feature Map의 가중합을 이용해서 Class Activation Map을 생성함.
특정 클래스 의 최종 Score는 다음과 같이 계산됨.
- : 마지막 Convolution Layer의 Feature Map
- : 클래스 에 대한 Feature Map Weight
그리고 각 위치 의 Activation Map은
으로 계산됨.
Heatmap에서 값이 클수록
해당 위치가 클래스 예측에 더 중요한 영역이라는 뜻.
CAM 한계
CAM은 매우 직관적인 방법이지만, 하단 같은 제약이 존재함.
- 반드시 Global Average Pooling(GAP) 구조를 사용해야 함.
- 클래스마다 별도의 Linear Classifier를 다시 학습해야 함.
- 이미 학습된 CNN에는 바로 적용하기 어려움.
=> 적용 가능한 네트워크 구조가 매우 제한적이라는 문제가 있었음.
Grad-CAM
이러한 문제를 해결하기 위해 Grad-CAM이 제안됨.
Grad-CAM은
Feature Map의 Gradient 평균을 이용해서
각 Feature Map의 중요도를 계산함.
Feature Map의 Weight는 다음과 같이 정의됨.
- : Feature Map 전체 Pixel 개수
- : Feature Map의 Gradient
Grad-CAM은
Gradient만 계산하면 되니까,
- CNN 구조를 수정할 필요가 없고,
- 재학습도 필요 없고,
- 대부분의 CNN에 바로 적용 가능함.
또한,
Heatmap을 Guided Backpropagation과 결합해서
더 높은 해상도의 시각화(Guided Grad-CAM)도 생성할 수 있음.
하지만 Grad-CAM에도 한계는 존재함
논문에서는 기존 Grad-CAM의 가장 큰 문제점을 두 가지로 설명함.
i) 동일한 객체가 여러 개 존재하는 경우
이미지 안에 같은 클래스의 객체가 여러 개 존재하면,
Grad-CAM은 일부 객체만 강조하고 나머지 객체는 제대로 Localization하지 못함.
이는 실제 환경에서는 동일한 객체가 여러 개 등장하는 경우가 매우 흔하기 때문에 중요한 문제임.
ii) 객체 전체를 설명하지 못함
Grad-CAM은
Feature Map 전체의 Gradient를 평균내어 하나의 Weight를 계산함.
이 때문에 객체 전체가 아니라
일부 특징적인 영역만 Heatmap에 강조되는 경우가 자주 발생함.
결과적으로
객체 Localization 성능이 떨어지고,
사용자가 모델을 신뢰하기 어려워질 수 있음.
Grad-CAM++
이러한 한계를 해결하기 위해
본 논문에서는 Grad-CAM++를 제안함.
Grad-CAM++는 기존 Grad-CAM을 일반화한 방법.
- 동일 객체가 여러 개 존재하는 경우에도 더욱 정확하게 Localization하고,
- 객체 전체를 보다 완전하게 설명하고,
- 기존 Grad-CAM보다 더 신뢰할 수 있는 Visual Explanation을 제공하는 것을 목표로 함.
이를 위해
기존 Grad-CAM보다 일반화된 수식을 유도하고,
객관적(Objective)·주관적(Subjective) 실험을 모두 수행하여 성능을 비교함.
정리해 보자면
- CNN Explainability 연구
: DeconvNet → Guided Backpropagation → CAM → Grad-CAM 순으로 발전해 왔음. - CAM은 GAP 기반 구조에서 Heatmap을 생성할 수 있었지만, 네트워크 구조가 제한되고 재학습이 필요했음.
- Grad-CAM은 Gradient를 이용햐서
대부분의 CNN에서 별도의 재학습 없이 시각적 설명을 생성할 수 있었음. - 하지만 동일 객체가 여러 개 존재하는 경우와 객체 전체를 충분히 Localization하지 못하는 문제가 존재했음.
본 논문에서는 이러한 한계를 해결하기 위해 Grad-CAM++를 제안하며, 이후 장에서 Pixel-wise Gradient Weight를 이용한 새로운 방법을 설명함.
✅3. GRAD-CAM++: PROPOSED METHODOLOGY
3.1. Intuition
Grad-CAM++의 main idea는
기존 Grad-CAM처럼 모든 위치의 Gradient를 동일하게 평균내는 게 아니라,
Feature Map의 각 위치에서 계산된 Gradient에 서로 다른 중요도 Weight를 부여하는 것임
논문에서는 이를 설명하기 위해 Figure. 2의 간단한 이진 분류 예제를 사용함.
예제 설정
객체가 이미지에 존재하는지를 판단하는 Binary Classification Task를 가정함.
- 객체가 존재하지 않으면 출력:
0 - 객체가 존재하면 출력:
1
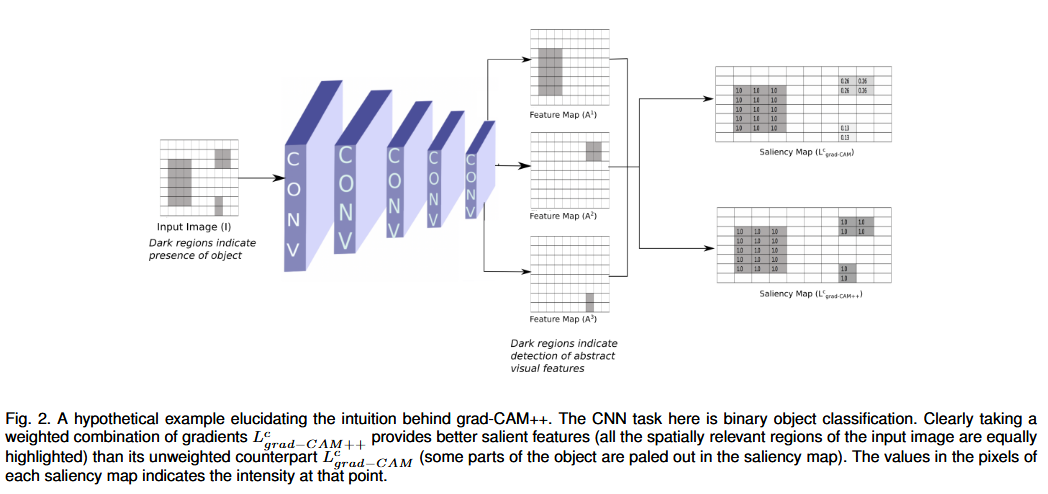
Figure. 2의 입력 이미지 에는 객체가 존재하므로, 모델의 출력은 임.
특정 클래스 에 대한 Saliency Map은 다음과 같이 표현됨.
그리고 CNN의 마지막 Convolution Layer에서 생성된 번째 Feature Map을 다음과 같이 표현함.
- : 번째 Feature Map
- : Feature Map 의 위치 에 있는 값
- : Feature Map의 공간적 위치를 나타내는 Index
Feature Map은 서로 다른 추상적인 시각적 패턴을 탐지함
그리고 피처맵 하나는
- 객체의 몸통
- 얼굴
- 다리
- 특정 방향의 윤곽선 등 서로 다른 특징에 반응할 수 있음.
논문의 단순화된 예제에서는 특정 시각적 패턴이 탐지되었는지에 따라 Feature Map의 값을 다음과 같이 설정함.
Figure. 2에서 어두운 영역은
인 위치를 의미함.
= 해당 Feature Map이 특정 패턴을 탐지한 영역.
Gradient Map 가정
클래스 Score 에 대해 Feature Map의 각 위치가 얼마나 영향을 주는지는 Gradient로 확인할 수 있음.
이 값은 Feature Map의 위치 가 클래스 의 예측에 얼마나 영향을 주는지를 의미함.
논문에서는 직관적인 설명을 위해 Gradient Map을 다음과 같이 단순화함.
- 객체의 시각적 패턴이 탐지된 위치에서는 Gradient가
1 - 탐지되지 않은 위치에서는 Gradient가
0
이라고 가정한 것.
객체의 존재에 기여하는 Feature Map 위치일수록 Gradient가 높게 나타난다는 의미.
Grad-CAM의 Feature Map Weight 계산
Grad-CAM은 Feature Map 전체의 Gradient를 평균내어 하나의 Weight를 계산하는 방식이었음.
- : 클래스 에 대한 Feature Map 의 중요도
- : Feature Map의 전체 Pixel 개수
- : 각 위치의 Gradient
Figure 2의 Feature Map은 총 80개 Pixel을 가지고 있으므로,
세 Feature Map에서 Gradient가 1인 Pixel의 개수가 각각
- 첫 번째 Feature Map: 15개
- 두 번째 Feature Map: 4개
- 세 번째 Feature Map: 2개
라면, Grad-CAM의 Weight는 다음과 같이 계산됨.
그러니 활성화된 공간의 크기가 큰 Feature Map일수록 더 큰 Weight를 받게 되는 것.
Grad-CAM에서 발생하는 문제
Grad-CAM의 최종 Saliency Map은
각 Feature Map에 해당 Weight를 곱한 뒤 합산하여 생성됨.
그런데 위 예제에서는
이기 때문에 첫 번째 Feature Map이 최종 Heatmap에서 가장 강하게 반영됨.
그러면 당연하게도 활성화된 영역이 작은 두 번째와 세 번째 Feature Map은 낮은 Weight를 받아 최종 Heatmap에서 희미해질 수 있다는 것.
Spatial Footprint 문제
논문에서는 이거를 Spatial Footprint의 차이로 설명함.
Spatial Footprint는 Feature Map에서 특정 패턴이 활성화된 공간적 범위를 의미함.
ex.
- Feature Map 1: 객체의 넓은 몸통 영역에 반응
- Feature Map 2: 객체의 작은 머리 영역에 반응
- Feature Map 3: 객체의 다리 일부에 반응
한다고 가정할 수 있음.
Grad-CAM은 Gradient를 단순 평균으로 구하니까
활성화된 Pixel이 많은 Feature Map에 더 큰 Weight를 부여함.
★ 그러니 객체를 인식하는 데 중요한 특징이라도 활성화 범위가 작으면 최종 Heatmap에서 약하게 표현될 수 있음.
활성화 영역이 넓은 Feature Map
                ↓
       평균 Gradient가 큼
                ↓
       높은 Feature Map Weight
                ↓
     최종 Heatmap에서 강하게 표시
반대로,
활성화 영역이 좁은 Feature Map
                ↓
       평균 Gradient가 작음
                ↓
       낮은 Feature Map Weight
                ↓
     최종 Heatmap에서 희미하게 표시
동일 클래스 객체가 여러 개 존재하는 경우
이 문제는 이미지에 동일한 클래스의 객체가 여러 개 존재할 때 더욱 심각해지는데,
같은 클래스 객체들이라도
- 방향
- 크기
- 자세
- 보이는 부분
- 촬영 각도
등이 서로 다를 수 있음.
그렇기에 각 객체는 서로 다른 Feature Map을 활성화할 수 있음.
근데 일부 객체에 반응하는 Feature Map의 Spatial Footprint가 작다면 해당 Feature Map은 낮은 Weight를 받게 되고,
결과적으로 Grad-CAM은 여러 객체 중 일부만 강조할 수 있음.
Grad-CAM의 단순 평균 방식은 객체의 중요성뿐 아니라 활성화된 영역의 크기에도 영향을 받음.
Grad-CAM++가 해결을 해보면,
Grad-CAM++는 이 문제를 해결하기 위해 각 위치의 Gradient를 동일하게 평균하지 않고,
Pixel-wise Gradient마다 서로 다른 Weight를 적용함.
Grad-CAM++의 Feature Map Weight는 다음과 같이 정의됨.
- : 클래스 에 대한 Feature Map 의 최종 중요도
- : 각 Pixel-wise Gradient에 부여되는 Weight
- : 위치 의 Gradient
- : 양수 Gradient만 남기는 함수
기존 Grad-CAM에서는 모든 위치의 Gradient에 똑같이
을 적용했음.
반면 Grad-CAM++에서는 각 위치마다
라는 서로 다른 Weight를 적용함.
[Grad-CAM]

모든 Pixel Gradient
        ↓
동일한 Weight 1/Z 적용
        ↓
단순 평균
[Grad-CAM++]
각 Pixel Gradient
↓
서로 다른 α Weight 적용
↓
Weighted Sum에 대해 좀 더 살펴 보자면...
는 Feature Map 의 위치 에서 계산된 Gradient가 클래스 의 예측에 얼마나 중요하게 반영되어야 하는지를 나타냄.
= 각 Pixel Gradient의 중요도를 조절하는 Weighting Coefficient
논문의 단순화된 예제에서는 를 다음과 같이 설정함.
이때
은 Feature Map 에서 양수 Gradient가 나타난 전체 개수에 해당.
각 Feature Map에 동일한 중요도를 부여하는 원리
첫 번째 Feature Map에 Gradient가 1인 위치가 15개라면,
각 위치의 는
가 됨.
따라서 Feature Map Weight는
이 됨.
두 번째 Feature Map에는 Gradient가 1인 위치가 4개이므로,
이고,
이 됨.
세 번째 Feature Map에는 Gradient가 1인 위치가 2개이므로,
이고,
이 됨.
결과적으로,
이 되니까 활성화 영역의 크기와 관계없이 각 Feature Map이 동일한 중요도로 반영됨.
덕분에 작은 객체 영역이나 객체의 일부를 탐지하는 Feature Map도 최종 Heatmap에서 사라지지 않게 됨.
근데 왜 Positive Gradient만 사용하게 되는 걸까
위의 식 에서는 Gradient에 ReLU를 적용함.
ReLU는 다음과 같이 동작함.
=>
- 양수 Gradient는 유지
- 음수 Gradient는 0으로 제거
되는 것임.
Gradient의 부호는 해당 Feature가 클래스 Score에 미치는 방향을 나타냄.
- 양수 Gradient: 해당 Feature가 활성화될수록 클래스 Score가 증가함.
- 음수 Gradient: 해당 Feature가 활성화될수록 클래스 Score가 감소함.
Grad-CAM++는 특정 클래스의 존재를 지지하는 시각적 특징을 찾는 것이 목적이므로,
클래스 Score를 증가시키는 Positive Gradient만 사용함.
[Positive Gradient]

Feature 활성화
      ↓
Class Score 증가
      ↓
해당 클래스를 지지하는 Feature
반대로 음수 Gradient는 해당 클래스의 출력을 억제하는 Feature를 의미하므로 Weight 계산에서 제외함.
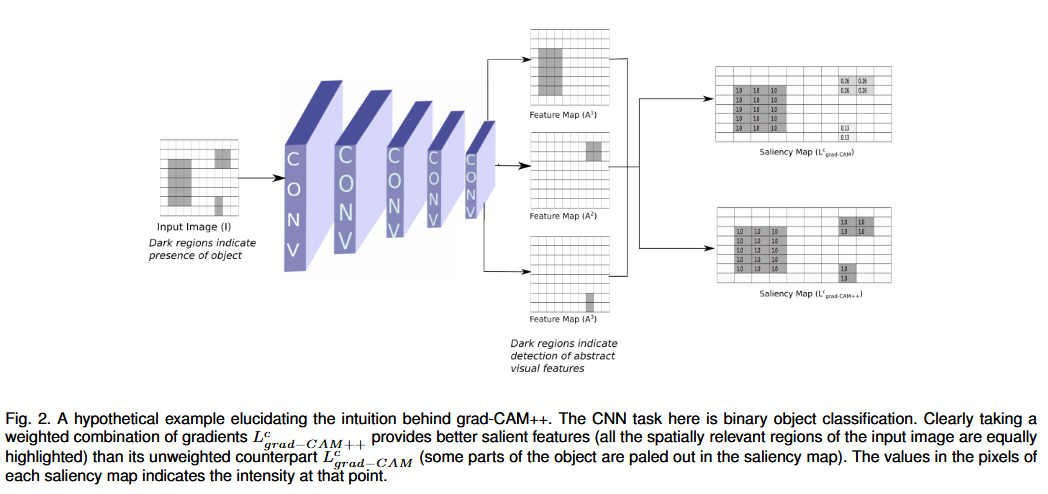
그리고 Figure. 2는 Grad-CAM과 Grad-CAM++의 차이를 단순화된 예제로 보여주는데,
다시 한번 살펴 보자면,
- Grad-CAM에서는 각 Feature Map의 Weight가 활성화된 Pixel 개수에 비례함.
=> 활성화 영역이 작은 Feature Map은 최종 Heatmap에서 희미하게 표현됨.
- Grad-CAM++는 Pixel-wise Weight인 를 적용해서,
활성화 영역의 크기가 서로 달라도 각 Feature Map의 중요한 영역을 최종 Heatmap에 충분히 반영함.
결과적으로 Grad-CAM++는 객체의 일부만 강조하는 게 아니라, 공간적으로 관련된 여러 영역을 비교적 균등하게 강조할 수 있음.
정리해 보자면,
- CNN의 각 Feature Map은 서로 다른 추상적인 시각적 패턴을 탐지함.
- Grad-CAM은 Feature Map 내부의 Gradient를 단순 평균해서 하나의 Weight를 계산함.
- 이 때문에 활성화된 공간적 범위가 넓은 Feature Map은 강하게 반영되고, 범위가 좁은 Feature Map은 최종 Heatmap에서 희미해질 수 있음.
- 이런 문제로 인해 동일 클래스의 객체가 여러 개 존재하거나 객체의 서로 다른 부분이 각기 다른 Feature Map을 활성화할 때 일부 영역이 누락될 수 있음.
- Grad-CAM++는 각 Pixel Gradient에 라는 서로 다른 Weight를 적용하여 이 문제를 해결함.
- 그리고 클래스 Score를 증가시키는 시각적 특징에 집중하기 위해 Positive Gradient만 사용함.
- Grad-CAM++의 main idea = Gradient 평균을 Pixel-wise Weighted Gradient Sum으로 확장한 것임.
3.2. Methodology
앞에서 Grad-CAM++가 기존 Grad-CAM의 단순 평균 대신, 각 Pixel-wise Gradient에 서로 다른 Weight인 를 부여한다는 main idea를 설명했고,
이제 이번 절에서는 이 를 실제로 어떻게 계산하는지 수식으로 유도하고자 함.
Grad-CAM++에서 구하고자 하는 값은?
특정 클래스 와 번째 Activation Map 에 대해,
Grad-CAM++는 다음 Weight를 사용함.
- : 클래스 에 대한 Feature Map 의 중요도
- : 위치 의 Gradient에 부여되는 Pixel-wise Weight
- : 위치 가 클래스 Score에 미치는 영향
- : Positive Gradient만 남기는 함수
그럼 이제
를 어떻게 계산할 것인가?가 엄청 중요
CAM에서 클래스 Score 는
Feature Map 전체의 합과 Feature Map Weight의 선형 결합으로 표현됨.
Grad-CAM++에서는
를 Pixel-wise Weighted Gradient로 정의했으니까,
이걸 기존 CAM 식에 대입하면 다음과 같음.
- : Feature Map 값을 합산하기 위한 위치 Index
- : Gradient Weight를 합산하기 위한 위치 Index
와 는 모두 같은 Feature Map 내부를 순회하지만,
서로 다른 합 연산을 구분하기 위해 별도의 기호를 사용한 것임.
그,니까 쉽게 말하면 ,
클래스 Score Yᶜ

=

각 Feature Map의 중요도
        ×
해당 Feature Map의 전체 Activation 합

을 모든 Feature Map에 대해 합산
이라는 것.
에서 자리에 Grad-CAM++의 Weight 식을 대입한 것.
근데 왜 유도 과정에서 ReLU를 제거하는 것인가
논문에서는 수식 유도를 단순화하기 위해
의 ReLU를 일시적으로 제거함.
ReLU는
로 작동하고, Gradient의 값 자체를 새롭게 계산하는 게 아니라
- 양수 Gradient는 통과시키고
- 음수 Gradient는 차단하는
Threshold 역할을 함.
=> 의 수학적 형태를 유도하는 과정에서는 ReLU를 제외하고 계산함.
그리고 최종 Grad-CAM++ Weight를 계산할 때는 다시 ReLU를 적용함.
1차 편미분
위 식의 양변을 에 대해 편미분함.
이 식에는 크게 두 부분이 존재함.
i) 첫 번째 항
이거는 Feature Map의 각 위치에서 계산된 Gradient에 를 곱해 합산한 값.
ReLU를 제외하면 기존에 정의한 Feature Map Weight 에 해당함.
ii) 두 번째 항
내부에 이미
가 포함되어 있으니까,
이거를 다시 에 대해 미분하면 2차 미분이 등장함.
2차 미분은
Gradient 자체가 Feature Map 값의 변화에 따라 얼마나 변하는가를 나타냄.
왜 고차 미분이 필요한가
Grad-CAM은 1차 Gradient를 단순 평균하기 때문에 각 위치의 Gradient 중요도를 동일하게 취급함.
이와 달리 Grad-CAM++는 위치마다 서로 다른 를 계산해야 함.
이를 위해서는 단순한 1차 Gradient뿐 아니라,
- Gradient가 얼마나 변화하는지 나타내는 2차 미분
- 그 2차 미분이 다시 얼마나 변화하는지 나타내는 3차 미분을
이용해 각 Gradient의 상대적인 중요도를 구함.
[1차 미분]

해당 위치가 현재 클래스 Score에 미치는 영향
[2차 미분]
해당 Gradient가 얼마나 빠르게 변하는지[3차 미분]
2차 미분의 변화 정도Grad-CAM++의 2차·3차 미분은 각 Pixel Gradient에 부여할 를 계산하기 위해 등장함.
그리고 한 번 더 편미분
아까 살펴 본 식을 다시 에 대해 편미분하면 다음과 같음.
여기서에서는 3차 미분이 등장함.
이는 2차 미분을 다시 한 번 미분한 값.
그리고 우변에서 를 공통 인자로 묶으면 다음과 같이 볼 수 있음.
이제 만 남도록 식을 정리할 수 있음.
Pixel-wise Weight 의 최종식
위에 식을 에 대해 정리하면 다음과 같음.
이 식이 Grad-CAM++의 핵심인 Pixel-wise Weight!!
분자는
로, 해당 위치의 Gradient 변화량을 나타냄.
분모는
로, Feature Map 전체 Activation과 고차 미분 정보를 함께 반영함.
는 Gradient 크기만 보는 게 아니라,
- 해당 위치의 Gradient 변화
- Feature Map 전체의 Activation
- 3차 미분에 따른 비선형 변화
를 함께 고려해서 각 Pixel Gradient의 중요도를 계산함.
는 각 위치의 Gradient가 Feature Map Weight를 계산할 때 얼마나 강하게 반영되어야 하는지를 나타내는 계수.
Grad-CAM++의 Feature Map Weight
위 식을 기존 Grad-CAM++ Weight 식에 대입하면 다음과 같음.
Grad-CAM++의 Feature Map Weight는 다음 두 요소를 곱해서 합산한 값임.
각 위치의 1차 Gradient 계산

↓

2차·3차 미분으로 α 계산

↓

α × Positive Gradient

↓

Feature Map 전체에서 합산

↓

최종 Feature Map Weight wₖᶜ
Grad-CAM과 Grad-CAM++의 관계
기존 Grad-CAM에서는 모든 위치에 동일한 Weight를 사용함.
만약 Grad-CAM++에서도 모든 에 대해
로 설정하면,
형태가 됨.
이는 Gradient를 공간적으로 평균내는 Grad-CAM의 방식과 유사해짐.
따라서 논문에서는 Grad-CAM++를
Grad-CAM의 일반화된 형태(Generalized Formulation)
로 설명함.
[Grad-CAM]

모든 위치에 동일한 Weight 1/Z
[Grad-CAM++]
각 위치에 서로 다른 Weight αᵏᶜᵢⱼGrad-CAM은 Grad-CAM++에서 모든 가 동일한 특별한 경우로 볼 수 있음.
클래스 Score가 Smooth Function이어야 하는 이유
Grad-CAM++는 를 계산할 때
- 1차 미분
- 2차 미분
- 3차 미분
을 사용함.
따라서 클래스 Score 는 여러 번 미분 가능한 Smooth Function이어야 함.
논문에서는 Penultimate Layer의 클래스 Score를 그대로 사용하는 Grad-CAM과 달리,
Grad-CAM++에서는 해당 Score를 Exponential Function에 통과시킴.
- : Penultimate Layer에서 클래스 에 해당하는 Score
- : Exponential Function을 적용한 Class Score
Exponential Function은 무한 번 미분 가능하므로,
Grad-CAM++에서 필요한 2차·3차 미분을 안정적으로 정의할 수 있음.
CAM, Grad-CAM, Grad-CAM++ 비교
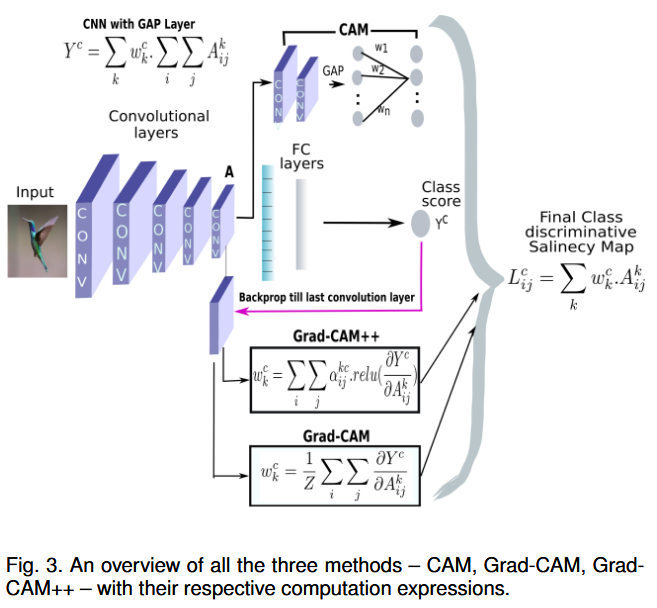
Figure. 3은 세 방법의 Weight 계산 방식을 비교함.
i) CAM
CAM은 마지막 Feature Map에 대해 학습된 Linear Classifier Weight를 사용함.
이 Weight는 모델 학습 과정에서 결정됨.
따라서 GAP 구조와 Linear Classifier가 필요함.
ii) Grad-CAM
Grad-CAM은 각 Feature Map의 Gradient를 평균내어 Weight를 계산함.
모든 공간 위치의 Gradient가 동일한 비중으로 반영됨.
iii) Grad-CAM++
Grad-CAM++는 각 위치의 Gradient에 서로 다른 를 적용함.
따라서 동일한 Feature Map 내부에서도 특정 위치의 Gradient가 더 중요한 경우 더 큰 비중을 부여할 수 있음.
정리해 보자면
- Grad-CAM++의 핵심은 각 Pixel-wise Gradient에 부여되는 Weight인 를 계산하는 것임.
- 를 유도하기 위해 클래스 Score를 Feature Map에 대해 두 번 미분하며, 이 과정에서 2차·3차 미분이 등장함.
- 최종 는 Feature Map의 Activation과 클래스 Score의 2차·3차 미분을 함께 반영함.
- Grad-CAM++의 Feature Map Weight는 와 Positive Gradient를 곱한 뒤 공간적으로 합산하여 계산함.
- 모든 를 동일한 로 설정하면 기존 Grad-CAM과 유사한 형태가 되므로, Grad-CAM++는 Grad-CAM의 일반화된 방식으로 해석할 수 있음.
- 고차 미분을 사용하기 때문에 Class Score는 여러 번 미분 가능한 Smooth Function이어야 하며, 논문에서는 Exponential Function을 사용함.
3.3. Computation Analysis
Grad-CAM++는 2차·3차 미분을 사용하므로,
기존 Grad-CAM보다 계산량이 크게 증가할 것처럼 보일 수 있음.
하지만 논문에서는 Grad-CAM++의 계산 복잡도가 기존 Grad-CAM과 동일한 수준이라고 설명함.
전체 Hessian을 계산하지 않음
일반적으로 다변수 함수의 2차 미분을 계산하면 서로 다른 변수 사이의 Cross Derivative가 포함됨.
예를 들면,
과 같은 항임.
하지만 Grad-CAM++에서는 서로 다른 위치 사이의 Cross Derivative를 사용하지 않고,
동일한 위치에 대한 미분인 Diagonal Term만 사용함.
따라서 전체 Hessian이나 고차 미분 Tensor를 계산할 필요가 없음.
각 Feature Map 위치에 대한 독립적인 고차 미분만 계산하므로 계산 부담을 줄일 수 있음.
Exponential Class Score
Penultimate Layer의 클래스 에 대한 Score를
라고 정의함.
논문에서는 최종 Class Score를 다음과 같이 설정함.
Exponential Function의 미분은 자기 자신이므로, 고차 미분 계산을 단순화할 수 있음.
1차 미분
를 에 대해 미분하면 Chain Rule에 의해 다음과 같음.
여기서
는 일반적인 Backpropagation으로 계산할 수 있음.
PyTorch나 TensorFlow와 같은 딥러닝 Framework는 Automatic Differentiation을 지원하므로,
이 값은 별도의 수식 구현 없이 자동으로 얻을 수 있음.
2차 미분
Equation (13)을 다시 한 번 미분하면 다음과 같음.
2차 미분은 두 항으로 구성됨.
- 1차 Gradient의 제곱
- 자체의 2차 미분
ReLU와 Linear Function의 2차 미분
ReLU는 다음과 같이 정의됨.
1차 미분은
임.
그리고 논문에서는 ReLU의 2차 미분을 다음과 같이 둠.
Linear Function 역시 기울기가 일정하므로 2차 미분은 임.
따라서 마지막 Layer들이 Linear Function이나 ReLU로 구성되어 있다면,
으로 볼 수 있음.
단순화된 2차 미분
에서 의 2차 미분 항을 제거하면 다음과 같음.
의 2차 미분은
Exponential Class Score × 1차 Gradient의 제곱
으로 계산됨.
단순화된 3차 미분
동일한 원리로 3차 미분은 다음과 같이 표현됨.
3차 미분 역시 별도의 복잡한 고차 미분 연산 없이,
1차 Gradient의 세제곱을 통해 표현할 수 있음.
실제 계산에 사용되는
이랑
을
에 대입하면 다음과 같음.
분자와 분모에 공통으로 존재하던
은 약분되어 사라짐.
따라서 최종적으로 는
- Feature Map Activation
- Penultimate Score에 대한 1차 Gradient
만으로 계산할 수 있음.
겉으로는 2차·3차 미분이 필요하지만, Exponential Function과 ReLU·Linear 구조를 이용하면 실제 계산은 1차 Gradient의 제곱과 세제곱으로 단순화됨.
Single Backward Pass
Grad-CAM++는
에 필요한
를 한 번의 Backpropagation으로 계산함.
이 Gradient를 얻은 후에는
- 제곱하여 2차 미분에 대응하는 값 계산
- 세제곱하여 3차 미분에 대응하는 값 계산
로 계산
을 수행하면 됨.
한 번의 Backward Pass

↓

1차 Gradient 획득

↓

Gradient², Gradient³ 계산

↓

α 계산

↓

Feature Map Weight 계산
따라서 논문에서는 Grad-CAM++가 기존 Grad-CAM과 유사한 계산 복잡도를 가진다고 설명함.
최종 Saliency Map
각 Feature Map의 Weight 를 계산한 후,
최종 Grad-CAM++ Saliency Map은 다음과 같이 생성됨.
- : 번째 Feature Map의 위치 Activation
- : 클래스 에 대한 Feature Map 중요도
- : 최종 Class-specific Saliency Map
각 Feature Map에 클래스별 Weight를 곱한 뒤 합산하고,
마지막으로 ReLU를 적용함.
최종 ReLU는 클래스 에 긍정적으로 기여하는 영역만 남기는 역할을 함.
Guided Grad-CAM++
Grad-CAM++의 Saliency Map은 마지막 Convolution Layer에서 생성되므로 원본 이미지보다 공간 해상도가 낮음.
따라서 논문에서는 다음 과정을 수행함.
Grad-CAM++ Saliency Map 생성

↓

원본 이미지 해상도로 Upsampling

↓

Guided Backpropagation 결과와 Point-wise Multiplication

↓

Guided Grad-CAM++ 생성
이를 수식으로 표현하면 개념적으로 다음과 같음.
- Grad-CAM++ : 클래스별로 중요한 영역 제공
- Guided Backpropagation : 세밀한 Pixel-level Detail 제공
- Guided Grad-CAM++ : Class-discriminative한 영역과 고해상도 Detail을 결합
정리해 보자면
- Grad-CAM++는 2차·3차 미분을 이용하여 Pixel-wise Weight 를 정의함.
- 하지만 전체 Hessian을 계산하지 않고 동일 위치에 대한 Diagonal Derivative만 사용함.
- Class Score에 Exponential Function을 적용하고, 마지막 Layer가 Linear 또는 ReLU라면 고차 미분을 1차 Gradient의 제곱과 세제곱으로 단순화할 수 있음.
- 따라서 한 번의 Backward Pass로 필요한 모든 를 계산할 수 있음.
- 계산된 Feature Map Weight와 Activation Map을 가중합한 후 ReLU를 적용하여 최종 Saliency Map을 생성함.
- 이를 Guided Backpropagation과 결합하면 더욱 세밀한 Guided Grad-CAM++를 얻을 수 있음.
3.4. Gradient Weights for Softmax Function
앞 절에서는 Class Score에 Exponential Function을 적용하여 Grad-CAM++ Weight를 계산했음.
하지만 실제 Classification Model에서는 여러 클래스의 확률을 출력하기 위해 Softmax Function을 자주 사용함.
Softmax 역시 Smooth Function이므로 Grad-CAM++에 사용할 수 있음.
Softmax Class Score
클래스 의 최종 Softmax Probability는 다음과 같음.
- : Penultimate Layer에서 클래스 의 Logit
- : 각 출력 클래스 의 Logit
- : 클래스 의 Softmax Probability
Exponential Function에서는 클래스 의 Score만 고려했지만,
Softmax에서는 분모에 모든 클래스의 Score가 포함됨.
따라서 클래스 의 Gradient를 계산할 때 다른 클래스의 영향도 함께 반영됨.
Softmax의 1차 미분
Softmax Class Score를 Feature Map 위치 에 대해 미분하면 다음과 같음.
원문에서는 클래스 합산 Index로 를 사용하지만, Feature Map Index 와 혼동을 피하기 위해 여기서는 출력 클래스 Index를 로 표현함.
첫 번째 항은
로, 해당 Feature Map 위치가 Target Class 의 Logit에 미치는 영향임.
두 번째 항은
로, 동일한 Feature Map 위치가 모든 클래스에 미치는 영향을 Softmax Probability로 가중 평균한 값임.
=> Softmax의 Gradient는
Target Class에 대한 영향에서 전체 클래스의 평균적인 영향을 뺀 값으로 볼 수 있음.
Exponential Function과 Softmax의 차이
Exponential Function에서는
이므로 클래스 만 독립적으로 고려함.
반면 Softmax에서는
이기 때문에 클래스 간 경쟁 관계가 존재함.
클래스 c의 Logit 증가

↓

클래스 c의 확률 증가
하지만 동시에
다른 클래스의 Logit 증가

↓

Softmax 분모 증가

↓

클래스 c의 확률 감소 가능
따라서 Softmax의 고차 미분식은 Exponential Function보다 복잡해짐.
Softmax의 2차 미분
네트워크의 마지막 부분이 Linear 또는 ReLU로 구성된 경우,
으로 둠.
이 조건에서 Softmax Score의 2차 미분은 다음과 같음.
첫 번째 부분은 1차 Softmax Gradient의 구조가 다시 반영된 항.
두 번째 부분은 다른 클래스 Probability의 변화까지 함께 고려하는 항.
Softmax에서는 Target Class 하나만 미분하는 것이 아니라,
하나의 Feature Map 변화가 전체 클래스 확률 분포를 어떻게 변화시키는지까지 반영해야 함.
Softmax의 3차 미분
Softmax Score의 3차 미분은 다음과 같음.
Exponential Function의 경우 2차·3차 미분이 Gradient의 제곱과 세제곱으로 단순하게 표현되었음.
반면 Softmax에서는 모든 클래스가 분모를 공유하기 때문에,
- 각 클래스의 1차 미분
- 각 클래스의 2차 미분
- 각 클래스의 Logit Gradient
가 함께 포함됨.
Softmax에서 계산
과
를 기존 식인
에 대입하면 Softmax 기반 Pixel-wise Weight를 얻을 수 있음.
Softmax에서는 2차·3차 미분식이 더 복잡하지만,
논문에서는 필요한 기본 Logit Gradient인
를 한 번의 Backward Pass로 계산할 수 있다고 설명함.
이후 해당 Gradient를 이용해 Softmax의 1차·2차·3차 미분과 를 계산할 수 있음.
왜 논문에서는 Exponential Function을 주로 사용하는가
Softmax와 Exponential Function 모두 Smooth Function이므로 이론적으로 Grad-CAM++에 사용할 수 있음.
하지만 Exponential Function은
처럼 클래스별 Score가 독립적으로 표현되며,
미분식도 단순함.
반면 Softmax는 클래스 사이의 경쟁 관계 때문에 고차 미분식이 복잡해짐.
따라서 논문에서는 계산의 단순성을 위해 Exponential Function을 사용했고,
Softmax 역시 Closed-form Expression을 통해 적용 가능함을 별도로 보였음.
정리해 보자면
- 실제 Classification Model에서는 최종 출력으로 Softmax Probability를 자주 사용함.
- Softmax는 Smooth Function이므로 Grad-CAM++의 Class Score로 사용할 수 있음.
- Softmax는 모든 클래스의 Logit을 함께 고려하므로 Exponential Function보다 1차·2차·3차 미분식이 복잡함.
- Target Class의 Gradient뿐 아니라 다른 클래스의 Probability와 Gradient도 함께 반영됨.
- 계산식은 복잡하지만 기본 Logit Gradient는 한 번의 Backward Pass로 얻을 수 있음.
- 논문에서는 수식과 계산이 더 단순한 Exponential Function을 주로 사용함.
✅4. EXPERIMENTS AND RESULTS
논문에서는 Grad-CAM++가 생성한 설명이 실제 모델의 예측과 얼마나 잘 연결되는지 확인하기 위해 다양한 실험을 수행함.
평가는 크게 두 관점으로 구성됨.
- Faithfulness: 설명이 실제 모델의 판단 근거를 얼마나 충실하게 반영하는가
- Human Interpretability / Trust: 사람이 설명을 보고 모델의 판단을 얼마나 이해하고 신뢰할 수 있는가
Heatmap이 보기 좋은지를 평가하는 것이 아니라,
Grad-CAM++가 실제 모델의 예측에 중요한 영역을 제대로 찾아냈는가를 객관적·주관적 실험을 통해 함께 검증함.
실험에 사용한 모델
모든 주요 실험에서는 기존 Grad-CAM 연구와의 공정한 비교를 위해 Caffe Model Zoo의 사전 학습된 VGG-16 모델을 사용함.
추가적으로 Appendix에서는 다음 모델에 대한 결과도 제시함.
AlexNetResNet-50
이를 통해 Grad-CAM++가 특정 CNN 구조에만 적용되는 것이 아니라, 다양한 Architecture에서도 효과적으로 작동함을 확인하고자 하였음.
4.1. Objective Evaluation for Object Recognition
먼저 객체 인식(Object Recognition) Task에서 Grad-CAM++ 설명의 Faithfulness를 정량적으로 평가함.
여기서 Faithfulness란,
Explanation Map이 실제 모델의 예측에 중요했던 영역을 얼마나 정확하게 포함하고 있는가를 의미.
Explanation Map 생성
입력 이미지 에 대해 클래스 의 Saliency Map을
라고 하면, Explanation Map 는 다음과 같이 생성됨.
- : 클래스 에 대한 Explanation Map
- : 원본 이미지 크기로 Upsampling한 Class-specific Saliency Map
- : 입력 이미지
- : Hadamard Product, 즉 같은 위치의 원소끼리 곱하는 연산
= Grad-CAM++가 중요하다고 판단한 영역만 원본 이미지에서 남기고, 중요하지 않은 영역은 약하게 만들거나 제거한 것.
원본 이미지 I
       ×
Upsampled Saliency Map Lᶜ
       ↓
Explanation Map Eᶜ
이 과정은 Grad-CAM++와 Grad-CAM 모두 동일하게 적용함.
따라서 두 방법이 생성한 Explanation Map을 모델에 다시 입력했을 때,
예측 Confidence가 어떻게 달라지는지를 비교할 수 있음.
실험 기본 idea
모델이 원본 이미지 전체를 보고 클래스 를 높은 Confidence로 예측했다고 가정함.
이후 원본 이미지 대신 Explanation Map만 입력함.
만약 Explanation Map이 모델의 실제 판단 근거를 잘 포함하고 있다면,
중요하지 않은 영역이 제거되더라도 클래스 에 대한 Confidence가 크게 감소하지 않아야 함.
반대로 Explanation Map이 실제 중요한 영역을 놓쳤다면,
모델의 Confidence가 크게 떨어질 것임.
[좋은 Explanation Map]

모델이 실제 사용한 영역을 충분히 포함
                 ↓
Explanation Map만 입력해도
Confidence가 비교적 유지됨
[좋지 않은 Explanation Map]
모델이 실제 사용한 영역을 누락
↓
Explanation Map만 입력하면
Confidence가 크게 감소함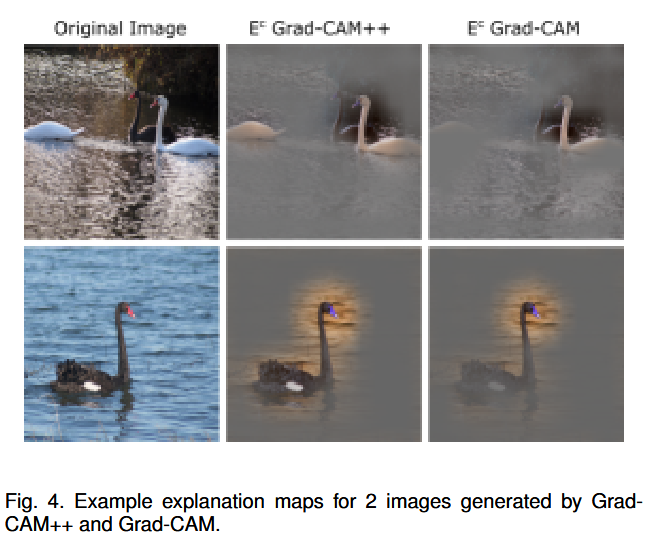
논문에서는 이를 평가하기 위해 세 가지 Metric을 사용함.
Average Drop %% Increase in ConfidenceWin %
i) Average Drop %
좋은 Explanation Map은 모델의 의사결정에 중요한 영역을 충분히 포함해야 함.
하지만 원본 이미지에서 일부 영역을 제거하면 주변 Context가 사라지므로, 일반적으로 Confidence가 어느 정도 감소하는 것은 자연스러움.
논문에서는 Grad-CAM++가 Grad-CAM보다 더 중요한 영역을 잘 포함한다면,
Explanation Map만 입력했을 때 Confidence 감소 폭도 더 작을 것이라고 가정함.
Average Drop %는 다음과 같이 계산됨.
원문 식의 의미를 명확히 표현하면 위와 같음.
- : 전체 이미지 개수
- : 번째 원본 이미지를 입력했을 때 클래스 의 Confidence
- : 번째 Explanation Map만 입력했을 때 클래스 의 Confidence
- : Confidence가 감소한 경우만 Drop으로 계산
Average Drop % 계산 예시
원본 이미지를 입력했을 때 Confidence가
이고,
Explanation Map만 입력했을 때 Confidence가
라고 가정함.
그러면 Confidence 감소율은
=> 모델의 Confidence가 원래 값보다 절반 감소한 것.
왜 를 사용하는가
경우에 따라서는 Explanation Map만 입력했을 때 오히려 Confidence가 증가할 수도 있음.
ex. 원본 이미지의 배경이 모델의 판단을 방해하고 있었다면,
설명 영역만 남겼을 때 Target Class가 더 명확해질 수 있음.
이때
가 되므로 Confidence Drop은 음수가 됨.
하지만 Average Drop Metric은 감소량만 측정하려는 지표이므로,
를 사용해 Confidence가 증가한 경우에는 Drop을 으로 처리함.
Average Drop %의 해석
Average Drop %는 낮을수록 좋음.
[낮은 Average Drop %]

Explanation Map만 입력해도
기존 Confidence가 잘 유지됨
        ↓
모델이 실제 사용한 영역을
잘 포함한 설명
반대로 값이 높다면 Explanation Map에서 모델의 판단에 중요했던 정보가 많이 제거됐다는 의미.
=> Grad-CAM++의 Average Drop %가 Grad-CAM보다 낮다면,
Grad-CAM++가 모델의 실제 판단 근거를 더 잘 포착했다고 해석할 수 있음.
ii) % Increase in Confidence
Average Drop %와 반대로,
Explanation Map만 입력했을 때 모델의 Confidence가 오히려 증가하는 경우도 존재함.
이는 원본 이미지의 배경이나 주변 객체가 모델의 판단에 방해가 되었지만,
Explanation Map이 중요한 영역만 남겨 Target Class를 더 명확하게 만든 경우임.
논문에서는 전체 Dataset 중 Explanation Map 입력 후 Confidence가 증가한 이미지의 비율을 계산함.
- : 조건이 참이면 1, 거짓이면 0을 반환하는 Indicator Function
- : Explanation Map을 입력한 뒤 Confidence가 증가한 경우
% Increase in Confidence 계산 예시
전체 이미지가 100장이고,
그중 30장에서 Explanation Map만 입력했을 때 Confidence가 증가했다면,
% Increase in Confidence 해석
이 지표는 높을수록 좋음.
[높은 % Increase in Confidence]

Explanation Map이
불필요하거나 방해되는 Context를 제거
              ↓
Target Class에 중요한 정보가
더 선명하게 남음
              ↓
모델 Confidence 증가
Grad-CAM++의 값이 더 높다면,
Grad-CAM++가 모델의 판단에 필요한 영역을 더 정교하게 분리해 냈다고 볼 수 있음.
iii) Win %
앞의 두 지표는 Grad-CAM++와 Grad-CAM의 전체 Dataset 평균 성능을 각각 평가함.
Win %는 각 이미지 단위에서 두 방법을 직접 비교하는 지표.
특정 이미지에서
- Grad-CAM++ Explanation Map의 Confidence 감소량
- Grad-CAM Explanation Map의 Confidence 감소량
을 비교하고,
Grad-CAM++의 Confidence 감소가 더 작으면 Grad-CAM++가 해당 이미지에서 이긴 것으로 판단.
Grad-CAM++ Confidence Drop
<
Grad-CAM Confidence Drop

↓

해당 이미지에서 Grad-CAM++ 승리
전체 이미지 중 Grad-CAM++가 승리한 비율을 백분율로 나타낸 것이 Win %.
Win %의 의미
Win %가 높다는 것은 단순히 일부 이미지에서 큰 개선을 보인 것이 아니라,
Dataset의 많은 이미지에서 Grad-CAM++가 Grad-CAM보다 일관되게 더 좋은 설명을 생성했다는 의미
=> 따라서 Average Drop %와 % Increase in Confidence를 보완하는 지표로 사용됨.
세 지표 차이
| Metric | 의미 | 좋은 방향 |
|---|---|---|
| Average Drop % | Explanation Map 입력 후 Confidence가 얼마나 감소하는가 | 낮을수록 좋음 |
| % Increase in Confidence | Explanation Map 입력 후 Confidence가 증가한 이미지 비율 | 높을수록 좋음 |
| Win % | Grad-CAM++가 Grad-CAM보다 Confidence를 더 잘 유지한 이미지 비율 | 높을수록 좋음 |
세 지표를 함께 사용함으로써 Explanation Map의 Faithfulness를 한 가지 기준에만 의존하지 않고 다각도로 평가함.
ImageNet 실험 결과
논문에서는 ImageNet ILSVRC 2012 Validation Dataset을 사용하여 Grad-CAM++와 Grad-CAM을 비교함.
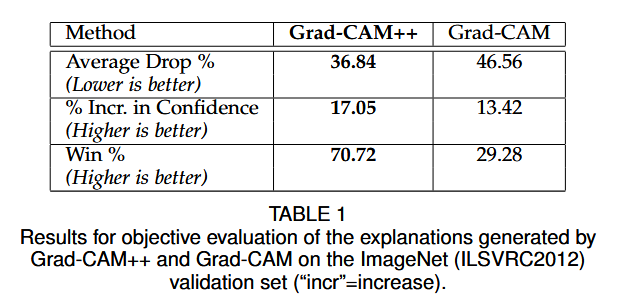
그 결과 Grad-CAM++는 세 지표 모두에서 Grad-CAM보다 더 좋은 성능을 보였음.
Average Drop %는 더 낮았고,% Increase in Confidence는 더 높았으며,Win %에서도 Grad-CAM++가 우세했음.
Grad-CAM++의 Pixel-wise Weighting 방식이 기존 Grad-CAM의 단순 Gradient 평균보다 모델의 실제 판단 구조를 더 잘 반영한다는 것을 의미.
Pascal VOC 2007 실험
논문에서는 ImageNet뿐만 아니라 Pascal VOC 2007 Validation Dataset에서도 동일한 실험을 수행함.
이 실험에서는 ImageNet으로 사전 학습된 VGG-16을 Pascal VOC 2007 Train Dataset으로 Fine-tuning한 뒤 평가함.
Pascal VOC는 하나의 이미지에 여러 객체가 함께 포함되는 경우가 많기 때문에,
Grad-CAM++의 Multi-object Localization 능력을 평가하기에 적합함.
실험 결과에서도 Grad-CAM++는 Grad-CAM보다 더 우수한 결과를 나타냄.
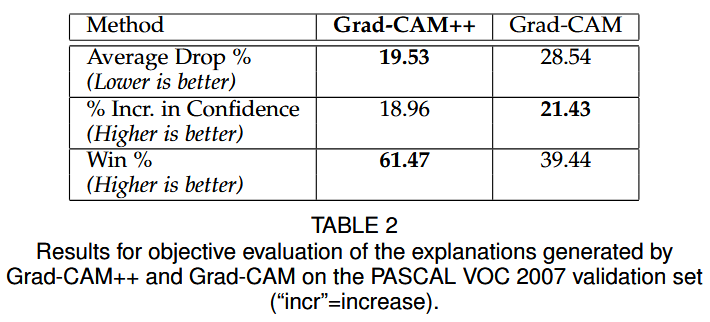
왜 이 결과가 Grad-CAM++의 가설을 뒷받침하는가
Grad-CAM++는 기존 Grad-CAM과 달리 각 위치의 Gradient에 Pixel-wise Weight를 적용함.
이 방식은 활성화 범위가 좁더라도 중요한 Feature를 최종 Explanation Map에 충분히 반영할 수 있게 함.
따라서 Explanation Map만 모델에 다시 입력하더라도,
예측에 실제로 필요했던 객체 영역이나 Context가 더 많이 유지됨.
그 결과
- Confidence 감소가 작고,
- 경우에 따라 Confidence가 증가하며,
- 이미지별 직접 비교에서도 Grad-CAM++가 더 자주 우세한 결과
가 나타난 것임.
다른 CNN Architecture에서도 검증
논문은 주요 본문에서 VGG-16을 사용했지만,
Appendix에서는 AlexNet과 ResNet-50에서도 실험을 수행함.
이를 통해 Grad-CAM++의 성능 향상이 특정 Network Architecture에만 의존하는 현상이 아니라는 점을 추가로 검증함.
정리해 보자면
- Grad-CAM++의 설명이 실제 모델 판단과 얼마나 일치하는지 확인하기 위해 Faithfulness 실험을 수행함.
- Saliency Map과 원본 이미지를 Element-wise Multiplication하여 Explanation Map을 생성함.
- Explanation Map만 다시 모델에 입력하고 원본 이미지 입력 결과와 Confidence를 비교함.
Average Drop %는 낮을수록,% Increase in Confidence와Win %는 높을수록 좋은 설명임.- ImageNet과 Pascal VOC 2007 모두에서 Grad-CAM++가 Grad-CAM보다 세 지표 전반에서 우수한 결과를 보였음.
- 이는 Grad-CAM++의 Pixel-wise Gradient Weighting이 모델의 실제 의사결정에 중요한 영역을 더 충실하게 포함한다는 것을 보여줌.
- AlexNet과 ResNet-50에서도 실험을 수행해서 다양한 CNN Architecture에 적용 가능함을 확인함.
4.2. Evaluating Human Trust
앞 절에서는 Grad-CAM++가 모델의 실제 예측 근거를 얼마나 충실하게 반영하는지, 즉 Faithfulness를 객관적으로 평가했음.
이번 절에서는 사람이 Grad-CAM++의 설명을 보았을 때 모델의 판단을 얼마나 쉽게 이해하고 신뢰할 수 있는지 평가함.
Grad-CAM++의 Heatmap이 Grad-CAM보다 사람에게 더 이해하기 쉽고, 모델에 대한 더 높은 신뢰를 유도하는지
실험 데이터 구성
논문에서는 ImageNet Validation Set에서 5개의 클래스를 선정함.
각 클래스에는 50개의 이미지가 있으므로, 총 실험 이미지 수는 다음과 같음.
각 이미지에 대해 두 개의 Explanation Map을 생성함.
- Grad-CAM Explanation Map
- Grad-CAM++ Explanation Map
Grad-CAM은 비교를 위한 Baseline으로 사용됨.
왜 F1-score가 높은 클래스를 선택했는가
논문에서는 ImageNet Validation Set에서 F1-score가 0.94보다 높은 5개 클래스를 선택함.
이는 모델이 해당 클래스들을 이미 엄청 잘 분류하고 있는 상황에서 설명 기법의 품질을 비교하기 위함임.
만약 모델이 클래스를 잘못 예측한 상태라면,
설명 Map이 이상한 이유가
- 설명 알고리즘의 문제인지
- 모델 자체의 잘못된 판단 때문인지
구분하기 어려움.
따라서 모델의 분류 성능이 높은 클래스를 사용해서,
모델이 올바르게 판단한 상황에서 Grad-CAM과 Grad-CAM++ 중 어느 설명이 더 신뢰할 만한가를 평가한 것임.
왜 Classification Error가 아니라 F1-score를 사용했는가
각 클래스는 Validation Set에 50개의 이미지만 포함하고 있음.
이처럼 클래스별 Sample 수가 제한적인 상황에서는 단순 Classification Error보다 Precision과 Recall을 함께 반영하는 F1-score가 적절하다고 논문에서는 설명함.
F1-score는 다음과 같이 정의됨.
- Precision: 해당 클래스로 예측한 것 중 실제로 맞은 비율
- Recall: 실제 해당 클래스 이미지 중 올바르게 찾아낸 비율
즉, F1-score는 Precision과 Recall의 조화 평균.
실험 참가자
총 13명의 사람이 실험에 참여함.
(딥러닝이나 해당 연구 분야에 대한 사전 지식이 전혀 없는 일반 사용자로 구성)
: 전문가의 관점이 아니라 실제 비전문 사용자가 Explanation Map을 어떻게 받아들이는지를 평가하기 위함임.
실험 방법
각 참가자에게 다음 정보를 보여줌.
- 원본 이미지
- 이미지의 클래스 이름
- Grad-CAM Explanation Map
- Grad-CAM++ Explanation Map
단, 참가자는 어떤 Map이 Grad-CAM이고 어떤 Map이 Grad-CAM++인지 알 수 없었음.
= Blind Test 형태로 실험을 진행한 것.
참가자는 두 Heatmap 중
이미지 속 객체를 더 잘 설명한다고 느껴지는 Map을 선택함.
또한 두 Explanation Map이 비슷하다고 생각한 경우에는
same을 선택할 수 있었음.
Human Trust를 어떻게 정의했는가
논문에서는 더 많은 선택을 받은 설명 알고리즘이,
기반 모델인 VGG-16의 판단에 대해 더 높은 Human Trust를 유도한다고 보았음.
쉽게 말하면,
Heatmap이 객체를 더 정확하고 완전하게 강조함
                    ↓
사용자가 모델이 무엇을 보고 판단했는지 이해함
                    ↓
모델의 예측을 더 신뢰하게 됨
이라는 가정.
점수 정규화 방식
각 이미지에 대해 13명의 응답을 받았음.
ex. 한 이미지에서 다음과 같은 응답이 나왔다고 가정함.
- Grad-CAM++ 선택: 5명
- Grad-CAM 선택: 4명
- same 선택: 4명
그러면 각 방법의 정규화된 점수는 다음과 같음.
나머지 약 은 same에 해당함.
논문에서는 각 이미지의 정규화된 총점이 반올림으로 인해 약 가 될 수 있다고 설명함.
250개 이미지 전체에서 얻을 수 있는 총점은 250점.
Human Trust 실험 결과
전체 결과는 다음과 같음.
| 선택 항목 | 점수 |
|---|---|
| Grad-CAM++ | 109.69 |
| Grad-CAM | 56.08 |
| Same | 84.23 |
| Total | 250 |
Grad-CAM++의 점수는
로,
Grad-CAM의
보다 약 두 배 가까이 높았음.
= 참가자들이 Grad-CAM++의 Explanation Map이 객체를 더 잘 설명한다고 판단한 경우가 훨씬 많았다는 의미.
Same 응답의 의미
전체 250점 중 84.23점은 두 방법이 비슷하다는 same 응답이었음.
이를 비율로 나타내면 약 다음과 같음.
약 33.69%의 경우에는 Grad-CAM++와 Grad-CAM의 결과가 유사하게 평가됨.
논문에서는 그 이유를 Grad-CAM++가 Grad-CAM의 일반화된 형태이기 때문이라고 설명함.
Grad-CAM++가 모든 상황에서 완전히 다른 Heatmap을 생성하는 게 아니라,
일부 이미지에서는 기존 Grad-CAM과 비슷한 결과를 생성할 수 있다는 의미.
결과 해석
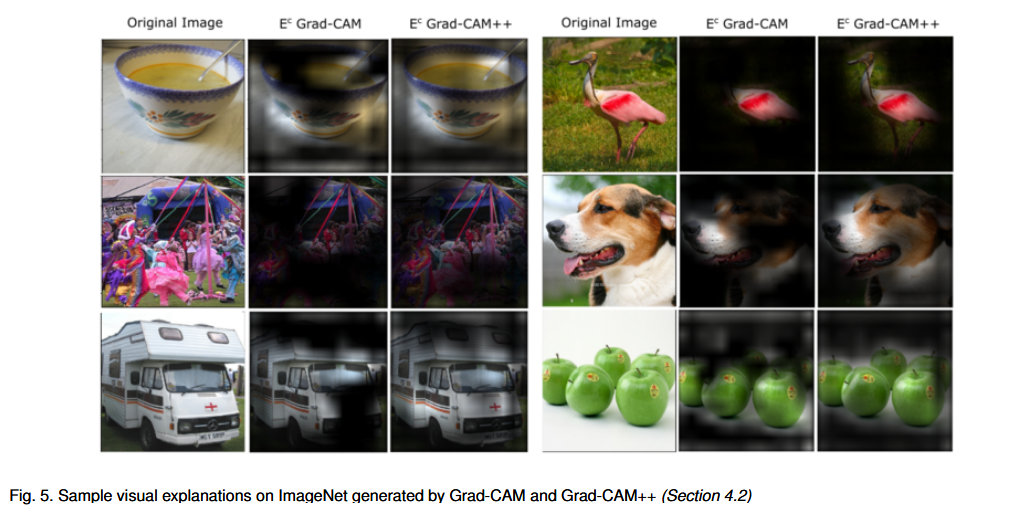
Grad-CAM++는 Pixel-wise Gradient Weighting을 사용해서
- 객체의 여러 부분
- 동일 클래스의 여러 객체
- 활성화 범위가 작은 Feature
를 더 잘 반영함.
=> Heatmap이 객체의 일부만 강조하기보다 객체의 더 넓고 완전한 영역을 보여줄 가능성이 높음.
이런 차이가 비전문 참가자에게도 시각적으로 인식됐고,
결과적으로 Grad-CAM++가 모델의 판단을 더 이해하기 쉽고 신뢰할 만하게 만든 것으로 해석됨.
Grad-CAM++는 수치상의 성능 향상도 이뤄내고, 사람이 체감할 수 있는 설명 품질 향상으로 이어졌음.
정리해 보자면
- 4.1절에서는 Explanation의 Faithfulness를 정량적으로 평가했고, 이번 4.2 절에서는 Human Trust를 평가함.
- ImageNet에서 F1-score가 0.94 이상인 5개 클래스를 선정하여 총 250개 이미지를 사용함.
- 딥러닝 지식이 없는 13명의 참가자가 Grad-CAM과 Grad-CAM++ 중 객체를 더 잘 설명하는 Heatmap을 선택함.
- 참가자는 어떤 알고리즘이 생성한 결과인지 모르는 Blind Test 방식으로 평가함.
- Grad-CAM++는 109.69점, Grad-CAM은 56.08점을 기록해서 Grad-CAM++가 더 높은 신뢰를 유도함.
- 약 33.69%의 경우에는 두 방법이 비슷하다고 평가되었으며, 이는 Grad-CAM++가 Grad-CAM의 일반화된 형태이기 때문임.
- 결과적으로 Grad-CAM++는 객관적 Faithfulness뿐 아니라 사람의 주관적인 이해도와 신뢰 측면에서도 Grad-CAM보다 우수했음.
4.3. Harnessing Explanations for Object Localization
이번에는 Grad-CAM++의 Explanation Map이 이미지 속 객체 위치를 얼마나 정확하게 찾아내는지 평가함.
Explanation Map이 실제 객체의 Bounding Box 내부를 얼마나 정확하게 강조하는지를 측정
실험 Dataset
객체 위치 평가를 위해 Pascal VOC 2012 Dataset을 사용함.
Pascal VOC 2012는 각 이미지 속 객체에 대해 Bounding Box Annotation을 제공하ㄱ;에,
Explanation Map이 실제 객체 위치와 얼마나 겹치는지 정량적으로 계산할 수 있음.
실험에서는 다음과 같이 모델을 구성함.
ImageNet으로 사전 학습된 VGG-16 사용Pascal VOC 2012 Train Set으로 Fine-tuningPascal VOC 2012 Validation Set에서 평가
Explanation Map 생성
특정 이미지 와 클래스 에 대해 Explanation Map은 앞서 정의한
를 기반으로 생성됨.
- : 클래스 에 대한 Explanation Map
- : 원본 이미지 크기로 Upsampling한 Class-specific Saliency Map
- : 입력 이미지
- : Hadamard Product, 즉 같은 위치의 원소끼리 곱하는 연산
다만 이번 Localization 실험에서는 Saliency Map 에 추가적인 처리를 적용함.
먼저 Saliency Map을 Min-Max Normalization함.
이 과정을 거치면 Saliency Map의 값은 일반적으로 0과 1 사이로 변환됨.
그다음 Threshold 를 적용함.
논문에서는 보다 큰 모든 Intensity를 으로 변환함.
즉, Threshold를 넘는 영역을 객체와 관련된 중요한 영역으로 간주하는 것.
이를 로 표현함.
Class-specific Saliency Map

↓

Min-Max Normalization

↓

Threshold δ 적용

↓

중요 영역을 Binary 형태로 추출
Threshold 의 의미
는 Heatmap에서 어느 정도 이상의 강도를 가진 영역만 중요하다고 볼 것인지를 결정함.
예를 들어,
- : 거의 모든 활성화 영역 포함
- : 비교적 약한 활성화 영역 제거
- : 강하게 활성화된 핵심 영역만 유지
Threshold가 높아질수록 Heatmap에서 강도가 높은 부분만 남게 됨.
[낮은 Threshold]

넓은 영역 유지
↓
객체 밖의 영역도 포함될 가능성 증가
[높은 Threshold]
강한 활성화 영역만 유지
↓
핵심 객체 영역만 남을 가능성 증가Localization IoU Metric
논문에서는 Explanation Map의 Localization 성능을 평가하기 위해 다음 Metric을 정의함.
각 항의 의미는 다음과 같음.
-
: 이미지 에서 클래스 객체의 Ground Truth Bounding Box 면적 -
: Explanation Map의 활성 Pixel 중 Bounding Box 내부에 존재하는 Pixel 수 -
: Explanation Map의 활성 Pixel 중 Bounding Box 바깥에 존재하는 Pixel 수
식의 직관적인 의미는
분자는 Explanation Map이 실제 객체 Bounding Box 내부에서 얼마나 많은 영역을 잡았는지를 나타냄.
분모는 실제 객체 Bounding Box 면적과 Heatmap이 잘못 활성화한 외부 영역을 함께 반영함.
따라서 좋은 Explanation Map은 다음 조건을 만족해야 함.
- Bounding Box 내부의 활성 Pixel이 많아야 함.
- Bounding Box 외부의 활성 Pixel이 적어야 함.
[좋은 Localization]

객체 내부 활성화 ↑
객체 외부 활성화 ↓
            ↓
Loc 값 증가
그러므로,
값은 높을수록 좋음.
일반적인 IoU와의 관계
일반적인 Intersection over Union은 다음과 같이 정의됨.
이번 논문의 식에서도
- Internal Pixels는 Intersection에 해당하고,
- Bounding Box 면적과 External Pixels의 합은 Union에 해당함.
따라서
은 Explanation Map의 활성 영역과 Ground Truth Bounding Box 사이의 IoU로 이해할 수 있음.
평가 이미지 선택 조건
Pascal VOC 2012 Validation Set의 모든 이미지를 그대로 사용한 것은 아님.
논문에서는 VGG-16의 예측 결과 중 Top-5 Class 안에,
실제 Bounding Box Annotation이 존재하는 클래스가 최소 하나 포함된 이미지만 평가함.
모델의 Top-5 예측 클래스
        ∩
Bounding Box가 존재하는 실제 클래스
        ≠
공집합
인 이미지만 사용함.
이는 모델이 전혀 예측하지 못한 클래스를 대상으로 Explanation Map을 평가하는 상황을 제외하기 위함임.
공정한 비교 조건
Grad-CAM과 Grad-CAM++의 Heatmap에는 동일한 Threshold 를 적용함.
만약 서로 다른 Threshold를 사용하면 한 방법이 더 넓거나 좁은 영역을 임의로 선택할 수 있기 때문에 공정한 비교가 어려움.
따라서 모든 실험에서 두 방법에 동일한 값을 사용함.
실험 결과
Pascal VOC 2012 Validation Set에서의 결과는 다음과 같음.
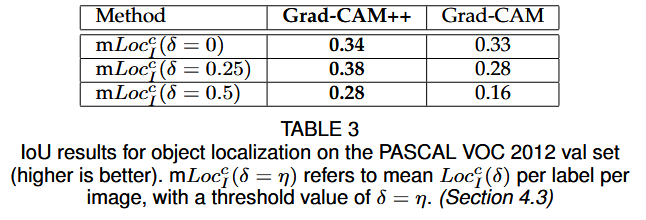
여기서
는
Threshold 일 때,
이미지와 클래스별 Localization Score를 평균한 값임.
일 때
Threshold를 적용하지 않거나 모든 활성 영역을 포함한 경우,
Grad-CAM++와 Grad-CAM의 성능은 다음과 같음.
두 방법의 차이는 크지 않음.
Threshold가 낮으면 약한 활성화 영역까지 모두 포함되기 때문에,
두 방법 모두 비교적 넓은 영역을 Heatmap에 남기게 됨.
이 경우 Grad-CAM의 낮은 강도 영역도 제거되지 않으므로 Grad-CAM++와의 차이가 작게 나타남.
일 때
Threshold를 0.25로 높이면 결과는 다음과 같음.
Grad-CAM++는 오히려 Localization Score가 증가했지만,
Grad-CAM은 성능이 크게 감소함.
이는 Grad-CAM++가 객체 영역에서 더 높은 Intensity를 생성하므로,
약한 영역을 제거한 뒤에도 중요한 객체 영역이 충분히 남기 때문임.
근데 Grad-CAM은 객체와 관련된 영역에서도 상대적으로 낮은 Intensity를 생성하는 경우가 많아서
Threshold를 적용하면 실제 객체 영역까지 함께 제거될 수 있음.
일 때
더 높은 Threshold인 0.5에서는 다음과 같은 결과가 나타남.
두 방법 모두 강한 활성화 영역만 남기기 때문에 Localization Score는 감소함.
하지만 Grad-CAM++는 여전히 Grad-CAM보다 훨씬 높은 성능을 유지함.
Threshold가 높아질수록 차이가 커지는 이유
논문에서 특히 강조하는 결과는 Threshold 가 높아질수록 Grad-CAM++와 Grad-CAM의 차이가 커진다는 점임.
각 Threshold에서 두 방법의 차이는 다음과 같음.
=> 강한 활성화 영역만 남겼을 때 Grad-CAM++의 우수성이 더욱 뚜렷하게 나타남.
이는 Section 3.1에서 제시한 직관을 뒷받침함.
Grad-CAM은 Gradient를 단순 평균하기 때문에 Spatial Footprint가 작은 Feature Map의 Weight가 낮아지고,
그 결과 객체 일부 영역의 Heatmap Intensity가 약하게 나타날 수 있음.
반면 Grad-CAM++는 Pixel-wise Weighting을 사용하므로,
객체의 다양한 부분을 더 높은 Intensity로 강조할 수 있음.
[Grad-CAM]

객체 일부의 Heatmap 강도가 낮음
              ↓
Threshold가 높아지면 객체 영역도 제거
              ↓
Localization 성능 급감
[Grad-CAM++]
객체의 여러 영역을 강하게 강조
↓
Threshold가 높아져도 핵심 영역 유지
↓
상대적으로 높은 Localization 성능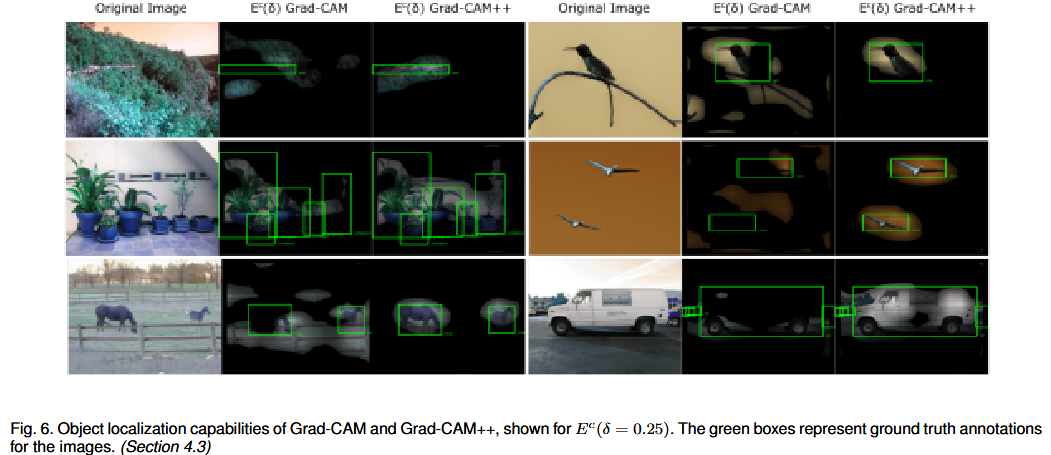
Figure. 6에서는 Grad-CAM++가 Grad-CAM보다 객체의 실제 위치를 더 정확하고 완전하게 강조하는 사례를 보여줌.
Grad-CAM은
- 객체의 일부만 강조하거나
- 동일 클래스 객체 중 일부를 놓치거나
- 주변 Context를 함께 활성화
하는 경우가 나타남.
반면 Grad-CAM++는
- 객체의 더 넓은 부분을 강조하고
- 여러 객체를 함께 포착하며
- Bounding Box 외부의 불필요한 활성화를 줄이는
결과를 보여줌.
정리해 보자면
- Pascal VOC 2012의 Bounding Box Annotation을 이용하여 Grad-CAM++의 Object Localization 성능을 평가함.
- Saliency Map을 Min-Max Normalization한 뒤 Threshold 를 적용하여 중요한 활성 영역을 추출함.
- Explanation Map 내부 활성 Pixel과 Ground Truth Bounding Box의 IoU를 기반으로 Localization Metric을 정의함.
- 객체 내부 활성화가 많고 객체 외부 활성화가 적을수록 높은 점수를 얻음.
- 모든 Threshold에서 Grad-CAM++가 Grad-CAM보다 높은 Localization 성능을 기록함.
- 특히 Threshold가 높아질수록 두 방법의 성능 차이가 커졌음.
- 이는 Grad-CAM의 Heatmap이 전반적으로 낮은 Intensity를 가지는 반면, Grad-CAM++는 객체의 중요한 영역을 더 강하게 강조한다는 Section 3.1의 직관을 뒷받침함.
- 결과적으로 Grad-CAM++는 모델의 판단을 설명하는 것뿐 아니라 실제 객체의 위치를 찾는 Weakly Supervised Localization에서도 더 효과적임.
✅5. LEARNING FROM EXPLANATIONS: KNOWLEDGE DISTILLATION
앞에서는 Grad-CAM++를 이용해서 모델의 판단 근거를 시각적으로 설명했고,
이번에는
Teacher Network가 생성한 Grad-CAM++ Explanation을 Student Network의 학습에 활용할 수 있는가?를 실험함.
Grad-CAM++를
Teacher Model이 이미지를 판단할 때 중요하게 본 영역을 Student Model에 전달하는 Knowledge Distillation 도구로 활용하고자 하는 것.
이때 Knowledge Distillation이란?
Knowledge Distillation은 성능이 좋은 크고 복잡한 모델인 Teacher Network의 지식을,
더 작고 가벼운 Student Network에 전달하는 학습 방법임.
크고 성능이 좋은 Teacher Network

↓

Teacher의 지식 전달

↓

작고 가벼운 Student Network
일반적으로 Teacher Network는
- Parameter 수가 많고
- 구조도 깊고
- 높은 성능을 가짐.
반면 Student Network는
- Parameter 수가 적고
- 구조가 얕고
- 연산량이 적음.
=> Knowledge Distillation의 목적은
Student Network의 크기와 계산량은 줄이면서도 Teacher Network의 성능을 최대한 유지하는 것
기존 Knowledge Distillation의 지식 전달 방식
기존 Knowledge Distillation에서는 Teacher가 출력한 Class Probability나 Logit을 Student가 따라가도록 학습함.
Teacher가
이 이미지는 고양이일 확률 0.8
개일 확률 0.15
자동차일 확률 0.05
와 같이 출력하면,
Student Network도 유사한 확률 분포를 생성하도록 학습함.
근데 이 방식은
Teacher가
이미지의 어떤 부분을 보고 해당 판단을 내렸는가에 대한 공간적인 정보는 직접 전달하지 않음.
Grad-CAM++ 기반 Knowledge Distillation
본 논문에서는 Teacher Network의 출력뿐 아니라,
Grad-CAM++로 생성한 Explanation Map도 Student Network에 전달함.
Student Network는 다음 두 가지를 동시에 학습하게 되는 것.
- 정답 Class를 올바르게 예측하는 방법
- Teacher가 중요하게 본 이미지 영역을 따라 보는 방법
Teacher Network

├── Class Prediction
└── Grad-CAM++ Explanation Map
                ↓
         Student Network 학습
그래서 논문에ㅓㅅ 말하고자 하는 건
= Student Network가 정답만 맞히는 것이 아니라, Teacher Network와 유사한 영역을 근거로 판단하도록 학습시키자.
CIFAR-10 실험 설정
첫 번째 실험에서는 CIFAR-10 Dataset과 Wide ResNet을 사용함.
Teacher Network는 다음과 같음.
- 40-Layer Wide ResNet
- 약 2.2M Parameters
Student Network는 다음과 같음.
- 16-Layer Wide ResNet
- 약 0.7M Parameters
Student Network는 Teacher Network보다 훨씬 얕고 Parameter 수도 적음.
Parameter 감소율은 약 다음과 같음.
Student Network가 Teacher보다 Parameter 수가 약 68.18% 적은 것.
Student Network의 전체 Loss
논문에서는 Student Network를 학습하기 위해 새로운 Loss Function을 정의함.
각 기호의 의미는 다음과 같음.
- : 입력 이미지
- : 입력 이미지의 정답 Class
- : Student Network의 Weight
- : Teacher Network의 Weight
- : 일반적인 Cross-Entropy Loss
- : Teacher와 Student Explanation의 차이를 측정하는 Loss
- : Interpretability Loss의 중요도를 조절하는 Hyperparameter
전체 Loss는
Classification Loss와
Explanation Matching Loss의 가중합.
Cross-Entropy Loss
첫 번째 항은 일반적인 Classification Loss.
Student Network가 입력 이미지 를 정답 Class 로 올바르게 분류하도록 학습함.
Student가 무엇을 예측해야 하는가를 알려주는 Loss
Interpretability Loss
두 번째 항은 Teacher와 Student의 Explanation Map 차이를 측정함.
- : Student Network가 생성한 클래스 의 Explanation Map
- : Teacher Network가 생성한 클래스 의 Explanation Map
- : 두 Explanation Map 사이의 Squared L2 Distance
쉽게 말하면 두 Heatmap의 Pixel별 차이를 제곱하여 모두 더한 값임.
Teacher와 Student가 비슷한 영역을 중요하게 볼수록 이 Loss는 작아짐.
Interpretability Loss의 직관
Teacher가 이미지 속 객체의 머리와 몸통을 중요하게 보았다고 가정함.
Student가 배경만 보고 같은 정답을 맞혔다면,
분류 결과는 맞더라도 판단 근거는 Teacher와 다름.
[Teacher]

객체의 머리와 몸통을 보고 판단
[Student]
배경을 보고 우연히 정답 예측Cross-Entropy Loss만 사용하면 Student가 정답을 맞혔기 때문에 큰 문제가 없다고 판단할 수 있음.
**하지만 Interpretability Loss를 추가하면,
Student가 Teacher와 다른 영역을 보고 있다는 차이까지 학습에 반영됨.**
=>
Student는
Teacher가 정답을 맞힌 결과뿐 아니라, 정답을 판단하는 과정까지 모방하도록 학습됨.
Hyperparameter
위 식의 는 Interpretability Loss의 영향력을 조절함.
가 작으면 Classification 성능을 중심으로 학습함.
[작은 α]

Cross-Entropy Loss 중심가 크면 Teacher의 Explanation Map을 더 강하게 따라가도록 학습함.
[큰 α]

Interpretability Loss 영향 증가
본 절의 모든 실험에서는 다음 값을 사용함.
CIFAR-10 비교 실험
논문에서는 여러 가지 Loss Function을 사용해서 Student Network를 학습함.
Baseline
Teacher의 개입 없이 Student Network를 독립적으로 학습함.
Grad-CAM++ Explanation Distillation
Teacher와 Student의 Grad-CAM++ Explanation Map이 유사해지도록 학습함.
Grad-CAM Explanation Distillation
Teacher와 Student의 Grad-CAM Explanation Map이 유사해지도록 학습함.
기존 Knowledge Distillation Loss
Hinton 등이 제안한 기존 Knowledge Distillation Loss인
도 함께 사용함.
논문에서는 Temperature Parameter를 다음과 같이 설정함.
Temperature는 Teacher가 출력한 Class Probability Distribution을 부드럽게 만드는 역할을 함.
이를 통해 Student는 정답 Class뿐만 아니라 다른 Class와의 상대적인 관계도 학습할 수 있음.
CIFAR-10 실험 결과
Teacher Network인 WRN-40-2의 Test Error Rate는
Student Network의 학습 결과는 다음과 같음.
| Loss Function | Test Error Rate |
|---|---|
| 6.78 | |
| 6.74 | |
| 6.86 | |
| 5.68 | |
| 5.56 | |
| 5.80 |
Test Error Rate는 낮을수록 좋음.
Explanation Loss만 사용한 결과
일반 Cross-Entropy Loss만 사용한 Baseline은
Grad-CAM++ Explanation Loss를 추가하면
Baseline보다 Error Rate가 소폭 감소함.
반면 Grad-CAM Explanation Loss를 사용한 결과는 으로 Baseline보다 오히려 높게 나타남.
=> Explanation 정보를 무조건 추가한다고 성능이 향상되는 것은 아니구나.
Teacher가 제공하는 Explanation의 품질이 Student 학습 성능에 직접적인 영향을 미침.
Grad-CAM++의 Explanation은 Student 학습에 도움이 되었지만,
Grad-CAM의 Explanation은 동일한 수준의 이점을 제공하지 못했음.
기존 Knowledge Distillation과 결합한 결과
기존 Knowledge Distillation Loss를 사용한 결과는 다음과 같음.
여기에 Grad-CAM++ Explanation Loss를 추가하면 으로 가장 낮은 Test Error Rate를 기록함.
반면 Grad-CAM Explanation을 추가한 경우에는 으로
오히려 기존 Knowledge Distillation만 사용한 결과보다 성능이 낮아짐.
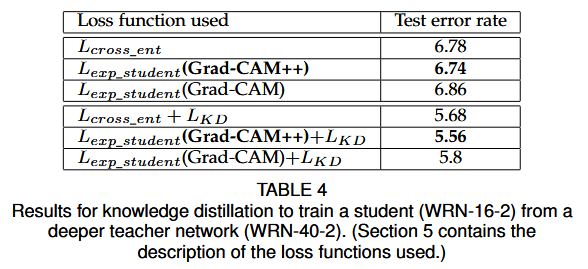
Table. 4에서는 두 가지 중요한 결과를 확인할 수 있음.
i) Teacher의 Explanation을 활용하면 Knowledge Distillation을 개선할 수 있음
기존 Knowledge Distillation은 Teacher의 출력 분포를 Student에게 전달함.
여기에 Teacher가 중요하게 본 이미지 영역까지 함께 전달하면,
Student가 더 풍부한 정보를 학습할 수 있음.
[기존 Knowledge Distillation]

Teacher의 Output Distribution 전달
[Explanation 기반 Knowledge Distillation]
Teacher의 Output Distribution
+
Teacher의 Spatial Attention 전달그 결과 Grad-CAM++ Explanation과 기존 를 함께 사용했을 때 가장 좋은 성능을 얻었음.
ii) Grad-CAM++가 Grad-CAM보다 Distillation에 더 효과적임
Grad-CAM++는 객체의 더 완전한 영역과 여러 객체를 잘 강조함.
따라서 Teacher가 실제로 중요하게 사용한 Feature를 Student에게 더 정확하게 전달할 수 있음.
근데 Grad-CAM은 객체 일부만 강조하거나 중요한 영역을 누락할 수 있으므로,
Student가 불완전한 Explanation을 따라 학습할 가능성이 있음.
Explanation 기반 Knowledge Distillation에서는 Explanation Map의 품질이 매우 중요함.
CIFAR-10의 한계
CIFAR-10 이미지는 다음과 같이 매우 작음.
이미지 해상도가 낮기 때문에 Explanation Map 역시 공간적으로 매우 제한적인 정보를 가짐.
즉, Teacher가 중요하게 본 영역을 세밀하게 전달하기 어려움.
작은 이미지

↓

작은 Feature Map과 Saliency Map

↓

전달할 수 있는 공간 정보 제한
따라서 논문에서는 더 큰 이미지를 사용하는 Pascal VOC 2007 Dataset에서도 추가 실험을 수행함.
Pascal VOC 2007 실험 설정
두 번째 실험에서는 Pascal VOC 2007 Dataset을 사용함.
VOC 2007은 CIFAR-10보다 이미지 크기가 크고,
하나의 이미지에 여러 객체가 포함될 수 있음.
따라서 Teacher의 Explanation Map이 더 넓고 풍부한 공간 정보를 포함함.
Teacher Network
Teacher Network는 ImageNet으로 사전 학습된 VGG-16을 사용함.
이후 Penultimate Layer를 Pascal VOC 2007 Train Set에 맞게 Fine-tuning함.
ImageNet Pretrained VGG-16

↓

Pascal VOC 2007 Fine-tuning

↓

Teacher Network
Student Network
Student Network는 11-Layer CNN으로 구성됨.
Parameter 수는 약 27M.
Teacher VGG-16과 비교하면 Parameter 수가 약 80% 감소한 것.
훨씬 작은
Student Network를 사용하면서Teacher의 지식을 전달받도록 설계함.
Pascal VOC 2007 실험 결과
실험 결과는 다음과 같음.
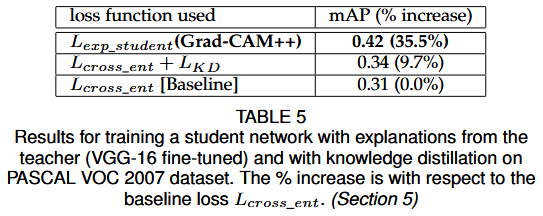
mAP는 높을수록 좋음.
Baseline 결과
Student Network를 Cross-Entropy Loss만으로 학습한 결과는 .
이는 Teacher Network의 도움 없이 Student가 독립적으로 학습한 Baseline 성능.
기존 Knowledge Distillation 결과
기존 Knowledge Distillation Loss를 추가하면 로 증가함.
Baseline 대비 증가율은 다음과 같음.
Teacher의 출력 정보를 전달하는 것만으로도 Student의 성능이 향상되었음.
Grad-CAM++ Explanation Distillation 결과
Grad-CAM++ Explanation을 이용한 경우에는 를 기록함.
Baseline 대비 증가율은 다음과 같음.
Cross-Entropy Loss만 사용한 경우보다 mAP가 약 35.5% 증가함.
기존 Knowledge Distillation의 9.7%보다 훨씬 큰 향상.
VOC 2007에서 성능 향상이 더 큰 이유
CIFAR-10은 이미지 크기가 이므로 Explanation Map이 제공할 수 있는 공간 정보가 제한적임.
반면 Pascal VOC 2007은 이미지가 더 크고 객체의 공간적 범위도 넓음.
따라서 Grad-CAM++ Explanation Map을 통해 다음 정보를 더 풍부하게 전달할 수 있음.
- 객체가 위치한 영역
- 객체의 여러 부분
- 동일 클래스의 여러 객체
- 객체와 배경의 구분
- 모델이 판단에 활용한 Context
[CIFAR-10]

작은 이미지
↓
제한된 공간적 Explanation
[Pascal VOC 2007]
큰 이미지와 여러 객체
↓
풍부한 공간적 Explanation
↓
더 효과적인 Knowledge Transfer이 때문에 VOC 2007에서는 Grad-CAM++ 기반 Explanation Distillation의 효과가 더욱 크게 나타남.
Explanation은 새로운 형태의 Knowledge가 될 수 있음
기존 Knowledge Distillation에서는 주로 다음 정보를 전달함.
- Logit
- Soft Probability
- Intermediate Feature
- Attention Map
본 논문은 Grad-CAM++ Explanation Map 역시 Teacher의 지식으로 활용할 수 있음을 보여줌.
Teacher가 가진 지식은
어떤 클래스라고 판단했는지 + 이미지의 어느 영역을 근거로 판단했는지도 포함되어 있음.
=> Explanation Map은
Teacher의 공간적 의사결정 지식을 Student에게 전달하는 수단으로 볼 수 있음.
Grad-CAM++의 역할 확장
기존 Grad-CAM++의 역할은 모델의 판단을 사람이 이해할 수 있도록 시각화하는 것이었음.
하지만 이번 실험에서는 Grad-CAM++가 모델 간 Knowledge Transfer에도 사용됨.
[기존 역할]

모델 → 사람

모델의 판단 근거 설명
[확장된 역할]
Teacher Model → Student Model
모델의 판단 근거 전달Grad-CAM++는
Student Network의 학습을 개선하는 학습 신호로도 활용될 수 있구나.
정리해 보자면
- 본 절에서는 Grad-CAM++ Explanation을 Knowledge Distillation에 활용함.
- Student Network는 정답 Class뿐 아니라 Teacher가 중요하게 본 이미지 영역도 함께 학습함.
- 전체 Loss는 Cross-Entropy Loss와 Teacher·Student Explanation Map 사이의 Interpretability Loss로 구성됨.
- Interpretability Loss는 두 Saliency Map 사이의 Squared L2 Distance로 계산함.
- CIFAR-10에서 Grad-CAM++ Explanation과 기존 Knowledge Distillation Loss를 결합했을 때 가장 낮은 Test Error Rate인 5.56%를 기록함.
- Grad-CAM Explanation을 사용한 경우에는 Grad-CAM++보다 낮은 성능을 보여, Explanation의 품질이 Distillation 성능에 중요함을 확인함.
- Pascal VOC 2007에서는 Grad-CAM++ 기반 학습이 Baseline 대비 mAP를 약 35.5% 향상시킴.
- 큰 이미지에서는 Teacher의 공간적 판단 근거를 더 풍부하게 전달할 수 있어 Explanation Distillation의 효과가 더욱 크게 나타남.
- 결과적으로 Grad-CAM++는 모델의 판단을 사람에게 설명하는 것뿐 아니라, Teacher의 의사결정 방식을 Student에게 전달하는 학습 도구로도 활용될 수 있음.
✅6. EXPLANATIONS FOR IMAGE CAPTIONING AND 3D ACTION RECOGNITION
Grad-CAM++는 일반적인 Image Classification뿐 아니라,
CNN을 핵심 구성 요소로 사용하는 다양한 Machine Learning Model의 의사결정을 설명하는 데 활용할 수 있음.
이번에는 Grad-CAM++를 다음 두 가지 Task에 적용함.
1. Image Captioning
2. 3D Action Recognition- 이미지로부터 생성된 문장
- 여러 Video Frame을 바탕으로 예측한 행동
에 대해서도 시각적 설명을 생성함.
특히 논문에서는 3D Action Recognition 실험을 통해,
CNN 기반 Video Model의 예측을 시각적으로 설명한 최초의 연구 중 하나라고 설명함.
Grad-CAM++의 적용 범위
Grad-CAM++를 사용하기 위한 핵심 조건은 다음과 같음.
전체 모델 내부에 CNN이 주요 구성 요소로 포함되어 있어야 함.
예를 들어 Image Captioning Model은 일반적으로 다음과 같이 구성됨.
Input Image

↓

CNN Encoder

↓

Image Feature

↓

LSTM Decoder

↓

Caption 생성
CNN이 이미지의 시각적 Feature를 추출하므로,
생성된 Caption이 이미지의 어떤 영역에 영향을 받았는지를 Grad-CAM++로 분석할 수 있음.
Video Action Recognition 역시 다음과 같은 구조를 가짐.
Input Video Frames

↓

3D CNN

↓

Spatio-temporal Feature

↓

Action Prediction
따라서 예측된 행동이 Video의 어느 Frame과 어느 공간적 영역에 의해 결정되었는지 시각화할 수 있음.
6.1. Image Captioning
Image Captioning은 입력 이미지를 분석하여 이미지 내용을 설명하는 자연어 문장을 생성하는 Task임.
예를 들어 다음과 같은 Caption을 생성할 수 있음.
A young girl accompanied by a small plant.일반적인 Image Classification에서는 하나의 Class Label을 예측하지만,
Image Captioning에서는 이미지의 여러 객체와 관계를 종합하여 하나의 문장을 생성해야 함.
실험에 사용한 Model
논문에서는 Flickr30k Dataset으로 학습한 표준 Image Captioning Model을 사용함.
모델은 대표적인 Show-and-Tell 구조를 수정해서 구성함.
전체 구조는 다음과 같음.
Input Image

↓

CNN Encoder

↓

Image Representation

↓

LSTM Decoder

↓

Predicted Caption
CNN Encoder
CNN은 입력 이미지에서 시각적 Feature를 추출함.
예를 들어
- 사람
- 식물
- 배경
- 물체의 형태
- 객체 간 공간 관계
등을 Feature Map으로 표현함.
LSTM Decoder
LSTM은 CNN이 추출한 Image Feature를 이용하여 단어를 순차적으로 생성함.
A → young → girl → accompanied → by → a → small → plant즉, CNN이 이미지 정보를 Encoding하고 LSTM이 이를 문장으로 Decoding함.
Grad-CAM과 동일한 실험 설정
공정한 비교를 위해 논문에서는 기존 Grad-CAM 연구에서 Image Captioning Task에 사용했던 것과 동일한 설정을 사용함.
Grad-CAM과 Grad-CAM++ 모두 동일한 Captioning Model과 입력 이미지에 적용하고,
두 방법이 생성한 Heatmap의 완전성과 의미적 관련성을 비교함.
Image Captioning에서 클래스 Score는 무엇인가?
일반적인 Classification Task에서는 클래스 에 대한 Score를
로 사용함.
예를 들어 클래스가 dog라면,
dog 출력 Neuron의 Score를 이용하여 Heatmap을 생성함.
하지만 Image Captioning에서는 하나의 Class가 아니라 문장 전체가 출력됨.
따라서 논문에서는 예측된 Caption의 Log Probability를 로 사용함.
모델이 해당 Caption을 생성할 가능성을 얼마나 높게 평가했는가를 Target Score로 설정한 것.
Caption의 Log Probability
Caption이 여러 단어로 구성되어 있다면,
문장 전체의 Probability는 각 시점에서 생성된 단어 Probability의 곱으로 표현할 수 있음.
예를 들어 Caption이
A young girl이라면 개념적으로 다음과 같이 표현됨.
곱셈 형태의 Probability는 값이 매우 작아질 수 있으므로 일반적으로 Log Probability를 사용함.
Grad-CAM++는 이 Log Probability가 CNN Feature Map에 대해 어떻게 변화하는지를 계산하여,
예측 Caption에 영향을 준 이미지 영역을 찾음.
Image Captioning Heatmap 생성
Grad-CAM++의 최종 Saliency Map은 기존 Equation (20)을 이용함.
다만 여기서 는 일반적인 Class Label이 아니라,
예측된 Caption 전체를 의미함.
Predicted Caption의 Log Probability

↓

CNN Feature Map에 대해 Backpropagation

↓

Feature Map별 Weight 계산

↓

Caption 생성에 중요한 이미지 영역 시각화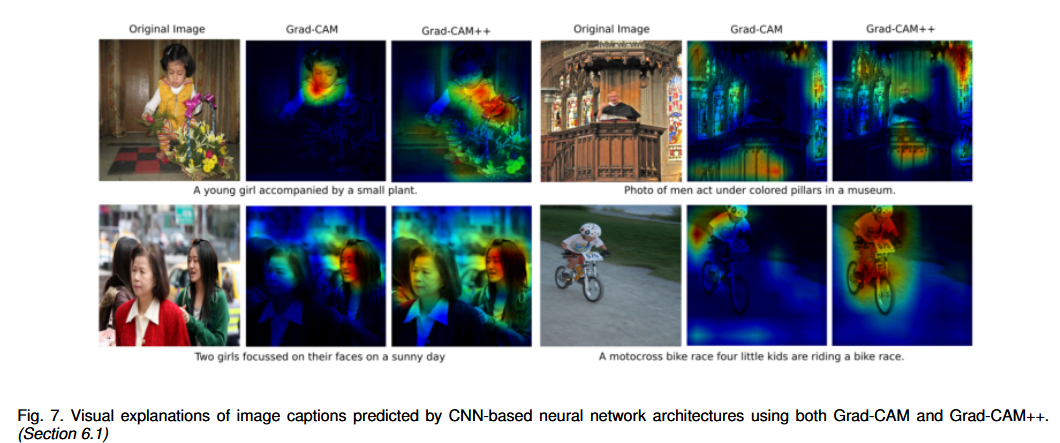
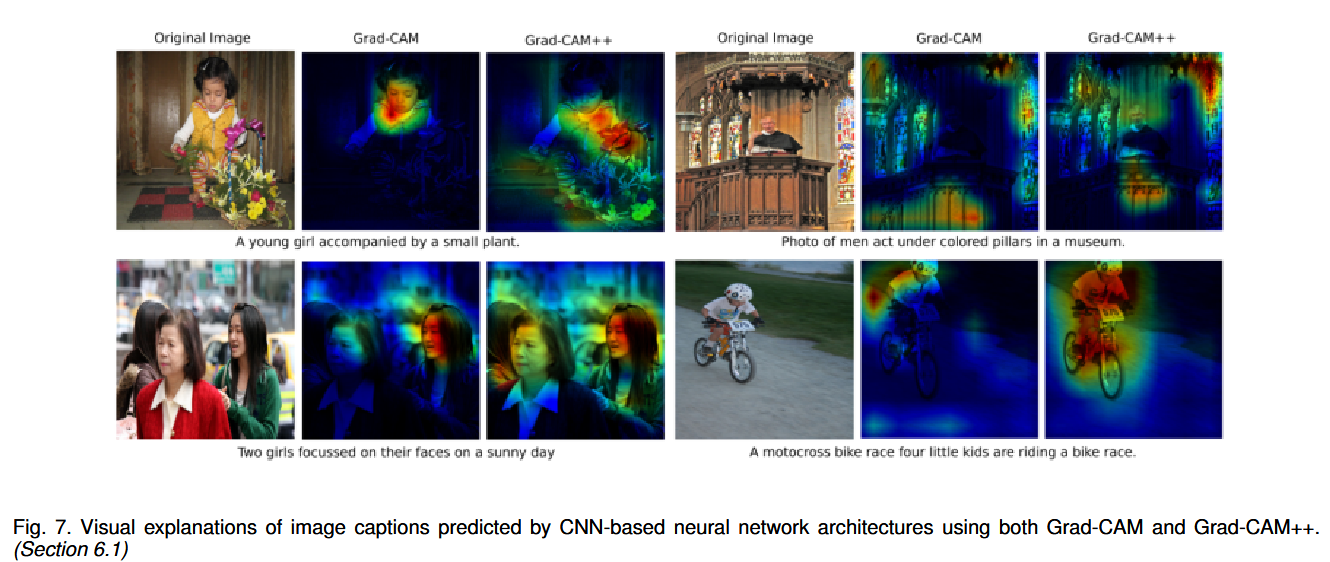
Figure. 7에서는 Flickr30k Dataset에서 무작위로 선택한 4개의 이미지에 대해,
예측 Caption을 기준으로 Grad-CAM과 Grad-CAM++의 Explanation을 비교함.
논문에서는 모든 사례에서 Grad-CAM++가 Grad-CAM보다 더 완전한 Heatmap을 생성했다고 설명함.
첫 번째 예제
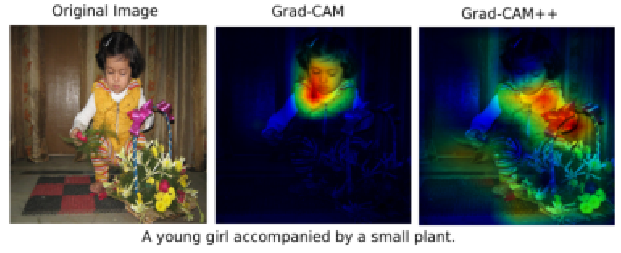
첫 번째 이미지에서 모델이 생성한 Caption은 다음과 같음.
A young girl accompanied by a small plant이 문장에는 두 가지 주요 시각적 요소가 포함됨.
- young girl
- small plant
Grad-CAM++는 이미지에서
- 여자아이
- 작은 식물
을 모두 강조함.
반면 Grad-CAM은 여자아이만 강조하고 식물 영역은 충분히 표시하지 못함.
[Grad-CAM]

girl만 강조
plant 누락
[Grad-CAM++]
girl 강조
+
plant 강조Grad-CAM++는 Caption을 구성하는 여러 객체를 더 완전하게 포착함.
왜 Grad-CAM은 일부 객체를 놓치는가?
Caption은 하나의 객체만 설명하지 않고 이미지에 포함된 여러 객체와 관계를 함께 표현할 수 있음.
하지만 Grad-CAM은 Feature Map의 Gradient를 단순 평균하므로,
공간적 범위가 작거나 상대적으로 약하게 활성화된 객체의 Feature가 최종 Heatmap에서 희미해질 수 있음.
일단 위 예시에서 작은 식물은 여자아이보다 이미지에서 차지하는 영역이 작음.
따라서 식물을 탐지하는 Feature Map의 Spatial Footprint도 작을 수 있고,
Grad-CAM에서는 낮은 Weight를 받을 가능성이 있음.
반면 Grad-CAM++는
Pixel-wise Weighting을 적용하기 때문에 작은 객체에 대응하는 영역도 더 잘 반영할 수 있음.
두 번째 예제: 잘못된 Caption의 해석
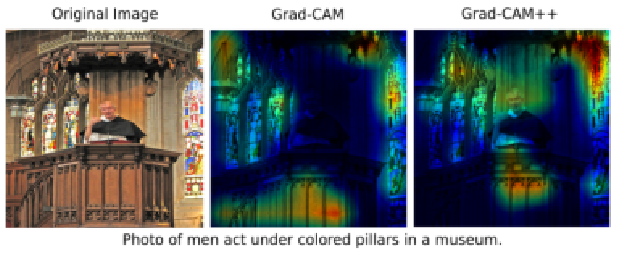
두 번째 이미지에서는 모델이 잘못된 Caption을 생성함.
하지만 Grad-CAM++의 Visualization을 보면 모델이 왜 그러한 Caption을 생성했는지 추론할 수 있음.
모델은 이미지 속
- 색이 있는 유리 구조물
- 사람
을 주목했음.
그리고 색이 있는 유리 구조물을 pillars로 잘못 인식함.
예측 결과는 틀렸지만 Grad-CAM++를 통해 다음과 같은 사실을 확인할 수 있음.
모델이 아무 근거 없이 틀린 것은 아님

↓

색이 있는 유리 구조물을 보고

↓

pillar로 잘못 해석함
Grad-CAM++는 유리 구조물과 사람을 모두 강조해서,
모델의 잘못된 판단 과정을 이해할 수 있도록 함.
반면 Grad-CAM의 Heatmap은 사람 위치를 제대로 강조하지 못해 설명이 불완전했음.
잘못된 예측에서 XAI의 역할
설명 기법은 모델이 정답을 맞혔을 때만 유용한 것이 아님.
오히려 모델이 틀렸을 때,
모델이 무엇을 보고 잘못 판단했는가를 분석하는 데 매우 중요함.
ex. 잘못된 Caption의 원인이 다음 중 무엇인지 확인할 수 있음.
- 중요한 객체를 보지 못했는가?
- 다른 객체를 비슷한 객체로 착각했는가?
- 배경 Context에 과도하게 의존했는가?
- 문장 생성 과정에서 단어 선택이 잘못되었는가?
Grad-CAM++는 모델의 Attention이 어느 시각적 영역에 집중되었는지 보여주므로,
Captioning Model의 오류 분석에 활용할 수 있음.
다양한 Caption에 대한 추가 실험
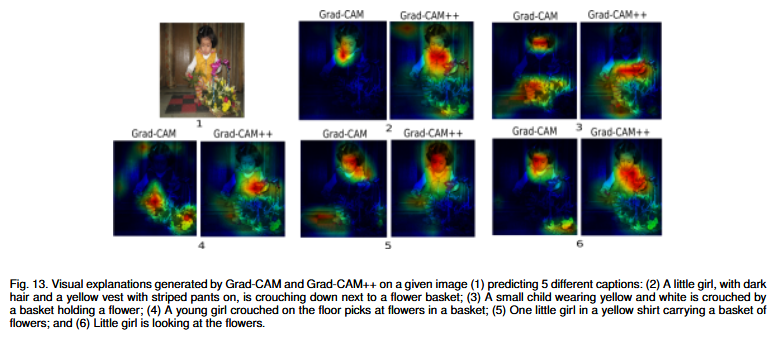
하나의 이미지에는 여러 개의 올바른 Caption이 존재할 수 있음.
예를 들어 같은 이미지도 다음과 같이 다양하게 설명할 수 있음.
A girl is standing beside a plant.A young child poses near a small plant.A girl and a plant are shown in the image.논문에서는 Captioning Model 학습에 사용된 5개의 서로 다른 Caption을 이용해서,
동일한 이미지에 대한 Explanation을 추가로 생성함.
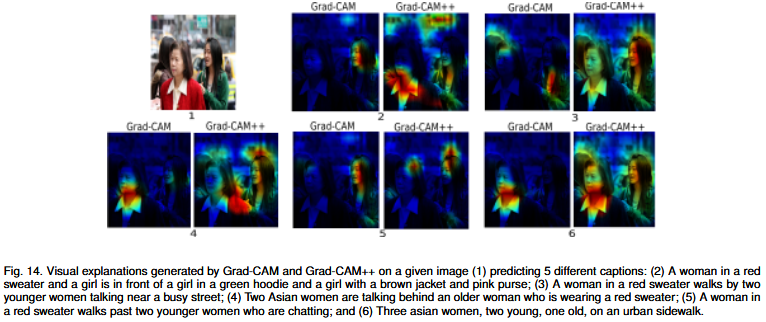
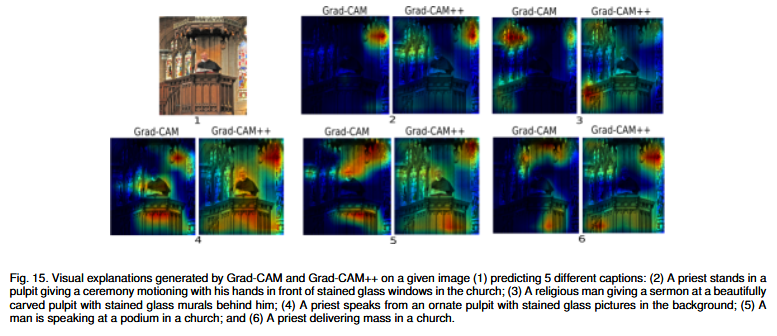
그 결과 모든 Caption에서 Grad-CAM++가 Grad-CAM보다 Caption 내용에 대응하는 영역을 더 완전하게 설명함.
Caption에 따라 Heatmap이 달라지는 이유
같은 이미지라도 Caption이 강조하는 내용이 다르면 모델이 중요하게 보는 영역도 달라질 수 있음.
예를 들어 한 Caption이 사람을 중심으로 설명한다면,
사람 영역이 강하게 나타날 수 있음.
반면 다른 Caption이 주변 객체나 행동을 중심으로 설명한다면,
해당 객체나 관계 영역이 더 강하게 활성화될 수 있음.
[Caption A]

A girl is standing.

↓

girl 영역 중심
[Caption B]
A girl stands beside a plant.
↓
girl + plant 영역Grad-CAM++는
특정 Caption을 생성할 때 모델이 사용한 시각적 근거를 Class-conditional하게 설명함.
Image Captioning 실험의 의미
이번 실험을 통해 Grad-CAM++가
CNN과 Sequence Model이 결합된 복합적인 Architecture에서도 사용할 수 있음을 보여줌.
Grad-CAM++는
- Caption 전체에 영향을 준 이미지 영역을 확인하고
- Caption에 포함된 여러 객체를 함께 강조하며
- 잘못된 Caption이 생성된 원인을 분석하고
- 서로 다른 Caption에 따른 시각적 근거 차이를 확인하는
데 활용될 수 있음.
정리해 보자면
- Image Captioning Model은 CNN Encoder와 LSTM Decoder로 구성됨.
- Grad-CAM++는 예측 Caption의 Log Probability를 Target Score로 사용함.
- 이 Score를 CNN Feature Map에 대해 Backpropagation하여 Caption 생성에 영향을 준 이미지 영역을 찾음.
- Grad-CAM++는 Caption에 포함된 여러 객체를 Grad-CAM보다 더 완전하게 강조함.
- 잘못된 Caption에서도 모델이 어떤 이미지 영역을 보고 잘못 판단했는지 분석할 수 있음.
- 하나의 이미지에 여러 Caption을 적용한 경우에도 Grad-CAM++가 각 Caption 내용에 더 적합한 설명을 제공함.
- 따라서 Grad-CAM++는 CNN과 LSTM이 결합된 Image Captioning Model에도 효과적으로 적용할 수 있음.
6.2. 3D Action Recognition
3D Action Recognition은 Video에 등장하는 사람이나 객체의 행동을 인식하는 Task임.
정지 이미지 한 장만 분석하는 게 아니라,
여러 Frame에 걸쳐 나타나는 공간적·시간적 변화를 함께 분석해야 함.
예를 들어 다음과 같은 행동을 분류할 수 있음.
- Tennis
- Basketball
- Swimming
- Running
- Skiing
2D CNN과 3D CNN의 차이
일반적인 2D CNN은 하나의 이미지에 대해 높이와 너비 방향으로 Convolution을 수행함.
반면 3D CNN은 Video Frame의 시간축까지 포함해서 Convolution을 수행함.
- : 시간 또는 Frame 축
- : 영상의 높이
- : 영상의 너비
3D CNN은 다음 정보를 함께 학습한다는 뜻.
- 객체의 형태
- 객체의 위치
- 시간에 따른 움직임
- Frame 간 변화
실험에 사용한 C3D Model
논문에서는 3D Action Recognition을 위해 C3D Model을 사용함.
C3D는 3D Convolution을 이용하여 Video의 Spatio-temporal Feature를 학습하는 대표적인 Architecture.
16 Video Frames

↓

3D Convolution

↓

Spatial + Temporal Feature

↓

Action Classification
Sports-1M Dataset
C3D Model은 Sports-1M Dataset으로 학습됨.
Sports-1M은 YouTube에서 수집된 대규모 스포츠 Video Dataset.
논문에서 제시한 구성은 다음과 같음.
- 총 Video 수: 1,133,158개
- Sports Label 수: 487개
100만 개가 넘는 Video와 수백 개의 스포츠 행동 Class를 포함함.
16-Frame Window
논문에서는 각 Video에서 연속된 16개의 Frame을 하나의 입력 Window로 사용함.
모델은 16개 Frame의 시간적 흐름을 분석하여 행동을 예측함.
예를 들어 Tennis Video라면,
- 선수가 라켓을 드는 모습
- 공을 향해 움직이는 모습
- 라켓을 휘두르는 모습
등의 연속적인 변화를 보고 tennis로 분류함.
Video에서 Grad-CAM++ 생성
Grad-CAM++ Explanation은 C3D Model의 마지막 Convolution Layer Feature Map에서 생성함.
3D CNN의 Feature Map은 일반적인 2D Feature Map과 달리 시간축을 포함함.
따라서 Heatmap도 시간과 공간 정보를 함께 가짐.
C3D의 마지막 Convolution Feature Map

↓

Predicted Action Score에 대해 Gradient 계산

↓

Grad-CAM / Grad-CAM++ Weight 계산

↓

Frame별 Spatio-temporal Saliency Map 생성
Video Explanation Map
생성된 Grad-CAM과 Grad-CAM++ Saliency Map은 원본 Video 해상도로 Upsampling함.
그다음 원본 Video와 Point-wise Multiplication하여 최종 Explanation Video Map을 생성함.
ㅇ; 식을 이용해서
이번 실험에서는
- : 입력 이미지가 아니라 입력 Video
- : Video에서 예측된 Action Class
- : 시간축을 포함한 Action-specific Saliency Map
- : 최종 Explanation Video
로 적용해서 진행.
Original Video

×

Upsampled Action Saliency Map

↓

Explanation Video
Frame별 Explanation
Video Explanation Map에서는 각 Frame마다 모델이 중요하게 본 공간적 영역을 확인할 수 있음.
예를 들어 모델이 tennis를 예측했다면,
다음과 같은 영역이 강조될 수 있음.
- Tennis Player
- Racket
- Ball
- Player의 팔
- Court 주변 Context
또한 Frame이 진행되면서 Heatmap이 어떻게 이동하는지를 통해,
모델이 행동의 시간적 변화 중 어떤 부분에 집중했는지도 확인할 수 있음.
정량적 평가
논문에서는 Sports-1M Dataset에서 임의로 3,000개의 Video를 수집함.
그리고 Section 4에서 사용한 것과 동일한 성능 지표를 적용함.
Average Drop %% Increase in ConfidenceWin %
원본 Video와 Explanation Video를 각각 모델에 입력하고,
예측된 Action Class의 Confidence 변화를 비교함.
Video에서 Average Drop %의 의미
원본 Video를 입력했을 때 Action Confidence를 라고 하고,
Explanation Video만 입력했을 때 Confidence를
라고 하면,
Explanation Video에 실제 행동 예측에 필요한 영역이 충분히 포함되어 있을수록 Confidence 감소가 작아야 함.
[좋은 Video Explanation]

행동 인식에 중요한 사람·도구·동작 포함
                     ↓
Explanation Video만 입력해도
Action Confidence 유지
따라서 Image Classification 실험과 마찬가지로,
Average Drop %는 낮을수록 좋음.
정량적 실험 결과
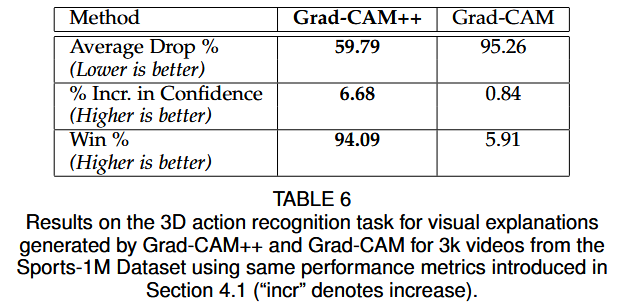
Table. 6의 결과에서 Grad-CAM++는 모든 Metric에서 Grad-CAM보다 더 좋은 성능을 나타냄.
Average Drop %가 더 낮고% Increase in Confidence가 더 높으며Win %에서도 더 우수한 결과
를 기록함.
= Grad-CAM++가 Video Action Prediction에 실제로 중요한 Spatio-temporal 영역을
Grad-CAM보다 더 잘 포착했다는 것을 의미함.
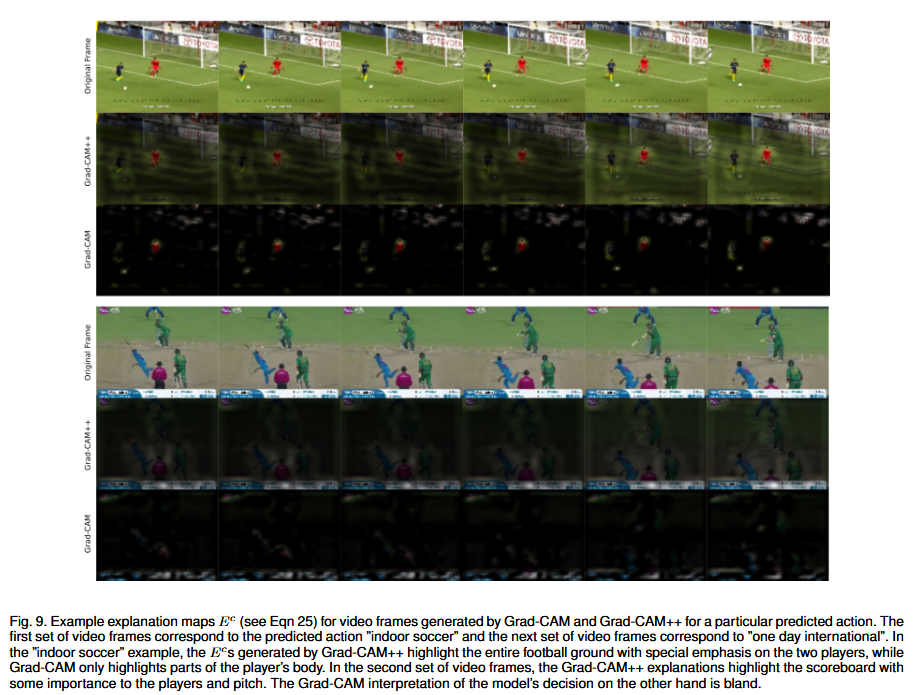
Figure. 9에서는 Video의 Explanation 결과를 시각적으로 비교함.
실제 입력은 16개 Frame으로 구성되어 있지만,
논문에서는 결과를 명확하게 보여주기 위해 그중 6개 Frame을 Sampling해서 제시함.
중요한 점은 예시 Video를 임의로 선택했으며,
좋은 결과만을 의도적으로 골라 제시하지 않았다는 것.
Grad-CAM++의 Semantic Relevance
논문에서는 Grad-CAM++가 생성한 Video Explanation이 Grad-CAM보다 의미적으로 더 관련성이 높다고 설명함.
Action을 분류하는 데 실제로 중요한 영역을 더 잘 강조한다는 것.
ex. Tennis Action이라면,
Grad-CAM++는 화면에서 넓게 움직이는 배경을 강조하는 방식이 아니라,
- Player
- Racket
- 팔의 움직임
- 공 주변 영역 등
Tennis를 구분하는 데 중요한 부분을 더 강하게 표시할 수 있음.
Context와 Discriminative Region의 밝기 차이
Grad-CAM++ Video Explanation에서는 Action을 이해하는 데 필요한 Context도 일부 강조함.
다만 Context는 상대적으로 어둡게 나타나고,
Action을 직접적으로 구분하는 가장 중요한 영역은 더 밝게 나타나는 경향이 있음.
덜 중요한 Context

→ 낮은 Intensity
가장 중요한 Discriminative Region
→ 높은 Intensityex. Tennis에서는 Court가 Context로 약하게 강조될 수 있지만,
Player와 Racket은 더 강하게 강조될 수 있음.
Grad-CAM++가 Context를 완전히 무시하는 것이 아니라,
예측 중요도에 따라 Heatmap 강도를 구분한다는 의미.
Video에서 Grad-CAM++의 장점
Video에는 하나의 이미지보다 더 복잡한 정보가 포함됨.
- 여러 Frame
- 객체의 이동
- 사람의 자세 변화
- 도구와 사람의 상호작용
- 배경 Context
- 시간에 따른 행동 순서
Grad-CAM은 Gradient를 단순 평균하므로,
시간과 공간상 일부 중요한 영역이 약하게 반영될 수 있음.
근데 Grad-CAM++는 Pixel-wise Gradient Weighting을 사용하므로,
여러 Frame에 걸친 다양한 Discriminative Region을 더 완전하게 강조할 수 있음.
3D Action Recognition 실험의 의미
이번 실험은 Grad-CAM++가 정적 이미지뿐 아니라 Video Model의 의사결정에도 적용 가능함을 보여줌.
이를 통해 다음과 같은 분석이 가능함.
- 모델이 Action을 예측할 때 어느 Frame을 중요하게 보았는가?
- 각 Frame에서 어느 객체나 신체 부위를 보았는가?
- 행동 자체보다 배경에 의존하고 있지는 않은가?
- 잘못된 Action Prediction이 어떤 시각적 근거에서 발생했는가?
- 여러 시간 구간 중 어느 동작이 가장 결정적이었는가?
Grad-CAM++는 Video Classification Model의 디버깅과 신뢰성 분석에도 활용할 수 있음.
정리해 보자면
- 3D Action Recognition에서는 Sports-1M으로 학습된 C3D Model을 사용함.
- 각 Video에서 연속된 16개 Frame을 입력으로 사용해서 Action을 예측함.
- C3D의 마지막 Convolution Layer에서 Spatio-temporal Saliency Map을 생성함.
- 생성된 Heatmap을 원본 Video 해상도로 Upsampling한 뒤 원본 Video와 곱하여 Explanation Video를 생성함.
- Sports-1M에서 임의로 선택한 3,000개 Video를 대상으로 정량 평가를 수행함.
- Grad-CAM++는 Average Drop, Confidence Increase, Win % 등 모든 지표에서 Grad-CAM보다 굳.
- 정성적 결과에서도 Grad-CAM++는 Action과 의미적으로 관련된 사람, 도구, 움직임을 더 완전하게 강조함.
- 배경 Context는 상대적으로 약하게, 가장 Discriminative한 영역은 더 밝게 표현하는 경향을 보임.
- Grad-CAM++는 Image Captioning과 Video Action Recognition에도 적용 가능한 범용적인 CNN 설명 기법.
✅7. DISCUSSION
Grad-CAM++의 주요 설계가 실제로 타당한지 추가 실험을 통해 검증해 보고자 함.
앞에서는 Grad-CAM++의 Feature Map Weight를 다음과 같이 정의했음.
이 식에는 두 가지 중요한 설계가 포함되어 있음.
- Positive Gradient만 사용함.
- Grad-CAM++가 Grad-CAM보다 더 넓은 영역을 강조하는 경우가 있음.
그래서 이번 절에서는 다음 두 가지 질문을 검증함.
[질문 1]

왜 Positive Gradient만 사용해야 하는가?
[질문 2]
Grad-CAM++의 성능 향상은
단순히 더 넓은 Heatmap을 생성하기 때문인가?7.1. Why Only Positive Gradients in Grad-CAM++?
Section 3.2에서 Grad-CAM++는 Feature Map 의 중요도를 계산할 때 Positive Gradient만 사용함.
여기서 ReLU는 다음과 같이 작동함.
- Positive Gradient는 유지하고
- Negative Gradient는 0으로 제거함.
논문에서는 다음 가정을 세움.
특정 클래스 의 Score를 증가시키는 Positive Gradient가 해당 클래스에 대한 Feature Map의 중요도를 더 잘 나타낸다.
이번 절에서는 이 가정이 실제로 맞는지 확인하기 위해 Negative Gradient까지 모두 포함한 변형 모델을 실험함.
Positive Gradient와 Negative Gradient의 의미
Feature Map의 특정 위치 에 대한 Gradient는 다음과 같음.
이 값의 부호는 해당 Activation이 클래스 의 Score에 미치는 영향을 나타냄.
Positive Gradient
해당 Activation이 증가할수록 클래스 의 Score도 증가함.
클래스 의 예측을 지지하는 영역으로 해석할 수 있음.
Negative Gradient
해당 Activation이 증가할수록 클래스 의 Score는 감소함.
클래스 의 예측을 억제하거나 반대하는 영역으로 볼 수 있음.
왜 Positive Gradient가 중요할 것으로 예상했는가
Grad-CAM++의 목적은 특정 클래스 를 예측하는 데 긍정적으로 기여한 영역을 찾는 것임.
따라서 클래스 Score를 높이는 Positive Gradient를 중심으로 Feature Map 중요도를 계산하는 것이 자연스러움.
[Positive Gradient]

클래스 c의 Score 증가
        ↓
클래스 c를 지지하는 Feature
[Negative Gradient]
클래스 c의 Score 감소
↓
클래스 c를 억제하는 FeatureNegative Gradient까지 함께 합산하면,
클래스를 지지하는 영역과 억제하는 영역이 하나의 Weight 안에서 섞일 수 있음.
이 경우 중요한 Positive Contribution이 Negative Contribution에 의해 상쇄될 가능성이 있음.
모든 Gradient를 사용하는 변형 모델
논문에서는 ReLU를 제거하고 Positive Gradient와 Negative Gradient를 모두 사용하는 Weight를 정의함.
기존 Grad-CAM++ 식과 비교하면 다음과 같음.
기존 Grad-CAM++
변형 Grad-CAM++
변형 모델에서는 ReLU가 제거되어 모든 Gradient가 그대로 사용됨.
계산
Pixel-wise Weight인 는 기존 Equation (10)과 동일한 형태로 계산함.
다만 기존 Grad-CAM++에서는 Negative Gradient 위치가 최종 Weight 계산에서 ReLU에 의해 제거됨.
이번 변형에서는 Negative Gradient 위치에 대해서도
으로 두고 모든 Gradient를 반영함.
Grad-CAM++
논문에서는 Negative Gradient까지 포함한 변형 모델을
라고 부름.
[Grad-CAM++]

Positive Gradient만 사용
[Grad-CAM++⊥]
Positive Gradient
+
Negative Gradient 모두 사용실험 설정
Section 4.1의 Objective Evaluation과 동일한 실험을 다시 수행함.
- Dataset: Pascal VOC 2007 Validation Set
- 이미지 수: 2,510장
- Model: VGG-16
- 비교 대상:
- Grad-CAM++
- Grad-CAM
평가 Metric 역시 동일함.
- Average Drop %
- % Increase in Confidence
- Win %
실험 결과
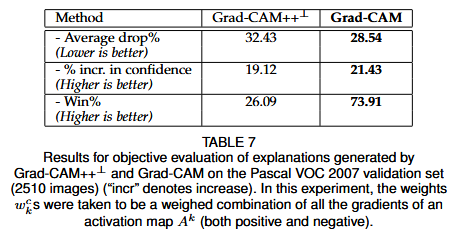
각 지표의 좋은 방향은 다음과 같음.
Average Drop %: 낮을수록 좋음% Increase in Confidence: 높을수록 좋음Win %: 높을수록 좋음
Average Drop % 결과
Grad-CAM++의 Average Drop은
Grad-CAM은
Grad-CAM++의 Confidence 감소가 더 큼.
모든 Gradient를 포함해 만든 Explanation Map만 모델에 입력했을 때,
원본 예측 Confidence가 더 많이 떨어졌음.
이는 Explanation Map이 실제 예측에 필요한 영역을 충분히 포함하지 못했다는 의미.
% Increase in Confidence 결과
Grad-CAM++는
Grad-CAM은
Grad-CAM++의 Confidence 증가 비율이 더 낮음.
모든 Gradient를 포함한다고 해서 중요한 영역이 더 풍부하게 보존되는 것이 아니며,
오히려 불필요하거나 클래스와 반대되는 영역이 함께 강조될 수 있음을 보여줌.
Win % 결과
Grad-CAM++의 Win %는
이고,
Grad-CAM은
를 기록함.
이미지별 직접 비교에서 Grad-CAM이 훨씬 더 자주 좋은 결과를 보였음.
Grad-CAM++의 Pixel-wise Weighting을 사용했음에도 불구하고,
Negative Gradient까지 포함하자 기존 Grad-CAM보다 성능이 떨어진 것.
왜 Negative Gradient를 포함하면 성능이 떨어지는가
Feature Map 하나에는 Target Class에 긍정적으로 기여하는 위치와 부정적으로 기여하는 위치가 함께 존재할 수 있음.
예를 들어 다음과 같은 Gradient가 있다고 가정함.
Positive Gradient만 사용하면
가 됨.
하지만 모든 Gradient를 합산하면
가 됨.
클래스 Score를 높이는 중요한 Feature가 Negative Gradient에 의해 상쇄됨.
[Positive Gradient]

Target Class를 지지
[Negative Gradient]
Target Class를 억제둘을 함께 합산
서로 상쇄
↓
Feature Map 중요도 왜곡Negative Gradient도 정보가 아닌가?
Negative Gradient 역시 모델의 판단을 이해하는 데 의미 있는 정보일 수 있음.
예를 들어,
- 특정 Class를 억제하는 영역
- 다른 Class를 지지하는 영역
- Target Class와 충돌하는 Feature
를 분석할 때 활용할 수 있음.
하지만 Grad-CAM++의 목적은
Target Class를 긍정적으로 설명하는 Class-discriminative Saliency Map을 생성하는 것
따라서 Target Class에 부정적으로 기여하는 Gradient를 같은 Heatmap Weight에 포함하면 목적과 맞지 않을 수 있음.
Negative Gradient가 무의미한 것이 아니라,
이번 Grad-CAM++ Heatmap의 목적에는 적합하지 않은 것임.
Section 3.2의 가설 검증
Section 3.2에서는 Positive Gradient의 Weighted Combination이 Feature Map의 중요도와 강한 상관관계를 가진다고 가정했음.
이번 실험에서 Negative Gradient를 포함한 Grad-CAM++가 Grad-CAM보다도 낮은 성능을 보였음.
따라서 다음 주장을 뒷받침함.
특정 클래스 에 대한 Feature Map 의 중요도를 계산할 때 Positive Gradient만 사용하는 것이 중요하다.
정리해 보자면
- Grad-CAM++는 Target Class Score를 증가시키는 Positive Gradient만 사용함.
- 이를 검증하기 위해 ReLU를 제거하고 모든 Gradient를 사용하는 Grad-CAM++를 정의함.
- Grad-CAM++는 Pascal VOC 2007에서 Average Drop, Confidence Increase, Win % 모두 Grad-CAM보다 낮은 성능을 보였음.
- Negative Gradient를 포함하면 Positive Contribution과 Negative Contribution이 서로 상쇄될 수 있음.
- 그 결과 Feature Map의 Target Class 중요도가 왜곡되고, Explanation의 Faithfulness가 낮아짐.
- 따라서 Positive Gradient만 사용하는 설계는 Grad-CAM++의 성능에 핵심적인 요소임.
7.2. Does Grad-CAM++ Do Well Because of Larger Maps?
Grad-CAM++의 Heatmap은 Grad-CAM보다 객체의 더 넓은 부분을 강조하는 경우가 많음.
따라서 다음과 같은 의문이 생길 수 있음.
Grad-CAM++가 실제로 중요한 영역을 더 잘 찾은 게 아니라, 단순히 더 넓은 영역을 보여주기 때문에 Confidence가 잘 유지되는 것은 아닌가?
Explanation Map의 영역이 넓으면 원본 이미지 정보가 더 많이 남음.
따라서 모델에 Explanation Map을 다시 입력했을 때 Confidence 감소가 작아지는 것은 자연스러울 수 있음.
큰 Explanation Map

원본 이미지 정보가 많이 유지됨
                ↓
Confidence 감소가 작을 가능성
따라서 Grad-CAM++의 높은 성능이 단순히 Heatmap 크기 때문인지 확인할 필요가 있음.
Heatmap 크기와 Faithfulness의 Trade-off
Explanation Map의 면적과 모델 Confidence 사이에는 일반적으로 Trade-off가 존재함.
넓은 영역을 유지하는 경우
- 원본 정보가 많이 남음
- Confidence가 비교적 잘 유지됨
- 불필요한 배경까지 포함할 가능성이 있음
좁은 영역만 유지하는 경우
- 핵심 영역만 남길 수 있음
- 중요한 정보를 제거할 위험이 있음
- Confidence가 크게 감소할 수 있음
따라서 Explanation Method를 공정하게 비교하려면,
같거나 비슷한 면적을 남겼을 때 어느 방법이 모델의 Confidence를 더 잘 유지하는지 확인해야 함.
ROC Curve를 이용한 비교
논문에서는 Heatmap의 공간적 면적과 Occlusion 이후 Confidence 사이의 관계를 비교하기 위해 ROC 형태의 Curve를 그림.
여기서 비교한 값은 다음과 같음.
- : 원본 이미지 를 입력했을 때 클래스 의 Score
- : Occluded Image를 입력했을 때 클래스 의 새로운 Score
이 비율은 원본 Confidence가 Occlusion 이후 얼마나 유지되었는지를 의미함.
Relative Confidence의 의미
예를 들어 원본 Confidence가
이고,
Occluded Image 입력 후 Confidence가
이라면,
= 원래 Confidence의 75%가 유지된 것.
이 값은 높을수록 Explanation Map이 모델 예측에 중요한 정보를 잘 보존했다는 의미.
Threshold Parameter
Heatmap에서 얼마만큼의 영역을 유지할지 조절하기 위해 Threshold Parameter 를 사용함.
는 0부터 1까지 같은 간격으로 변화시킴.
각 에 대해 Heatmap Pixel Value의 분포에서 Quantile Threshold인 를 계산함.
Quantile Threshold
는 다음 조건을 만족하는 값.
- : Saliency Map의 위치 에서의 값
- : 제거할 하위 Pixel 비율
- : 해당 Quantile에 대응하는 Heatmap Intensity
쉽게 말하면,
가 0.3이라면 Heatmap 값이 낮은 하위 30% Pixel을 제거하는 Threshold를 구하는 것.
Occlusion Mask
각 Pixel에 대해 Binary Mask 를 생성함.
- Saliency가 Threshold보다 낮으면 0
- Saliency가 Threshold 이상이면 1
로 설정함.
Occluded Image 생성
Occluded Image는 원본 이미지와 Mask를 Element-wise Multiplication하여 생성함.
- : 원본 이미지
- : Binary Mask
- : Hadamard Product
원본 이미지 I
      ×
Binary Mask Δ
      ↓
Occluded Image
Heatmap 값이 높은 영역만 남고,
낮은 영역은 0으로 제거됨.
에 따른 영역 변화
가 작으면 적은 Pixel만 제거함.
[낮은 θ]

Heatmap 하위 일부만 제거
↓
넓은 이미지 영역 유지가 크면 많은 Pixel을 제거함.
[높은 θ]

Heatmap 하위 대부분 제거
↓
가장 강한 영역만 유지
따라서 를 변화시키면서
- 남겨지는 공간적 면적
- 유지되는 Class Confidence
사이의 관계를 비교할 수 있음.
이미지별 Quantile을 사용하는 이유
Heatmap의 절대 Intensity 범위는 이미지마다 다를 수 있음.
예를 들어 한 이미지의 Heatmap 값이
0.1~0.5 사이에 분포하고,
다른 이미지의 Heatmap 값은
0.4~1.0 사이에 분포할 수 있음.
모든 이미지에 동일한 절대 Threshold를 사용하면 남는 Pixel 비율이 서로 달라질 수 있음.
따라서 논문에서는 각 이미지의 Heatmap 분포를 기준으로 Quantile Threshold를 계산함.
이를 통해 각 이미지에서 유사한 비율의 영역을 유지하거나 제거하면서 Grad-CAM과 Grad-CAM++를 비교할 수 있음.
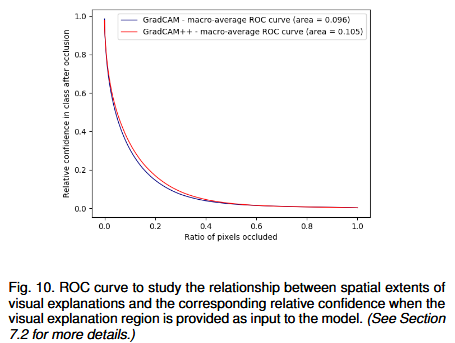
Figure. 10에서는 모든 Quantile 에서 Grad-CAM++가 Grad-CAM과 같거나 더 높은 Relative Confidence를 유지함.
동일한 비율의 영역을 남기는 조건에서도 Grad-CAM++가 모델의 예측에 더 중요한 정보를 포함했음.
[동일한 공간적 범위 비교]

Grad-CAM++
≥
Grad-CAM
이 결과는 Grad-CAM++의 성능이 더 넓은 Heatmap을 생성하기 때문만은 아님을 보여줌.
Spatial Extent와 무관한 Faithfulness
만약 Grad-CAM++가 단순히 더 넓은 영역을 강조해서 성능이 높았다면,
동일한 Quantile로 영역 크기를 통제했을 때 Grad-CAM과의 차이가 사라져야 함.
하지만 실험 결과에서는 영역 크기를 통제한 뒤에도 Grad-CAM++가 더 높은 Confidence를 유지함.
=> Grad-CAM++의 장점
: 넓은 영역을 표시하는 것 자체가 아니라, 같은 면적 안에서도 모델이 실제로 중요하게 사용한 영역을 더 잘 선택하는 것
예시로 이해하자면
두 Explanation Method가 이미지의 20% 영역만 남긴다고 가정함.
Grad-CAM
남은 20%

객체 일부
+
관련 없는 배경
Grad-CAM++
남은 20%

객체의 핵심 부분
+
예측에 필요한 Context
두 방법이 동일한 면적을 유지하더라도,
Grad-CAM++가 더 중요한 Pixel을 선택한다면 모델의 Confidence가 더 잘 유지됨.
이번 실험은 바로 이러한 차이를 확인한 것임.
ROC Curve 해석
Curve에서 좋은 Explanation Method는 같은 공간적 면적을 유지할 때 더 높은 Relative Confidence를 가져야 함.
또는 같은 Relative Confidence를 유지하면서 더 작은 영역만 남길 수 있어야 함.
Curve가 더 우수한 위치에 존재할수록
적은 Pixel로도 모델의 예측 근거를 더 잘 보존하는 설명
Figure. 10에서 Grad-CAM++는 각 Quantile에서 Grad-CAM과 같거나 더 좋은 결과를 보였음.
정리해 보자면
- Grad-CAM++의 성능 향상이 단순히 더 넓은 Heatmap 때문일 수 있다는 의문을 검증함.
- Explanation Map의 면적이 넓으면 원본 정보가 많이 남아 Confidence가 높게 유지될 수 있음.
- 이를 통제하기 위해 Heatmap Pixel의 Quantile을 기준으로 동일한 비율의 영역을 남기는 Occlusion 실험을 수행함.
- Threshold Parameter 를 0부터 1까지 변화시키며 공간적 면적과 Relative Confidence의 Trade-off를 비교함.
- 각 이미지마다 Quantile Threshold 를 계산하여 Heatmap Scale 차이의 영향을 줄임.
- 모든 Quantile에서 Grad-CAM++는 Grad-CAM과 같거나 더 높은 Relative Confidence를 유지함.
- 따라서 Grad-CAM++의 성능 향상은 단순히 더 넓은 영역을 강조하기 때문이 아님.
- Grad-CAM++는 동일한 공간적 범위에서도 모델의 예측에 더 중요한 영역을 선택함.
- 결과적으로 Grad-CAM++의 Explanation은 Heatmap 크기와 무관하게 Grad-CAM보다 더 Faithful함.
🔚8. CONCLUSION
본 논문에서는 CNN 기반 모델의 시각적 설명 기법인 Grad-CAM++를 제안함.
Grad-CAM++는 기존 Grad-CAM을 일반화한 방법으로, Pixel-wise Gradient Weighting을 통해 객체의 여러 부분과 동일 클래스의 여러 객체를 보다 정확하게 강조할 수 있다.
논문의 주요 기여는 다음과 같음.
- Grad-CAM의 한계(다중 객체, 불완전한 Localization) 개선
- ImageNet, Pascal VOC에서 객관적(Faithfulness)·주관적(Human Trust) 평가 모두 우수한 성능 확인
- Image Captioning과 3D Action Recognition 등 다양한 CNN 기반 모델에도 효과적으로 적용 가능함을 검증
- Grad-CAM++ Explanation을 Knowledge Distillation에 활용하여 Student Network의 성능을 향상시킴
마지막으로 저자는 향후 연구 방향으로 다음을 제시함.
- Explanation 기반 Knowledge Distillation Loss 개선
- 다중 클래스가 존재하는 이미지에서의 Explanation 연구
- RNN, LSTM, GAN 등 다양한 신경망 구조로의 확장
- Grad-CAM++는 Grad-CAM을 일반화한 설명 기법으로, Pixel-wise Weighting을 통해 더 정확한 Heatmap을 생성힘.
- 다양한 실험에서 Faithfulness와 Human Trust 모두 기존 Grad-CAM보다 우수한 성능을 보임.
- Image Classification뿐 아니라 Image Captioning, Video Action Recognition, Knowledge Distillation에도 효과적으로 활용될 수 있음을 확인함.
- 향후에는 다양한 신경망 구조와 Explanation 기반 학습 방법으로의 확장이 기대됨.
