Paper: SHAP - A Unified Approach to Interpreting Model Predictions
🔍1. Introduction
모델의 예측 결과를 올바르게 해석하는 것
= 다양한 응용 분야에서 매우 중요함.
모델을 해석할 수 있으면
- 사용자의 신뢰를 높일 수 있고,
- 모델 개선 방향을 찾을 수 있으며,
- 실제 문제를 이해하는 데 도움을 줄 수 있음.
기존에는 해석이 쉬운 선형 모델과 같은 단순한 모델이 선호되기도 했지만,
최근에는 대규모 데이터(Big Data)의 등장으로 복잡한 모델(앙상블, 딥러닝)이 더 높은 성능을 보이면서
정확도(Accuracy) 와 해석 가능성(Interpretability) 사이의 Trade-off가 더욱 중요해졌음.
이를 해결하기 위해 다양한 XAI 기법들이 제안되었지만,
각 방법이 서로 어떤 관계인지,
어떤 상황에서 어떤 방법을 사용하는 것이 적절한지는 명확하지 않았음.
본 논문에서는 이러한 문제를 해결하기 위해
SHAP(SHapley Additive exPlanations) 라는 통합(Unified) Framework를 제안했음.
논문의 기여는 다음 세 가지.
i) Explanation Model 관점 제안
모델의 설명(Explanation) 자체도 하나의 모델이라고 정의했음.
이를 Explanation Model이라 하고,
이걸 기반으로 Additive Feature Attribution Methods라는 새로운 방법군(Class)을 정의해서 기존 6개의 설명 기법을 하나의 Framework로 통합했음.
ii) SHAP Value 제안
게임이론(Game Theory)의 Shapley Value를 기반으로,
Additive Feature Attribution Methods에서
바람직한 성질을 모두 만족하는 유일한 Feature Importance가 존재함을 증명했음.이걸
SHAP Value라고 정의했고,
기존 여러 설명 기법은 SHAP Value를 근사(Approximation)하는 방법으로 해석할 수 있음을 보였음.
iii) 새로운 SHAP 추정 방법 제안
SHAP Value를 효율적으로 계산하는 새로운 알고리즘을 제안했음.
실험 결과, 기존 방법보다
- 사람의 직관과 더욱 잘 일치하고,
- 서로 다른 클래스의 예측을 더 효과적으로 구분하는 성능을 보였음.
✅2. Additive Feature Attribution Methods
본 논문에서는 기존의 다양한 설명 기법들이 사실 하나의 공통된 형태를 가진다는 점을 보였음.
그렇지만, 복잡한 모델 자체는 해석하기 어렵기 때문에,
모델을 직접 설명하는 대신
이를 근사하는 설명 모델(Explanation Model)을 사용해야 한다고 정의했음.
Explanation Model
원래 예측 모델을 라고 하고,
설명을 위한 모델을 라고 정의했음.
SHAP에서는
특정 입력 하나에 대한 예측을 설명하는
Local Explanation을 대상으로 함.
설명 모델은
원래 입력을 단순화한 입력(Simplified Input) 을 사용하고,
이를 Mapping Function인
를 통해 원래 입력 공간으로 변환함.
설명 모델은 원래 모델을 최대한 잘 근사하도록
다음 관계를 만족하도록 설계함.
Definition 1 : Additive Feature Attribution Methods
논문에서는 기존 설명 기법들의 공통 구조를
Additive Feature Attribution Methods라고 정의했음.
설명 모델은 다음과 같은 선형 형태를 가짐.
그리고 그 선형함수가 바로 Equation (1)이고,
하단 처럼 표현됨.
- : 단순화된 입력
- : Feature 개수
- : Feature Importance
각 Feature의 기여도()를 모두 더하면
원래 모델의 예측값을 설명하는 구조.
논문에서는 하단 기존 설명 기법들이 모두 Definition 1을 만족한다고 설명했음.
LIMEDeepLIFTLayer-wise Relevance Propagation (LRP)Shapley Regression ValuesShapley Sampling ValuesQuantitative Input Influence
겉보기에는 서로 다른 방법처럼 보였지만,
수학적으로는 모두 동일한 Additive Explanation Model을 사용하고 있었던 것.
2.1. LIME
LIME은 특정 입력 주변(Local Region)에서 원래 모델을 선형 모델로 근사하여 설명하는 방법임.
설명 모델은 다음과 같은 선형 형태를 그대로 사용함.
LIME은 Definition 1을 정확하게 만족하는 Additive Feature Attribution Method.
LIME에서는 단순화된 입력(Simplified Input)을 Interpretable Input이라고 부름.
입력 공간에 따라 Mapping Function 가 달라짐.
- 텍스트 : 단어 존재 여부(1/0)
- 이미지 : Superpixel 존재 여부(1/0)
LIME은 다음 목적함수를 최소화하여 설명 모델을 학습함.
- : 원래 모델과 설명 모델의 차이
- : 현재 입력 주변(Local Region)에 더 큰 가중치를 주는 Kernel
- : 설명 모델의 복잡도
LIME 설명 모델도 선형 형태를 그대로 사용하므로, Additive Feature Attribution Method에 해당한다는 것.
2.2. DeepLIFT
DeepLIFT는 Input 을 Reference Input과 비교해서
각 입력 Feature가 출력 변화에 얼마나 기여했는지를 계산하는 방법.
Input 은
- 1 : 원래 입력
- 0 : Reference Value
로 표현함.
DeepLIFT는
라는 Summation-to-Delta Property를 만족함.
여기서 ""이고,
는 Reference Input임.
논문에서는
로 두면
DeepLIFT역시 Equation (1)과 동일한 형태가 됨을 보였음.
2.3. Layer-Wise Relevance Propagation
LRP(Layer-Wise Relevance Propagation)는 Deep Network의 예측을 설명하기 위해 Relevance를 역전파하는 방법임.
논문에서 LRP는 모든 Reference Activation을 0으로 고정한 DeepLIFT와 수학적으로 같다고 설명했음.
따라서
- 1 : 원래 입력
- 0 : 입력값 0
으로 Mapping되고,
LRP역시 Equation (1)을 만족하는 Additive Feature Attribution Method.
2.4. Classic Shapley Value Estimation
논문에서는 기존의 Shapley 기반 방법도 모두 Equation (1)에 포함된다고 설명했음.
대표적인 방법:
- i)
Shapley Regression Values - ii)
Shapley Sampling Values - iii)
Quantitative Input Influence
i) Shapley Regression
Feature를 하나 추가했을 때 예측이 얼마나 변하는지를
모든 가능한 Feature 부분집합에 대해 계산한 뒤,
이를 가중 평균하여 Shapley Value를 계산함.
Feature가 예측에 기여한 평균적인 Marginal Contribution을 계산하는 방식.
ii) Shapley Sampling
위 식을 Sampling으로 근사하여 계산량을 줄인 방법
iii) Quantitative Input Influence
거의 동일한 Sampling 기반 Shapley 접근 사용
결국 세 방법 모두 Equation (1)을 만족하는
Additive Feature Attribution Method.
LIME은 Local Linear Model을 사용하므로 Equation (1)을 그대로 만족함.DeepLIFT는 Reference Input 대비 출력 변화량을 Feature별로 분배하며 Equation (1)과 동일한 구조를 가짐.LRP는 Reference를 모두 0으로 둔 DeepLIFT와 동일함.기존 Shapley 기반 방법들도 모두 Feature 기여도를 더하는 형태이므로 Equation (1)에 포함됨.
=>기존의 대표적인 설명 기법들은 모두
Additive Feature Attribution Methods라는 하나의 Framework로 통합될 수 있음.
✅3. Simple Properties Uniquely Determine Additive Feature Attributions
Section 2에서는 LIME, DeepLIFT, LRP, Shapley 기반 방법들이 모두 Additive Feature Attribution Methods라는 동일한 Framework에 속한다는 것을 보였음.
하지만 단순히 같은 Framework를 사용한다고 해서 모두 같은 품질의 설명을 제공하는 것은 아님.
그래서 좋은 Feature Attribution Method가 만족해야 하는 세 가지 성질(Property) 을 정의하고,
이를 모두 만족하는 방법은 SHAP Value 하나뿐임을 증명하고자 함.
Property 1 : Local Accuracy
첫 번째 성질은 Local Accuracy.
설명 모델은 현재 입력에 대해 원래 모델의 출력과 같은 값을 가져야 함.
그러니
를 만족해야 함.
- : 원래 모델의 출력
- : 설명 모델의 출력
설명 모델이 실제 모델의 예측값을 정확하게 재현해야 한다는 의미.
Property 2 : Missingness
두 번째 성질은 Missingness.
입력에 존재하지 않는 Feature는
설명에도 영향을 줘선 안 됨.
그렇기에
를 만족해야 함.
Feature가 존재하지 않는데 Importance가 부여된다면
올바른 설명이라고 볼 수 없는 것.
Property 3 : Consistency
세 번째 성질은 Consistency임.
모델이 변경돼서
어떤 Feature의 기여도가 증가하거나 그대로 유지되었다면,
설명에서 해당 Feature의 Importance 역시 감소해서는 안 됨.
실제 모델에서 Feature의 영향력이 커졌는데
설명에서는 Importance가 줄어든다면
설명 방법이 일관성을 잃게 됨.
라고 정의하고,
(는 Feature 를 제거해서 으로 만든 입력을 의미)
임의의 두 모델 와 에 대해,
가 모든 에 대해 성립한다면,
다음 역시 반드시 만족해야 함.
모델이 변경돼서 Feature 의 실제 기여도가 증가(또는 유지)했다면,
설명에서 계산되는 Importance 역시 감소해서는 안 된다는 의미.실제 모델의 영향력과 Explanation이 서로 일관성을 유지해야 한다는 것이 Consistency Property에서의 중요 포인트.
Theorem 1
논문에서는 Definition 1을 만족하는 Additive Feature Attribution Methods 중
다음 세 가지 Property인
Local AccuracyMissingnessConsistency
를 모두 만족하는 방법은 단 하나뿐임을 증명했음.
그 유일한 것이 바로 SHAP Value.
SHAP Value는 다음과 같이 정의됨.
- : 현재 입력의 Feature 부분집합
- : 해당 Feature 집합만 존재할 때의 모델 출력
- : Feature 를 제거한 경우의 모델 출력
모든 가능한 Feature 조합에서
Feature 하나를 추가했을 때 증가하는 예측값(Marginal Contribution)을
적절한 가중치로 평균낸 값이 SHAP Value.
논문에서는
이 결과가 Cooperative Game Theory의 Shapley Value와 동일함을 설명함.
Young(1985)의 결과를 이용해서
Shapley Value가 이런 성질을 만족하는 유일한 해(Unique Solution) 임을 보였고,
SHAP는 이걸 XAI 문제에 적용한 것.
Section 2에서
기존 설명 기법들이 모두 같은 Additive Framework를 사용한다는 사실을 보였음.
이어서 Section 3에서는 그 Framework 안에서
좋은 설명이 만족해야 하는 세 가지 성질을 정의하고,
이를 모두 만족하는 유일한 Feature Attribution이
SHAP Value임을 이론적으로 증명했음.
기존 방법들이 모두 같은 Framework 안에 존재하지만,
모든 Property를 동시에 만족하는 것은 SHAP뿐이구나.
- 좋은 Explanation은
Local Accuracy,Missingness,Consistency를 만족해야 함.
-Local Accuracy: 원래 모델의 출력과 설명 모델의 출력이 동일해야 함을 의미.
-Missingness: 존재하지 않는 Feature에는 Importance를 부여하지 않아야 함을 의미.
-Consistency는 Feature: 실제 영향력이 증가하면 Importance도 감소해서는 안 됨을 의미.- 논문에서는 이 세 가지 성질을 모두 만족하는 유일한 Additive Feature Attribution Method가 SHAP Value임을 증명했음.
✅4. SHAP (SHapley Additive exPlanation) Values
이번에는 실제로 SHAP Value를 어떻게 정의하고 계산하는지 설명하도록 하겠음.
본 논문에서는 SHAP Value를 Feature Importance를 측정하는 통합된(Unified) 척도로 제안했음.
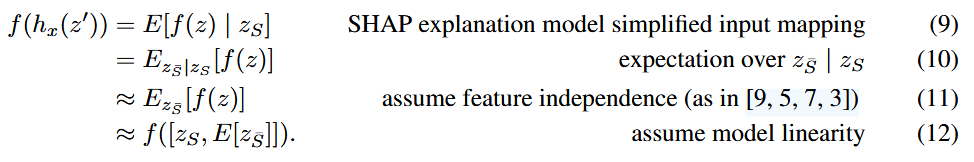
SHAP Value는 원래 모델의 Conditional Expectation Function에 대해 계산한 Shapley Value이며,
Equation (8)의 해를 그대로 사용함.
그래서
로 정의함.
- : 에서 값이 1인 Feature들의 집합
- : Feature 집합 가 주어졌을 때의 조건부 기대값(Conditional Expectation)
현재 선택된 Feature들만 유지한 상태에서 모델의 평균적인 예측값을 계산하는 것과 같음.
Simplified Input Mapping
SHAP에서는 단순화된 입력(Simplified Input)을
로 정의함.
- : 선택된 Feature만 남겨두고,
선택되지 않은 Feature들은 Missing Value로 처리한 입력.
하지만 대부분의 Machine Learning 모델은
Missing Value를 직접 입력받을 수 없음.> 따라서 논문에서는 이를 그대로 사용할 수 없기 때문에
Conditional Expectation으로 근사함.
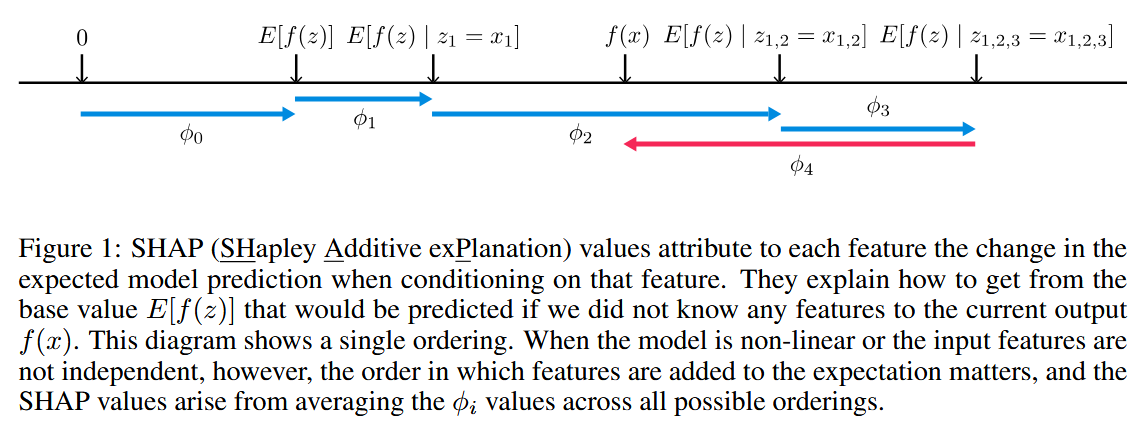
Conditional Expectation
SHAP의 정의는
으로 표현됨.
선택된 Feature들은 고정한 상태에서
나머지 Feature들의 가능한 값을 모두 고려해
모델 출력의 평균을 계산하는 것.
Assumption 1 : Feature Independence
Conditional Expectation을 계산하는 것은 매우 어려움.
따라서 첫 번째 근사 방법으로
Feature들이 서로 독립이라고 가정함.
그러면
으로 계산할 수 있음.
선택되지 않은 Feature들은
조건부 분포대신
전체 분포에서 평균적으로 샘플링해서\ 계산함.
이건 기존의
Shapley SamplingQuantitative Input InfluenceLIMEDeepLIFT
등에서도 사용한 가정임.
Assumption 2 : Model Linearity
Conditional Expectation 계산을 더욱 단순하게 하기 위해
모델이 선형적으로 동작한다고 추가로 가정할 수도 있음.
이 경우
으로 근사함.
Missing Feature들을 평균값으로 대체한 뒤
한 번만 모델을 수행하여 예측값을 계산하는 방법.
Conditional Expectation을 직접 계산하는 것보다 훨씬 빠르지만,
정확도는 다소 감소할 수 있음.
왜 Conditional Expectation을 사용하는가
SHAP에서는 Feature를 제거한 상태에서도
모델의 출력을 계산해야 함.
다만 실제 모델은 Missing Value를 입력받을 수 없음.
따라서 제거된 Feature들의 값을 직접 비우는 대신,
그 Feature들이 가질 수 있는 다양한 값을
평균내서 Conditional Expectation으로 대체한 것.
SHAP은
Feature를 제거했을 때 모델이 평균적으로 어떻게 예측하는지를 계산하기 위해
Conditional Expectation을 사용함.
SHAP Value는 Conditional Expectation Function에 대한 Shapley Value임.- 선택된 Feature만 유지한 상태에서 모델의 평균적인 출력을 계산함.
- 대부분의 모델은 Missing Value를 처리하지 못하기 때문에 Conditional Expectation으로 대신함.
- Conditional Expectation 계산이 어려우므로
Feature Independence와Model Linearity라는 두 가지 근사를 사용할 수 있음.
4.1. Model-Agnostic Approximations
SHAP Value를 정확하게 계산하는 것은 계산량이 엄청 많기 때문에 현실적으로 어려움.따라서 본 논문에서는 모델 종류와 관계없이(Model-Agnostic) SHAP Value를 근사하는 여러 방법을 제안했음.
먼저 Feature Independence를 가정하면(Equation 11),
SHAP Value는 기존의 Shapley Sampling Values 또는 Quantitative Input Influence 방법을 이용하여 근사할 수 있음.
이 방법들은 Equation (8)의 Shapley Value를 모든 Feature 순열(Permutation)에 대해 샘플링하여 계산함.
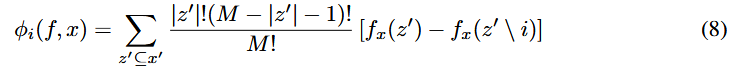
하지만 Feature마다 각각 별도의 Sampling을 수행해야 하므로,
입력 Feature 수가 많아질수록 계산량이 매우 커지는 문제가 있음.
이를 해결하기 위해 논문에서는 Kernel SHAP를 새롭게 제안했음.
Kernel SHAP (Linear LIME + Shapley Values)
Kernel SHAP
: Linear LIME과 Shapley Value를 결합한 방법.
LIME 역시 선형 설명 모델을 사용해서
원래 모델을 국소적으로(Local) 근사함.
위 형태의 Explanation Model을 사용한다는 점에서
Definition 1을 만족하는 Additive Feature Attribution Method임.
따라서 Section 3의 Theorem 1에 의해,
LIME 역시
Local AccuracyMissingnessConsistency를 모두 만족하려면
반드시 SHAP Value를 계산해야 함.
하지만 기존 LIME은
Loss Function,Weighting Kernel,Regularization을 경험적으로(Heuristically) 선택했기 때문에
실제로는 SHAP Value를 계산하지 못함.> Local Accuracy 또는 Consistency를 위반할 수 있고,
특정 상황에서는 직관적이지 않은 Explanation을 생성할 수 있음.
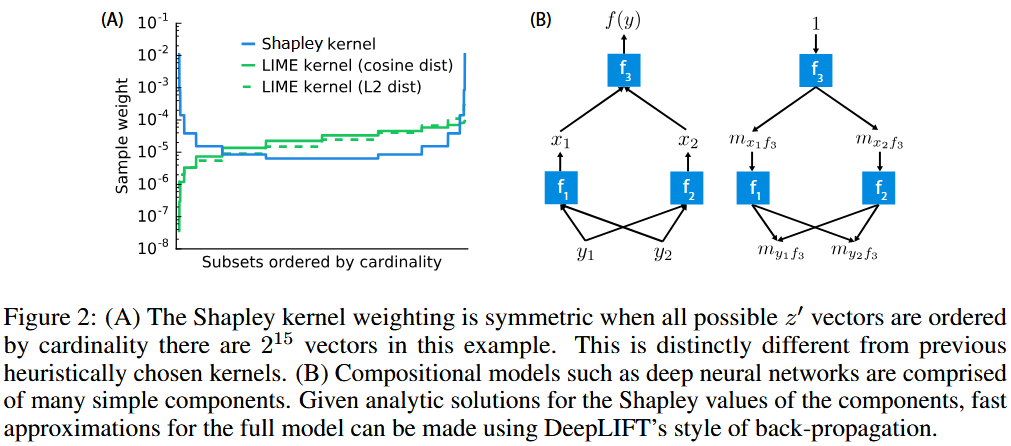
Theorem 2 (Shapley Kernel)
논문에서는 Equation (2)의
RegularizationWeighting KernelLoss Function을 어떻게 선택해야
SHAP Value와 동일한 결과를 얻을 수 있는지를 증명했음.
그 결과는 다음과 같음.
i) Regularization
Regularization은 사용할 필요가 없구나.
ii) Weighting Kernel
- : 전체 Feature 개수
- : 선택된 Feature 개수
기존 LIME의 Kernel은 경험적으로 선택되었지만,
SHAP에서는 위 식이 유일한 해임을 증명했음.
iii) Loss Function
설명 모델과 원래 모델의 차이를
Weighting Kernel을 적용한 Weighted Least Squares 형태로 최소화함.
논문에서는 인 경우
가 되어
다음 두 조건이 반드시 만족되도록 강제한다고 설명함.
기본값(Base Value)과 모든 Feature Attribution의 합이
반드시 원래 모델의 출력과 같도록 강제하는 것.
실제 구현에서는 이러한 무한대 가중치를 직접 사용하지 않고,
해당 조건을 이용해서 두 개의 변수를 제거한 뒤 최적화를 수행함.
왜 Kernel SHAP가 중요한가?
Theorem 2를 통해
Shapley Value를 Weighted Linear Regression만으로 계산할 수 있게 됐음.
> 게임이론에서 정의된 Shapley Value를
복잡한 조합 계산 없이
선형회귀 문제로 변환할 수 있게 된 것.
모든 Feature를 동시에 추정하기 때문에
기존 Shapley Sampling보다
훨씬 적은 모델 평가(Model Evaluation)만으로도
비슷한 정확도의 SHAP Value를 계산할 수 있음.
- 기존 Shapley Sampling은 얀산량이 매우 큼.
Kernel SHAP는 Linear LIME과 Shapley Value를 결합한 새로운 방법.기존 LIME은 Kernel과 Loss를 경험적으로 선택하기 때문에 SHAP Value를 보장하지 못함.- Theorem 2에서는 SHAP Value를 정확히 복원하는 Kernel, Loss Function, Regularization을 제안함.
- 이를 통해 Shapley Value를 Weighted Linear Regression 문제로 변환해서 보다 효율적으로 계산할 수 있게 되었음.
4.2. Model-Specific Approximations
Kernel SHAP는 모든 종류의 모델(Model-Agnostic)에 적용할 수 있다는 장점이 있지만,
여전히 많은 모델 평가(Model Evaluation)가 필요하여 계산 비용이 큰 편.
그렇기 때문에 특정 모델의 구조를 활용해서
SHAP Value를 더욱 빠르게 근사하는
Model-Specific Approximation Methods를 제안했음.
i) Linear SHAP
선형 모델(Linear Model)의 경우에는
Feature들이 서로 독립이라고 가정하면(Equation 11),
SHAP Value를 엄청 간단하게 계산할 수 있음.
선형 모델은
로 표현됨.
이 경우,
Base Value는 고,
각 Feature의 SHAP Value는
로 계산됨.
Feature Importance는 해당 Feature의 가중치()와
평균으로부터 얼마나 벗어났는지 를 곱한 값으로 표현됨.
이건 Theorem 2와 Equation (11)으로부터 유도되고,
기존 Shapley Sampling 연구에서도 알려진 결과임.
ii) Low-Order SHAP
Theorem 2를 이용한 Linear Regression 기반 SHAP 계산은
시간복잡도가
> Feature 개수가 적은 경우에는 효율적으로 계산할 수 있지만,
Feature 수가 많아질수록 계산량이 급격히 증가함.
iii) Max SHAP
논문에서
Max Function에 대해서는
모든 Feature 조합을 계산하지 않고도
SHAP Value를 빠르게 계산할 수 있음을 보였음.
입력값을 정렬한 뒤,
각 Feature가 최대값(Maximum)을 증가시킬 확률을 계산해서
SHAP Value를 구함.
그래서 기존 의 계산량을
까지 감소시킬 수 있음.
Max Pooling과 같은 연산에서
아주 효율적으로 SHAP Value를 계산 가능.
iv) Deep SHAP (DeepLIFT + SHAP Values)
Kernel SHAP은
모든 모델에서 사용할 수 있지만,
Deep Neural Network에서는
네트워크의 구조를 활용하면
더 빠르게 SHAP Value를 계산할 수 있음.
논문에서는
DeepLIFT와 SHAP 사이에 중요한 관계가 존재함을 발견했음.
만약
DeepLIFT의 Reference Value를
Equation (12)의
로 해석하면,
DeepLIFT는
- Feature Independence
- Model Linearity
를 가정한 SHAP Value의 근사 방법으로 볼 수 있음.
근데DeepLIFT의 Backpropagation Rule은
직관적으로 설계된 경험적(Heuristic) 방법이었음.
그래서 논문에서는
이를 SHAP Theory에 맞게 수정해서
Deep SHAP를 제안했음.
Deep SHAP의 계산 과정
Deep SHAP는
네트워크를 작은 구성 요소(Component)로 나눠서
각 Component의 SHAP Value를 계산한 뒤,
이를 전체 Network로 전파함.
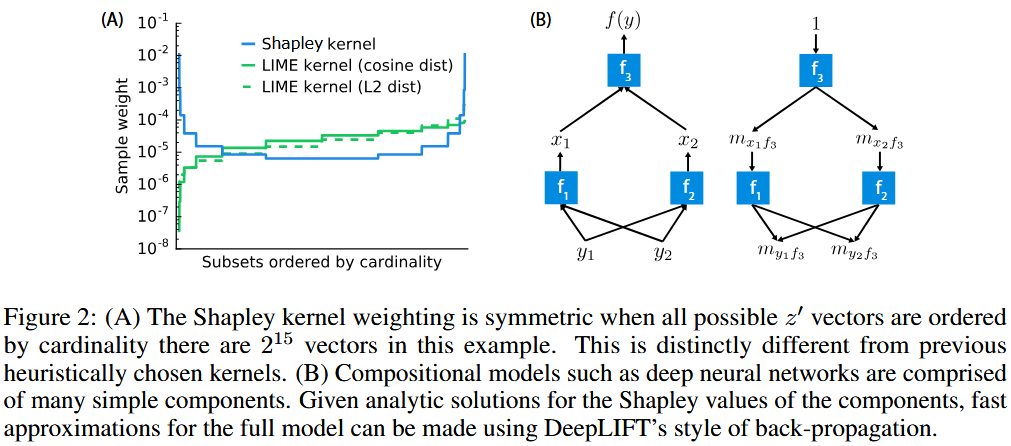
먼저,
출력 노드의 Multiplier는로 정의함.
은닉층에서는
를 계산함.
이후에 Chain Rule을 이용해서
Multiplier를 뒤쪽 Layer로 전달함.
마지막으로
Linear Approximation을 이용해서최종 SHAP Value를 계산함.
> Deep SHAP는
각 Layer에서 계산한 SHAP Value를
Backpropagation 방식으로 전달해서
전체 Network의 SHAP Value를 빠르게 계산하는 방법.
Deep SHAP 장점
Deep SHAP는
Activation Function, Max Pooling, Linear Layer 등
각 Network Component의 SHAP Value를 먼저 계산한 뒤,
이걸 조합해서
전체 모델의 SHAP Value를 계산함.
기존 DeepLIFT처럼
경험적으로 Layer를 선형화하는 게 아니라,
각 Component에서 계산한 SHAP Value를 이용해서
보다 이론적으로 타당한 Explanation을 생성할 수 있음.
Model-Specific SHAP
: 특정 모델 구조를 활용해서 SHAP Value를 빠르게 계산하는 방법.- Linear SHAP는 선형 모델에서 Weight만으로 SHAP Value를 계산할 수 있음.
- Max SHAP는 Max Function의 계산량을 에서 까지 감소시켰음.
- Deep SHAP는 DeepLIFT와 SHAP를 결합하여 Deep Neural Network에서 SHAP Value를 효율적으로 계산하는 방법임.
- 각 Layer의 SHAP Value를 Chain Rule을 이용하여 전달함으로써 전체 Network의 SHAP Value를 근사함.
✅5. Computational and User Study Experiments
본 논문에서는 제안한 SHAP Value의 성능을 검증하기 위해
Kernel SHAP와 Deep SHAP를 이용한 다양한 실험을 수행했음.
실험은 크게 세 가지로 구성.
- Computational Efficiency : 계산 효율성과 근사 정확도 비교
- Consistency with Human Intuition : 사람이 생각하는 Feature Importance와의 일치 정도 비교
- Explaining Class Differences : 이미지 분류 문제에서 Explanation 품질 비교
5.1. Computational Efficiency
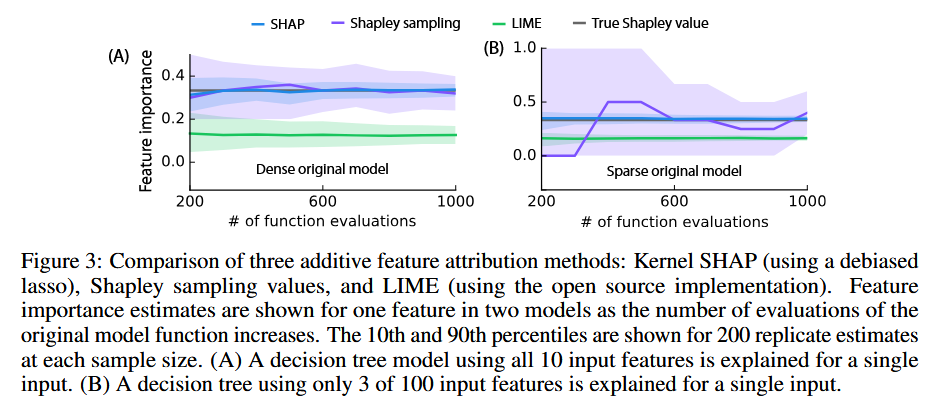
첫 번째 실험에서는
Kernel SHAPLIMEShapley Sampling Values
를 비교해서 계산 효율성과 정확도를 평가했음.
Kernel SHAP는 Theorem 2에서 제안한 Weighted Linear Regression을 이용해서 SHAP Value를 계산함.
기존의 Shapley Sampling은 Feature마다 반복적으로 샘플링을 수행해야 하기 때문에 계산량이 매우 큼.
반면, Kernel SHAP은 모든 Feature의 Importance를 동시에 추정하니까
더 적은 횟수의 모델 평가(Model Evaluation)만으로도 높은 정확도를 달성했음.
또한,
Linear Regression에 Regularization을 추가하면
근사 정확도가 더욱 향상되는 것을 확인했음.
논문에서는
Dense Decision Tree와 Sparse Decision Tree를 이용해서
Shapley SamplingKernel SHAPLIME을 비교했거,
Kernel SHAP이 가장 높은 Sample Efficiency를 보였음.
그리고 LIME은 SHAP Value와 상당히 다른 Feature Importance를 계산하는 경우가 존재했음.
(LIME이 Local Accuracy와 Consistency를 항상 만족하지 못하기 때문임. )
5.2. Consistency with Human Intuition
두 번째 실험에서는
SHAP Value가 실제 사람의 직관(Human Intuition)과 얼마나 일치하는지를 평가했음.
논문에서는 Amazon Mechanical Turk를 이용해서 사용자 실험(User Study)을 수행했음.
기본 가정
: 좋은 Explanation이라면, 모델을 이해한 사람이 생각하는 Feature Importance와 비슷해야 함.
실험은 두 가지 시나리오로 구성되었읍.
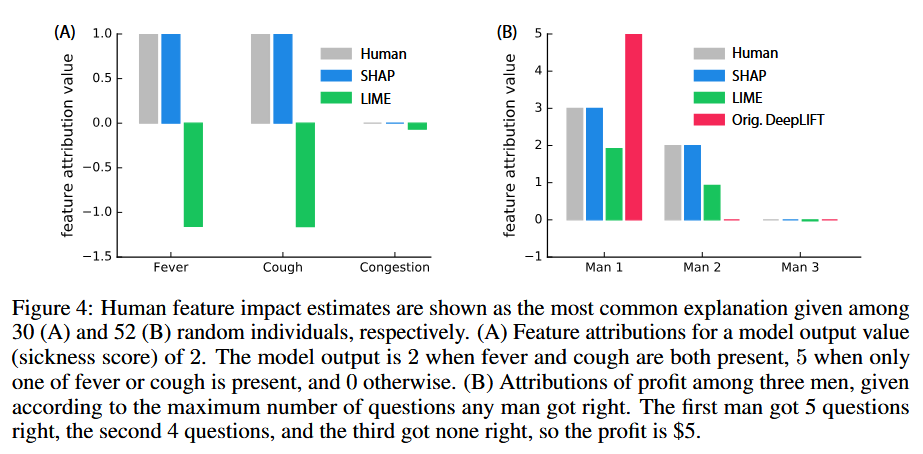
i) Sickness Score
첫 번째 실험에서는
두 개의 증상 중 하나만 존재할 때
질병 점수가 높아지는 간단한 모델을 사용했음.
참가자들은 질병 점수가 발생한 원인을
각 증상에 어떻게 분배할지를 직접 판단했음.
ii) Max Allocation Problem
두 번째 실험에서는
세 사람이 획득한 최대 점수(Max Score)에 따라
상금을 분배하는 문제를 사용했음.
참가자들은 최종 결과에 대한 기여도를
각 사람에게 어떻게 배분해야 하는지를 평가했음.
두 실험 모두에서
SHAP의 Explanation이 LIME이나 DeepLIFT보다
사람의 직관과 훨씬 높은 일치도를 보였음.
특히 DeepLIFT에서 해결하지 못했던
Max Pooling Function의 Attribution 문제를
SHAP이 효과적으로 해결함을 확인했음.
5.3. Explaining Class Differences
세 번째 실험에서는
MNIST 손글씨 숫자 분류 문제를 이용해서
SHAPDeepLIFTLIME의 Explanation 성능을 비교했음.
실험에서는
- 두 개의 Convolution Layer,
- 두 개의 Dense Layer,
- 10-Class Softmax Output으로 구성된
사전 학습된 CNN 모델을 사용했음.
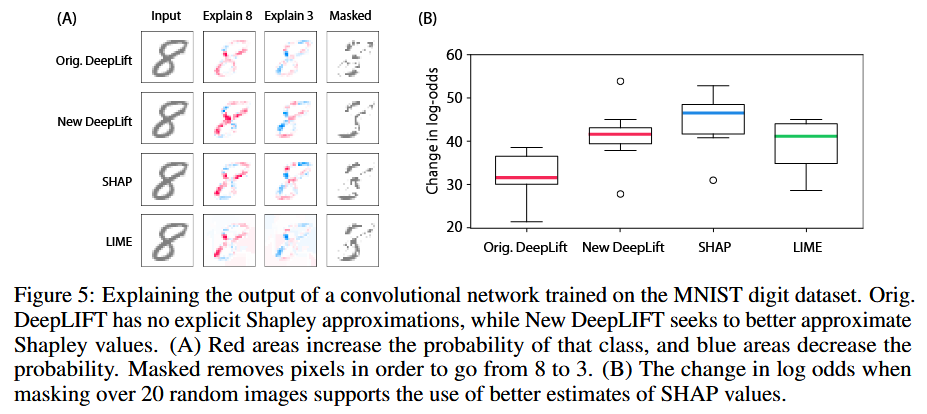
DeepLIFT는 중간 Linear Layer를 설명하는 반면,
SHAP과 LIME은 최종 모델 출력(Output)을 설명하도록 설정함.
SHAP와 LIME은 각각 50,000개의 샘플을 사용하여 Explanation을 계산했고,
LIME은 성능 향상을 위해 픽셀 단위의 Segmentation을 사용함.
실험에서는 숫자 8을 3으로 잘못 분류하도록 만드는 데
가장 중요한 20%의 픽셀을 각 방법이 얼마나 정확하게 찾아내는지를 비교했음.
그 결과,
SHAP에 가까운 Attribution을 사용할수록
클래스를 변경하는 데 필요한 핵심 픽셀을 더 정확하게 식별할 수 있었음.
그리고 Deep SHAP는 기존 DeepLIFT보다
Shapley Value에 더욱 가까운 Explanation을 생성해서
더 우수한 성능을 보였음.
🔚6. Conclusion
최근 머신러닝 모델은 높은 예측 성능을 달성하고 있지만,
모델이 왜 이러한 예측을 내렸는지 이해하기 어려운 문제가 점점 중요해지고 있음.
이런 Accuracy와 Interpretability 사이의 Trade-off는
모델의 예측을 해석하기 위한 다양한 XAI 기법의 발전을 이끌었음.
본 논문에서는
기존의 다양한 Feature Attribution 방법들을
Additive Feature Attribution Methods라는 하나의 Framework로 통합했음.
또한, 이 Framework에서
Local AccuracyMissingnessConsistency를 모두 만족하는 유일한 해가
SHAP Value임을 이론적으로 증명했음.
SHAP은
기존의 여러 XAI 기법을 하나의 이론으로 연결하고,
가장 바람직한 Feature Importance를 계산하는 통합된 기준(Unified Measure)을 제시한 것.
논문에서는
SHAP Value를 효율적으로 계산하기 위한
다양한 근사 알고리즘도 함께 제안했음.
대표적으로
Kernel SHAPLinear SHAPMax SHAPDeep SHAP등을 소개했고,이론적 증명과 다양한 실험을 통해
SHAP Value가 기존 방법보다
더 일관되고 신뢰할 수 있는 Explanation을 제공함을 확인했음.
마지막으로,
논문에서는 향후 연구 방향도 제시하였음.
앞으로는
- 더 적은 가정으로 SHAP Value를 계산하는 알고리즘 개발
- 모델 구조를 활용한 더욱 빠른 SHAP 근사 방법 연구
- 게임이론 기반의 Feature Interaction 분석
- 새로운 형태의 Explanation Model 개발
등이 중요한 연구 주제가 될 것으로 제안하였음.
- SHAP은 기존 Feature Attribution 방법들을 하나의 Framework로 통합했음.
Local Accuracy,Missingness,Consistency를 모두 만족하는 유일한 Feature Attribution Method가 SHAP Value임을 증명했음.Kernel SHAP,Deep SHAP등 다양한 근사 알고리즘을 제안해서 실제 모델에서도 효율적으로 SHAP Value를 계산할 수 있도록 함.- 이론 증명 & 실험을 통해 SHAP이 기존 방법보다 더 신뢰성 있고 일관된 Explanation을 제공함을 확인함.
- 향후에는 더욱 빠른 SHAP 계산 방법과 Feature Interaction을 고려한 새로운 Explanation 기법 연구가 필요함.
