Paper: Integrated Gradients - Axiomatic Attribution for Deep Networks
🔍1. Motivation and Summary of Results
본 논문에서는 딥러닝 모델의 예측 결과를 각 입력 특징에 할당하는 Attribution 문제를 다뤘음.
우선 딥러닝 모델을 하단과 같은 함수로 정의함.
- : 설명하고자 하는 딥러닝 모델
입력은 다음과 같이 표현함.
- : 실제 입력
Baseline 입력 을 기준으로 한 입력 의 Attribution은 다음과 같은 벡터로 정의됨.
- : Baseline 입력
여기서 는 입력 특징 가 모델의 예측 에 기여한 정도를 의미함.
이미지 분류 모델에서는 하단처럼 Attribution을 통해 특정 클래스를 선택하는 데 어떤 픽셀들이 영향을 미쳤는지 확인할 수 있음.
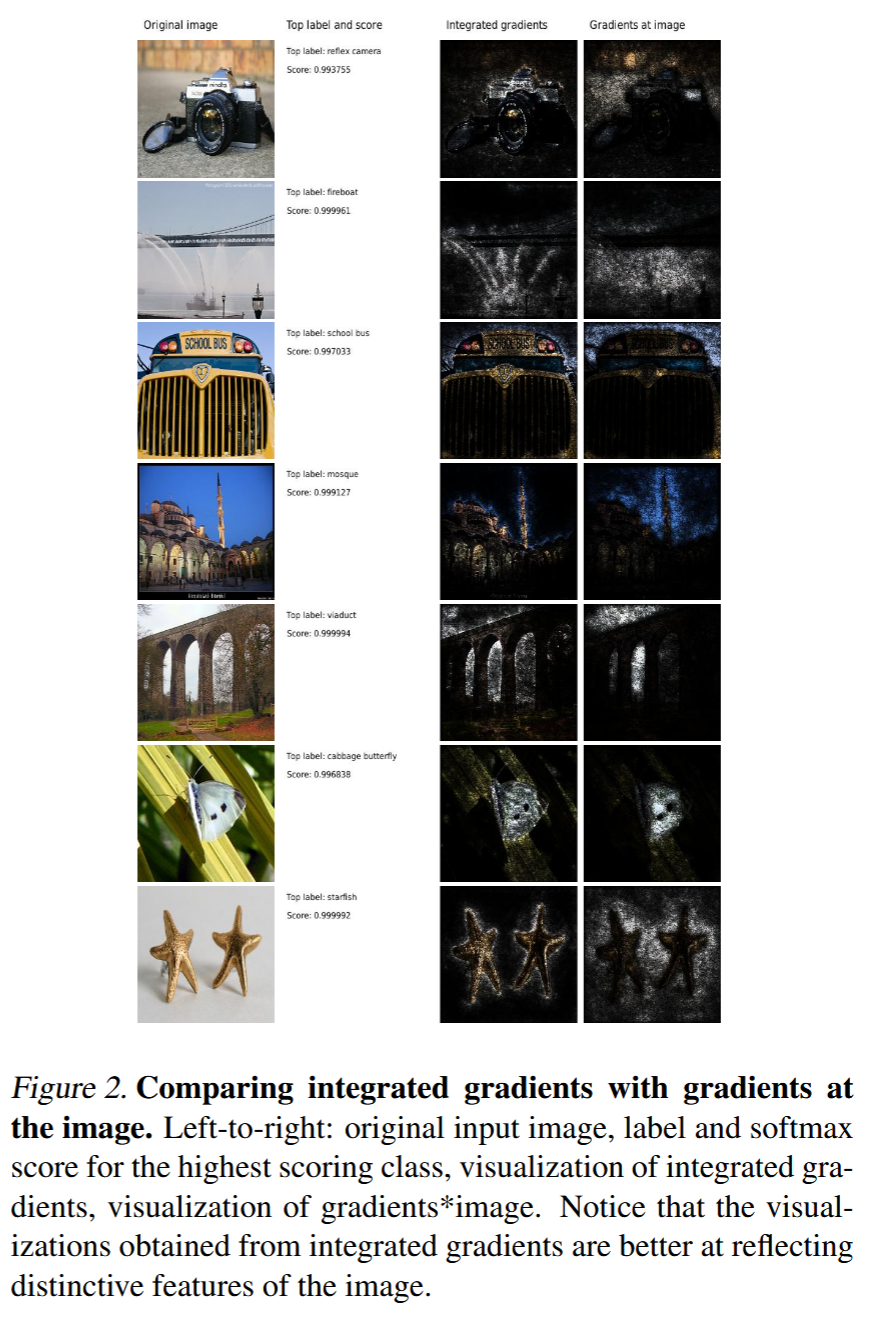
=> 덕분에 모델의 입/출력 사이의 관계를 이해하고, 모델을 개선하거나 디버깅하는 데 활용될 수 있음.
기존 Attribution 연구(CAM, Saliency Map, DeepLIFT 등)는 단순히 예쁜 Heatmap을 만드는 것이 목적이 아님.
왜 모델이 그런 예측을 했는지 이해하고, 이걸 기반으로 모델을 개선하는 게 궁극적인 목적.
ex1. 의료 영상 모델이 특정 질환을 예측한 경우, 영상의 어느 부분이 판단에 영향을 미쳤는지를 의사에게 제공할 수 있음.
ex2. 개발자는 Attribution을 이용해 신경망이 학습한 패턴을 분석하고, 이를 규칙 기반 시스템에 활용할 수도 있음.
★ 하지만 Attribution 방법은 실험적으로 평가하기 어렵다는 문제가 있음.
: 설명 결과가 잘못됐을 때,
그 원인이 모델 자체의 잘못된 동작인지 Attribution 방법의 오류인지 구분하기 어렵기 때문.
본 논문에서는
이러한 한계를 보완하기 위해
공리적 접근법(Axiomatic Approach)을 사용했음.모든 Attribution 방법이 만족해야 할 두 가지 공리(
Sensitivity,Implementation Invariance)를 정의하고
(근데 기존의 대부분의 Attribution 방법은 이 두 공리 중 적어도 하나를 만족하지 못함),이를 바탕으로 새로운 방법인 Integrated Gradients를 제안했음.
- Integrated Gradients는 기존 네트워크 구조를 수정할 필요가 없고,
- 표준 Gradient 연산을 여러 번 수행하는 방식으로 비교적 쉽게 계산할 수 있음.
논문에서는 이를
이미지,텍스트 처리,화학 모델에 적용해,
모델 이해,디버깅,규칙 추출등의 활용 가능성을 보였음.
Sensitivity: 예측을 바꾼 Feature라면 반드시 기여도가 있어야 함.Implementation Invariance: 같은 함수를 구현하면 Attribution도 같아야 함.
+ Baseline은 왜 필요한가
Attribution은 실제 입력 만으로 정의되지 않고,
비교 기준인 Baseline 을 함께 사용함.
사람의 경우, 어떤 원인에 책임을 부여할 때,
해당 원인이 존재하지 않았을 경우를 암묵적으로 비교함.
ex.
A 때문에 사고가 났다.
↓
A가 "없었다면" 사고가 났을까?
논문에서는 이런 반사실적 직관(Counterfactual Intuition)을 딥러닝 모델에 적용해,
원인이 존재하지 않는 상태를 하나의 Baseline 입력으로 표현했음.
그래서 객체 인식 모델에서는 일반적으로 검은 이미지를 Baseline으로 사용할 수 있음.
즉, Integrated Gradients는 다음과 같은 관점에서 입력 특징의 기여도를 계산함.
Baseline에서 실제 입력으로 변화하는 과정에서 각 입력 특징이 모델의 예측에 얼마나 기여했는지를 분석하는 것.
정리해 보자면
- Attribution: 모델의 예측을 입력 특징별 기여도로 나누는 문제.
- 모델의 오류와 설명 방법의 오류를 구분하기 어렵기 때문에 경험적 평가에는 한계가 있음.
- 본 논문에서는 공리적 접근(Axiomatic Approach)을 통해 Integrated Gradients를 제안했음.
- IG는 Baseline과 실제 입력을 비교해서 각 특징의 기여도를 계산함.
✅2. Two Fundamental Axioms
앞 장에서 언급했듯, Attribution 방법은 실험만으로 객관적인 평가가 어렵다는 문제가 있었음.
그래서 본 논문에서는 좋은 Attribution 방법이라면 반드시 만족해야 하는 두 가지 공리(Axiom)를 제안함.
- i) Sensitivity
- ii) Implementation Invariance
논문에서는 기존 Attribution 방법인
GradientDeepLiftLayer-wise Relevance Propagation(LRP)Deconvolution Network(DeConvNet)Guided Backpropagation
등을 분석한 결과,
모든 방법이 최소 하나 이상의 공리를 만족하지 못한다고 설명함.
그리고 이후 제안하는 Integrated Gradients는 이 두 공리를 만족하도록 설계되었음.
Gradients
선형 모델에서는 일반적으로
모델의 계수(Coefficient) × 입력 특징값(Feature Value)을 확인해서 예측이 왜 그렇게 나왔는지를 분석함.
딥러닝에서는 선형 모델의 계수(Coefficient)에 대응되는 값이 Gradient기에,
기존 연구에서는
Gradient × Input을 Attribution의 출발점으로 사용했음.
하지만 논문에서는 Gradient 기반 방법은 이후 소개할 Sensitivity 공리를 만족하지 못한다고 지적함.
2.1. Axiom: Sensitivity(a)
Sensitivity(a)란?
Baseline과 실제 입력이 오직 하나의 특징(feature)에서만 다르고,
그 차이로 인해 모델의 출력이 달라졌다면,
그 특징의 Attribution은 반드시 0이 아니어야 한다는 조건.
Baseline
↓

Feature 하나만 변경

↓

Prediction도 변경
이라면
해당 Feature는 반드시 예측에 attribute했다고 판단해야 함.
왜 Gradient는 Sensitivity를 만족하지 못하는가
논문에서는 아래와 같은 ReLU 예제를 제시함.
- Baseline :
- Input :
이 경우
모델의 출력은 0에서 1로 변했음.
=> 입력이 예측을 변화시켰으므로
는 0이 아닌 Attribution을 받아야 함.
하지만 주어진 함수 는
ReLU의 특성 때문에 x>1에서 함수가 일정한(flat) 값을 가지고,
그렇기에 에서는 함수가 flat해져 Gradient가 0이 됨.
그래서 Gradient 기반 Attribution은
Attribution = 0을 반환하게 됨.
=> 예측은 변했는데도 기여도를 0으로 판단하는 것이기에, Sensitivity(a)를 위반함.
논문에서는 이런 현상이 발생하는 이유를
Gradient는 입력 지점에서의 순간 기울기(Instantaneous Gradient)만 보기 때문이라고 설명함.
입력 근처가 평평하면
실제로 Baseline과 비교했을 때 출력은 크게 달라졌더라도
Gradient는 0이 될 수 있음.
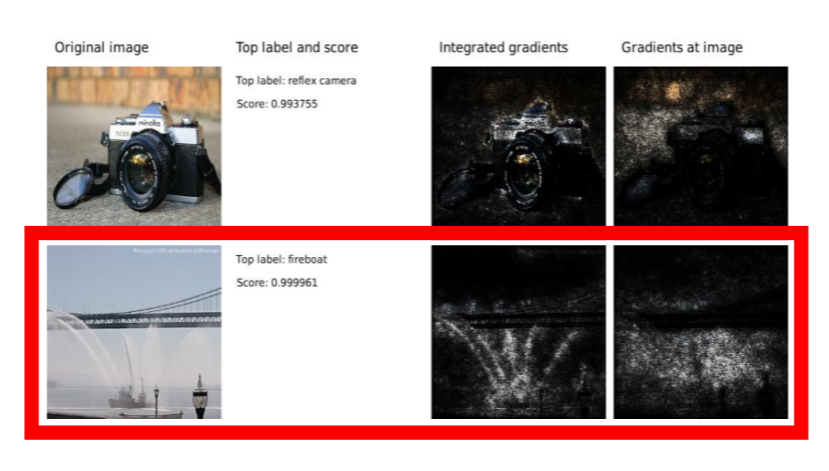
그리고 이런 문제 때문에
Gradient는 실제 중요한 특징보다
불필요한 특징에 집중하는 경우도 발생한다고 설명함.(하단 fireboat 참고)
DeepLift와 LRP의 경우,
DeepLift와 LRP(Layer-wise Relevance Propagation)는
Gradient 대신 Baseline과 Input 사이의 Discrete Gradient를 사용해서
Flat Region을 피하려고 했음.
그렇게, Sensitivity 문제는 어느 정도 해결했지만,
다른 공리인 Implementation Invariance를 만족하지 못했음.
2.2. Axiom: Implementation Invariance
Implementation Invariance란,
두 신경망이 모든 입력에 대해 동일한 출력(Function)을 생성한다면,
내부 구현 방식이 다르더라도
Attribution 결과 역시 동일해야 한다는 조건임.
만약
Network A->Output = 0.93Network B->Output = 0.93
이렇게 두 네트워크가 완전히 같은 함수를 구현한다면 Attribution도 동일해야 한다는 의미.
왜 Gradient는 이를 만족하는가
Gradient는 미분의 연쇄법칙(Chain Rule)을 따르기에,
중간 계산 과정이 어떻게 구현되어 있든
최종 입력에 대한 Gradient는 동일하게 계산됨.
그래서 Gradient는
Implementation Invariance를 만족함.
왜 DeepLift와 LRP는 위반하는가
DeepLift와LRP(Layer-wise Relevance Propagation)는
Gradient 대신 Discrete Gradient를 사용함.
다만, Discrete Gradient에는
Gradient처럼 Chain Rule이 일반적으로 성립하지 않음.그렇기에, 같은 함수를 구현하더라도
내부 구현 방식에 따라 Attribution 결과가 달라질 수 있음.
=> Implementation Invariance를 만족하지 못함.
그리고 논문에서는
같은 Function을 구현하는 두 모델이
초기값이나 학습 과정의 차이만으로
다른 Attribution을 생성하는 것은 바람직하지 않다고 설명함.
정리해 보자면
- 논문에서는 Attribution 방법이 만족해야 하는 두 가지 공리를 제안했음.
:Sensitivity,Implementation InvarianceSensitivity(a)는 출력을 변화시킨 Feature에는 반드시 0이 아닌 Attribution을 부여해야 한다는 조건.
Gradient는 Flat Region 문제 때문에 Sensitivity(a)를 만족하지 못함.DeepLift와LRP는 Baseline을 사용해서 Sensitivity 문제를 개선했지만,
Implementation Invariance를 만족하지 못함.
기존 Attribution 방법들은 최소 하나 이상의 공리를 위반하기에,
이를 해결하기 위해 이후 Integrated Gradients가 제안됨.
✅3. Our Method: Integrated Gradients
본 논문에서 제안한 Integrated Gradients(IG)는 직관적으로 봤을 때,
- Gradient가 가지는
Implementation Invariance- DeepLIFT나 LRP가 가지는
Sensitivity
를 함께 만족하도록 설계된 방법.
우선, 설명하고자 하는 딥러닝 모델을 이렇게 정의함.
- : 설명하고자 하는 딥러닝 모델
- : 실제 입력
- : Baseline 입력
+Baseline 예시
- 이미지 모델: 검은 이미지
- 텍스트 모델: Zero Embedding Vector
Integrated Gradients는 Baseline 에서 실제 입력 까지 이어지는 직선 경로(Straight-line Path)를 고려함.
그리고 이 경로 위의 모든 지점에서 Gradient를 계산하고, 이걸 누적함.
기존 Gradient 방법처럼 실제 입력 한 지점에서의 Gradient만 보는 게 아니라,
Baseline에서 실제 입력까지 변하는 전체 과정의 Gradient를 적분하는 것임.
Baseline과 Input 사이 경로
Baseline과 실제 입력 사이의 임의의 지점은 하단과 같음,
(이때, )
(α = Baseline에서 실제 입력까지 얼마나 이동했는지 나타내는 비율(parameter))
- 이면 Baseline
- 이면 실제 입력
- 이면 Baseline과 실제 입력 사이의 중간 지점
=> Integrated Gradients
: 각 지점에서의 Gradient를 모두 고려하는 방식.
Baseline
   ↓
중간 입력 1
   ↓
중간 입력 2
   ↓
...
   ↓
Actual Input
Integrated Gradients 정의
입력 와 Baseline 에 대해,
번째 특징의 Integrated Gradient는 아래와 같이 정의됨.
-
: Baseline에서 실제 입력까지 번째 특징이 변한 정도 -
: Baseline과 실제 입력 사이 지점 -
: Baseline에서 실제 입력까지 얼마나 이동했는지를 나타내는 비율
-
: 경로상의 해당 중간 지점에서 번째 특징에 대한 모델 출력의 Gradient -
: 를 0부터 1까지 변화시키면서 경로 전체의 Gradient를 누적하는 과정
입력 특징의 변화량에 Baseline부터 실제 입력까지의 평균적인 Gradient를 곱한 값으로 이해할 수 있음.
기존 Gradient와의 차이
기존 Gradient 기반 Attribution은 실제 입력 에서의 순간적인 Gradient만 사용함.
따라서 실제 입력 지점에서 함수가 Flat한 경우,
예측값이 Baseline과 크게 달라졌더라도 Gradient가 0이 될 수 있음.
반면 Integrated Gradients는
경로 전체의 Gradient를 누적하기 때문에, 중간 구간에서 발생한 출력 변화를 반영할 수 있음.
Axiom: Completeness
Integrated Gradients는 Completeness라는 공리를 만족함.
Completeness
: 모든 입력 특징의 Attribution을 더하면, 실제 입력과 Baseline 사이의 모델 출력 차이가 되어야 한다는 조건.
모델 출력이 Baseline에서 실제 입력으로 이동하며 변화한 전체 값을 각 입력 특징에 빠짐없이 분배한다는 의미.
Completeness는 왜 필요한가
Completeness는 Attribution 결과가 모델 출력의 변화 전체를 충분히 설명하고 있는지 확인하는 일종의 Sanity Check 역할을 함.
ex. 신용정보를 입력받아 보험료를 계산하는 모델에서
모델의 출력이 단순히 가장 높은 클래스를 선택하는 용도가 아니라 실제 숫자 자체로 사용된다면,
각 특징의 기여도를 모두 더했을 때 보험료의 전체 변화량과 일치하는 것이 바람직함.
Proposition 1
함수
가 거의 모든 지점에서 미분 가능하다면,
가 성립함.
이는 경로 적분에 대한 미적분학의 기본정리를 적용한 결과.
Baseline 출력이 0에 가까운 경우
대부분의 딥러닝 모델에서는 Baseline을 적절히 선택하면
이 되도록 만들 수 있음.
이미지 모델에서는 검은 이미지가 이러한 Baseline 역할을 할 수 있음.
이때 Completeness는 다음과 같이 근사됨.
따라서 Integrated Gradients는 모델의 최종 출력값을 각 입력 특징에 나누어 할당하는 방법으로 해석할 수 있음.
Completeness와 Sensitivity(a)의 관계
Integrated Gradients는 Completeness를 만족하기 때문에 Sensitivity(a)도 만족함.
Sensitivity(a)는 Baseline과 실제 입력이 오직 하나의 특징에서만 다르고, 그 결과 모델 출력이 달라지는 경우를 다룸.
이때 Completeness에 따르면
가 됨.
출력값이 서로 다르다면
이므로 해당 특징의 Attribution 역시 반드시 0이 아니게 됨.
즉,
Completeness는 Sensitivity(a)를 포함하는 더 강한 조건임.
정리해 보자면
- Integrated Gradients
: Gradient의Implementation Invariance와 DeepLIFT·LRP의Sensitivity를 결합하려는 방법.
- Baseline에서 실제 입력까지의 직선 경로 위에서 Gradient를 계산하고 이를 누적함.
- 실제 입력 한 지점의 Gradient만 보는 것이 아니라, 입력이 변화하는 전체 과정을 고려함.
- 각 feature의 IG는 해당 특징의 변화량과 경로 전체 Gradient의 적분으로 계산됨.- 모든 특징의 Attribution 합은 와 같으며, 이를
Completeness라고 함.Completeness는Sensitivity(a)보다 강한 조건이므로, IG는Sensitivity(a)를 만족함.
✅4. Uniqueness of Integrated Gradients
기존 Attribution 연구들은 대부분 실험(Empirical Evaluation)을 통해 방법의 성능을 평가했음.
ex. 이미지 분류에서는 Attribution 값이 높은 상위 k개의 픽셀을 선택한 뒤, 해당 픽셀을 무작위로 변경하고 모델의 출력이 얼마나 감소하는지를 측정하는 방법 사용.
좋은 Attribution 방법이라면 중요한 픽셀을 변경했을 때 모델의 출력이 크게 감소해야 함.
하지만 이러한 평가는 한계가 존재했음.
- 픽셀을 무작위로 변경하면 학습 과정에서 등장하지 않았던 비정상적인 이미지가 생성될 수 있음.
- 출력 감소가
Attribution 방법때문인지,데이터 변형(Perturbation)때문인지,모델 자체의 문제인지 구분하기 어려움.
그러면 다른 평가 방법은?
: 사람이 직접 그린 Bounding Box 내부에 Attribution이 얼마나 집중되는지를 측정하는 방식.
하지만 실제로는 객체뿐 아니라 주변 배경(Context)도 예측에 중요한 역할을 할 수 있으므로 항상 올바른 평가지표라고 보기 어려움.
★ 결국 논문에서는 이런 경험적 평가만으로 Attribution 방법의 우수성을 판단하기 어렵다고 보고, Section 2에서 제안한 것처럼 ★공리(Axiom) 기반 접근을 선택★했음.
4.1. Path Methods
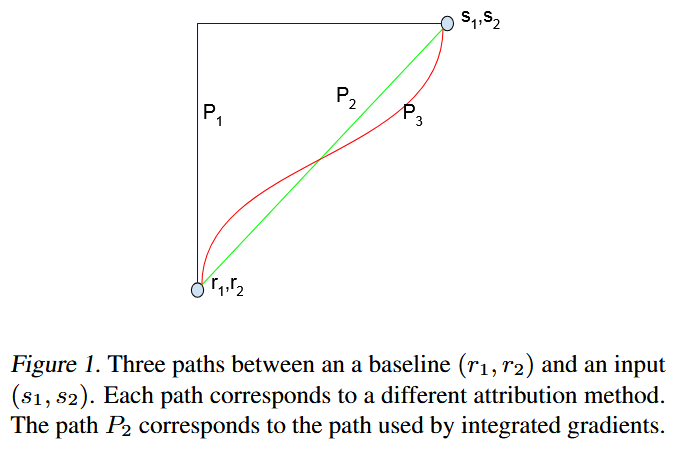
Integrated Gradients
: Baseline과 입력을 직선(Straight-line Path) 으로 연결한 뒤 그 경로를 따라 Gradient를 적분하는 방법.
+근데 반드시 직선일 필요는 없음.
Baseline과 입력을 연결하는 다른 곡선 경로를 사용할 수도 있으며, 이러한 모든 방법을 Path Methods라고 정의했음.
경로를 라고 하면,
, 을 만족해야 함.
- 시작점은 Baseline
- 끝점은 실제 입력
이어야 함.
Path Method의 Attribution은 다음과 같이 정의됨.
Integrated Gradients는
라는 직선 경로를 사용하는 특별한 경우임.
모든 Path Method는 다음 성질을 만족함.
Implementation InvarianceCompletenessSensitivity(a)
논문에서는 추가적으로 두 가지 공리를 정의함.
i) Axiom: Sensitivity(b)
어떤 입력 변수가 모델 출력에 전혀 영향을 주지 않는다면,
그 변수의 Attribution은 항상 0이어야 함.
영향이 없는 변수는 중요도도 없어야 함.
ii) Axiom: Linearity
두 모델 를 처럼 선형 결합했다면,
Attribution도
가 되어야 함.
모델의 선형성이 Attribution에도 그대로 유지되어야 함.
Proposition 2
Path Methods는 다음 네 가지 공리를 동시에 만족하는 유일한 Attribution 방법 계열임.
- Implementation Invariance
- Sensitivity(b)
- Linearity
- Completeness
Economics와의 연결
논문에서는 Path Integrated Gradients가 경제학의 Cost Sharing 문제에서 사용되던 방법과 동일한 수학적 구조를 가진다고 설명했음.
특히 Integrated Gradients는 경제학의 Aumann-Shapley 방법과 동일하다고 함.
4.2. Integrated Gradients is Symmetry-Preserving
Path Method는 여러 종류가 존재하지만,
왜 그중에서도 직선 경로(Straight-line Path) 를 사용하는 Integrated Gradients를 선택해야 하는지가 남은 문제임.
논문은 그 이유를 Symmetry-Preserving 성질로 설명했음.
Symmetric Variables
두 입력 변수를 서로 바꾸어도 모델 출력이 변하지 않는다면,
두 변수는Symmetric Variables라고 함.
예를 들어 이면
와 는 서로 대칭적인 변수라는 것.
Symmetry-Preserving
Baseline에서도 두 변수 값이 같고,
Input에서도 두 변수 값이 같다면,
두 변수의 Attribution 역시 동일해야 함.
ex. 에서는
과 가 완전히 같은 역할을 수행하므로,
두 변수의 Attribution 역시 동일해야 함.
Theorem 1
Integrated Gradients는
Symmetry-Preserving을 만족하는 유일한 Path Method임.
직선 경로를 사용하는 게 단순한 선택이 아니라,
대칭성을 보존하는 유일한 방법이라는 점을 수학적으로 증명했음.
Shapley-Shubik과 비교
논문에서는 Shapley-Shubik 방법도 소개함.
이 방법은 가능한 모든 입력 순서(n!개)에 대해 Attribution을 계산한 뒤 평균을 구함.
여러 경로를 평균내기에 다양한 관점을 반영할 수 있다는 게 장점이긴 하나,
Deep Learning에서는 문제가 있음.
- 계산량이 n!으로 매우 큼.
- 하나의 경로도 n번의 Forward가 필요함.
- 학습에서 보지 못한 비정상적인 입력 조합을 방문할 수 있음.
- Attribution Artifact가 발생할 가능성이 있음.
반면
Integrated Gradients는약 20~300회의 모델 호출만으로 안정적으로 Attribution을 계산할 수 있음.
정리해 보자면,
- 기존 Attribution 평가는 Perturbation 기반이라 신뢰성이 부족했음.
- 논문는
공리(Axiom)를 기반으로 Attribution 방법을 설계했음.Path Method: Baseline과 입력을 연결하는 모든 경로 기반 Attribution 방법을 의미.Integrated Gradients: 직선 경로를 사용하는 Path Method의 특수한 경우.Path Method: Implementation Invariance, Sensitivity(b), Linearity, Completeness를 동시에 만족하는 유일한 방법 계열임.- 그중에서도
Integrated Gradients는Symmetry-Preserving을 만족하는 "유일한 Path Method".
계산량도 매우 적어서 Deep Learning에 현실적으로 적용 가능함.
✅5. Applying Integrated Gradients
Selecting a Benchmark(baseline)
Integrated Gradients를 실제로 적용할 때 가장 중요한 과정 중 하나는 적절한 Baseline을 선택하는 것.
논문에서는 Baseline의 출력값이 0에 가까운(Near-zero score) 입력을 사용하는 것을 권장했음.
- 이렇게 하면 Attribution을 입력 자체의 기여도로 해석하기 쉬워짐.
- 하지만 단순히 출력값이 0에 가까운 것만으로는 충분하지 않음.
ex. 객체 인식 모델에서는 적대적 예제(Adversarial Example)를 이용해 특정 클래스의 출력값을 0으로 만들 수 있음.
근데 이런 입력을 Baseline으로 사용하면 Baseline 자체가 가지고 있는 특징이 Attribution에 포함될 수 있어 올바른 해석이 어려워짐.
따라서 좋은 Baseline은 단순히 낮은 출력을 갖는 것이 아니라,
입력 신호가 완전히 없는 상태(Absence of Signal) 를 표현해야 함.
ex.
이미지 모델에서는 검은 이미지(Black Image)텍스트 모델에서는 모든 입력 임베딩이 0인 벡터(All-zero Embedding)
를 Baseline으로 사용하는 것이 적절하다고 설명함.
이미지에서는 검은 이미지가 객체가 존재하지 않는 상태를 직관적으로 나타내고,
텍스트에서는 학습 과정에서 중요하지 않은 단어일수록 임베딩의 크기가 작아지는 경향이 있으므로,
모든 값이 0인 임베딩이 입력 신호가 없는 상태를 잘 표현함.
Computing Integrated Gradients
Integrated Gradients의 적분은 실제 구현에서 직접 계산하지 않고 리만 합(Riemann Sum) 으로 근사함.
리만 합(Riemann Sum)
: Baseline과 실제 입력 사이를 작은 구간으로 나눈 뒤,
각 지점에서 Gradient를 계산하여 모두 더하는 방식.
근사식은 다음과 같음.
- : 경로를 몇 개의 구간으로 나눌 것인지 결정하는 Step 수
(이 커질수록 적분값에 더욱 가까워짐.)
실제 구현에서는
for k in range(1, m+1):
    gradient 계산
과 같이 반복문으로 Gradient를 계산한 뒤 모두 더하면 됨.
TensorFlow에서는 tf.gradients를 반복 호출하거나 Batch 형태로 계산할 수 있다고 설명했음.
논문에서는 일반적으로 20~300 Step 정도면 실제 적분값을 약 5% 이내 오차로 근사할 수 있다고 보고했음.
또한 계산이 끝난 뒤에는
가 성립하는지 확인해서,
오차가 크다면 Step 수 을 증가시키는 것을 권장했음.
정리해 보자면,
- 좋은 Baseline은 단순히 출력이 낮은 입력이 아니라, 입력 신호가 완전히 없는 상태를 표현해야 함.
이미지에서는 검은 이미지,텍스트에서는 All-zero Embedding을 Baseline으로 사용하는 것이 적절.- IG의 적분은 실제 구현에서 리만 합으로 근사하여 계산함.
- Baseline과 입력 사이를 여러 구간으로 나누고 각 지점에서 Gradient를 계산하여 합산함.
- 일반적으로 20~300 Step이면 충분한 정확도를 얻을 수 있음.
- 계산 후에는 Completeness가 근사적으로 만족되는지 확인하여 Step 수를 조절하는 것이 좋음.
✅6. Applications
Integrated Gradients를 다양한 딥러닝 모델에 적용해서 Feature Attribution이 실제로 어떻게 활용될 수 있는지 확인했음.
실험 대상은 다음과 같음.
객체 인식(Object Recognition)당뇨망막병증 진단(Diabetic Retinopathy)질문 분류(Question Classification)기계 번역(Neural Machine Translation)화학 분자 예측(Chemistry Model)
6.1. An Object Recognition Network
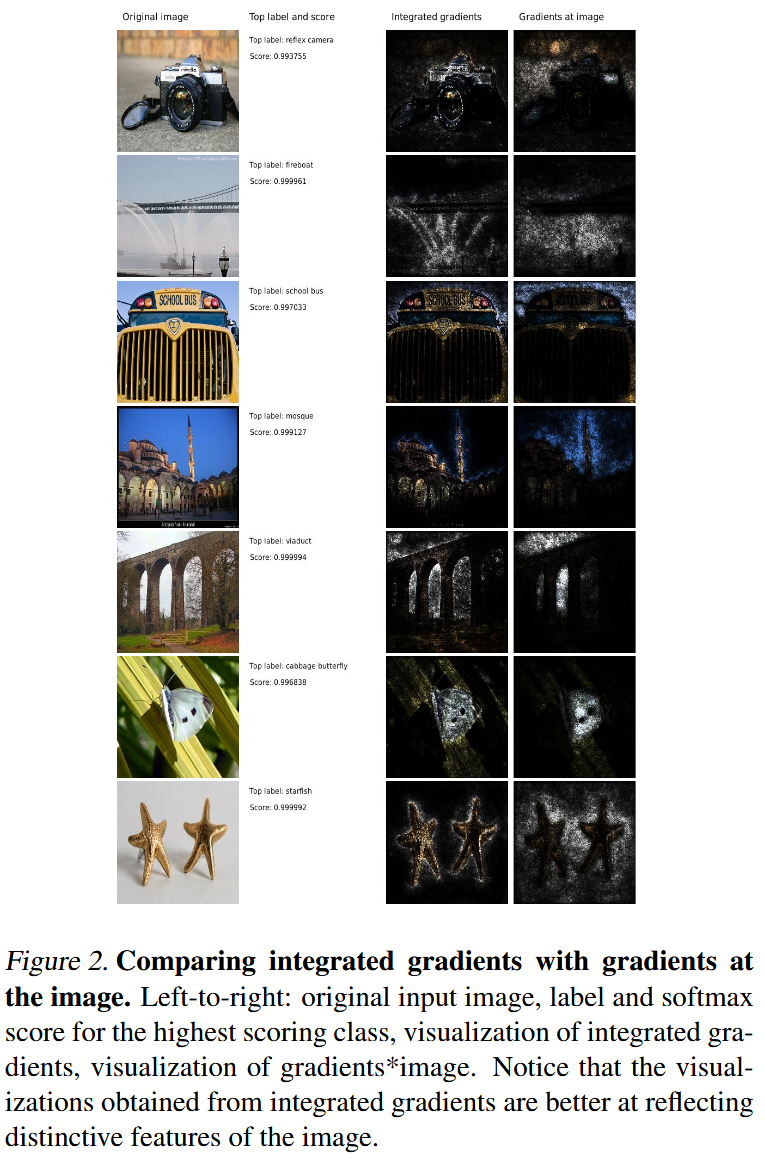
GoogleNet 기반 ImageNet 분류 모델에 Integrated Gradients를 적용했음.
- Baseline : 검은 이미지(Black Image)
- Attribution 대상 : 입력 이미지의 각 픽셀
각 픽셀의 Attribution을 RGB 채널 방향으로 합산한 뒤 원본 이미지 위에 시각화했음.
기존 Gradient × Input보다 Integrated Gradients가 객체의 특징적인 영역을 더욱 명확하게 강조하는 결과를 보였음.
6.2. Diabetic Retinopathy Prediction
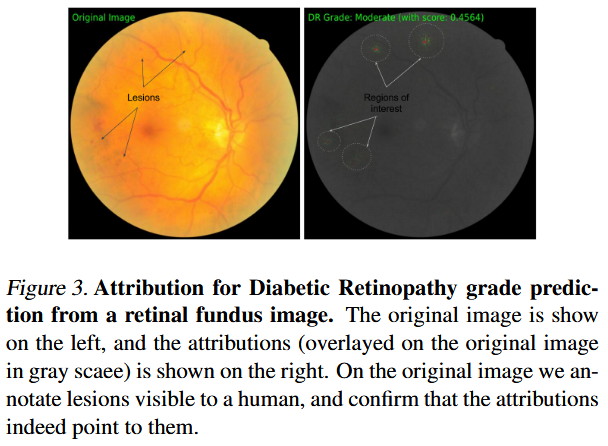
망막 사진으로 당뇨망막병증의 심각도를 예측하는 모델에 적용했음.
- Baseline: 검은 이미지
[의료 분야에서 Attribution이 중요한 이유]
- 의사가 모델을 신뢰할 수 있는 근거 제공
- 경계 사례(Borderline Case) 판정 지원
- 추가 검사 및 진단 방향 제시
시각화 결과,
Integrated Gradients는 병변(Lesion) 주변에 집중되었고,
병변 내부보다 경계(Boundary)에 높은 Attribution이 나타났음.
모델은 병변의 내부보다 경계를 중요한 특징으로 활용하고 있음을 확인했음.
6.3. Question Classification
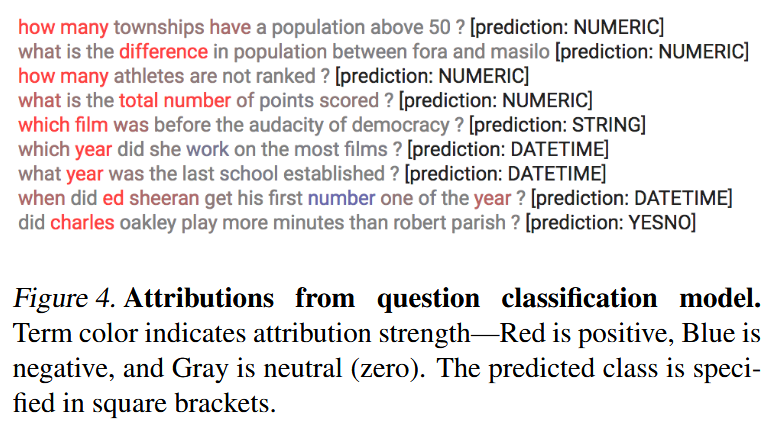
질문의 유형(예: 날짜, 숫자, Yes/No)을 분류하는 자연어 처리 모델에 적용했음.
- 모델 : Kim(2014) TextCNN
- 데이터셋 : WikiTableQuestions
- Baseline : All-zero Embedding
Integrated Gradients를 이용해 단어별 Attribution을 계산한 결과,
기존 규칙인
- "when" → 날짜 질문
- "how many" → 숫자 질문
뿐 아니라,
새로운 규칙인
- "total number" → 숫자 질문
도 발견할 수 있었음.
그리고
- "charles"
같이 데이터 편향으로 인해 잘못 학습된 규칙도 발견할 수 있었음.
6.4. Neural Machine Translation
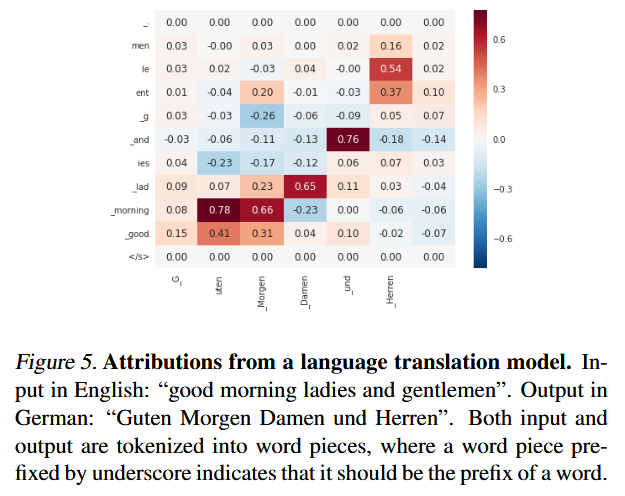
LSTM 기반 기계번역 모델에 적용했음.
출력 단어 하나마다
입력 단어 각각이 얼마나 기여했는지를 Attribution으로 계산했음.
- Baseline은 시작(Start)과 종료(End) 토큰을 제외한 모든 임베딩을 0으로 설정했음.
Attribution 결과는 입력 문장과 출력 문장을 자연스럽게 정렬(Alignment)하는 효과를 보였음.
ex.
- "and" → "und"
- "morning" → "morgen"
과 같이 올바른 대응 관계를 확인할 수 있었음.
LSTM은 비선형성이 크므로
약 100~1000 Step으로 IG를 근사했음.
6.5. Chemistry Models
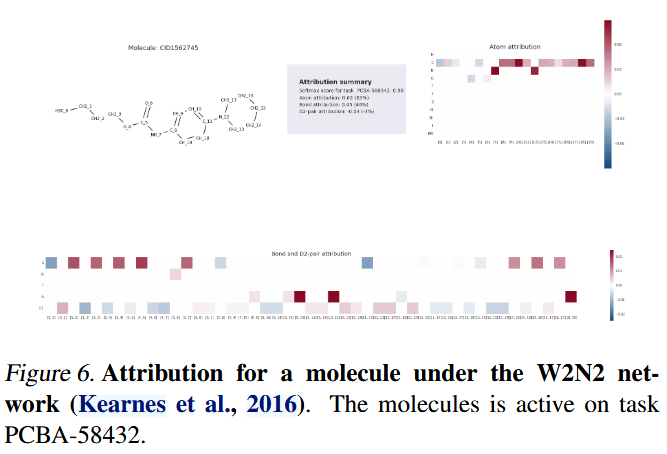
분자의 활성 여부를 예측하는 GCN(Graph Convolution Network)에 적용했음.
- Input:
-원자(Atom)
-원자쌍(Atom Pair)
특징으로 구성 - Baseline: 모든 Feature Vector를 0으로 설정.
Integrated Gradients를 Heatmap으로 시각화해서
각 원자와 결합이 예측에 얼마나 기여했는지를 확인했음.
-
특정 분자에서는
결합(Bond)을 가진 원자쌍이 전체 예측 점수의 약 46%를 기여한 반면,
그 외 원자쌍은 -3%만 기여했음. -
또한 Attribution 분석을 통해,
동일한 원자 유형이 모두 같은 Attribution을 받는 이상 현상을 발견했음. -
결과적으로,
기존 GCN 구조에서는 원자와 원자쌍 Feature가 충분히 Convolution되지 않아
같은 원자 종류와 같은 결합 개수를 가진 원자들이 동일하게 처리되는 구조적 문제가 존재했음을 확인했음.
Integrated Gradients는
설명 기법 + 모델 설계상의 결함(Degenerate Feature)까지 발견하는 도구로 활용될 수 있음을 보여주었음.
✅7. Other Related work
본 논문에서는 기존 Attribution 연구와 관련 연구들을 비교하며 Integrated Gradients의 차별성을 설명했음.
기존에는 주로 Computer Vision 분야에서
- 특정 뉴런이 무엇을 학습했는지
- 뉴런이 어떤 표현(Representation)을 학습했는지
를 분석하는 연구가 활발했음.
근데 Integrated Gradients는
특정 입력(Input)에 대해
각 입력 Feature가 예측에 얼마나 기여했는지를 분석하는 데 초점을 맞췄음.
LIME과 비교
논문에서는 LIME도 함께 비교했음.
LIME은 입력 주변(Local Region)의 모델 동작을 단순한 해석 가능한 모델로 근사하여 설명을 생성함.
[LIME 장점]
- 모델 구조와 무관하게 사용할 수 있음
- Implementation Invariance를 만족함.
[LIME 한계]
- Sensitivity 보장 불가.
- Flat Region에 머무르면 중요한 Feature를 찾지 못할 수 있음.
- 이미지처럼 입력 차원이 큰 경우 Region 샘플링과 추가 모델 학습이 필요해서 계산량이 매우 큼.
그치만 Integrated Gradients는
Gradient 계산만으로 Attribution을 구할 수 있어 훨씬 효율적!!
Attention과 비교
Attention Mechanism 역시 설명(Explanation)으로 사용할 수 있다는 의견이 있었음.
하지만 논문에서는
Attention만으로는 Attribution을 대체할 수 없다고 설명했음.
예를 들어 LSTM에서는 출력이
Memory CellHidden StateAttention
등 여러 경로를 통해 영향을 받음.
따라서 Attention만 분석하면 입력 Feature의 실제 영향력을 모두 설명하지 못함.
🔚8. Conclusion
본 논문에서ㅏ의 가장 큰 contribution은
Integrated Gradients라는
새로운 Attribution 방법을 제안한 것임.
Integrated Gradients
- Gradient 계산만으로 쉽게 구현 가능.
- 다양한 딥러닝 모델에 적용 가능.
- 강력한 이론적 근거(Axiomatic Framework)를 갖는 설명 기법.
- +경제학의 Cost Sharing 이론에서 착안한 공리(Axiom)를 이용해서 좋은 Attribution 방법이 만족해야 할 성질을 명확하게 정의함.
=> 데이터 자체의 문제, 모델 구조의 문제, Attribution 방법 자체의 문제를 구분해서 해석할 수 있는 기반을 마련했음.
다만, 본 논문에서는
Input Feature 간의 상호작용(Interaction)이나
모델이 실제로 어떤 논리(Logic)로 추론하는지는 설명하지 못했음.
입력 Feature의 중요도는 설명할 수 있지만,
딥러닝 모델의 전체 의사결정 과정을 완전히 이해하는 문제는 여전히 남아있는 연구 과제임.
정리해 보자면,
- 기존 연구는 뉴런이나 내부 표현을 분석하는 데 집중했음.
- 근데 Integrated Gradients는 입력 Feature의 중요도를 직접 설명하는 방법.
LIME보다 계산량이 적고 Sensitivity를 만족한다는 장점이 있음.- Attention은 설명의 일부일 뿐, 전체 Attribution을 대체할 수 없음.
- 본 논문의 primary contribution: Integrated Gradients와 공리 기반 Attribution Framework를 제안한 것.
그러나 Feature 간 상호작용과 모델의 추론 과정은 여전히 설명하지 못하는 한계 존재.
