Keras
home : https://keras.io/
한국어 home : https://keras.io/ko/
용어 정리
딥러닝 모델 : 딥러닝 훈련을 위한 신경망 구조
딥러닝 모델 종류
- 심층 신경망 ( DNN )
- 합성곱 신경망 ( CNN )
- 순환 신경망 ( RNN )
하이퍼 파라미터
- 딥러닝 모델을 구성하고 훈련할 때 미리 설정하는 파라미터
AI 모델
딥러닝 모델을 이용하여 데이터를 훈련한 결과를 저장한 모델모델 파라미터( 매개 변수 )
- 딥 러닝 모델을 훈련할 때 결정되는 파라미터
- 최적의 모델 파라미터( 매개 변수 )를 결정하는 과정이 훈련
- 최종적인 AI 모델이 가지고 있는 파라미터
딥러닝
- 딥러닝 모델을 훈련하여 최적의 모델 파라미터( 매개 변수 )를 갖는 AI 모델을 생성하는 과정
- 딥러닝 모델을 만들기 위한 고수준의 구성 요소를 제공하는 모델 수준의 추상화 라이브러리
- 텐서 조작이나 미분과 같은 저수준의 연산을 다루지 않는다.
- Keras의 백엔드 엔진( Backend Engine )에서 제공하는 최적화되고 특화된 텐서 라이브러리를 사용한다.
- Keras는 모듈 구조로 구성되어 있기 때문에 여러 백엔드 엔진과 매끄럽게 연동된다.
- Keras 백엔드 엔진으로는 Tensorflow, theano( 씨아노 ), CNTK, MXNet등이 있다.
- Tensorflow 2 버전 부터 Tensorflow와 Keras가 통합
딥 러닝을 통한 AI 모델 생성 과정
- 문제 정의
- 데이터 수집
- 데이터 전처리
- 데이터 이해(EDA)
Tensorflow(keras) 활용 단계
5. 훈련 데이터 결정(입력 데이터/레이블(정답) ) - 지도 학습
(훈련 데이터/검증 데이터/테스트 데이터 분리)
6. 딥러닝 모델 구성 (모델링) - 신경망 구성
7. 딥러닝 모델 훈련 -> 결과물은 AI 모델
8. AI 모델 평가
9. AI 모델을 활용한 예측 ( predict )/추론( inference )
Keras 이용 딥 러닝( 신경망 ) 모델 생성 과정
Sequential Model
- 순차적으로 신경망 모델 표현
- 심층 신경망( DNN ), 합성곱 신경망( CNN ), 순환 신경망( RNN )
Functional API Model
- 복잡한 신경망 모델 표현
- Seq2Seq, Attention, Transformer등
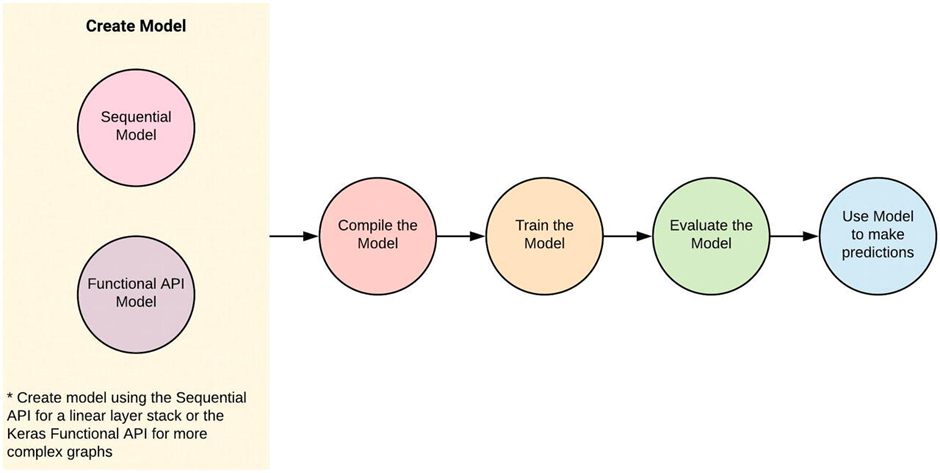
keras를 이용한 딥러닝 모델 생성 스크립트 구조 ( Sequential API )
1. 모델링( Modeling ) 단계 - 모델 생성
딥러닝(신경망) 모델 구조
입력층( Input Layer )
- 입력 데이터를 의미
- 입력층의 뉴런( Neuron )수는 입력 데이터의 특성 수에 따라 결정
은닉층( Hidden Layer )
- 실제 입력 데이터에 대한 패턴을 학습하는 층
- 은닉층의 뉴런 수는 임의로 결정 - 하이퍼 파라미터
- 은닉층은 여러 층으로 구성될 수 있다. - 하이퍼 파라미터
출력층( Output Layer )
- 문제 정의에 따라 뉴런 수 결정
- 모델종류
분류 모델
이진 분류 모델 - 뉴런 수는 1개
다중 클래스 분류 모델 - 뉴런 수는 클래스 수에 따라 결정
회귀 모델 - 뉴런 수는 1개
Sequential() 객체
tf.keras.Sequential(layers=None, name=None)
Sequential.add(layer)
계층을 구성하기 위한 모델 생성 객체. 객체를 생성 후 필요한 층(Layer)을 추가한다.
< 구현 예 >
 from tensorflow.keras.models import Sequential
 model = Sequential()
 model.add( … ) # 층( Layer ) 추가
 model.add( … ) # 층( Layer ) 추가
Dense() 객체
- 전결합층( Fully-Connected Layer )
모든 뉴런이 연결되어 있는 구조- 전결합층( Fully-Connected Layer ) 추가시 사용하는 객체.
model.add()메서드의 인수로 추가
Flatten() 객체
- 심층 신경망( DNN )은 항상 1차원 형태로 데이터 입력
- 2차원 구조의 데이터를 1차원 구조로 만들어주는 객체
- 실제 입력 데이터를 은닉층에 1차원 형태로 입력하기 위한 목적으로 사용하고 훈련에 참여하지는 않는다. 즉 모델 파라미터가 없다.
Embedding() 객체
- 자연어(NLP) 처리시 주로 사용
- 단어를 밀집 벡터로 만들어 Embedding layer를 만든다.
Embedding() 은 정수 인코딩이 된 단어에 대하여 임베딩 수행- https://keras.io/api/layers/core_layers/embedding/
워드 임베딩( Word embedding )
- 단어를 밀집 벡터( dense vector )로 만드는 작업 의미
- 워드 임베딩으로 부터 얻은 임베딩 벡터는 원-홧 벡터에 대하여 상대적으로 저차원을 가지으로 모든 원소의 값을 실수로 가지며, 단어의 유사도 정보를 가지게 된다.
- Embedding layer는 은닉층 시작전에 위치하고 임베딩 벡터를 생성하여 은닉층에 입력으로 사용
2. 컴파일( Compile ) 단계
compile() 메서드
Model.compile(
    optimizer="rmsprop",
    loss=None,
    metrics=None,
    loss_weights=None,
    weighted_metrics=None,
    run_eagerly=None,
    steps_per_execution=None,
    jit_compile=None,
    pss_evaluation_shards=0,
    **kwargs)
- 모델을 기계가 이해할 수 있도록 컴파일( binary로 변환 )
- 인수로 추가할 수 있는 내용
비용( 오차, 손실 ) 함수( loss ) - 오차 함수
최적화 방법( optimizer ) - 모델 파라미터 변경
metric 평가 방법( 훈련 평가 )
metric 평가 방법( 훈련 평가 )
- 회귀 모델
mse, mae( 오차 )- 분류 모델
accuracy( 정확도 )
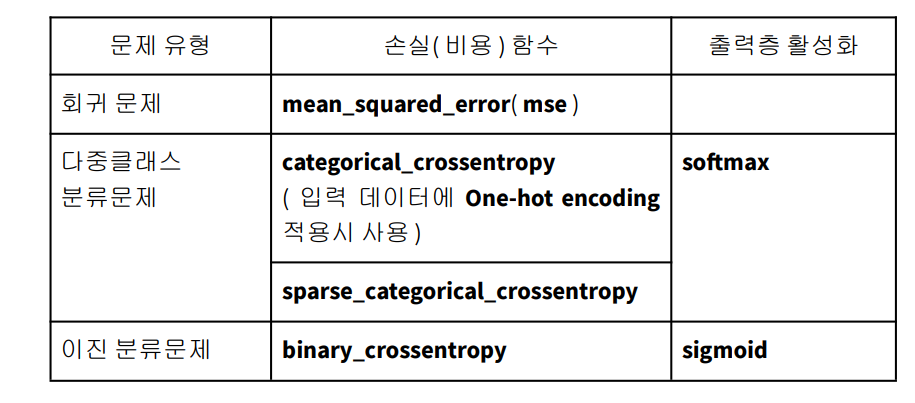
자연어를 학습에 사용할 때는 컴퓨터가 이해 할 수 있는 형태로 변환( encoding ) 해야 한다.
1. 자연어에 대한 vocabulary 생성
2. vocabulary 내용에 대하여 encoding 수행
encoding 종류
1. 정수 encoding - vocabulary의 단어를 순서대로 정수를 부여하는 방식
2. One-hot encoding - vocabulary의 단어수 만큼의 vector를 생성한 후 단어 위치에 1을 부여하고 나머지는 0을 부여하는 방식
sparse_categorical_crossentropy 사용 경우 - 정수형으로 인코딩 된 데이터를 학습하는 경우 사용
categorical_crossentropy 사용 경우 - One-hot 인코딩 된 데이터를 학습하는 경우 사용
3. 훈련( Training ) 단계
fit() 메서드
Model.fit(
    x=None,
    y=None,
    batch_size=None,
    epochs=1,
    verbose="auto",
    callbacks=None,
    validation_split=0.0,
    validation_data=None,
    shuffle=True,
    class_weight=None,
    sample_weight=None,
    initial_epoch=0,
    steps_per_epoch=None,
    validation_steps=None,
    validation_batch_size=None,
    validation_freq=1,
    max_queue_size=10,
    workers=1,
    use_multiprocessing=False,)
모델을 훈련한다
4. 평가(Evaluation) 및 예측(Prediction) 단계
evaluate() 메서드
Model.evaluate(
    x=None,
    y=None,
    batch_size=None,
    verbose="auto",
    sample_weight=None,
    steps=None,
    callbacks=None,
    max_queue_size=10,
    workers=1,
    use_multiprocessing=False,
    return_dict=False,
    **kwargs)
테스트 데이터를 통해 학습한 모델에 대한 평가
predict() 메서드
Model.predict(
    x,
    batch_size=None,
    verbose="auto",
    steps=None,
    callbacks=None,
    max_queue_size=10,
    workers=1,
    use_multiprocessing=False)
테스트 데이터 또는 임의의 데이터를 통한 모델의 결과 확인
5. 모델 저장( save ) 또는 로드( Load )
save() 메서드
Model.save(filepath, overwrite=True, save_format=None, **kwargs)모델을 hdf5 형식의 파일로 저장
load() 함수
tf.keras.saving.load_model(filepath, custom_objects=None,
compile=True, safe_mode=True, **kwargs)
저장된 모델을 메모리로 로드하여 적재