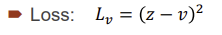24) Model-based RL
Model-Based and Model-Free RL
Model-free RL
모델이 없고 경험을 통한 value function을 배웁니다.𝐷→𝜋
Model-Based RL
경험 혹은 rules로 부터 model, 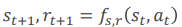 을 만듦.모델로 부터 가치함수를 plan합니다.
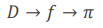
장점으로는 지도학습방법으로 env.를 효율적으로 학습할 수 있습니다. 또한, 모델의 변화(리워드 또는 다이나믹스)에 적응할 수 있습니다.
단점으로는 먼저 모델을 학습한 다음 가치 함수를 구성합니다.
이는 바로 ⇒ 근사 오차의 두 가지 원인이 됩니다.
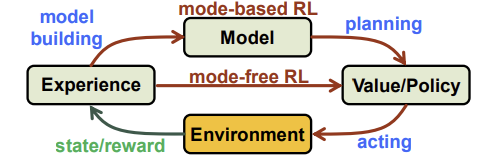
Model
순차적 의사결정 모델은 학습되거나 주어진 규칙에 의해 결정되는데, 모델은 transition model, reward model.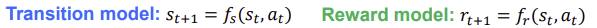
Model-based reinforcement learning basic으로는 1.base policy를 D를 모으기 위해 run
2.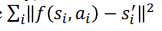 를 minimize하는 f(s,a)인 dynamics model을 learn합니다.
3.actions를 choose하기 위한 f(s,a)를 통해 plan합니다.
Planning
planning: 모델을 사용하여 정책을 만들거나 개선하는 모든 계산 프로세스를 진행합니다.
즉, model을 통해 policy를 planning
그리고 인공지능에서의 planning은 다음과 같습니다.
인공지능에서의 계획:
-state-space planning: 목표에 도달할 상태 찾기(예: forward search) 즉, states의 조합을 통해 goal에 도달하는 것입니다.
-plan-space planning: 계획의 공간(예: partial-order planner)을 탐색합니다.
-우리는 다음과 같은 (일반적이지 않은) 관점을 취합니다:
-모든 state-space planning에는 명시적 또는 암묵적으로 value 함수가 포함됩니다.
즉,value가 최대가 되도록 하여서 state-space planning
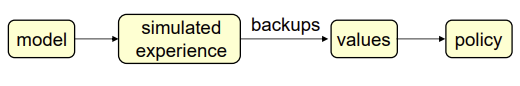
-이들은 모두 가상화된 환경에 백업을 적용합니다. 아래 그림에서 보이는 것과 같이 따라가며 즉, action-space q값을 따라가도록 합니다.
Model Learning
모델 M은 MDP<S,A,P,R>.그리고 이는 parameterized된 값 𝜂을 따라가며, 우리는 이를 통해 state space S, 그리고 action space A를 가정할 수 있습니다.
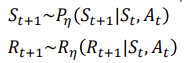
그리고 조건 독립을 통해 2개를 따로 learning할 수 있습니다.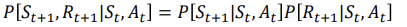
모델을 통해 만듦 (planning),그리고 이것은 supervised learning problem이며, 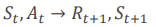 s,a->r은 regression problem이며 s,a->s'은 density estimation problem.그리고 mean-squared error혹은 KL divergence와 같은 loss function을 고릅니다.
Table Lookup Model Example
그 state로 많이 가는지를 찾습니다. 그리고 이러한 Models의 examples들로는 Table Lookup Model,Linear Expectation Mode,Linear Gaussian Model,Gaussian Process Model,Deep Belief Network Model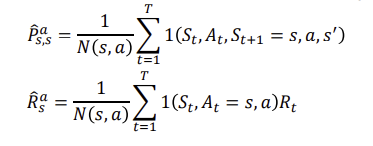
each time t마다 ,sample model마다 임의의 state에 왔을 때 randomly하게 고른다.
15가지 중 1가지 를 확률적 model로 고릅니다. A선행시 B로 와 같은 경험들을 통해 table을 만듭니다.
Sample-Based Planning
sample-based planning이란 만약 data가 작다면 tree그려서 진짜 maximum값을 구하기도 가능합니다. 즉 model을 sample혹은 tree를 생성하는 용도로만 사용합니다.
그리고 model-free RL을 samples들에 적용한 것들로 보면 MC,SARSA,Q-learning...등이 있습니다.
Integrating Learning and Planning
Real and Simulated Experience로는 Real experience와 Simulated experience와 같은 것들이 있으며 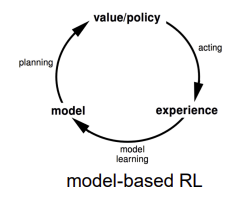
Dyna는 value/policy-><-experience의 과정은 model free하고, model->value/policy과정은 planning으로 update합니다.
Dyna-Q Algorithm
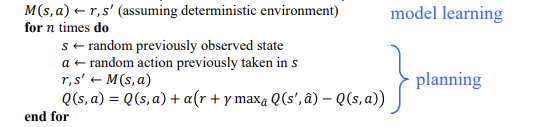
model이 준값으로 update.
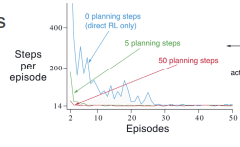
훨씬 빨리 배운다.
Landscape of Planning Methods
Planning은 언제하냐?를 봤을 때
1.decision할 시간이 되었을 때 계속->Continuous actions or Discrete action,
continuous는 다시 shooting과 collocation으로 나뉘는데 shooting은 끝까지 가보면서 total cost 어떤가 보는것, collocation은 현 state는 어떤 action을 취하는가로 볼 수 있습니다.
2.미리함->미리할 때는 Simulate Environment와 Assist Learning algorithm으로 나뉩니다.
Background vs Decision-time Planning
model-free RL은 점근 보상, 구축 시 계산에 좋습니다.
model-based RL은 데이터 효율성, 변화하는 보상/역학, 탐색에 적응하는 속도에 좋습니다.
Background vs Decision-time Planning
Background Planning과 Decision-Time planning으로 나뉘는데 Background Planning은 여러가지 상황에 대해서 추측할 때 쓰이며, Decision-Time planning은 딱히 learning을 하지 않고 계속 찾아가는 방식을 사용합니다. Background planning은 미리 구축해놓은 것이 있는 경우인 부분 관측 가능성, 빠른 계산에 좋으며 Decision-Time planning은 새로운 상황에 적응을 잘하며 부분적인 관찰 가능성을 사용합니다.
Simulation-Based Search
model을 가지고 model이 내주는 값으로 끝까지 가봅니다. 그 후,reward를 계산 합니다.
정보가 없는 검색의 경우에는 DFS와 BFS와 같은 방법으로 다 찾아봅니다.
Adversarial Search algorithm: Minimax for perfect information game
위와 가튼 방법의 대표 방법으로는 MC tree search,2명이서 하는 것으로 상황에 대한 판단이 100%로 observation이 완벽합니다. zero-sum game의 특성도 있습니다.
Monte-Carlo Simulation
왜냐하면 Minimax는 사용 가능한 모든 노드 탐색하기 때문입니다. MCTS는 불완전한 정보를 갖고 있고, option이 너무 많아서 non-deterministic game을 하기 때문입니다.
주어진 root state s0,완벽하지 않더라도 끝까지 가봅니다. 적당한 level을 만들고 이후로는 그냥 가보기만 해서 action을 선택합니다.
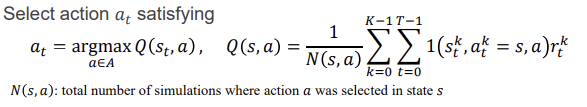
Monte-Carlo Tree Search
action을 취한 후 내려갈 떄 2개 중에 1개가 더 크다. 따라서 일단 더하고 그 방향 더 아래로 진행한다.
그리고 simulations을 하면서 best action을 select한다.
그리고 tree grows하면서 minimax에 가까워지는 nodes 중 values.
즉 MCTS 과정을 반복하면 실제 tree에서 tree policy(stored)된 것은 일부이며, default policy 는 끝까지 가보기만 하는 것입니다.
root s0로부터 simulations를 시작합니다. 그리고 가장 간단한 version으로 greedy MCTS를 선택하며 그에 대한 방법으로는 selection stage, expansion stage와 같은 방법이 있습니다.
그리고 mean outcome Q에 의해 모든 state와 action이 평가됩니다.
Applying Monte-Carlo Tree Search
1.Selection
value가 max가 되는 방향으로 node들을 택합니다.
2.Expansion
만약에 terminal node가 아니라면 하나 혹은 그 이상의 nodes들을 생성합니다.
3.Simulation(roll out)
random aciton으로 최종 결과를 도출해낸다. (win or lose)
4.Backpropagation
만약 탐험중 압도적확률이 높으면 break,그렇지 않으면 다가본다.
AI Agents for the Game of Go
AlphaGo, AlphaGo Zero, AlphaZero, MuZero와 같이 발전해나가며 각각의 특징이 있다.
AlphaGo Algorithm
선택에 대해 확신하는가?하는 것이며 이 뜻은 다른 의미로는 몇번가봤어?와 같은 것입니다. exploration이 잘 될 수 있도록 하는 것이며
To Play the Game using AlphaGo
AlphaGo Zero
개선사항:
- 단일 정책이 사용됨
- 정책 Net 및 Value Net은 동일한 기능 추출기( 𝑝, 𝑝)를 공유합니다
- 더 이상 지도 학습 없음
- 더 이상의 원격 설치 시뮬레이션 없음
Policy Net; p
-가중치는 무작위로 초기화됩니다.
-교차엔트로피 손실
-loss: 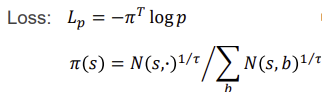
Value Net; v
-가중치는 무작위로 초기화됩니다.
-MSE
-