CSV 요약
왜 이 글을 쓰는가
로그라이크 전투에서 가장 위험한 순간은 버튼이 많아 보이지만 사실상 한 버튼만 누르면 되는 상태다. Attack만 누르거나 Skill만 눌러도 전투가 풀리면, 전투 선택지는 UI에만 존재하고 플레이어의 판단은 사라진다.
회귀자는 탑을 오른다도 이 위험이 있었다. 전투에는 Attack, Defend, Skill이 있었고, 마타이오스도 actor로 들어오기 시작했다. 하지만 "마타이오스가 언제 보호하고, 언제 공격을 돕고, 언제 스킬 타이밍을 보조해야 하는가"를 감으로 정하기에는 근거가 부족했다.
그래서 ML-Agents를 붙였다.
다만 중요한 전제가 있었다. ML-Agents를 본편 runtime AI로 넣으려는 게 아니었다. 본편 combat은 deterministic해야 하고, 같은 상태에서는 같은 결과가 나와야 한다. 그래서 ML-Agents는 shipped NPC brain이 아니라, 전투 설계의 취약점을 찾는 실험용 Combat Design Lab으로 분리했다.
결론부터 말하면, PPO를 더 오래 돌리는 것보다 전투 규칙과 context 설계를 고치는 게 먼저였다. 그리고 최종 handoff는 ONNX runtime 연결이 아니라 deterministic ContextPolicy였다.
실험실을 본편에서 분리했다
처음 세운 경계는 단순했다.
본편 runtime에는 RL을 넣지 않는다.
별도 TrainingCombat 환경에서만 학습한다.
PPO 결과는 설계 근거로만 사용한다.
본편에는 deterministic rule로 환원한다.
이 경계를 잡지 않으면 실험과 게임이 서로 망가진다. 본편은 안정적인 플레이와 QA가 필요하고, 실험 환경은 빠르게 규칙을 바꾸고 metric을 추가할 수 있어야 한다.
그래서 TrainingCombat은 본편의 HUD, save/load, node map, shop/event flow에서 분리된 전투 실험 장면으로 잡았다. 여기서 PPO agent와 baseline policy를 비교했다.
비교 대상은 다음과 같았다.
RandomPolicy
AttackSpamPolicy
SkillSpamPolicy
DefendHeavyPolicy
ContextPolicy
PPO Agent
baseline을 먼저 둔 이유는 간단하다. PPO 하나만 보면 학습이 된 것처럼 보일 수 있다. 하지만 AttackSpam이나 SkillSpam보다 못하면, 그건 좋은 전투 정책이 아니라 reward surface의 빈틈을 따라간 결과일 수 있다.
Experiment 01: 연결부터 확인했다
첫 실험의 목표는 학습 성능이 아니었다.
목표는 세 가지였다.
Unity executable과 Python trainer 연결
ML-Agents training loop 동작
ONNX export 확인
이 단계는 pipeline milestone이다. "좋은 agent가 나왔다"가 아니라 "이제 실험할 수 있는 연결이 생겼다"에 가깝다.
이 구분이 중요하다. 포트폴리오에서 ONNX export를 보여줄 수는 있지만, 그것만으로 게임 AI가 완성됐다고 말하면 안 된다.
Experiment 02: PPO가 SkillSpam과 구분되지 않았다
Exp02에서 처음으로 PPO와 spam baseline을 비교했다.
결과는 애매했다. PPO는 Random이나 AttackSpam보다 좋아 보였지만, SkillSpam과는 명확히 구분되지 않았다.
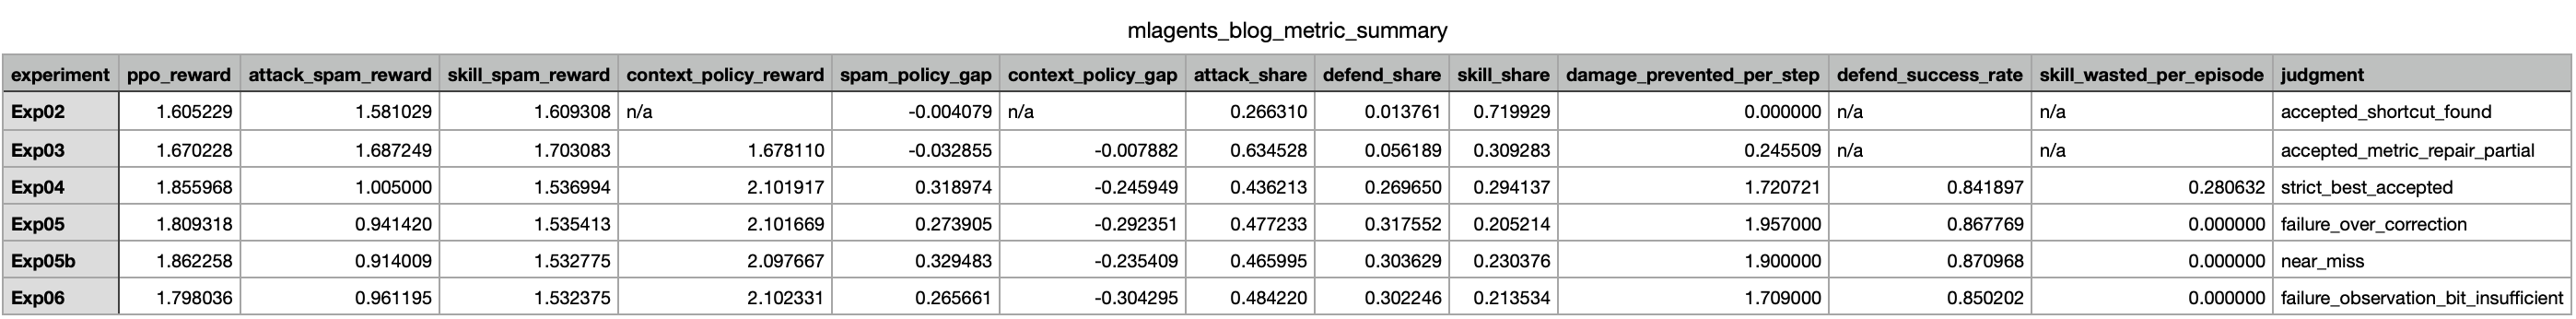
핵심 수치는 이렇다.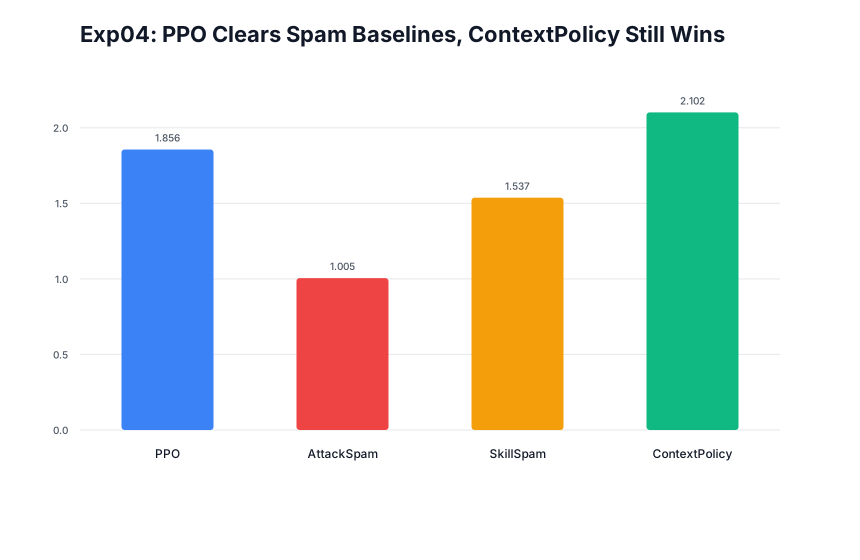
Policy Reward Win proxy Attack Defend Skill 해석
PPO10k 1.605229 1.000000 0.266310 0.013761 0.719929 Skill-heavy learned policy
AttackSpamPolicy 1.581029 1.000000 1.000000 0.000000 0.000000 공격 반복도 강함
SkillSpamPolicy 1.609308 1.000000 0.000000 0.000000 1.000000 Skill shortcut 노출
DefendHeavyPolicy -1.139359 0.003000 0.237230 0.762389 0.000381 Defend payoff 부족
PPO의 Skill share는 0.719929였다. 거의 Skill-heavy policy였다.
이건 실패처럼 보이지만, 실제로는 가장 좋은 발견 중 하나였다. 전투 구조가 Skill-heavy shortcut을 허용하고 있다는 걸 데이터로 확인했기 때문이다.
문제는 agent가 아니었다. 규칙이 그렇게 행동하도록 열려 있었다.
Experiment 03: 보상보다 metric이 먼저였다
다음 단계에서는 Skill spam을 줄이고 Defend를 살리려고 했다.
변경한 것은 크게 두 가지다.
Skill cooldown / cost 추가
Defend prevented-damage metric 추가
결과는 바로 보였다. PPO의 Skill share가 줄었다.
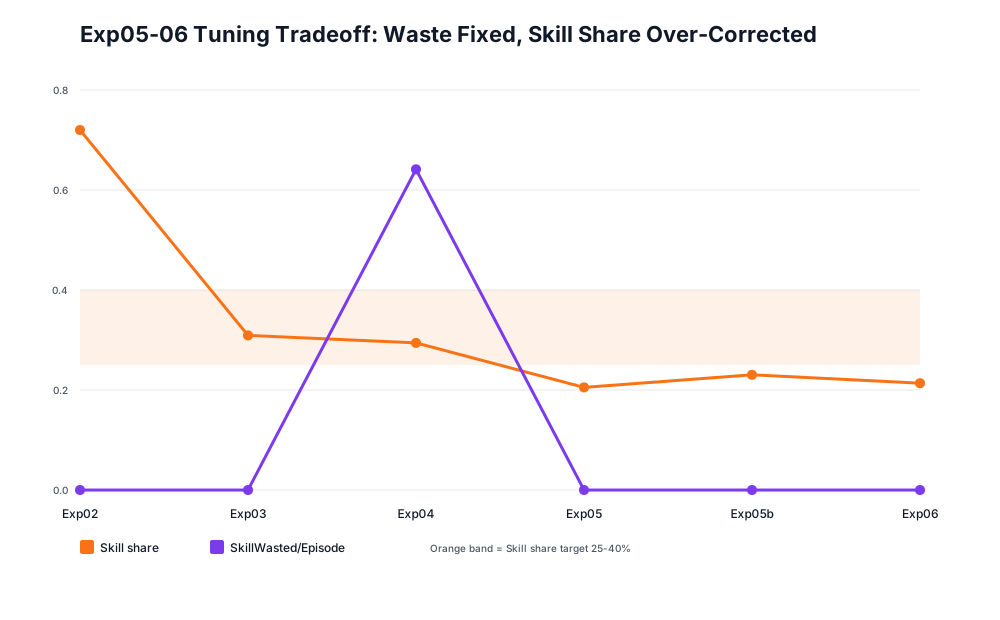
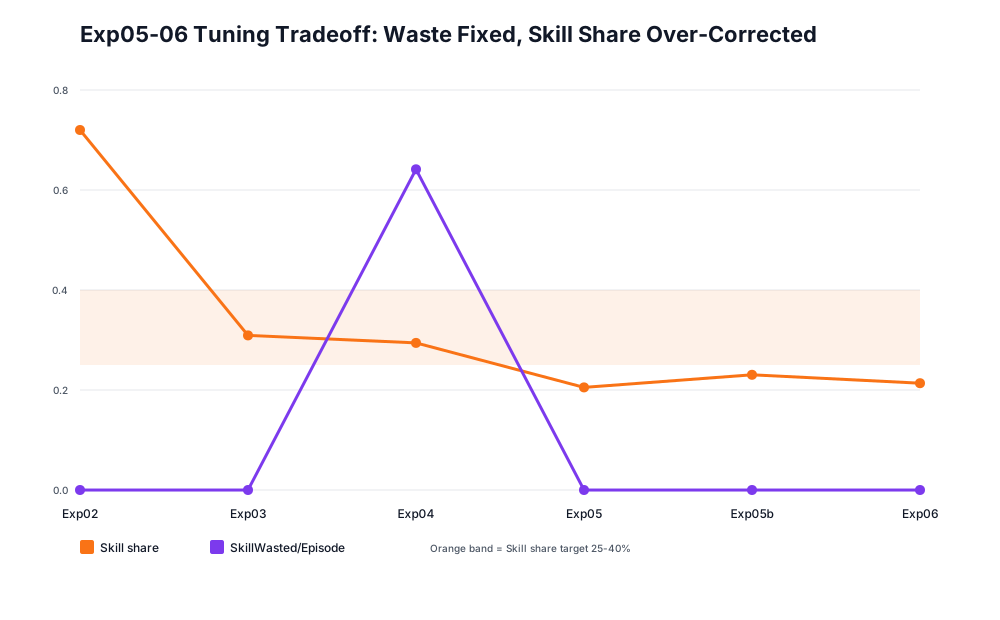
0.719929 → 0.309283
또한 방어가 실제로 피해를 막았는지 metric으로 드러나기 시작했다.
DamagePreventedPerStep: 0 → 0.245509
하지만 이것만으로 충분하지 않았다. SkillSpam과 AttackSpam은 여전히 강했고, PPO는 spam baseline을 명확히 이기지 못했다.
여기서 얻은 교훈은 단순하다.
학습을 더 오래 돌리기 전에,
전투 규칙이 좋은 선택을 구분할 수 있게 만들어야 한다.
Experiment 04: 규칙을 바꾸자 결과가 바뀌었다
Exp04에서는 reward만 만지지 않고 전투 규칙을 더 적극적으로 바꿨다.
변경 내용은 다음과 같다.
2턴 Skill cooldown
low-HP Skill waste penalty
high-threat enemy turn
Defend tempo attack payoff
ContextPolicy 강화
목표는 spam policy보다 나은 결과를 만드는 것이었다.
이번에는 변화가 있었다.
Policy Reward Win Attack Defend Skill DamagePrevented/Step SkillWasted/Ep
PPOExp04_10k 1.855968 0.988142 0.436213 0.269650 0.294137 1.720721 0.280632
AttackSpamPolicy 1.005000 0.785000 1.000000 0.000000 0.000000 0.000000 0.000000
SkillSpamPolicy 1.536994 1.000000 0.666667 0.000000 0.333333 0.000000 0.000000
ContextPolicy 2.101917 1.000000 0.438940 0.296159 0.264901 2.397086 0.000000
PPO reward는 가장 강한 spam baseline보다 +0.318974 높았다.
이제 PPO는 Attack, Defend, Skill을 모두 사용했다. Defend도 살아났고, Skill도 무작정 반복하지 않았다.
그런데 더 중요한 사실이 있었다. PPO보다 ContextPolicy가 더 좋았다.
ContextPolicy는 사람이 설계한 deterministic policy다. high-threat에서는 방어하고, 방어 성공 후에는 tempo attack으로 보상을 가져가고, Skill은 낭비되지 않을 때만 쓴다. PPO는 그 방향을 어느 정도 배웠지만, 10k 단계에서는 여전히 Skill waste가 남았다.
이 지점에서 결론이 정리됐다.
PPO는 좋은 설계 probe였다.
하지만 본편에 넣을 후보는 PPO가 아니라 ContextPolicy다.
Experiment 05~06: 더 돌리는 게 답은 아니었다
Exp04 이후에도 tuning을 더 해봤다.
Exp05에서는 Skill opportunity gate를 추가했다. Skill waste는 0으로 줄었지만, Skill share가 0.205214까지 내려갔다. 너무 보수적으로 변한 것이다.
Exp05b에서는 HP threshold를 12에서 10으로 완화했다. PPO reward와 SpamPolicyGap은 좋아졌지만, Skill share는 0.230376으로 여전히 목표에 조금 못 미쳤다.
Exp06에서는 Skill opportunity observation bit를 추가했다. 하지만 결과는 strict fail이었다.
PPO reward: 1.798036
Skill share: 0.213534
ContextPolicyGap: -0.304295
이 결과는 중요했다. 관측을 하나 더 넣고, tuning을 더 한다고 자동으로 좋은 정책이 나오는 게 아니었다.
그래서 여기서 멈췄다. 50k training이나 ONNX runtime 연결로 밀고 가지 않았다. Exp05~06은 성공으로 포장하지 않고 failure/near-miss evidence로 남겼다.
본편에는 어떻게 반영하나
실험 결과를 본편에 직접 RL로 넣지 않는다.
대신 ContextPolicy의 판단 구조를 deterministic Mataios combat brain으로 옮긴다.
예를 들면 이런 식이다.
상황 마타이오스 행동
enemy threat high protects
player low HP stabilizes
enemy vulnerable assists / finishes
repeated attack pattern pressure assist
defend success counter / tempo payoff
player Skill timing valid skill setup assist
본편 구조는 이렇게 잡힌다.
MataiosCombatContext
→ MataiosCombatBrain
→ MataiosActionPlan
여기에는 ONNX inference가 없다. runtime learning도 없다. 외부 API call도 없다. Affinity나 붕괴도 같은 narrative state를 전투 modifier로 쓰지도 않는다.
같은 state가 들어오면 같은 action이 나온다.
이게 이 프로젝트의 원칙과 맞다. ML-Agents는 AI NPC 자동화가 아니라, 전투 설계의 취약점을 찾고 더 나은 deterministic policy를 설계하기 위한 도구였다.그래서 포트폴리오는 아래와 같이 소개하고자 한다.
Unity ML-Agents를 활용해 로그라이크 전투를 별도 TrainingCombat 환경으로 분리하고,
PPO agent와 Random/AttackSpam/SkillSpam/DefendHeavy/ContextPolicy baseline을 비교했다.
실험을 통해 Skill-heavy shortcut과 Defend payoff 부재를 발견했고,
reward/metric repair 및 combat rule redesign을 거쳐 spam baseline을 넘는 PPO probe를 만들었다.
최종적으로는 PPO를 본편 runtime에 직접 연결하지 않고,
ContextPolicy의 설계 근거를 deterministic Mataios combat brain으로 환원하는 방향을 선택했다.
여기서 중요한 건 "강화학습을 했다"가 아니다.
강화학습을 실제 게임 제작 문제에 연결했다는 점이다. 수동 QA로 찾기 어려운 전투 설계 shortcut을 baseline과 PPO로 확인했고, 그 결과를 본편 설계로 되돌렸다.
배운 것
첫째, baseline 없이 PPO만 보면 착각하기 쉽다. PPO가 좋아 보여도 SkillSpam과 비슷하면 좋은 정책이라고 말할 수 없다.
둘째, reward를 고치기 전에 metric을 고쳐야 할 때가 있다. Defend가 의미 있는지 보려면 방어가 실제로 막은 피해가 metric으로 드러나야 한다.
셋째, 더 긴 학습이 항상 답은 아니다. Exp05~06은 오히려 context와 rule design이 먼저라는 사실을 보여줬다.
넷째, 실험 결과는 본편 결정이 아니라 설계 근거다. 본편은 deterministic policy로 유지하고, ML-Agents는 실험 도구로 분리하는 것이 맞았다.
마지막으로, 좋은 AI 포트폴리오는 모델 성능만 보여주는 게 아니라 문제 발견과 설계 개선 루프를 보여줘야 한다. 이 Combat Design Lab은 그 방향의 첫 증거다.
이 글은 개발 기록 기반 초안이다. PPO/ML-Agents는 본편 runtime AI로 연결하지 않았고, 실험 결과는 게임 규칙을 자동 확정하지 않는다.
