엘보우 기법과 실루엣 스코어를 활용한 K-means 최적 군집 개수 찾기
클러스터링에서 최적의 군집 개수(k)를 찾는 것은 중요한 문제임
- 대표적인 방법으로 엘보우 기법과 실루엣 스코어가 있음
- K-means를 활용하여 두 방법을 비교하고 최적의 k를 결정하는 과정 정리
1. K-means 군집화란
K-means는 비지도 학습 알고리즘으로 데이터를 k개의 클러스터로 나눔
- 각 데이터 포인트는 가장 가까운 클러스터 중심에 할당됨
- 수렴할 때까지 반복하여 최적의 클러스터를 형성
- 최적의 k를 찾기 위해 엘보우 기법과 실루엣 스코어 활용
2. 엘보우 기법 (Elbow Method)
개념
엘보우 기법은 WCSS(Within-Cluster Sum of Squares, 군집 내 분산)를 기준으로 최적의 k를 찾는 방법임
- k가 증가할수록 WCSS 값이 감소함
- 감소율이 급격히 줄어드는 "엘보우 포인트"를 최적의 k로 선택
코드
import numpy as np
import matplotlib.pyplot as plt
from sklearn.datasets import load_iris
from sklearn.cluster import KMeans
from yellowbrick.cluster import KElbowVisualizer

iris = load_iris()
X = iris.data

kmeans = KMeans(random_state=42)
plt.figure(figsize=(12, 6))
elbow_kmeans = KElbowVisualizer(kmeans, k=(1, 11))
elbow_kmeans.fit(X)
elbow_kmeans.show()
결과 (Elbow Plot)
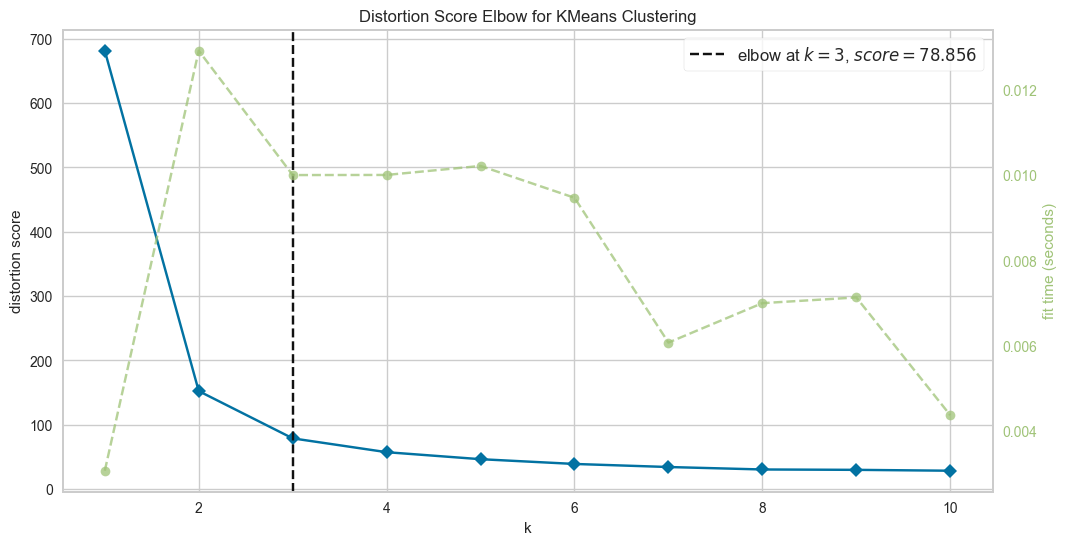
그래프에서 k=3에서 WCSS 감소율이 급격히 줄어드는 것을 확인할 수 있음
- 최적의 k는 3으로 선택됨
3. 실루엣 스코어 (Silhouette Score)
개념
실루엣 스코어는 클러스터링 품질을 평가하는 지표임
- 데이터가 자신의 클러스터 내에서는 가깝고, 다른 클러스터와는 멀리 떨어져 있어야 이상적임
- 점수 범위: -1 ~ 1
- 1에 가까울수록 클러스터가 잘 분리됨
- 0이면 애매한 상태
- -1이면 잘못된 클러스터링
코드
from sklearn.metrics import silhouette_score

silhouette_scores = []
for k in range(2, 11):
    kmeans = KMeans(n_clusters=k, random_state=42)
    kmeans.fit(X)
    score = silhouette_score(X, kmeans.labels_)
    silhouette_scores.append(score)

plt.figure(figsize=(12, 6))
plt.plot(range(2, 11), silhouette_scores, marker='o', linestyle='--', color='b')
plt.title('Silhouette Score for Different k values')
plt.xlabel('Number of Clusters (k)')
plt.ylabel('Silhouette Score')
plt.grid(True)
plt.show()
결과 (Silhouette Score Plot)
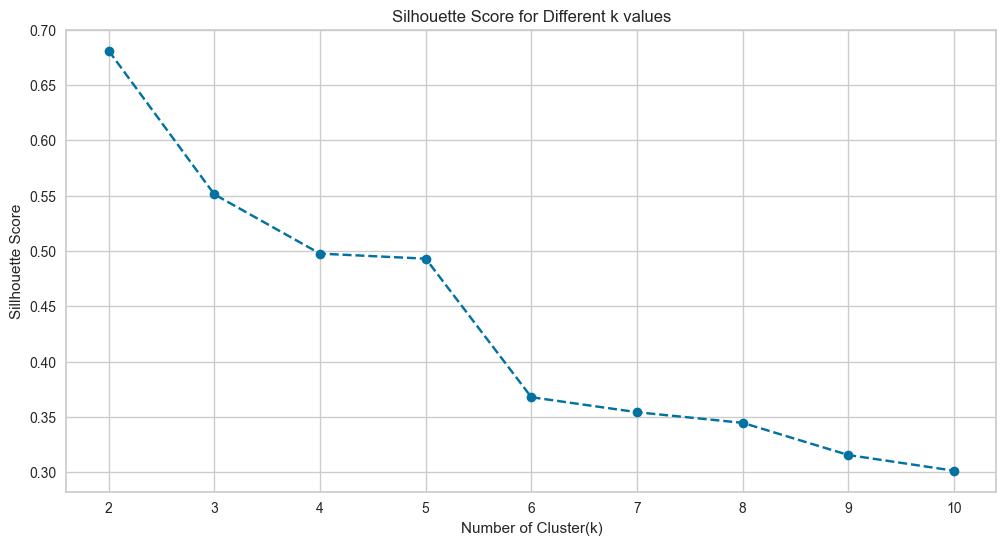
그래프에서 k=2일 때 실루엣 점수가 가장 높고, 이후 감소하는 경향을 보임
- k=3도 비교적 높은 실루엣 점수를 보임
4. 엘보우 기법 vs 실루엣 스코어 비교
| 엘보우 기법 | 실루엣 스코어 | |
|---|---|---|
| 기준 | WCSS(군집 내 분산) | 데이터 분포 기반 평가 |
| 목적 | 급격한 감소 구간 찾기 | 클러스터 품질 평가 |
| 단점 | 엘보우 포인트가 모호할 수 있음 | 계산량이 많음 |
| 결과 해석 | 그래프의 "꺾이는 지점" 찾기 | 점수가 가장 높은 k 선택 |
5. 결론
엘보우 기법에서는 k=3이 최적의 군집 개수로 선택됨
- 실루엣 스코어에서도 k=2 또는 k=3이 높은 점수를 보임
- 두 방법을 종합적으로 고려할 때 k=3이 최적의 군집 개수로 판단됨
K-means 클러스터링에서 최적의 k를 찾는 것은 중요한 과정임
- 엘보우 기법은 WCSS 감소율을 기반으로 k를 결정함
- 실루엣 스코어는 클러스터 품질을 평가하여 최적의 k를 찾음
- 두 가지 방법을 함께 사용하여 최적의 k를 결정하는 것이 바람직함
참고 자료
- Scikit-learn 공식 문서: https://scikit-learn.org/
- Yellowbrick 공식 문서: https://www.scikit-yb.org/en/latest/
gpt로 다시 배우는 개발