안녕하세요, 미니지식공간입니다.
grok-4.7은 모델 문자열만 바꿔도 호출이 되지만, 그대로 두면 안 되는 설정이 세 가지 있다. Grok 4.7 전환에서 실제로 비용과 동작을 가르는 것은 200K 롱 컨텍스트 요율, prompt_cache_key, 그리고 Responses API가 항상 돌려주는 암호화된 추론 아이템이다.
결론부터
- SpaceXAI가 2026년 9월 21일 Grok 4.7을 공개했다. 모델 문자열
grok-4.7, 컨텍스트 500,000 토큰, 지식 컷오프 2026년 5월이다. - 표시 요율은 Grok 4.6과 동일하다. 다만 프롬프트가 200k 토큰에 도달하면 그 요청의 모든 토큰에 롱 컨텍스트 요율이 붙어 단가가 2배가 된다.
- Responses API는
include에 명시하지 않아도reasoning.encrypted_content를 항상 반환한다. 멀티턴에서 추론 아이템을 그대로 되돌려 보내는 것이 기본 사용법이 됐다.
1. 최소 요청과 추론 강도
공식 문서가 제시하는 최소 형태부터 본다. 아래 스니펫은 Grok 4.7 문서의 "Using the API" 예제를 그대로 옮긴 것이다.
import os
from xai_sdk import Client
from xai_sdk.chat import user

client = Client(api_key=os.getenv("XAI_API_KEY"))

chat = client.chat.create(model="grok-4.7")
chat.append(user("Find and fix the bug, then explain it: function median(a){a.sort();return a[a.length/2]}"))

response = chat.sample()
print(response.content)
OpenAI 호환 경로를 쓰고 있다면 baseURL만 xAI로 돌리면 된다. 이것도 문서의 원문 예제다.
import OpenAI from 'openai';

const client = new OpenAI({
  apiKey: process.env.XAI_API_KEY,
  baseURL: 'https://api.x.ai/v1',
});

const response = await client.responses.create({
  model: 'grok-4.7',
  input: [
    {
      role: 'user',
      content: 'Find and fix the bug, then explain it: function median(a){a.sort();return a[a.length/2]}',
    },
  ],
});

console.log(response.output_text);
추론 강도는 low / medium / high / xhigh 네 단계이고 기본값은 high다. xhigh는 이번 발표의 벤치마크 측정에 쓰인 설정이기도 하다. 기본값이 이미 high이므로, 이전 모델에서 옮겨오면서 아무것도 지정하지 않으면 추론 토큰이 예상보다 많이 나올 수 있다.
2. 요율표: 200k에서 꺾인다
공식 가격 문서 기준이다. 단위는 100만 토큰당 USD.
| 프롬프트 크기 | 입력 | 캐시 입력 | 출력 |
|---|---|---|---|
| 200k 미만 | $2.00 | $0.50 | $6.00 |
| 200k 이상 | $4.00 | $1.00 | $12.00 |
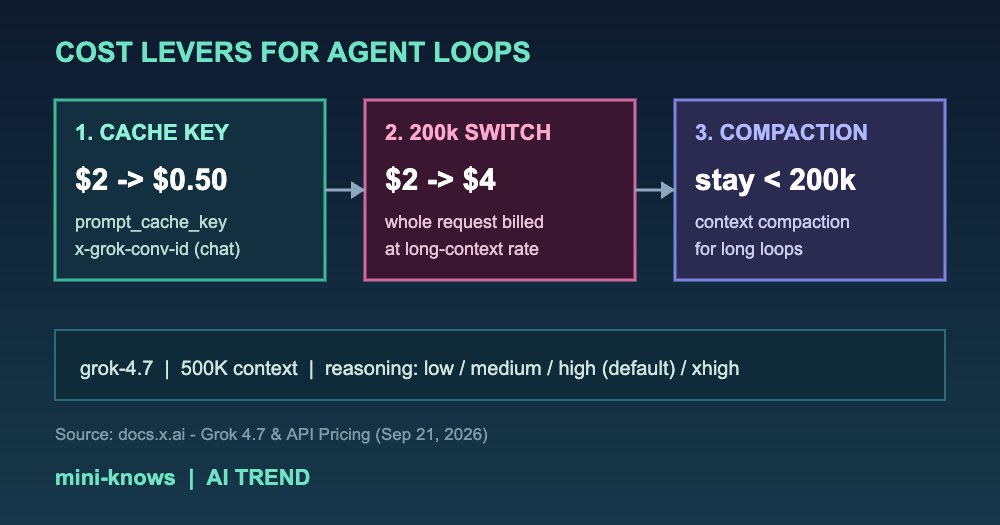
문서의 표현이 중요하다. "롱 컨텍스트 가격이 있는 모델은 프롬프트가 임계값에 도달하면 요청 안의 모든 토큰에 롱 컨텍스트 요율을 청구한다." 초과분 누진이 아니라 요청 단위 스위치다. 199,000 토큰 요청과 201,000 토큰 요청의 비용 차이는 토큰 2,000개가 아니라 2배다.
여기에 배수 두 개가 더 얹힌다.
- US 리전 엔드포인트(
https://us.api.x.ai/v1): 모든 토큰 항목에 1.1배. grok-4.7 기준 $2.20 / $0.55 / $6.60(200k 미만), $4.40 / $1.10 / $13.20(200k 이상). - Priority Processing: 표준 요율의 2배. 응답이
"service_tier": "priority"로 확인될 때만 청구된다. 기본 티어로 서빙되면 표준가다.
Grok 4.7 Fast는 배수가 아니라 별도 경로로 봐야 한다. 같은 모델을 빠른 인프라에서 서빙하고 요율은 2배인데, 공개 xAI API에서는 제공되지 않는다. Cursor와 Grok Build 전용이며 Grok Build 무료 등급에서도 제외다.
3. prompt_cache_key는 선택이 아니다
문서가 굵게 강조하는 항목이다. Responses API는 prompt_cache_key를, Chat Completions는 x-grok-conv-id 헤더를 설정하라고 안내한다. 이유는 라우팅이다. 같은 대화의 요청을 같은 서버로 보내야 캐시 적중이 안정적으로 나오고, 설정하지 않으면 캐시가 식은 서버에 붙어 전체 입력가를 그대로 내는 경우가 잦다고 문서가 직접 적었다.
캐시 입력 단가가 $0.50이고 일반 입력이 $2이니 적중 여부가 입력 비용을 4분의 1로 줄인다. 200k를 넘는 구간에서는 $1 대 $4로 격차가 그대로 유지된다. 에이전트 루프처럼 같은 접두부를 반복해서 싣는 구조라면 이 키 하나가 월 청구서를 바꾼다.
긴 루프에는 컨텍스트 압축(context compaction)을 함께 쓰라는 권고도 붙어 있다. 500k 컨텍스트를 계속 채워 돌리는 구조를 전제하지 않는다는 뜻이다. 결국 컨텍스트 관리는 품질 튜닝이 아니라 200k 경계를 넘지 않게 유지하는 원가 작업이 된다.
4. 암호화된 추론은 항상 돌아온다
Responses API에서 POST /v1/responses의 grok-4.7 응답은 include에 나열하지 않아도 reasoning.encrypted_content를 항상 포함한다. 문서는 다음 요청의 input에 추론 아이템을 변경 없이 그대로 되돌려 보내라고 안내한다. 그렇게 하면 추론 내용을 노출하지 않으면서 멀티턴 대화가 모델의 추론 상태를 유지한다. Chat Completions는 변경 없다.
실무에서 걸리는 지점은 여기다. 응답 아이템을 직접 골라 담아 히스토리를 재조립하는 래퍼가 있다면, 추론 아이템을 버리거나 필드를 손대는 순간 상태가 끊긴다. logprobs와 top_logprobs도 grok-4.20 이후 모델에서는 조용히 무시되므로, 이 값을 읽던 코드가 있다면 동작을 다시 확인해야 한다. 암호화된 추론 트랜스크립트를 둘러싼 논의는 이전에 정리한 Claude Fable 5.1 전환 점검 글의 반증류 항목과 같은 맥락에 있다.
5. 도구 과금이 같은 날 바뀌었다
모델 발표와 함께 X Search 과금 방식이 변경됐다. 2026년 9월 21일 오후 12시(미국 태평양시)부터다.
| 구분 | 이전 | 변경 후 |
|---|---|---|
| X Search | 호출 1k건당 $5 | 게시물 1k건당 $5 + 프로필 1k건당 $10 |
| Web Search | 호출 1k건당 $5 | 변경 없음 |
| Code Execution | 호출 1k건당 $5 | 변경 없음 |
| File Attachments | 호출 1k건당 $10 | 변경 없음 |
| Collections Search | 호출 1k건당 $2.50 | 변경 없음 |
집계 기준이 호출 수에서 반환 건수로 바뀐 것이 핵심이다. 문서는 검색이나 스레드 조회로 반환된 모든 게시물이 집계 대상이며 부모 게시물과 인용 게시물도 포함된다고 명시한다. 호출 1건이 스레드 하나를 통째로 끌어오면 그 안의 게시물이 전부 계산된다. 검색 쿼리를 넓게 잡아둔 에이전트는 여기서 비용이 튄다.
6. 벤치마크는 설정이 다르다
전부 SpaceXAI 자사 발표값이고, 독립 검증 결과가 아니다. 회사는 Grok 4.7을 xhigh, Grok 4.6을 high로 측정했다고 표에 표기했다.
| 벤치마크 | Grok 4.7 (xhigh) | Grok 4.6 (high) | GPT-5.6 Sol (max) | Fable 5.1 (max) |
|---|---|---|---|---|
| CursorBench 4.0 | 46.3% | 40.4% | 41.7% | 51.8% |
| DeepSWE v1.1 | 71.0%* | 65.2% | 72.7% | 70.0% |
| Terminal-Bench 4.0 | 38.0% | 20.3% | 37.3% | 57.9% |
| EEBench | 64.0% | 53.0% | 39.4% | 56.4% |
| AA Briefcase v1.1 | 1,657 | 1,546 | 1,487 | 1,678 |
| Harvey Legal Agent | 19.6% | 15.8% | 2.5% | 6.7% |
| HealthBench Professional | 56.7% | 48.5% | 60.5% | 62.1% |
* DeepSWE v1.1의 Grok 4.7 점수는 high 강도 측정값이라고 회사가 각주로 표기했다.
읽을 때 단서 세 가지. 첫째, 추론 강도가 모델마다 다르므로 동일 조건 비교가 아니다. 둘째, 코딩·터미널 축에서는 Claude Fable 5.1이 앞서고, 전기공학·법률 같은 전문 영역에서는 Grok 4.7이 앞선다. 셋째, 회사가 내세우는 것은 절대 점수가 아니라 가격 대비 성능이다. GPT-5.6 Sol 대비 입력 절반·출력 3분의 1, Claude Fable 5.1 대비 입력 5분의 1·출력 12분의 1이라는 단가 차이가 그 주장의 근거다. GDPval Elo에서는 Fable 5.1(max) 1,735 > Grok 4.7(xhigh) 1,695 > Grok 4.6(high) 1,605 > GPT-6 Astra(max) 1,542 순이었다. GPT-6 Astra 쪽 요율 구조는 별도 글에 정리해 두었다.
에이전트에서 의미 있는 지표는 결국 과제당 비용이다. 추론을 많이 쓰더라도 재시도 없이 끝내는 모델이 최종 비용은 낮을 수 있고, 긴 컨텍스트를 반복 적재하다 후반에 실패하는 구조는 반대 결과를 낸다. usage를 찍어 완료율·재시도·토큰 소비를 같이 보는 편이 벤치마크 점수보다 정확하다.
자주 묻는 질문
Q. grok-4.7로 문자열만 바꾸면 기존 코드가 그대로 동작하나?
대체로 동작한다. 다만 Responses API 응답에 암호화된 추론 아이템이 항상 포함되므로 히스토리를 재조립하는 코드는 확인해야 하고, logprobs·top_logprobs는 무시된다. 툴 사용이 많다면 prompt_cache_key 설정을 함께 넣는 것이 좋다.
Q. 500k 컨텍스트를 그대로 쓰면 비용이 선형으로 늘어나나?
아니다. 프롬프트가 200k에 도달하면 요청 전체에 롱 컨텍스트 요율이 적용돼 입력·캐시·출력 단가가 모두 2배가 된다. 임계값 근처에서 단가가 꺾인다.
Q. Grok 4.7 Fast를 API로 쓸 수 있나?
쓸 수 없다. 공식 문서는 Fast 변형이 Cursor와 Grok Build에서만 제공되며 공개 xAI API에서는 제공되지 않는다고 명시한다. Grok Build 무료 등급에도 포함되지 않는다.
마무리
Grok 4.7 전환에서 코드 변경량 자체는 작다. 실제 작업은 프롬프트 길이 분포를 찍어 200k 경계를 얼마나 넘는지 확인하고, prompt_cache_key를 붙이고, X Search 반환 건수를 다시 추정하는 쪽이다. 표시 단가가 그대로라는 점 때문에 오히려 이 세 가지를 건너뛰기 쉽다.
출처
- SpaceXAI, Introducing Grok 4.7 (2026-09-21)
- SpaceXAI Docs, Grok 4.7 (2026-09-21 갱신)
- SpaceXAI Docs, API Pricing (2026-09-21 갱신)
- SpaceXAI Docs, Models (2026-09-21 갱신)
- Data Studios, xAI launches Grok 4.7 (2026-09-21)
본 글은 공개 자료를 바탕으로 정리했으며, 세부 내용·수치는 원 출처·공식 문서와 대조 확인을 권장합니다. 본문의 성능·안전성 수치는 별도 표기가 없는 한 SpaceXAI 자사 발표이며 독립 검증 결과가 아닙니다.