https://arxiv.org/pdf/1711.00937
Continuous latent 대신 discrete latent를 사용하면 어떨까?
VQ-VAE는 Vector Quantization을 이용해 데이터를 discrete code로 표현하고, 이를 통해 의미 있는 high-level representation을 학습한다.
1. VQ-VAE는 왜 등장했을까?
Generative model의 목표 중 하나는 단순히 데이터를 잘 생성하는 것을 넘어, 입력 데이터로부터 유용한 representation을 학습하는 것이다.
예를 들어 이미지라면 모든 pixel 값을 그대로 기억하는 것보다,
- 어떤 object가 있는지
- 전체적인 scene structure가 어떤지
와 같은 정보가 더 유용할 수 있다.
음성에서도 마찬가지다. 원본 waveform의 아주 세세한 변화보다는
- 어떤 phoneme인지
- 무슨 내용을 말하고 있는지
와 같은 high-level information이 더 중요한 경우가 많다.
기존 VAE는 일반적으로 이러한 latent representation을 continuous variable로 표현한다.
예를 들어,
처럼 latent가 연속적인 실수 값을 가진다.
반면 VQ-VAE는 latent를 discrete representation으로 표현한다.
Continuous
0.312...
0.313...
0.314...
...

Discrete
code #1
code #2
code #3
...
code #K
논문은 language, speech 등의 high-level structure가 이러한 discrete representation과 자연스럽게 연결될 수 있다고 본다. Language는 본질적으로 symbol의 sequence이고, speech 역시 phoneme 등의 discrete unit으로 표현할 수 있기 때문이다.
2. 기존 VAE와 Posterior Collapse
먼저 일반적인 VAE는 크게 세 요소로 볼 수 있다.
- : Encoder가 만드는 posterior
- : latent에 대한 prior
- : latent로부터 데이터를 생성하는 Decoder
보통 VAE에서는 posterior와 prior를 Gaussian distribution으로 두고, Gaussian reparameterization trick(Gaussian sampling을 형태로 바꿔서 VAE를 backpropagation으로 학습할 수 있게 하는 방법)을 이용해 gradient를 안정적으로 전달한다.
그런데 강력한 autoregressive decoder를 사용하면 문제가 생길 수 있다.
Posterior Collapse
Decoder가 너무 강력하면,
"굳이 latent 를 사용하지 않아도 를 잘 생성할 수 있는데?"
라는 상황이 발생한다.
x → Encoder → z → Decoder
                ↑
             거의 무시
이처럼 decoder가 latent를 거의 사용하지 않게 되는 현상을 posterior collapse라고 한다.
PixelCNN처럼 이전 pixel들을 기반으로 다음 pixel을 강력하게 예측할 수 있는 decoder에서는 이러한 현상이 특히 문제가 될 수 있다.
VQ-VAE의 핵심 motivation 중 하나는 discrete latent representation을 사용하면서 이 문제를 피하는 것이다.
3. 핵심 아이디어: Vector Quantization
VQ-VAE의 VQ는 Vector Quantization을 의미한다.
Quantization, 즉 양자화는 쉽게 말하면
연속적으로 가능한 값을 그대로 사용하는 대신, 정해진 대표값 중 하나로 치환하는 것
이다.
예를 들어 Encoder가
라는 continuous vector를 출력했다고 하자.
그리고 다음과 같은 embedding들이 존재한다고 하자.
Encoder output과 가장 가까운 embedding을 찾는다.
만약 가장 가까운 것이 이라면,
으로 바꾼다.
즉,
Encoder output
[0.82, 0.15]
      ↓
Nearest Neighbor Search
      ↓
Codebook #1
[1.0, 0.0]
이 과정이 Vector Quantization이다.
4. Codebook
VQ-VAE는 학습 가능한 embedding table, 즉 codebook을 가지고 있다.
논문에서는 embedding space를
로 정의한다.
여기서
- : codebook에 존재하는 embedding의 개수
- : 각 embedding vector의 dimension
이다.
예를 들어
라면,
e1   → 64-dimensional vector
e2   → 64-dimensional vector
...
e512 → 64-dimensional vector
총 512개의 선택지가 존재한다.
5. , , 구분하기
Encoder가 직접 출력한 continuous representation
어떤 codebook entry가 선택되었는지를 나타내는 discrete index
예:
Quantization 이후 Decoder에게 실제로 전달되는 vector
따라서 전체 흐름은
Input x
  ↓
Encoder
  ↓
z_e(x)
continuous
  ↓
Nearest Neighbor
  ↓
z = 3
discrete index
  ↓
e_3
  ↓
z_q(x)
quantized representation
  ↓
Decoder
Encoder는 입력 를 continuous latent representation 로 변환하고, 그와 가장 가까운 codebook vector의 index를 선택한다. 선택된 embedding 를 quantized representation 로 사용해 Decoder에 전달한다.
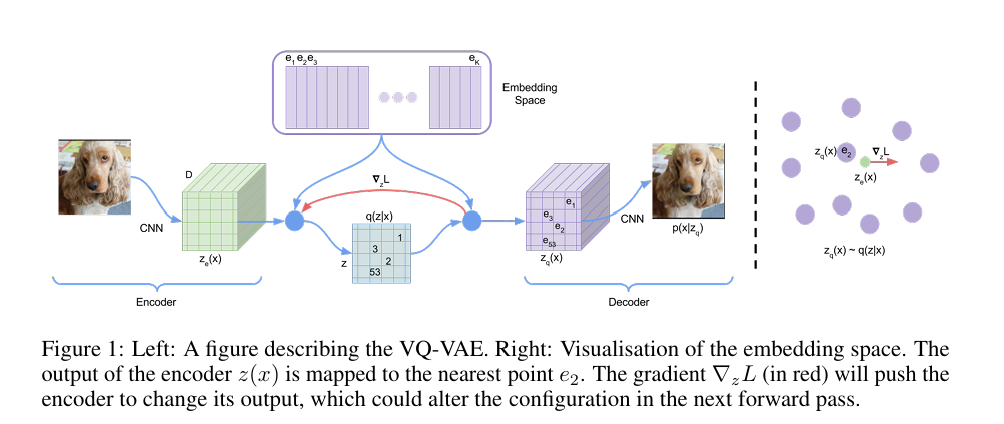
Figure 1의 왼쪽은 VQ-VAE 전체 구조를, 오른쪽은 embedding space에서 encoder output이 가장 가까운 embedding으로 quantize되는 과정을 보여준다. 논문은 실제로 를 가장 가까운 codebook vector에 mapping하고 이를 decoder에 전달한다.
Figure를 볼 때는 다음 흐름만 보면 된다.
Image
 ↓
Encoder
 ↓
z_e(x)
 ↓
Codebook에서 nearest embedding 검색
 ↓
Discrete code
 ↓
z_q(x)
 ↓
Decoder
 ↓
Reconstruction
6. Posterior (q(z|x))
VQ-VAE에서 posterior는 categorical distribution이다.
논문에서는 다음과 같이 정의한다.
즉 Encoder output과 가장 가까운 embedding 하나만 확률 1을 가지고, 나머지는 모두 0이다.
예를 들어 네 개의 code 중 세 번째가 가장 가깝다면
이 된다.
따라서 VQ-VAE의 posterior는 사실상 deterministic하다.
일반적인 VAE처럼 posterior에서 랜덤하게 를 sampling하는 것이 아니라,
가장 가까운 code를 무조건 선택한다.
7. 그런데 Nearest Neighbor는 미분이 안 된다
여기서 큰 문제가 발생한다.
Quantization은
라는 discrete operation을 포함한다.
argmin은 일반적인 방식으로 미분할 수 없다.
따라서 그대로라면
Decoder
 ↑
Loss
 ↑
z_q(x)

--- Quantization ---
gradient가 끊김

z_e(x)
 ↑
Encoder
이 되어 Encoder를 reconstruction loss로 학습할 수 없다.
VQ-VAE에서는 이 문제를 Straight-Through Estimator로 해결한다.
8. Straight-Through Estimator
Forward pass에서는 실제로 quantization을 수행한다.
z_e(x)
 ↓
Nearest Neighbor
 ↓
z_q(x)
 ↓
Decoder
하지만 backward pass에서는 quantization을 무시한다.
Decoder에서 온 gradient를
에서
로 그대로 복사한다.
Backward

Decoder
 ↑
∇L
 ↑
z_q(x)
 ↑
│ gradient 그대로 복사
│
z_e(x)
 ↑
Encoder
논문은 decoder input 의 gradient를 encoder output 에 그대로 전달한다고 설명한다.
즉,
Forward에서는 discrete quantization을 사용하지만, Backward에서는 quantization이 없었던 것처럼 gradient를 전달한다.
이것이 VQ-VAE에서 사용하는 Straight-Through Estimator의 핵심이다.
Encoder output이 gradient에 따라 움직이면, 다음 forward pass에서는 가장 가까운 codebook embedding 자체가 달라질 수도 있다.
9. VQ-VAE의 Loss
VQ-VAE의 학습 objective는 크게 세 부분으로 구성된다.
논문은 각각의 term이 서로 다른 부분을 학습하도록 구성한다.
논문의 표기를 그대로 따르면 첫 항은 로 표현된다. 직관적으로는 reconstruction을 잘하도록 만드는 항으로 이해하면 된다.
9.1 Reconstruction Loss
첫 번째 term은
이다.
목표는 단순하다.
Quantized latent로부터 원본 를 잘 복원하자.
x
↓
Encoder
↓
Quantization
↓
Decoder
↓
x̂

x ≈ x̂
이 term은
- Decoder
- Encoder
를 학습시킨다.
Encoder에는 앞서 설명한 Straight-Through Estimator를 통해 gradient가 전달된다.
10. Codebook Loss
두 번째 term은
이다.
여기서 sg는 stop-gradient operator이다.
이지만 backward에서는
이다.
즉 값은 사용하지만 해당 변수는 이 loss를 통해 업데이트하지 않는다.
따라서
에서는 가 고정된다.
Encoder output        Codebook
 z_e ●  ←────────────  ● e_k
          e_k 이동
즉 codebook embedding을 encoder output 쪽으로 이동시킨다.
K-Means에서 cluster centroid를 데이터가 모여 있는 방향으로 이동시키는 것과 비슷하게 이해할 수 있다.
11. Commitment Loss
세 번째 term은
이다.
이번에는 codebook 가 stop-gradient로 고정된다.
따라서 반대로 Encoder output이 움직인다.
Encoder output        Codebook
 z_e ●  ────────────→ ● e_k
       z_e 이동
목표는
Encoder가 자신이 선택한 embedding 근처에 머물도록 만드는 것
이다.
그래서 이름이 commitment loss이다.
Encoder가 특정 codebook vector에 commit하도록 만드는 역할이다.
12. Codebook Loss vs Commitment Loss
두 loss는 비슷해 보이지만 움직이는 대상이 다르다.
| Loss | 역할 | 업데이트되는 대상 |
|---|---|---|
| Reconstruction | 입력 복원 | Encoder + Decoder |
| Codebook Loss | embedding을 Encoder output 쪽으로 이동 | Codebook |
| Commitment Loss | Encoder output을 embedding 쪽으로 이동 | Encoder |
즉 한 그림으로 보면,
          서로 가까워지도록 학습

z_e(x) ●  ←────────────→  ● e_k
         ↑                ↑
    Commitment        Codebook
       Loss             Loss
이다.
논문에서는 commitment loss의 coefficient로
를 사용한다.
13. 기존 VAE의 KL Loss는 어디 갔을까?
일반적인 VAE라면
가 등장한다.
그런데 VQ-VAE를 처음 학습할 때 prior를 uniform distribution으로 둔다.
그리고 posterior는 one-hot이다.
따라서 어떤 code를 선택해도 KL divergence는
로 일정하다.
즉 Encoder parameter가 변해도 값이 변하지 않으므로 gradient 관점에서는 의미가 없다.
그래서 VQ-VAE를 학습할 때 기존 VAE처럼 별도의 KL term을 최적화할 필요가 없다.
14. 이미지에서는 code 하나만 사용하는 게 아니다
논문 설명에서는 편의를 위해 하나의 를 사용하지만, 실제 데이터에서는 여러 개의 discrete latent를 사용한다.
예를 들어 이미지라면 Encoder가
의 feature map을 만든다고 해보자.
그러면 각 spatial position마다 하나의 codebook entry가 선택된다.
17  17  23  41  ...
17   8  23  41  ...
31  31   9   9  ...
...
즉 하나의 이미지가 discrete code map으로 바뀌는 것이다.
논문에서는 speech, image, video에 각각 1D, 2D, 3D latent feature space를 사용한다고 설명한다.
15. Autoregressive Prior
여기까지 학습하면 VQ-VAE는
입력을 어떤 discrete code들로 표현할 것인가
를 배운 것이다.
그런데 새로운 이미지를 생성하려면 입력 이미지 없이 새로운 latent code를 만들어야 한다.
이 역할을 하는 것이 prior 이다.
VQ-VAE 학습 중에는 prior를 단순한 uniform distribution으로 둔다.
그리고 VQ-VAE 학습이 완료된 뒤, 실제 training data에서 얻은 discrete latent code를 이용해 autoregressive prior를 별도로 학습한다.
즉 학습은 두 단계로 볼 수 있다.
[Step 1]

Input
 ↓
VQ-VAE
 ↓
Meaningful discrete representation 학습


[Step 2]

Discrete codes
 ↓
Autoregressive prior
 ↓
code들의 확률 패턴 학습
이미지에서는 PixelCNN, raw audio에서는 WaveNet을 prior로 사용한다.
16. Autoregressive는 무엇인가?
예를 들어 discrete latent가
으로 이루어져 있다고 하자.
전체 분포는
로 표현할 수 있다.
즉
z1 생성
 ↓
z1을 보고 z2 생성
 ↓
z1, z2를 보고 z3 생성
 ↓
...
처럼 이전 latent code를 바탕으로 다음 latent code를 생성한다.
새로운 데이터를 생성할 때는
Autoregressive Prior
        ↓
새로운 discrete latent
        ↓
VQ-VAE Decoder
        ↓
Image / Audio
의 구조가 된다.
여기서 중요한 점은 VQ-VAE와 prior를 이 논문에서는 joint training하지 않는다는 것이다.
먼저 VQ-VAE를 학습하고, 그 후 prior를 학습한다.
17. 그래서 Abstract의 “prior is learnt”는?
처음 Abstract에서
prior is learnt rather than static
이라고 표현해서 약간 헷갈릴 수 있다.
Method까지 읽으면 더 정확한 의미가 보인다.
VQ-VAE representation 학습 시
으로 고정한다.
VQ-VAE 학습 이후
실제 discrete latent들의 분포
를 PixelCNN/WaveNet 등의 autoregressive model로 학습한다.
즉,
representation learning 단계의 prior는 단순하게 두고, representation이 만들어진 이후 실제 latent distribution을 별도로 학습한다.
라고 이해하는 것이 정확하다.
18. 기존 Discrete VAE와 무엇이 달랐을까?
Discrete latent는 deep learning에서 오래전부터 어려운 문제였다.
Continuous latent에서는 Gaussian reparameterization trick을 사용해 상대적으로 낮은 variance의 gradient를 얻을 수 있었다.
반면 discrete variable은 선택 과정이 미분 가능하지 않기 때문에 여러 방법이 제안되었다.
대표적으로 논문에서는
- NVIL
- VIMCO
- Concrete distribution
- Gumbel-Softmax
등을 언급한다.
Gumbel-Softmax 계열은 처음에는 discrete selection을 continuous하게 완화하여 학습한 뒤, temperature를 낮춰 점점 hard selection에 가까워지게 하는 방식이다.
Soft

[0.15, 0.20, 0.55, 0.10]

        ↓ temperature ↓

[0.01, 0.02, 0.96, 0.01]

        ↓

Hard

[0, 0, 1, 0]
하지만 이러한 방식들은 bias와 variance 사이의 문제가 있었고, 기존 continuous VAE와의 성능 차이를 완전히 없애지는 못했다.
VQ-VAE는 continuous relaxation 대신 Vector Quantization + Straight-Through Estimator라는 비교적 단순한 접근을 사용한다.
19. Experiments
실험은 모든 세부사항보다 각 실험이 어떤 주장을 검증하는지를 보는 것이 중요하다.
19.1 Continuous VAE와 비교
CIFAR10에서 같은 기본 architecture를 사용했을 때 결과는 다음과 같다.
| Model | bits/dim |
|---|---|
| VAE | 4.51 |
| VQ-VAE | 4.67 |
| VIMCO | 5.14 |
VQ-VAE는 discrete latent를 사용하면서도 continuous VAE와 상당히 가까운 likelihood 성능을 보였다.
즉,
discrete representation을 사용하기 위해 generative performance를 크게 희생할 필요는 없었다.
는 것이 첫 번째 결과이다.
20. Image: 강하게 압축해도 주요 정보는 남는다
ImageNet의
이미지를
의 discrete latent로 압축했고,
개의 codebook entry를 사용했다.
논문은 이를 약 42.6배의 bit reduction이라고 설명한다. 그럼에도 reconstruction은 원본보다 약간 blurry한 정도였다.
21. Powerful Decoder에서도 Posterior Collapse를 피할 수 있는가?
DeepMind Lab 실험에서는 PixelCNN처럼 강력한 decoder를 사용했다.
일반적인 VAE라면 decoder가 latent를 무시하면서 posterior collapse가 일어날 수 있는 설정이다.
하지만 저자들은 VQ-VAE에서는 latent가 의미 있게 사용되었다고 보고한다.
특히 두 번째 단계에서는 이미지 전체를 단 3개의 latent, 즉
로 압축했다.
완벽한 reconstruction은 불가능했지만,
- room layout
- nearby walls
- texture와 같은 scene information
은 상당 부분 유지되었다.
22. Audio: VQ-VAE가 무엇을 학습했을까?
개인적으로 이 논문의 representation learning 주장을 가장 잘 보여주는 부분은 Audio 실험이다.
VCTK speech에서 VQ-VAE의 latent space를 원본 waveform보다 64배 작게 만들었다.
그 결과 원본 waveform을 sample 단위로 완벽하게 복원할 수는 없었다.
그런데 reconstruction을 들어보면
- waveform은 상당히 달라짐
- prosody도 달라짐
- 말한 내용은 그대로 유지
되었다.
저자들은 이를 통해 VQ-VAE가 low-level waveform detail보다는 speech content 같은 high-level information을 latent에 저장한다고 해석한다.
23. Unsupervised Phoneme Learning
더 흥미로운 실험은 phoneme과의 관계이다.
VQ-VAE를 학습할 때는 phoneme label을 전혀 사용하지 않았다.
그런데 학습된 discrete latent code를 실제 phoneme과 대응시켜 보았다.
41-way phoneme classification 결과:
를 기록했다.
비교 기준은
였다.
즉,
Raw Speech
    ↓
No phoneme supervision
    ↓
VQ-VAE
    ↓
Discrete latent code
    ↓
실제 phoneme과 높은 관련성
을 보인 것이다.
이는 VQ-VAE의 discrete latent가 단순한 압축 번호가 아니라 실제 데이터의 high-level semantic structure와 관련될 수 있다는 중요한 증거이다.
24. Speaker Conversion
Decoder에는 latent 외에도 speaker identity를 별도로 줄 수 있다.
한 화자의 음성을 encode하고,
Speaker A
"Hello"
  ↓
VQ-VAE Encoder
  ↓
Content Latent
decoder에는 다른 speaker ID를 제공한다.
Content Latent
+
Speaker B ID
 ↓
Decoder
 ↓
Speaker B의 목소리로
"Hello"
실험 결과 말의 내용은 유지되면서 목소리는 두 번째 speaker의 특성을 가지게 되었다.
이는 latent representation이 speaker-specific low-level characteristic보다 content information을 상대적으로 분리해서 담고 있음을 보여준다.
25. Video: Pixel Space가 아니라 Latent Space에서 미래를 생성하기
마지막으로 DeepMind Lab 환경에서 action-conditioned video generation을 수행한다.
초기 frame과 action이 주어지면 미래 frame 자체를 직접 생성하는 것이 아니라 먼저
라는 latent sequence를 생성한다.
그 후 deterministic decoder를 사용해 각 latent를 pixel space로 변환한다.
Initial Frames + Actions
          ↓
Future discrete latents 생성
          ↓
Decoder
          ↓
Future Frames
즉 긴 sequence를 compressed latent space에서 먼저 모델링할 수 있다는 것을 보여준다.
26. Appendix: EMA로 Codebook을 업데이트할 수도 있다
본문에서는 codebook loss
를 사용해 embedding을 업데이트한다.
하지만 Appendix에서는 codebook을 Exponential Moving Average(EMA) 방식으로 업데이트하는 대안도 소개한다.
한 embedding (e_i)를 선택한 encoder output이
라면 이상적인 (e_i)는 이들의 평균이다.
K-Means에서 cluster centroid를 업데이트하는 것과 같은 아이디어다.
실제 학습은 minibatch 단위이므로 전체 평균을 매번 계산하는 대신 EMA를 사용할 수 있다.
new value
=
γ × old value
+
(1-γ) × current batch
논문에서는
가 잘 작동했다고 보고한다.
핵심은 단순하다.
Codebook loss 대신 encoder output들의 moving average를 이용해서 codebook을 업데이트할 수도 있다.
27. VQ-VAE 전체 흐름 정리
이제 논문 전체 구조를 다시 한 번 연결하면 다음과 같다.
Input x
  ↓
Encoder
  ↓
Continuous representation
z_e(x)
  ↓
Vector Quantization
  ↓
가장 가까운 Codebook Entry 선택
  ↓
Discrete index z
  ↓
Quantized representation
z_q(x)=e_k
  ↓
Decoder
  ↓
Reconstruction
학습할 때는
Reconstruction Loss
→ Encoder + Decoder

Codebook Loss
→ Codebook

Commitment Loss
→ Encoder
를 사용한다.
Quantization은 미분할 수 없기 때문에,
Decoder Gradient
      ↓
z_q(x)
      ↓
Straight-Through Estimator
      ↓
z_e(x)
      ↓
Encoder
처럼 gradient를 그대로 복사한다.
그리고 VQ-VAE 학습이 끝난 뒤에는
Training Data
 ↓
VQ-VAE
 ↓
Discrete Latent Codes
 ↓
PixelCNN / WaveNet
 ↓
Autoregressive Prior p(z)
를 학습한다.
생성 시에는 반대로
Autoregressive Prior
 ↓
새로운 Discrete Latent
 ↓
VQ-VAE Decoder
 ↓
Image / Audio / Video
의 흐름을 사용한다.
28. Conclusion
VQ-VAE의 핵심은 VAE와 Vector Quantization을 결합하여 discrete latent representation을 학습하는 것이다.
기존 continuous VAE와 달리 encoder representation을 codebook에 존재하는 embedding 중 하나로 quantize한다.
그 결과 VQ-VAE는
- discrete latent를 사용하면서 continuous VAE와 경쟁 가능한 likelihood를 얻었고,
- powerful decoder에서도 latent를 의미 있게 사용할 수 있었으며,
- image, audio, video의 high-level structure를 compressed latent에 표현할 수 있었고,
- phoneme supervision 없이도 phoneme과 밀접하게 관련된 speech representation을 학습했다.
저자들은 이러한 실험을 통해 VQ-VAE의 discrete latent space가 비지도 방식으로 데이터의 중요한 feature를 포착할 수 있다고 결론 내린다.
29. 내가 이해한 VQ-VAE의 핵심
처음에는 discrete latent라는 말 때문에 단순히
“continuous vector 대신 정수 code를 쓰는 모델인가?”
정도로 생각했다.
하지만 실제 핵심은 어떤 방식으로 discrete bottleneck을 만들고, 그럼에도 neural network를 end-to-end로 학습할 수 있게 하느냐에 있었다.
VQ-VAE의 핵심 요소를 다시 뽑으면
로 정리할 수 있다.
특히 가장 기억에 남는 부분은 Forward와 Backward의 동작이 다르다는 점이다.
Forward에서는 실제 discrete quantization을 수행하지만,
Backward에서는 quantization을 무시하고 gradient를 Encoder로 그대로 전달한다.
덕분에
discrete representation을 실제로 사용하면서도 gradient-based learning을 가능하게 한다.
그리고 학습된 discrete representation은 단순히 데이터를 압축하는 것에 그치지 않고, phoneme이나 scene structure처럼 원본 데이터의 여러 dimension에 걸쳐 존재하는 high-level information을 포착할 수 있음을 실험적으로 보여준다.