[Zero to ML Master #03] 행렬 쉽게 이해하기 — shape·행렬 곱셈·역행렬이 필요한 이유 (파이썬 NumPy)
Zero to 머신러닝 딥러닝 Master
반 전체의 과목별 점수를 표로 정리해 본 적 있나요? 그 표가 바로 행렬입니다. 📋
딥러닝 코드를 읽다 보면 shape mismatch 에러를 정말 자주 만나는데, 그 대부분은 "이 행렬이 몇 행 몇 열인가" 를 확인하는 습관 하나로 막을 수 있어요. 이번 글에서는 행렬의 shape, 행렬 곱셈의 패턴(행과 열을 짝지어 내적), 그리고 행렬에는 왜 나눗셈 대신 역행렬이 필요한지를 정리합니다.
📘 이 글은 위키독스 도서 Zero to 머신러닝 딥러닝 Master 의 00-02 행렬 — 성적표는 곧 행렬이다 을 블로그용으로 다듬은 글입니다.
💻 실습 코드: GitHub · 🏠 mldict.net · ✍️ 기술 블로그
💻 이 글의 코드:
00-02-matrices-report-card· Open in Colab — 핵심 코드와 실제 실행 결과는 글 아래 💻 GitHub 실습 섹션에 있습니다.
⬅️ 이전 글: #02 벡터란? 장바구니로 이해하는 벡터·내적·코사인 유사도 (파이썬 NumPy 실습) \
➡️ 다음 글: #04 최소제곱법과 정규방정식 — 선형회귀가 머신러닝의 첫 모델인 이유 (파이썬 NumPy)
TL;DR — 3줄 요약
- 행렬의 크기는 행 → 열 순서("3×2" = 3행 2열)로 읽고, 코드에서는
.shape로 가장 먼저 확인합니다. - 행렬 곱셈은 앞 행렬의 행 × 뒤 행렬의 열의 내적을 반복하는 연산입니다. 그래서 안쪽 차원이 같아야 해요.
- 행렬에는 나눗셈이 없어서, 를 풀 때는 역행렬 을 곱합니다.
00-02-D 📏 행렬의 크기(shape) 표현하기 — "몇 행 몇 열인가요?"
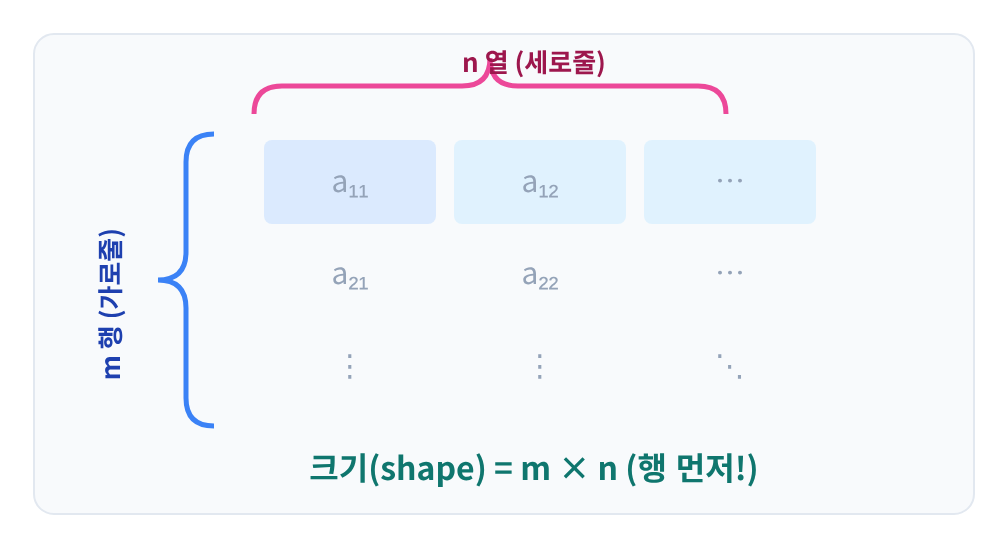
사람을 소개할 때 키와 몸무게를 말하듯이, 행렬을 소개할 때는 "가로로 몇 줄, 세로로 몇 줄인가"를 먼저 말합니다. 이 "행렬의 몸집"을 크기(size) 또는 모양(shape)이라고 부릅니다. 앞으로 행렬을 다룰 때마다 "이 행렬의 shape가 뭐지?"를 가장 먼저 확인하게 될 텐데, 그 이유는 뒤에서 배울 덧셈·곱셈이 전부 이 크기가 맞느냐 안 맞느냐로 가능 여부가 갈리기 때문입니다. 🔑
앞서 만든 성적표 행렬을 다시 봅시다. 가로로 3줄(학생 철수·영희·민수), 세로로 3줄(수학·영어·과학)이 있었습니다. 이런 행렬을 "3행 3열 행렬", 줄여서 "3×3 행렬"이라고 부릅니다. 읽을 때는 "삼 바이 삼(3 by 3)"이라고 읽습니다.
🎯 절대 잊으면 안 되는 약속 — 행이 먼저!
행(가로)의 개수를 먼저 쓰고, 열(세로)의 개수를 나중에 씁니다. "3×2"라고 쓰면 "행이 3개, 열이 2개"라는 뜻이지, 그 반대가 아닙니다. 이 순서를 뒤집어 부르면 완전히 다른 행렬을 가리키게 되므로, 처음부터 확실히 몸에 익혀두어야 합니다.
💜 더 쉽게 이해하기 — "행렬"이라는 이름 자체가 힌트
외우기 어렵다면, "행렬(行列)"이라는 단어를 그대로 읽어보세요. 한자 행(行, 가로)이 먼저 나오고 열(列, 세로)이 뒤에 나옵니다. 크기를 쓰는 순서도 똑같이 행 → 열입니다. 영어로도 Row → Column, 알파벳 순서 그대로라 "알씨(RC)" 순서라고 기억하면 편합니다. 🗂️
이제 처음 예시를 정확히 정리해봅시다. 학생이 4명이고 과목이 2개라면, 행(학생)이 4개, 열(과목)이 2개이므로 이 행렬의 크기는 4×2입니다. 순서를 헷갈려 "2×4"라고 쓰면 "학생 2명, 과목 4개"라는 전혀 다른 표를 가리키게 됩니다. 숫자 두 개는 같아 보여도 순서가 의미를 완전히 바꿔버립니다. 🔄
🧩 크기에 따라 특별한 이름이 붙는 행렬들
| 크기 | 이름 | 설명 |
|---|---|---|
| n×n | 정사각행렬 | 행과 열의 개수가 같은 "정사각형" 행렬 (단위행렬·역행렬이 여기서 등장) |
| 1×n | 행벡터 | 한 줄짜리 가로 벡터 — 00-01장에서 본 벡터의 정체 |
| m×1 | 열벡터 | 한 칸짜리 세로 벡터 — 장바구니 예시의 "가격표"가 이것 |
| 1×1 | 스칼라 | 숫자 하나 — 우리가 평소에 쓰는 그냥 "수" |
🔬 수학적 표기 —
수학책에서는 "는 행 열의 실수 행렬"이라는 말을 다음과 같이 짧게 씁니다.
여기서 은 실수(real number) 전체를 뜻하고, 오른쪽 위의 이 바로 크기입니다. 이 표기 하나에 "이 행렬은 실수로 채워져 있고, 행이 개, 열이 개다"라는 정보가 모두 담겨 있습니다. 논문이나 교재에서 아주 자주 보게 될 표기이니 눈에 익혀두세요. 👀
🐍 Python
import numpy as np

# 학생 4명 × 과목 2개 → 4행 2열(4×2) 행렬
scores = np.array([
    [85, 90],   # 철수
    [92, 88],   # 영희
    [70, 85],   # 민수
    [60, 75]    # 지수
])

print("shape(행, 열):", scores.shape)  # (4, 2) → 행 먼저, 열 나중
print("차원 수(ndim) :", scores.ndim)   # 2 (행렬은 2차원)
print("전체 원소 수  :", scores.size)   # 8 (=4×2)
🔗 GitHub에서 코드 보기 — 00_02_matrices_report_card.py L12–L24
✅ Output
shape(행, 열): (4, 2)
차원 수(ndim) : 2
전체 원소 수 : 8.shape가 돌려주는 (4, 2)는 튜플이고, 항상 (행, 열) 순서입니다. 우리가 손으로 "4행 2열"이라고 셌던 것과 정확히 같습니다. 🎉
🐞 실수하기 쉬운 부분 — 엑셀 셀 주소와 헷갈리지 마세요
엑셀에서 셀 주소
B3은 열(B)을 먼저, 행(3)을 나중에 씁니다. 즉 엑셀은 행렬 수학과 정반대 순서입니다. 그래서 엑셀에 익숙한 사람일수록 "열-행" 순서로 착각하기 쉽습니다. 수학·NumPy에서는 무조건 행이 먼저라는 점을 별도로 각인해두세요. ⚠️
00-02-E 🌍 우리 주변의 행렬들 — "세상은 표로 가득 차 있다"
행렬을 "성적표"라는 딱딱한 수학 개념으로만 생각하면 금방 지루해집니다. 하지만 일단 "행과 열로 정리된 숫자 표"라는 눈으로 세상을 보기 시작하면, 우리 주변이 온통 행렬 투성이라는 사실이 보입니다. 사실 컴퓨터와 AI가 세상을 이해하는 거의 유일한 방법이 "모든 것을 행렬(숫자 표)로 바꾸는 것"입니다. 몇 가지 예를 자세히 들여다봅시다. 🔍
💜 더 쉽게 이해하기 — 사물함 비유
학교 복도의 사물함 🗄️을 떠올려보세요. 사물함은 여러 층·여러 칸으로 반듯하게 나뉘어 있고, 각 칸에는 물건이 하나씩 들어 있습니다. "몇 층 몇 번째 칸"만 말하면 원하는 물건을 정확히 찾을 수 있죠. 행렬도 똑같습니다. "몇 행 몇 열"이라는 주소만 있으면 그 칸의 숫자를 콕 집어 꺼낼 수 있습니다. 세상의 수많은 데이터가 이 "반듯한 사물함" 구조에 딱 들어맞습니다.
- 📊 엑셀 스프레드시트: 우리가 매일 보는 그 표가 바로 행렬입니다. 첫 행에 항목 이름, 왼쪽 열에 이름표를 붙이고 나면, 안쪽의 숫자들이 통째로 하나의 행렬입니다. 회사의 월별 매출표, 가계부, 반 친구들 연락처 — 전부 행렬이라고 부를 수 있습니다.
- 🖼️ 디지털 사진: 흑백 사진은 가로·세로로 픽셀이 촘촘히 박혀 있고, 각 픽셀은 "얼마나 밝은가"를 나타내는 0(검정)~255(흰색) 사이의 숫자 하나입니다. 그래서 가로 1000·세로 1000 픽셀의 흑백 사진은 그대로 1000×1000 행렬입니다. 컬러 사진은 여기에 빨강·초록·파랑(RGB) 세 장이 겹쳐 있어서 행렬 세 개, 즉 3차원 "텐서"가 됩니다 (텐서는 뒤에서 다룹니다).
- 🎬 영화 평점 데이터(추천 시스템): 행에 사용자, 열에 영화를 두면, 각 칸에는 "그 사용자가 그 영화에 준 별점"이 들어갑니다. 넷플릭스·유튜브의 추천 알고리즘은 바로 이 거대한 (그리고 대부분 빈칸인) 행렬에서 "빈칸을 채워 넣는(=아직 안 본 영화의 예상 별점을 맞히는)" 문제를 풉니다.
- 🕸️ 친구 관계(그래프/SNS): 행과 열에 똑같이 사람들을 나열하고, "A와 B가 친구면 1, 아니면 0"을 적으면 인접행렬(adjacency matrix)이 됩니다. SNS의 친구 추천, 지하철 환승 경로 계산이 이런 행렬 위에서 이루어집니다.
- 🔎 검색 엔진(문서-단어 행렬): 행에 문서, 열에 단어를 두고 "그 문서에 그 단어가 몇 번 나왔는지"를 적으면, 검색 엔진이 문서의 내용을 이해하는 기초 행렬이 됩니다.
- 🧠 신경망의 가중치: AI 모델 내부에는 수많은 행렬이 저장되어 있고, 이 행렬들의 숫자 하나하나가 AI의 "지식"에 해당합니다. AI가 학습한다는 것은 결국 이 행렬 속 숫자들을 조금씩 바꿔 나가는 과정입니다. (이 장의 마지막 절에서 다시 만납니다.)
📋 한눈에 보는 "행렬로 표현되는 데이터"
| 분야 | 행(가로) | 열(세로) | 각 칸의 의미 |
|---|---|---|---|
| 성적표 | 학생 | 과목 | 점수 |
| 흑백 사진 | 세로 픽셀 | 가로 픽셀 | 밝기(0~255) |
| 추천 시스템 | 사용자 | 영화 | 별점 |
| SNS 그래프 | 사람 | 사람 | 친구면 1, 아니면 0 |
| 검색 엔진 | 문서 | 단어 | 등장 횟수 |
"사진이 정말 숫자 표일까?" 5×5짜리 아주 작은 흑백 이미지를 행렬로 직접 만들어보면 실감이 납니다. 아래에서 255는 흰색, 0은 검정입니다. 숫자 배치가 화면의 밝기 패턴과 그대로 대응됩니다. 🖼️
🐍 Python
import numpy as np

# 5×5 흑백 이미지 (255=흰색, 0=검정) — 가운데에 십자 모양이 그려진 그림
image = np.array([
    [  0,   0, 255,   0,   0],
    [  0,   0, 255,   0,   0],
    [255, 255, 255, 255, 255],
    [  0,   0, 255,   0,   0],
    [  0,   0, 255,   0,   0]
])

print("이미지 크기(shape):", image.shape)  # (5, 5)
# 밝은 칸(255)은 ■, 어두운 칸(0)은 · 로 그려보기
for row in image:
    print("".join("■" if v > 127 else "·" for v in row))
🔗 GitHub에서 코드 보기 — 00_02_matrices_report_card.py L28–L42
✅ Output
이미지 크기(shape): (5, 5)
··■··
··■··
■■■■■
··■··
··■··
숫자 255가 있던 자리에 정확히 십자(+) 모양이 나타났습니다. 이미지가 곧 행렬이라는 것을 눈으로 확인한 셈입니다. 나중에 배울 "이미지를 알아보는 AI(CNN)"는, 결국 이 숫자 행렬 위에서 계산을 하는 것입니다. 🎯
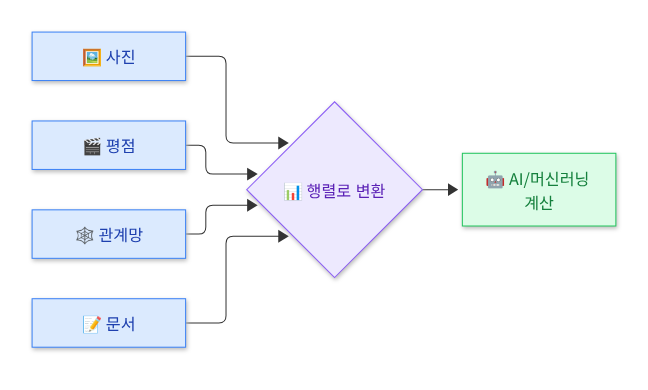
📌 핵심: 사진이든, 평점이든, 관계망이든 — 세상의 데이터는 일단 행렬(숫자 표)로 바뀐 다음에야 컴퓨터와 AI의 계산 대상이 됩니다. 그래서 행렬은 "선택 과목"이 아니라 머신러닝의 공용 언어입니다. 🗣️
00-02-Q 🔁 패턴 정리 — "행과 열을 짝지어서 내적한다"
앞에서 2×2 행렬 곱셈을 하며 네 칸(1행1열, 1행2열, 2행1열, 2행2열)을 하나씩 채웠습니다. 그 네 번의 계산에는 완전히 똑같은 한 가지 패턴이 반복되고 있었습니다. 그 패턴을 딱 한 문장으로 뽑아내면 행렬 곱셈의 전부를 손에 쥘 수 있습니다. 👀
✨ 한 문장 요약
결과 행렬의 (i행, j열) 자리에 들어갈 숫자 = 왼쪽 행렬 A의 i번째 행과 오른쪽 행렬 B의 j번째 열을 짝지어 "내적"한 값
💜 잠깐 복습 — "내적"이 뭐였죠? (00-01 벡터)
내적은 "같은 자리끼리 곱해서, 그것을 전부 더하는" 연산이었습니다. 예를 들어 와 의 내적은 입니다. 장바구니 예시에서 "개수 × 단가를 다 더해 총액을 구한 것"이 바로 내적이었죠. 🛒 행렬 곱셈은 이 내적을, "A의 각 행"과 "B의 각 열"의 모든 짝에 대해 반복하는 것뿐입니다.
🔬 수학적 의미 — 공식과 변수 정의
변수 정의 (기호를 하나씩 확실히 짚고 갑니다):\
• : 왼쪽 행렬, 크기 \
• : 오른쪽 행렬, 크기 \
• : 결과 행렬, 크기 \
• : 결과에서 지금 채우려는 행 번호 ()\
• : 결과에서 지금 채우려는 열 번호 ()\
• : 짝지어 곱할 대상을 훑는 합의 인덱스, 부터 까지\
• : 짝지을 대상의 개수 = A의 열 개수 = B의 행 개수 (이 둘이 같아야만 곱셈 가능)
공식 를 말로 풀면 이렇습니다. "A의 i행을 왼쪽에서 오른쪽으로(), B의 j열을 위에서 아래로() 훑으면서, 같은 순번(k)끼리 곱해 전부 더한다." 이게 정확히 내적입니다. ✏️
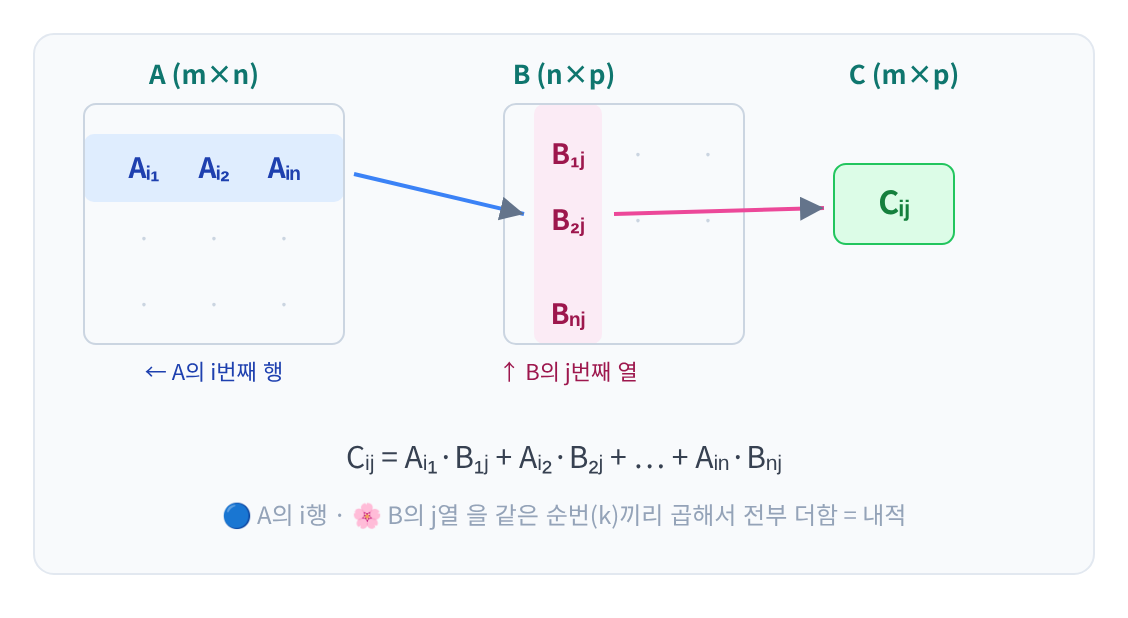
공식을 예시에 대입해보기. 앞의 , 에서 결과의 (1행, 1열), 즉 을 공식으로 구하면:
✅ Output
i=1, j=1 이므로 A의 1행(1,2), B의 1열(5,7)

C₁₁ = Σ(k=1..2) A₁ₖ·Bₖ₁
    = A₁₁·B₁₁ + A₁₂·B₂₁
    =  1 × 5  +  2 × 7
    =   5     +   14
    =   19   ✅  (손으로 계산했던 값과 일치!)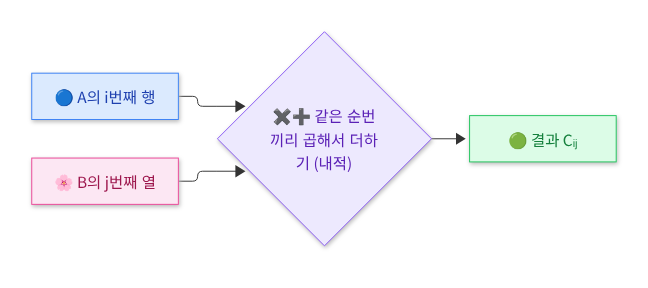
🧠 직관적 의미 — 왜 하필 "곱하고 더하기"일까? 내적은 결국 가중합(weighted sum)입니다. B의 한 열이 "각 항목에 얼마씩 가중치를 줄지"를 정하는 규칙이라면, A의 한 행에 그 규칙을 적용해 "하나의 대표 숫자"로 요약하는 것이 내적입니다. 장바구니 예시에서 "각 과일 개수에 단가라는 가중치를 곱해 총액 하나로 요약"한 것과 똑같습니다. 이 "가중합으로 요약하기"가 뒤에서 배울 신경망의 뉴런 하나가 하는 일과 정확히 같습니다. 🔗
공식 를 삼중 반복문으로 그대로 옮겨보면, NumPy의 @가 내부에서 무슨 일을 하는지 손에 잡힙니다. 💻
🐍 Python
import numpy as np

A = np.array([[1, 2], [3, 4]])  # (m=2, n=2)
B = np.array([[5, 6], [7, 8]])  # (n=2, p=2)

m, n = A.shape          # A: m행 n열
n2, p = B.shape         # B: n행 p열
assert n == n2, "내부 차원(n)이 안 맞으면 곱할 수 없음!"

C = np.zeros((m, p))    # 결과는 m×p 크기
for i in range(m):           # 결과의 행
    for j in range(p):       # 결과의 열
        for k in range(n):   # 짝지어 곱할 대상(합의 인덱스)
            C[i, j] += A[i, k] * B[k, j]   # 곱해서 누적 = 내적

print("직접 구현한 결과:\n", C)
print("NumPy @ 결과:\n", A @ B)
🔗 GitHub에서 코드 보기 — 00_02_matrices_report_card.py L46–L62
✅ Output
직접 구현한 결과:
 [[19. 22.]
 [43. 50.]]
NumPy @ 결과:
 [[19 22]
 [43 50]]
공식을 그대로 옮긴 삼중 루프의 결과와 @의 결과가 완전히 같습니다. 즉 @는 이 세 겹 반복을 (아주 빠르게) 대신 해주는 것뿐입니다. 실제로는 항상 @를 쓰지만, "속을 열어보면 이 공식"이라는 걸 아는 것과 모르는 것은 큰 차이입니다. 🔧
⚖️ 프레임워크 관점 — 같은 공식, 다른 이름
| 개념 | NumPy | PyTorch | TensorFlow | JAX |
|---|---|---|---|---|
| 행렬 곱 | A @ B | torch.matmul | tf.matmul | jnp.matmul |
| 공식 그대로 (아인슈타인 표기) | np.einsum('ik,kj->ij', A, B) | einsum은 네 프레임워크 모두 동일 문법으로 지원 |
특히 einsum('ik,kj->ij')는 방금 배운 공식 의 인덱스를 문자 그대로 적은 것입니다. 공식을 이해했다면 이 표기가 오히려 가장 직관적으로 보일 것입니다. 🧠
🐞 디버깅 포인트 — 내부 차원(n)이 생명
곱셈이 가능하려면 A의 열 개수와 B의 행 개수(둘 다 )가 같아야 합니다. 안 맞으면
ValueError: ... not aligned가 납니다. 곱하기 직전에print(A.shape, B.shape)로 안쪽 두 숫자가 같은지 확인하는 습관을 들이세요. 예: (2,3) @ (3,4) → OK, 결과는 (2,4).
00-02-Y 🤔 역행렬은 왜 필요할까? — "행렬에는 나눗셈이 없다"
역행렬()을 배웠지만, "그래서 이걸 어디에 쓰지?"라는 의문이 남습니다. 역행렬이 태어난 이유는 딱 하나, 행렬에는 "나눗셈"이라는 연산이 아예 없기 때문입니다. 그런데 우리는 종종 나눗셈이 필요합니다. 그 필요를 대신 채워주는 것이 역행렬입니다. 🧩
가장 흔한 상황은 이런 식입니다. 어떤 값 를 모르는데, "에 를 적용했더니 가 나왔다"는 사실만 알고 있습니다. 수식으로는:
여기서 우리가 알고 싶은 건 "원래 가 무엇이었나?"입니다. 이건 사실 연립방정식을 푸는 것과 같고, 현실에서는 "결과()를 보고 원인()을 거꾸로 알아내는" 아주 흔한 문제입니다. 예컨대 "여러 재료를 섞어 만든 음료의 성분()을 보고, 원래 재료를 얼마씩 넣었는지()를 역추적"하는 상황이죠. 🔎
💜 더 쉽게 이해하기 — "되돌리기(Undo)" 버튼 비유
역행렬은 컴퓨터의 Ctrl+Z(되돌리기) 🔙 같은 존재입니다. 가 "에 어떤 변형을 가하는 작업"이라면, 은 그 변형을 정확히 원상복구하는 작업입니다. 자물쇠를 잠그는 열쇠()가 있으면 여는 열쇠()가 있고, 둘을 이어서 쓰면 아무 일도 없던 것처럼() 됩니다. 그래서 인 것입니다.
일반 숫자였다면 에서 양변을 3으로 나눠 를 구했을 겁니다. 하지만 행렬에는 나눗셈이 없으니, "나누기" 대신 "역행렬을 곱하기"를 씁니다.
🔬 공식 유도 — 단계별
출발:
① 양변의 왼쪽에 을 곱합니다 (여기가 핵심!):
② 왼쪽에서 (역행렬 × 원래 행렬 = 단위행렬):
③ 단위행렬 는 곱해도 값이 변하지 않으므로 ():
⚠️ 왜 "왼쪽에" 곱해야 하나요?
행렬 곱셈은 순서를 바꾸면 결과가 달라진다는 것()을 앞에서 배웠습니다. 에서 는 의 왼쪽에 붙어 있으므로, 이를 떼어내려면 도 반드시 양변 모두 왼쪽에 곱해야 합니다. 만약 오른쪽에 곱하면() 위치가 안 맞아 를 만들 수 없어 를 분리할 수 없습니다. "붙어 있는 쪽과 같은 쪽에서 떼어낸다"고 기억하세요. 🔑
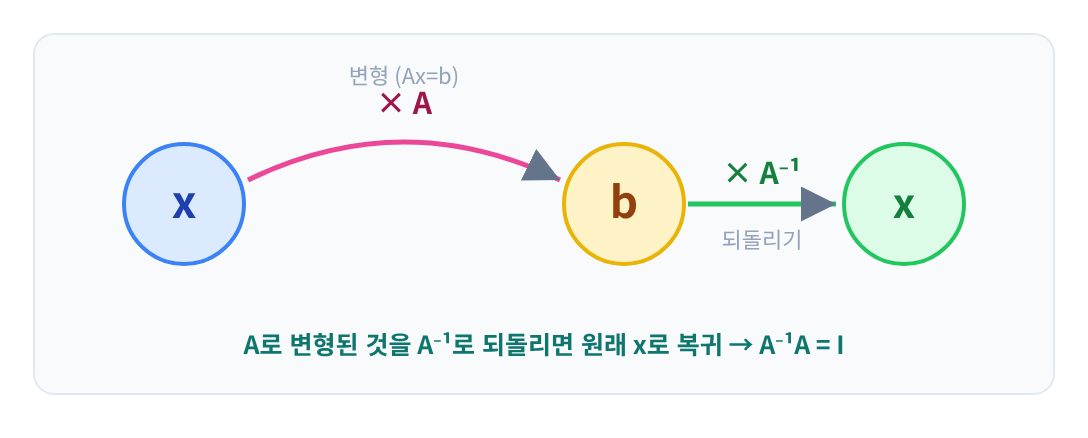
이렇게 역행렬을 이용하면 형태의 방정식에서 로 답을 구할 수 있습니다. 이 논리는 00-03장에서 연립방정식을 본격적으로 풀 때 그대로 다시 등장합니다. 🔁
⚠️ 모든 행렬에 역행렬이 있는 것은 아닙니다. 일반 숫자에서 의 역수 이 정의되지 않는 것처럼, 어떤 행렬은 역행렬이 존재하지 않습니다(이를 특이행렬, singular matrix라 합니다). 역행렬이 있느냐 없느냐는 행렬식(determinant)이 0이 아니냐 0이냐로 판별하는데, 이 개념은 뒤에서 따로 다룹니다.
🚀 머신러닝에서는? — 선형회귀의 "정규방정식"
머신러닝에서 가장 기본이 되는 선형회귀의 정답 공식(정규방정식)이 바로 역행렬로 쓰입니다.
데이터 와 정답 로부터 최적의 가중치 를 한 번에 구하는 이 식에 이 등장합니다. 즉 "를 거꾸로 풀어 를 구한다"는, 방금 배운 와 완전히 같은 아이디어입니다. 🎯
코드로 를 두 가지 방법으로 풀어 비교해봅시다. 하나는 역행렬을 직접 구해 곱하는 방법, 다른 하나는 전용 함수 np.linalg.solve를 쓰는 방법입니다. 💻
🐍 Python
import numpy as np

# 풀고 싶은 방정식:  A x = b
A = np.array([[2., 1.],
               [1., 3.]])
b = np.array([5., 10.])

# 방법 1) 역행렬을 직접 구해서 곱하기: x = A⁻¹ b
x1 = np.linalg.inv(A) @ b

# 방법 2) 전용 solver 사용 (실무 권장) — 내부적으로 더 안정적/빠름
x2 = np.linalg.solve(A, b)

print("역행렬로 푼 x :", x1)
print("solve로 푼 x  :", x2)
print("검산 A@x = b ?:", np.allclose(A @ x2, b))
🔗 GitHub에서 코드 보기 — 00_02_matrices_report_card.py L66–L81
✅ Output
역행렬로 푼 x : [1. 3.]
solve로 푼 x  : [1. 3.]
검산 A@x = b ?: True
두 방법의 답 이 같고, 가 정확히 로 돌아오는 것도 확인됩니다. 개념을 이해할 땐 "역행렬을 곱한다"로 생각하되, 실제 코드에서는 solve를 쓰는 것이 정석입니다. 🎯
🐞 디버깅 팁
•
LinAlgError: Singular matrix→ 그 행렬은 역행렬이 없습니다(행렬식 0). 데이터가 겹치거나 종속인 경우 자주 발생합니다.\
• dtype이 정수(int)면 소수점 결과가 잘려 엉뚱한 값이 나올 수 있으니2.,1.처럼 실수(float)로 만드세요.\
• 실무 권장: 가 필요할 때도inv(A) @ b보다solve(A, b)가 더 빠르고 수치적으로 안정적입니다. 역행렬을 통째로 구하는 것은 계산 낭비이자 오차의 원인이 되기 쉽습니다.
🔜 다음 장 예고 — 00-03. 연립방정식 — "x가 뭔지 맞춰보세요" 게임
방금 를 역행렬로 푸는 법을 맛보았습니다. 다음 장에서는 이 식이 실제로 무엇을 푸는지 — 사과·바나나 가격 맞히기 게임에서 출발해,
식이 데이터보다 많을 때 "가장 그럴듯한 답"을 찾는 최소제곱법까지 갑니다. 그리고 그것이 곧 머신러닝의 첫 모델, 선형회귀라는 사실을 확인합니다.
💻 GitHub 실습 — 코드로 직접 확인하기
📂 이 장의 코드 폴더: book/00-math-overview-for-beginners/00-02-matrices-report-card
책에 실린 코드를 장(절)별로 모아 둔 폴더입니다. 아래 파일을 열어 보거나, Colab에서 바로 실행해 보세요.
| 파일 | 용도 | 링크 |
|---|---|---|
00_02_matrices_report_card.py | 책의 코드 블록 4개를 순서대로 모은 실행 스크립트 (# %% 셀 구분) | 코드 보기 |
00_02_matrices_report_card.ipynb | 같은 코드를 블록당 셀 1개로 담은 주피터 노트북 | 보기 · Colab |
README.md | 코드 블록 목록 · 실행 방법 · 검증 결과 | 보기 |
🎬 medium-series/04-matrices/ | Medium 시리즈 예제 — 같은 주제를 블로그용으로 다듬은 실습 | 폴더 · Colab |
🧪 저장소 검증 상태: ✅ 실행 OK
🔑 핵심 코드 1 — 행렬 곱셈을 3중 for문으로 직접 구현하기
📄 00_02_matrices_report_card.py L46–L62 · Block 3 (00-02-Q 🔁 패턴 정리 — "행과 열을 짝지어서 내적한다")
import numpy as np

A = np.array([[1, 2], [3, 4]])  # (m=2, n=2)
B = np.array([[5, 6], [7, 8]])  # (n=2, p=2)

m, n = A.shape          # A: m행 n열
n2, p = B.shape         # B: n행 p열
assert n == n2, "내부 차원(n)이 안 맞으면 곱할 수 없음!"

C = np.zeros((m, p))    # 결과는 m×p 크기
for i in range(m):           # 결과의 행
    for j in range(p):       # 결과의 열
        for k in range(n):   # 짝지어 곱할 대상(합의 인덱스)
            C[i, j] += A[i, k] * B[k, j]   # 곱해서 누적 = 내적

print("직접 구현한 결과:\n", C)
print("NumPy @ 결과:\n", A @ B)
▶ 실행 결과 — 위 코드를 실행한 출력 (직접 실행: Windows · Python 3.11.2 · numpy 2.4.6, 앞 블록부터 순서대로 실행)
직접 구현한 결과:
 [[19. 22.]
 [43. 50.]]
NumPy @ 결과:
 [[19 22]
 [43 50]]
🔑 핵심 코드 2 — 역행렬 vs solve — Ax = b 풀기
📄 00_02_matrices_report_card.py L66–L81 · Block 4 (00-02-Y 🤔 역행렬은 왜 필요할까? — "행렬에는 나눗셈이 없다")
import numpy as np

# 풀고 싶은 방정식:  A x = b
A = np.array([[2., 1.],
               [1., 3.]])
b = np.array([5., 10.])

# 방법 1) 역행렬을 직접 구해서 곱하기: x = A⁻¹ b
x1 = np.linalg.inv(A) @ b

# 방법 2) 전용 solver 사용 (실무 권장) — 내부적으로 더 안정적/빠름
x2 = np.linalg.solve(A, b)

print("역행렬로 푼 x :", x1)
print("solve로 푼 x  :", x2)
print("검산 A@x = b ?:", np.allclose(A @ x2, b))
▶ 실행 결과 — 위 코드를 실행한 출력 (직접 실행: Windows · Python 3.11.2 · numpy 2.4.6, 앞 블록부터 순서대로 실행)
역행렬로 푼 x : [1. 3.]
solve로 푼 x  : [1. 3.]
검산 A@x = b ?: True
☁️ Colab에서 바로 실행
👉 Open in Colab — 00_02_matrices_report_card.ipynb · 설치 없이 브라우저에서 셀을 위에서부터 순서대로 실행하세요.
🖥️ 내 컴퓨터에서 실행하기
git clone https://github.com/otoloism/Zero_to_ML_Master.git
cd Zero_to_ML_Master
python -m venv .venv
source .venv/bin/activate          # Windows: .venv\Scripts\activate
pip install -r book/requirements.txt   # 책 전체용 (PyTorch 등 포함, 용량 큼)
# 이 장만 실행한다면 이것만으로 충분합니다: pip install numpy
cd book/00-math-overview-for-beginners/00-02-matrices-report-card
python 00_02_matrices_report_card.py
⭐ GitHub Star / Fork
⭐ 코드가 도움이 되셨다면 GitHub 저장소에 Star를 눌러 주세요. 새 장의 코드가 올라올 때 가장 먼저 알 수 있습니다.
🍴 직접 고쳐 보며 실험하고 싶다면 Fork 해서 내 저장소에서 마음껏 바꿔 보세요. 오류 제보·개선 제안은 Issues로 환영합니다!
🔮 다음 글 예고
다음 글은 00-03 연립방정식 — 최소제곱법 🧾 입니다. 식은 100개인데 미지수는 2개뿐이라 완벽한 답이 없을 때, 오차가 가장 작은 답을 찾는 최소제곱법과 정규방정식 를 직접 유도하고, 그것이 곧 선형회귀 = 머신러닝의 첫 모델이라는 사실을 확인합니다.
⬅️ 이전 글: #02 벡터란? 장바구니로 이해하는 벡터·내적·코사인 유사도 (파이썬 NumPy 실습) \
➡️ 다음 글: #04 최소제곱법과 정규방정식 — 선형회귀가 머신러닝의 첫 모델인 이유 (파이썬 NumPy)
📚 더 깊이 공부하고 싶다면
이 시리즈는 수학을 놓았던 비전공자가 AI를 직접 구현하기까지의 공부 기록을 그대로 옮긴 연재입니다. 원문 책, 코드, 개념 사전을 함께 보면 훨씬 빨리 늡니다. 🚀
| 바로가기 | 이런 분께 | |
|---|---|---|
| 📘 책 (위키독스, 무료) | Zero to 머신러닝 딥러닝 Master | 5권 · 20개 장 · 163개 절 전체를 순서대로 읽고 싶은 분 |
| 📄 이 글의 원문 | 00-02 행렬 — 성적표는 곧 행렬이다 | 연습문제·해설까지 전부 보고 싶은 분 |
| 💻 실습 코드 (GitHub) | otoloism/Zero_to_ML_Master | .py·.ipynb를 Colab에서 바로 돌려보고 싶은 분 |
| 🏠 머신러닝 백과사전 | mldict.net | 본문 속 핵심 개념을 카드로 다시 확인하고 싶은 분 |
| ✍️ 기술 블로그 | wikidocs.net/blog/@mldict | 새 글 알림을 가장 먼저 받고 싶은 분 |
⭐ 도움이 되셨다면 velog 팔로우와 GitHub Star를 눌러 주세요. 다음 글을 쓰는 가장 큰 힘이 됩니다. 궁금한 점은 댓글로 편하게 남겨 주세요! 🙌