[Zero to ML Master #02] 벡터란? 장바구니로 이해하는 벡터·내적·코사인 유사도 (파이썬 NumPy 실습)
Zero to 머신러닝 딥러닝 Master
마트에서 사과 3개, 바나나 2개, 우유 1개를 샀습니다. 이걸 세 숫자로 줄여 적는 순간, 여러분은 이미 벡터를 쓴 겁니다. 🛒
넷플릭스의 "취향 벡터", 챗봇의 "단어 벡터", 이미지의 "픽셀 벡터"까지, AI가 세상을 이해하는 첫 번째 문법이 바로 벡터예요. 이번 글에서는 화살표도 물리학도 없이, "같은 자리끼리" 라는 한 문장만으로 벡터 연산과 코사인 유사도 기반 추천까지 가 봅니다.
📘 이 글은 위키독스 도서 Zero to 머신러닝 딥러닝 Master 의 00-01 벡터 — 장바구니 속 숫자의 줄서기 을 블로그용으로 다듬은 글입니다.
💻 실습 코드: GitHub · 🏠 mldict.net · ✍️ 기술 블로그
💻 이 글의 코드:
00-01-vectors-shopping-cart· Open in Colab — 핵심 코드와 실제 실행 결과는 글 아래 💻 GitHub 실습 섹션에 있습니다.
⬅️ 이전 글: #01 수포자를 위한 머신러닝·딥러닝 독학 로드맵 — 수학부터 파이썬, LLM·RAG까지 163절 커리큘럼 \
➡️ 다음 글: #03 행렬 쉽게 이해하기 — shape·행렬 곱셈·역행렬이 필요한 이유 (파이썬 NumPy)
TL;DR — 3줄 요약
- 벡터 = 순서를 약속하고 나란히 적은 숫자 묶음입니다. 차원은 숫자의 개수일 뿐이에요.
- 덧셈·뺄셈·스칼라 곱은 모두 같은 자리끼리, 크기(Norm)는 피타고라스 정리로 구합니다.
- 내적과 코사인 유사도는 "비슷함"을 숫자 하나로 바꾸는 도구이고, 추천 시스템의 심장입니다.
📚 00권 소개 — 비전공자 처음부터: 수포자 훑어보기
📐 입문 기초 수학
"수학은 나랑 안 맞아요"라고 느끼셨나요? 이 챕터는 일상의 비유로만 시작합니다.
장바구니로 벡터를,
성적표로 행렬을,
안개 낀 산으로 경사하강법을,
병원 검사로 베이즈 정리를,
책 요약으로 SVD를 만나봅니다.
공식 암기 ZERO! 전 6챕터 · 진짜 입문
📋 챕터 목록
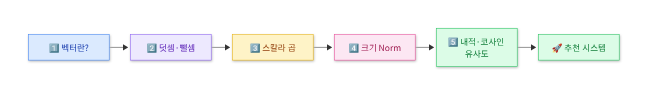
- 00-01 벡터 — 장바구니 속 숫자의 줄서기 → #02
- 00-02 행렬 — 성적표는 곧 행렬이다 → #03
- 00-03 연립방정식 — "x가 뭔지 맞춰보세요" 게임 → #04
- 00-04 미분·경사하강법 — 안개 낀 산에서 내려오기 → #05 · #06
- 00-05 확률·베이즈 정리 — 병원 검사의 함정 → #07 · #08
- 00-06 SVD·PCA — 300페이지 책을 3페이지로 → #09 · #10
✏️ 꼭 알아야 할 TIP
📌 벡터는 그냥 "순서가 있는 숫자 목록"입니다\
한 줄 비유 🛒 — 장바구니 속 사과·바나나·우유 개수를 처럼 괄호 안에 나열한 것, 그것이 벡터입니다. 화살표 나 굵은 글씨 는 모두 같은 대상을 가리키는 표기법일 뿐, 벡터의 본질은 "숫자 목록"입니다.\
가장 중요한 포인트 ⭐ — 벡터의 모든 연산은 예외 없이 "같은 자리끼리" 이루어집니다. 이 한 문장만 붙잡고 있으면 이번 장의 절반은 이미 끝난 것입니다.\
실무에서 쓰는 이유 🚀 — 넷플릭스의 "취향 벡터", 워드 임베딩의 "단어 벡터", 이미지의 "픽셀 벡터"처럼 데이터를 숫자 목록으로 정리하는 모든 곳에 벡터가 등장합니다. AI가 세상을 이해하는 첫 번째 문법이 바로 벡터입니다.
📚 선행지식
☐ 초등학교 수준의 사칙연산(더하기, 빼기, 곱하기) — 이것이 전부입니다\
☐ 중학교 수준의 피타고라스 정리 — 몰라도 됩니다. 4단계에서 그림과 함께 처음부터 다시 설명합니다\
☐ 괄호 안에 숫자를 나열하는 표기, 예: \
☐ 파이썬 리스트 [3, 2, 1]를 만들어본 경험 (없어도 코드마다 한 줄씩 해설합니다)
🎯 학습 목표
☐ 🛒 벡터가 무엇인지 장바구니 비유로 설명할 수 있다 🟢\
☐ ➕ 벡터의 덧셈·뺄셈을 손으로 계산하고, 왜 "같은 자리끼리"인지 설명할 수 있다 🟢\
☐ ✖️ 스칼라 곱이 무엇이고 왜 "공평하게" 곱해야 하는지 설명할 수 있다 🟢\
☐ 📐 피타고라스 정리로 벡터의 크기(Norm)를 계산할 수 있다 🔵\
☐ 🎬 내적과 코사인 유사도로 "두 데이터가 얼마나 비슷한지" 계산할 수 있다 🔵 ⭐\
☐ 💻 NumPy 코드로 위의 모든 연산을 직접 실행하고 결과를 검증할 수 있다 🟢\
☐ 🚀 넷플릭스 추천·워드 임베딩 등 실제 AI 서비스와 벡터를 연결해 설명할 수 있다 🚀
🗂️ 핵심 학습 내용
| 단계 | 학습 내용 | 핵심 공식 | 결과 |
|---|---|---|---|
| 1️⃣ | 벡터의 정의 | "숫자 묶음"이라는 감을 잡음 | |
| 2️⃣ | 덧셈·뺄셈 | 같은 자리끼리 계산하는 원리 이해 | |
| 3️⃣ | 스칼라 곱 | 비율을 유지하며 크기 조절 | |
| 4️⃣ | Norm(크기) | 피타고라스 정리로 거리 계산 | |
| 5️⃣ | 내적·코사인 유사도 | "비슷함"을 숫자로 표현, 추천 구현 |
1단계 — 벡터란 무엇인가?
① 핵심 정의 — 무엇인가?\
벡터는 순서가 정해진 숫자들의 묶음입니다. "순서가 정해져 있다"는 말은, 몇 번째 자리에 어떤 의미를 담을지 미리 약속해두었다는 뜻입니다.
왜 필요한가?\
컴퓨터는 글자도, 그림도, 감정도 직접 이해하지 못합니다. 오직 숫자만 계산할 수 있습니다. 그래서 세상의 데이터(취향·위치·색깔·문장)를 컴퓨터에게 넘기려면 반드시 숫자 목록으로 번역해야 하는데, 그 번역 결과물이 바로 벡터입니다.
언제 사용하는가?\
"여러 개의 값이 하나의 대상을 함께 설명할 때" 사용합니다. 한 사람의 (키, 몸무게, 나이), 한 영화의 (액션, 로맨스, 공포) 점수처럼 흩어진 숫자들을 하나의 덩어리로 묶어 다루고 싶을 때가 벡터의 자리입니다.
💜 더 쉽게 이해하기 — 🛒 장바구니 비유
마트에서 사과 3개, 바나나 2개, 우유 1개를 샀습니다. 친구에게 이걸 알려주려면 "사과 세 개랑 바나나 두 개랑 우유 하나 샀어"라고 길게 말해야 할까요?\
\
친구와 미리 "첫째 자리=사과, 둘째 자리=바나나, 셋째 자리=우유"라고 약속만 해두면, "(3, 2, 1)" 이 세 글자로 장보기 내용 전체를 전달할 수 있습니다. 약속된 순서 덕분에 이름표를 떼어내도 의미가 살아남는 것이죠. 📮\
\
이것이 벡터의 전부입니다. 화살표도, 좌표평면도, 물리학도 필요 없습니다. "순서를 정해서 나란히 적어놓은 숫자들의 묶음" — 그것이 벡터입니다.
🔢 진행 과정 — 데이터를 벡터로 만드는 5단계
- 항목 정하기 — 무엇을 측정할지 고른다 (사과, 바나나, 우유)
- 순서 약속하기 — 첫째=사과, 둘째=바나나, 셋째=우유로 고정한다 (가장 중요! 이후 절대 바꾸지 않는다)
- 숫자 채우기 — 각 항목의 값을 순서대로 적는다 (3, 2, 1)
- 괄호로 묶기 — 하나의 덩어리로 만든다 →
- 차원 세기 — 숫자가 몇 개인지 센다 → 3개이므로 3차원 벡터
🔬 수학공식 — 벡터의 표기
변수 정의\
• : 벡터 전체 (굵은 소문자로 표기, 손으로 쓸 땐 )\
• : 벡터의 번째 성분(component) — 괄호 안 번째 자리의 숫자\
• : 성분의 개수 = 벡터의 차원(dimension)\
• : "실수 개로 이루어진 벡터들의 세계"를 뜻하는 기호\
\
장바구니 을 이 표기로 쓰면 이고, 입니다.
📖 수학적 의미\
교과서는 흔히 "벡터란 크기와 방향을 모두 가지는 물리량이다"라고 정의합니다. 이 정의가 틀린 것은 아니지만, 벡터를 화살표 그림으로 그렸을 때에만 자연스럽게 와닿는 정의입니다. 우리는 반대 순서로 갑니다. "숫자 묶음"이라는 본질을 먼저 잡으면, "크기"는 4단계에서, "방향"은 5단계에서 저절로 따라 나옵니다. 실제로 머신러닝에서 다루는 300차원 단어 벡터를 화살표로 그릴 수는 없지만, 숫자 목록으로는 얼마든지 다룰 수 있습니다.
💡 직관적 의미\
2차원 벡터 = 지도에서 "동쪽 2칸, 북쪽 5칸". 3차원 벡터 = "가로1 × 세로3 × 높이2 상자". 100차원 벡터라고 해도 특별할 것은 없습니다. 그냥 괄호 안에 숫자가 100개 들어있다는 뜻일 뿐입니다. 차원이 높아진다고 개념이 어려워지지는 않습니다 — 단지 목록이 길어질 뿐입니다. 📏
🖼️ 시각화 ② — 2차원 벡터를 지도로 표현하기
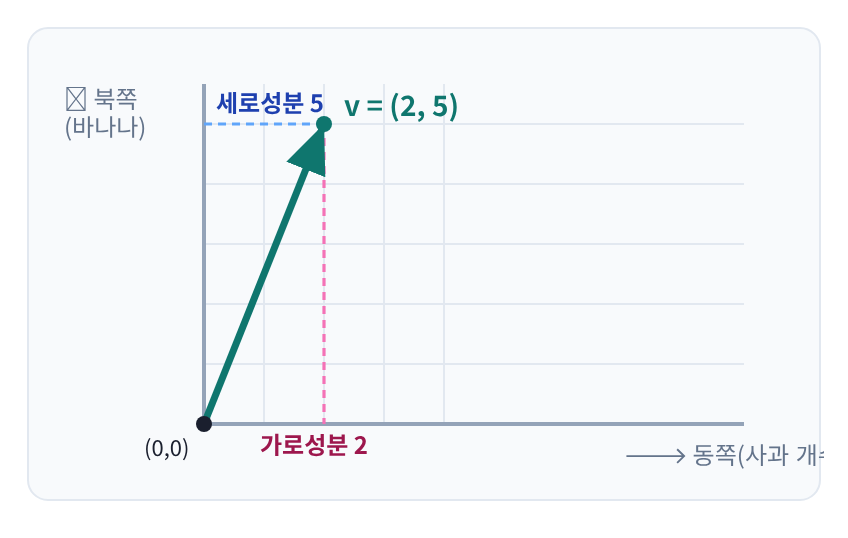
그림 1-1. 벡터 (2, 5) — 원점에서 동쪽 2칸, 북쪽 5칸 이동한 화살표. 괄호 안 숫자가 곧 "이동량"이다
⚙️ 구현 관점 — 컴퓨터는 벡터를 어떻게 저장하는가?\
컴퓨터는 벡터를 "숫자들이 메모리에 연속으로 붙어 있는 덩어리(배열, array)"로 저장합니다. 파이썬 기본 리스트 [3, 2, 1]는 각 숫자가 메모리 여기저기 흩어져 있어 계산이 느립니다. 반면 NumPy의 np.array는 같은 타입의 숫자를 한 줄로 빽빽하게 붙여 저장하기 때문에, 수천만 개의 숫자도 순식간에 계산할 수 있습니다. 이것이 머신러닝에서 리스트 대신 NumPy를 쓰는 이유입니다. 🚄
🔗 프레임워크 관점
| 개념 | NumPy | DeZero | PyTorch | TensorFlow | JAX |
|---|---|---|---|---|---|
| 벡터 생성 | np.array([3,2,1]) | Variable(...) | torch.tensor([3,2,1]) | tf.constant([3,2,1]) | jnp.array([3,2,1]) |
| 크기 확인 | .shape | .shape | .shape | .shape | .shape |
👉 이름만 다를 뿐 "숫자 목록을 담는 상자"라는 역할은 다섯 프레임워크가 완전히 같습니다. 하나를 익히면 나머지는 문법만 바꾸면 됩니다.
💻 코드 구현
🐍 Python
import numpy as np   # 수치 연산 라이브러리를 np라는 별칭으로 불러옵니다

# 자리 약속: [0]=사과, [1]=바나나, [2]=우유  ← 반드시 주석으로 남긴다!
# np.array()는 파이썬 리스트를 "벡터 연산이 가능한" 배열로 바꿔줍니다
basket = np.array([3, 2, 1])

print("벡터 내용 :", basket)         # 벡터 전체 출력
print("차원 개수 :", basket.shape)   # (3,) → 숫자가 3개(3차원)
print("첫째 성분 :", basket[0])     # 사과 개수 = 3 (0번부터 셈)
print("자료형    :", basket.dtype)   # int64 (정수형)
🔗 GitHub에서 코드 보기 — 00_01_vectors_shopping_cart.py L12–L21
📘 코드 이해 — 한 줄씩 뜯어보기
| 코드 | 하는 일 |
|---|---|
import numpy as np | NumPy를 불러오고 np라는 짧은 이름을 붙임 (관례) |
np.array([3, 2, 1]) | 파이썬 리스트를 ndarray(벡터)로 변환. 이 순간부터 +, *가 "성분별 연산"으로 동작 |
basket.shape | 모양을 튜플로 반환. (3,)은 "1차원이고 성분이 3개" |
basket[0] | 0번째 성분 꺼내기. 수학의 = 코드의 [0] ⚠️ |
basket.dtype | 담긴 숫자의 자료형. 정수면 int64, 소수면 float64 |
🧩 코드 설명 — Python 기초:
.shape가 왜(3,)인가?•
.shape는 메서드가 아니라 속성(attribute)입니다. 괄호 없이basket.shape로 씁니다.\
• 결과(3,)의 쉼표가 어색해 보이지만, 파이썬에서 원소가 하나뿐인 튜플은(3,)처럼 써야(3)(그냥 숫자 3)과 구분됩니다.\
• 즉(3,)은 "축이 하나(1차원)이고 그 축의 길이가 3"이라는 뜻입니다. 00-02장에서 배울 행렬은(3, 2)처럼 숫자가 두 개가 됩니다.
✅ 실행 결과
벡터 내용 : [3 2 1]
차원 개수 : (3,)
첫째 성분 : 3
자료형    : int64
🧪 실습 1
계란 6개, 밀가루 300g, 설탕 50g을 벡터로 만들고
.shape과.dtype을 출력해보세요.\
정답:recipe = np.array([6, 300, 50])→ shape는(3,), dtype는int64
🐞 실수하기 쉬운 부분 — "자리의 의미"를 잊어버림
왜 틀리는가? (사과, 바나나) 순서로 약속해놓고 실제 데이터는 (바나나, 사과) 순서로 넣는 실수입니다.\
원인은? 벡터에는 이름표가 없습니다. 순서를 뒤집어도 에러가 전혀 나지 않고 계산은 멀쩡히 됩니다. 결과의 의미만 조용히 뒤바뀝니다 — 가장 발견하기 어려운 종류의 버그입니다.\
올바른 수정 방법: 벡터를 만드는 줄 바로 위에# [0]=사과, [1]=바나나처럼 자리 의미를 반드시 주석으로 남기세요.\
추가 디버깅 팁: 수학의 (1부터)과 코드의[0](0부터)이 다르다는 점도 항상 확인하세요. ⚠️
2단계 — 벡터의 덧셈과 뺄셈
① 핵심 정의 — 무엇인가?\
벡터의 덧셈은 두 벡터에서 같은 자리에 있는 숫자끼리 더하는 연산입니다. 뺄셈도 원리는 완전히 동일합니다.
왜 필요한가?\
데이터는 대개 여러 번에 나눠서 들어옵니다. 월요일 판매량과 화요일 판매량, 1반 성적과 2반 성적, 여러 센서의 측정값 — 이렇게 흩어진 데이터를 하나로 합치거나(덧셈), 차이를 보려면(뺄셈) 벡터 연산이 필요합니다.
언제 사용하는가?\
🔹 덧셈: 여러 기간·여러 출처의 데이터를 누적할 때\
🔹 뺄셈: "목표 − 현재"로 얼마나 부족한지를 구할 때. 이 "차이 벡터"는 나중에 배울 오차(error)와 경사하강법의 출발점입니다. 🚀
💜 더 쉽게 이해하기 — 📦 택배 상자 합치기 비유
택배 상자 두 개가 도착했습니다. 첫 상자에는 (사과3, 바나나2), 둘째 상자에는 (사과1, 바나나4)가 들어 있습니다. 이 둘을 하나의 큰 상자에 옮겨 담으면 어떻게 될까요?\
\
당연히 사과는 사과끼리, 바나나는 바나나끼리 모입니다 → (4, 6). 사과와 바나나를 섞어서 더하는 사람은 없죠. 🍎🍌\
\
벡터 덧셈이 "같은 자리끼리"인 이유가 바로 이것입니다. 각 자리는 서로 다른 종류의 물건이라서, 같은 종류끼리만 합칠 수 있는 것입니다.
🔢 진행 과정
- 두 벡터의 차원이 같은지 확인한다 (다르면 계산 불가 🚫)
- 첫째 자리끼리 더한다 →
- 둘째 자리끼리 더한다 →
- (차원 수만큼 반복)
- 결과를 같은 순서로 묶는다 →
🔬 수학공식 — 성분별(element-wise) 연산
변수 정의\
• : 첫 번째 벡터 의 번째 성분\
• : 두 번째 벡터 의 번째 성분\
• : 두 벡터가 공통으로 가지는 차원 수\
\
공식이 말하는 것: 왼쪽 항의 와 오른쪽 항의 가 같다는 점이 핵심입니다. 은 오직 하고만 만나고, 절대로 와 만나지 않습니다. 이것이 "같은 자리끼리"의 수학적 표현입니다.\
\
성립 조건: — 즉 두 벡터의 차원이 같아야만 정의됩니다.
📖 수학적 의미\
벡터 덧셈에는 익숙한 성질이 그대로 성립합니다. 교환법칙 (상자를 어느 것부터 옮겨 담든 결과는 같다), 결합법칙 (셋을 어떻게 묶어 더하든 같다), 그리고 모든 성분이 0인 영벡터 은 를 만족해 "덧셈의 0" 역할을 합니다. 🧮 (00-02장에서 배울 행렬 곱셈은 교환법칙이 성립하지 않는다는 점과 대조됩니다 — 미리 기억해두세요!)
💡 직관적 의미 — 화살표를 이어 붙이기\
화살표로 보면 벡터 덧셈은 "첫 화살표 끝에서 둘째 화살표를 그대로 이어 그리는 것"입니다. 집에서 학교로, 학교에서 도서관으로 이동했다면, 최종 위치는 두 이동을 이어 붙인 결과와 같습니다. 뺄셈 는 반대로 "에서 로 가는 화살표", 즉 목표까지 남은 거리를 뜻합니다. 🧭
🖼️ 시각화 ③ — 화살표 이어 붙이기
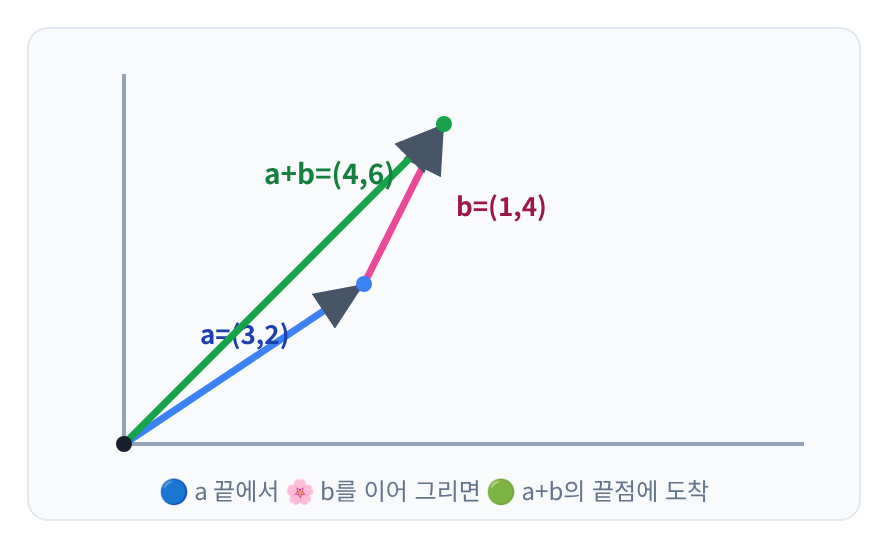
그림 1-2. 벡터 덧셈 = 화살표 이어 붙이기 (3+1=4, 2+4=6)
🖼️ 시각화 ④ — 계산 흐름
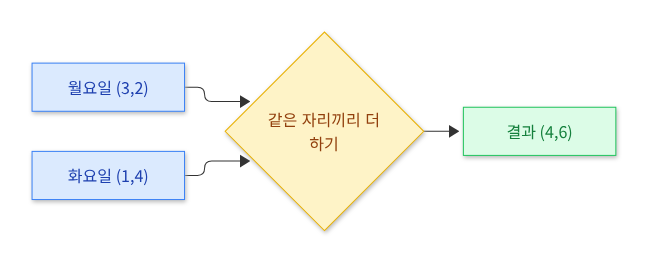
⚙️ 구현 관점\
a + b를 쓰면 파이썬은 내부적으로 a.__add__(b)를 호출합니다. NumPy는 이 메서드 안에서 반복문 없이 C 언어 수준에서 한 번에 모든 성분을 더합니다(벡터화 연산). 성분이 100만 개여도 파이썬 for문보다 수십 배 빠릅니다. 🚄
🔗 프레임워크 관점 — 다행히 다섯 프레임워크 모두 +, - 연산자를 그대로 씁니다(연산자 오버로딩).
| 개념 | NumPy | DeZero | PyTorch | TensorFlow | JAX |
|---|---|---|---|---|---|
| 덧셈 | a + b | a + b | a + b | a + b | a + b |
| 내부 함수 | np.add | Add 클래스 | torch.add | tf.add | jnp.add |
💻 코드 구현
🐍 Python
import numpy as np

# 자리 약속: [0]=사과, [1]=바나나
monday  = np.array([3, 2])   # 사과 3, 바나나 2
tuesday = np.array([1, 4])   # 사과 1, 바나나 4

# 계산 전 차원 확인 — 습관화하면 버그의 90%가 사라집니다
assert monday.shape == tuesday.shape, "차원이 다르면 더할 수 없습니다!"

# '+' 는 __add__ 를 호출해 같은 자리끼리 더해줍니다
weekly_total = monday + tuesday
print("이번 주 합계   :", weekly_total)

# 뺄셈: "목표 - 현재" = 앞으로 줄여야 할 양
# 자리 약속: [0]=몸무게(kg), [1]=체지방률(%)
goal    = np.array([65, 15])
current = np.array([72, 20])
gap = goal - current            # __sub__ 호출
print("목표까지 남은 차이:", gap)
🔗 GitHub에서 코드 보기 — 00_01_vectors_shopping_cart.py L25–L43
📘 코드 이해 — 한 줄씩 뜯어보기
| 코드 | 하는 일 |
|---|---|
assert A.shape == B.shape | 조건이 거짓이면 즉시 멈추고 메시지 출력 — 차원 불일치 버그를 조기에 잡는 안전장치 |
monday + tuesday | [3+1, 2+4]을 한 번에 계산 → [4 6] |
goal - current | [65-72, 15-20] → [-7 -5]. 음수는 "줄여야 할 양"을 뜻함 |
🧩 코드 설명 — Python 기초:
__add__와 연산자 오버로딩파이썬에서
a + b를 쓰면 내부적으로a.__add__(b)가 자동 실행됩니다. 이렇게+같은 기호에 클래스가 원하는 동작을 붙이는 것을 "연산자 오버로딩"이라고 합니다.\
덕분에 우리는np.add(a, b)대신 사람이 읽기 편한a + b를 쓸 수 있습니다. 같은 원리로-는__sub__,*는__mul__이 호출됩니다. 04-03장 DeZero에서 이 메서드들을 직접 구현하게 되니 이름을 눈에 익혀두세요! 👀
✅ 실행 결과
이번 주 합계   : [4 6]
목표까지 남은 차이: [-7 -5]
결과 는 "몸무게를 7kg 줄이고, 체지방률을 5%포인트 줄여야 목표에 도달한다"는 뜻입니다. 부호까지 의미를 가진다는 점이 중요합니다. 📉
🧪 실습 2
① 를 NumPy로 계산해보세요. (정답:
[5 15 25])\
② 같은 두 벡터로 와 를 각각 구해 교환법칙이 성립하는지np.array_equal()로 확인해보세요.
🐞 디버깅 포인트 — shape 확인
왜 틀리는가? 길이가 다른 두 벡터를 더하면
ValueError: operands could not be broadcast together오류가 납니다.\
원인은? 짝지어 더할 상대가 없는 성분이 생기기 때문입니다.\
수정 방법: 연산 직전에print(a.shape, b.shape)로 두 모양이 같은지 확인하세요. 위 코드처럼assert를 넣어두면 더 좋습니다.\
단, 예외: 스칼라(숫자 하나)와의 연산은 NumPy의 브로드캐스트 규칙에 따라 허용됩니다 — 3단계와 심화 절에서 다룹니다.
3단계 — 스칼라 곱
① 핵심 정의 — 무엇인가?\
스칼라(scalar)란 벡터가 아닌 평범한 숫자 하나(3, 0.5, −2 등)를 가리키는 이름표입니다. 스칼라 곱은 벡터의 모든 성분에 같은 스칼라를 곱하는 연산입니다.
왜 필요한가?\
데이터의 비율(패턴)은 그대로 두고 전체 크기만 조절해야 하는 상황이 매우 많기 때문입니다. 단위 변환(원→달러), 확대·축소, 그리고 머신러닝의 학습률(learning rate)을 곱하는 과정이 전부 스칼라 곱입니다. 🚀
언제 사용하는가?\
평균 구하기(합계에 곱하기), 정규화(크기로 나누기 — 4단계에서 사용), 경사하강법에서 "기울기 방향으로 조금만 이동하기" 등에 쓰입니다.
💜 더 쉽게 이해하기 — 🍞 레시피 배수 비유
빵 1개 레시피가 (계란 2개, 밀가루 100g)입니다. 손님 3명분을 만들려면? 모든 재료를 정확히 3배로 늘려야 합니다 → (6, 300).\
\
만약 계란만 3배로 늘리고 밀가루는 그대로 둔다면? 🥴 반죽 비율이 무너져 전혀 다른 음식이 됩니다. 그래서 스칼라 곱은 항상 모든 성분에 "공평하게" 적용됩니다.\
\
를 곱하면 반죽 절반, 을 곱하면 "재료를 빼는 방향"(화살표가 정반대로 뒤집힘)이 됩니다. 🔄
🔢 진행 과정
- 곱할 스칼라 를 정한다 (예: 3)
- 벡터의 첫째 성분에 를 곱한다 →
- 둘째 성분에도 같은 를 곱한다 →
- 모든 성분에 대해 반복한다
- 결과를 같은 순서로 묶는다 →
🔬 수학공식 — 스칼라 곱
변수 정의\
• : 스칼라 (그냥 숫자 하나, )\
• : 벡터, 는 그 번째 성분\
\
값에 따른 효과\
• → 화살표가 길어짐 (확대)\
• → 화살표가 짧아짐 (축소)\
• → 변화 없음 (곱셈의 항등원)\
• → 영벡터 (원점으로 붕괴)\
• → 길이 변화 + 방향이 정반대로 뒤집힘 🔄
📖 수학적 의미\
스칼라 곱에는 분배법칙 가 성립합니다. "두 상자를 합친 뒤 3배 하는 것"과 "각 상자를 3배 한 뒤 합치는 것"이 같다는 뜻입니다. 또한 크기와는 관계가 있습니다 — 절댓값 가 붙은 이유는, 음수를 곱해도 길이는 여전히 양수이기 때문입니다(방향만 뒤집힘). 4단계를 배운 뒤 다시 읽으면 더 선명해집니다. 📐
💡 직관적 의미\
스칼라 곱은 "화살표의 방향은 그대로 두고 길이만 조절하는 손잡이"입니다. 볼륨 노브를 돌리는 것과 같아서, 음악의 멜로디(비율)는 그대로 두고 소리 크기만 바꿉니다. 🔊
🖼️ 시각화 ⑤ — 방향은 유지, 길이만 변화
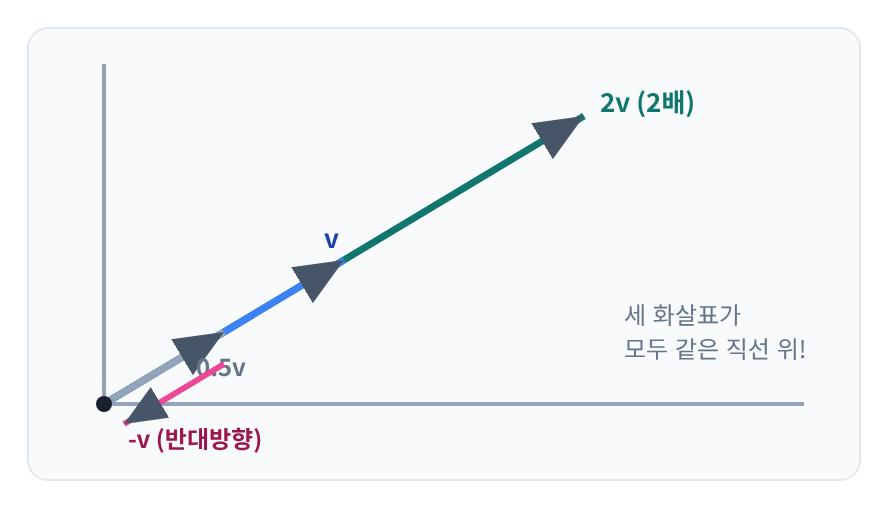
그림 1-3. 스칼라 곱 — 방향(기울기)은 그대로, 길이만 달라진다. 음수는 반대편으로 뒤집힌다
⚙️ 구현 관점\
NumPy는 3 * v를 만나면, 스칼라 3을 [3, 3]처럼 벡터 크기에 맞게 가상으로 늘려서(브로드캐스트) 성분별 곱셈을 수행합니다. 실제로 메모리에 [3,3]을 만들지는 않기 때문에 메모리 낭비도 없습니다. 💾
🔗 프레임워크 관점
| 개념 | NumPy | DeZero | PyTorch | TensorFlow | JAX |
|---|---|---|---|---|---|
| 스칼라 곱 | 3 * v | 3 * v | 3 * v | 3 * v | 3 * v |
| 성분별 곱 | a * b | Mul 클래스 | a * b | a * b | a * b |
💻 코드 구현
🐍 Python
import numpy as np

# 자리 약속: [0]=계란(개), [1]=밀가루(g)
recipe = np.array([2, 100])

recipe_x3   = 3 * recipe     # __rmul__ 호출 → 모든 성분에 3을 곱함
recipe_half = 0.5 * recipe   # 절반 레시피 (결과가 실수형으로 바뀜!)
recipe_neg  = -1 * recipe    # 방향 반전 (화살표가 정반대)

print("3배 레시피 :", recipe_x3,   "dtype:", recipe_x3.dtype)
print("절반 레시피:", recipe_half, "dtype:", recipe_half.dtype)
print("반전 레시피:", recipe_neg)

# ⚠️ 주의: 벡터끼리의 '*' 는 스칼라 곱이 아니라 "성분별 곱"입니다
print("성분별 곱  :", np.array([2, 3]) * np.array([10, 100]))
🔗 GitHub에서 코드 보기 — 00_01_vectors_shopping_cart.py L47–L61
📘 코드 이해 — 한 줄씩 뜯어보기
| 코드 | 하는 일 |
|---|---|
3 * recipe | 스칼라가 왼쪽에 있으므로 __rmul__(오른쪽 곱셈)이 호출됨 → [6 300] |
0.5 * recipe | 정수 벡터에 소수를 곱해 dtype이 float64로 승격 → [1. 50.] |
-1 * recipe | 모든 성분의 부호가 뒤집힘 → 화살표가 정반대 방향 |
[2,3] * [10,100] | 벡터 × 벡터는 같은 자리끼리 곱함(성분별 곱) → [20 300]. 내적(5단계)과 다름! ⚠️ |
🧩 코드 설명 — Python 기초:
__mul__vs__rmul__
v * 3처럼 벡터가 왼쪽이면v.__mul__(3)이 호출됩니다. 그런데3 * v처럼 스칼라가 왼쪽이면 파이썬은 먼저int.__mul__(v)를 시도하고, 정수는 벡터를 곱할 줄 모르므로 실패합니다. 이때 파이썬이 순서를 뒤집어v.__rmul__(3)을 호출합니다 — r은 reflected(반사된)의 약자입니다. 덕분에3 * v와v * 3둘 다 잘 동작합니다. ✨
✅ 실행 결과
3배 레시피 : [  6 300] dtype: int64
절반 레시피: [ 1. 50.] dtype: float64
반전 레시피: [  -2 -100]
성분별 곱  : [ 20 300]
🧪 실습 3
① 벡터 를 배 해보고, 원래 비율()이 유지되는지 확인해보세요.\
② 분배법칙 가 실제로 성립하는지 코드로 검증해보세요. (힌트:np.array_equal)
🐞 디버깅 포인트 — dtype 확인
왜 틀리는가? 정수 벡터에 소수를 곱했더니 결과가 갑자기
[1. 50.]처럼 소수점 표기로 바뀌어 당황하는 경우입니다.\
원인은? NumPy는 정보 손실을 막기 위해 더 넓은 자료형(float64)으로 자동 승격합니다. 오류가 아니라 안전장치입니다.\
수정 방법: 의도한 자료형인지print(result.dtype)으로 확인하고, 정수가 필요하면.astype(int)로 명시적으로 변환하세요.\
반대 함정 ⚠️: 정수끼리 나눗셈v // 2는 소수점을 버립니다. 평균 계산 시/와//를 혼동하지 마세요.
4단계 — 벡터의 크기(Norm)
① 핵심 정의 — 무엇인가?\
벡터를 화살표로 그렸을 때, 원점(출발점)에서 끝점까지의 직선 거리를 벡터의 크기(Norm)라고 부르고 로 씁니다.
왜 필요한가?\
"이 데이터가 얼마나 큰가", "두 데이터가 얼마나 멀리 떨어져 있는가"를 하나의 숫자로 말할 수 있어야 하기 때문입니다. 크기를 알아야 정규화(크기를 1로 맞추기), 거리 기반 검색, 오차의 크기 측정이 가능해집니다.
언제 사용하는가?\
🔹 두 데이터의 유사도를 거리로 잴 때(추천·검색)\
🔹 손실 함수에서 "예측과 정답의 차이 벡터"가 얼마나 큰지 잴 때\
🔹 5단계 코사인 유사도의 분모로 쓸 때 ⭐
💜 더 쉽게 이해하기 — 📐 대각선 지름길 비유
공원에서 동쪽으로 3칸, 북쪽으로 4칸 떨어진 벤치까지 가야 합니다. 길을 따라 ㄱ자로 돌아가면 3+4=7칸을 걸어야 하죠.\
\
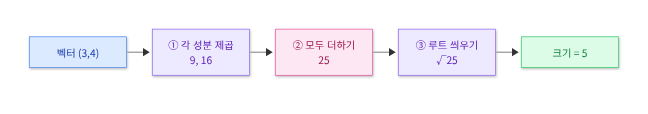
그런데 잔디밭을 가로질러 대각선으로 곧장 걸어가면 딱 5칸이면 도착합니다. 🚶 이 "지름길 거리 5"가 바로 벡터 의 크기입니다.\
\
즉 Norm은 "성분들을 단순히 더한 값(7)"이 아니라 "실제로 얼마나 멀리 왔는가(5)"를 재는 자입니다.
🔢 진행 과정
- 각 성분을 제곱한다 → , (음수를 없애기 위함)
- 제곱한 값들을 모두 더한다 →
- 더한 값에 루트(제곱근)를 씌운다 → (제곱했던 것을 원래 단위로 되돌림)
- 결과는 항상 0 이상의 숫자 하나 (거리에 음수는 없다)
🔬 수학공식 — 공식 유도 (단계별)
① 출발: 직각삼각형 만들기\
벡터 를 그리면 가로 변 3, 세로 변 4인 직각삼각형이 생기고, 우리가 구할 화살표는 그 빗변입니다.\
② 피타고라스 정리 적용③ 계산
④ 2차원 일반화
⑤ n차원으로 확장 — 차원이 늘어도 "제곱해서 더하고 루트" 규칙은 그대로입니다.
변수 정의\
• : 벡터의 번째 성분\
• : 차원 수\
• : 노름 기호 (막대기 두 개 — 절댓값 과 구분!)\
• : 시그마, "모두 더하라"는 뜻
📖 수학적 의미 — 이 Norm의 정식 이름은 "L2 노름"\
지금 배운 "제곱해서 더하고 루트"는 정확히는 L2 노름(유클리드 노름)입니다. 거리를 재는 방법이 하나뿐은 아니기 때문에 이름이 필요합니다. 다른 방식도 잠깐 소개하면, L1 노름 은 "격자 길을 따라 돌아가는 거리"(맨해튼 거리)로, 앞의 비유에서 ㄱ자로 돌아간 7칸에 해당합니다. 🏙️ 머신러닝의 정규화(L1/L2 regularization)에서 다시 만나게 되지만, 지금은 L2만 확실히 익히면 충분합니다.
💡 직관적 의미 — 크기와 방향의 분리\
벡터를 크기 로 나누면 길이가 정확히 1인 벡터(단위벡터) 가 됩니다. 이것을 정규화(normalization)라고 합니다. 이 과정을 거치면 "크기 정보는 버리고 방향 정보만" 남습니다. 🧭 5단계 코사인 유사도가 정확히 이 아이디어를 사용합니다 — 영화 평점을 후하게 주는 사람과 짜게 주는 사람의 취향 방향만 비교하기 위해서죠.
🖼️ 시각화 ⑥ — 피타고라스 정리로 크기 구하기
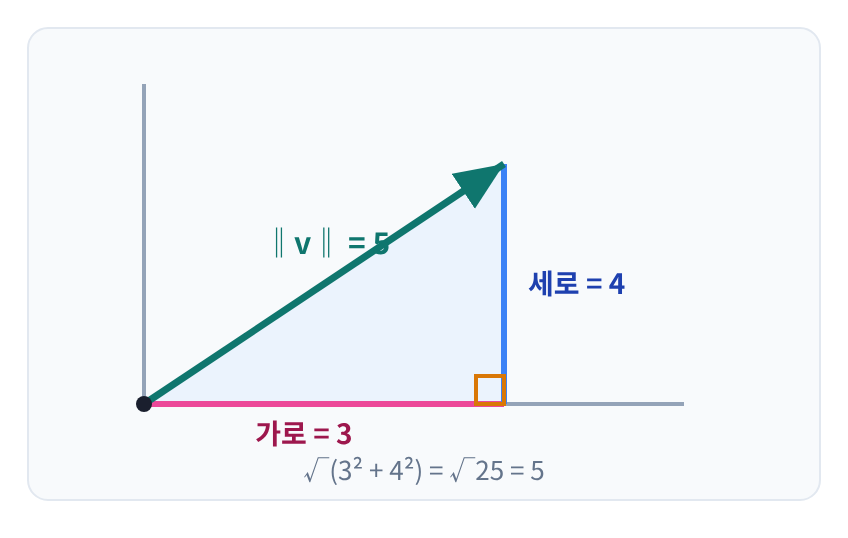
그림 1-4. 3-4-5 직각삼각형 — 벡터의 크기는 빗변의 길이다
⚙️ 구현 관점\
np.linalg.norm(v)는 내부적으로 np.sqrt(np.sum(v**2))을 수행합니다. linalg는 linear algebra(선형대수)의 줄임말로, 벡터·행렬 전용 함수들이 모여 있는 NumPy의 하위 모듈입니다. 직접 구현할 수도 있지만, norm은 아주 큰 값에서 오버플로가 나지 않도록 내부적으로 더 안전하게 계산합니다. 🛡️
🔗 프레임워크 관점
| 개념 | NumPy | DeZero | PyTorch | TensorFlow | JAX |
|---|---|---|---|---|---|
| L2 Norm | np.linalg.norm(v) | 직접 구현 | torch.linalg.norm(v) | tf.norm(v) | jnp.linalg.norm(v) |
| L1 Norm | norm(v, ord=1) | 직접 구현 | norm(v, ord=1) | tf.norm(v, ord=1) | norm(v, ord=1) |
💻 코드 구현
🐍 Python
import numpy as np

v = np.array([3, 4])

# 방법 1) 공식을 그대로 구현: √(3² + 4²)
manual = np.sqrt(np.sum(v ** 2))

# 방법 2) 전용 함수 (실무 권장)
builtin = np.linalg.norm(v)

print("직접 계산 :", manual)    # 5.0
print("norm 함수 :", builtin)   # 5.0

# 3차원도 규칙은 동일: √(1+4+4) = √9 = 3
print("3차원 크기:", np.linalg.norm(np.array([1, 2, 2])))

# 음수가 있어도 제곱하면 양수 → 크기는 절대 음수가 될 수 없음
print("(-3,4) 크기:", np.linalg.norm(np.array([-3, 4])))

# 정규화: 크기로 나누면 길이가 1인 "방향만 남은" 단위벡터가 됩니다
unit = v / np.linalg.norm(v)
print("단위벡터  :", unit, "| 그 크기:", np.linalg.norm(unit))
🔗 GitHub에서 코드 보기 — 00_01_vectors_shopping_cart.py L65–L86
📘 코드 이해 — 한 줄씩 뜯어보기
| 코드 | 하는 일 / 공식 대응 |
|---|---|
v ** 2 | 모든 성분을 제곱 → [9 16] · 공식의 |
np.sum(...) | 전부 더하기 → 25 · 공식의 |
np.sqrt(...) | 루트 씌우기 → 5.0 · 공식의 |
np.linalg.norm(v) | 위 세 줄을 한 번에 · 실무에서는 이것만 쓰면 됨 |
v / np.linalg.norm(v) | 정규화 → 크기 1인 단위벡터 |
🧩 코드 설명 — Python 기초: ``와 벡터 나눗셈**
•
**는 거듭제곱 연산자입니다.v ** 2는 벡터의 모든 성분에 제곱을 적용합니다(성분별 연산).\
•v / 5.0처럼 벡터를 숫자 하나로 나누면 브로드캐스트가 작동해 모든 성분이 5로 나눠집니다. 이것이 정규화 코드가 한 줄로 끝나는 이유입니다.\
• 반환값이5.0처럼 소수인 이유는, 루트 계산 결과가 항상 실수(float)이기 때문입니다.
✅ 실행 결과
직접 계산 : 5.0
norm 함수 : 5.0
3차원 크기: 3.0
(-3,4) 크기: 5.0
단위벡터  : [0.6 0.8] | 그 크기: 1.0
공식을 그대로 옮긴 결과와 전용 함수의 결과가 정확히 같습니다. 그리고 정규화한 [0.6 0.8]의 크기가 정확히 1.0이 된 것도 확인됩니다 — 방향은 그대로, 길이만 1로 맞춘 것입니다. 🎯
🧪 실습 4
① 벡터 의 크기를 손으로 계산한 뒤
np.linalg.norm으로 검증하세요. (정답: 10)\
② 그 벡터를 정규화하고, 결과의 크기가 정말 1인지 출력해보세요. (정답:[0.6 0.8])\
③np.linalg.norm(v, ord=1)로 L1 노름도 구해보고 L2와 값이 왜 다른지 설명해보세요.
🐞 디버깅 포인트
실수 ① — "성분에 음수가 있으니 크기도 음수겠지?" ❌ 제곱하는 순간 음수는 사라지므로 Norm은 절대 음수가 될 수 없습니다. 입니다.\
실수 ② — 성분을 그냥 더하기(). ❌ 그건 L1 노름이고, 기본은 L2()입니다.\
실수 ③ — 영벡터 정규화: 모든 성분이 0인 벡터를 정규화하면0/0이 되어nan+RuntimeWarning이 발생합니다. 나누기 전에if norm > 1e-10:같은 조건을 반드시 넣으세요. ⚠️
5단계 — 내적(Dot Product)과 코사인 유사도
① 핵심 정의 — 무엇인가?\
내적은 두 벡터에서 같은 자리의 숫자끼리 곱한 뒤 모두 더한 값입니다. 결과는 벡터가 아니라 숫자 하나(스칼라)입니다. 그래서 "스칼라 곱(scalar product)"이라고도 부릅니다.
왜 필요한가?\
"두 데이터가 얼마나 비슷한 방향(패턴)을 가지고 있는가"를 단 하나의 숫자로 압축할 수 있기 때문입니다. 넷플릭스·유튜브·검색엔진의 추천, 챗봇의 문장 유사도 판별이 전부 이 원리로 동작합니다. 게다가 00-02장에서 배울 행렬 곱셈과 신경망의 뉴런 계산도 결국 내적의 반복입니다. ⭐
언제 사용하는가?\
유사도 계산, 추천 시스템, 검색 랭킹, 그리고 신경망의 "입력 × 가중치" 계산 — 머신러닝에서 가장 자주 등장하는 연산입니다.
💜 더 쉽게 이해하기 — 🎬 영화 취향 비유
영화를 (액션, 로맨스, 공포) 점수로 표현해봅시다.\
• 영화 A = (5, 1, 0) — 액션 영화 💥\
• 영화 B = (4, 2, 1) — 액션 위주에 살짝 다른 요소 💥\
• 영화 C = (0, 5, 0) — 순수 로맨스 💕\
\
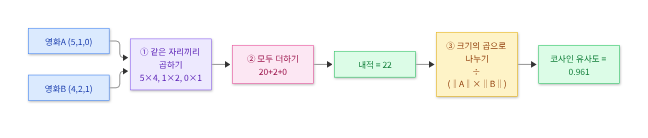
"같은 자리끼리 곱해서 더하면" A·B = 5×4 + 1×2 + 0×1 = 22, A·C = 5×0 + 1×5 + 0×0 = 5가 나옵니다.\
\
왜 A·B가 클까요? 둘 다 액션 점수가 높아서 "큰 수 × 큰 수"가 만났기 때문입니다. 반대로 A·C는 한쪽이 높으면 다른 쪽이 0이라 곱이 죽어버립니다. 🎯 내적이 크다 = 강조하는 항목이 서로 겹친다 = 비슷하다는 뜻입니다.
🔢 진행 과정
- 두 벡터의 차원이 같은지 확인한다
- 첫째 자리끼리 곱한다 →
- 둘째 자리끼리 곱한다 → , 셋째 →
- 곱한 값들을 모두 더한다 → ← 내적 완성
- (유사도가 필요하면) 두 벡터의 크기 곱으로 나눈다 → 코사인 유사도
🔬 수학공식 ① — 내적의 정의
변수 정의\
• : 차원이 같은 두 벡터\
• : 각 벡터의 번째 성분\
• : 내적 기호 (가운뎃점) — 일반 곱셈 와 구분\
• 결과는 스칼라(숫자 하나)이지 벡터가 아님 ⚠️
🔬 수학공식 ② — 각도와의 관계, 그리고 코사인 유사도 유도
두 벡터가 이루는 각도를 라 하면, 코사인 법칙으로부터 다음 관계가 유도됩니다(결과만 사용합니다).
① 식 (1)의 양변을 로 나누면
② 이 값을 코사인 유사도라 부릅니다
직관 💡 — 내적을 두 벡터의 크기로 나눔으로써 "얼마나 큰가"는 지워지고 "방향이 얼마나 같은가"만 남습니다. 그래서 결과는 항상 범위에 들어옵니다.
📖 수학적 의미 — 각도별 해석
| 각도 | 기하적 의미 | 추천 시스템에서의 해석 | |
|---|---|---|---|
| 0° | 완전히 같은 방향 | 1 (최댓값) | 취향이 판박이 — 강력 추천 🎯 |
| 90° | 직각(서로 무관) | 0 | 겹치는 취향 없음 — 탐색용 추천 🧭 |
| 180° | 완전히 반대 방향 | −1 (최솟값) | 취향이 정반대 — 추천 제외 🚫 |
💡 직관적 의미 — 왜 내적이 아니라 "코사인" 유사도인가?\
내적만 쓰면 문제가 생깁니다. 별점을 후하게 주는 사람의 벡터는 성분이 전부 커서, 취향과 무관하게 내적이 크게 나옵니다. 📈 코사인 유사도는 크기로 나눠서 이 "후함/짬"의 영향을 제거하고 순수한 취향의 방향만 비교합니다. 그래서 실무 추천 시스템은 대부분 내적이 아닌 코사인 유사도를 씁니다. ⭐
🖼️ 시각화 ⑦ — 각도로 보는 유사도
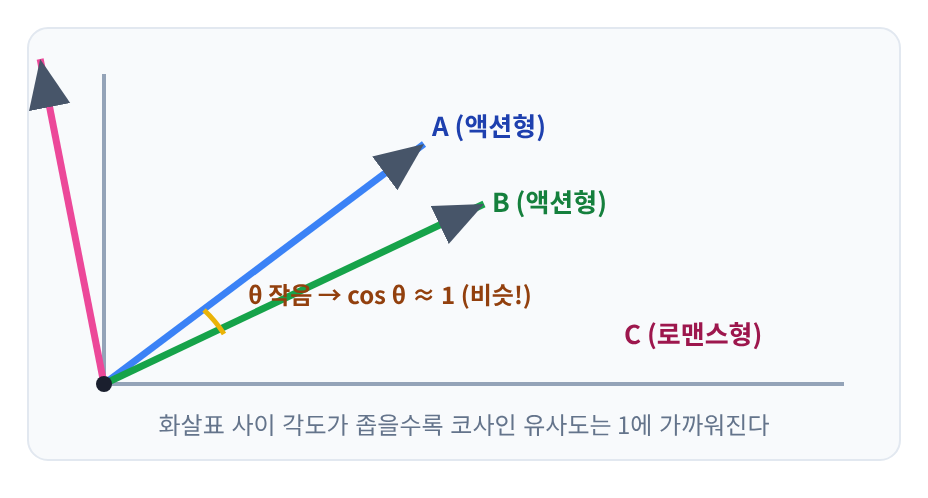
그림 1-5. 코사인 유사도는 "길이"가 아니라 "각도"를 본다
⚙️ 구현 관점\
np.dot(a, b)는 내부적으로 a[0]*b[0] + a[1]*b[1] + ...를 파이썬 반복문 없이 한 번에 계산합니다(벡터화 연산). 성분이 300개인 워드 임베딩 100만 개를 비교하는 일도 이 덕분에 현실적인 시간 안에 끝납니다. 🚄 참고로 np.dot은 00-02장에서 행렬을 만나면 행렬 곱셈으로 확장됩니다 — 즉 행렬 곱셈은 내적의 반복입니다.
🔗 프레임워크 관점
| 개념 | NumPy | DeZero | PyTorch | TensorFlow | JAX |
|---|---|---|---|---|---|
| 내적 | np.dot(a,b) | 직접 구현 | torch.dot(a,b) | tf.tensordot(a,b,1) | jnp.dot(a,b) |
| 코사인 유사도 | 직접 구현 | 직접 구현 | F.cosine_similarity | keras.losses.cosine_similarity | 직접 구현 |
💻 코드 구현
🐍 Python
import numpy as np

# 자리 약속: [0]=액션, [1]=로맨스, [2]=공포
movie_a = np.array([5, 1, 0])   # 액션 영화
movie_b = np.array([4, 2, 1])   # 액션 위주
movie_c = np.array([0, 5, 0])   # 순수 로맨스

print("A·B 내적:", np.dot(movie_a, movie_b))  # 20+2+0 = 22
print("A·C 내적:", np.dot(movie_a, movie_c))  # 0+5+0 = 5

def cosine_similarity(x, y, eps=1e-10):
    """
    두 벡터가 얼마나 비슷한 '방향'을 가리키는지 -1~1 사이 값으로 반환합니다.

    비유:
    두 사람이 걸어가는 방향이 같으면 1,
    직각이면 0, 정반대면 -1.
    (얼마나 '빨리' 걷는지=크기 는 무시하고 방향만 봅니다)
    """
    dot_value  = np.dot(x, y)                              # 분자: 내적
    norm_product = np.linalg.norm(x) * np.linalg.norm(y)   # 분모: 크기의 곱
    if norm_product < eps:      # 영벡터 방어 → 0으로 나누기 방지
        return 0.0
    return dot_value / norm_product

print("A-B 유사도:", round(cosine_similarity(movie_a, movie_b), 3))
print("A-C 유사도:", round(cosine_similarity(movie_a, movie_c), 3))
print("영벡터 방어:", cosine_similarity(movie_a, np.array([0, 0, 0])))
🔗 GitHub에서 코드 보기 — 00_01_vectors_shopping_cart.py L90–L117
📘 코드 이해 — 한 줄씩 뜯어보기
| 코드 | 하는 일 / 공식 대응 |
|---|---|
np.dot(x, y) | 공식 — 곱해서 전부 더하기 (분자) |
norm(x) * norm(y) | 공식의 분모 — 두 크기를 곱함 |
if norm_product < eps | 영벡터 방어. eps는 "아주 작은 수"로, 0과의 직접 비교를 피하는 실무 관례 |
return dot / norm_product | 완성 — 결과는 항상 −1 ~ 1 |
round(..., 3) | 소수점 셋째 자리까지 반올림해 읽기 좋게 출력 |
🧩 코드 설명 — Python 기초: docstring과 기본 인자
• docstring (
""" """): 함수 바로 아래에 쓰는 설명글입니다.help(cosine_similarity)를 호출하면 그대로 출력되는 "코드의 사용 설명서"입니다.\
• 기본 인자eps=1e-10: 호출할 때 생략하면 자동으로1e-10이 쓰입니다.1e-10은 을 뜻하는 지수 표기입니다.\
• 함수 이름: 지시서 규칙대로 함수는snake_case(소문자+밑줄)로 씁니다. 클래스라면PascalCase였겠죠.
✅ 실행 결과
A·B 내적: 22
A·C 내적: 5
A-B 유사도: 0.961
A-C 유사도: 0.196
영벡터 방어: 0.0
A–B는 0.961(거의 1 → 매우 비슷), A–C는 0.196(0에 가까움 → 별로 안 비슷)입니다. 이 숫자 하나로 "이 사용자에게 B를 추천하고 C는 뒤로 미루자"는 판단이 가능해집니다. 이것이 추천 시스템의 가장 단순한 형태입니다. 🚀
🧪 실습 5
① 벡터 과 의 내적과 코사인 유사도를 계산하고, 왜 0이 나오는지 각도로 설명해보세요.\
② 영화 D = (10, 2, 0)을 추가해보세요. A와 내적은 훨씬 커지지만 코사인 유사도는 거의 그대로인 것을 확인하고, 그 이유를 설명해보세요. (힌트: D는 A와 방향은 같고 크기만 2배)\
③ 반복문(for)만으로 내적을 직접 구현하고np.dot과 결과를 비교해보세요.
🐞 실수하기 쉬운 부분 & 디버깅
실수 ①
*와np.dot혼동 —a * b는 성분별 곱이라 결과가 벡터([20 2 0])이고,np.dot(a,b)는 내적이라 결과가 숫자(22)입니다. 원인은 두 연산이 이름이 비슷해서입니다. 수정: "결과가 숫자여야 하면np.dot"이라고 외우세요.\
실수 ② 분모 0 — 모든 성분이 0인 영벡터가 들어오면0/0→nan이 됩니다. 위 코드처럼eps방어를 반드시 넣으세요.\
실수 ③ 차원 불일치 — 길이가 다른 두 벡터에np.dot을 쓰면ValueError: shapes not aligned가 납니다.print(a.shape, b.shape)로 확인하세요.\
실수 ④ 정수 나눗셈 — 유사도는 소수이므로, dtype이 정수여도/(참나눗셈)를 써야 합니다.//를 쓰면 0이 나옵니다. ⚠️
심화 내용 🔴 — 브로드캐스트와 벡터화
① 브로드캐스트(broadcasting)\
NumPy는 벡터와 스칼라를 연산할 때, 스칼라를 벡터와 같은 크기로 "가상으로 복제"해서 계산합니다. 예를 들어 np.array([1,2,3]) + 10은 10을 [10,10,10]으로 확장한 뒤 더한 것과 같은 결과를 냅니다. 실제로 메모리에 복사본을 만들지는 않으므로 빠르고 메모리도 아낍니다. 💾
💜 더 쉽게 이해하기 — 📢 확성기 비유
선생님이 반 전체에게 "모두 10점씩 가산!"이라고 한 번 외치면, 30명 학생 각자에게 10점이 적용됩니다. 선생님이 30번 말할 필요도, 10점짜리 쪽지 30장을 인쇄할 필요도 없습니다. 이것이 브로드캐스트입니다. 📢
② 벡터화(vectorization)가 왜 빠른가?\
파이썬 for문은 숫자 하나를 처리할 때마다 파이썬 인터프리터를 거칩니다. 반면 NumPy 연산은 C로 컴파일된 코드가 메모리에 붙어 있는 숫자들을 한 번에 처리합니다. 같은 계산이라도 수십~수백 배 차이가 납니다. 머신러닝 코드에서 "for문을 없애라"는 조언이 나오는 이유입니다. 🚄
③ 이 개념이 왜 중요한가\
00-02 행렬과 이후 신경망에서 배치(batch) 데이터를 처리할 때, "데이터 100개 × 특징 300개"를 한 번에 계산하는 것이 전부 브로드캐스트와 벡터화 덕분입니다. 지금은 "스칼라가 자동으로 늘어난다"는 감각만 잡아두면 충분합니다. 🔑
🐍 Python
import numpy as np
import time

scores = np.array([70, 80, 90])
print("전원 10점 가산:", scores + 10)   # 브로드캐스트

# 속도 비교: 100만 개 원소의 합
big = np.arange(1_000_000)

t0 = time.time(); total_loop = 0
for x in big:            # 느린 방식: 파이썬 for문
    total_loop += x
t1 = time.time(); total_vec = big.sum()   # 빠른 방식: 벡터화
t2 = time.time()

print("for문  :", round(t1 - t0, 4), "초")
print("벡터화 :", round(t2 - t1, 4), "초")
🔗 GitHub에서 코드 보기 — 00_01_vectors_shopping_cart.py L121–L137
✅ 실행 결과 (환경에 따라 수치는 달라집니다)
전원 10점 가산: [ 80  90 100]
for문  : 0.0812 초
벡터화 : 0.0007 초
같은 계산인데 100배 이상 차이가 납니다. 벡터를 쓰는 이유가 "수학적으로 우아해서"만은 아니라는 것을 보여줍니다. ⚡
🔗 프레임워크 비교 종합표
| 개념 | NumPy | DeZero | PyTorch | TensorFlow | JAX |
|---|---|---|---|---|---|
| 벡터 생성 | np.array | Variable | torch.tensor | tf.constant | jnp.array |
| 덧셈·뺄셈 | a+b | a+b | a+b | a+b | a+b |
| 스칼라 곱 | c*v | c*v | c*v | c*v | c*v |
| Norm | np.linalg.norm | 직접 구현 | torch.linalg.norm | tf.norm | jnp.linalg.norm |
| 내적 | np.dot | 직접 구현 | torch.dot | tf.tensordot | jnp.dot |
| 코사인 유사도 | 직접 구현 | 직접 구현 | F.cosine_similarity | keras.losses.cosine_similarity | 직접 구현 |
👉 함수 이름만 다를 뿐 수학 공식은 완전히 동일합니다. NumPy로 원리를 이해했다면 나머지는 문법 사전만 있으면 됩니다.
✏️ 연습문제
[개념 문제 1] 벡터와 스칼라의 차이를 한 문장으로 설명하시오.
[개념 문제 2] 벡터 덧셈에서 "두 벡터의 차원이 같아야 한다"는 조건이 왜 필요한지, 장바구니 비유로 설명하시오.
[계산 문제 1] 을 계산하시오.
[계산 문제 2] 벡터 의 크기 를 구하고, 이를 정규화한 단위벡터를 구하시오.
[계산 문제 3] , 의 내적을 손으로 계산하시오.
[구현 문제] NumPy로 두 벡터의 코사인 유사도를 계산하는 함수를 작성하되, 영벡터(0으로 나누기) 예외까지 처리하시오.
[사고 확장 문제 1] 두 벡터의 내적이 0이라면, 실제 서비스(예: 추천 시스템)에서는 이를 어떻게 해석하고 활용할 수 있을지 설명하시오.
[사고 확장 문제 2] 별점을 후하게 주는 사용자와 짜게 주는 사용자를 비교할 때, 내적 대신 코사인 유사도를 쓰는 것이 왜 더 공정한지 설명하시오.
💡 해설
[개념 1] 벡터는 순서가 있는 숫자 여러 개의 묶음이고, 스칼라는 숫자 하나입니다.\
\
[개념 2] 각 자리는 서로 다른 품목을 뜻합니다. 한쪽에만 세 번째 품목(우유)이 있다면 짝지어 더할 상대가 없으므로 계산 자체가 정의되지 않습니다. 🍎🍌🥛\
\
[계산 1] 같은 자리끼리 더하면 \
\
[계산 2] . 단위벡터는 이며, 이 벡터의 크기는 정확히 1입니다.\
\
[계산 3] \
\
[구현] 분모(크기의 곱)가 0에 가까울 때 0을 반환하도록 방어합니다.\
if norm_product < 1e-10: return 0.0← 0과 직접 비교하지 않고 아주 작은 수(eps)와 비교하는 것이 실무 관례입니다. 부동소수점 오차 때문에 "정확히 0"인 경우가 드물기 때문입니다.\
\
[사고 1] 내적이 0이면 두 벡터가 직각, 즉 "겹치는 특성이 전혀 없다"는 뜻입니다. 추천 시스템에서는 유사 추천에는 부적합하지만, 오히려 사용자에게 새로운 취향을 제안하는 "탐색(발견) 추천"에 활용할 수 있습니다. 🧭\
\
[사고 2] 후하게 주는 사용자는 모든 성분이 커서 내적 값 자체가 무조건 커집니다 — 취향이 비슷해서가 아니라 단지 점수를 크게 줬기 때문입니다. 코사인 유사도는 각 벡터의 크기로 나눠 이 영향을 제거하므로, "얼마나 후하게 주는가"가 아닌 "무엇을 더 좋아하는가(방향)"만 비교하게 됩니다. ⚖️
🎯 이번 장에서 배운 내용
🛒 벡터의 정의 — 순서가 있는 숫자 묶음\
➕ 덧셈·뺄셈 — 같은 자리끼리, 차원이 같아야 가능\
✖️ 스칼라 곱 — 모든 성분에 공평하게, 방향 유지\
📐 Norm — 피타고라스 정리로 구한 화살표 길이\
🎬 내적·코사인 유사도 — "비슷함"을 숫자 하나로 압축\
🔴 브로드캐스트·벡터화 — 빠르게 계산하는 원리
📌 핵심 문장 3가지
1) 벡터는 순서를 약속하고 나란히 적은 숫자들의 묶음이다.\
2) 벡터 연산은 언제나 "같은 자리"끼리 이루어진다.\
3) 내적과 코사인 유사도는 "비슷함"을 숫자로 바꾸는 도구이며, AI 추천의 심장이다.
✅ 개념 체크리스트 (성취 기준)
☐ 벡터 을 장바구니 비유로 설명할 수 있다 🟢\
☐ 벡터의 "차원"이 무엇을 뜻하는지 말할 수 있다 🟢\
☐ 를 손으로 계산할 수 있다 🟢\
☐ 벡터 덧셈에 왜 차원 일치 조건이 필요한지 설명할 수 있다 🟢\
☐ 스칼라가 무엇이고 왜 "공평하게" 곱해야 하는지 설명할 수 있다 🟢\
☐ 일 때 벡터에 어떤 일이 일어나는지 말할 수 있다 🔵\
☐ 벡터 의 크기를 피타고라스 정리로 계산할 수 있다 (정답 10) 🔵\
☐ 정규화(단위벡터)가 무엇이고 왜 하는지 설명할 수 있다 🔵\
☐ 두 벡터의 내적이 클수록 무엇을 의미하는지 설명할 수 있다 🔵\
☐ 내적 대신 코사인 유사도를 쓰는 이유를 설명할 수 있다 🔵 ⭐\
☐ NumPy로 덧셈·스칼라곱·Norm·내적·코사인 유사도를 직접 실행할 수 있다 🟢\
☐ 브로드캐스트가 무엇인지 예시로 설명할 수 있다 🔴
🚧 실수 방지 체크리스트
☐ 두 벡터의 차원(shape)이 같은지 확인했는가\
☐ 각 성분의 "자리 의미"를 주석으로 적어두었는가\
☐ 수학의 (1부터)과 코드의 [0](0부터)을 혼동하지 않았는가\
☐ 스칼라 곱·나눗셈 후 dtype이 의도대로인지 확인했는가 (/ vs //)\
☐ a * b(성분별 곱)와 np.dot(a,b)(내적)를 혼동하지 않았는가\
☐ Norm을 구할 때 성분을 그냥 더하지(L1) 않고 제곱→합→루트(L2)를 했는가\
☐ 코사인 유사도 계산 시 분모(영벡터)가 0이 아닌지 방어했는가\
☐ HTML 태그가 모두 닫혔는가 / Mermaid 노드 ID를 ASCII로 썼는가\
☐ <, >를 이스케이프했는가\
☐ 수식 변수명()과 코드 변수명(a[i])이 일관되는가
🚀 추가 학습 추천
🖊️ 직접 구현 — 반복문(for)만으로 내적·Norm을 구현하고 np.dot·np.linalg.norm과 속도를 비교해보세요.\
🔥 PyTorch 비교 — torch.tensor로 동일한 다섯 연산을 수행하고 결과가 같은지 확인해보세요.\
📊 TensorFlow 비교 — tf.constant와 tf.tensordot으로 재현하고 문법 차이를 표로 정리해보세요.\
⚡ JAX 비교 — jnp로 실행해보고 jit 적용 전후의 속도 차이를 느껴보세요.\
🎬 미니 프로젝트 — 좋아하는 영화 5편을 (액션, 로맨스, 공포, 코미디) 4차원 벡터로 직접 만들고, 코사인 유사도로 "나만의 추천 순위표"를 출력해보세요! 🍿
➡️
🔮 다음 장 예고 — 00-02. 행렬(Matrix) — 성적표는 곧 행렬이다
이번 장에서 배운 "숫자 한 줄(벡터)"이 여러 개 모이면 "표(행렬)"가 됩니다. 학생 한 명의 성적은 벡터였지만, 반 전체의 성적표는 행렬입니다. 📋\
\
다음 장에서는 엑셀 표와 똑같이 생긴 행렬을 배우고, 행렬 곱셈이 사실은 이번 장에서 배운 "내적"의 반복일 뿐이라는 사실을 확인합니다. 그리고 마침내 "입력 × 가중치 = 출력"이라는 한 줄로, AI의 핵심 부품인 신경망 한 층이 어떻게 작동하는지 직접 계산해봅니다! 🤖✨
💻 GitHub 실습 — 코드로 직접 확인하기
📂 이 장의 코드 폴더: book/00-math-overview-for-beginners/00-01-vectors-shopping-cart
책에 실린 코드를 장(절)별로 모아 둔 폴더입니다. 아래 파일을 열어 보거나, Colab에서 바로 실행해 보세요.
| 파일 | 용도 | 링크 |
|---|---|---|
00_01_vectors_shopping_cart.py | 책의 코드 블록 6개를 순서대로 모은 실행 스크립트 (# %% 셀 구분) | 코드 보기 |
00_01_vectors_shopping_cart.ipynb | 같은 코드를 블록당 셀 1개로 담은 주피터 노트북 | 보기 · Colab |
README.md | 코드 블록 목록 · 실행 방법 · 검증 결과 | 보기 |
🎬 medium-series/03-vectors/ | Medium 시리즈 예제 — 같은 주제를 블로그용으로 다듬은 실습 | 폴더 · Colab |
🧪 저장소 검증 상태: ✅ 실행 OK
🔑 핵심 코드 1 — 내적과 코사인 유사도 — 영화 취향 비교
📄 00_01_vectors_shopping_cart.py L90–L117 · Block 5 (5단계 — 내적(Dot Product)과 코사인 유사도)
import numpy as np

# 자리 약속: [0]=액션, [1]=로맨스, [2]=공포
movie_a = np.array([5, 1, 0])   # 액션 영화
movie_b = np.array([4, 2, 1])   # 액션 위주
movie_c = np.array([0, 5, 0])   # 순수 로맨스

print("A·B 내적:", np.dot(movie_a, movie_b))  # 20+2+0 = 22
print("A·C 내적:", np.dot(movie_a, movie_c))  # 0+5+0 = 5

def cosine_similarity(x, y, eps=1e-10):
    """
    두 벡터가 얼마나 비슷한 '방향'을 가리키는지 -1~1 사이 값으로 반환합니다.

    비유:
    두 사람이 걸어가는 방향이 같으면 1,
    직각이면 0, 정반대면 -1.
    (얼마나 '빨리' 걷는지=크기 는 무시하고 방향만 봅니다)
    """
    dot_value  = np.dot(x, y)                              # 분자: 내적
    norm_product = np.linalg.norm(x) * np.linalg.norm(y)   # 분모: 크기의 곱
    if norm_product < eps:      # 영벡터 방어 → 0으로 나누기 방지
        return 0.0
    return dot_value / norm_product

print("A-B 유사도:", round(cosine_similarity(movie_a, movie_b), 3))
print("A-C 유사도:", round(cosine_similarity(movie_a, movie_c), 3))
print("영벡터 방어:", cosine_similarity(movie_a, np.array([0, 0, 0])))
▶ 실행 결과 — 위 코드를 실행한 출력 (직접 실행: Windows · Python 3.11.2 · numpy 2.4.6, 앞 블록부터 순서대로 실행)
A·B 내적: 22
A·C 내적: 5
A-B 유사도: 0.942
A-C 유사도: 0.196
영벡터 방어: 0.0
🔑 핵심 코드 2 — 브로드캐스트와 벡터화 — for문 vs NumPy 속도 비교
📄 00_01_vectors_shopping_cart.py L121–L137 · Block 6 (심화 내용 🔴 — 브로드캐스트와 벡터화)
import numpy as np
import time

scores = np.array([70, 80, 90])
print("전원 10점 가산:", scores + 10)   # 브로드캐스트

# 속도 비교: 100만 개 원소의 합
big = np.arange(1_000_000)

t0 = time.time(); total_loop = 0
for x in big:            # 느린 방식: 파이썬 for문
    total_loop += x
t1 = time.time(); total_vec = big.sum()   # 빠른 방식: 벡터화
t2 = time.time()

print("for문  :", round(t1 - t0, 4), "초")
print("벡터화 :", round(t2 - t1, 4), "초")
▶ 실행 결과 — 위 코드를 실행한 출력 (직접 실행: Windows · Python 3.11.2 · numpy 2.4.6, 앞 블록부터 순서대로 실행)
전원 10점 가산: [ 80  90 100]
for문  : 0.1781 초
벡터화 : 0.001 초
⏱️ 시간 측정값은 컴퓨터마다 달라집니다.
☁️ Colab에서 바로 실행
👉 Open in Colab — 00_01_vectors_shopping_cart.ipynb · 설치 없이 브라우저에서 셀을 위에서부터 순서대로 실행하세요.
🖥️ 내 컴퓨터에서 실행하기
git clone https://github.com/otoloism/Zero_to_ML_Master.git
cd Zero_to_ML_Master
python -m venv .venv
source .venv/bin/activate          # Windows: .venv\Scripts\activate
pip install -r book/requirements.txt   # 책 전체용 (PyTorch 등 포함, 용량 큼)
# 이 장만 실행한다면 이것만으로 충분합니다: pip install numpy
cd book/00-math-overview-for-beginners/00-01-vectors-shopping-cart
python 00_01_vectors_shopping_cart.py
⭐ GitHub Star / Fork
⭐ 코드가 도움이 되셨다면 GitHub 저장소에 Star를 눌러 주세요. 새 장의 코드가 올라올 때 가장 먼저 알 수 있습니다.
🍴 직접 고쳐 보며 실험하고 싶다면 Fork 해서 내 저장소에서 마음껏 바꿔 보세요. 오류 제보·개선 제안은 Issues로 환영합니다!
🔮 다음 글 예고
다음 글은 00-02 행렬 — 성적표는 곧 행렬이다 📋 입니다. 엑셀 표처럼 생긴 행렬의 shape(몇 행 몇 열?)를 읽는 법부터, 행렬 곱셈이 사실은 이번 글에서 배운 "내적"의 반복이라는 사실, 그리고 행렬에는 왜 나눗셈 대신 역행렬이 필요한지까지 NumPy로 확인합니다.
⬅️ 이전 글: #01 수포자를 위한 머신러닝·딥러닝 독학 로드맵 — 수학부터 파이썬, LLM·RAG까지 163절 커리큘럼 \
➡️ 다음 글: #03 행렬 쉽게 이해하기 — shape·행렬 곱셈·역행렬이 필요한 이유 (파이썬 NumPy)
📚 더 깊이 공부하고 싶다면
이 시리즈는 수학을 놓았던 비전공자가 AI를 직접 구현하기까지의 공부 기록을 그대로 옮긴 연재입니다. 원문 책, 코드, 개념 사전을 함께 보면 훨씬 빨리 늡니다. 🚀
| 바로가기 | 이런 분께 | |
|---|---|---|
| 📘 책 (위키독스, 무료) | Zero to 머신러닝 딥러닝 Master | 5권 · 20개 장 · 163개 절 전체를 순서대로 읽고 싶은 분 |
| 📄 이 글의 원문 | 00-01 벡터 — 장바구니 속 숫자의 줄서기 | 연습문제·해설까지 전부 보고 싶은 분 |
| 💻 실습 코드 (GitHub) | otoloism/Zero_to_ML_Master | .py·.ipynb를 Colab에서 바로 돌려보고 싶은 분 |
| 🏠 머신러닝 백과사전 | mldict.net | 본문 속 핵심 개념을 카드로 다시 확인하고 싶은 분 |
| ✍️ 기술 블로그 | wikidocs.net/blog/@mldict | 새 글 알림을 가장 먼저 받고 싶은 분 |
⭐ 도움이 되셨다면 velog 팔로우와 GitHub Star를 눌러 주세요. 다음 글을 쓰는 가장 큰 힘이 됩니다. 궁금한 점은 댓글로 편하게 남겨 주세요! 🙌