[Zero to ML Master #10] SVD 추천 시스템부터 미니 신경망(XOR)까지 — 수포자 수학 6개 장 총정리 (2부)
Zero to 머신러닝 딥러닝 Master
넷플릭스의 사용자×영화 평점 행렬은 99% 이상이 비어 있습니다. 한 사람이 모든 영화를 볼 수는 없으니까요. 그런데도 넷플릭스는 "이 영화, 좋아하실 거예요"라고 꽤 잘 맞힙니다. 🎬
그 비밀이 1부에서 배운 SVD입니다. 2부에서는 SVD로 빈칸을 채워 추천 시스템을 만들고, 마지막으로 00-01~00-06의 여섯 재료를 한 바퀴 안에서 전부 써서 NumPy만으로 XOR을 푸는 미니 신경망을 학습시킵니다. 흩어진 조각이 하나의 그림이 되는 순간이에요. 🧩
📘 이 글은 위키독스 도서 Zero to 머신러닝 딥러닝 Master 의 00-06 SVD·PCA — 300페이지 책을 3페이지로 (2부) 을 블로그용으로 다듬은 글입니다.
💻 실습 코드: GitHub · 🏠 mldict.net · ✍️ 기술 블로그
💻 이 글의 코드:
00-06-svd-pca· Open in Colab — 핵심 코드와 실제 실행 결과는 글 아래 💻 GitHub 실습 섹션에 있습니다.
⬅️ 이전 글: #09 고유값·SVD·PCA 쉽게 이해하기 — 300페이지 책을 3페이지로 (1부) \
➡️ 다음 글: #11 머신러닝에 수학이 왜 필요할까? — 라면과 요리로 보는 AI 수학 공부법 (파이썬 20줄 맛보기)
TL;DR — 3줄 요약
- 추천 점수는 사용자 벡터와 영화 벡터의 내적 이고, SVD로 압축하는 것이 곧 예측입니다.
- XOR은 직선 하나로 나눌 수 없어서, 비선형 활성화 함수가 있는 은닉층이 꼭 필요합니다.
- 신경망 학습은 벡터·행렬(입력) → 확률(손실) → 미분(역전파) → 갱신이 한 바퀴를 이루며 반복되는 과정입니다.
🔗 1부 복습: 고유벡터는 "방향이 변하지 않는 화살표", SVD는 "어떤 행렬이든 로 쪼개는 만능 도구", PCA는 "분산이 가장 큰 방향 찾기"였습니다. 1부를 아직 못 보셨다면 #09 고유값·SVD·PCA 쉽게 이해하기부터 읽고 오세요.
📍 00-06-D · 4단계 — 추천 시스템: SVD의 실전 활용
🔎 ① 핵심 정의 — 무엇인가?\
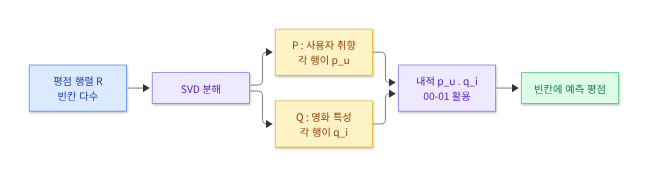
넷플릭스의 사용자×영화 평점 행렬은 99% 이상이 비어 있습니다 — 한 사람이 모든 영화를 볼 수는 없으니까요. 추천 시스템의 목표는 이 빈칸을 예측하는 것이고, SVD는 "비슷한 취향의 사용자 패턴"을 찾아 빈칸을 채웁니다.
❓ 왜 필요한가?\
사용자가 평가하지 않은 항목에 대해서도 "이건 좋아하실 것 같아요"라고 말할 수 있어야 추천이 성립합니다. 평가한 것만 보여주면 추천이 아니라 기록 조회일 뿐이죠.
⏰ 언제 사용하는가?\
넷플릭스·유튜브·스포티파이 추천, 쇼핑몰 상품 추천, 그리고 00-01에서 배운 코사인 유사도 기반 추천의 다음 단계입니다. 🔗
💜 더 쉽게 이해하기 — 🧩 퍼즐의 빠진 조각 맞추기
1000조각 퍼즐에서 몇 조각이 사라졌습니다. 그래도 우리는 빈자리에 어떤 그림이 들어갈지 대충 짐작할 수 있습니다. 왜일까요? 🧩
전체 그림이 "하늘", "바다", "산" 같은 몇 개의 큰 패턴으로 이루어져 있고, 빈칸 주변이 온통 파란 하늘이라면 그 조각도 파란 하늘일 가능성이 크기 때문이죠. 🌤️
SVD는 이 "큰 패턴"(잠재 요인)을 자동으로 찾아내는 도구입니다. 사용자 취향에도 "액션 좋아함", "옛날 영화 선호" 같은 숨은 축이 있고, SVD가 그것을 데이터에서 발굴합니다. ⛏️
🔢 진행 과정 — 4단계
- 사용자×영화 평점 행렬을 만든다 (미평가는 일단 0)
- SVD로 를 구한다 → 잠재 요인 공간
- 상위 개 요인만 남겨 재구성한다
- 원래 0이었던 칸의 값을 예측 평점으로 읽는다
🔬 수학공식 ⑥ — 잠재 요인 모델
2단계의 근사식을 둘로 쪼개서 새로운 의미를 부여합니다.
따라서 사용자 가 영화 에 줄 평점은:
변수 정의\
• : 평점 행렬 ( 사용자 × 영화)\
• : 사용자 의 취향 벡터 (차원)\
• : 영화 의 특성 벡터 (차원)\
• : 잠재 요인의 개수 (보통 20~200)\
\
📌 00-01과 연결 🔗 — 예측이 내적 한 번으로 끝납니다! 사용자 취향과 영화 특성이 같은 차원 공간에 놓이기 때문에, 두 벡터의 내적이 곧 "얼마나 잘 맞는가"가 됩니다. 00-01에서 영화 취향을 벡터로 표현했던 것이, 여기서는 데이터로부터 자동 발견되는 것입니다. ✨\
\
⚠️ 주의: 잠재 요인이 "액션", "로맨스" 같은 사람이 읽을 수 있는 이름을 갖는 것은 아닙니다. 그저 데이터에서 자동으로 발견된 축일 뿐입니다.
📖 수학적 의미 — 저장 공간과 의 트레이드오프
| 가 작으면 | 가 크면 |
|---|---|
| 😊 일반화 잘 됨 — 큰 패턴만 학습 | 😊 관측된 평점을 정확히 재현 |
| 😊 저장 공간 절약 | 😰 "0"까지 그대로 학습 → 과적합 |
| 😰 세밀한 취향 반영 못 함 | 😰 빈칸 예측이 0에 가까워짐 ⚠️ |
📌 가 최대(=랭크)가 되면 이 되어, 빈칸은 원래의 0을 그대로 돌려줍니다. 즉 압축을 해야만 예측이 생깁니다 — 아래 실행 결과에서 직접 확인합니다! 🔬
🗺️ 시각화 ⑥ — 빈칸이 채워지는 과정
⚙️ 구현 원리 — 두 가지 버전을 비교합니다\
① 순진한 버전: 빈칸을 0으로 두고 그대로 SVD → 문제점을 드러내기 위함\
② 개선 버전: 사용자별 평균으로 채우고 중심화 후 SVD → 실무에 가까운 방식\
두 결과를 비교하면 "왜 0으로 채우면 안 되는지"가 명확해집니다. 🔬
🔗 프레임워크 관점
| 개념 | NumPy (원리 학습) | 실무 라이브러리 | 딥러닝 |
|---|---|---|---|
| 행렬 분해 | np.linalg.svd | surprise.SVD() | nn.Embedding |
| 결측 처리 ⭐ | 평균 채우기 (근사) | implicit (ALS) | 관측값만 손실 계산 |
| 학습 방식 | 분해 한 번 | 교대 최소제곱 (00-03 🔗) | 경사하강법 (00-04 🔗) |
📌 ALS(교대 최소제곱)는 를 고정하고 를 00-03의 최소제곱으로 풀고, 다시 를 고정하고 를 푸는 것을 반복합니다. 🔗 즉 00-03의 정규방정식이 추천 시스템의 심장인 셈입니다!
🐍 Python — 순진한 버전 vs 개선 버전 비교
import numpy as np
np.set_printoptions(suppress=True)

# 사용자 5명 × 영화 5편, 0은 '아직 평가하지 않음'
R = np.array([
    [5, 4, 0, 1, 2],   # 사용자0: 영화0,1을 좋아함
    [4, 5, 1, 0, 3],   # 사용자1: 비슷한 취향
    [1, 2, 5, 4, 0],   # 사용자2: 영화2,3을 좋아함
    [2, 0, 4, 5, 1],
    [0, 1, 3, 5, 4]
], dtype=float)

mask = R > 0          # 관측된 평점의 위치 (00-05의 불리언 마스크! 🔗)
print(f"관측 평점: {mask.sum()}개 / 전체 {R.size}개")

def svd_predict(matrix, k):
    """
    SVD 랭크-k 근사로 평점을 예측합니다.

    비유:
    퍼즐의 큰 패턴 k개만 파악해서 빈칸을 추론하는 것과 같습니다.
    """
    U, S, Vt = np.linalg.svd(matrix, full_matrices=False)
    return U[:, :k] @ np.diag(S[:k]) @ Vt[:k, :]   # 2단계와 동일!

# ══════ 버전 A) 순진한 방법 — 0을 그대로 두고 SVD ══════
U, S, Vt = np.linalg.svd(R, full_matrices=False)
print("\n[A] 특잇값:", S.round(3))

energy = np.cumsum(S**2) / np.sum(S**2)
print("[A] k별 예측값과 관측 오차")
for k in range(1, 6):
    P = svd_predict(R, k)
    # 관측된 칸에서만 오차 측정 (00-03의 잔차 개념 🔗)
    rmse = np.sqrt(np.mean((P[mask] - R[mask])**2))
    print(f"   k={k}: 에너지 {energy[k-1]:.3f} | [0,2] 예측 {P[0,2]:6.2f}"
          f" | 관측 RMSE {rmse:.4f}")

# ══════ 버전 B) 개선 — 사용자별 평균으로 채우고 중심화 ══════
# 아이디어: "평가 안 함"을 0(=최악)이 아니라 '그 사람의 평균'으로 보자
user_mean = np.array([R[i][mask[i]].mean() for i in range(len(R))])
print("\n[B] 사용자별 평균 평점:", user_mean.round(2))

R_filled = R.copy()
for i in range(len(R)):
    R_filled[i][~mask[i]] = user_mean[i]      # ~는 부정(NOT) 연산자

# 3단계 PCA처럼 '중심화' — 사용자별 후함/짬을 제거 (00-05의 발상 🔗)
R_centered = R_filled - user_mean[:, None]   # [:, None]로 열벡터 만들어 브로드캐스트

for k in [1, 2, 3]:
    P = svd_predict(R_centered, k) + user_mean[:, None]   # 평균 복원!
    rmse = np.sqrt(np.mean((P[mask] - R[mask])**2))
    print(f"[B] k={k}: [0,2] 예측 {P[0,2]:.2f} | 관측 RMSE {rmse:.4f}")

# ══════ 최종 추천 결과 (개선 버전, k=2) ══════
P_final = svd_predict(R_centered, 2) + user_mean[:, None]
print("\n[B] 미평가 칸의 예측 평점 (k=2)")
for i, j in zip(*np.where(~mask)):          # 0이었던 위치만 순회
    print(f"   사용자{i} → 영화{j}: {P_final[i, j]:.2f}점")
🔗 GitHub에서 코드 보기 — 00_06_svd_pca.py L147–L206
📘 코드 이해 — 수식과 코드 대응
| 수학·개념 | 코드 | 설명 |
|---|---|---|
| 관측 여부 | mask = R > 0 | 00-05의 불리언 마스크 🔗 |
U[:,:k]@diag(S[:k])@Vt[:k,:] | 2단계와 완전히 같은 한 줄 | |
| 관측 RMSE | sqrt(mean((P[mask]-R[mask])**2)) | 00-03 잔차의 제곱평균 🔗 |
| 사용자 평균 | R[i][mask[i]].mean() | 관측된 값만으로 평균 |
| 중심화 | R_filled - user_mean[:, None] | 3단계 PCA와 같은 발상 🔗 |
| 예측 복원 | svd_predict(...) + user_mean[:,None] | ⚠️ 평균 다시 더하기 필수 |
🧩 코드 설명 — NumPy 고급 인덱싱
•
P[mask]— 불리언 마스크로 관측된 값만 1차원으로 뽑아냅니다. 00-05의passed[high]와 같은 기법입니다 🔗. 덕분에 빈칸을 제외한 오차만 정확히 잴 수 있습니다.\
\
•~mask—~는 부정(NOT) 연산자입니다.True↔False를 뒤집어 "미평가 위치"를 고릅니다. ⚠️ 파이썬의not이 아니라~를 써야 합니다.\
\
•user_mean[:, None]⭐ — 1차원 배열(5,)를 열벡터(5,1)로 바꿉니다. 이렇게 해야 브로드캐스트가 "각 행에 그 행의 평균을 빼는" 방식으로 작동합니다.[None, :]로 쓰면 열 방향이 되어 완전히 다른 결과가 나옵니다!\
\
•np.where(~mask)— 조건이True인 (행 인덱스 배열, 열 인덱스 배열)을 돌려줍니다.zip(*...)로 풀면(i, j)좌표를 하나씩 순회할 수 있습니다.\
\
•R.copy()⚠️ — 복사하지 않고R_filled = R로 쓰면 원본까지 바뀝니다(00-04에서 배운 그 함정 🔗).
✅🟩 실행 결과
관측 평점: 20개 / 전체 25개

[A] 특잇값: [12.534  8.079  3.479  2.263  0.627]
[A] k별 예측값과 관측 오차
   k=1: 에너지 0.655 | [0,2] 예측   2.37 | 관측 RMSE 1.6271
   k=2: 에너지 0.927 | [0,2] 예측   0.50 | 관측 RMSE 0.7873
   k=3: 에너지 0.977 | [0,2] 예측   0.63 | 관측 RMSE 0.4487
   k=4: 에너지 0.998 | [0,2] 예측   0.18 | 관측 RMSE 0.1220
   k=5: 에너지 1.000 | [0,2] 예측   0.00 | 관측 RMSE 0.0000

[B] 사용자별 평균 평점: [3.   3.25 3.   3.   3.25]
[B] k=1: [0,2] 예측 1.85 | 관측 RMSE 0.8393
[B] k=2: [0,2] 예측 2.40 | 관측 RMSE 0.6183
[B] k=3: [0,2] 예측 2.90 | 관측 RMSE 0.3443

[B] 미평가 칸의 예측 평점 (k=2)
   사용자0 → 영화2: 2.40점
   사용자1 → 영화3: 2.06점
   사용자2 → 영화4: 2.54점
   사용자3 → 영화1: 2.87점
   사용자4 → 영화0: 2.54점
🔍 결과 해석 — 이 절의 가장 중요한 교훈
① 를 키울수록 예측값이 0으로 수렴한다 ⚠️ — 버전 A에서 로 갈수록 [0,2] 예측이 2.37 → 0.50 → 0.63 → 0.18 → 0.00으로 0에 가까워집니다. 관측 RMSE는 0으로 떨어지지만, 이건 "미평가=0점"이라는 거짓말까지 완벽히 외운 것입니다. 전형적인 과적합이죠! 😱
② 압축이 곧 예측이다 — 를 작게 해서 세부사항을 버려야만 빈칸에 의미 있는 값이 생깁니다. "덜 정확한 것이 더 유용한" 역설적인 상황입니다. 🎯
③ 개선 버전이 훨씬 합리적 ⭐ — 사용자 평균으로 채우고 중심화하니 예측이 2~3점대의 자연스러운 범위에 놓입니다. 버전 A의 가 0.50점(사실상 "최악의 영화")이라고 말한 것과 대조적이죠. 같은 SVD인데 전처리 하나로 결과가 완전히 달라집니다. 🔧
④ 추천 결과가 상식과 맞는가? — 사용자0은 영화0,1을 좋아하고(5,4점) 영화3을 싫어합니다(1점). 사용자2,3,4는 반대로 영화2,3을 좋아하죠. 개선 버전은 사용자0의 영화2 예측을 2.40점(평균 3점보다 낮음)으로 냈습니다 — "취향이 다른 그룹의 영화라 별로일 것"이라는 합리적 판단입니다! ✅
🛠️ 실습 4 🔵🔴🚀
① 버전 A에서 일 때 예측 행렬이 원본과 완전히 같은지
np.allclose로 확인하세요. 왜 그럴까요?\
② 영화별 평균으로 채우는 버전을 만들어 사용자별 평균 버전과 RMSE를 비교하세요.\
③ 사용자0의 취향 벡터 와 사용자1의 의 코사인 유사도(00-01 🔗)를 구해보세요. 취향이 비슷한 두 사람이 실제로 가까운가요?\
④ 🚀 00-04와 연결: 관측된 값에 대해서만 손실 을 정의하고, 경사하강법으로 를 학습시켜보세요. 이것이 실무 추천 시스템의 진짜 방식입니다! 💪
🐞 실수하기 쉬운 부분 & 디버깅 포인트
❌ 실수 ① "미평가 0"을 "0점 평가"로 취급 ⭐ 가장 근본적인 오류\
왜 틀리나? "안 봤다"와 "봤는데 최악이다"는 완전히 다른 정보인데, 0으로 채우면 SVD가 "이 사람은 이 영화를 싫어한다"고 학습합니다. 수정: 평균으로 채우거나(위 버전 B), 관측값에만 손실을 계산하는 ALS·경사하강법을 쓰세요.❌ 실수 ② 전체 RMSE로 성능 평가\
빈칸까지 포함해 오차를 재면 "0을 잘 맞추는 모델"이 1등이 됩니다. 수정: 반드시P[mask]처럼 관측된 칸에서만 평가하세요.❌ 실수 ③ 를 최대로 설정\
=랭크면 이 되어 빈칸이 원래 0 그대로 나옵니다. 예측이 전부 0이면 이것을 의심하세요. 수정: 에너지 비율 0.8~0.95 수준의 를 고르세요.❌ 실수 ④ 중심화 후 평균 복원 누락\
+ user_mean[:, None]을 빼먹으면 예측값이 −1~1 근처로 나와 "평점"으로 해석할 수 없습니다.❌ 실수 ⑤ 예측값 범위 미조정\
SVD는 −0.3점이나 5.8점 같은 값도 뱉습니다. 수정:np.clip(P, 1, 5)로 유효 범위에 가두세요.✅ 검산 습관: ① 예측값이 상식적인 범위인가 ② 관측 RMSE가 에 따라 어떻게 변하는가 ③ 취향이 비슷한 사용자끼리 예측도 비슷한가 — 이 셋을 확인하세요. 🛡️
📍 00-06-E · 5단계 — 종합: 00-01부터 00-06까지 하나로 잇기
🔎 ① 핵심 정의 — 무엇인가?\
지금까지 배운 여섯 장은 따로 노는 지식이 아닙니다. 신경망 하나가 학습하는 단 한 바퀴 안에서 전부 함께 돌아갑니다. 이 마지막 단계에서는 NumPy만으로 신경망을 처음부터 만들어 그 사실을 눈으로 확인합니다.
❓ 왜 필요한가?\
PyTorch의 model.fit() 한 줄 뒤에 무엇이 있는지 모르면, 문제가 생겼을 때 손쓸 수 없습니다. 직접 만들어보면 "블랙박스"가 "내가 아는 수식들의 조합"으로 바뀝니다. 🔦
⏰ 언제 사용하는가?\
학습이 안 될 때 원인을 추적할 때, 새 손실 함수를 직접 만들 때, 논문을 구현할 때 — 실력 있는 실무자와 라이브러리 사용자를 가르는 지점입니다.
💜 더 쉽게 이해하기 — 🏭 공장 생산 라인
신경망 학습은 자동화된 공장과 똑같습니다. 🏭
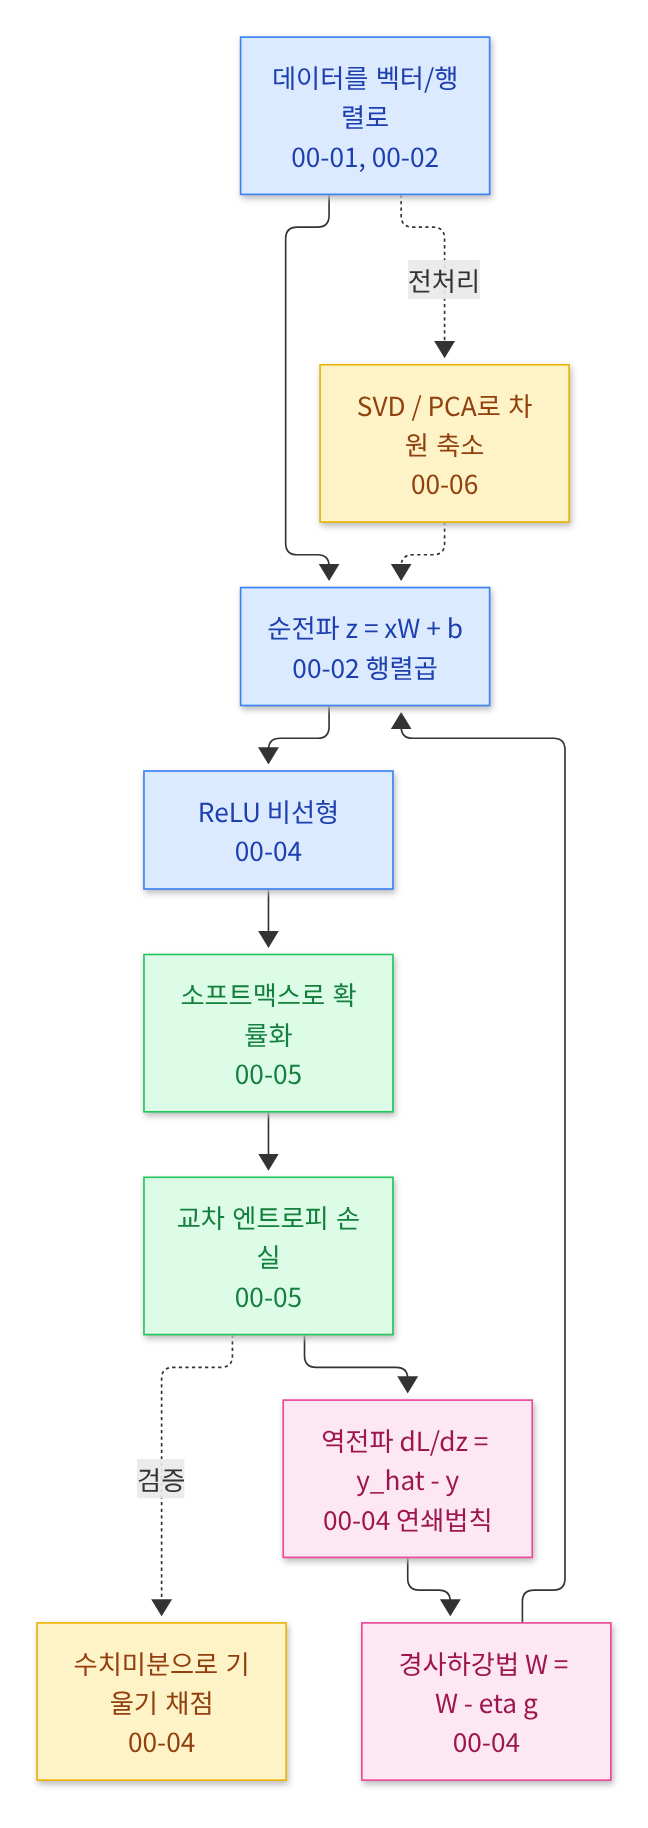
📦 원료 투입 — 데이터를 벡터/행렬로 (00-01, 00-02)\
⚙️ 공정 통과 — 각 층에서 행렬 곱셈 (00-02)\
🔍 품질 검사 — 불량 정도를 숫자 하나로 (00-05 교차 엔트로피)\
📢 피드백 전달 — 검사 결과를 라인 앞쪽으로 (00-04 연쇄법칙)\
🔧 설정 미세 조정 — 각 공정을 아주 조금씩 (00-04 경사하강법)\
✂️ 원료 전처리 — 필요하면 미리 압축 (00-06 SVD/PCA)이 한 바퀴를 수천 번 반복하면, 처음엔 엉망이던 공장이 점점 좋은 제품을 만들어냅니다. 🎁
🔢 진행 과정 — 학습 한 바퀴의 5단계
- 순전파 — 입력에 가중치를 곱해 예측을 만든다 (00-02)
- 확률화 — 소프트맥스로 원시 점수를 확률로 (00-05)
- 손실 계산 — 교차 엔트로피로 "얼마나 틀렸나" (00-05)
- 역전파 — 연쇄법칙으로 각 가중치의 기울기 (00-04)
- 가중치 갱신 — 기울기 반대 방향으로 한 걸음 (00-04)
🔬 수학공식 ⑦ — 6개 장의 수식을 한자리에
【순전파】
【손실】
【역전파】 — 🎁 00-05에서 유도한 그 선물
【갱신】
변수 정의\
• 입력, 가중치, 편향, 은닉층 출력\
• 외적(outer product), 성분별 곱, 조건이 참이면 1\
• 학습률\
\
📌 ReLU의 미분이 왜 인가? 는 이면 기울기 1, 이면 0입니다. 그래서 "양수였던 자리만 기울기를 통과시키는 문지기" 역할을 합니다. 🚪
🗺️ 시각화 ⑦ — 6개 장이 한 바퀴 안에서 맞물리는 모습
⚙️ 구현 원리 — XOR 문제를 고른 이유\
XOR(둘이 다르면 1, 같으면 0)은 직선 하나로는 절대 나눌 수 없는 문제입니다. 📐 00-03의 선형회귀로는 영원히 풀 수 없죠. 그래서 은닉층 + 비선형(ReLU)이 왜 필요한지를 보여주는 역사적인 예제입니다. 실제로 이 문제 때문에 1970년대 AI 연구가 한 번 멈췄습니다. ❄️
🐍 Python — NumPy만으로 만든 미니 신경망 + 기울기 검증
import numpy as np

class MiniNeuralNet:
    """
    00-01 ~ 00-05의 내용만으로 만든 2층 신경망입니다.

    비유:
    원료(입력)를 받아 공정(행렬 곱셈)을 거쳐 제품(예측)을 만들고,
    품질 검사(손실)에서 불량이 나오면 그 결과를 라인 앞쪽으로
    되돌려 설정을 조금씩 고치는(역전파) 작은 생산 라인입니다.
    """

    def __init__(self, n_input, n_hidden, n_output, seed=0):
        rng = np.random.default_rng(seed)
        # 00-02: 가중치는 행렬, 00-05: 작은 정규분포에서 초기화
        # ⚠️ 스케일이 크면 초반부터 기울기가 불안정해집니다
        self.W1 = rng.standard_normal((n_input, n_hidden)) * 0.5
        self.b1 = np.zeros(n_hidden)
        self.W2 = rng.standard_normal((n_hidden, n_output)) * 0.5
        self.b2 = np.zeros(n_output)

    def softmax(self, x):
        """00-05: 최댓값 빼기로 오버플로 방지 (결과는 불변임을 증명했음)"""
        e = np.exp(x - np.max(x))
        return e / e.sum()

    def forward(self, x):
        """순전파: 입력 → 예측 확률"""
        self.x = x
        self.z1 = x @ self.W1 + self.b1        # 00-02 행렬곱
        self.h1 = np.maximum(0, self.z1)         # 00-04 ReLU
        self.z2 = self.h1 @ self.W2 + self.b2  # 00-02 행렬곱
        self.y_hat = self.softmax(self.z2)     # 00-05 확률화
        return self.y_hat

    def loss(self, y):
        """00-05: 교차 엔트로피 L = -Σ y log(ŷ)"""
        return -np.sum(y * np.log(self.y_hat + 1e-15))

    def backward(self, y):
        """
        역전파: 00-04의 연쇄법칙으로 기울기 계산.
        기울기 변수는 지시서 규칙대로 g 접두사를 씁니다.
        """
        # 🎁 00-05에서 유도한 선물: softmax + CE의 기울기 = ŷ - y
        gz2 = self.y_hat - y

        gW2 = np.outer(self.h1, gz2)     # 00-01 외적 → (은닉, 출력) 행렬
        gb2 = gz2

        # 00-04 연쇄법칙: 뒤층 기울기를 W2로 되돌리고 ReLU 문지기 통과
        gz1 = (self.W2 @ gz2) * (self.z1 > 0)

        gW1 = np.outer(self.x, gz1)
        gb1 = gz1
        return gW1, gb1, gW2, gb2

    def update(self, grads, lr=0.3):
        """00-04 경사하강법: W ← W - η·∂L/∂W"""
        gW1, gb1, gW2, gb2 = grads
        self.W1 -= lr * gW1
        self.b1 -= lr * gb1
        self.W2 -= lr * gW2
        self.b2 -= lr * gb2

# ══════ XOR 데이터 (직선 하나로는 못 나누는 문제!) ══════
X = np.array([[0, 0], [0, 1], [1, 0], [1, 1]], dtype=float)
Y = np.array([[1, 0], [0, 1], [0, 1], [1, 0]], dtype=float)  # 원-핫

net = MiniNeuralNet(n_input=2, n_hidden=8, n_output=2, seed=0)

print("=== 학습 시작 (은닉 8개) ===")
for epoch in range(300):
    total = 0.0
    for x, y in zip(X, Y):
        net.forward(x)                 # ① 순전파
        total += net.loss(y)           # ② 손실
        net.update(net.backward(y), lr=0.3)   # ③ 역전파+갱신
    if epoch % 50 == 0 or epoch == 299:
        print(f"  {epoch:3d} epoch: 평균 손실 = {total/4:.4f}")

print("\n=== 최종 예측 ===")
for x, y in zip(X, Y):
    p = net.forward(x)
    mark = "✅" if np.argmax(p) == np.argmax(y) else "❌"
    print(f"  입력{x} → 예측{np.argmax(p)} (정답{np.argmax(y)}) 확률{p.round(3)} {mark}")

# ══════ 🔬 00-04의 수치미분으로 역전파 검증 ══════
print("\n=== 역전파 기울기 검증 (수치미분과 대조) ===")
check = MiniNeuralNet(2, 4, 2, seed=1)
x, y = X[1], Y[1]
check.forward(x)
gW2_formula = check.backward(y)[2]        # 공식으로 구한 gW2

h = 1e-5
gW2_numeric = np.zeros_like(check.W2)
for i in range(check.W2.shape[0]):
    for j in range(check.W2.shape[1]):
        tmp = check.W2[i, j]
        check.W2[i, j] = tmp + h; check.forward(x); l_plus = check.loss(y)
        check.W2[i, j] = tmp - h; check.forward(x); l_minus = check.loss(y)
        gW2_numeric[i, j] = (l_plus - l_minus) / (2 * h)   # 00-04 중심차분
        check.W2[i, j] = tmp        # ★ 원상복구 필수!

print("  공식 gW2 첫 행:", gW2_formula[0].round(6))
print("  수치 gW2 첫 행:", gW2_numeric[0].round(6))
print(f"  최대 오차: {np.abs(gW2_formula - gW2_numeric).max():.2e}")
🔗 GitHub에서 코드 보기 — 00_06_svd_pca.py L210–L316
📘 코드 이해 — 어느 장의 수식이 어느 줄이 되었나
| 수학공식 | 코드 | 출처 장 |
|---|---|---|
x @ self.W1 + self.b1 | 00-02 행렬곱 + 브로드캐스트 | |
np.maximum(0, self.z1) | 00-04 ReLU | |
np.exp(x-x.max())/... | 00-05 소프트맥스 (안정화 포함) | |
-np.sum(y*np.log(y_hat+1e-15)) | 00-05 교차 엔트로피 | |
gz2 = self.y_hat - y | 🎁 00-05의 유도 결과 한 줄 | |
np.outer(self.h1, gz2) | 00-01 외적 (2단계에서도 등장 🔗) | |
(self.W2 @ gz2) * (self.z1 > 0) | 00-04 연쇄법칙 + ReLU 미분 | |
self.W1 -= lr * gW1 | 00-04 경사하강법 | |
(l_plus-l_minus)/(2*h) | 00-04 중심차분 검증 |
🧩 코드 설명 — Python/NumPy 기초
•
np.outer(a, b)⭐ — 외적입니다. 길이 과 인 벡터로 행렬을 만듭니다. 왜 필요할까요? 가중치 가 (은닉, 출력) 크기의 행렬이므로, 그 기울기도 같은 크기여야 하기 때문입니다. 2단계 SVD의 "층"에서도 같은 함수를 썼습니다 🔗\
\
•(self.z1 > 0)— 불리언 배열이 그대로 0/1로 곱해집니다. ReLU 미분(이면 1, 아니면 0)을 if문 없이 한 번에 구현하는 우아한 방법입니다. 00-05에서np.mean(불리언)을 쓴 것과 같은 원리죠 🔗\
\
•self.x = x저장 — 역전파에서np.outer(self.x, gz1)에 필요하기 때문입니다. 00-04의Square클래스가 입력을 저장했던 것, 00-05의Sigmoid가 출력을 저장했던 것과 같은 패턴입니다 🔗\
\
•np.random.default_rng(seed)— 시드를 고정하면 매번 같은 초기 가중치가 나와 결과를 재현할 수 있습니다. 실험할 때 필수입니다.\
\
•zip(X, Y)— 입력과 정답을 짝지어 순회합니다. 여기서는 데이터를 하나씩 처리하지만(확률적 경사하강법, SGD), 실무에서는 여러 개를 묶어 처리합니다(미니배치).\
\
•np.argmax(p)— 확률이 가장 큰 인덱스를 돌려줍니다. 확률[0.998, 0.002]면0을 반환하죠.
✅🟩 실행 결과
=== 학습 시작 (은닉 8개) ===
    0 epoch: 평균 손실 = 0.7535
   50 epoch: 평균 손실 = 0.0999
  100 epoch: 평균 손실 = 0.0185
  150 epoch: 평균 손실 = 0.0094
  200 epoch: 평균 손실 = 0.0063
  250 epoch: 평균 손실 = 0.0046
  299 epoch: 평균 손실 = 0.0037

=== 최종 예측 ===
  입력[0. 0.] → 예측0 (정답0) 확률[0.998 0.002] ✅
  입력[0. 1.] → 예측1 (정답1) 확률[0.01  0.99 ] ✅
  입력[1. 0.] → 예측1 (정답1) 확률[0.001 0.999] ✅
  입력[1. 1.] → 예측0 (정답0) 확률[0.999 0.001] ✅

=== 역전파 기울기 검증 (수치미분과 대조) ===
  공식 gW2 첫 행: [ 0.203899 -0.203899]
  수치 gW2 첫 행: [ 0.203899 -0.203899]
  최대 오차: 6.61e-12
🏆 이 책 전체의 결승점입니다.
① 손실이 0.7535 → 0.0037로 200배 넘게 줄었고, 네 개 모두 정답을 맞혔습니다. 그것도 확률 99.8%의 확신으로요. 직선으로는 절대 못 나누는 XOR을, NumPy 몇 십 줄로 풀어낸 것입니다! 🎉
② 역전파 검증에서 최대 오차 ⭐ — 우리가 손으로 유도한 기울기 공식과 00-04의 수치미분이 소수점 11자리까지 일치합니다. 연쇄법칙을 제대로 적용했다는 수학적 증거입니다. PyTorch의 gradcheck가 하는 일이 정확히 이것입니다! 🔬
③ 여섯 장이 전부 한 코드 안에 있습니다. 벡터 외적(00-01), 행렬 곱(00-02), 잔차 개념(00-03), 연쇄법칙과 경사하강법(00-04), 소프트맥스와 교차 엔트로피와 그 기울기(00-05), 그리고 전처리로서의 SVD(00-06). 따로 배운 조각들이 하나의 그림이 되었습니다. 🧩✨
🛠️ 실습 5 🔴🚀
① 은닉층을 2개로 줄여(
n_hidden=2) 다시 학습시켜보세요. ⚠️ 손실이 0.53에서 멈추고 정확도가 3/4로 떨어집니다! 표현력이 부족하면 XOR을 완전히 학습하지 못한다는 것을 직접 확인하세요.\
② ReLU를 없애고(h1 = z1) 돌려보세요. ⚠️ 비선형이 없으면 층을 아무리 쌓아도 결국 하나의 선형 변환이라 XOR을 절대 못 풉니다. 이것이 활성화 함수가 존재하는 이유입니다!\
③ 학습률을 3.0으로 키워보세요. 00-04에서 배운 발산이 실제로 일어나는지 확인하세요. 🔗\
④gW1과gb2도 수치미분으로 검증하는 코드를 추가하세요.\
⑤ 🚀 3층으로 확장하세요.W3, b3를 추가하고 역전파를 한 단계 더 이어붙이면 됩니다 — 패턴이 똑같이 반복된다는 것을 체감하게 됩니다.\
⑥ 🚀 PyTorch로 재구현하고,nn.Linear·nn.CrossEntropyLoss·loss.backward()가 우리 코드와 같은 결과를 내는지 비교하세요.
🐞 실수하기 쉬운 부분 & 디버깅 포인트
❌ 실수 ① 손실이
nan\
원인: 학습률이 너무 크거나(00-04 발산 🔗), 초기 가중치 스케일이 큼. 수정:lr을 1/10로,* 0.5를* 0.1로. 확인법: 첫 에폭 손실이log(클래스 수)≈0.693근처인지 보세요.❌ 실수 ② 손실이 안 줄어듦\
원인: 학습률이 너무 작거나, 갱신 부호를+로 썼거나, 은닉층이 너무 작음. 확인법: 기울기 크기np.abs(gW1).max()를 찍어보세요. 거의 0이면 기울기 소실입니다.❌ 실수 ③ 외적 순서 혼동 ⭐\
np.outer(gz2, self.h1)로 쓰면 전치된 행렬이 나와 shape 오류가 나거나 조용히 틀립니다. 규칙:np.outer(앞층 출력, 뒤층 기울기). 확인법:gW2.shape == W2.shape를assert로 걸어두세요.❌ 실수 ④ ReLU 미분 누락\
gz1 = self.W2 @ gz2만 쓰면 음수 구간까지 기울기가 통과해 학습이 이상해집니다.* (self.z1 > 0)을 잊지 마세요.❌ 실수 ⑤ 수치미분 후 원상복구 누락\
check.W2[i,j] = tmp를 빼면 가중치가 조금씩 오염되어 검증 자체가 무의미해집니다(00-04에서 강조한 그 함정 🔗).✅ 최고의 디버깅 습관: 새 층이나 새 손실을 만들면 반드시 수치미분으로 채점하세요. 오차가 보다 크면 유도가 틀린 것입니다. 🛡️
🔴 심화 — SVD가 요즘 AI에서 쓰이는 곳
💜 더 쉽게 이해하기 — 🔧 자동차 튜닝
거대한 언어 모델(LLM)을 내 업무에 맞게 고치고 싶습니다. 그런데 파라미터가 700억 개라 전부 다시 학습시키는 것은 불가능하죠. 🚗💨
자동차를 통째로 다시 만드는 대신 부품 몇 개만 바꾸는 튜닝을 하듯, "바뀌는 부분만 작은 랭크로 표현"하면 어떨까요? 이것이 바로 LoRA입니다. 🔧
🔬 수학공식 ⑧ — LoRA: 저랭크 근사의 현대적 활용
원래 가중치 ()를 얼려두고, 변화량만 랭크 로 표현합니다.
여기서 는 , 는 이고 입니다.\
\
학습할 파라미터 개수 비교 (, 일 때)\
• 전체 미세조정: 개\
• LoRA: 개 → 약 0.4% 😲\
\
📌 2단계의 "랭크- 근사"가 그대로 쓰인 것입니다. 차이가 있다면 SVD로 분해하는 대신 를 00-04의 경사하강법으로 학습한다는 점이죠. 이 책의 여섯 장이 최신 기술에 그대로 살아 있습니다! 🔗✨
📋 SVD·PCA의 실무 활용 지도
| 분야 | 무엇을 압축하나 | 효과 |
|---|---|---|
| 🖼️ 이미지 압축 | 픽셀 행렬 | 용량 90% 절감, 노이즈 제거 |
| 📝 잠재의미분석(LSA) | 문서×단어 행렬 | "의미"가 비슷한 문서 검색 |
| 🎬 추천 시스템 | 사용자×아이템 행렬 | 빈칸 예측 (4단계) |
| 👤 고유얼굴(Eigenface) | 얼굴 사진 행렬 | 얼굴 인식, 수백 차원 → 수십 |
| 🤖 LoRA 파인튜닝 | 가중치 변화량 | 학습 파라미터 99.6% 절감 |
| 📊 데이터 시각화 | 고차원 특징 | 1000차원 → 2차원 산점도 |
📝 연습문제
🧠 개념 문제
Q1 🟢 고유벡터를 "방향이 변하지 않는 화살표"라고 하는 이유를 식으로 설명하세요.
Q2 🔵 SVD에서 작은 특잇값을 버려도 원본을 거의 복원할 수 있는 이유를 에너지 비율로 설명하세요.
Q3 🔵 고유값 분해로 못 하고 SVD로만 할 수 있는 것은 무엇인가요?
Q4 🔴 PCA에서 중심화를 빠뜨리면 왜 결과가 망가지나요?
🧮 계산 문제
Q5 🟢 에서 과 이 고유벡터인지 확인하고 고유값을 구하세요.
Q6 🔵 의 고유값을 특성방정식으로 구하세요.
Q7 🔴 특잇값이 일 때, 에너지 90%를 넘기는 최소 를 구하세요.
💻 구현 문제
Q8 🔵 에너지 비율 목표(예: 0.95)를 받아 최소 를 자동으로 정하고 압축하는 함수 compress(A, target=0.95)를 작성하세요.
Q9 🔴 MiniNeuralNet에 은닉층을 하나 더 추가해 3층으로 확장하세요.
🚀 사고 확장 문제
Q10 🔴 사용자 100만 명 × 영화 10만 편이면 이 장의 방식에 어떤 문제가 생기나요?
Q11 🔴🚀 2단계의 "저랭크 근사"와 5단계의 "은닉층 크기 줄이기"는 어떤 공통점이 있나요?
✅ 해설
A1. 의 결과가 , 즉 원래 벡터의 상수배입니다. 스칼라배는 00-01에서 배웠듯 방향은 유지하고 길이만 바꾸므로, 변환 후에도 같은 직선 위에 남습니다. 🔗
A2. 에너지 비율 가 말해줍니다. 특잇값은 급격히 작아지므로 상위 몇 개가 에너지의 대부분을 차지합니다. 이 장의 예제에서는 만으로도 99.54%였죠. 게다가 에카르트–영 정리에 의해 이보다 나은 랭크- 근사는 존재하지 않습니다.
A3. 직사각 행렬()의 분해입니다. 고유값은 정사각 행렬에만 정의되지만, SVD는 어떤 크기든 가능합니다. 실제 데이터(사용자×영화, 문서×단어)는 거의 다 직사각형이라 SVD가 실무의 기본입니다.
A4. 평균이 0이 아니면 "원점에서 데이터 덩어리까지의 방향"이 분산으로 잘못 계산되어, PC1이 실제 퍼짐이 아니라 위치를 가리키게 됩니다. 예를 들어 평균이 인 데이터는 모든 점이 원점에서 멀리 있어 그 방향의 "분산"이 거대해 보입니다.
A5. → 고유벡터, . → 고유벡터, . 대각행렬은 대각선 값이 곧 고유값이고 축 방향이 고유벡터입니다.
A6. → .\
검산: 대각합 ✅, 행렬식 ✅A7. , 합 .\
: ❌ / : ✅\
따라서 입니다. 4차원을 2차원으로 줄이면서 정보의 93%를 지킵니다.A8.
U,S,Vt = np.linalg.svd(A)→energy = np.cumsum(S**2)/np.sum(S**2)→k = int(np.searchsorted(energy, target)) + 1→return U[:,:k] @ np.diag(S[:k]) @ Vt[:k,:], k.\
searchsorted는 정렬된 배열에서 목표값이 들어갈 위치를 찾아주므로, 조건을 만족하는 최소 인덱스를 한 번에 구할 수 있습니다.A9.
W3, b3를 추가하고,forward에z2 → h2 → z3 → softmax단계를 넣습니다.backward에서는gz3 = y_hat - y에서 시작해 같은 패턴을 한 번 더 반복하면 됩니다:\
gz2 = (W3 @ gz3) * (z2 > 0)→gW2 = np.outer(h1, gz2)→ ...\
📌 층이 늘어도 "뒤층 기울기를 가중치로 되돌리고 → 활성화 미분을 곱하고 → 외적으로 가중치 기울기"라는 패턴이 똑같이 반복됩니다. 이것이 역전파가 층 수와 무관하게 작동하는 이유입니다. 🔁A10. ① 메모리: 개 원소를 float64로 저장하면 800GB 💥 ② 연산량: 전체 SVD는 으로 사실상 불가능 ③ 희소성: 99.9%가 빈칸인데 0을 전부 저장하는 것은 낭비.\
해결: 희소 행렬 자료구조 +svds(부분 SVD), 또는 관측값만 쓰는 ALS(00-03 최소제곱 🔗)나 경사하강법(00-04 🔗) 기반 행렬 분해.A11. 둘 다 "정보를 좁은 통로로 밀어 넣어 핵심만 남기게 강제하는 것"입니다. 🚪\
• SVD의 : 행렬이 통과할 수 있는 랭크의 상한\
• 은닉층 크기: 정보가 통과하는 차원의 상한\
둘 다 작으면 표현력 부족(과소적합), 크면 잡음까지 학습(과적합)이라는 같은 트레이드오프를 가집니다. 실제로 오토인코더는 이 둘을 명시적으로 결합한 모델이며, 은닉층에 선형 활성화만 쓰면 수학적으로 PCA와 동일해집니다! 😲🔗
✨ 이번 장에서 배운 내용
🎯 개념 요약
🏹 고유벡터 — , 특성방정식으로 유도\
✂️ SVD — , 직사각형도 OK\
📊 에너지 비율 — 를 정하는 정량적 기준\
🏆 에카르트–영 — 오차 , 최적 근사\
🎯 PCA — 분산 최대 방향, \
🎬 추천 — , 압축이 곧 예측\
🤖 종합 — 6개 장이 한 바퀴 안에서 맞물림
📌 핵심 문장 3가지
① 🏹 고유벡터는 행렬을 곱해도 방향이 변하지 않는 벡터이며, 고유값이 클수록 그 방향이 지배적이다.\
\
② ✂️ SVD는 어떤 행렬이든 로 분해하며, 작은 특잇값을 버린 근사는 수학적으로 최적이다. PCA는 이를 분산 최대 방향 찾기에 응용한 것이다.\
\
③ 🤖 신경망 학습은 벡터·행렬(입력) → 확률(손실) → 미분(역전파) → 갱신이 한 바퀴를 이루며 반복되는 과정이고, SVD·PCA는 그 데이터를 미리 압축하는 역할을 한다.
🗺️ 이 책 전체 지도 — 여섯 개의 재료가 어떻게 이어지는가
| 장 | 핵심 개념 | 핵심 수식 | 신경망에서의 역할 |
|---|---|---|---|
| 00-01 벡터 | 내적·노름·유사도 | 뉴런 하나의 계산, 외적으로 기울기 | |
| 00-02 행렬 | 행렬곱·전치·역행렬 | 층 전체의 순전파 | |
| 00-03 최소제곱 | 과결정계·정규방정식 | 선형회귀 = 1층 신경망, 잔차 개념 | |
| 00-04 미분 | 연쇄법칙·경사하강법 | 역전파와 학습 그 자체 | |
| 00-05 확률 | 베이즈·소프트맥스·CE | 출력의 확률화와 손실 계산 | |
| 00-06 SVD·PCA | 분해·차원축소 | 데이터 압축·전처리·LoRA |
☑️ 개념 체크리스트 (성취 기준)
☐ 고유벡터를 "방향이 변하지 않는 화살표" 비유로 설명할 수 있다 🟢\
☐ 특성방정식 으로 2×2 고유값을 손으로 구할 수 있다 🔵⭐\
☐ 대각합=고유값 합, 행렬식=고유값 곱으로 검산할 수 있다 🔵\
☐ SVD가 고유값 분해로 못 하는 직사각 행렬을 다룰 수 있음을 설명할 수 있다 🔵⭐\
☐ 가 "회전→늘이기→회전"임을 설명할 수 있다 🔵\
☐ 에너지 비율로 를 정량적으로 정할 수 있다 🔵⭐\
☐ 압축 오차가 임을 코드로 확인할 수 있다 🔴\
☐ PCA가 분산 최대화 문제의 해가 고유벡터임을 설명할 수 있다 🔵⭐\
☐ PCA의 고유값과 SVD 특잇값의 관계 를 검증할 수 있다 🔴\
☐ PCA 전 중심화·표준화가 왜 필요한지 설명할 수 있다 🔵⭐\
☐ 추천 시스템에서 를 키우면 예측이 0에 수렴하는 이유를 설명할 수 있다 🔴\
☐ "미평가 0"을 그대로 쓰면 안 되는 이유와 대안을 말할 수 있다 🔴⭐\
☐ NumPy만으로 2층 신경망의 순전파·역전파를 구현할 수 있다 🔴⭐🚀\
☐ 유도한 역전파 기울기를 수치미분으로 검증할 수 있다 🔴⭐\
☐ 은닉층이 작거나 ReLU가 없으면 XOR을 못 푸는 이유를 설명할 수 있다 🔴
🚫 실수 방지 체크리스트
☐ 고유벡터를 [:, i](열)로 꺼냈는가 — [i]는 틀림\
☐ 부호·크기가 달라도 로 판정했는가\
☐ np.linalg.svd의 S를 np.diag()로 감쌌는가\
☐ 는 [:, :k], 는 [:k, :]로 방향을 맞게 잘랐는가\
☐ 직사각 행렬에 full_matrices=False를 썼는가\
☐ PCA 전에 중심화했는가 / 단위가 다르면 표준화했는가\
☐ np.cov()에 .T를 붙였는가 (또는 rowvar=False)\
☐ eigh 결과를 내림차순으로 정렬했는가\
☐ PCA 복원 시 평균을 다시 더했는가\
☐ 추천에서 관측된 칸에서만 오차를 쟀는가\
☐ 신경망에서 np.outer(앞층 출력, 뒤층 기울기) 순서가 맞는가\
☐ ReLU 미분 * (z1 > 0)을 곱했는가\
☐ 수치미분 후 원상복구했는가\
☐ 새 층·새 손실을 만들면 수치미분으로 검증했는가\
☐ HTML 태그 닫힘 / Mermaid 노드 ID ASCII / 수식·코드 변수명 일치
📚 추가 학습
🖼️ 이미지 압축 체험 — 흑백 사진에 SVD를 적용해 일 때를 나란히 그려보기\
📊 MNIST PCA — 손글씨 784차원을 2차원으로 압축해 산점도로 군집 확인하기\
📝 LSA 실습 — TruncatedSVD로 문서-단어 행렬을 분석해 "의미가 비슷한 문서" 찾기\
🔥 PyTorch 재구현 — MiniNeuralNet을 nn.Linear로 다시 만들고 loss.backward()와 우리 기울기 비교하기\
🎬 추천 개선 — 관측값에만 손실을 걸고 경사하강법으로 학습시키기 (00-04 🔗)\
🤖 오토인코더 — 은닉층이 작은 신경망을 만들어 PCA와 결과가 비슷한지 확인하기\
⚡ LoRA 맛보기 — 큰 행렬 의 변화량을 ()로 학습시켜 파라미터 절감 효과 측정하기
🎉 책을 마치며 — 여섯 개의 재료를 모두 손에 넣었습니다
🛒 벡터로 장바구니를 숫자로 만들었고, 📋 행렬로 성적표를 계산했으며, 🧩 연립방정식으로 사과와 바나나 가격을 알아냈습니다. 🌫️ 미분으로 안개 낀 산에서 내려오는 법을 배웠고, 🏥 확률로 병원 검사의 함정을 간파했으며, 📚 SVD·PCA로 300페이지를 3페이지로 줄였습니다.
그리고 마지막에는 이 여섯 가지를 전부 합쳐 신경망 하나를 처음부터 만들었습니다. 🤖 손으로 유도한 기울기가 수치미분과 소수점 11자리까지 일치하는 것도 직접 확인했죠.
💡 이 모든 것이 가능했던 이유는 여러분이 갑자기 수학 천재가 되어서가 아닙니다. 장바구니, 성적표, 영수증, 등산, 병원 검사, 책 요약처럼 이미 알고 있던 일상의 경험에 정확한 이름표를 붙였을 뿐입니다. 🏷️
🚀 이제 PyTorch로 진짜 모델을 만들어보거나, 캐글(Kaggle)의 실제 데이터에 도전해보세요. 논문의 수식을 만나도 이제는 "아, 이건 내적이구나", "이건 연쇄법칙이구나"라고 읽어낼 수 있을 것입니다.
수고하셨습니다 — 수학은 이제 두려운 존재가 아니라, 여러분이 쓰는 도구입니다. 😊✨
🔜 다음 권 예고 — 01권. 수포자들을 위한 머신러닝 수학 완전기초와 파이썬 맛보기
00권에서 벡터·행렬·연립방정식·미분·확률·SVD라는 여섯 가지 재료를 가볍게 한 바퀴 훑었습니다.
01권에서는 같은 재료를 기호 읽는 법(01-02)부터 다시 시작해, 손으로 계산하고 코드로 검산할 수 있을 만큼 깊게 다집니다. 00권에서 "아, 그런 게 있구나" 했던 개념이 01권을 지나면 "이제 직접 할 수 있다"로 바뀝니다.
💻 GitHub 실습 — 코드로 직접 확인하기
📂 이 장의 코드 폴더: book/00-math-overview-for-beginners/00-06-svd-pca
책에 실린 코드를 장(절)별로 모아 둔 폴더입니다. 아래 파일을 열어 보거나, Colab에서 바로 실행해 보세요.
| 파일 | 용도 | 링크 |
|---|---|---|
00_06_svd_pca.py | 책의 코드 블록 5개를 순서대로 모은 실행 스크립트 (# %% 셀 구분) | 코드 보기 |
00_06_svd_pca.ipynb | 같은 코드를 블록당 셀 1개로 담은 주피터 노트북 | 보기 · Colab |
README.md | 코드 블록 목록 · 실행 방법 · 검증 결과 | 보기 |
🎬 medium-series/08-2-svd-recsys-mini-nn/ | Medium 시리즈 예제 — 같은 주제를 블로그용으로 다듬은 실습 | 폴더 · Colab |
🧪 저장소 검증 상태: ✅ 실행 OK
🔑 핵심 코드 1 — SVD 랭크-k 근사로 평점 예측하기
📄 00_06_svd_pca.py L162–L183 · Block 4 (📍 00-06-D · 4단계 — 추천 시스템: SVD의 실전 활용)
def svd_predict(matrix, k):
    """
    SVD 랭크-k 근사로 평점을 예측합니다.

    비유:
    퍼즐의 큰 패턴 k개만 파악해서 빈칸을 추론하는 것과 같습니다.
    """
    U, S, Vt = np.linalg.svd(matrix, full_matrices=False)
    return U[:, :k] @ np.diag(S[:k]) @ Vt[:k, :]   # 2단계와 동일!

# ══════ 버전 A) 순진한 방법 — 0을 그대로 두고 SVD ══════
U, S, Vt = np.linalg.svd(R, full_matrices=False)
print("\n[A] 특잇값:", S.round(3))

energy = np.cumsum(S**2) / np.sum(S**2)
print("[A] k별 예측값과 관측 오차")
for k in range(1, 6):
    P = svd_predict(R, k)
    # 관측된 칸에서만 오차 측정 (00-03의 잔차 개념 🔗)
    rmse = np.sqrt(np.mean((P[mask] - R[mask])**2))
    print(f"   k={k}: 에너지 {energy[k-1]:.3f} | [0,2] 예측 {P[0,2]:6.2f}"
          f" | 관측 RMSE {rmse:.4f}")
▶ 실행 결과 — 위 코드를 실행한 출력 (직접 실행: Windows · Python 3.11.2 · numpy 2.4.6, 앞 블록부터 순서대로 실행)
[A] 특잇값: [12.534  8.079  3.479  2.263  0.627]
[A] k별 예측값과 관측 오차
   k=1: 에너지 0.655 | [0,2] 예측   2.37 | 관측 RMSE 1.6271
   k=2: 에너지 0.927 | [0,2] 예측   0.50 | 관측 RMSE 0.7873
   k=3: 에너지 0.977 | [0,2] 예측   0.63 | 관측 RMSE 0.4487
   k=4: 에너지 0.998 | [0,2] 예측   0.18 | 관측 RMSE 0.1220
   k=5: 에너지 1.000 | [0,2] 예측   0.00 | 관측 RMSE 0.0000
🔑 핵심 코드 2 — MiniNeuralNet의 순전파·역전파 (XOR 학습)
📄 00_06_svd_pca.py L236–L265 · Block 5 (📍 00-06-E · 5단계 — 종합: 00-01부터 00-06까지 하나로 잇기)
    def forward(self, x):
        """순전파: 입력 → 예측 확률"""
        self.x = x
        self.z1 = x @ self.W1 + self.b1        # 00-02 행렬곱
        self.h1 = np.maximum(0, self.z1)         # 00-04 ReLU
        self.z2 = self.h1 @ self.W2 + self.b2  # 00-02 행렬곱
        self.y_hat = self.softmax(self.z2)     # 00-05 확률화
        return self.y_hat

    def loss(self, y):
        """00-05: 교차 엔트로피 L = -Σ y log(ŷ)"""
        return -np.sum(y * np.log(self.y_hat + 1e-15))

    def backward(self, y):
        """
        역전파: 00-04의 연쇄법칙으로 기울기 계산.
        기울기 변수는 지시서 규칙대로 g 접두사를 씁니다.
        """
        # 🎁 00-05에서 유도한 선물: softmax + CE의 기울기 = ŷ - y
        gz2 = self.y_hat - y

        gW2 = np.outer(self.h1, gz2)     # 00-01 외적 → (은닉, 출력) 행렬
        gb2 = gz2

        # 00-04 연쇄법칙: 뒤층 기울기를 W2로 되돌리고 ReLU 문지기 통과
        gz1 = (self.W2 @ gz2) * (self.z1 > 0)

        gW1 = np.outer(self.x, gz1)
        gb1 = gz1
        return gW1, gb1, gW2, gb2
▶ 실행 결과 — Block 5 전체를 실행한 출력 (직접 실행: Windows · Python 3.11.2 · numpy 2.4.6, 앞 블록부터 순서대로 실행)
=== 학습 시작 (은닉 8개) ===
    0 epoch: 평균 손실 = 0.7535
   50 epoch: 평균 손실 = 0.0999
  100 epoch: 평균 손실 = 0.0185
  150 epoch: 평균 손실 = 0.0094
  200 epoch: 평균 손실 = 0.0063
  250 epoch: 평균 손실 = 0.0046
  299 epoch: 평균 손실 = 0.0037

=== 최종 예측 ===
  입력[0. 0.] → 예측0 (정답0) 확률[0.998 0.002] ✅
  입력[0. 1.] → 예측1 (정답1) 확률[0.01 0.99] ✅
  입력[1. 0.] → 예측1 (정답1) 확률[0.001 0.999] ✅
  입력[1. 1.] → 예측0 (정답0) 확률[0.999 0.001] ✅

=== 역전파 기울기 검증 (수치미분과 대조) ===
  공식 gW2 첫 행: [ 0.203899 -0.203899]
  수치 gW2 첫 행: [ 0.203899 -0.203899]
  최대 오차: 6.61e-12
☁️ Colab에서 바로 실행
👉 Open in Colab — 00_06_svd_pca.ipynb · 설치 없이 브라우저에서 셀을 위에서부터 순서대로 실행하세요.
🖥️ 내 컴퓨터에서 실행하기
git clone https://github.com/otoloism/Zero_to_ML_Master.git
cd Zero_to_ML_Master
python -m venv .venv
source .venv/bin/activate          # Windows: .venv\Scripts\activate
pip install -r book/requirements.txt   # 책 전체용 (PyTorch 등 포함, 용량 큼)
# 이 장만 실행한다면 이것만으로 충분합니다: pip install numpy
cd book/00-math-overview-for-beginners/00-06-svd-pca
python 00_06_svd_pca.py
⭐ GitHub Star / Fork
⭐ 코드가 도움이 되셨다면 GitHub 저장소에 Star를 눌러 주세요. 새 장의 코드가 올라올 때 가장 먼저 알 수 있습니다.
🍴 직접 고쳐 보며 실험하고 싶다면 Fork 해서 내 저장소에서 마음껏 바꿔 보세요. 오류 제보·개선 제안은 Issues로 환영합니다!
🔮 다음 글 예고
다음 글부터는 01권 — 수포자들을 위한 머신러닝 수학 완전기초가 시작됩니다. 첫 글은 01-01 왜 수학인가? — 요리를 배울 것인가, 라면만 끓이다 갈 것인가! 🍜 입니다. model.fit() 한 줄의 한계, 운전 → 정비로 이어지는 4단계 학습 로드맵, 그리고 지금까지 배운 여섯 장을 20줄 코드로 다시 맛봅니다.
⬅️ 이전 글: #09 고유값·SVD·PCA 쉽게 이해하기 — 300페이지 책을 3페이지로 (1부) \
➡️ 다음 글: #11 머신러닝에 수학이 왜 필요할까? — 라면과 요리로 보는 AI 수학 공부법 (파이썬 20줄 맛보기)
📚 더 깊이 공부하고 싶다면
이 시리즈는 수학을 놓았던 비전공자가 AI를 직접 구현하기까지의 공부 기록을 그대로 옮긴 연재입니다. 원문 책, 코드, 개념 사전을 함께 보면 훨씬 빨리 늡니다. 🚀
| 바로가기 | 이런 분께 | |
|---|---|---|
| 📘 책 (위키독스, 무료) | Zero to 머신러닝 딥러닝 Master | 5권 · 20개 장 · 163개 절 전체를 순서대로 읽고 싶은 분 |
| 📄 이 글의 원문 | 00-06 SVD·PCA — 300페이지 책을 3페이지로 (2부) | 연습문제·해설까지 전부 보고 싶은 분 |
| 💻 실습 코드 (GitHub) | otoloism/Zero_to_ML_Master | .py·.ipynb를 Colab에서 바로 돌려보고 싶은 분 |
| 🏠 머신러닝 백과사전 | mldict.net | 본문 속 핵심 개념을 카드로 다시 확인하고 싶은 분 |
| ✍️ 기술 블로그 | wikidocs.net/blog/@mldict | 새 글 알림을 가장 먼저 받고 싶은 분 |
⭐ 도움이 되셨다면 velog 팔로우와 GitHub Star를 눌러 주세요. 다음 글을 쓰는 가장 큰 힘이 됩니다. 궁금한 점은 댓글로 편하게 남겨 주세요! 🙌