데이터 분석 라이브러리 함수 모음
AICE 연습문제 풀이
AICE 총정리
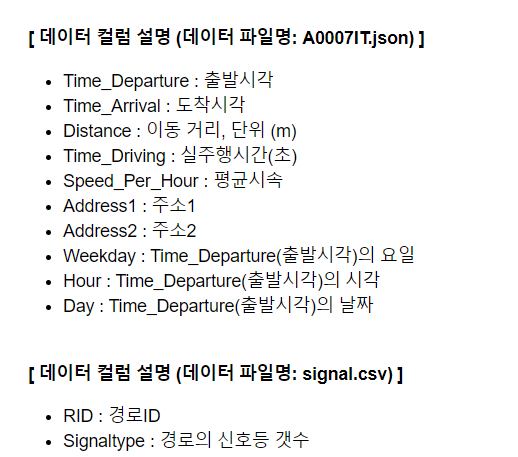
- scikit-learn 패키지는 머신러닝 교육을 위한 최고의 파이썬 패키지 입니다. scikit-learn를 별칭(alias) sk로 임포트하는 코드를 작성하고 실행하세요.
import sklearn as sk
- Pandas는 데이터 분석을 위해 널리 사용되는 파이썬 라이브러리 입니다. Pandas를 사용할 수 있도록 별칭(alias)을 pd로 해서 불러오세요.
import pandas as pd
- 모델링을 위해 분석 및 처리할 데이터 파일을 읽어오려고 합니다. Pandas 함수로 2개 데이터 파일을 읽고 합쳐서 1개의 데이터 프레임 변수명 df에 할당하는 코드를 작성하세요.
- A0007IT.json 파일을 읽어 데이터 프레임 변수 df_a에 할당하세요.
- signal.csv 파일을 읽어 데이터 프레임 변수명 df_b에 할당하세요.
- df_a와 df_b 데이터프레임을 판다스의 merge 함수를 활용하여 합쳐 데이터프레임 변수명 df에 저장하세요.
- 합칠 때 사용하는 키(on) : 'RID'
- 합치는 방법(how): 'inner'
import pandas as pd  # pandas 임포트

# A0007IT.json 파일을 읽어 데이터프레임 df_a에 저장
df_a = pd.read_json("A0007IT.json")

# signal.csv 파일을 읽어 데이터프레임 df_b에 저장
df_b = pd.read_csv("signal.csv")

# 두 데이터프레임을 'RID'를 기준으로 inner join
df = pd.merge(df_a, df_b, on="RID", how="inner")

# 결과 출력
df
다음 문항을 풀기 전에 아래 코드를 실행하세요
import matplotlib.pyplot as plt
import matplotlib.font_manager as fm
plt.rc('font', family='NanumGothicCoding')
- Address1(주소1)에 대한 분포도를 알아 보려고 합니다.
Address1(주소1)에 대해 countplot 그래프로 만드는 코드와 답안을 작성하세요
- Seaborn을 활용하세요
- 첫번째, Address1(주소1)에 대해서 분포를 보여주는 countplot 그래프를 그리세요
- 두번째, 지역명이 없는 '-'에 해당되는 row(행)을 삭제하세요
- 출력된 그래프를 보고 해석한 것으로 옳지 않은 선택지를 아래에서 골라 답안04 변수에 저장하세요(예 답안04=4)
1) Countplot 그래프에서 Address1(주소1) 분포를 확인시 '경기도' 분포가 제일 크다.
2) Address1(주소1) 분포를 보면 '인천광역시'보다 '서울특별시'가 더 크다.
3) 지역명이 없는 '-'에 해당되는 row(행)가 2개 있다.
import seaborn as sns

import seaborn as sns

sns.countplot(data=df, x='Address1')
plt.show()

df = df[df['Address1'] != '-']
df
답안04=3
- 실주행시간과 평균시속의 분포를 같이 확인하려고 합니다.
Time Driving(실주행시간)과 Speed_Per_Hour(평균시속)을 jointplot 그래프로 만드세요
- Seanorn을 활용하세요
- X축에는 Time_Driving(실주행시간)을 표시하고 Y축에는 Speed_Per_Hour(평균시속)을 표시하세요.
sns.jointplot(data=df, x='Time_Driving',y='Speed_Per_Hour')
plt.show()
- 위의 jointplot 그래프에서 시속 300이 넘는 이상치를 발견할 수 있습니다. 가이드에 따라 전처리를 수행하고 저장하세요.
- 대상 데이터프레임 : df
- jointplot 그래프를 보고 시속 300이상되는 이상치를 찾아 해당 행 (Row)을 삭제하세요.
- 불필요한 'RID' 컬럼을 삭제하세요.
- 전처리 반영 후에 새로운 데이터프레임 변수명 df_temp에 저장하세요.
df_temp = df[df['Speed_Per_Hour']<300]
df_temp
- 모델링 성능을 제대로 얻기 위해 결측치 처리는 필수입니다.
아래 가이드를 따라 결측치 처리하세요.
- 대상 데이터 프레임: df_temp
- 결측치를 확인하는 코드를 작성하세요.
- 결측치가 있는 행(raw)를 삭제하세요.
- 전처리 반영된 결과를 새로운 데이터 프레임 변수명 df_na에 저장하세요.
- 결측치 개수를 '답안07' 변수에 저장하세요(예. 답안07 = 5)
# 결측치 확인
missing_values = df_temp.isnull().sum()
total_missing = missing_values.sum()  # 전체 결측치 개수

df_na = df_temp.dropna()

# 결측치 개수를 변수에 저장
답안07 = total_missing
- 모델링 성능을 제대로 얻기 위해서 불필요한 변수를 삭제해야 합니다. 아래 가이드를 따라 불필요 데이터를 삭제 처리하세요.
- 대상 데이터프레임: df_na
- 'Time_Departure', 'Time_Arrival' 2개 컬럼을 삭제하세요.
- 전처리 반영된 결과를 새로운 데이터 프레임 변수명 df_del에 저장하세요.
# 불필요한 컬럼 삭제
df_del = df_na.drop(columns=["Time_Departure", "Time_Arrival"])
- 원-핫 인코딩(One_hot encoding)은 범주형 변수를 1과 0의 이진형 벡터로 변환하기 위하여 사용하는 방법입니다.
원-핫 인코딩으로 아래 조건에 해당하는 컬럼 데이터를 변화하세요.
- 대상 데이터프레임: df_del
- 원-핫 인코딩 대상: object 타입의 전체 컬럼
- 활용함수: Pandas의 get_dummies
- 해당 전처리가 반영된 결과를 데이터프레임 변수 df_preset에 저장해 주세요
cols = df_del.select_dtypes('object').columns
df_preset = pd.get_dummles(data=df_del, columns= cols)
- 훈련과 검증 각각에 사용할 데이터셋을 분리하려고 합니다.
Time_Driving(실주행시간) 컬럼을 label값 y로, 나머지 컬럼을 feature값 X로 할당한 후 훈련데이터셋과 검증데이터셋으로 분리하세요.
추가로, 가이드에 따라서 훈련데이터셋과 검증데이터셋에 스케일링을 수행하세요.
- 대상 데이터프레임: df_preset
- 훈련과 검증 데이터셋 분리
- 훈련 데이터셋 label: y_train, 훈련 데이터셋 Feature: X_train
- 검증 데이터셋 label: y_valid, 검증 데이터셋 Feature: X_valid
- 훈련 데이터셋과 검증데이터셋 비율은 80: 20
- random_state : 42
- Scikit-learn의 train_test_split 함수를 활용하세요.
- RobustScaler 스케일링 수행
- sklearn.perprocessing의 RobustScaler 함수 사용
- 훈련데이터셋의 Feature는 RobustScaler의 fit_transform 함수를 활용하여 X_train 변수로 할당
- 검증데이터셋의 Reature는 RobustScaler의 transform함수를 활용하여 X_test 변수로 할당
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import RobustScaler

# Feature(X)와 Label(y) 분리
X = df_preset.drop(columns=["Time_Driving"])  # Feature 데이터
y = df_preset["Time_Driving"]  # Label 데이터

# 훈련 데이터셋과 검증 데이터셋 분리 (80:20 비율, random_state=42 설정)
X_train, X_valid, y_train, y_valid = train_test_split(X, y, test_size=0.2, random_state=42)

# RobustScaler 객체 생성
scaler = RobustScaler()

# 훈련 데이터셋 Feature 변환 (fit_transform 적용)
X_train = scaler.fit_transform(X_train)

# 검증 데이터셋 Feature 변환 (transform 적용)
X_valid = scaler.transform(X_valid)
- Time_Driving(실주행시간)을 예측하는 머신러닝 모델을 만들려고 합니다.
의사결정나무(dcision tree)와 랜덤포레스트(RandomForest)는 여러 가지 규칙을 순차적으로 적용하면서 독립 변수 공간을 분할하는 모형으로 분류(classification)와 회귀분석(regression)에 모두 사용될 수 있습니다.
아래 가이드에 따라 의사결정나무와 랜덤포레스트 모델을 만들고 학습을 진행하세요.
- 의사결정나무
- 트리의 최대 깊이: 5로 설정
- 노드를 분할하기 위한 최소한의 샘플 데이터수(min_samples_split): 3로 설정
- random_state : 120로 설정
- 의사 결정 나무 모델을 dt 변수에 저장해 주세요.
- 랜덤포레스트
- 트리의 최대 깊이: 5로 설정
- 노드를 분할하기 위한 최소한의 샘플 데이터수(min_sample_split): 3로 설정
- 랜덤포레스트(RandomForest)모델을 rf 변수에 저장해주세요.
- 위의 2개의 모델에 대해 fit을 활용해 모델을 학습해 주세요, 학습 시 훈련 데이터 셋을 활용해주세요.
from sklearn.tree import DecisionTreeRegressor
from sklearn.ensemble import RandomForestRegressor

# 의사결정나무 모델 생성
dt = DecisionTreeRegressor(max_depth=5, min_samples_split=3, random_state=120)

# 랜덤포레스트 모델 생성
rf = RandomForestRegressor(max_depth=5, min_samples_split=3, random_state=120)

# 모델 학습 (훈련 데이터셋 활용)
dt.fit(X_train, y_train)
rf.fit(X_train, y_train)

# 학습 완료 확인
print("의사결정나무 모델 학습 완료!")
print("랜덤포레스트 모델 학습 완료!")
- 위 의사결정나무와 랜덤포레스트 모델의 성능을 평가하려고 합니다.
아래 가이드에 따라 예측 결과의 mae(Mean Absolute Error)를 구하고 평가하세요.
- 성능 평가는 검증 데이터셋을 활용하세요
- 11번 문제에서 만든 의사결정나무 모델로 y값을 예측하여 y_pred_df에 저장하세요
- 검증 정답과 예측값의 mae를 구하고 dt_mae 변수에 저장하세요
- 11번 문제에서 만든 랜덤포레스트 모델로 y값을 예측하여 y_pred_rf에 저장하세요
- 검증 정답과 예측값의 mad를 구하고 rf_mae 변수에 저장하세요
- 2개의 모델에 대한 mae 성능평가 결과을 확인하여 성능좋은 모델 이름을 '답안12'변수에 저장하세요 (예. 딥인12 = 'decisiontree' 혹은 답안12 = 'randomforest'
from sklearn.metrics import mean_absolute_error

# 의사결정나무 모델 예측
y_pred_dt = dt.predict(X_valid)

# 랜덤포레스트 모델 예측
y_pred_rf = rf.predict(X_valid)

# MAE 계산 (Mean Absolute Error)
dt_mae = mean_absolute_error(y_valid, y_pred_dt)
rf_mae = mean_absolute_error(y_valid, y_pred_rf)

# 성능 비교 후 가장 성능이 좋은 모델 저장
답안12 = "decisiontree" if dt_mae < rf_mae else "randomforest"
- Time_Driving(실주행시간)을 예측하는 딥러닝 모델을 만들려고 힙니다.
아래 가이드에 따라 모델링하고 학습을 진행하세요
- Tensorflow framework를 사용하여 딥러닝 모델을 만드세요
- 히든레이어(hidden layer)2개이상으로 모델을 구성하세요
- dropout 비율 0.2로 Dropout 레이어 1개를 추가해 주세요.
- 손실함수는 MSE(Mean Squared Error)를 사용하세요
- 하이퍼파라미터 epochs: 30, batch_size:16 으로 설정해주세요.
- 각 에포크마다 loss와 metrics 평가하기 위한 데이터로 x_valid, t_valid 사용하세요.
- 학습정보는 history 변수에 저장해주세요
# 모델 생성
model = Sequential([
    Dense(64, activation='relu', input_shape=(X_train.shape[1],)),  # 입력층 + 첫 번째 히든레이어
    Dense(32, activation='relu'),  # 두 번째 히든레이어
    Dropout(0.2),  # Dropout 레이어 (과적합 방지)
    Dense(16, activation='relu'),  # 세 번째 히든레이어
    Dense(1)  # 출력층 (실수값 예측)
])

# 모델 컴파일 (손실 함수: MSE, 최적화 함수: Adam)
model.compile(optimizer='adam', loss='mse', metrics=['mae'])

# 모델 학습 (훈련 데이터셋 사용)
history = model.fit(
    X_train, y_train,
    validation_data=(X_valid, y_valid),  # 검증 데이터 사용
    epochs=30,
    batch_size=16,
    verbose=1  # 학습 과정 출력
)
- 위 딥러닝 모델의 성능을 평가하려고 합니다.
Matplotlib 라이브러리 활용해서 학습 mse와 검증 mse를 그래프로 표시하세요
- 1개의 그래프에 학습 mse과 검증 mse 2가지를 모두 표시하세요
- 위 2가지 각각의 범례를 'mse', 'val_mse'로 표시하세요
- 그래프의 타이틀은 'Model MSE'로 표시하세요
- X축에는 'Epochs'라고 표시하고 Y축에는 'MSE'라고 표시하세요
import matplotlib.pyplot as plt

# 학습 과정에서 저장된 MSE 값 가져오기
train_mse = history.history['loss']  # 학습 데이터 MSE
val_mse = history.history['val_loss']  # 검증 데이터 MSE
epochs = range(1, len(train_mse) + 1)  # Epoch 값

# 그래프 그리기
plt.figure()
plt.plot(epochs, train_mse, 'b', label='mse')  # 학습 MSE
plt.plot(epochs, val_mse, 'r', label='val_mse')  # 검증 MSE

# 그래프 설정
plt.title('Model MSE')
plt.xlabel('Epochs')
plt.ylabel('MSE')
plt.legend()  # 범례 추가
plt.grid()

# 그래프 출력
plt.show()
