pandas 시계열 데이터
Rolling & Expanding
Rolling
window값, center값에 따른 출력 값 변화
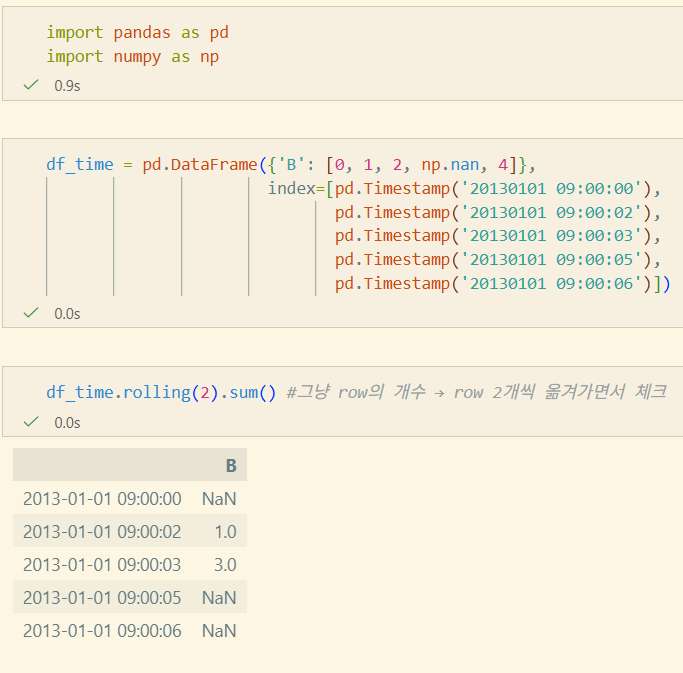
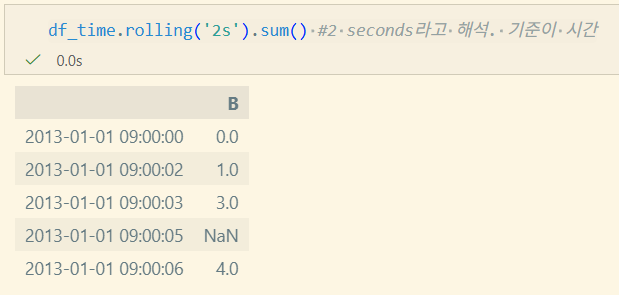
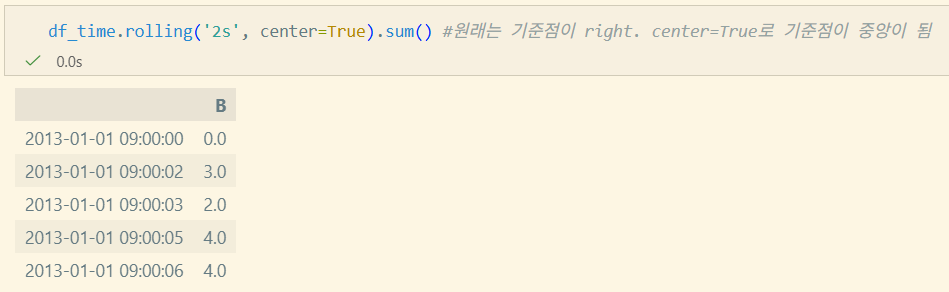
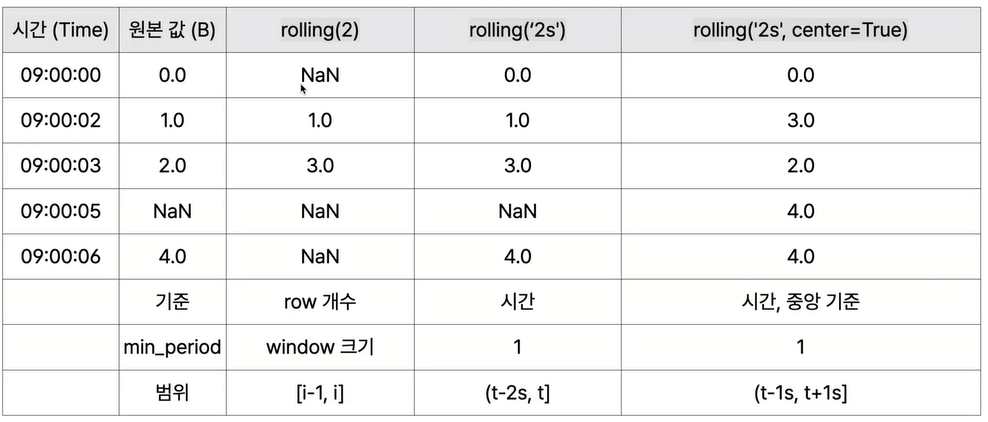
- NaN 값인 이유 → min_periods 값에 못미쳐서
- rolling('2s')에서는 기본적으로 min_periods가 1이 됨.
- 기본적으로 범위 포함은 right가 default여서, 왼쪽은 포함 x 오른쪽은 포함 o
- ex) 09:00:05에서 3초대는 미포함, 5초대는 포함 → NaN값
- 보통 center보단 기본인 right가 많이 쓰인다.
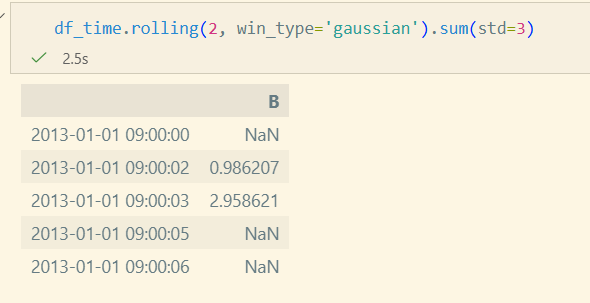
- rolling에서 win_type이 주어진 경우 Window class가 반환됨
- mean, sum, var, std 함수를 호출할 때 추가 parameter 필요
- win_type이 가우시안일때, 표준편차값 필요
https://pandas.pydata.org/pandas-docs/stable/reference/window.html
- mean, sum, var, std 함수를 호출할 때 추가 parameter 필요
- win_type 주려면 scipy 가 필요
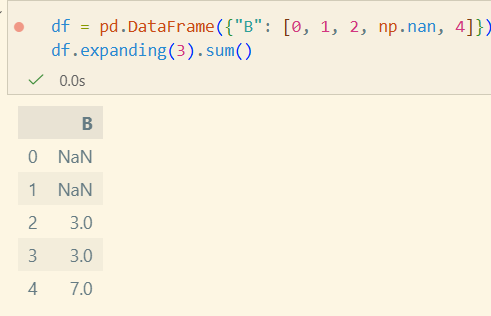
expanding
DataFrame.expanding(min_periods=1, axis=<no_default>, method='single')min_periods: intaxis: 0 or 'index', 1 or 'columns'method: 'single', 'table'
시계열 분해(Decomposition)
시계열 데이터를 구성하는 요소들을 분리하여 각 요소의 특성 파악, 예측 모델의 정확도를 높이기 위해 사용
- 주요 이유
- 숨겨진 패턴 이해: 추세, 주기성, 계절성 파악
- 예측 정확도 향상
- 모델 선택 및 성능 평가에 적용
요소 및 방법
요소
- 추세 (Trend): 이게 미래에도 유망하냐
- 주기성/순환성 (Cycle): 반도체 빅사이클 ㅋㅋ
- 계절성 (Seasonality)
- 불규칙성 (Irregularity)
분해 방법
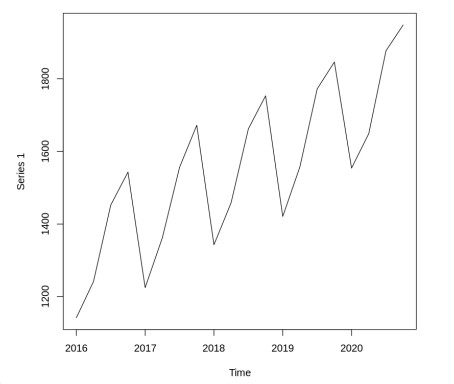
-
가법 모델 (Additive)
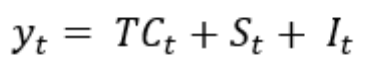
-
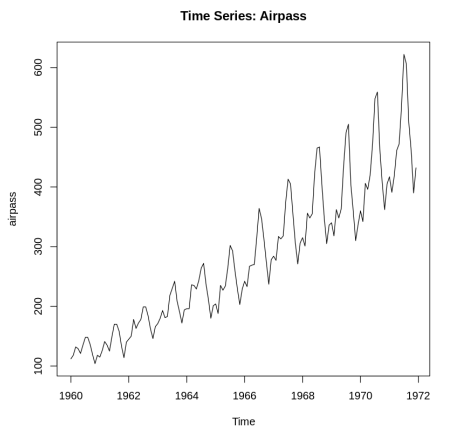
승법 모델 (Multiplicative)
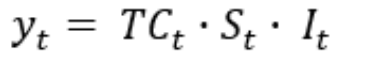
Statemodule 패키지
통계 모델의 추정, 통계 검정 수행 및 통계 데이터 탐색을 위한 클래스와 함수를 제공하는 python 모듈
- statsmodels에서 제공하는 시계열 분해 가능
- seasonal_decompose
- 가법/승법 모델 지원
- 계절성이 안정적이고 데이터에 noise 가 너무 많지 않을 때 유용
- STL(Seasonal-Trend Decomposition using LOESS)
- seasonal_decompose에 비해 유연성, 견고성 ↑
- 복잡한 계절성 다루기 가능
- 이상치에 저항성 o
- 분해 과정 세부 조정 가능
- MSTL(Multi-Seasonal_trend Decompostion using LOESS)
- 여러개의 계절성 요소가 있을때 효과적
LOESS: 국소 가중 회귀(Locally Weighted Regression or Scatterplot Smoothing)의 약자로, 데이터의 전체가 아닌 특정 지점 주변의 데이터에 가중치를 두어 회귀 모델을 만드는 비모수적 통계 기법
주식 데이터 실습
- 주식얘기도 해주셨다.
- 시드머니(본업 급여) 올리는거에 80%, 주식보는데 20% 힘내시라고 하심 ㅋㅋ
- 주식 잘하려면 거시경제 잘해야한다. 세계뉴스도 잘 파악할 필요 있다(환율, 세계 흐름)
FinanceDataReader
- 금융 데이터 수집을 위한 라이브러리
- 설치: pip install -U finance-datareader
- https://github.com/FinanceData/FinanceDataReader
- 주로 사용되는 함수는 아래 두 가지며, 분석할 데이터를 불러오는 데 사용하는 함수는 DataReader 한 가지다.
DataReader(symbol, startdate, enddate)- symbol : 수집 대상 코드
- startdate : 수집 시작 날짜
- enddate : 수집 종료 날짜
StockListing(market)- 거래소 별 상장 종목 목록을 가져오는 함수
import
import pandas as pd
import seaborn as sns
import matplotlib.pyplot as plt
import FinanceDataReader as fdr

plt.rc('font', family='NanumGothic')
Data 읽기
특정 종목에 대한 가격 수집
samsung = fdr.DataReader('005930')
print(samsung.info())
print(samsung)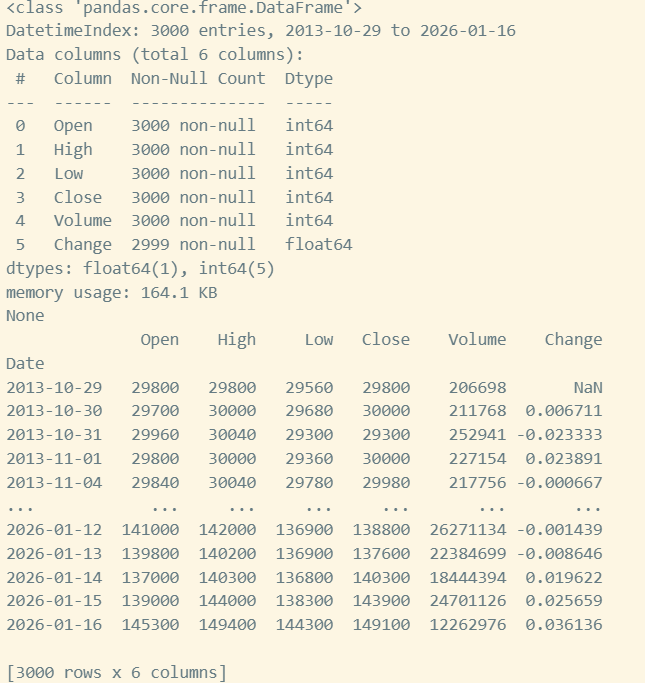
samsung_krx = fdr.DataReader('KRX:005930') # 네이버에서 가져옴. 3000개로 fix되어있음. old data는 제공되지 않음
print(samsung_krx.info())
print(samsung_krx)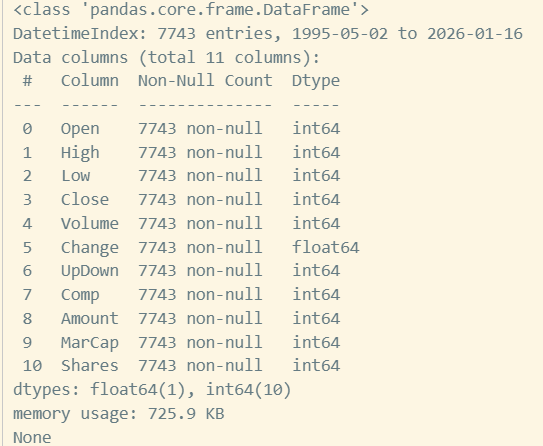
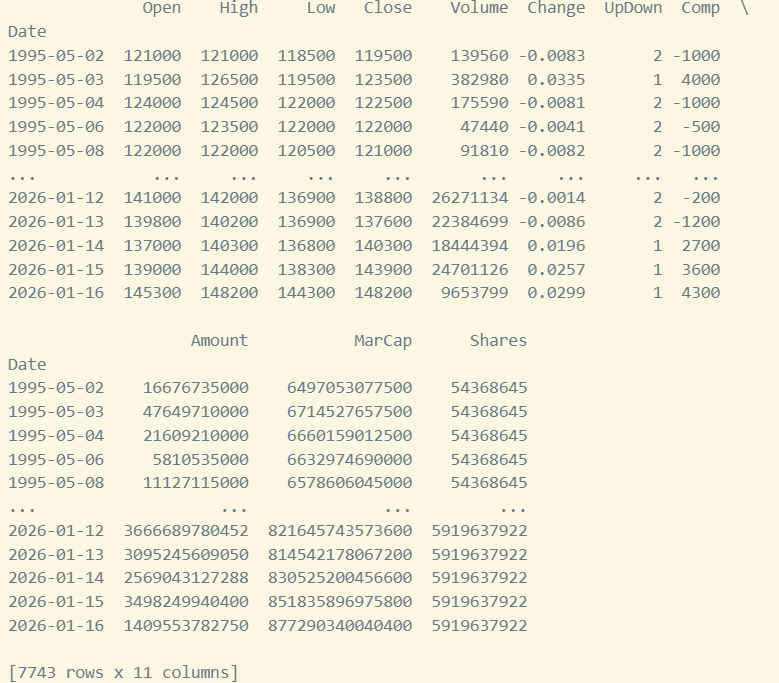
액면 분할에 따른 데이터 확인
- 주식 1장을 주식 50장으로 나눴다네요
- 그래서 95년도에 12만원대였던건 실제로는 50으로 나눈 값이 현재 기준
print(samsung_krx.loc['2017-12-20':'2018-01-05'])
print(samsung_krx.loc['2018-04-26':'2018-05-05'])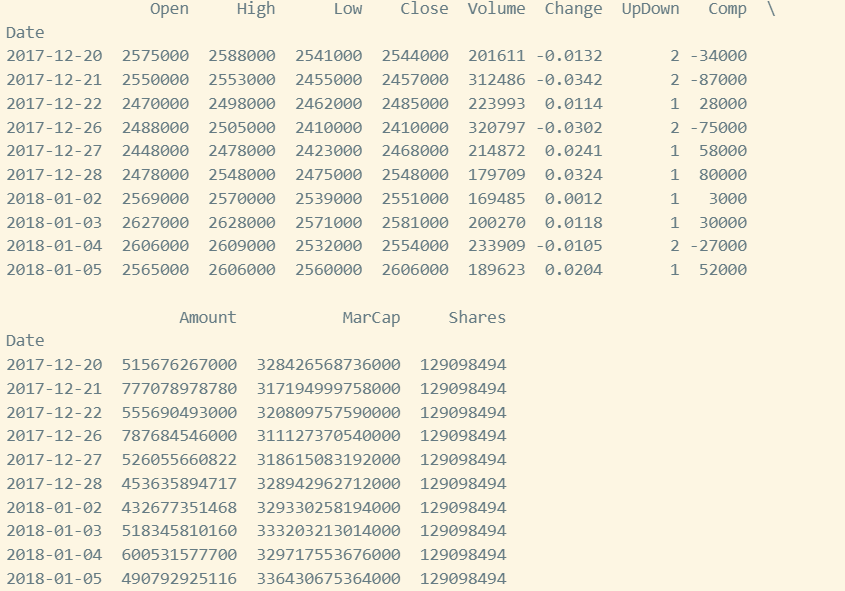
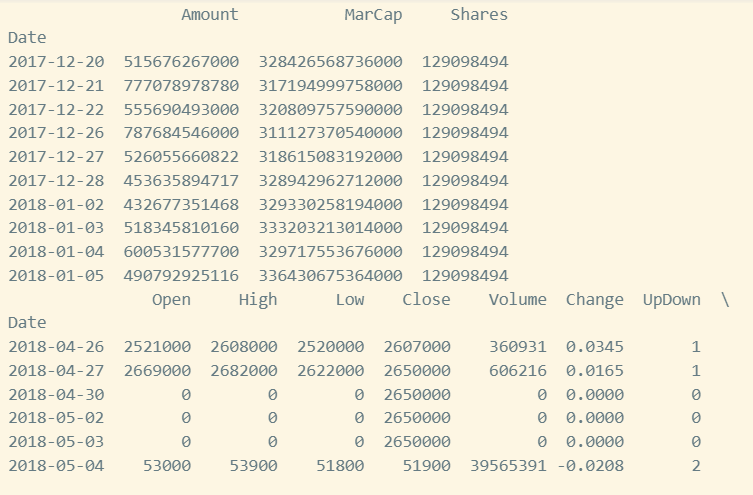
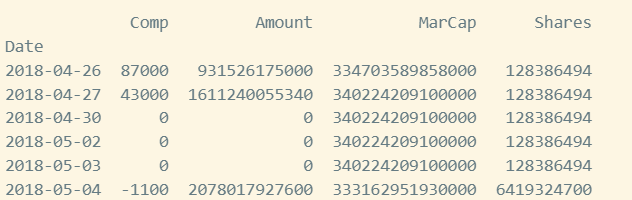
stock = samsung_krx[['Close', 'Volume']].copy()
split_date = pd.Timestamp('2018-05-01')
#퍼모먼스적으로 좋은 call은 아님
stock['Close'] = stock.apply(lambda x: int(x['Close'] / 50) if x.name < split_date else x['Close'], axis=1) #x에 stock의 row 하나씩 들어가는 형식 → series가 됨
stock['Volume'] = stock.apply(lambda x: int(x['Volume'] * 50) if x.name < split_date else x['Volume'], axis=1)
stock = stock[stock['Volume'] != 0]
print(stock.loc['2017-12-20':'2018-01-05'])
print(stock.loc['2018-04-26':'2018-05-05'])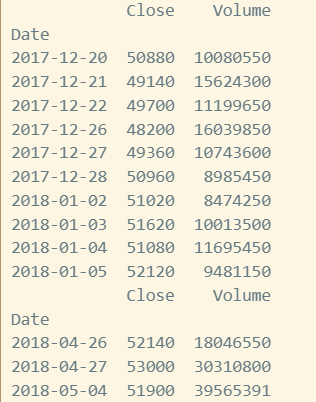
시각화
# 전체 기간
stock.plot(y='Close', title='005930_삼성전자', figsize=(15,5))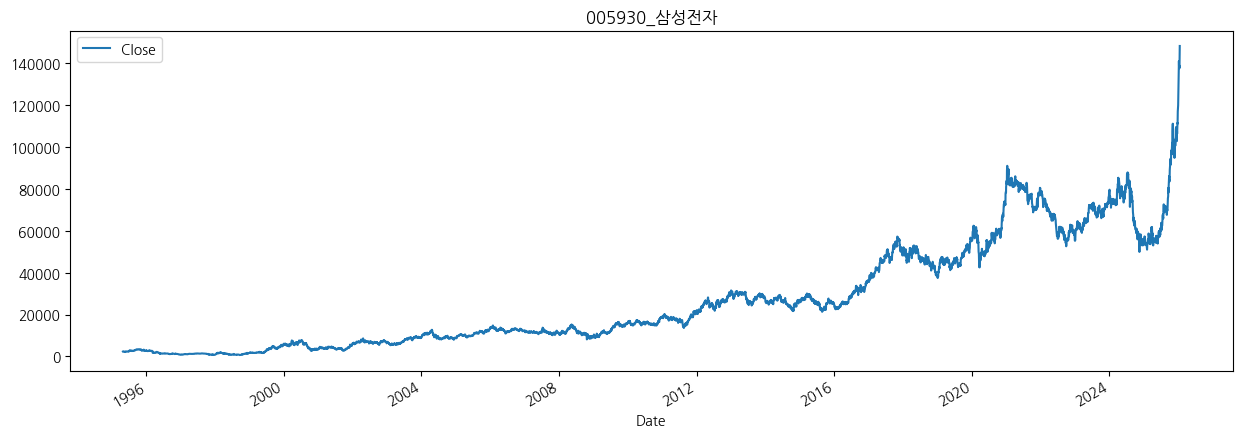
#YTD: Year to Date로 현재 연도의 시작부터 현재까지의 기간
stock.loc['2025'].plot(y='Close', title='005930_삼성전자', figsize=(15,5))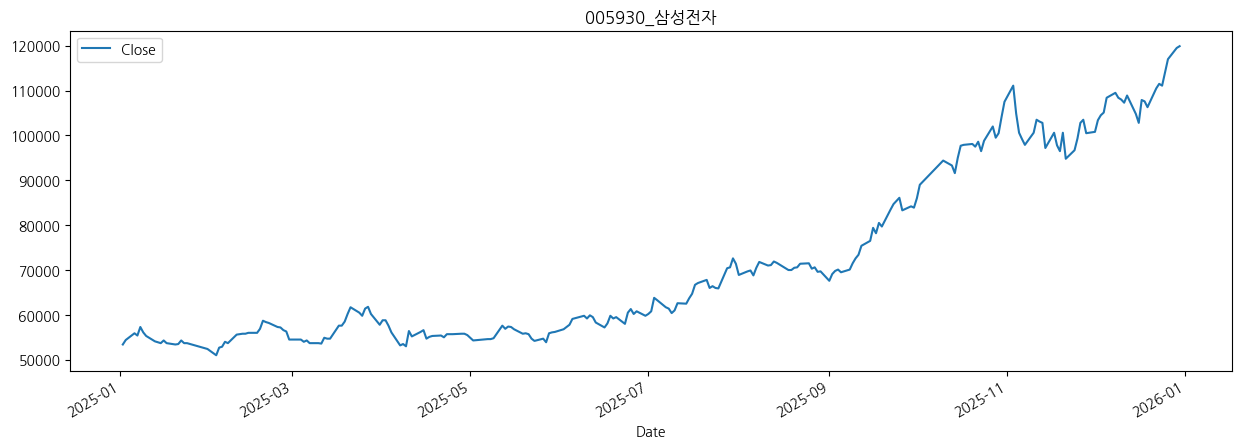
이동평균
- SMA(Simple Moving Average, 단순이동평균)
- 일정 기간동안의 가격 데이터의 평균
- 모든 데이터포인트에 동일한 가중치 부여
- 노이즈를 제거하고 추세를 파악하는 데 유용
- 최신 데이터 반영이 느리다는 단점
- EMA(Exponential Moving Average, 지수이동평균)
- 최근 데이터에 더 높은 가중치를 부여하여 계산된 이동평균
- 최신 가격 움직임을 빠르게 반영
- SMA보다 민감하게 반응하지만, 짧은 기간 설정 시 노이즈가 증가할 수 있음
- 가중치
- : EMA 기간
- EMA 업데이트
- : 현재 가격
- : 이전 EMA 값
SMA
- Simple Moving Average. 단순이동평균
컬럼.rolling(윈도우사이즈).mean()- 단기 이동평균 : 빠른 변동성 파악
- 5일 : 평일 기준 한 주 동안의 거래일수
- 10일
- 20일 : 평일 기준 월간 거래일수
- 중기 이동평균 : 중기적인 가격 추세와 지지 및 저항 수준 파악
- 60일 : 분기(3개월) 기준
- 100일
- 장기 이동평균 : 장기적인 시장 흐름 이해
- 120일 : 반년단위
- 200일 : 1년단위
# 이동평균선 계산
stock['SMA_5'] = stock['Close'].rolling(window=5).mean()
stock['SMA_20'] = stock['Close'].rolling(window=20).mean()
stock['SMA_60'] = stock['Close'].rolling(window=60).mean()
stock['SMA_120'] = stock['Close'].rolling(window=120).mean()

fig, ax1 = plt.subplots(figsize=(15, 8))

# 종가 및 이동평균선 라인플롯
sns.lineplot(data=stock.loc['2025'][['Close', 'SMA_5', 'SMA_20', 'SMA_60', 'SMA_120']], ax=ax1)
ax1.set_title('삼성전자 종가 및 이동평균선 + 거래량 히스토그램')
ax1.set_xlabel('Date')
ax1.set_ylabel('Price')

# 거래량 히스토그램 (세컨더리 y축)
ax2 = ax1.twinx()
ax2.bar(stock.loc['2025'].index, stock.loc['2025']['Volume'], color='gray', alpha=0.3, label='Volume', width=1)
ax2.set_ylabel('Volume')
ax2.legend(loc='upper right')

plt.show()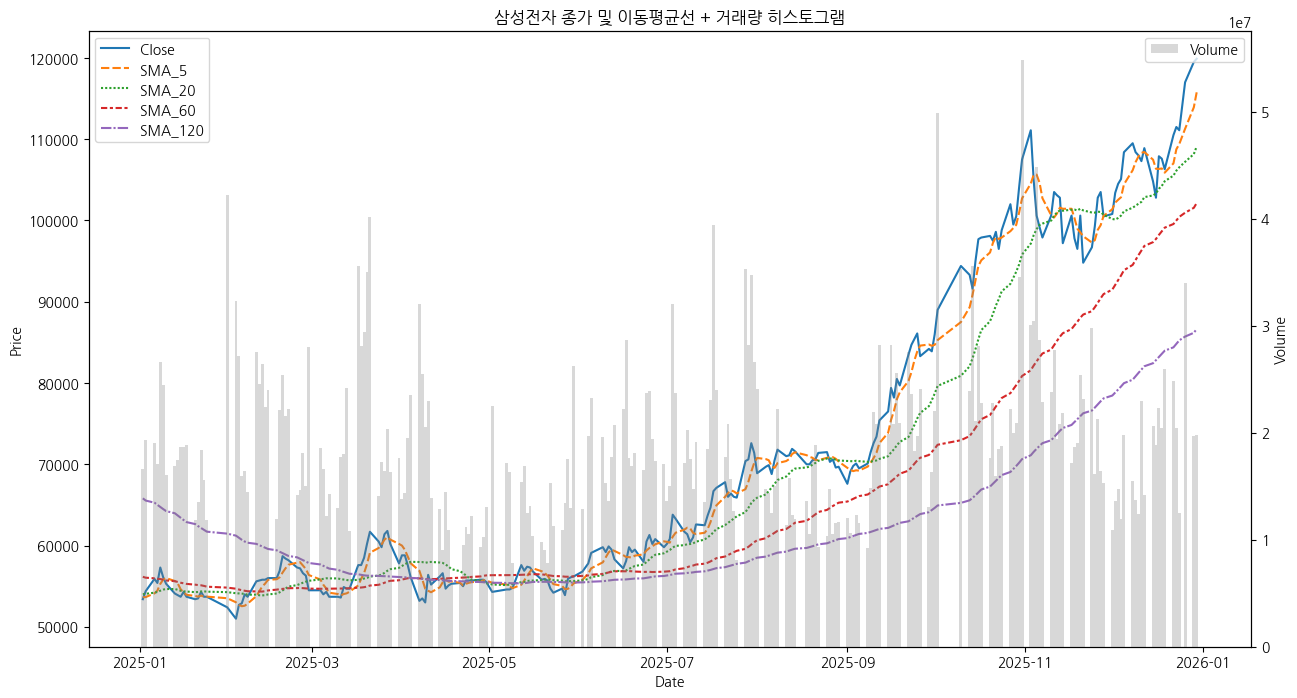
EMA
컬럼.ewm(span=기간, adjust=False).mean()
볼린저 밴드
- 주식, 외환, 암호화폐 등의 금융시장에서 널리 사용되는 기술적 분석 도구
- 1980년대 초 존 볼린저(John Bollinger)가 개발
- 가격의 변동성을 측정하고 상대적인 고가와 저가 수준을 식별하는 데 도움을 줍니다.
- 볼린저밴드는 세 개의 선으로 구성
- 중간밴드(Middle Band) : 일반적으로 20일 이동평균선(SMA) 사용
- 상단밴드(Upper Band) : 중간밴드 + (20일 이동표준편차*2)
- 하단밴드(Lower Band) : 중간밴드 - (20일 이동표준편차*2)
- 주요 특징과 용도
- 변동성 측정 : 밴드의 폭이 넓을수록 시장 변동성이 높고, 좁을수록 변동성이 낮다.
- 과매수/과매도 신호 : 가격이 상단 밴드에 닿으면 과매수(overbought) 상태로, 하단 밴드에 닿으면 과매도(oversold) 상태로 해석할 수 있다.
- 추세 확인 : 강한 추세에서는 가격이 밴드 방향을 따라 지속적으로 움직인다.
- 반전 신호 : 가격이 밴드를 벗어났다가 다시 안으로 들어오는 것은 잠재적인 반전 신호가 될 수 있다.
삼성과 하이닉스 상관관계 구하기?
column1: 삼성전자(closed) column2: 하이닉스(closed) 인 dataframe 만들기
index: 시계열데이터
이후 correlation으로 구하기
sh = pd.DataFrame({'삼성전자':stock['Close'],
                  '하이닉스':hynix_krx['Close']})
print(sh)
ax = sns.lineplot(data=sh)
ax.set_title('삼성전자(005930) & SK하이닉스(000660) 종가 추이')
ax.set_xlabel('Date')
ax.set_ylabel('Close Price')
ax.legend(labels=['삼성전자(005930)', 'SK하이닉스(000660)'])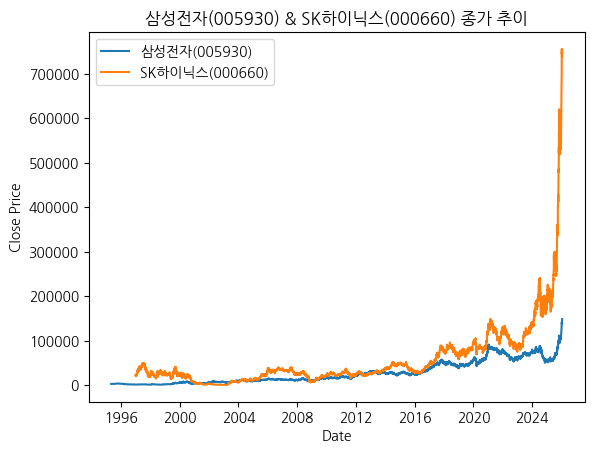
ax.legend에서 labels를 주면 선이 끊겨나온다. 라고 같은 수강생분께서 알려주셨다!
sh = pd.DataFrame({'삼성전자(005930)':stock['Close'],
                  'SK하이닉스(000660)':hynix_krx['Close']})
print(sh)
ax = sns.lineplot(data=sh)
ax.set_title('삼성전자(005930) & SK하이닉스(000660) 종가 추이')
ax.set_xlabel('Date')
ax.set_ylabel('Close Price')
ax.legend()
Kubernetes
Open Source System. Containerized Application을
- Automating deployment
- Scaling
- Management
minicube가 pc레벨에서 잘 쓰였는데, 요즘은 docker compose desktop에서 kubernetes를 제공한다.
rancher desktop라는 것도 있다.
Kubernetes Architecture
컴퓨팅 환경 변화
Traditional
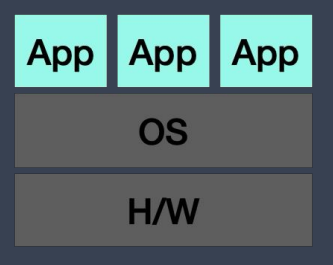
- 물리 서버
- 그냥 pc
- 비용 효율 ↓
- 자원 할당 문제
- 한 App이 자원을 독점
- Peak-time을 대비한 충분한 사양
Virtual Machine
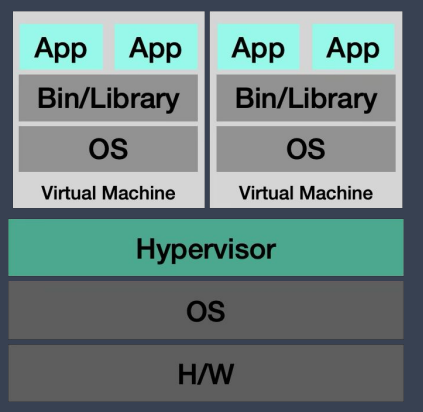
- 가상화
- 하드웨어 가상화로 자원 격리
- Guest OS가 포함되어 무겁고 부팅 느림
- 동적 VM 운영
- 자원 할당
- Isolation
- Security
- 부팅에 nn초
Container
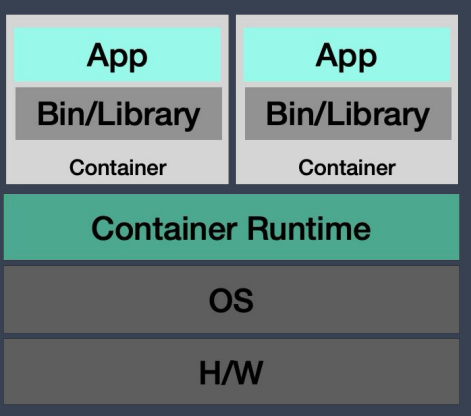
- 이 노드가 실질적인 하드웨어일수도 있으나, VM일수도 있음
- 컨테이너
- 컨테이너가 Host server의 OS Kernel 공유
- 컨테이너 자체의 OS가 없다는 것이 VM과 큰 차이
- Application과 Library만 패키징
- 초 단위 실행
- 뛰어난 효율성
- 부팅에 n초
docker는 이미지를 인스턴스로 해서 하나의 컨테이너를 띄우게 됨
하나의 파일에서 여러 애플리케이션을 동시에 관리하며 여러 컨테이너를 동시에 띄우는걸 docker compose
여러개의 노드를 한꺼번에 관리하면서 전체 애플리케이션을 관장하는 docker swarm
한동안 그렇게 썼었는데 kubernetes가 등장
kubernetes 사용 이유
컨테이너 오케스트레이션을 지원해줌
- 배포, 복구, 스케일링, 업데이트, 네트워킹을 자동화
자동화된 복구
- Pod가 실패 or Node가 죽었을 때, Controller가 이를 감지하고 새로운 Pod을 생성하여 상태 복구
업데이트
- 애플리케이션의 버전을 중단없이 안전하게 교체, Rollback 가능
빈틈없는 확장
- 트래픽 변화에 따라 Pod의 개수를 자동으로 늘리거나 줄여 리소스를 효율적으로 관리(Auto-scaling)
Pod
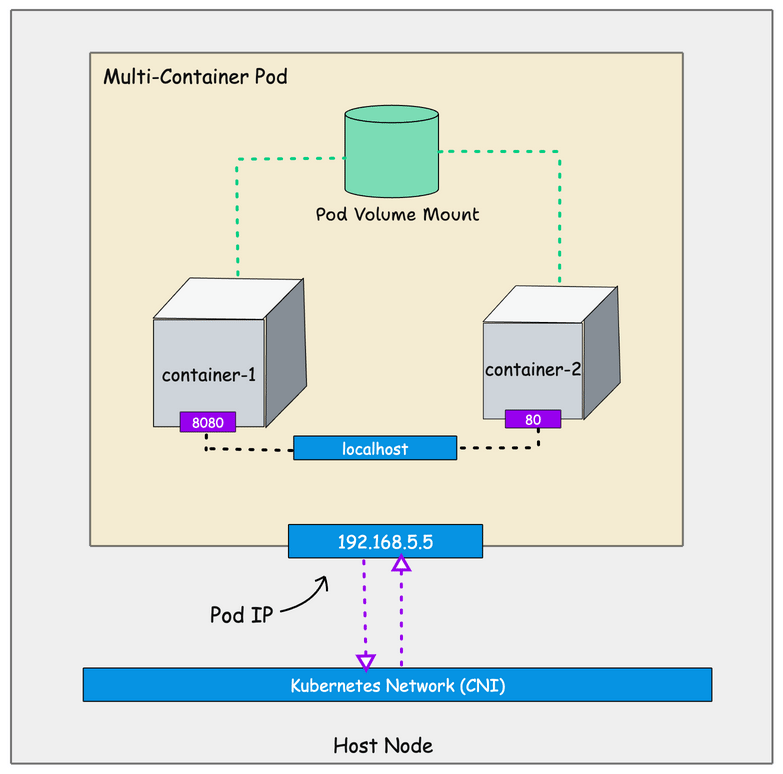
https://devopscube.com/kubernetes-pod/
생성하고 관리할 수 있는 가장 작은 배포 단위
- 하나 이상의 컨테이너 그룹(보통은 1Pod =1Container)
- 같은 Pod 내의 컨테이너들은 IP(network)와 Volume(Storage)를 공유
- Logical Host
- Logical Host와 다르게 일시적(Ephemeral): 죽으면 되살아나지 않고 새로운 pod 대체
- 즉, 계속 감시중
참고: Docker
https://docs.docker.com/get-started/docker-concepts/building-images/writing-a-dockerfile/
어떠한 컨테이너의 docker 이미지를 만들 때 베이스를 설정
FROM python:3.13
WORKDIR /usr/local/app

# Install the application dependencies
COPY requirements.txt ./
RUN pip install --no-cache-dir -r requirements.txt

# Copy in the source code
COPY src ./src
EXPOSE 8080

# Setup an app user so the container doesn't run as the root user
RUN useradd app
USER app

CMD ["uvicorn", "app.main:app", "--host", "0.0.0.0", "--port", "8080"]- uvicorn: python 앱 실행 명령어의 일종
Kubernetes Cluster 구조
Master & Worker 구조
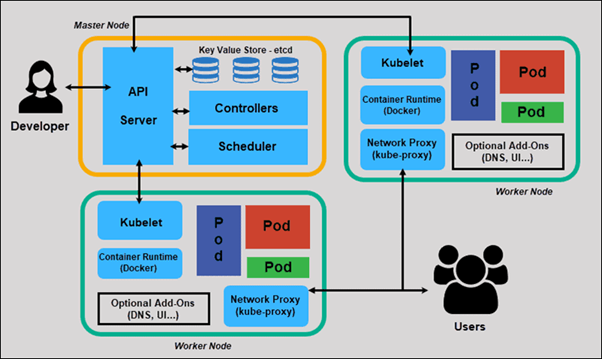
https://www.ais.com/an-overview-of-kubernetes-architecture-and-container-deployment/
두뇌역할 Control Plane + 일하는 Work Node
- Control Plane: 클러스터 전체 상태를 관리, 이벤트 감지, 의사 결정
- Worker Node: 실제 애플리케이션(Pod)이 동작하는 서버. Control Plane의 명령을 받아 Pod 구동
둘은 logical하게 분리된다.(physical하게 분리될 필요는 x)
다만 control plane이 다른 작업때문에 버벅대면 안되니, 물리적으로 분리시키는 것이 맞다.
Control Plane Components
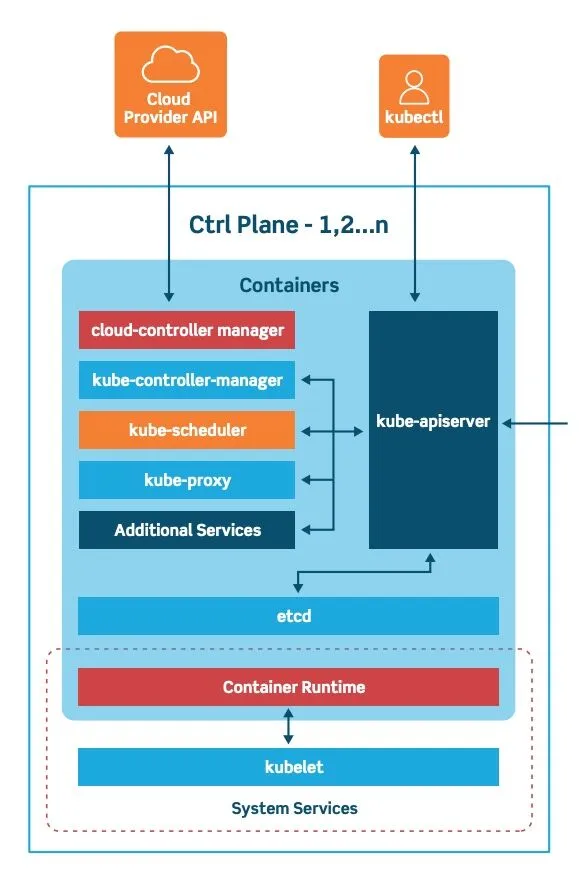
https://platform9.com/blog/kubernetes-enterprise-chapter-2-kubernetes-architecture-concepts/
kube-apiserver
- 클러스터 앞단에서 모든 요청(REST)를 처리하고 검증하는 관문. authorize & authenticate
etcd
- 스토리지 역할. 모든 클러스터 데이터(설정, 상태)를 저장하는 고가용성 분산 Key-Value 저장소
kube-scheduler
- 새로 생성된 Pod 감지, 리소스 상태를 고려해 최적의 노드를 선택하여 배치
kube-controller-manager
- 클러스터가 원하는 상태를 유지하도록 끊임없이 Pod의 down, 복제본 수 감시, 복구
cloud-controller-manager
- Cloud Provider와의 interface를 담당. Cloud쪽 서비스의 AZ(Available Zone), VM, Storage, DNS, Routing, Load balancing 지원
kubectl
- 실행 커맨드
Worker Node Components
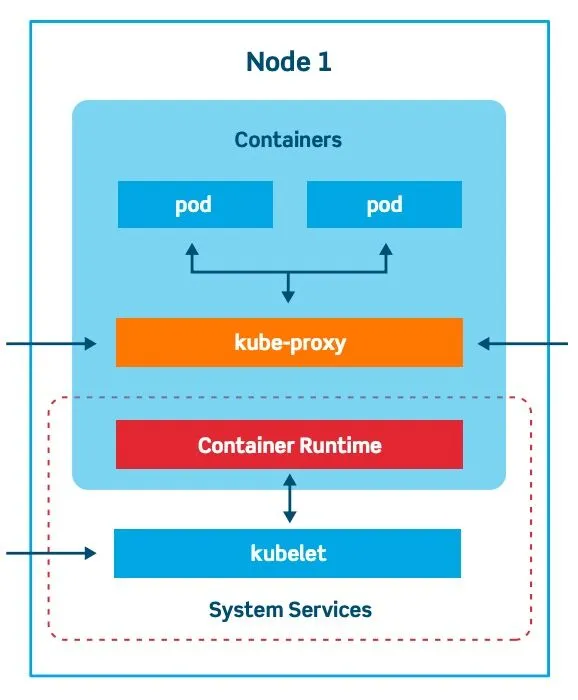
kubelet
- Control Plane과 통신
- 각 노드에서 실행되는 에이전트, Pod가 수행되도록 보장
kube-proxy
- 노드의 네트워크 동작과 규칙을 유지관리
- Pod 간 통신을 가능하게 함
Container Runtime
- 실제 컨테이너를 실행하는 소프트웨어
- Containered(요즘 많이 씀), Docker Engine 등
Controller & Desired State
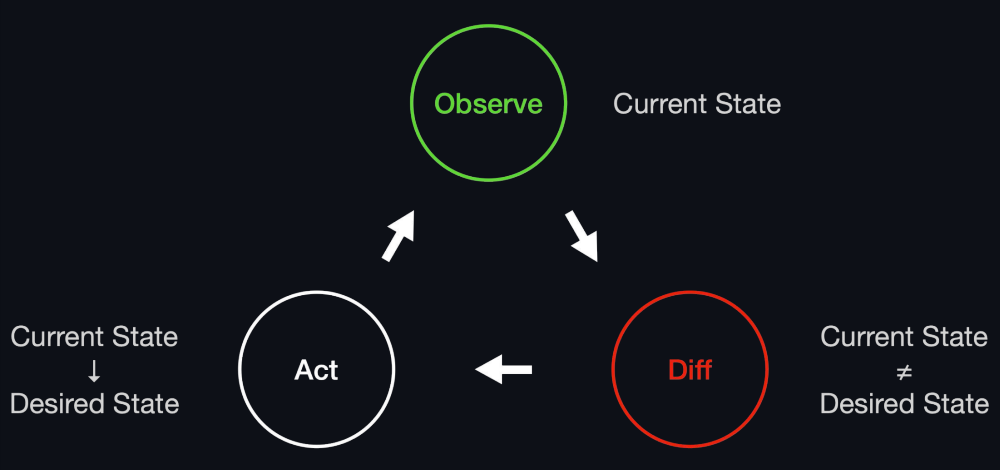
- 어떻게(Imperative)(X) 무엇을(Declaravite)(O)
- 사용자가 Desired State을 정의(YAML) 하면, 컨트롤러가 끊임없이 Current State를 감시하며 일치시킴
이러한 Reconcillation Loop가 Kubernetes 자동화의 핵심
Workload Resources
Workload
kubernetes에서 구동되는 애플리케이션
- 실행되길 원하는 애플리케이션
- 컨테이너에서 돌게끔 됨 → 컨테이너는 Pod를 통해 워크로드 배포
- 단일 component 이거나 여러개의 component일 수도 있음
- 상태 유무, 생명주기 등에 맞춰 적절한 워크로드 리소스(컨트롤러) 선택 필요
- Third-party에서 새롭게 Workload resource를 정의해서 사용 가능(쿠버네티스 사용 확장 이유)
주요 리소스 타입
- Deployment/ReplicaSet: 웹서버같은 Stateless
- StatefulSet: DB같은 Stateful 앱(Cache는 논외)
- DaemonSet: 로그 수집, 모니터링
- Job/CronJob: 일회성/주기적 작업
Stateful은 상태(데이터)를 서버나 시스템이 기억하고 유지하는 방식이고, Stateless는 요청마다 필요한 모든 정보를 포함하며 이전 상태를 기억하지 않는 방식
Deployment & ReplicaSet
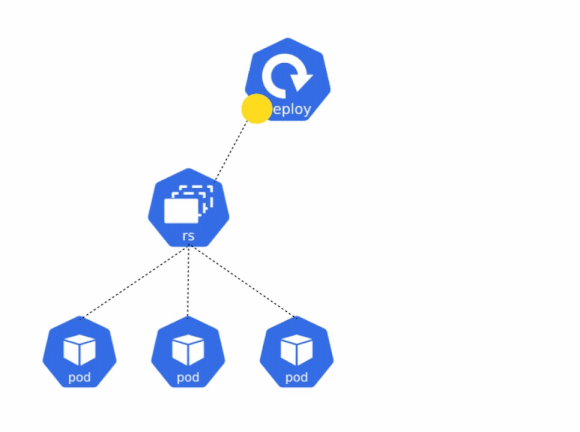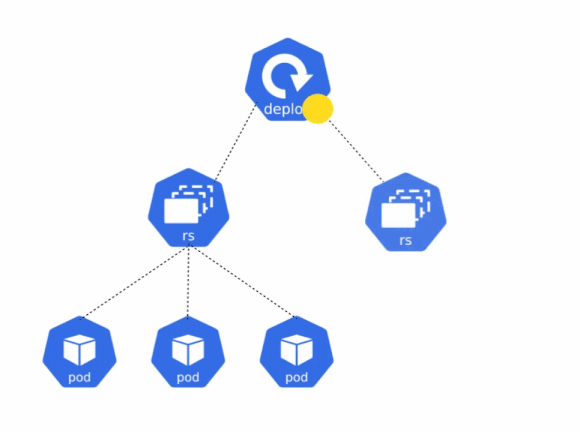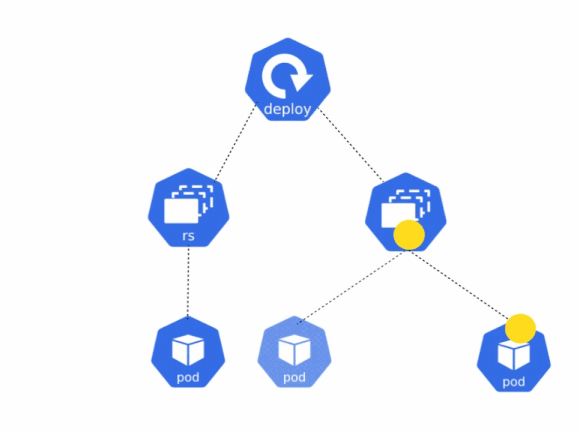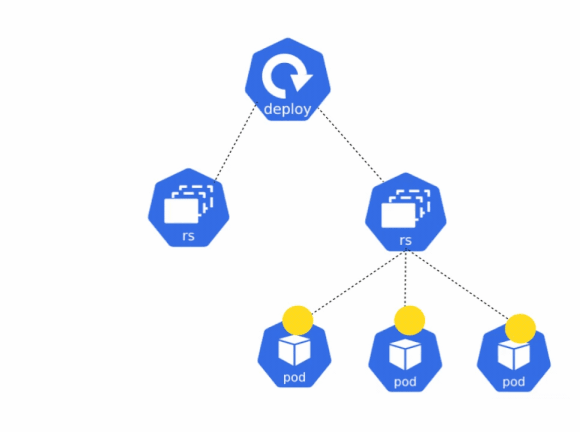
https://devtron.ai/blog/deployment-vs-statefulset/
왼쪽: old ver ReplicaSet
오른쪽: new ver ReplicaSet
ReplicaSet
- 고가용성 보장
- 정의된 Replicas 개수를 항상 유지
- Pod가 삭제되면 즉시 새로운 Pod를 생성하여 복구함
Deployment
- Stateless 앱의 표준
- 가장 널리 사용되는 리소스
- 웹서버 등 상태 저장이 필요 없는 애플리케이션에 적합
- 내부적으로 ReplicaSet을 통해 Pod를 관리
- Replica와 다르게, 선언적 업데이트 제공
- Update: Pod 버전을 교체하는 여러 Strategy가 존재
- Rollback: 문제 발생 시 이전 버전으로 즉시 되돌리기 가능
Deployment Strategy
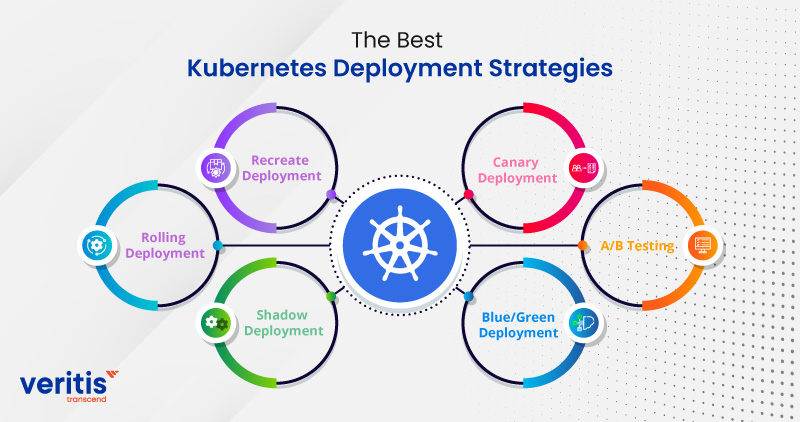
https://www.veritis.com/blog/kubernetes-deployment-strategies-all-you-need-to-know/
- Rolling: 업데이트할때 하나씩 점진적으로 old → new 자동업데이트(=무중단 배포). Blue/Green 보다는 리소스를 덜쓴다. 다만 시간은 오래걸림.
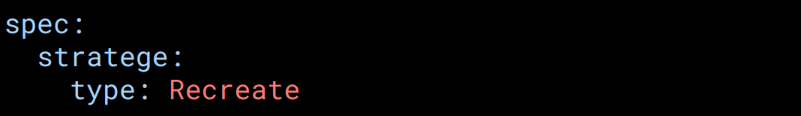
- Recreate: old버전 싹 지우고 새로운 new버전 생성(다운타임 O) ex:은행앱. 제일 단순함. 이걸 써도 되는 서비스면 이 방법을 취하지 않을 이유가 없다고...
- Canary: 시스템의 일부만 업데이트. 동일한 서버 10개라면 10개중 1개만 업데이트 → 상태 확인 후 사람이 수동으로 나머지 업데이트. 어떤 사용자가 어느 버전을 쓸지는 랜덤
- A/B: 시스템에 A ver과 B ver 전부 존재. 업데이트용이라기 보다는 둘 다 두고 유저 피드백을 보기 위함. 시스템을 명시적으로 분리(어떤 사용자가 어느 버전을 쓸지 정하기 가능)
- ex) 프리미엄 가입자에게 업그레이드 기능 먼저 제공
- Blue/Green: Old인 Blue에서 New인 Green이 존재. 두 셋이 있을 때 모든 유저의 트래픽이 Blue로 감. 스위치를 켜면 모든 유저의 트래픽이 Green으로 넘어가도록 업데이트. Old로 트래픽이 갈 때, New로는 트래픽이 가지 않는다.
- Shadow: Old로 트래픽이 갈 때, 이를 복제해서 테스트용으로 New로도 트래픽을 보내봄. 실제 DB에 저장되지 않는 테스트 느낌. 실제 유저에게 영향 X
예제
- Recreate
- RollingUpdate
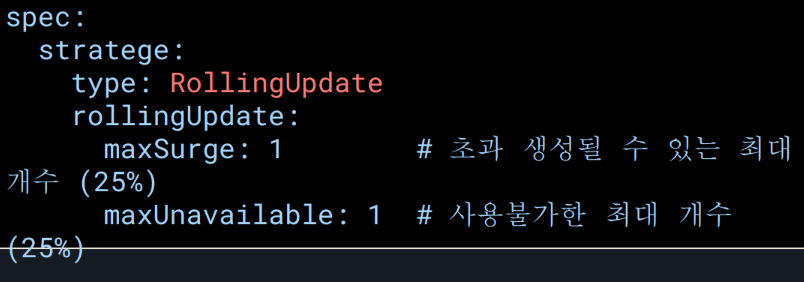
maxSurge는 숫자 혹은 퍼센티지로 나타낼 수 있음. 업데이트하는동안 추가 생성 가능한 수
maxUnavailable은 업데이트하는동안 몇개를 사용하지 못해도 괜찮다는 의미
maxSurge가 0이고 maxUnavailable이 1이면 → 1개를 먼저 죽이고 new 버전을 나중에 하나 띄움
maxSurge가 1이고 maxUnavailable이 0이면 → 1개를 먼저 만들고 나중에 old 버전 하나 죽임
→ 두개 다 0일수는 없다. - Canary
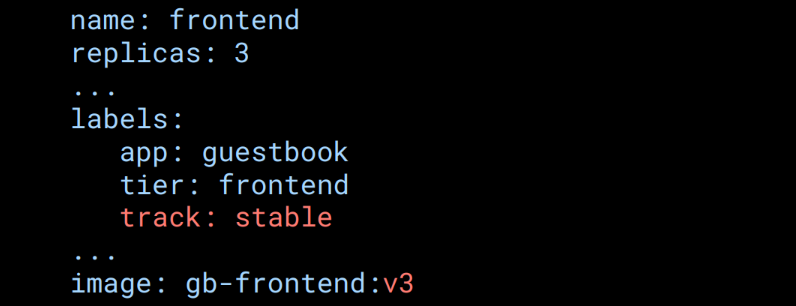
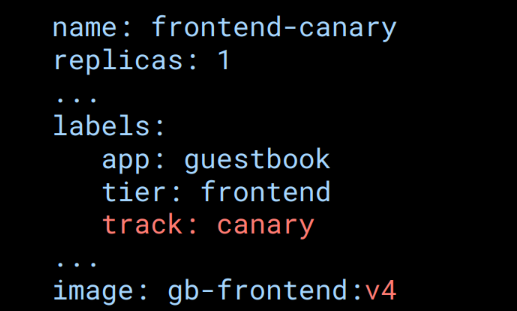
서로 다른 deployment 2개가 필요
track은 임의의 이름 가능
서비스에서는 labels의 tier부분까지만 읽기때문에 track이 달라도 같은것으로 취급 → 둘 다 배포됨
blue/green deployment는 deployment에서 설정하는게 아니라, 그 앞단(서비스, 로드밸런서)에서 아예 스위칭함.
YAML
ReplicaSet, Deployment YAML 예제
ReplicaSet
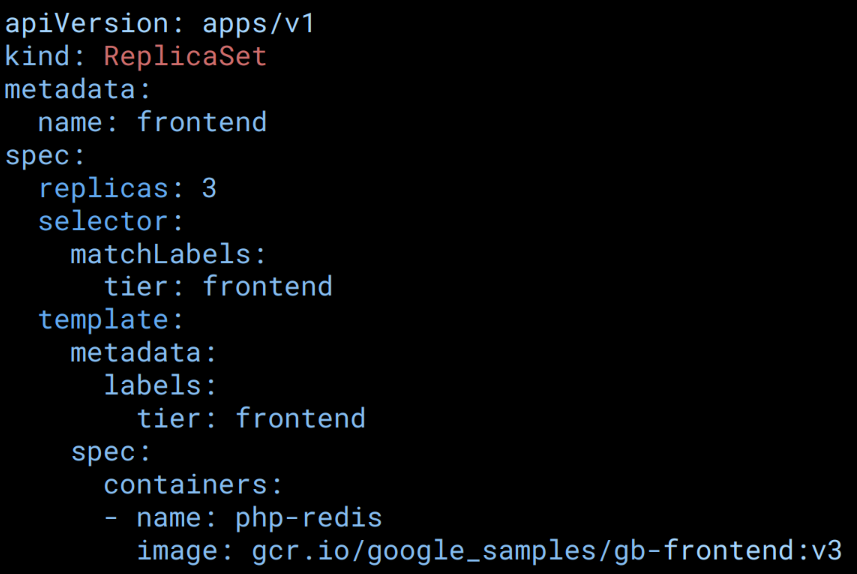
주요 필드
replicas: 유지할 Pod 개수selector: 관리할 Pod를 식별하는 label(Controller에게 보내는 커맨드. tier의 값이 frontend인걸 찾아서 3개를 유지해)template: 새로 생성할 Pod의 명세(스케줄러에게 보내는 커맨드. Pod를 하나 만드는데, 아래 spec에 정의된걸 만들어. 그 Pod의 label을 frontend로 달아.)
주의: label은 unique해야한다.
Deployment
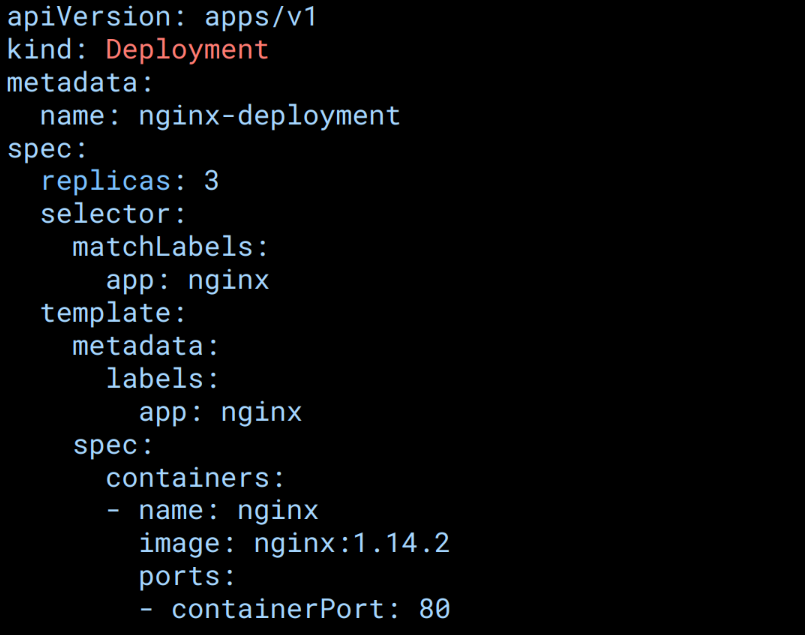
- Nginx 웹서버 3개를 배포하는 기본적인 YAML
- 업데이트 하는것에 장점이 있음(image의 버전을 바꿔 적어주면 업데이트됨)
kubectl 사용
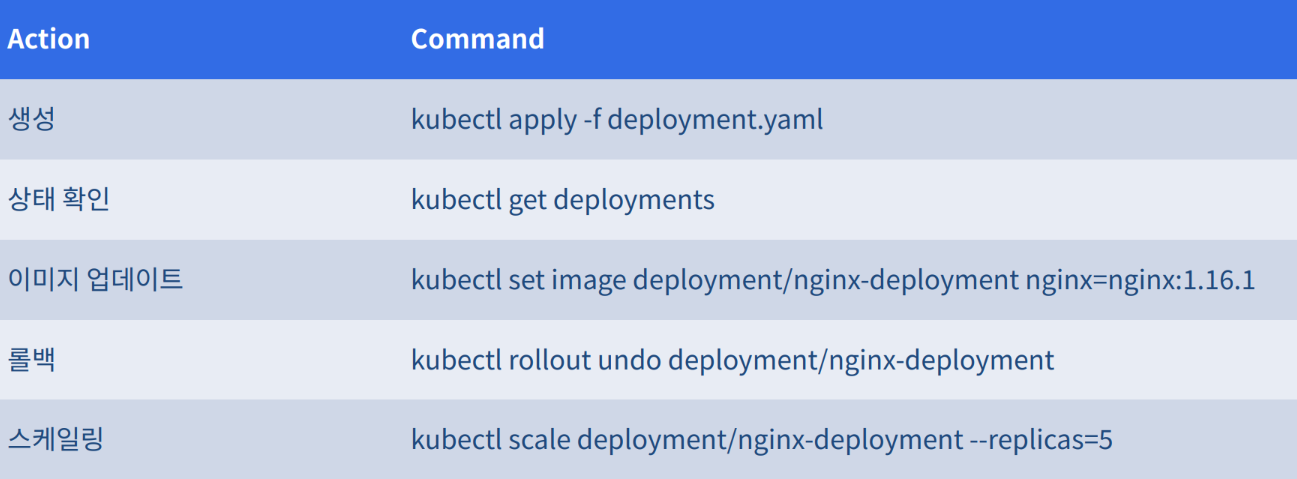
이미지 업데이트는 yaml 뿐만이 아니라, 이미지 업데이트 명령어로도 가능하다.
스케일링은 쿠버네티스에서 워크로드의 파드 개수를 수동으로 조절할 때 사용
Service
Ephemeral Pod
- 서버쪽에서 요청 들어올때 IP나 호스트로 연결
- Pod가 재생성되면 IP가 변함
- Client가 매번 바뀌는 IP에 대응 불가 → 바뀌면 연결 불가하지 않나? 그래서 서비스라는 개념이 등장
Discovery & Load Balancing
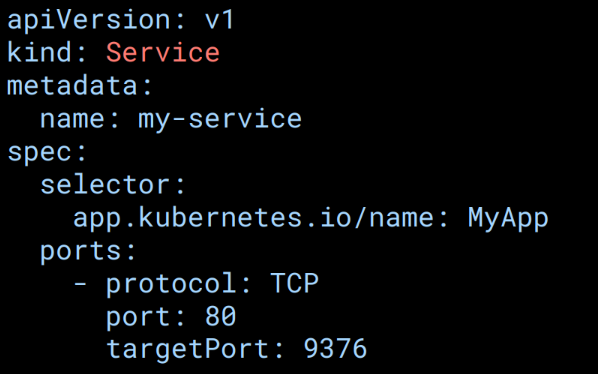
- 여러 Pod를 Label Selector로 묶어 하나의 그룹으로 만든다(selector이 같은 pod들 묶음)
- 내부적으로 Load Balancer 역할을 수행하여 트래픽을 Pod 그룹으로 분배
- 기본적으로 고정된 ClustIP를 가짐
app.kubernetes.io/name: MyAPP 인 Pod들을 9376 포트로 연결해줌
Headless Service
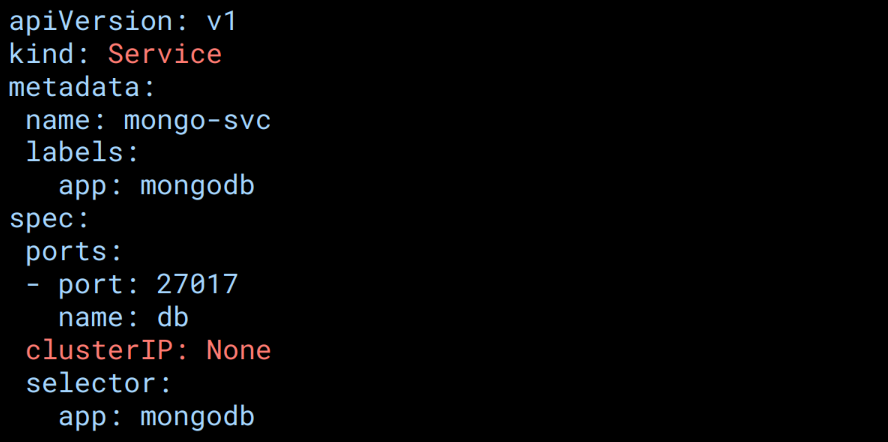
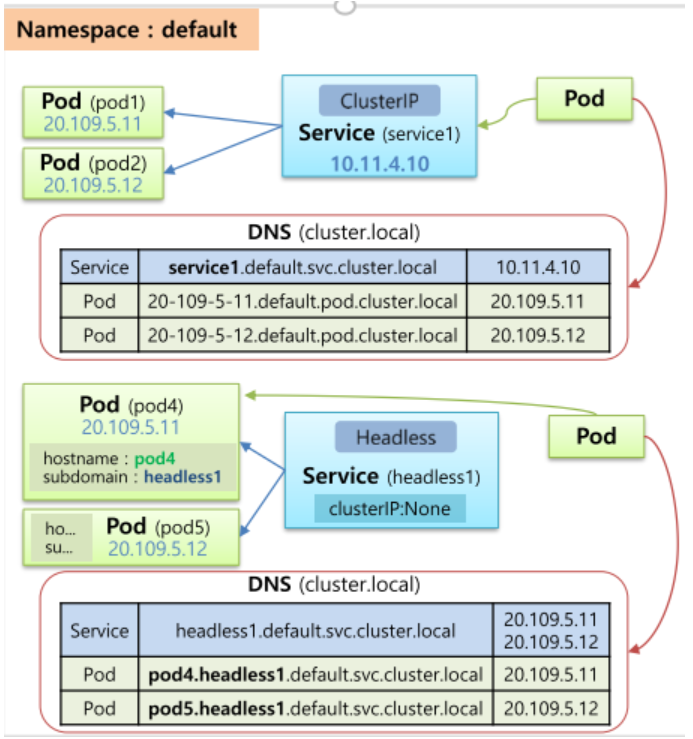
Load Balancing과 Single IP(하나의 입구)가 필요 없을 때
clusterIP: None이라 하면 Headless Service라고 명시하는 것
 https://dgjinsu.tistory.com/71
- Service Discovery 기능은 계속 제공
- Pod하나가 새로 뜨면 selectord에 걸림 → IP 확인 → 분배시 해당 IP로 Pod에 할당 → 죽으면 IP 제거(반복)
- 각 Pod는 자신의 IP를 할당받고 직접적인(direct) 연결 가능
- 서비스에 연결된 pod을 DNS를 통해 IP를 가져올 수 있음
StatefulSet
 https://medium.com/avmconsulting-blog/deploying-statefulsets-in-kubernetes-k8s-5924e701d327
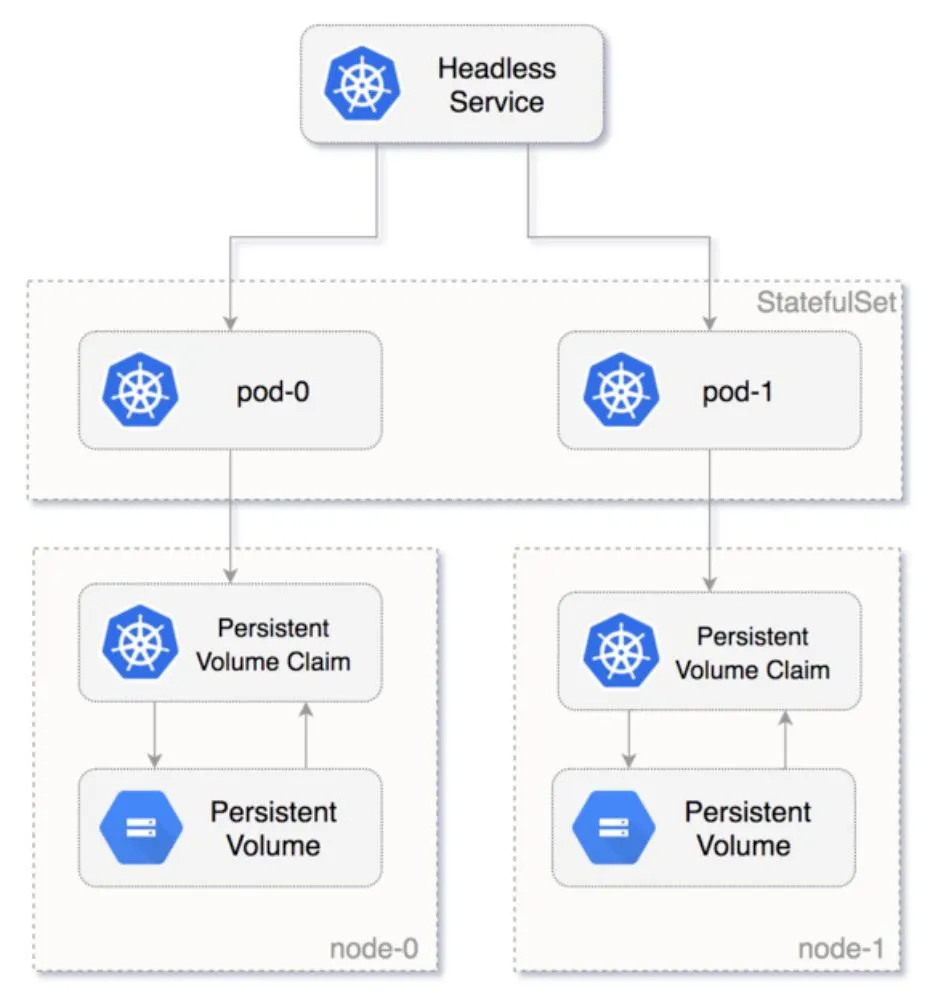
상태가 중요한 애플리케이션
- Headless Service 사용 (꼭 그래야 하는 것은 아니다, 보통 그렇다는 의미)
- DB, Zookeeper 등 상태 저장이 필요한 앱에 사용
- 고유한 식별자: Pod 이름이 web-0, web-1 처럼 순서대로 부여
- 안정적인 스토리지: 각 Pod는 자신만의 PVC(Persistent Volume Claim)을 가지며 이를 통해 PV와 연결 → Pod가 Ephemeral하더라도 PV에 정보 저장하면 날라가지 않는다.
- Pod가 재시작되어도 기존 데이터를 그대로 유지한 채 연결
PersistentVolume(PV)
실제 물리적인 스토리지 자원(AWS EBS, NFS, Local Disk 등)
- 인프라 관리자 영역
- 클러스터에 미리 프로비저닝 되어있거나 동적으로 생성
PersistentVolumeClaim(PVC)
사용자가 요청하는 스토리지 주문서
- 개발자 영역
- "50GB가 필요해"와 같이 요청을 하면 kubernetes가 적절한 PV를 찾아 연결(Binding)
StatefulSet YAML 예제
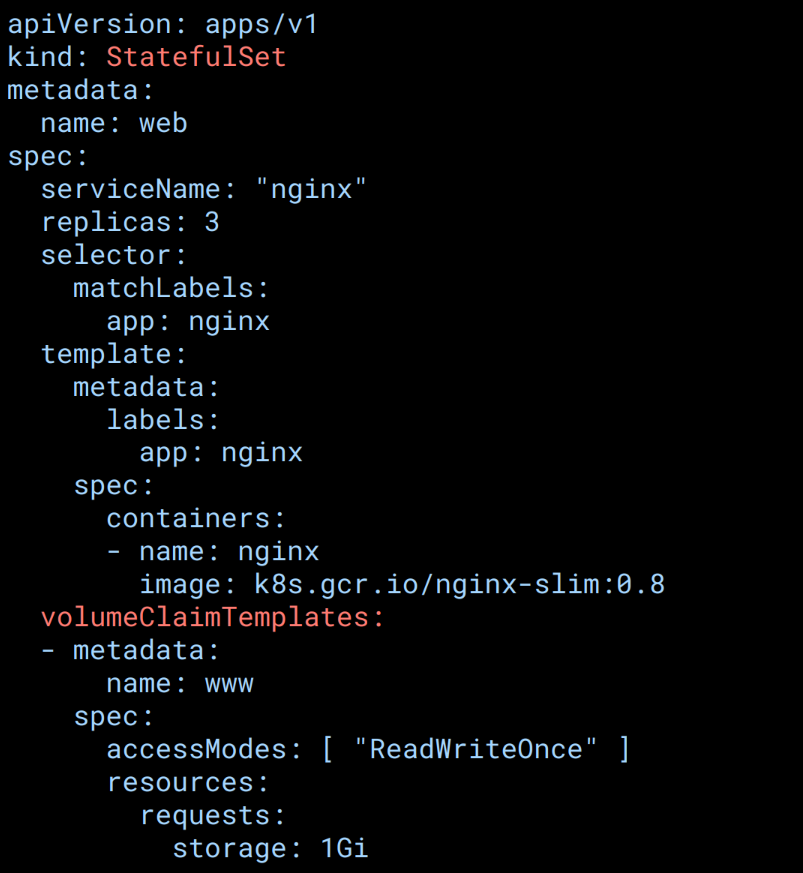
- volumeClaimTemplates를 통해 각 Pod마다 별도의 스토리지 자동 생성
- metadata의 name으로 인해 pod는 web-1 web-2 .. 식
Deployment vs StatefulSet
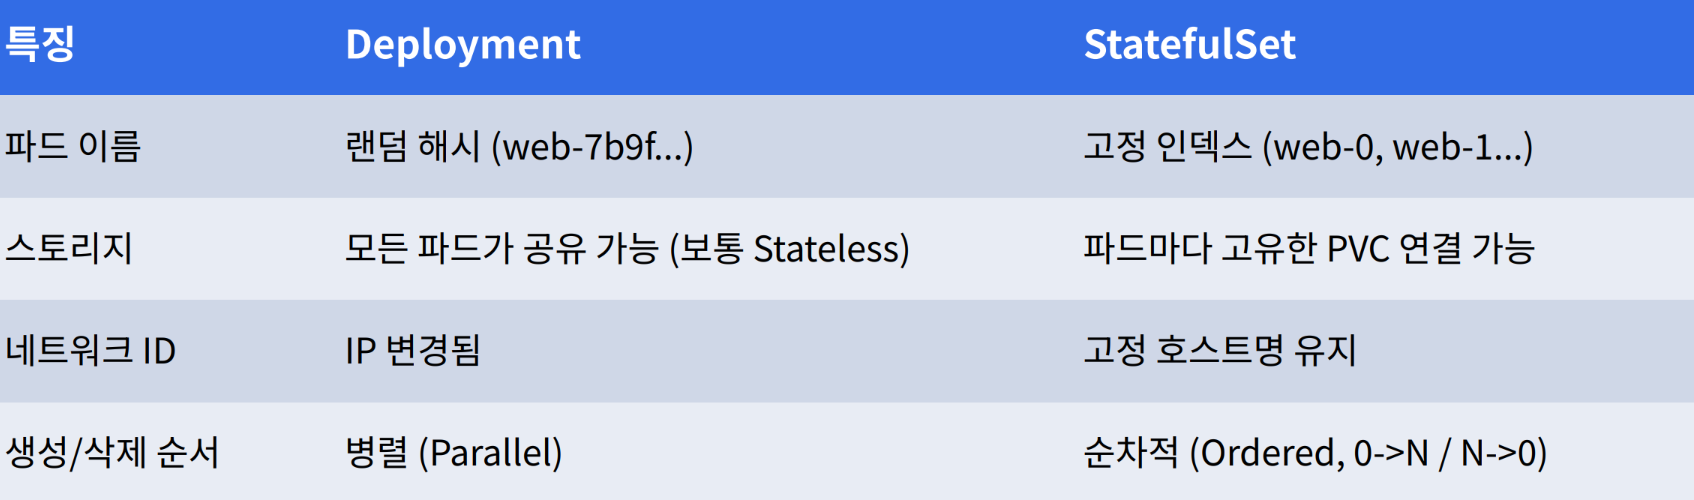
- 고정 인덱스 → DNS에 저장되어 고정됨
- StatefulSet의 삭제는 뒤에서부터(N → 0)
샤딩(Sharding)은 대규모 데이터베이스나 분산 시스템의 성능과 확장성을 향상시키기 위해 데이터를 여러 개의 작은 조각(샤드)으로 나누어 서로 다른 서버에 분산 저장하고 관리하는 기술
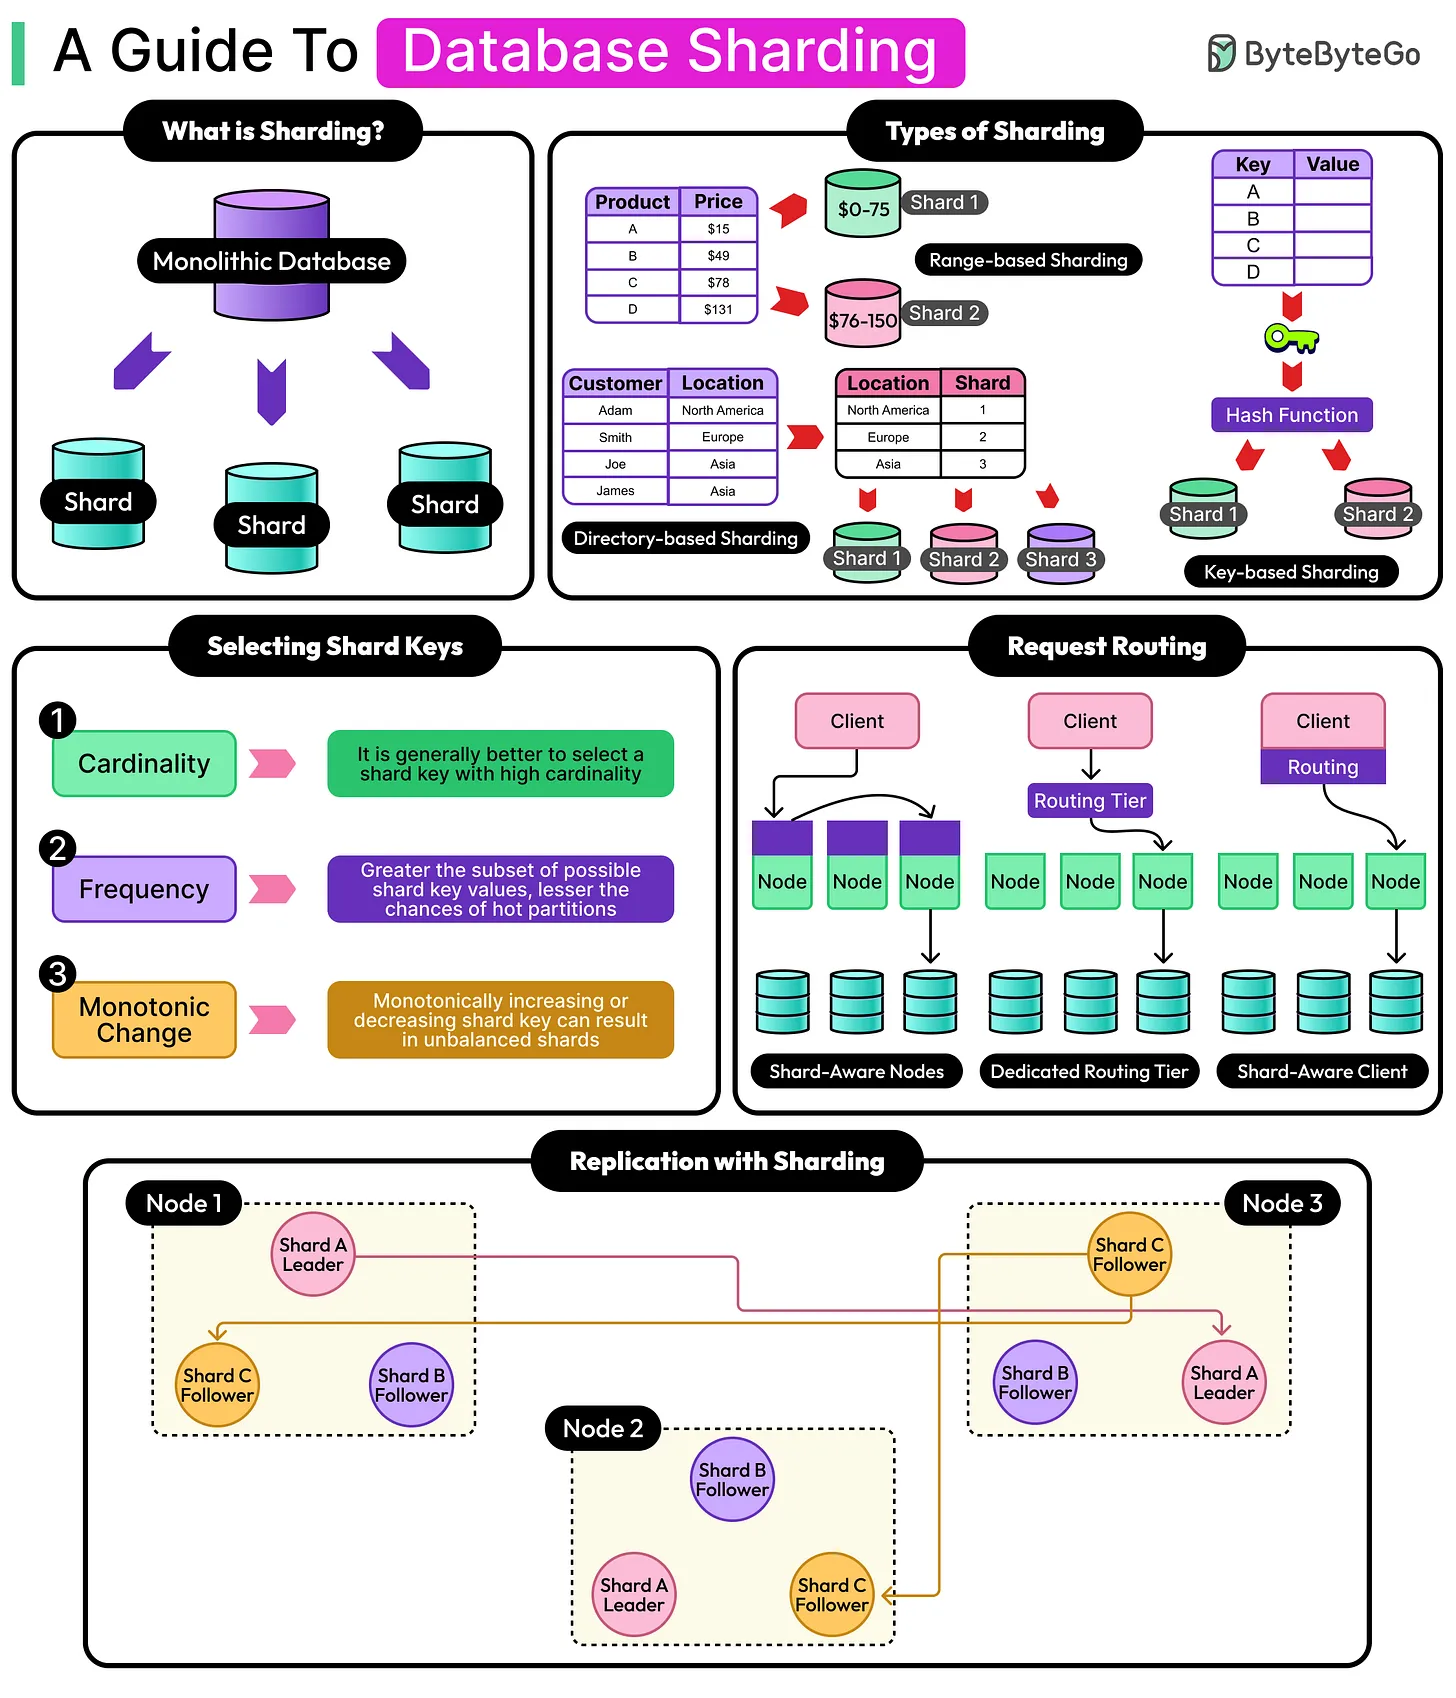
https://blog.bytebytego.com/p/must-know-message-broker-patterns-4c4
- 보통 key-based sharding을 많이 한다.
DaemonSet
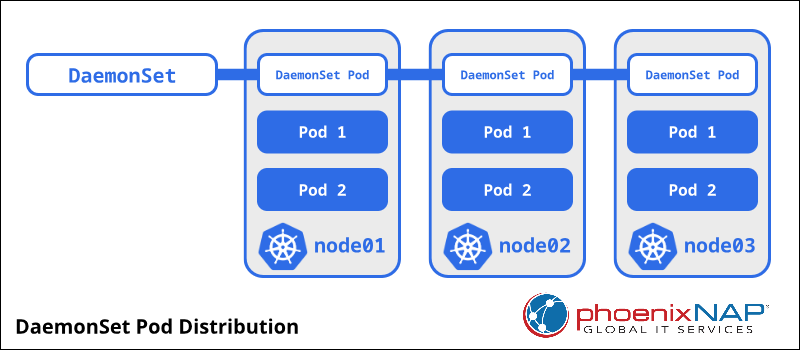
- 노드가 사라졌다 생겼을때 Pod가 실행되는 것을 보장해줌
- 노드마다 하나씩 존재하는 Pod를 사용할 때 사용하는 컨셉
- 클러스터의 모든 노드(또는 특정 노드)에 Pod 사본을 하나씩 실행
- 대표적 예시 → 로그 수집기: fluentd, logstash
- 모니터링 에이전트: Prometheus Node Exporter
- 노드가 추가되면 자동으로 Pod가 생성, 제거되면 사라짐
- DaemonServer(죽지않고 계속 가동되는서버)와는 다른 개념
Job & CronJob
배치 작업 처리
Job
- Pod를 생성하여 작업을 실행 → 성공적으로 완료(Exit Code 0)되면 종료
- 데이터 분석, 백업에 사용
CronJob
- Job을 시간 스케줄(Crontab 형식)에 따라 주기적으로 생성
- 예) 매일 밤 12시 백업
리소스 비교 요약
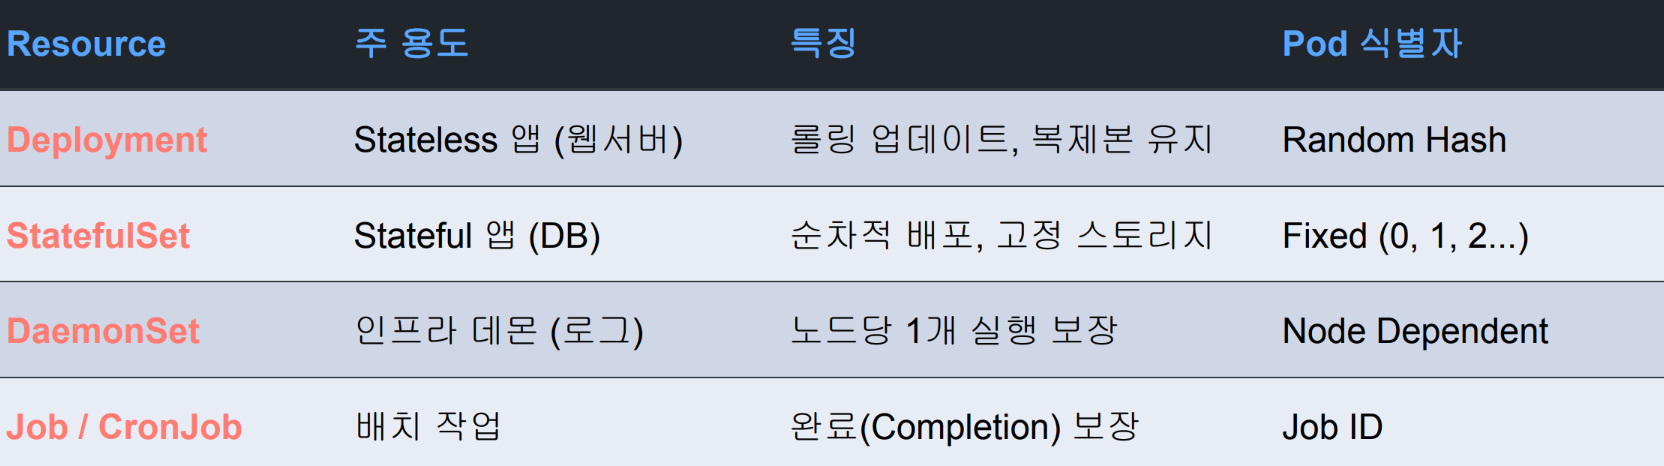
설정과 코드의 분리
ConfigMap
- 데이터베이스 주소, UI 테마 색상 등 일반적인 설정 정보 저장
- 컨테이너 이미지를 다시 빌드하지 않고도 설정을 변경할 수 있게 해줌
Secret
- 비밀번호, OAuth 토큰, SSH키 등 민감한 정보 저장
- Base64 인코딩
- 보안을 위해 메모리에만 마운트
-----------
Kubernetes 사용 목적과 리소스 목적 정리
1. Kubernetes의 사용 목적
Kubernetes(K8s)는 컨테이너화된 애플리케이션을 자동으로 배포, 운영, 확장, 관리하기 위한 컨테이너 오케스트레이션 플랫폼이다.
Kubernetes를 사용하는 이유
1️⃣ 컨테이너 운영 자동화
- 컨테이너 배포 자동화
- 장애 발생 시 자동 재시작 (Self-healing)
- 노드 장애 시 다른 노드로 자동 이동
2️⃣ 확장성과 고가용성
- 트래픽 증가 시 자동 스케일링
- 여러 컨테이너를 분산 배치
- 무중단 배포 (Rolling Update)
3️⃣ 인프라 추상화
- 서버를 직접 관리하지 않고 리소스 단위로 관리
- 온프레미스, 클라우드, 하이브리드 환경에서 동일한 방식 사용
4️⃣ 일관된 배포 환경
- 개발/테스트/운영 환경 차이 최소화
- YAML 기반 선언적 설정
5️⃣ 운영 복잡성 감소
- 로드밸런싱
- 서비스 디스커버리
- 설정 및 비밀 정보 관리
한 줄 요약
Kubernetes는 컨테이너 기반 애플리케이션을 안정적이고 확장 가능하게 운영하기 위한 플랫폼이다.
2. Kubernetes 리소스의 목적
Kubernetes는 모든 구성 요소를 리소스(Resource)로 관리한다.
각 리소스는 역할이 명확히 분리된 책임 단위이다.
Pod
목적: 컨테이너 실행의 최소 단위
- 하나 이상의 컨테이너를 포함
- 동일한 네트워크(IP)와 볼륨 공유
- 보통 직접 생성하지 않음
ReplicaSet
목적: 지정한 개수의 Pod를 항상 유지
- Pod 장애 시 자동 재생성
- 일반적으로 Deployment가 내부적으로 사용
Deployment
목적: 애플리케이션 배포 및 업데이트 관리
- Pod와 ReplicaSet을 선언적으로 관리
- Rolling Update, Rollback 지원
- 실무에서 가장 많이 사용
Service
목적: Pod에 대한 고정된 접근 지점 제공
- Pod IP 변경을 숨김
- 로드밸런싱 제공
- 서비스 디스커버리 역할
종류:
- ClusterIP
- NodePort
- LoadBalancer
Ingress
목적: HTTP/HTTPS 기반 외부 트래픽 라우팅
- 도메인/경로 기반 라우팅
- SSL/TLS 처리
- 여러 Service를 하나의 엔드포인트로 통합
ConfigMap
목적: 애플리케이션 설정 정보 관리
- 환경 변수
- 설정 파일
- 코드와 설정 분리
Secret
목적: 민감한 정보 저장
- 비밀번호, 토큰, 인증서
- Base64 인코딩 (암호화는 아님)
Volume / PV / PVC
목적: 데이터 영속성 제공
- Pod 종료 후에도 데이터 유지
- 스토리지 추상화
- PVC를 통해 필요한 스토리지 요청
Namespace
목적: 리소스 논리적 분리
- dev / staging / prod 환경 분리
- 팀 또는 프로젝트 단위 격리
- RBAC과 함께 사용
Node
목적: Pod가 실행되는 실제 서버
- VM 또는 물리 서버
- kubelet, kube-proxy 실행
정리
Kubernetes 리소스는 컨테이너 실행, 확장, 네트워크, 설정, 보안, 저장소를 역할별로 분리하여 선언적으로 관리하기 위한 객체들이다.
실무 기준 Kubernetes 리소스 흐름
전체 흐름 요약
사용자 요청
 → Ingress
   → Service
     → Pod (Deployment → ReplicaSet → Pod)
       → Container
1️⃣ 배포 단계 (운영자 관점)
Deployment 생성
실무에서는 Pod를 직접 생성하지 않는다.
Deployment
└ ReplicaSet
└ Pod
└ Container
Deployment를 사용하는 이유
- 자동 배포
- 무중단 업데이트
- 롤백 가능
- Pod 개수 관리
실무 기준:
애플리케이션 하나당 Deployment 하나
Deployment 내부 동작 흐름
- Deployment 생성
- ReplicaSet 생성
- Pod 생성
- Scheduler가 Node 선택
- kubelet이 컨테이너 실행
2️⃣ 실행 단계
Pod
- 컨테이너가 실제로 실행되는 단위
- IP는 재시작 시 변경됨
- 언제든지 삭제될 수 있는 소모품
👉 Pod에 직접 접근하지 않는다.
ReplicaSet
- Pod 개수 보장
- 장애 시 자동 복구
- 직접 다루지 않음
3️⃣ 네트워크 흐름
Service
Pod 앞단의 고정된 접근 지점
Service
├ Pod IP: 10.1.0.3
├ Pod IP: 10.1.0.7
└ Pod IP: 10.1.0.12
역할:
- Pod IP 변경 은닉
- 로드밸런싱
- 서비스 디스커버리
Pod 직접 접근 ❌
Service를 통한 접근 ⭕
Ingress
외부 트래픽의 관문
Client
→ Ingress
→ Service
→ Pod- 도메인 기반 라우팅
- URL 경로 기반 라우팅
- HTTPS 처리
예시:
api.example.com → api-service
web.example.com → web-service
4️⃣ 설정 및 보안 흐름
ConfigMap
↓
Secret
↓
Pod
↓
Container (환경변수 / 파일)
원칙:
- 설정은 코드에서 제거
- 환경별 ConfigMap 분리
- Secret은 Git에 저장하지 않음
5️⃣ 스토리지 흐름
Pod
→ PVC
→ PV
→ 실제 스토리지 (EBS, NFS 등)
사용 예:
- 데이터베이스
- 로그
- 파일 업로드
6️⃣ 장애 발생 시 흐름
Pod 장애
Pod Down
→ ReplicaSet 감지
→ 새 Pod 생성
Node 장애
Node Down
→ Scheduler
→ 다른 Node에 Pod 재배치
7️⃣ 실무에서 가장 흔한 구조
[User]
↓
[Ingress]
↓
[Service]
↓
[Deployment]
↓
[ReplicaSet]
↓
[Pod]
↓
[Container]
8️⃣ 실무 핵심 요약
- Pod는 소모품
- Service는 고정 진입점
- Deployment는 운영 단위
- Ingress는 외부 트래픽 관문
- 설정은 ConfigMap / Secret
- 상태 데이터는 PVC
한 문장 정리
Kubernetes 실무 운영은
Deployment로 애플리케이션을 선언하고,
Service로 안정적인 통신을 제공하며,
Ingress로 외부 요청을 제어하는 구조이다.