아이템의 수가 인간의 탐색 능력을 넘어선 지 오래 된 정보 과잉의 시대가 도래했다.
하지만 아이템이 기하급수적으로 늘어나면 실제 취향을 우연히 만날 확률이 0으로 수렴하게 된다.
- 탐색 비용 증가
검색에 실패하지 않도록 유도하는 과정이 필요로 되어졌고,
누군가 대신 골라줘야 하는 상황이 생겼다. - 선택의 역설
선택이 많아질 수록 결정을 포기하게 된다. (Schwartz, 2004)
좋은 추천은 선택지를 늘리는게 아니라 줄여주는 것이다.
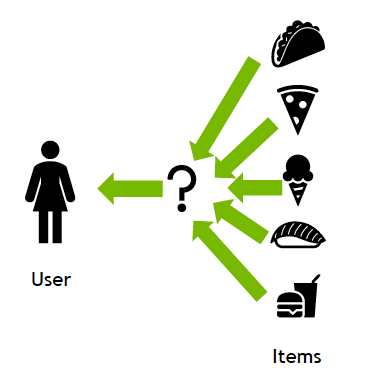
따라서 추천시스템은 search에 초점을 둔 것이 아니라 filtering에 초점을 둔 분야이다.
1. Recommendation System Overview
추천 시스템의 수학적 정의
효용 함수 는 아래와 같이 설계되어야 한다.
- 서비스마다 다르게 설정
- 한 사람만을 위한 것이 아니기에 일반화 필요
(다중 이해 관계자)
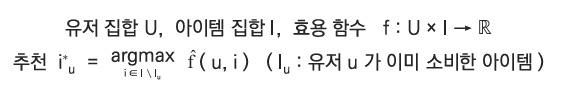
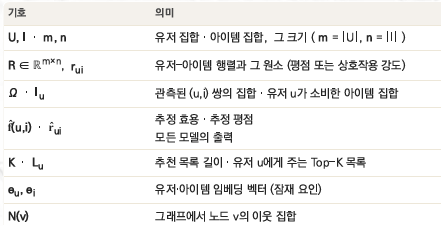
효용 함수 가 고려해야 하는 challenge
- 를 직접 관찰할 수 없음
- 가 큼
- data문제로 인해, 행동의 일부만 보임
- 시스템 문제로 인해, 모든 쌍을 평가 불가
추천 시스템의 단계
추천 시스템은 3가지 process로 세분화 된다.
모두에게 같은 model로 출발하여, 한 사람만의 비개인화 model로 만든다.
- 단계가 진행되면 진행 될 수록 비용이 높아진다.
- 실제 서비스는 세 단계를 섞어서 사용하며, 신규 유저에게는 step1, 데이터가 쌓이면 step3를 사용한다.
step 1. 비개인화
인기 차트 & 베스트 셀러 모두에게 동일하게 보여줌
(cold start의 표준 해법)
= 본인의 data를 제공하지만 추천을 하는 상태는 아님
step 2. 세그먼트 개인화
'20대에게 인기', '지역별'과 같은 집단 단위 맞춤
data에 존재하는 edge로 route 만들 수 있음 (추천 경로)
(Problem) data가 많아지면 많아질 수록 경로가 많아짐
step 3. 완전 개인화 Segment (or Grouping)
행동 이력 기반 1:1 (이 분야의 주제)
위의 문제를 해결하기 위해 data를 model로 학습
Search vs Recommendation
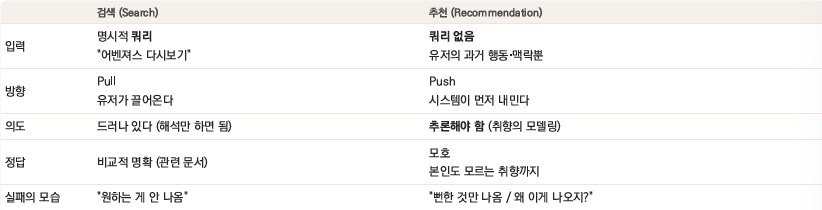
Search는 의도를 해석하지만, Recommendation은 의도를 발명해야되기에 Recommendation이 더 어렵다.
(ex. Search=Google / Recommendation=Netflix)
그리고 최근 자동완성 / 피드 랭킹과 같은 것 때문에
Search와 Recommendation의 경계가 흐려지는 중이다.
2. Challenges of Recommendation System
2-1. 미니 MovieLens
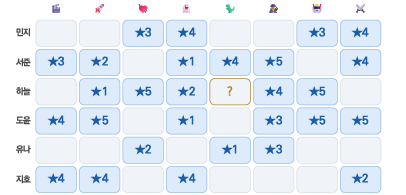
추천 시스템 문제의 분류
-
Rating Prediction (평점 예측)
빈칸의 값 자체를 맞추는 Regression 문제
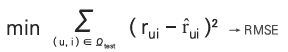
-
Ranking (Top-K 랭킹)
각 유저에게 길이 K의 목록을 만드는 문제(틀려도 순서만 맞으면 됨)
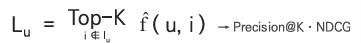
평점을 잘 맞추는 model이 랭킹 목록을 잘 만든다는 보장이 없기에, 두 문제를 분류한다.
Explicit vs Implicit Feedback
둘 다 중요하지만 Implicit Feedback이 현대 서비스에서 더 중요하다.
- Explicit Feedback
: 조작이 가능한 data (ex. 네이버 리뷰 이벤트) - Implicit Feedback
: 조작이 어려움
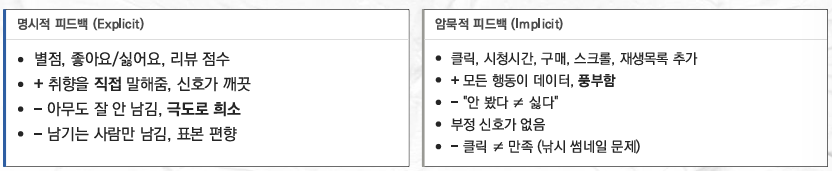
추천 data의 Challenges
- Sparsity (희소성)
: User들이 같은 영화를 평가할 확률 조차 희박 → 유사도 계산부터 흔들림 - Cold Start (콜드 스타트)
: 신규 user 행과 신규 item 열은 통째로 빈칸 - Long-tail (롱테일)
: 상위 소수 item에 집중되고, 대부분은 거의 노출되지 않음
→ 추천의 존재 이유가 사라짐
이 3가지의 공통 해결책은 '행렬 바깥의 정보를 끌어오기'이다.
Context
함수 의 모든 가정은 '취향은 고정되어 있다' 라는 것이다.
하지만 현실의 취향은 두 시간 축에서 움직인다.
(시간 t, 세 번째 인자)
- drift (장기 변화) : 나이&생애 단계에 따른 취향 이동
(오래된 data의 weight를 낮춰야 한다) - session (단기 맥락) : 방금 본 것이 다음 선택을 강하게 결정
(직전 행동이 최고의 신호로 여겨질 수 있게 weight를 높여야 한다)
3. System (=Pipeline)
규모의 문제 / Candidate Generation(후보 생성) / Ranking(랭킹) / Re-ranking(리랭킹) / 순환 구조
하나의 거대한 model이 아니라, 역할이 다른 단계들의 깔대기(funnel)가 답이다.
정밀한 model은 느려서 전체에 못 쓰고, 빠른 model은 거칠어서 최종 선택을 못 맡김
(하나의 model만으로는 만족시킬 수 없음)
solution : 먼저 후보를 좁히고, 좁혀진 후보만 평가
(funnel의 각 단계는 서로 다른 알고리즘, 목표를 가짐)
4.