제 1원칙: Model은 Data보다 좋아질 수 없다
- Garbage In, Garbage Out
: Model은 데이터의 패턴을 증폭할 뿐, 데이터에 없는 진실을 만들어내지 못 한다.
실무에서도 Model보다 로그 정의 / 데이터 검증 / 특징 설계와 같은 곳에 시간을 많이 쓸 정도로 Data는 중요하다.
더불어 같은 Model이더라도 다른 Data로 실험하면 완전히 다른 System이 된다.
그래서 좋은 Data 정제는 좋은 Model을 만드는데 큰 영향을 미친다.
이 Chapter의 핵심 : Data를 의심하는 습관을 만들자!
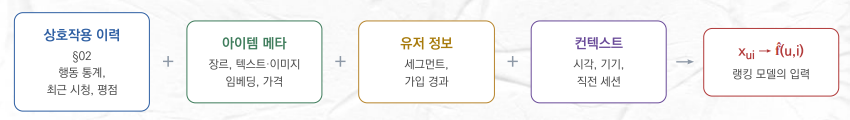
Data의 분류 (4+1)
1) Interaction Data (User - Item)
- 개념 : 행렬 R의 값이 되는 코어 데이터
- 특성 : explicit implicit의 갈림길
(ex. 평점/클릭/시청/구매)
2) Item Meta Data
- 개념 : 아이템이 스스로에 대해 말하는 데이터
- 특성 : 상호작용 없이도 존재
(ex. 장르/텍스트/이미지/가격)
3) User Information
- 개념 : User가 행동하기 전부터 알고 있는 사전 정보
- 특성 : 효용은 제한적 / Cold Start 문제 해결에 사용
4) Context
- 개념 : 현재의 정보 ('취향은 움직인다')
(ex. 시간대/위치/디바이스/세션)
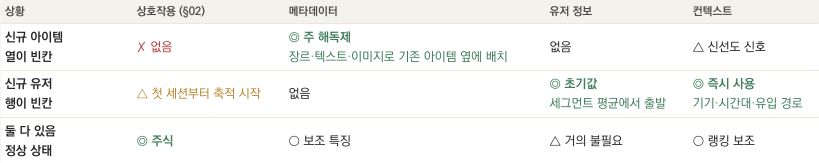
Interaction Data가 비어있을 경우, Cold Start 문제가 생긴다
이때 해결책(Cold Start의 해독제)으로, 사용되는 Data들이 Item Meta Data / User Information / Context 이다.
- 우선 순위 : 행동(Interation Data) > Context > 인구 통계(User Information)
1. Interaction Data (User - Item)
행렬 의 값을 채우는 Data는 두 가지로 나뉜다.
- Explicit Data (의도적으로 말해준 것)
- Implicit Data (행동으로 흘린 것)
Explicit Data
User가 의도적으로 남긴 신호로, 직접 말해준 취향이라고 볼 수 있다. (ex. 평점/좋아요/리뷰)
Explicit Data 분류
1) Rating (1-5점)
- 가장 풍부한 정보량 / 수치로 표현 가능
- 척도가 사람마다 다름
2) 좋아요 / 싫어요
- 이진 신호
- 응답 비용이 낮음
(넷플릭스가 이것으로 바뀐 뒤 응답률이 높아졌다고 발표)
3) Review Text
- 가장 풍부한 정보이지만 가장 희귀한 정보
- 설명 가능한 추천의 원료
- 텍스트 처리가 필요
Explicit Data의 특징
1) 신호의 품질
- 취향을 직접 진술하기에, 해석 할 필요 없음
- 음의 신호 존재
- 정도(degree)로 표현되기에, 회귀 문제로 볼 수 있음
2) 표본의 문제
- 극도로 sparse함 (ex. 시청 1000번에 평점 1개)
- 남기는 사람만 남기기에 편향 존재
- 보통 아주 좋거나 나쁠 때만 남김
결론만 놓고 보면, Explicit는 '보정용 정밀 데이터'로는 최고이지만,
'학습용 데이터'라고 보기에는 힘들다
(=그렇기에 Implicit data가 필요)
Implicit Data
User는 직접 평가하지 않아도 끊임없이 행동한다.
(행동이 흘린 취향의 흔적)
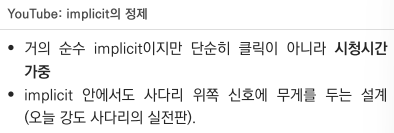
그리고 행동에는 '강도의 사다리' 또한 존재한다.
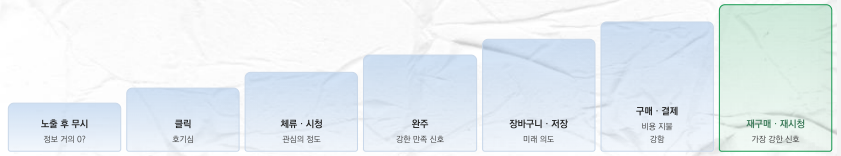
오른쪽으로 갈 수록 신호는 강하지만 드물고
왼쪽으로 갈 수록 흔하지만 모호하다.
그렇기에 여러 단을 함께 쓰는 것이 표준적인 방식이다.
그리고 이러한 Data는 아래와 같이 Domain마다 사다리가 다르게 설정된다.
- 영상 - 완주
- 음악 - 재생목록 추가
- 숏폼 - 재시청
Implicit Data의 3가지 함정
- 음의 신호가 존재 X
'안 봤다'는 싫다는 뜻일 수도, 몰랐다는 뜻일 수도 있음
하지만 그것이 구분되지 않는다.
즉, 0과 빈칸을 구분할 수 없다.
(=이것은 Model 학습의 최대 난제 중 하나) - 행동 ≠ 만족
클릭했지만 낚인 것일 수도 있고, 틀어놓고 잠든 것일 수도 있다.
(= 행동은 만족의 대리 지표) - Noise 존재
다른 사람이 누른 클릭일 수도 있고, 가족 공용 계정일 수도 있다.
explicit에는 거의 없는 비의도적 이벤트가 섞여있다.
Q. 왜 현업에서는 Explicit보다 Implicit Data를 더 많이 사용하는가?
3가지 함정이 존재함에도 불구하고, Implicit Data를 주 data로 소비하는 이유는 Data의 양 때문이다.
- 모든 User들이 남김
: 평점을 안 남긴 다수의 User들도 Implicit Data는 풍부하게 가지고 있음- 실시간성
: 시청이 끝나야 기록되는 Rating과 달리, Implicit는 행동하는 순간 발생
그렇기에 Implicit Data를 잘 사용하기 위하여
3가지 함정을 다루는 방법론이 따로 존재한다.
(ex. Confidence 분리 / Negative Sampling)
Implicit Data 처리 방법론 1. Preference - Confidence 분리
Implicit을 다룬 표준 문법이다. (Hu, Koren & Volinsky 2008)
앞에서 소개한 것처럼 문제가 되는 '안 봤다'는
(preference)으로 쓰되, (confidence) 로 약하게 설정한다.
음의 신호 부재를 낮은 확신으로 우회하는 방법이다.
- 많이 본 것일 수록, Confidence가 커져 만약 틀리면 손실에서 큰 비중을 차지
Implicit Data 처리 방법론 2. Negative Sampling
'좋다'만 있는 data로는 '싫다'를 가르치기 어렵다.
그래서 Negative Data를 직접 만들어서 쓰는 것이 이 방법론의 핵심이다.
- 관측 안 된 쌍 중 일부를 뽑아 '아마 덜 좋아할 것'으로 취급해
학습
(전부 쓰면 빈칸이 너무 많아 계산 불가) - 양성 1개당 음성 몇 개씩 샘플링하는 것이 표준
(딜레마) 하지만 빈칸은 '싫다'가 아니라 대부분 '몰랐다'일 가능성이 높다.
긍정 item을 음성으로 가르치는 오류가 필연적으로 생긴다.
그래서 Sampling 조차 Bias 설계의 일종이다.
Sampling 방법
- Uniform Sampling (표준)
- 인기가 높은 item인데 선택하지 않으면 더 좋은 음성 신호로 판단
- BPR : 선호도를 랭킹으로 학습하는 방법 BPR 내용 참고
Explicit와 Implicit Data 모두 필요하다
Implicit '학습용 데이터' (Confidence or Sampling) + Explicit '보정용 정밀 데이터'
- implicit data (양, 실시간성)
- explicit data (보정, 음의 신호)
- Confidence와 Negative Sampling
2. Item Meta Data
Interation Data가 0건이어도 존재하는 Data로,
item을 등록하는 순간 생긴다.
- Meta Data의 품질이 정제 과정에 따라 달라진다.
(카테고리 오등록/ 빠진 장르 / 어뷰징 태그와 같은 문제 때문에)
구조적 Meta Data
(ex. 장르/카테고리/출시 연도/가격/러닝 타임)
(ex 2. 관계형 정보 : 제작진-브랜드)
- 장점 : 즉시 사용 가능한 표 형태로, 전처리 과정 적음
- 단점 : '거칠다' 한 단어에 추천 가능한 것이 수 만 편 존재
비구조적 Meta Data
(ex. 줄거리/설명/리뷰/포스터/상품 이미지/음원&영상)
- 장점 : 정보가 풍부함/미묘한 결까지 표현 가능
- 단점 : Vectorization 과정 필수
Vectorization
text, image, audio는 행렬로 표현이 불가능하기에,
Vectorization 필요한 상황이다.

- Text : Word or Sentence를 Embedding 하여 비슷한 방향의 벡터를 추출
- Image : CNN로 보기에 비슷한 상품 추천을 함
- Audio : 파형 → 스펙트로그램 → 신경망 벡터
(Spotify가 신곡 Cold Start를 푼 도구)
3. User Information
: 효용은 제한적이지만, 책임은 무겁다.
User Information을 사용하는 이유
- 신규 User의 Initialization
- 세그먼트 개인화
(ex. 행동이 없을 때 '20대 평균 취향'에서 출발 가능) - 연령 제한 등 정책 filtering
- 지역
- 언어&배송권역 같은 하드 제약
User Information의 한계점
- 같은 군집에서 취향 분산이 집단 간 차이보다 큼
- 시간이 지날 수록, 행동 data > 인구 통계 data
- 고정관념 강화 위험
(ex. 성별로 장난감 색 가르는 추천)
User Information은 Privacy와 직결되어있다.
- 현대 설계의 원칙 : 민감 정보는 최소, 추론은 행동에서
- 무엇을 모으지 않아도 되는가? 를 먼저 물음
- 행동 Data가 풍부하면 할 수록 인구 통계 안 모아도 됨
4. Context
: 현재의 정보
Context의 종류
- 시간대& 요일
: 같은 User가 시간대와 요일에 따라 주기적으로 다른 사람이 될 수 있다. 가장 저렴하고 강력한 Context이다. - 위치&디바이스 : 소비 형태를 결정하는 신호
- 직전 세션
: 장기 이력보다 '방금 본 Data'가 더 강력한 신호
(Session Data는 Context 이자 Implicit Data라고 볼 수 있음)
Context의 주의점
- 경우의 수 폭발
- Sparse한 Data가 더 잘게 쪼개짐
이러한 점을 해결하기 위한 Solution 존재한다.
Context를 활용하기 위한 전략
1) Pre-filtering
- 개념 : Context로 Data를 먼저 자르고 학습
- 장점 : 단순, 기존 모델 재사용
- 단점 : 데이터가 잘게 쪼개져 희소성 악화
2) Post-filtering
- 개념 : Context 무시하고 추천 후 결과를 거름
- 장점 : 가장 실용적이며 규칙으로 표현됨
- 단점 : Context가 취향 자체를 바꾸는 경우를 대응 못 함
3) Contextual Modeling
- 개념 : c를 model의 input feature로 넣어 직접 학습
- 장점 : 가장 표현력 높음
- 단점 : model, data 요구량 증가
현대에서는 Post-filtering, Contextual Modeling을 적절하게 섞어서 사용하고 있다.
Cold Start의 Solution
행렬 을 기준으로 어디가 비어있는지 확인하고,
Interation Data를 제외한 나머지 3가지 Data를 채워넣으면 된다.
같은 Model이라도 (feature vector)에 무엇을 넣었느냐가 성능을 좌우한다.
6. 로그의 함정
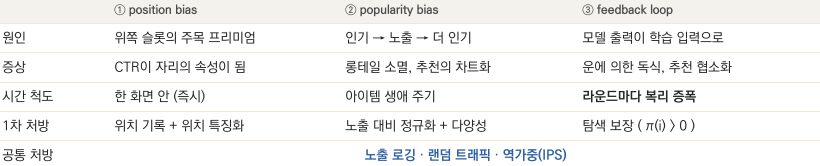
로그 데이터는 아래와 같은 bias로 인해 시스템이 개입한 결과물이라고 볼 수 있다.
- Position Bias : 위에 놓일 수록 더 많은 클릭이 유도됨
- Popularity Bias : 인기가 많아서 노출이 올라감
- Feedback Loop : 추천한 것만 여러 번 학습됨
모든 item이 같은 조건에서 같은 기회를 받으면 좋겠지만,
클릭률 차이 = 취향 차이 + 노출 차이 + 위치 차이
로 뒤범벅 되어있다.
(=분리하지 않으면 Data가 거짓말하는 것처럼 보일 수 있음)
1) Position Bias
User는 위에서 아래로 훑기에, 아래로 갈 수록 Examination 감소한다.
그래서 위치가 만든 클릭을 취향으로 오독하는 상황이 발생한다.
Position Bias의 Solution. 클릭을 두 확률로 쪼개기

- 위치를 feature 자체로 넣음
Model이 위치 효과 자체를 배우게 함 (가장 실용적인 방안) - 소량의 랜덤화
트래픽 일부에 순서를 섞어 위치 효과 자체를 측정 - 역가중(IPS)
잘 안 보이는 위치의 클릭에 큰 가중치를 둠
이 모든 것은 '노출 위치를 로그에 기록한다' 라는 examination 가설이 전제되어 있어야 한다.
2) Popularity Bias : 인기가 인기를 부른다
인기 item 자체는 더 많이 노출되어 더 많은 interation을 가진다.
(= 비인기 item은 기록조차 없음)
로그에서의 인기는 취향의 합산이라기 보다, 노출의 합산일 수 있다. ('데이터의 민주성'은 착시)
Popularity Bias의 Solution
- 노출 대비 성과로 정규화
- 리랭킹의 다양성 장치
- 롱테일 커버리지 지표로 감시
3) Feedback Loop : 추천한 것만 다시 학습
앞에서 소개한 position bias / popularity bias가 시간 축에서 복리로 굴러가는 현상이다.
- Model이 자기 Output을 자기 input으로 받아 먹는 구조
(모델이 보여줌 → 보여준 것에서만 반응 발생 → 그 반응만으로 재학습 → 더 확신하고 또 보여줌 )
초기의 사소한 운(어떤 아이템이 우연히 먼저 노출됐는가)이 영구적 승자를 결정할 수 있는 구조이다.
Experiment. feedback loop 시뮬레이터 (미니 MovieLens 영화 8편)
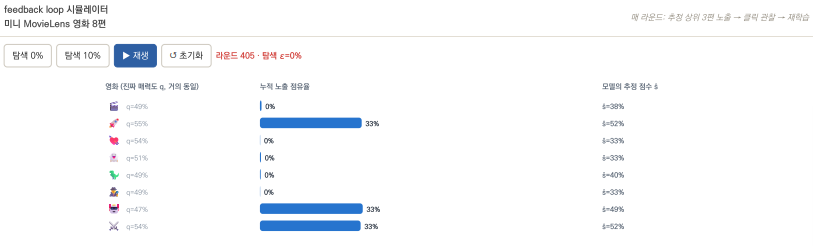
- 탐색 0%
매력도가 거의 같은데도 특정 몇 편이 노출을 독식하는 것을 확인할 수 있다.
(=수렴이 아니라 고착화)
초기화하면 다른 영화가 우연으로 인해 노출을 독식한다. - 탐색 10%
쏠림이 완화되고 추정이 매력도에 수렴한다.

이면 의 Data는 영원히 Model을 갱신하지 못 한다.
을 보장하는 최소한의 탐색이 있어야 추정이 갱신 될 기회가 생긴다. 그래서 무작위성이 약이다.
Bias 보정 방법론
더 정직한 Data를 만들기 위한 장치로 3가지를 소개할 수 있다.
- 노출 log 기록
클릭만 기록하는 것이 아니라, '무엇을, 몇 번째에, 보여줬는가?' 와 같은 상세한 내용까지 기록한다. - Randomness 추가
루프 탈출을 한 번에 성공할 수 있는 기회이다. - 역가중 하기(IPS)
균등 노출을 세상으로 재가중하는 통계적 보정이다.
Bias 비교 정리
( position bias - popularity bias - feedback loop)