[확률적 경사 하강법]
손실 함수 값이 낮아지는 방향으로 독립 변수 값을 변형시켜가면서 최종적으로는 최소 함수 값을 갖도록 하는 독립 변수 값을 찾는 방법이다.
-
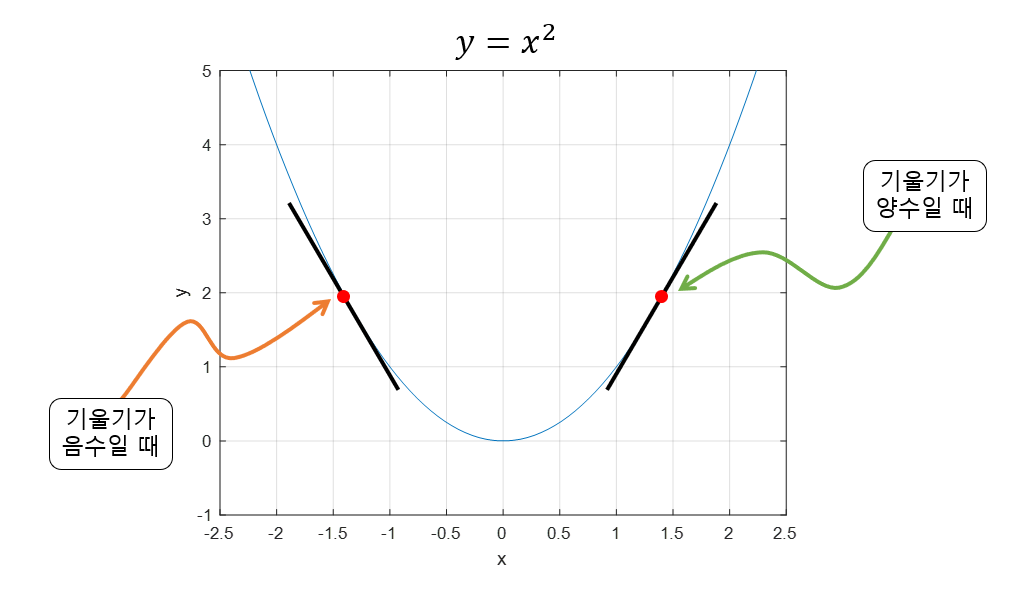
함수의 기울기를 이용해 x의 값이 변함에 따라 함수가 최소값을 찾는지 알아보는 방법이라고 할 수 있다.
-
기울기가 양수라는 것은 x값이 커질 수록 함수 값이 커진다는 것을 의미하고,
반대로 기울기가 음수라면 x값이 커질 수록 함수의 값이 작아진다는 것을 의미한다고 볼 수 있다. -
기울기의 값이 크다는 것은 가파르다는 것을 의미하기도 하지만, 또 한편으로는 x의 위치가 최소값/최댓값에 해당되는 x좌표로부터 멀리 떨어져있는 것을 의미하기도 한다.
-
이동거리에 사용할 값을 gradient의 크기와 비례하는 factor를 이용하면 현재 x의 값이 극소값에서 멀 때는 많이 이동하고, 극소값에 가까워졌을 때는 조금씩 이동할 수 있게 된다.
(사실 극대값에 가까울 때에도 미분 계수는 작아지기 마련인데, 경사 하강법 과정에서 극대값에 머물러 있는 경우는 극히 드물기 때문에 이 문제에 대해서는 고려하지 않고자 한다.)
이런식으로 step size 조절 가능
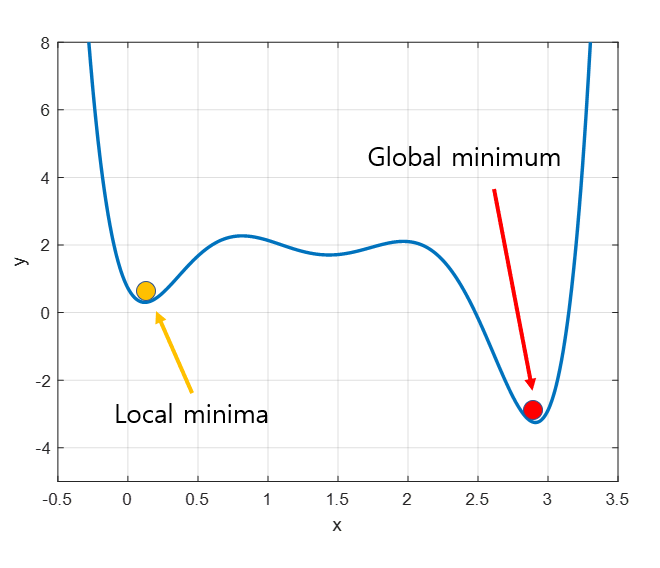
전역 최솟값(global minimum)이 아닌 지역 최솟값(local minimum)에 빠질 위험이 있다.
(학습률 스케줄링, 모멘텀, 적응적 학습률, 랜덤 초기화, 드롭아웃)
혼공머신 Ch.4에서 확률적 경사 하강법을 학습했는데 이는 신경망 알고리즘에 사용된다.
이에 역전파 알고리즘을 들어가기 전에 신경망에 대해 이야기를 알아보자.
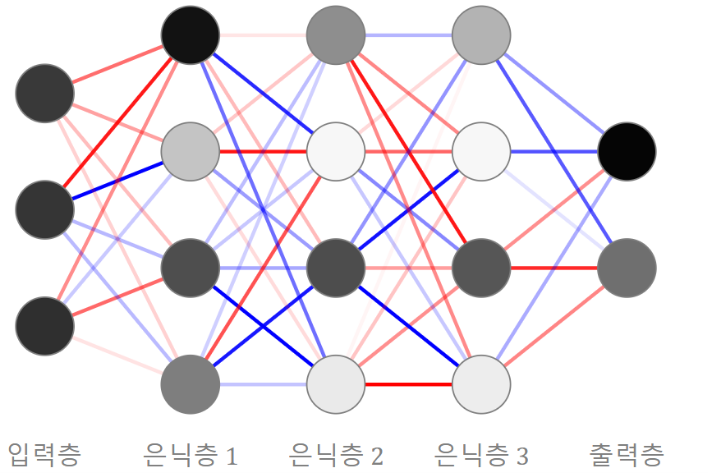
인공신경망은 행렬을 모델로 삼아 인간의 뉴련 구조를 본떠 만든 기계학습 모델로 인공지능을 구현하기 위한 기술 중 한 형태이다.
인공신경망은 수많은 '노드'들로 구성된다.
하나의 노드는 여러 함수로 이루어진 하나의 계단 단위인데, 이 단위 자체가 뉴런을 모방하는 것이다.
그리고 각 노드를 용도별로 분리한 단위를 '층'이라고 하며 각 노드가 얼마나 많은 노드와 신호(정보)를 주고 받는지 따질 수 있는 그 연결의 수를 '망'이라 한다.
그래서 최종적으로 인공신경망이라고 하는 것
- 역전파 알고리즘은 인공신경망의 학습과정에서 오차를 최소화하기 위한 가중치와 편향을 조정하기 위해 사용하는 학습 알고리즘입니다.
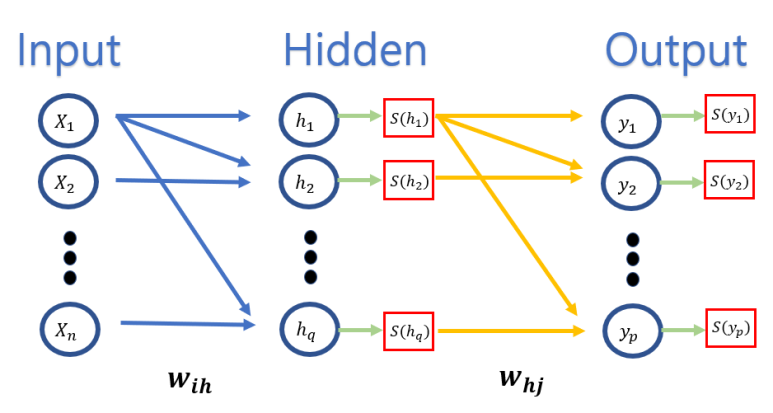
인공신경망은 입력층, 은닉층, 출력층으로 구성되어 있으며, 각 층은 여러 개의 뉴런으로 구성되어 있다.
[순전파 학습과정]
- 먼저, 신경망에 입력 데이터를 제공하고 각 뉴런은 입력 신호에 가중치를 곱하고
- 이를 모두 합한 후 활성화 함수를 통과시켜 출력 신호를 생성한다.
- 이렇게 생성된 출력 신호는 다음 층의 입력으로 사용된다.
- 생성된 출력과 실제 정답을 비교하여 오차를 계산한다.
이 오차가 최소가 되도록 신경망의 가중치를 조정해야 한다.
이때 역전파 알고리즘이 사용된다.
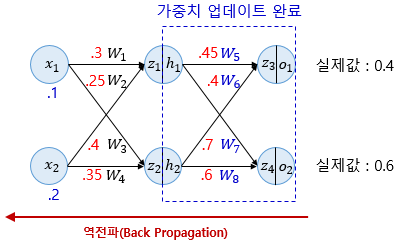
[역전파 학습과정]
역전파 알고리즘은 출력층에서부터 입력층까지 역순으로 진행된다.
- 출력층에서의 오차를 계산하고
- 이를 이용해 미분의 Chain Rule을 통해 가중치를 계산하고 조정한다.
- 그런 다음, 바로 앞의 은닉층으로 이동하여 같은 과정을 반복합니다.
이렇게 출력층에서 입력층까지 오차를 역전파하면서 가중치를 조정하는 과정이 진행된다.
이런 역전파 알고리즘은 이미지 인식, 음성 인식, 자연어 처리 등 다양한 분야에서 역전파 알고리즘을 활용하여 모델을 학습시킬 수 있다.
역전파 알고리즘은 이러한 다양한 응용분야에서 모델의 학습을 도와, 정확도를 향상시키는데 기여한다.
그러나 역전파 알고리즘에도 몇 가지 한계점이 있습니다.
첫째, 신경망의 구조가 복잡해질수록, 즉, 뉴런의 수나 은닉층의 수가 많아질수록, 가중치를 조정하는 과정이 복잡해지고, 계산량이 크게 증가합니다. 이로 인해 학습 시간이 길어지고, 컴퓨팅 리소스의 소모가 증가합니다.
둘째, 이 기술은 전역 최솟값(global minimum)이 아닌 지역 최솟값(local minimum)에 빠질 위험이 있습니다. 이는 학습 결과의 정확도를 떨어뜨릴 수 있습니다.
셋째, 역전파 알고리즘은 데이터의 순서에 영향을 받습니다. 즉, 데이터를 입력하는 순서에 따라 학습 결과가 달라질 수 있습니다.
역전파 알고리즘은 초기 가중치 설정에 따라 학습 결과가 달라질 수 있어요
학습 속도와 수렴성에도 당연히 영향을 미칠 수 있습니다.
큰 제약은 과적합의 가능성입니다 학습 데이터에 너무 맞춰져서 새로운 입력에 대한 일반화 능력이 떨어질 수가 있다고합니다.
한계를 예방하기 위해서
-
가중치의 초기값을 적절히 설정하거나, 학습률을 조정하거나, 데이터를 무작위로 섞는 등의 방법이 사용될 수 있습니다.
-
또한, 최근에는 드롭아웃(dropout)이나 배치 정규화(batch normalization) 등의 기법이 제안되어, 이러한 한계점들을 어느 정도 해결하는데 도움을 주고 있습니다.
결국, 역전파 알고리즘은 인공신경망을 학습시키는데 있어서 매우 중요한 알고리즘입니다. 이러한 한계점을 극복하기 위한 다양한 방법들이 제안되고 있으며, 이를 적절히 활용하여 모델의 성능을 최적화할 수 있습니다. 이 알고리즘을 통해 신경망의 가중치가 조정되어, 모델의 출력값이 실제값과 가까워지게 되며, 이로써 모델의 성능이 향상됩니다. 이를 적절히 활용하면 모델의 성능을 최적화할 수 있습니다. 이를 통해, 더욱 정확하고 효율적인 인공지능 모델을 구축할 수 있을 것입니다
