혼공머신 Chapter.5
5-1 결정트리
예시) 표시가 누락된 와인의 병에 인쇄된 알코올 도수, 당도, pH 값으로 와인 종류를 구별할 수 있는 방법
import pandas as pd
wine = pd.read_csv('https://bit.ly/wine-date')
wine.head()
#class 타깃 값이 0이면 레드 와인, 1이면 화이트 와인(양성 클래스)
#즉 전체 와인 데이터에서 화이트 와인을 골라내는 문제임
info() 메서드 : 데이터프레임의 각 열의 데이터 타입과 누락된 데이터가 있는지 확인
describe() 메서드 : 열에 대한 간략한 통계를 출력함, 최소,최대,평균값 등을 확인
wine.info()
wine.describe()
누락된 값이 있다면? 버리거나 평균값, 중앙값 등으로 채운 후 사용
data = wine[['alcohol', 'sugar', 'pH']].to_numpy()
target = wine['class'].to_numpy()
from sklearn.model_selection import train_test_split
train_input, test_input, train_target, test_target = train_test_split(data, target, test_size=0.2, random_state=42)
print(train_input.shape, test_input.shape) ->(5197, 3) (1300, 3)
test_size 지정 안하면 기본 25%를 테스트 세트로 지정
from sklearn.preprocessing import StandardScaler
ss = StandardScaler()
ss.fit(train_input)
train_scaled = ss.transform(train_input)
test_scaled = ss.transform(test_input)
from sklearn.linear_model import LogisticRegression
lr = LogisticRegression()
lr.fit(train_scaled, train_target)
print(lr.score(train_scaled, train_target))
print(lr.score(test_scaled, test_target))
print(lr.coef, lr.intercept) -> [[ 0.51270274 1.6733911 -0.68767781]][1.81777902]
결정트리 Decision Tree
from sklearn.tree import DecisionTreeClassifier
dt = DecisionTreeClassifier(random_state=42)
dt.fit(train_scaled, train_target)
print(dt.score(train_scaled, train_target))
print(dt.score(test_scaled, test_target))
import matplotlib.pyplot as plt
from sklearn.tree import plot_tree
plt.figure(figsize=(10,7))
plot_tree(dt)
plt.show()
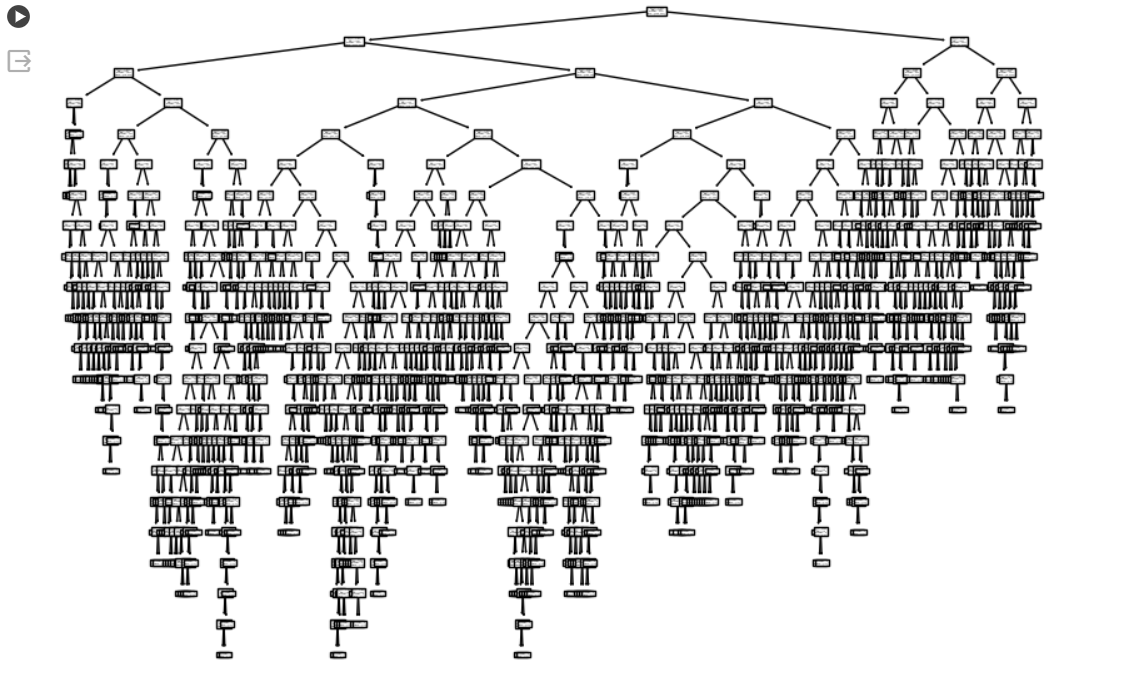
plt.figure(figsize=(10,7))
plot_tree(dt, max_depth=1, filled=True, feature_names=['alcohol', 'sugar', 'pH'])
plt.show()
#filled=True로 지정하면 클래스마다 색깔을 부여하고, 어떤 클래스의 비율이 높아지면 점점 진한색으로 표시한다.
#만약 결정 트리를 회귀 문제에 적용하면 리프 노드에 도달한 샘플의 타깃을 평균하여 예측값으로 사용한다.
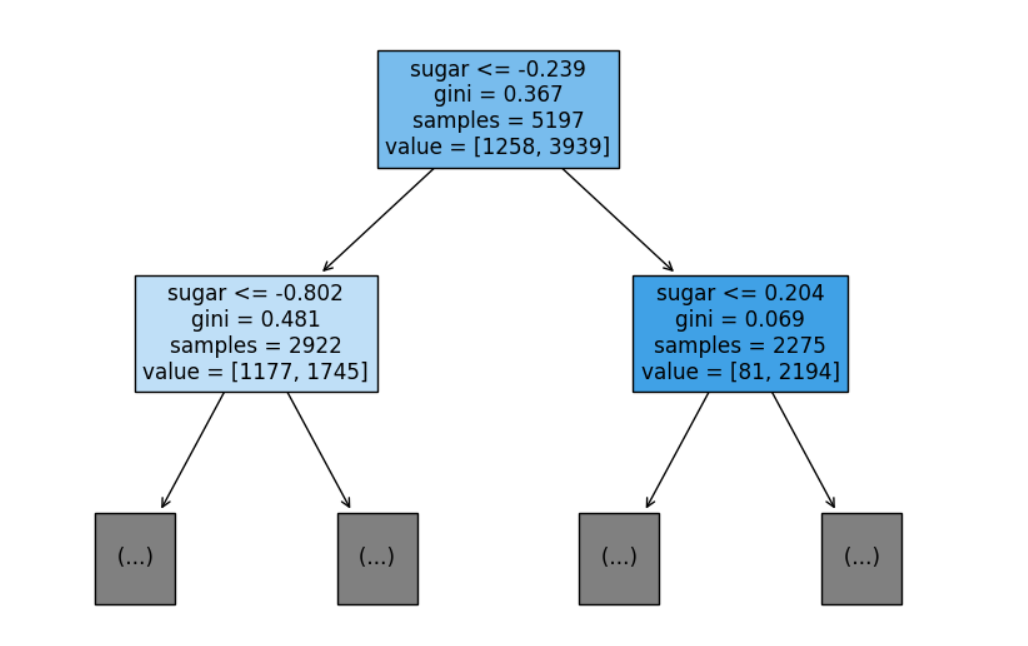
gini는 지니 불순도 Gini impurity 를 의미
imformation gain 정보이득 = parent 와 child node의 불순도 차이
IG가 최대가 되도록..
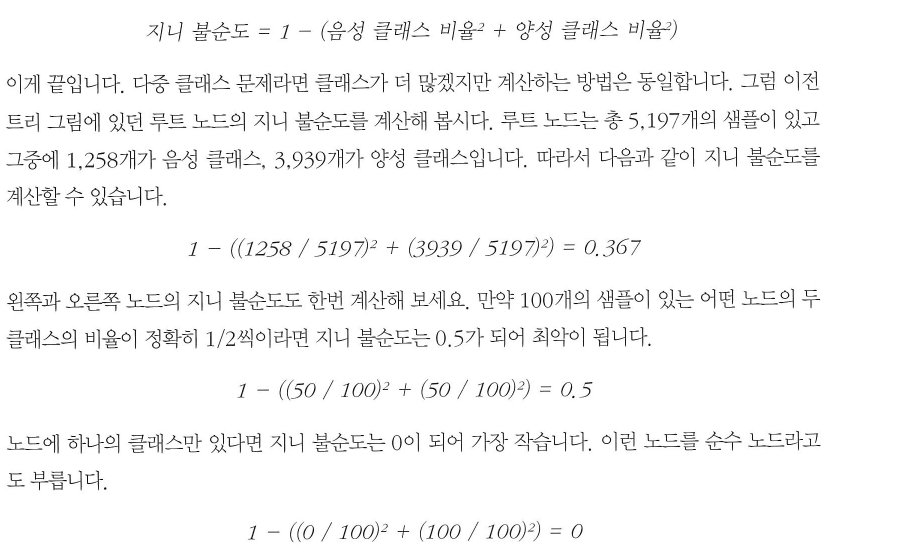
결정 트리 모델은 parent node와 child node의 불순도 차이가 가능한 크도록 트리를 성장시킨다.
-> 먼저 자식 노드의 불순도를 샘플 개수에 비례하여 모두 더한 다음 부모 노드의 불순도에서 빼면 된다.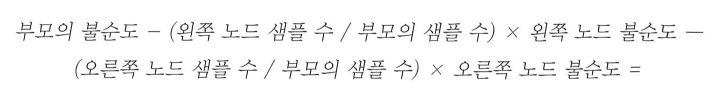
정보 이득(information gain) : 부모와 자식 노드 사이의 불순도 차이
가지치기 pruning
dt = DecisionTreeClassifier(max_depth=3, random_state=42)
dt.fit(train_scaled, train_target)
print(dt.score(train_scaled, train_target))
print(dt.score(test_scaled, test_target))
#trainning set score 감소 but test set score 거의 그대로
plt.figure(figsize=(20,15))
plot_tree(dt, filled=True, feature_names=['alcohol', 'sugar', 'pH'])
plt.show()
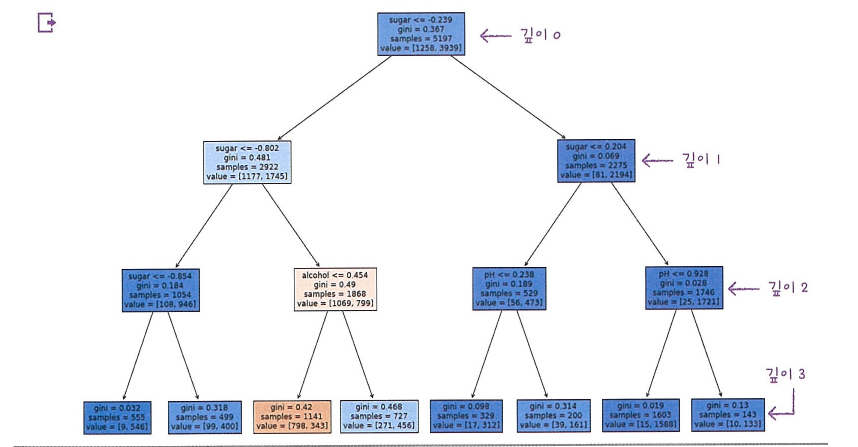
#결정 트리는 표준화 전처리 과정이 필요없다.(특성값의 스케일은 계산에 영향 X)
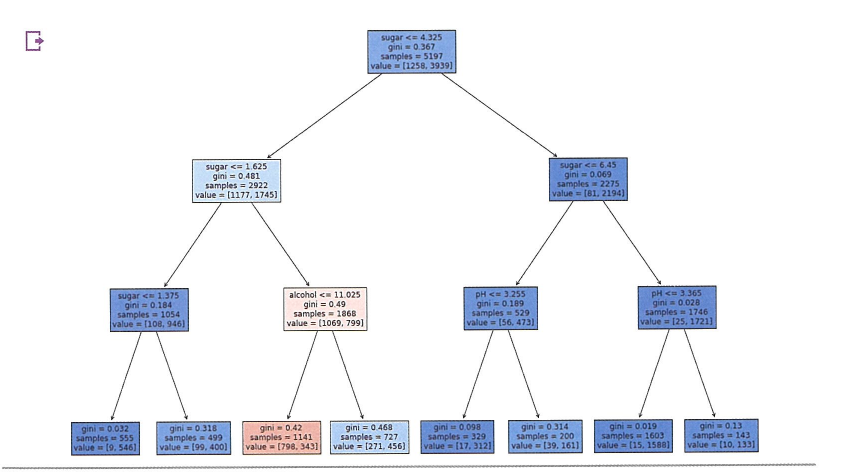
dt = DecisionTreeClassifier(max_depth=3, random_state=42)
dt.fit(train_input, train_target)
print(dt.score(train_input, train_target))
print(dt.score(test_input, test_target))plt.figure(figsize=(20,15))
plot_tree(dt, filled=True, feature_names=['alcohol', 'sugar', 'pH'])
plt.show()
#결과는 같은 트리지만, 특성값을 표준점수로 바꾸지 않아 이해가 쉬움ㅋprint(dt.featureimportances)
- 결정 트리는 어떤 특성이 가장 유용한지 나타내는 특성 중요도를 계산한다.
- 특성 중요도는 featureimportances 속성에 저장
- 속성들의 중요도 합 = 1
- 특성 중요도는 각 노드의 IG와 전체 샘플에 대한 비율을 곱한 후 특성별로 더하여 계산
5-2 교차 검증과 그리드 서치
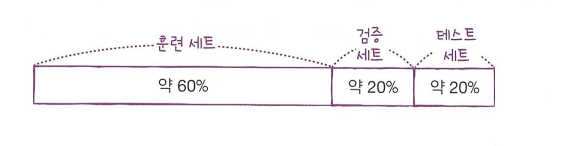
- 검증 세트
import pandas as pd
wine = pd.read_csv('https://bit.ly/wine-date')
wine.head()
data = wine[['alcohol', 'sugar', 'pH']].to_numpy()
target = wine['class'].to_numpy()
from sklearn.model_selection import train_test_split
train_input, test_input, train_target, test_target = train_test_split(
data, target, test_size = 0.2, random_state = 42)
train set의 일부를 검증세트로
sub_input, val_input, sub_target, val_target = train_test_split(train_input, train_target, test_size=0.2, random_state=42)
print(sub_input.shape, val_input.shape)
from sklearn.tree import DecisionTreeClassifier
dt = DecisionTreeClassifier(random_state=42)
dt.fit(sub_input, sub_target)
print(dt.score(sub_input, sub_target))
print(dt.score(val_input, val_target))
- 교차 검증 cross validation
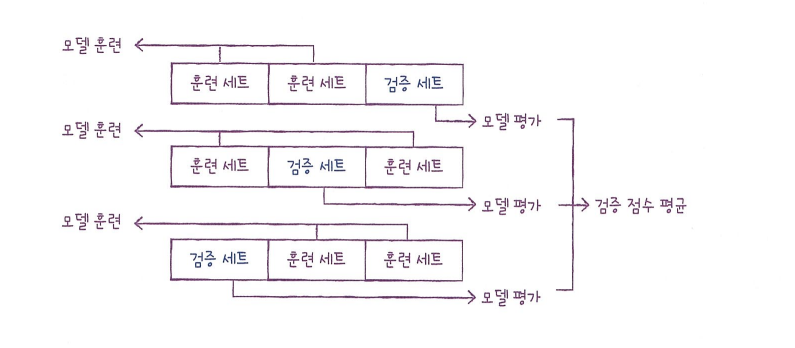
- k-폴드 교차 검증 (k-fold cross validation)
- 5,10 폴드 교차 검증을 많이사용 -> 데이터의 80~90% 까지 훈련에 사용한다
- 검증 세트가 줄어들지만 각 폴드에서 계산한 검증 점수를 평균하기 때문에 안정된 점수로 생각할 수 있다.
from sklearn.model_selection import cross_validate
scores = cross_validate(dt, train_input, train_target) #직접 검증 세트를 떼어 내지 않고 진행
print(scores) ->
{'fit_time': array([0.03568053, 0.03593707, 0.018435 , 0.01565194, 0.02600002]), 'score_time': array([0.00232816, 0.00258636, 0.00399208, 0.00217724, 0.00202155]), 'test_score': array([0.86923077, 0.84615385, 0.87680462, 0.84889317, 0.83541867])}
-
이 함수는 fit_time, score_time, test_score 키를 가진 딕셔너리를 반환한다.
-
처음 2개의 키는 각각 모델을 훈련하는 시간과 검증하는 시간을 의미
-
각 키마다 5개의 숫자가 담겨있다.
-
cross_validate()함수는 기본적으로 5-폴드 교차 검증을 수행함
-
cv 매개변수에서 폴드 수를 바꿀 수 있음
-
교차 검증의 최종 점수는 test_score 키에 담긴 5개의 점수를 평균하여 얻을 수 있다.
import numpy as np
print(np.mean(scores['test_score']))
교차 검증을 할 때 훈련 세트를 섞으려면 분할기(splitter)를 지정해야 함
from sklearn.model_selection import StratifiedKFold
scores = cross_validate(dt, train_input, train_target, cv=StratifiedKFold())
print(np.mean(scores['test_score']))
splitter = StratifiedKFold(n_splits=10, shuffle=True, random_state=42)
#n_splits 매개변수는 몇(k) 폴드 교차 검증을 할지 정함
scores = cross_validate(dt, train_input, train_target, cv=splitter)
print(np.mean(scores['test_score']))
하이퍼파라미터 튜닝
- Grid Search 그리드 서치
from sklearn.model_selection import GridSearchCV
params = {'min_impurity_decrease':[0.0001, 0.0002, 0.0003, 0.0004, 0.0005]}
gs = GridSearchCV(DecisionTreeClassifier(random_state=42), params,n_jobs=-1)
#cpu코어수 n_jobs = -1로 지정하면 시스템에 있는 모든 코어 사용
gs.fit(traininput, train_target)
dt = gs.best_estimator
print(dt.score(traininput, train_target))
print(gs.best_params) #그리드 서치로 찾은 최적의 매개변수는 bestparams속성에 저장
print(gs.cvresults['mean_test_score']) #각 매개변수에서 수행한 교차 검증의 평균 점수는 cvresults 속성의 'mean_test_score'키에 저장
bestindex = np.argmax(gs.cv_results['mean_test_score'])
print(gs.cvresults['params'][best_index])
위의 과정을 정리해 보면
-
먼저 탐색할 매개변수를 지정
-
그 다음 훈련 세트에서 그리드 서치를 수행하여 최상의 평균 검증 점수가 나오는 매개변수 조합을 찾는다. 이 모델은 그리드 서치 객체에 저장됨
-
그리드 서치는 최상의 매개변수에서 (교차 검증에 사용한 훈련 세트가 아니라) 전체 훈련 세트를 사용해 최종 모델을 훈련한다. 이 모델도 그리드 서치 객체에 저장됨.
- min_impurity_decrease 는 노드를 분할하기 위한 불순도 감소 최소량을 지정한다.
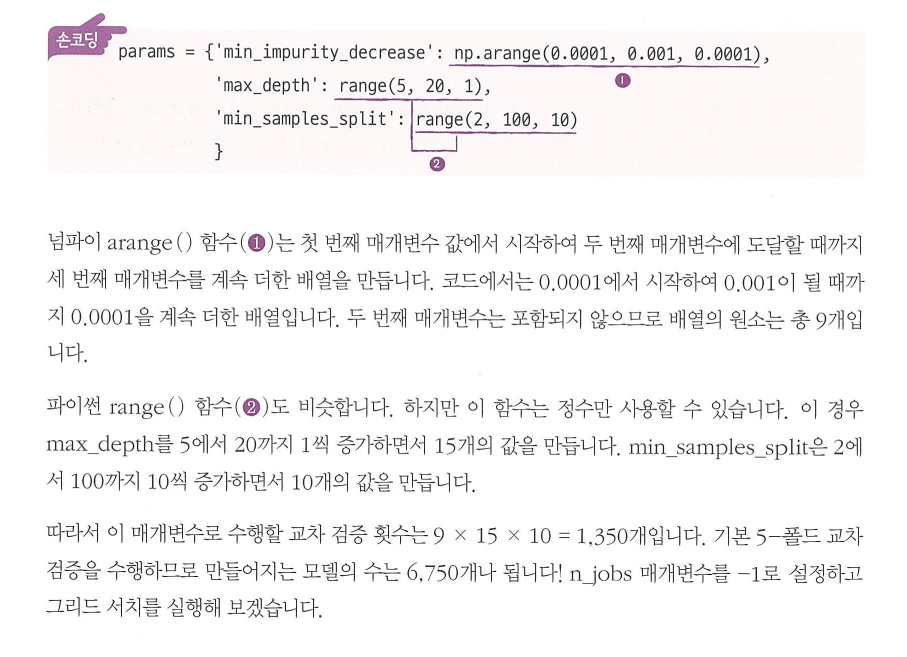
params = {'min_impurity_decrease': np.arange(0.0001, 0.001, 0.0001), 'max_depth':range(5, 20, 1), 'min_samples_split':range(2, 100, 10)}
#p.249 참고
gs = GridSearchCV(DecisionTreeClassifier(randomstate=42), params, n_jobs=-1)
gs.fit(train_input, train_target)
print(gs.best_params) -> {'max_depth': 14, 'min_impurity_decrease': 0.0004, 'min_samples_split': 12}
-
min_impurity_decrease : 이 매개변수는 노드를 분할하기 위한 최소 불순도 감소를 나타낸다. 값이 높을수록 더 적은 수의 불순한 노드만이 분할되고, 이는 모델의 복잡도를 줄이고 일반화 성능을 향상시킬 수 있다.
-
min_samples_split : 이 매개변수는 노드를 분할하기 위해 필요한 최소 샘플 수를 나타닌다. 결정 트리는 데이터를 분할하여 트리를 구성하며, 이때 각 노드에서 샘플의 수가 min_samples_split보다 작으면 더 이상 분할을 하지 않고 leaf 노드가 된다.
-
min_samples_leaf는 리프 노드가 가져야 하는 최소 샘플 수를 나타낸다.
리프 노드는 더 이상 자식 노드를 가지지 않는 노드로서, 해당 노드의 샘플 수가 이 값보다 작으면 분할되지 않고 리프 노드가 된다.
-
min_samples_split은 노드를 분할할 때 사용되며, 각 내부 노드의 분할에 관여한다.
-
min_samples_leaf는 리프 노드가 되기 위한 최소 샘플 수를 제어하며, 리프 노드의 크기에 직접적인 영향을 미친다,.
-
두 매개변수는 모두 모델의 복잡도를 조절하여 과적합을 방지하고 일반화 능력을 향상시키는 데 사용된다. 적절한 값을 선택하기 위해서는 실험과 모델의 성능 평가가 필요하다.
#랜덤 서치 Random Search
from scipy.stats import uniform, randint
rgen = randint(0, 10)
rgen.rvs(10)
np.unique(rgen.rvs(1000), return_counts=True)
ugen = uniform(0, 1)
ugen.rvs(10)
#ugen.rvs(10) -> 10번 반복 의미
params = {'min_impurity_decrease':uniform(0.0001, 0.001), 'max_depth':randint(20, 50), 'min_samples_split':randint(2, 25), 'min_samples_leaf':randint(1, 25)}
from sklearn.model_selection import RandomizedSearchCV
gs = RandomizedSearchCV(DecisionTreeClassifier(random_state=42), params, n_iter=100, n_jobs=-1, random_state=42)
gs.fit(train_input, train_target)
print(gs.bestparams)
print(np.max(gs.cvresults['mean_test_score']))
dt = gs.bestestimator
print(dt.score(test_input, test_target))
5-3 앙상블 학습(ensemble learning)
- 정형 데이터를 다루는 데 가장 뛰어난 성과를 내는 알고리즘으로 대부분 결정 트리를 기반으로 만들어짐
(비정형 데이터는? 신경망 알고리즘 사용)
랜덤 포레스트 : 앙상블 학습 중 하나로 안정적인 성능을 보임. 결정 트리를 랜덤하게 만들어 결정 트리의 숲을 만드는 느낌적인 느낌쓰~
부트스트랩 샘플 (bootstrap sample) :데이터 내에서 중복을 허용하여 반복적으로 샘플링
p264
각 노드를 분할할 때 전체 특성 중에서 일부 특성을 무작위로 고른 다음 이 중에서 최선의 분할을 찾는다.
분류 모델인 RandomForestClassifier는 기본적으로 전체 특성 개수의 제곱근만큼의 특성을 선택한다.
사이킷런의 랜덤 포레스트는 기본적으로 100개의 결정트리를 위의 방식(p.264그림)으로 훈련.
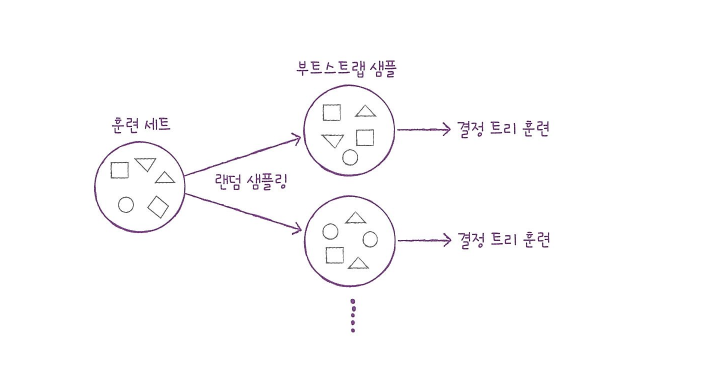
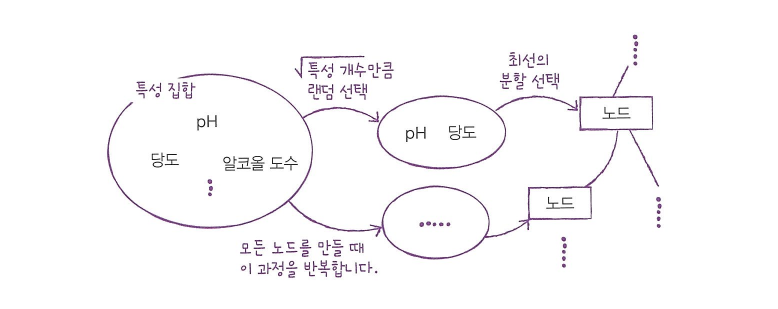
그 다음
분류일 때 : 각 트리의 클래스별 확률을 평균하여 가장 높은 확률을 가진 클래스를 예측
회귀일 때 : 단순히 각 트리의 예측을 평균
import numpy as np
import pandas as pd
from sklearn.model_selection import train_test_split
wine = pd.read_csv('https://bit.ly/wine-date')
data = wine[['alcohol', 'sugar', 'pH']].to_numpy()
target = wine['class'].to_numpy()
train_input, test_input, train_target, test_target = train_test_split(data, target, test_size=0.2, random_state=42)
from sklearn.model_selection import cross_validate
from sklearn.ensemble import RandomForestClassifier
rf = RandomForestClassifier(n_jobs=-1, random_state=42)
scores = cross_validate(rf, train_input, train_target, return_train_score=True, n_jobs=-1)
print(np.mean(scores['train_score']), np.mean(scores['test_score']))
랜덤 포레스트는 결정 트리의 앙상블이기 때문에 DecisionTreeClassifier가 제공하는 중요한 매개변수를 모두 제공한다.
결정 트리의 장점 중 하나인 특성 중요도를 계산한다.
랜덤 포레스트의 특성 중요도는 각 결정 트리의 특성 중요도를 취합한 것이다.
rf.fit(traininput, train_target)
print(rf.feature_importances)
OOB Sample (Out Of Bag) : 부트스트랩 샘플에 포함되지 않고 남는 샘플
-> 이걸로 부트스트랩 샘플로 훈련한 결정 트리를 평가할 수 있음
이 점수를 얻으려면 RandomForestClassifier 클래스의 oob_score 매개변수를 True로 지정해야 한다.(이 매개변수의 기본값은 False).
이렇게 하면 랜덤 포레스트는 각 결정 트리의OOB점수를 평균하여 출력한다.
rf = RandomForestClassifier(oobscore = True, n_jobs=-1, random_state=42)
rf.fit(train_input, train_target)
print(rf.oob_score)
OOB 점수를 사용하면 교차 검증을 대신할 수 있어서 결과적으로 훈련 세트에 더 많은 샘플을 사용할 음
엑스트라 트리 Extra Tree는 기본적으로 100개의 결정 트리를 훈련한다.랜덤포레스트와의 차이점은 부트스트랩 샘플을 사용하지 않는다는 점이다.
엑스트라 트리가 사용하는 결정 트리가 splitter='random'인 결정 트리임.
하나의 결정 트리에서 특성을 무작위로 분할한다면 성능이 낮아지겠지만 많은 트리를 앙상블 하기때문에 과대적합을 막고 검증 세트의 점수를 높이는 효과가 있다.
from sklearn.ensemble import ExtraTreesClassifier
et = ExtraTreesClassifier(n_jobs=-1, random_state=42)
scores = cross_validate(et, train_input, train_target, return_train_score=True, n_jobs=-1)
print(np.mean(scores['train_score']), np.mean(scores['test_score']))
결정 트리는 최적의 분할을 찾는데 고려해야 할 특성의 개수가 많을때 더 많은 시간을 소요한다.
만약 무작위로 나눈다면 빠르게 트리를 구성할 수 있음.
et.fit(traininput, train_target)
print(dt.feature_importances)
그레이디언트 부스팅 gradient boosting은 깊이가 얕은 결정 트리를 사용하여 이전 트리의 오차를 보완하는 방식으로 앙상블 하는 방법이다.
사이킷런의 GradientBoostingClassifier는 기본적으로 깊이가 3인 결정 트리를 100개 사용한다.
깊이가 얕은 결정 트리를 사용하기 때문에 과대적합에 강하고 일반적으로 높은 일반화 성능을 기대할 수 있다.
경사 하강법을 사용하여 트리를 앙상블에 추가한다.
분류에서는 로지스틱 손실 함수를 사용하고
회귀에서는 평균 제곱 오차 함수를 사용한다.
from sklearn.ensemble import GradientBoostingClassifier
gb = GradientBoostingClassifier(random_state=42)
scores = cross_validate(gb, train_input, train_target, return_train_score=True, n_jobs=-1)
print(np.mean(scores['train_score']), np.mean(scores['test_score']))
gb = GradientBoostingClassifier(n_estimators=500, learning_rate=0.2, random_state=42)
scores = cross_validate(gb, train_input, train_target, return_train_score=True, n_jobs=-1)
print(np.mean(scores['train_score']), np.mean(scores['test_score']))
gb.fit(traininput, train_target)
print(gb.feature_importances)
subsample 매개변수는 트리 훈련에 사용할 훈련 세트의 비율을 정하는 매개변수로 기본값은 1.0으로 전체 훈련 세트를 사용한다.
히스토그램 기반 그레이디언트 부스팅은 정형 데이터를 다루는 머신러닝 알고리즘이다.
입력 특성을 256개의 구간으로 나눈다. 256개 구간 중에서 하나를 떼어 놓고 누락된 값을 위해서 사용한다. 따라서 입력에 누락된 특성이 있더라도 이를 따로 전처리할 필요가 없자나.
from sklearn.experimental import enable_hist_gradient_boosting
from sklearn.ensemble import HistGradientBoostingClassifier
hgb = HistGradientBoostingClassifier(random_state=42)
scores = cross_validate(hgb, train_input, train_target, return_train_score=True)
print(np.mean(scores['train_score']), np.mean(scores['test_score']))
hgb.fit(traininput, train_target)
print(rf.feature_importances)
hgb.score(test_input, test_target)
from xgboost import XGBClassifier
xgb = XGBClassifier(tree_method='hist', random_state=42)
scores = cross_validate(xgb, train_input, train_target, return_train_score=True)
print(np.mean(scores['train_score']), np.mean(scores['test_score']))
from lightgbm import LGBMClassifier
lgb = LGBMClassifier(random_state=42)
scores = cross_validate(lgb, train_input, train_target, return_train_score=True, n_jobs=-1)
print(np.mean(scores['train_score']), np.mean(scores['test_score']))
