짧은 책 형식으로 자세히 다루었으니 궁금한 내용을 발췌하여 보시는 것을 추천 드립니다 :)
🤔 Jev란 무엇인가: ‘판단하는 AI’가 주목받는 이유
2026년 9월, TypeSafe AI가 공개한 Jev가 AI 개발자 커뮤니티에서 빠르게 주목받고 있다.
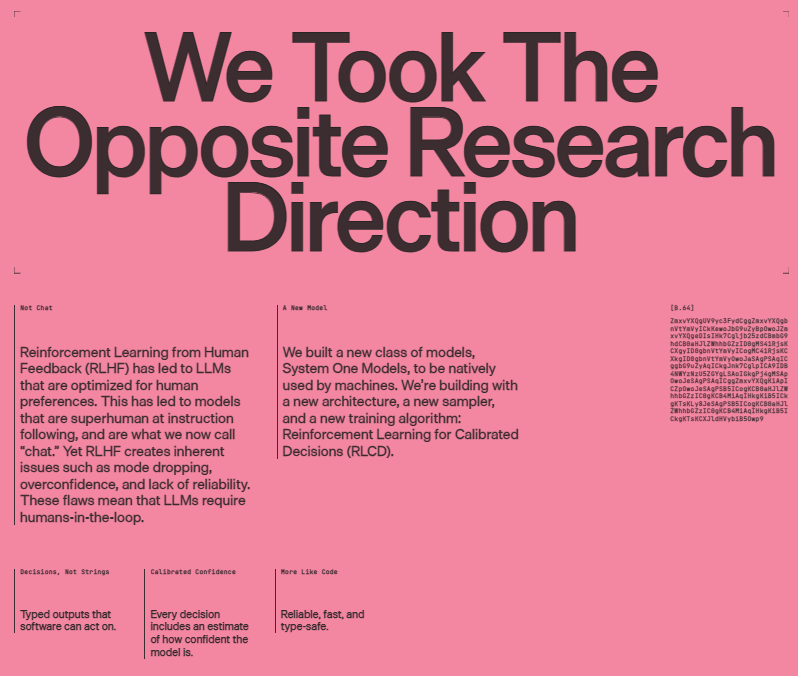
Jev는 GPT, Claude, Gemini처럼 자연어 문장을 생성하는 모델이 아니다. TypeSafe가 새롭게 정의한 System One Model의 첫 번째 공개 모델로, 자연어나 프로그램의 상태를 입력받은 뒤 소프트웨어가 바로 사용할 수 있는 구조화된 판단과 확률을 반환하는 것이 핵심이다. TypeSafe는 이를 “unstructured state in, typed probabilistic decisions out”이라는 방식으로 설명한다.
쉽게 표현하면 다음과 같다.
GPT가 말을 잘하는 AI라면, Jev는 판단을 빠르게 내리는 AI에 가깝다.
이 글에서는 Jev가 정확히 무엇인지부터 시작해, 왜 갑자기 주목받고 있는지, Jev 관련 개념들과 개인 관심 분야와의 연결까지 정리한다.
1. Jev란?
1.1 Jev라는 이름은 어디서 왔을까?
System One이라는 이름은 Daniel Kahneman이 대중화한 System 1 / System 2 사고 구분에서 왔다.
System 1은 빠르고 직관적인 판단을, System 2는 느리고 숙고하는 reasoning을 의미한다.
TypeSafe는 여기에서 빠르고 focused된 judgment라는 부분을 가져와 System One Model이라고 이름 붙였다.
그리고 Jev라는 이름은 경제학자 William Stanley Jevons에서 따왔다.
이는 Jevons Paradox와 연결된다.
효율성이 증가해서 자원 사용 비용이 낮아지면 반드시 자원 소비가 감소하는 것이 아니라, 새로운 사용처가 늘어나면서 오히려 전체 소비가 증가할 수 있다는 아이디어다.
TypeSafe의 가설도 비슷하다.
AI judgment cost
       ↓

사용할 수 있는 영역
       ↑

전체 AI decision 호출량 ↑
즉,
AI intelligence의 가격을 충분히 낮추면 지금까지 AI를 사용할 생각조차 하지 않았던 작은 판단들까지 AI가 담당하게 된다.
는 것이다.
TypeSafe는 Jev의 이름에 이런 방향성을 담았다고 설명한다.
1.2 GPT와 Jev의 가장 큰 차이
일반적인 LLM은 기본적으로 다음 token을 계속 예측하면서 문장을 생성한다.
Input
  ↓
Token prediction
  ↓
Token
  ↓
Token
  ↓
Token
  ↓
Generated text
따라서 GPT에게 고객 문의를 보여주고
"이 고객의 문의를 분석해줘."
라고 요청하면 다음과 같은 텍스트를 생성할 수 있다.
이 고객은 중복 결제 문제를 경험하고 있으며
환불을 요청하고 있습니다.
긴급성이 비교적 높은 문의로 판단됩니다.
하지만 실제 소프트웨어가 필요한 것은 이런 설명문이 아닐 수도 있다.
예를 들어 고객지원 시스템 입장에서는 다음과 같은 정보가 더 유용하다.
department = billing
refund_requested = 0.94
urgency = high
Jev는 애초부터 이런 machine-readable decision을 만들기 위해 설계됐다.
TypeSafe가 설명하는 System One Model의 기본 구조는 다음과 같다.
state + question
        ↓
       Jev
        ↓
typed decision + probability
즉,
GPT = 생성이 기본이고 판단 결과를 그 안에서 추출하는 방식
이라면,
Jev = 판단 자체가 기본 출력인 방식
이라고 볼 수 있다.
1.3 Jev의 세 가지 판단 primitive
현재 TypeSafe는 Jev의 질문 유형을 Choice, Score, Noul 세 가지로 정의한다.
| Primitive | 질문 형태 | 예시 |
|---|---|---|
| Choice | 여러 선택지 중 무엇인가? | billing / technical / account |
| Score | 어느 정도인가? | 고객 불만 수준 0~2 |
| Noul | 이 명제가 참인가? | 환불을 요청했는가? → 0.95 |
Choice
예를 들어 고객 문의를 어느 부서로 보내야 하는지 판단한다.
billing       0.82
technical     0.12
account       0.06

→ choice = billing
Choice는 하나의 답만 반환하는 것이 아니라 선택지별 probability distribution과 confidence도 함께 제공할 수 있다.
Score
사용자가 정의한 level별 확률을 바탕으로 계산한 위치값이다. 따라서 1.4는 1과 2 사이의 실제 물리적 정도라기보다 두 level 사이에 판단이 분산된 결과로 해석해야 한다.
예를 들어 고객 frustration을
0 = calm
1 = frustrated
2 = very frustrated
라고 정의하고 Jev가
score = 1.4처럼 판단할 수 있다.
Noul
Yes/No 질문에서는 확률 자체가 출력이다.
예를 들어
"이 고객은 환불을 요청했는가?"라는 질문에
noul = 0.95가 반환됐다면 Yes에 0.95의 probability가 배정됐다는 뜻이다.
TypeSafe는 Noul에서 1에 가까우면 강한 Yes, 0에 가까우면 강한 No, 0.5에 가까울수록 불확실한 상태라고 설명한다.
2. Jev의 핵심 철학: 큰 질문 하나보다 작은 판단 여러 개
Jev의 중요한 특징은 복잡한 reasoning을 한 번에 시키기보다 작고 독립적인 판단으로 분해한다는 것이다.
예를 들어 스타트업을 평가하면서
"이 스타트업은 좋은 투자인가?"라고 한 번에 묻기보다는,
시장 규모는 충분한가?
기술적으로 실현 가능한가?
경쟁사와 차별화되어 있는가?
처럼 작은 판단으로 나눈다.
각각의 결과를 받은 뒤 실제 최종 판단은 코드에서 조합한다.
TypeSafe 역시 공식 문서에서 복합적인 판단을 하나의 질문으로 만들기보다 atomic question으로 나누고 결과를 코드에서 조합하는 방식을 권장한다.
예를 들어,
market_size          → 0.91
technical_feasibility → 0.76
differentiation       → 0.83
을 얻은 후 프로그램이
final_score
= 0.4 × market_size
+ 0.3 × technical_feasibility
+ 0.3 × differentiation
처럼 조합할 수 있다.
이 때문에 Jev를 이해하는 좋은 비유가 하나 있다.
2.1 Jev는 ‘semantic if statement’에 가깝다
일반 프로그램에서는 다음과 같은 조건을 쉽게 만들 수 있다.
if price > 100:
    ...
숫자로 표현할 수 있기 때문이다.
하지만 다음과 같은 조건은 전통적인 코드만으로 표현하기 어렵다.
if 고객이 화가 난 것 같다면
if 이 검색결과가 질문과 관련 있다면
if 이 문서가 주장을 실제로 뒷받침한다면
if 이 행동이 수상하다면
Jev가 노리는 영역이 바로 이런 semantic condition이다.
즉,
자연어 / 프로그램 state
          ↓
         Jev
          ↓
P(condition)
          ↓
         code
          ↓
     if / routing
구조를 만드는 것이다.
그래서 Jev를 일종의 “똑똑한 if문”이라고 이해하면 꽤 직관적이다.
3. 그렇다면 GPT의 Structured Output과 뭐가 다른가?
여기서 자연스럽게 생기는 질문이 있다.
GPT에게 JSON으로 대답하라고 하면 똑같은 것 아닌가?
실제로 LLM에게도 다음과 같이 요청할 수 있다.
{
  "department": "billing",
  "refund_requested": true,
  "confidence": 0.91
}
기능적으로는 상당 부분 비슷한 결과를 만들 수 있다.
하지만 두 모델이 무엇을 위해 최적화됐느냐가 다르다.
일반적인 LLM
input
  ↓
next-token generation
  ↓
text
  ↓
structured-output constraint
  ↓
decision
Jev
state
  ↓
decision model
  ↓
typed probability distribution
TypeSafe는 System One Model이 미리 정의한 answer space 안에서 type-safe한 값을 반환하도록 만들었으며, Jev의 모든 질문은 동일한 state를 보고 독립적으로 평가된다. 또한 여러 질문을 한 request에서 병렬 평가할 수 있다.
즉 Jev는 텍스트를 잘 만든 다음 구조화를 하는 모델이 아니라, 애초부터 구조화된 판단 자체를 만들기 위해 설계된 모델이라는 것이 TypeSafe의 주장이다.
4. Jev가 갑자기 주목받는 이유
4.1 이유 ① 속도
Agent를 생각해보면 작은 판단이 계속 발생한다.
현재 페이지가 원하는 페이지인가?
        ↓
어떤 버튼을 눌러야 하는가?
        ↓
로그인이 필요한가?
        ↓
검색 결과가 충분한가?
        ↓
이 링크가 relevant한가?
        ↓
추가 검색이 필요한가?
이 판단마다 큰 reasoning LLM을 호출하면 latency가 계속 누적된다.
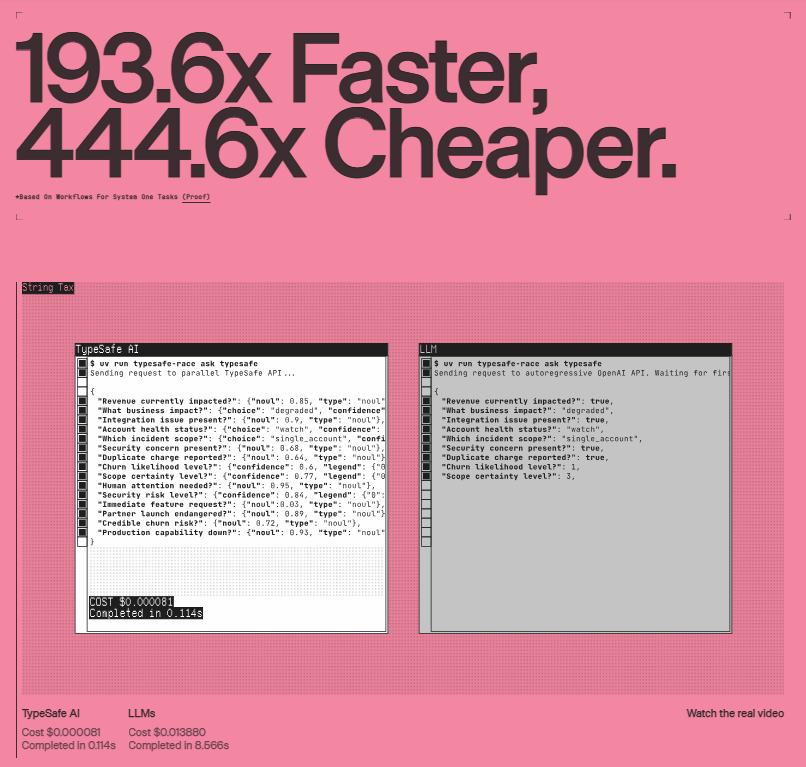
Jev는 텍스트를 token-by-token으로 생성하는 대신 여러 decision을 병렬로 평가하는 구조를 사용한다.
TypeSafe의 자체 workflow 실험에서는 특정 System One workflow에서 기존 LLM 대비 193.6배 빠르고 444.6배 저렴했다고 보고한다. 다만 이 수치는 TypeSafe 자체 benchmark이므로 독립적으로 확정된 일반적 성능 차이라고 받아들이기보다는 회사의 측정 결과로 보는 것이 적절하다.
공식 문서 역시 동일한 state에 대한 여러 질문을 한 request에서 병렬로 처리하도록 설계되어 있다고 설명한다.
4.2 이유 ② 매우 낮은 비용
2026년 9월 21일 기준 Jev 1.13의 공식 가격은
$0.042 / 1M input tokens
= $42 / 1B input tokens

output token = 무료
이다.
Context length는 최대 64k이며 text input만 지원한다.
이 가격 구조의 의미는 단순히 “LLM보다 싸다”가 아니다.
AI 판단을 특별한 기능으로 한두 번 사용하는 것이 아니라 소프트웨어 곳곳에서 매우 자주 호출하는 primitive로 만들려는 것에 가깝다.
4.3 이유 ③ Agent와 궁합이 좋다
기존 Agent는 흔히 다음과 같이 동작한다.
LLM
 ↓
생각
 ↓
Tool 호출
 ↓
결과 확인
 ↓
LLM
 ↓
다음 판단
 ↓
Tool 호출
 ↓
...
모든 판단에 강한 LLM을 사용하면 비용과 latency뿐 아니라 context 증가 문제도 발생한다.
Jev가 제안하는 구조는 오히려 다음과 가깝다.
                ┌─ deterministic code
                │
Input → workflow├─ Jev: 작은 판단
                ├─ Jev: 작은 판단
                ├─ Jev: 작은 판단
                │
                └─ Reasoning LLM
                   정말 어려운 문제만
즉,
모든 것을 Agent에게 맡기는 것
이 아니라
코드가 control flow를 담당하고, AI가 필요한 semantic judgment만 수행하는 구조
다.
Jev의 output을 deterministic check와 조합하고, Choice·Score는 confidence를, Noul은 Yes 확률 자체를 기준으로 임계값을 설정해 자동 처리·추가 검증·사람 검토로 라우팅할 수 있다.
실제로 출시 직후 개발자들은 Jev를 브라우저 Agent의 action 선택, Claude Code model routing 및 context 관련 도구, Agent 평가, 광고 분석 등에 연결하는 실험을 진행했다. 9월 20일 보도에서는 실시간 광고 분석, Claude Code context 처리, Agent task 검증, 브라우저 Agent 행동 결정 등의 사례가 소개됐다.
Vercel은 Jev가 AI Gateway에 추가된 뒤 24시간 동안 유료 팀의 약 13%가 사용했으며, 자사 Gateway 역사상 가장 빠르게 채택된 모델 출시였다고 발표했다. 물론 초기 사용량과 장기적인 모델 활용성은 별개의 문제다.
5. Jev에서 가장 중요한 부분: 확률을 반환한다
Jev의 특징 중 하나는 단순히
YES라고 답하는 것이 아니라,
YES = 0.90
NO  = 0.10
처럼 probability를 반환한다는 것이다.
그런데 여기서 0.90의 의미를 정확하게 이해해야 한다.
5.1 0.90은 “90%만큼 관련 있다”가 아니다
예를 들어 Jev에게
이 검색 문서는 사용자의 질문과 관련 있는가?
라고 묻고
Yes = 0.90을 얻었다고 하자.
이것을
“문서가 90% 정도 관련 있다.”
라고 해석하면 정확하지 않다.
TypeSafe가 목표로 하는 calibration 관점에서는
모델이 약 0.9라는 확률을 부여하는 유형의 문제들을 모았을 때, 실제 outcome도 약 90% 정도 맞도록 확률을 학습한다
는 의미에 가깝다.
System One 공식 문서는 모델의 probability를 실제 outcome과 맞도록 최적화하여 uncertainty를 반영하는 것을 calibration이라고 설명한다.
6. Calibration이란 무엇인가?
가상의 AI 모델이 100개의 문제에 대해 모두
P(Yes) = 0.90이라고 예측했다고 생각해보자.
실제 결과를 확인했더니
Yes = 60개
No  = 40개
였다면 모델은
예측 confidence = 90%
실제 accuracy    = 60%
인 셈이다.
즉 지나치게 자신만만한 모델, overconfident한 모델이다.
반대로 calibration이 잘 된 모델이라면 대략 다음과 같은 관계가 나타나야 한다.
confidence ≈ 0.9인 문제
→ 실제 약 90% 정답

confidence ≈ 0.7인 문제
→ 실제 약 70% 정답

confidence ≈ 0.5인 문제
→ 실제 약 50% 정답
중요한 점은 calibration이 개별 문제에 대한 보장이 아니라는 것이다.
Jev가 어떤 한 문제에 대해
0.83이라고 했다고 해서
“이 답이 정확히 83% 확률로 참이다.”
라고 검증할 방법은 없다.
대신 비슷한 확률을 받은 문제들을 많이 모아서 확인한다.
confidence 약 0.85인 문제 10,000개
                 ↓
         실제 outcome 확인
                 ↓
        정답 8,470개
                 ↓
       실제 accuracy 84.7%
라면
predicted probability ≈ 85%
actual frequency       ≈ 84.7%
가 되므로 calibration이 꽤 잘 맞는다고 볼 수 있다.
TypeSafe 역시 calibration은 prediction group을 대상으로 측정되는 통계적 성질이며 개별 prediction의 correctness를 보장하지 않는다고 명시한다.
7. Accuracy와 Calibration은 서로 다른 개념이다
예를 들어 두 모델을 생각해보자.
모델 A
전체 accuracy = 90%

하지만 모든 문제에
confidence = 99%
정확도 자체는 높더라도 probability가 실제 성공률과 맞지 않는다면 calibration은 좋지 않을 수 있다.
모델 B
쉬운 문제
confidence ≈ 98%
실제 accuracy ≈ 98%

애매한 문제
confidence ≈ 60%
실제 accuracy ≈ 60%
이 모델은 자신의 uncertainty를 훨씬 잘 표현한다.
자동화 시스템에서는 이것이 매우 중요하다.
단순히
“모델이 얼마나 자주 맞느냐?”
뿐 아니라,
“모델이 틀릴 가능성이 높은 상황을 스스로 어느 정도 구별할 수 있느냐?”
가 중요하기 때문이다.
8. 그러면 Jev의 확률은 어떻게 학습한 것일까?
TypeSafe는 이를 위해 RLCD(Reinforcement Learning for Calibrated Decisions)라는 새로운 training method를 사용한다고 발표했다.
기존 방식과 비교하면 TypeSafe는 다음과 같이 설명한다.
| 학습 방식 | 주요 목표 |
|---|---|
| RLHF | 사람이 선호하는 답변 |
| RLVR | 검증 가능한 정답에 대한 reward |
| RLCD | calibrated decision과 epistemically honest probability |
즉 RLCD의 목표는 단순히 정답을 많이 맞히는 것이 아니라,
모델이 실제로 얼마나 확신할 수 있는지를 probability에도 반영하도록 학습하는 것
이다.
다만 매우 중요한 한계가 있다.
8.1 RLCD의 상세 학습 recipe는 아직 공개되지 않았다
현재 TypeSafe가 공개한 것은 RLCD의 목표와 개념이다.
정확히 어떤 reward function을 사용하는지, 어떤 loss와 결합하는지, calibration dataset을 어떻게 구성하는지, reward signal을 어떻게 생성하는지 등 전체 알고리즘이 공개된 상태는 아니다.
따라서
“RLCD는 정확히 이런 식으로 probability를 계산한다.”
라고 단정해서는 안 된다.
8.2 직관적으로 이해하는 방법
다음은 RLCD의 실제 구현을 설명하는 것이 아니라, calibrated probability 학습이 어떤 목표를 갖는지를 이해하기 위한 예시다.
정답이 Yes인 문제가 있다고 하자.
모델 A
Yes = 0.99정답도 맞았고 자신감도 높다.
모델 B
Yes = 0.55맞기는 했지만 uncertainty가 크다.
모델 C
Yes = 0.10
No  = 0.90
틀렸을 뿐 아니라 매우 자신 있게 틀렸다.
단순 classification accuracy만 보면 A와 B는 둘 다 정답이다.
A → 1점
B → 1점
C → 0점
하지만 probability quality를 학습하려면 A와 B를 동일하게 취급할 수 없고, 특히 자신 있게 틀리는 C에 큰 penalty를 주는 구조가 필요하다.
9. 이런 아이디어 자체는 기존 머신러닝에도 존재한다
Calibration 자체가 Jev에서 처음 등장한 개념은 아니다.
전통적인 probability prediction에서도 cross-entropy / log loss, Brier score 등 probability의 quality를 평가하는 방법들이 존재한다.
예를 들어 실제 정답이 Yes일 때
P(Yes) = 0.9라면 log loss는
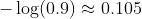
이다.
반면 실제 정답이 Yes인데 모델이
P(Yes) = 0.1이라고 했다면
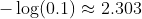
으로 훨씬 큰 penalty를 받는다.
이와 관련된 중요한 개념이 proper scoring rule이다.
적절히 설계된 scoring rule은 모델이 자신이 믿는 probability를 과장하거나 축소하기보다 정직하게 보고하는 것이 기대 reward를 최대화하도록 만들 수 있다.
따라서 Jev의 새로움은 “확률 calibration이라는 아이디어를 처음 만들었다”가 아니다.
TypeSafe가 주장하는 차별점은
모델 자체를 처음부터 typed decision + calibrated probability에 최적화하고, 이를 위한 별도의 RL training methodology인 RLCD와 새로운 model architecture·sampler를 함께 개발했다
는 것이다.
10. 확률을 반환하면 무엇이 좋은가?
가장 큰 장점 중 하나는 confidence-aware routing이 가능하다는 것이다.
예를 들어 웹 검색 결과가 실제 evidence인지 판단한다고 해보자.
Document A → 0.98
Document B → 0.94
Document C → 0.81
Document D → 0.52
Document E → 0.21
프로그램을 다음과 같이 설계할 수 있다.
p > 0.90
→ 자동으로 evidence 후보로 사용

0.60 < p ≤ 0.90
→ 강한 reasoning model에게 검증 요청

p ≤ 0.60
→ 제외 또는 보류
즉
Jev
 ↓
uncertainty 확인
 ↓
 ┌──────────────┬───────────────┐
 │             │               │
high          medium           low
 │              │               │
자동 처리    reasoning LLM     reject
같은 계층형 AI 시스템을 만들 수 있다.
TypeSafe 역시 confidence threshold를 설정해 자동 처리할 경우와 human/reasoning model에게 escalation할 경우를 구분하는 방식을 System One의 주요 활용법으로 설명한다.
11. 여러 probability를 조합할 수도 있다
하나의 문서에 대해 질문을 하나만 할 필요도 없다.
예를 들어 검색 결과에 대해 다음과 같이 판단할 수 있다.
Q1. 질문과 관련 있는가?
→ relevance = 0.96

Q2. 해당 claim을 실제로 뒷받침하는가?
→ support = 0.84

Q3. 출처가 신뢰할 만한가?
→ credibility = 0.91

Q4. 다른 evidence와 충돌하는가?
→ contradiction = 0.13
그다음 이 값을 코드에서 조합한다.
relevance ─────┐
support ───────┼──→ Evidence Score
credibility ───┤
contradiction ─┘
이것이 Jev의 중요한 설계 철학이다.
복잡한 judgment를 하나의 AI에게 통째로 맡기는 대신, 독립적인 semantic judgment들로 분해하고 최종 의사결정은 명시적인 프로그램에서 수행한다.
TypeSafe의 workflow eval 역시 작업을 programmatic rule과 narrow intelligent judgment로 분해하고 Choice·Score·Noul 결과를 코드에서 조합하는 방식을 사용한다.
다만 서로 다른 Jev 질문의 probability를 하나의 논리적으로 완벽한 확률 체계처럼 해석해서는 안 된다. 각 질문은 같은 state를 기준으로 독립적으로 평가되므로, 서로 보완 또는 부정 관계처럼 보이는 질문이라도 결과가 정확히 합쳐서 1이 된다는 보장은 없다.
예를 들어 supports_claim과 contradicts_claim을 별도 질문으로 만들었다면, 두 값이 동시에 높거나 낮게 나올 수 있다. 따라서 Jev의 결과는 최종 결론 자체라기보다 코드·규칙·constraint가 처리할 수 있는 probabilistic signal로 사용하는 것이 적절하다. 상호 배타성, 모순 해결, 최종 승인 조건은 deterministic code나 rule engine에서 명시적으로 관리해야 한다.
12. JEV를 직접 사용해 보자 : TypeSafe AI Playground 실험
TypeSafe는 Jev를 API뿐 아니라 웹 기반 Playground를 통해 실험할 수 있도록 제공하고 있다. Jev는 아직 초기 공개 단계이므로 접근 가능 여부나 인터페이스는 계정에 따라 달라질 수 있다. TypeSafe 역시 공식 발표에서 Jev를 early access 형태로 공개했다고 설명한다.
이번에는 가장 이해하기 쉬운 Noul primitive를 이용해 다음 질문을 실험해봤다.
“고객이 명시적으로 환불을 요청했는가?”
핵심은 단순히 한 번 실행해보는 것이 아니라, 질문과 판단 기준은 그대로 두고 입력 문장만 조금씩 바꿔 보는 것이다.
이렇게 하면 Jev가 semantic difference와 uncertainty를 probability에 어떻게 반영하는지 직접 확인할 수 있다.
12.1 먼저 State를 입력한다
Playground에서 Jev가 판단할 대상은 state 형태로 제공한다.
예를 들어 고객이 다음과 같이 말했다고 하자.
{
  "example_state": "Please refund the duplicate charge."
}
여기서 중요한 것은 example_state라는 이름 자체가 아니라 그 안에 들어 있는 판단 대상 정보다.
즉 Jev는 대략 다음 구조로 동작한다고 생각하면 된다.
State
"Please refund the duplicate charge."
              +
Question
"Does the customer explicitly request a refund?"
              ↓
             Jev
              ↓
True / False probability
13. Noul 질문 직접 만들어보기
Playground에서 Noul 질문을 만들면 다음과 같은 형태의 설정을 볼 수 있다.
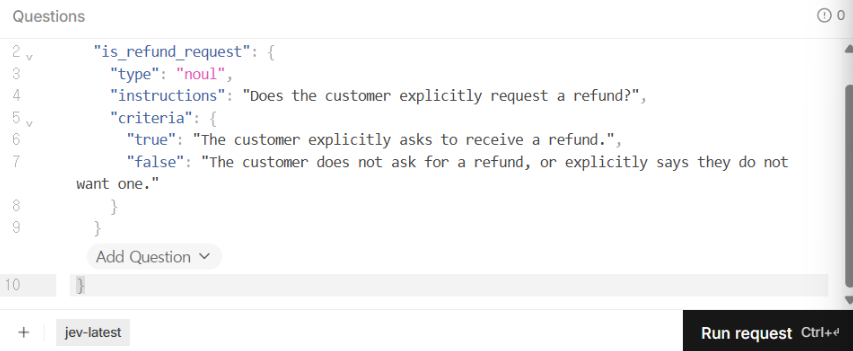
각 요소의 의미를 하나씩 살펴보자.
13.1 is_refund_request
"is_refund_request"이 질문의 key 또는 이름이다.
쉽게 말해 변수명처럼 생각하면 된다.
프로그램에서는 이후 이 판단 결과를
is_refund_request라는 이름으로 식별할 수 있다. 질문의 목적에 따라 다음처럼 이름을 만들 수도 있다.
is_relevant
is_spam
is_trustworthy
supports_claim
requires_escalation
즉 사람이 결과를 봤을 때 무엇을 판단한 값인지 바로 알 수 있도록 이름을 붙이는 것이 좋다.
13.2 type: "noul"
"type": "noul"어떤 종류의 판단을 수행할지를 지정한다.
noul은 Yes / No 형태의 명제 판단에 사용한다.
예를 들어,
이 고객은 환불을 요청했는가?
이 검색 결과는 질문과 관련 있는가?
이 문서는 해당 claim을 뒷받침하는가?
이 메시지는 긴급한가?
처럼 참/거짓 형태로 표현할 수 있는 semantic judgment에 적합하다.
결과는 단순한 True 또는 False만이 아니라 각 판단에 대한 probability로 나타난다.
13.3 instructions
"instructions": "Does the customer explicitly request a refund?"Jev에게 무엇을 판단해야 하는지 알려주는 실제 질문이다.
이번 실험에서는
고객이 명시적으로 환불을 요청했는가?
라는 질문을 사용했다.
여기서 explicitly라는 단어가 중요하다.
우리가 알고 싶은 것이
고객이 환불을 원할 것 같은가?
가 아니라
실제로 환불을 요청했는가?
이기 때문이다.
작은 문구 차이가 decision boundary를 바꿀 수 있다.
13.4 criteria.true
"true": "The customer explicitly asks to receive a refund."어떤 상태를 True라고 판단할지 정의하는 기준이다.
이번 예에서는
고객이 명시적으로 환불을 요청하면 True
라고 정의했다.
예를 들면 다음 문장은 True에 해당한다.
"Please refund the duplicate charge."13.5 criteria.false
"false": "The customer does not ask for a refund, or explicitly says they do not want one."반대로 어떤 상태를 False라고 판단할지 정의한다.
예를 들어,
"I don't want a refund."이나 단순히
"I was charged twice."라고 문제만 설명한 경우는 이 기준에 따르면 False에 가까워진다.
즉 구조를 정리하면 다음과 같다.
instructions
= 무엇을 판단할 것인가?

criteria.true
= 어떤 경우를 True라고 할 것인가?

criteria.false
= 어떤 경우를 False라고 할 것인가?
criteria는 특히 애매한 semantic judgment에서 중요하다.
모델에게 Yes/No 질문만 던지는 것이 아니라 판단 기준 자체를 명시적으로 지정할 수 있기 때문이다.
14. 실험 1: 명백한 환불 요청
먼저 매우 명확한 문장을 넣어봤다.
{
  "example_state": "Please refund the duplicate charge."
}
질문은 그대로 유지한다.
Does the customer explicitly request a refund?그리고 판단 기준도 그대로다.
True
→ The customer explicitly asks to receive a refund.

False
→ The customer does not ask for a refund,
   or explicitly says they do not want one.
Playground의 결과는 다음과 같았다.
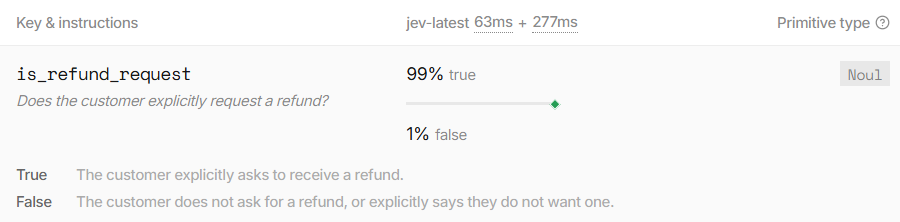
즉 Jev는 이 문장에 대해 P(True) = 0.99를 할당했다.
문장 자체에
"Please refund ..."라는 직접적인 요청이 있기 때문에 우리가 설정한 True criterion과 매우 잘 일치한다.
15. 실험 2: 환불에 관심은 있지만 요청하지 않은 경우
이번에는 조금 더 애매하게 만들어봤다.
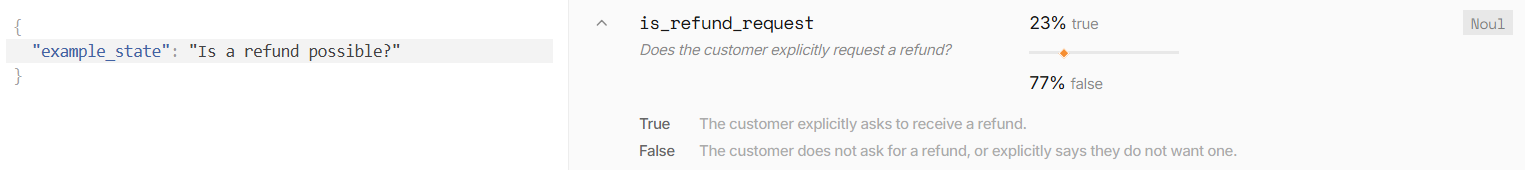
첫 번째 사례와 비교하면 상당히 달라졌다.
"Please refund the duplicate charge."
→ True 99%

"Is a refund possible?"
→ True 23%
왜 이런 차이가 발생했을까?
Is a refund possible?은 분명 refund에 관한 문장이다.
하지만 현재 질문은
"환불과 관련된 이야기를 하는가?"가 아니다.
질문은 정확히
"Does the customer explicitly request a refund?"이다.
즉,
Is a refund possible?
        │
        ├─ 환불에 관심이 있는가?        → Yes
        ├─ 환불 가능 여부를 묻는가?      → Yes
        └─ 환불을 명시적으로 요청했는가? → 대체로 No
가 된다.
그래서 Jev가 False 쪽에 더 높은 probability를 할당했다고 해석할 수 있다.
그렇다고 True가 0%가 된 것은 아니다.
Is a refund possible?이라는 표현은 실제 대화에서 환불 의향을 간접적으로 드러내는 표현일 가능성도 있기 때문이다.
이런 사례가 바로 Jev에서 probability를 사용하는 이유를 보여준다.
16. 실험 3: 환불이라는 단어조차 없는 경우
다음에는 다음 문장을 넣었다.

이 문장을 읽은 사람은 자연스럽게 다음과 같이 추론할 수 있다.
두 번 결제됐다
      ↓
중복 결제 문제다
      ↓
하나는 환불받아야 하지 않을까?
하지만 이것은 추론된 의도다.
고객이 실제로 말한 것은
"I was charged twice."뿐이다.
고객은 아직
"Refund it."이라고 하지 않았다.
따라서 현재 우리가 만든 판단 기준에서는
문제가 있음                      ✓
중복 결제임                      ✓
환불이 필요할 가능성이 있음        ✓

환불을 '명시적으로 요청'했는가?    ✕
가 된다.
그래서 Jev가 False에 93%를 부여한 것으로 해석할 수 있다.
17. 세 결과를 비교하면 Jev의 특징이 더 잘 보인다
실험 결과를 한 번에 비교하면 다음과 같다.
| State | True | False | 해석 |
|---|---|---|---|
Please refund the duplicate charge. | 99% | 1% | 명백한 환불 요청 |
Is a refund possible? | 23% | 77% | 환불을 문의하지만 직접 요청하지는 않음 |
I was charged twice. | 7% | 93% | 결제 문제만 설명했으며 환불 요청은 없음 |
여기서 재미있는 부분은 refund라는 단어의 존재 여부만으로 판단하지 않았다는 점이다.
"Please refund the duplicate charge."
        │
        └─ explicit request
                 ↓
              99% True


"Is a refund possible?"
        │
        └─ refund 언급은 있지만 inquiry
                 ↓
              23% True


"I was charged twice."
        │
        └─ 문제가 있지만 refund request 없음
                 ↓
               7% True
즉 이번 작은 실험에서는 Jev가 단순한 keyword matching보다 우리가 정의한 semantic condition과 입력 문장의 관계를 평가하는 것처럼 동작하는 모습을 확인할 수 있었다.
다만 세 개 사례만으로 모델의 일반적인 성능을 입증할 수 있는 것은 아니다.
18. 여기서 23%와 7%는 정확히 무엇을 의미할까?
이 부분을 잘못 이해하기 쉽다.
Is a refund possible?에 대해
True = 23%가 나왔다고 해서
“이 고객이 실제로 환불을 요청했을 확률이 객관적으로 정확히 23%다.”
라고 해석해서는 안 된다.
더 정확하게 표현하면,
현재 제공된 state, question, criteria를 바탕으로 Jev가 True에 0.23의 probability를 할당했다.
는 의미다.
마찬가지로
"I was charged twice."

True = 7%
도
현실 세계에서 이 고객이 환불을 원할 확률이 7%
라는 뜻이 아니다.
우리가 Jev에게 질문한 것은 고객의 숨은 심리나 미래 행동이 아니라
“이 문장에서 고객이 명시적으로 환불을 요청했는가?”
이기 때문이다.
따라서 Jev의 probability는 항상 어떤 질문과 criteria를 정의했는가와 함께 해석해야 한다.
19. Playground 실험만으로 Calibration을 증명할 수 있을까?
여기에도 중요한 구분이 있다.
우리가 이번 실험에서 확인한 것은
입력의 의미와 애매함이 달라질 때 Jev가 서로 다른 probability를 반환한다.
는 것이다.
하지만 이것만으로
Jev의 23%라는 확률이 실제로 정확하게 calibrated되어 있다.
고 결론 내릴 수는 없다.
Calibration은 한 문제로 검증하는 성질이 아니기 때문이다.
예를 들어 Jev가 여러 데이터에 대해 True ≈ 20%를 반환했다고 해보자.
True probability ≈ 20%인 사례
          ↓
        1,000개 수집
          ↓
Ground Truth와 비교
          ↓
실제로 약 200개가 True인가?
이렇게 같은 probability 구간에 속하는 많은 prediction을 모아서 실제 outcome frequency와 비교해야 calibration을 평가할 수 있다.
따라서 Playground에서
23%
7%
99%
가 나오는 것을 보는 것은 Jev의 uncertainty 표현을 이해하는 데는 유용하지만, calibration 성능 자체를 검증하는 실험은 아니다.
20. Jev를 제대로 체험하려면 이렇게 실험해보자
한 문장만 넣어서 결과를 보는 것보다 하나의 변수만 바꿔가면서 비교하는 방식이 훨씬 유용하다.
20.1 실험 A: State만 바꾼다
먼저 Question과 Criteria는 완전히 고정한다.
Question:
Does the customer explicitly request a refund?

True:
The customer explicitly asks to receive a refund.

False:
The customer does not ask for a refund,
or explicitly says they do not want one.
그리고 State만 단계적으로 바꾼다.
A. "Please refund the duplicate charge."
B. "I would like a refund."
C. "I'm considering asking for a refund."
D. "Is a refund possible?"
E. "I was charged twice."
F. "I don't want a refund."
그다음 각 문장의 probability를 기록해서 비교한다.
이 실험의 목적은 semantic ambiguity가 바뀌면서 probability가 어떤 식으로 움직이는지 확인하는 것이다.
명시적으로 환불을 요청하는 문장에서 시작해서, 점점 애매한 표현을 거쳐 명시적으로 환불을 거절하는 문장까지 바꿔보면 Jev의 decision boundary를 직관적으로 관찰할 수 있다.
20.2 실험 B: State는 그대로 두고 Criteria만 바꾼다
오히려 이 실험이 Jev의 특성을 이해하는 데 더 재미있을 수 있다.
State를 고정한다.
"Is a refund possible?"첫 번째 criteria는 다음과 같다.
True:
The customer explicitly asks to receive a refund.
우리 실험에서는 이때
True = 23%가 나왔다.
이번에는 True criterion을 바꿔본다.
True:
The customer expresses an intention or interest
in receiving a refund.
이 경우에는 같은 문장이라도 True probability가 달라질 가능성이 있다.
왜냐하면 판단 대상이
명시적인 환불 요청에서
환불에 대한 의향이나 관심으로 바뀌었기 때문이다.
이 실험이 중요한 이유는 Jev의 decision이 단순히
state → classification만으로 결정되는 것이 아니라,
              State
                +
             Question
                +
             Criteria
                ↓
              Jev
                ↓
       Typed Probabilistic Decision
이라는 것을 체감할 수 있기 때문이다.
20.3 실험 C: 경계 사례를 만들어본다
Jev를 시험할 때는 명백한 사례보다 애매한 사례를 일부러 만드는 것이 더 재미있다.
예를 들어 다음과 같은 문장을 넣어볼 수 있다.
"Could I maybe get my money back?"
"What options do I have if I want my money back?"
"I'm not sure whether I should ask for a refund."
"If this isn't fixed, I'll ask for a refund."
"I need this fixed, not refunded."
"Why haven't I received my refund yet?"
여기서는 단순히 결과가 맞았는지만 보는 것보다,
어떤 표현에서 confidence가 떨어지고, 어떤 semantic distinction에 민감하게 반응하는가?
를 관찰하는 것이 더 중요하다.
예를 들어 "Why haven't I received my refund yet?"는 새롭게 환불을 요청하는 문장은 아니지만, 이미 환불이 진행 중이라는 강한 정보를 담고 있다.
이처럼 단순한 keyword 여부로 처리하기 어려운 경계 사례를 넣어보는 것이 Jev를 이해하는 데 더 좋은 실험이 된다.
21. 다음 단계: 환불 문제가 아닌 실제 AI Agent 문제로 확장하기
Noul의 동작을 이해했다면 더 흥미로운 실험으로 넘어갈 수 있다.
특히 Web Research Agent를 염두에 두면 다음과 같은 질문을 만들 수 있다.
21.1 Search Relevance
다음과 같은 Noul을 정의할 수 있다.
Key:
is_relevant

Instructions:
Does this document directly address the user's question?

True:
The document contains information directly relevant
to answering the user's question.

False:
The document is unrelated or only tangentially related.
State에는 사용자의 질문과 검색 결과를 함께 넣는다.
User question:
"When is GraphRAG more useful than vanilla RAG?"

Search result:
"GraphRAG constructs entity-relation graphs and can support reasoning across connected information."
이 경우 Jev가 얼마나 높은 relevance probability를 주는지 확인할 수 있다.
이런 구조를 활용하면 Web Search Agent가 검색한 수많은 문서를 모두 reasoning LLM에게 넘기기 전에 1차적으로 relevant한 문서만 필터링하는 용도를 생각해볼 수 있다.
21.2 Evidence Support
더 재미있는 예시는 claim과 evidence의 관계를 판단하는 것이다.
State:
Claim:
GraphRAG performs better than vanilla RAG
on every dataset.

Evidence:
GraphRAG achieved higher accuracy than vanilla RAG
on one multi-hop QA dataset.
Question:
Does this evidence sufficiently support the entire claim?여기서 중요한 포인트는
특정 데이터셋에서 우수함과
모든 데이터셋에서 우수함이 논리적으로 같지 않다는 것이다.
따라서 Jev가 단순 keyword similarity를 보는 것이 아니라 claim과 evidence 사이의 의미적·논리적 관계를 얼마나 잘 판단하는지 살펴볼 수 있다.
21.3 여러 판단으로 하나의 문서를 분해해보기
문서 하나에 대해 질문을 하나만 할 필요도 없다.
예를 들어 다음과 같이 여러 판단으로 분해할 수 있다.
is_relevant
→ 이 문서가 질문과 관련 있는가?

supports_claim
→ 이 문서가 claim을 실제로 뒷받침하는가?

is_credible
→ 이 출처를 신뢰할 만한가?

is_contradictory
→ 기존 evidence와 충돌하는가?
그러면 하나의 문서를 다음처럼 여러 개의 semantic judgment로 표현할 수 있다.
Document
   ↓
 ┌─ relevance     = 0.96
 ├─ support       = 0.81
 ├─ credibility   = 0.88
 └─ contradiction = 0.12
이 결과를 프로그램에서 다시 조합할 수 있다.
예를 들어,
relevance > 0.9
AND support > 0.8
AND credibility > 0.8
AND contradiction < 0.2
를 만족하는 문서만 최종 evidence 후보로 전달하는 식이다.
바로 이 부분이 Jev의 핵심 철학과 연결된다.
복잡한 판단 하나를 AI에게 통째로 맡기는 대신, 작은 semantic judgment들로 분해하고 그 결과를 코드에서 조합한다.
22. Playground를 통해 확인할 수 있었던 Jev의 핵심
직접 테스트해보면 Jev를 단순히
“Yes/No classifier인데 확률도 주는 모델”
이라고 이해하는 것만으로는 부족하다는 것을 알 수 있다.
더 중요한 구조는 다음과 같다.
Unstructured State
        +
Semantic Question
        +
Explicit Criteria
        ↓
       Jev
        ↓
Typed Probabilistic Decision
        ↓
      Software
이번 실험에서는 특히 세 가지를 확인할 수 있었다.
22.1 질문의 wording이 중요하다
다음 두 질문은 비슷해 보이지만 서로 다른 판단을 요구한다.
"Is this about a refund?""Does the customer explicitly request a refund?"첫 번째 질문은 단순히 환불과 관련된 내용인지 판단한다.
반면 두 번째 질문은 고객이 실제로 환불이라는 행동을 요청했는가를 판단한다.
따라서 "Is a refund possible?" 같은 문장도 첫 번째 질문에서는 높은 True probability가 나올 수 있지만, 두 번째 질문에서는 낮아질 수 있다.
22.2 Criteria가 decision boundary를 정의한다
다음 두 True criteria 역시 서로 다른 의미다.
The customer explicitly requests a refund.The customer shows interest in receiving a refund."Is a refund possible?"이라는 동일한 state를 넣더라도 두 기준에 대한 probability는 달라질 수 있다.
즉 Jev를 사용할 때 중요한 것은 단순히 무슨 데이터를 넣느냐만이 아니다.
State
+
Question
+
Criteria
를 어떻게 설계하는지가 실제 decision의 의미를 결정한다.
22.3 Probability는 단순한 True/False보다 많은 정보를 제공한다
이번 실험에서는 다음과 같은 결과를 얻었다.
"Please refund..."
→ 99%

"Is a refund possible?"
→ 23%

"I was charged twice."
→ 7%
만약 binary result만 사용했다면 대략 다음과 같이 보였을 수 있다.
True
False
False
그러면 두 번째와 세 번째 사례의 차이는 사라진다.
하지만 probability를 함께 보면,
23%
vs.
7%
이라는 uncertainty의 차이를 확인할 수 있다.
이 값을 실제 프로그램의 control flow에도 활용할 수 있다.
예를 들어,
P(True) > 0.90
→ 자동 처리

0.30 < P(True) ≤ 0.90
→ 추가 판단 또는 stronger model 호출

P(True) ≤ 0.30
→ False 경로 처리
처럼 설계할 수 있다.
즉 Jev의 probability는 단순히 화면에 confidence 숫자를 보여주기 위한 값이 아니라,
Jev
 ↓
probability
 ↓
threshold / rule
 ↓
 ┌─────────────┬─────────────┐
 ↓             ↓             ↓
자동 처리    추가 검증      제외
처럼 software의 다음 행동을 결정하는 값으로 사용할 수 있다.
결국 Playground를 통해 가장 직관적으로 확인할 수 있는 Jev의 특징은 다음과 같다.
Jev는 자연어를 보고 하나의 답변을 생성하는 대신, 우리가 정의한 semantic question과 criteria를 기준으로 판단하고 그 결과를 probability 형태로 프로그램에 전달한다.
그리고 바로 이 특성이 이후 살펴볼 다른 기술들과의 결합 지점에 대해 고민해 보게 만들었다.
23. “Jev는 hallucination이 없다”는 말은 어떻게 해석해야 할까?
TypeSafe는 Jev에 대해 “can't hallucinate”, 홈페이지에서는 “Zero Hallucinations”라는 강한 표현을 사용한다.
하지만 이 표현은 매우 주의해서 이해할 필요가 있다.
예를 들어 Choice의 answer space를
서울
부산
대전
으로 정했다면 Jev는 갑자기
뉴욕이라는 새로운 문자열을 생성하지 않는다.
모든 output이 predefined answer space 안에 있기 때문이다.
TypeSafe 공식 문서 역시 Choice와 Score의 결과는 사용자가 정의한 option이나 level 안에서만 반환된다고 설명한다.
따라서 Jev는 schema 밖의 내용을 마음대로 만들어내는 generative hallucination을 구조적으로 제거하기 쉽다.
그러나 이것은 Jev가 잘못된 판단을 하지 않는다는 뜻이 아니다.
정답 = 부산

Jev:
서울 = 0.91
처럼 type은 완벽하게 맞지만 semantic decision은 틀릴 수 있다.
그래서 더 정확한 표현은 다음과 같다.
Jev는 자유로운 text generation에서 발생하는 형태의 hallucination을 구조적으로 제한하지만, 판단 오류까지 제거하는 것은 아니다.
실제로 TypeSafe 문서도 calibration이 individual answer의 correctness를 보장하지 않는다고 명시한다.
24. 또 다른 한계: 선택지를 사람이 잘 설계해야 한다
다음 customer-routing 시스템을 생각해보자.
A. billing
B. technical
C. account
그런데 고객이
“귀사와 B2B partnership을 논의하고 싶습니다.”
라고 보냈다면 어떻게 될까?
partnership이 answer space에 없다.
Choice는 사용자가 미리 정의한 option 중 하나를 선택하기 때문에 taxonomy가 부족하면 문제가 생긴다.
TypeSafe 역시 가능한 input을 모두 포괄하지 못할 가능성이 있다면 Choice에 other 또는 none of the above option을 추가하라고 권장한다.
따라서 Jev 기반 시스템의 품질은 단순히 모델의 intelligence만으로 결정되지 않는다.
Model intelligence
        +
좋은 taxonomy
        +
좋은 question decomposition
        +
적절한 confidence threshold
        +
fallback / escalation
        +
명시적인 code logic
이 모두 중요하다.
25. Jev가 적합한 task
Jev는 Generation Model이 아니라 Decision Model이므로 모든 AI task에 적합한 것은 아니다.
| 문제 | Jev 적합성 |
|---|---|
| 고객 문의 routing | 높음 |
| Spam / abuse 판단 | 높음 |
| 검색 결과 relevance | 높음 |
| 문서 ranking | 높음 |
| Agent action 평가 | 높음 |
| 이상 행동 탐지 | 높음 |
| Sentiment / urgency 판단 | 높음 |
| Evidence validation | 높음 |
| 긴 보고서 작성 | 낮음 |
| 코드 생성 | 낮음 |
| 복잡한 수학 reasoning | 낮음 |
| 논문 전체 요약 | 낮음 |
| 자연스러운 장문 설명 | 낮음 |
System One 공식 문서에서도
“Does this message convey urgency?”
같은 빠르고 focused된 judgment는 적절하지만,
“Analyze this message and determine the best course of action.”
처럼 복합적인 reasoning이 필요한 질문은 작은 문제들로 분해할 것을 권장한다.
💡 Think
Jev를 Neuro-Symbolic AI와 연결지을 수 있을까?
Jev는 Neuro-Symbolic AI 자체는 아니지만 Neuro-Symbolic architecture의 neural component로 사용하기 매우 자연스러운 형태를 가진다.
Neural model은 자연어처럼 모호한 정보를 이해하고, Symbolic system은 규칙, graph, logic, constraint 등 명시적인 구조를 이용한다.
Jev를 Neural Component로 사용하기
예를 들어 웹 문서를 검증한다고 해보자.
Jev가 다음을 판단한다.
문서 A가 Claim X를 support하는가?
→ 0.92

문서 A와 문서 B가 contradiction인가?
→ 0.87

문서 A가 질문과 relevant한가?
→ 0.95
이 판단 자체는 neural semantic judgment다.
자연어 의미를 보고 확률적으로 판단하기 때문이다.
그다음 프로그램에서
IF support(A, X) > 0.9
AND credibility(A) > 0.8
AND contradiction(A, X) < 0.2
THEN
    accept_evidence(A, X)
같은 규칙을 적용한다면 이 부분은 symbolic / rule-based reasoning에 가까워진다.
전체 구조는 다음과 같다.
Jev
(neural semantic judgment)
        ↓
typed probabilities
        ↓
Rules / Constraints / Program
        ↓
Final decision
따라서 Jev를 단독으로 사용하는 것은 단순한 neural decision model에 가깝지만,
Jev
  ↓
probabilistic predicates
  ↓
Knowledge Graph / Logic / Constraint
  ↓
symbolic reasoning
으로 구성하면 전형적인 Neuro-Symbolic 방향과 상당히 가까워질 수 있다.
Knowledge Graph와 결합할 수 있을까?
웹 검색 Agent를 예로 들어보자.
기존 Agent는 대략 다음과 같다.
Query
 ↓
Web Search
 ↓
LLM
 ↓
문서 판단
 ↓
LLM
 ↓
추가 검색
 ↓
LLM
 ↓
Answer
각 단계에서 LLM에게 reasoning을 반복적으로 요구한다.
Jev를 사용하면 다음과 같은 구조를 생각할 수 있다.
Search Results
      ↓
     Jev
 ┌─────────┼─────────┐
 ↓        ↓        ↓
관련성   근거성    신뢰성
 ↓        ↓        ↓
0.96    0.84      0.91
      ↓
Filtering / Ranking
      ↓
Reasoning LLM
      ↓
Final Answer
여기에 Knowledge Graph를 추가하면 한 단계 더 나아갈 수 있다.
Web Documents
      ↓
Claim Extraction
      ↓
Knowledge Graph
      ↓
Candidate Evidence
      ↓
Jev
 ├─ relevant?
 ├─ supported?
 ├─ conflicting?
 └─ trustworthy?
      ↓
Symbolic Constraints
      ↓
Evidence Selection
      ↓
Reasoning LLM
      ↓
Answer
예를 들어 그래프에는
Claim A ── supported_by ──> Document 1

Claim A ── contradicted_by ──> Document 2

Document 1 ── published_by ──> Source X
같은 relation을 저장하고,
Jev는 자연어 evidence를 읽어
supports(Claim A, Document 1) = 0.94
contradicts(Claim A, Document 2) = 0.88
같은 probabilistic relation을 만드는 역할을 할 수 있다.
이 결과에 symbolic constraint나 graph reasoning을 적용하는 것이다.
왜 AI Agent 연구에서 중요한가?
현재 많은 Agent 구조는 강한 LLM 하나에게 상당히 많은 일을 맡긴다.
Understand
Reason
Plan
Retrieve
Judge
Verify
Act
Generate
하지만 앞으로는 역할별로 specialized model이나 algorithm을 분리하는 방향도 생각할 수 있다.
Generation
→ LLM

Deep Reasoning
→ Reasoning Model

Retrieval
→ Search / Embedding

Ranking
→ Reranker

Semantic Judgment
→ Jev와 같은 Decision Model

Knowledge Representation
→ Knowledge Graph

Constraint Satisfaction
→ Symbolic Solver

Control Flow
→ Deterministic Code
Jev가 흥미로운 이유는 이 중 Semantic Judgment를 별도의 모델 category로 만들겠다는 시도에 가깝기 때문이다.
즉
“LLM에게 문장을 생성시킨 뒤 거기서 판단을 얻는 것이 정말 최선인가?”
라는 질문을 던진다.
Jev가 정말 중요한지는 아직 검증 중이다
현재 Jev가 제시하는 아이디어는 흥미롭지만 몇 가지는 반드시 구분해야 한다.
Jev는 2026년 9월 15일 공개됐고 아직 매우 초기 단계다. TypeSafe 자체 benchmark에서 뛰어난 cost-latency trade-off를 보여주고 있지만, 공개 후 시간이 매우 짧기 때문에 다양한 real-world distribution에서 정확도와 calibration이 얼마나 유지되는지에 대한 독립적인 검증은 더 필요하다.
특히 앞으로 확인해야 할 핵심은 다음과 같다.
1. Jev의 calibration이 domain shift에서도 유지되는가?

2. confidence가 실제 오류 가능성을 충분히 반영하는가?

3. 복잡한 semantic judgment에서도 atomic decomposition이 효과적인가?

4. Jev + stronger LLM routing이 LLM-only system보다 실제로 cost/accuracy 측면에서 우월한가?

5. predefined taxonomy가 없는 open-world 상황은 어떻게 처리할 것인가?

6. Jev의 probabilistic judgment를 symbolic reasoning이나 Knowledge Graph와 결합하면 reliability를 높일 수 있는가?
특히 RLCD에 대해서는 목표와 기본 철학은 공개됐지만 상세 training recipe가 모두 공개된 것은 아니므로, “Jev의 0.9가 어떤 수학적 과정으로 만들어졌는가?”에 대한 완전한 답은 아직 공개 자료만으로는 할 수 없다.
✔️ 핵심 정리
Jev를 한 문장으로 정의하면 다음과 같다.
Jev는 자연어를 생성하기보다, 소프트웨어 안에서 사용할 수 있는 빠르고 구조화된 확률적 판단을 수행하도록 설계된 TypeSafe AI의 System One Model이다.
그리고 관련 용어는 다음과 같이 기억하면 된다.
System One Model
= 모델 카테고리 / 패러다임

Jev
= 실제 모델

RLCD
= calibrated decision을 학습하기 위한
  TypeSafe의 training methodology

Choice / Score / Noul
= Jev에게 판단을 요청하는 primitive

Calibration
= 모델이 제시하는 probability와
  실제 outcome frequency를 맞추려는 성질
기존 LLM이
Input
 ↓
Reason / Generate
 ↓
Text
를 중심으로 발전했다면,
Jev가 제안하는 방향은
State
 ↓
Semantic Judgment
 ↓
Typed Probability
 ↓
Code / Rules / Constraints
 ↓
Action
에 가깝다.
따라서 Jev의 의미는 단순히 “GPT 경쟁 모델이 하나 더 나왔다”가 아니다.
오히려
Generation과 Decision을 같은 모델이 모두 담당해야 하는가?
라는 AI system architecture 차원의 질문을 던지고 있다는 점이 중요하다.
그리고 이 관점은 Agent, retrieval, evidence verification, Knowledge Graph, constraint satisfaction, Neuro-Symbolic AI와 자연스럽게 연결된다.
특히 Web Research Agent를 생각하면
Web Search
    ↓
Candidate Evidence
    ↓
Jev
 ├ relevance
 ├ support
 ├ credibility
 └ contradiction
    ↓
Knowledge Graph
    ↓
Symbolic Constraints
    ↓
Reasoning LLM
    ↓
Final Answer
같은 구조를 생각할 수 있다.
결국 Jev에서 가장 흥미로운 아이디어는 특정 모델 하나의 성능 수치보다도,
AI에게 모든 것을 생성시키지 말고, AI가 잘하는 semantic judgment만 맡긴 뒤 그 결과를 probability 형태로 받아 deterministic code·symbolic rule·Knowledge Graph와 조합하자
는 접근이다.
이 방향이 실제로 기존 LLM 중심 Agent보다 더 빠르고, 저렴하고, reliable하며, interpretable한 시스템으로 이어질지는 앞으로의 독립적인 실험과 연구를 통해 검증해야 할 문제다.
Jev가 무엇인지 이해하기 쉽게 정리되어 있고, 굉장히 인사이트가 느껴지는 글이었습니다. 잘 보고 갑니다!