CI/CD
1.[Docker] 서버에서 쓰는 Docker와 Docker Desktop은 뭐가 다를까?

Docker를 처음 설치하려고 하면 가장 헷갈리는 지점이 있다.분명 Docker를 쓰려는 건 똑같은데, 어떤 글에서는 Docker Desktop을 설치하라고 하고, 어떤 글에서는 서버에 docker engine을 설치하라고 한다.
2.[Docker] 윈도우에서 Docker 쓰려면 WSL이 꼭 필요할까?
윈도우에서 Docker Desktop을 설치하다 보면 WSL이라는 말을 자주 보게 된다
3.[Kubernetes] 로컬에서 k3d 클러스터 만들고 LoadBalancer 포트 열기
이번에는 로컬 환경에서 k3d를 사용해 Kubernetes 클러스터를 만들고, 80, 443 포트를 LoadBalancer에 연결하는 작업을 진행했다. 처음에는 -p 80:80@loadbalancer, -p 443:443@loadbalancer 옵션이 무슨 의미인지 헷
4.[Docker] Spring Boot 게시판 프로젝트를 Docker로 배포하고 Docker Hub에 올리기
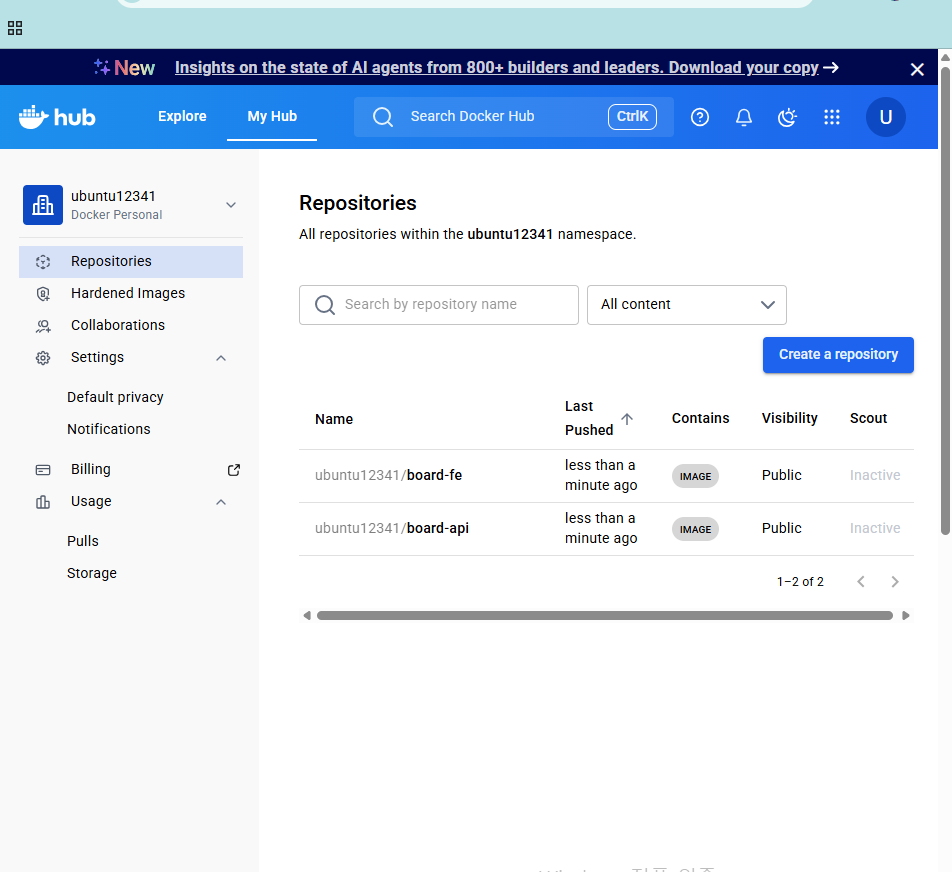
이번에는 로컬에서 실행하던 게시판 프로젝트를 Docker 컨테이너 환경으로 배포하고, 직접 만든 이미지를 Docker Hub에 push하는 과정을 정리한다.기존에는 FE, API, DB를 각각 로컬에서 실행했다.하지만 실제 배포 환경에서는 각 서비스를 컨테이너 단위로
5.[DOCKER] 왜 멀티 스테이지 빌드를 쓰고, 왜 JRE만 남길까?
도커로 스프링부트를 배포하다 보면 처음엔 이런 생각이 든다.그런데 실제 운영 환경에서는:이미지 용량빌드 속도OS 차이캐싱CI/CD 환경같은 문제들이 생긴다.오늘은:Dockerfile 구조JDK vs JRE멀티 스테이지 빌드target 폴더Docker 캐싱환경별 yml
6.[DOCKER] Maven 빌드, `.m2` 캐시, Dockerfile 방식 비교 정리
스프링부트 프로젝트를 Docker로 올리다 보면 단순히 docker run만 문제가 아니다.실제로는 그 전에:이라는 흐름을 이해해야 한다.이번에는 Maven 빌드, .m2 저장소, Dockerfile 두 가지 방식, 그리고 Compose에서 환경변수를 넘기는 구조까지
7.[DOCKER] 컨테이너에서 localhost가 안 먹히는 이유: host.docker.internal과 Profile 분리
이번에 겪은 문제는 단순히 DB URL 하나가 틀린 문제가 아니었다.핵심은 이거였다.이 셋은 같은 것처럼 보여도 네트워크 기준에서는 완전히 다르다.처음에는 Spring Boot API가 PostgreSQL을 바라보도록 설정했다.Docker Compose에서는 이게 잘
8.[DOCKER] `8080:8080` 도대체 무슨 뜻일까?
Docker를 처음 배우면 가장 많이 보는 명령어 중 하나가 이것이다.근데 처음 보면 솔직히 헷갈린다.오늘은 이 개념을 진짜 직관적으로 이해해보자.Docker 컨테이너는 단순한 프로그램이 아니라:이라고 생각하면 이해가 쉽다.즉:서로 네트워크 공간도 다르다.예를 들어 S
9.[DOCKER] Dockerfile 빌드 방식 2가지: jar만 복사할까, 컨테이너 안에서 빌드할까?
Spring Boot 애플리케이션을 Docker 이미지로 만들 때 처음 헷갈리는 지점이 있다.“jar 파일을 먼저 만들고 Docker 이미지에 넣어야 하나?”“아니면 Dockerfile 안에서 Maven 빌드까지 해야 하나?”“둘 중에 어떤 방식이 실무에 더 가까운가?
10.[CI/CD] 도커 빌드 런 메이븐 빌드 런 순서가 어케 되는지
Docker 없이 Spring Boot를 그냥 로컬에서 실행하면 이렇게 간다.이건 쉽게 말하면:이 경우 jar 파일을 명시적으로 만들지 않아도 된다.흐름은 이렇다.즉 이건 개발할 때 빠르게 실행하는 방식이다.이번에는 jar 파일을 만들고 싶을 때다.이 명령은 앱을 실행
11.[CI/CD]`FROM eclipse-temurin:21-jre-alpine` 같은 이미지
FROM eclipse-temurin:21-jre-alpine 같은 이미지는 종류가 엄청 많아 보이는데, 사실 태그를 쪼개서 보면 별거 아님.이건 이렇게 읽으면 된다.즉 한 줄로 말하면:eclipse-temurin은 OpenJDK 배포판 중 하나다.Java는 언어/플랫
12.[DOCKER] docker run 하기 전에 mvn spring-boot:run도 해야 할까?
Spring Boot 애플리케이션을 Docker로 실행하다 보면 처음에 이런 생각이 든다.나도 이 부분이 처음에는 헷갈렸다.왜냐하면 둘 다 결국 localhost:8080으로 접속하기 때문이다.이렇게 실행해도 localhost:8080으로 접속하고,이렇게 실행해도 lo
13.[DOCKER] Docker Compose로 PostgreSQL 데이터 유지하기: volume은 왜 필요할까?
Docker로 PostgreSQL을 띄우면 처음에는 굉장히 편하다. docker compose up 한 번이면 DB 컨테이너가 실행되고, 포트만 연결하면 DBeaver 같은 DB 클라이언트에서도 바로 접속할 수 있다. 그런데 여기서 가장 자주 헷갈리는 문제가 있다.do
14.[KUBERNETES] k9s는 뭐고 왜 쓰는 걸까?
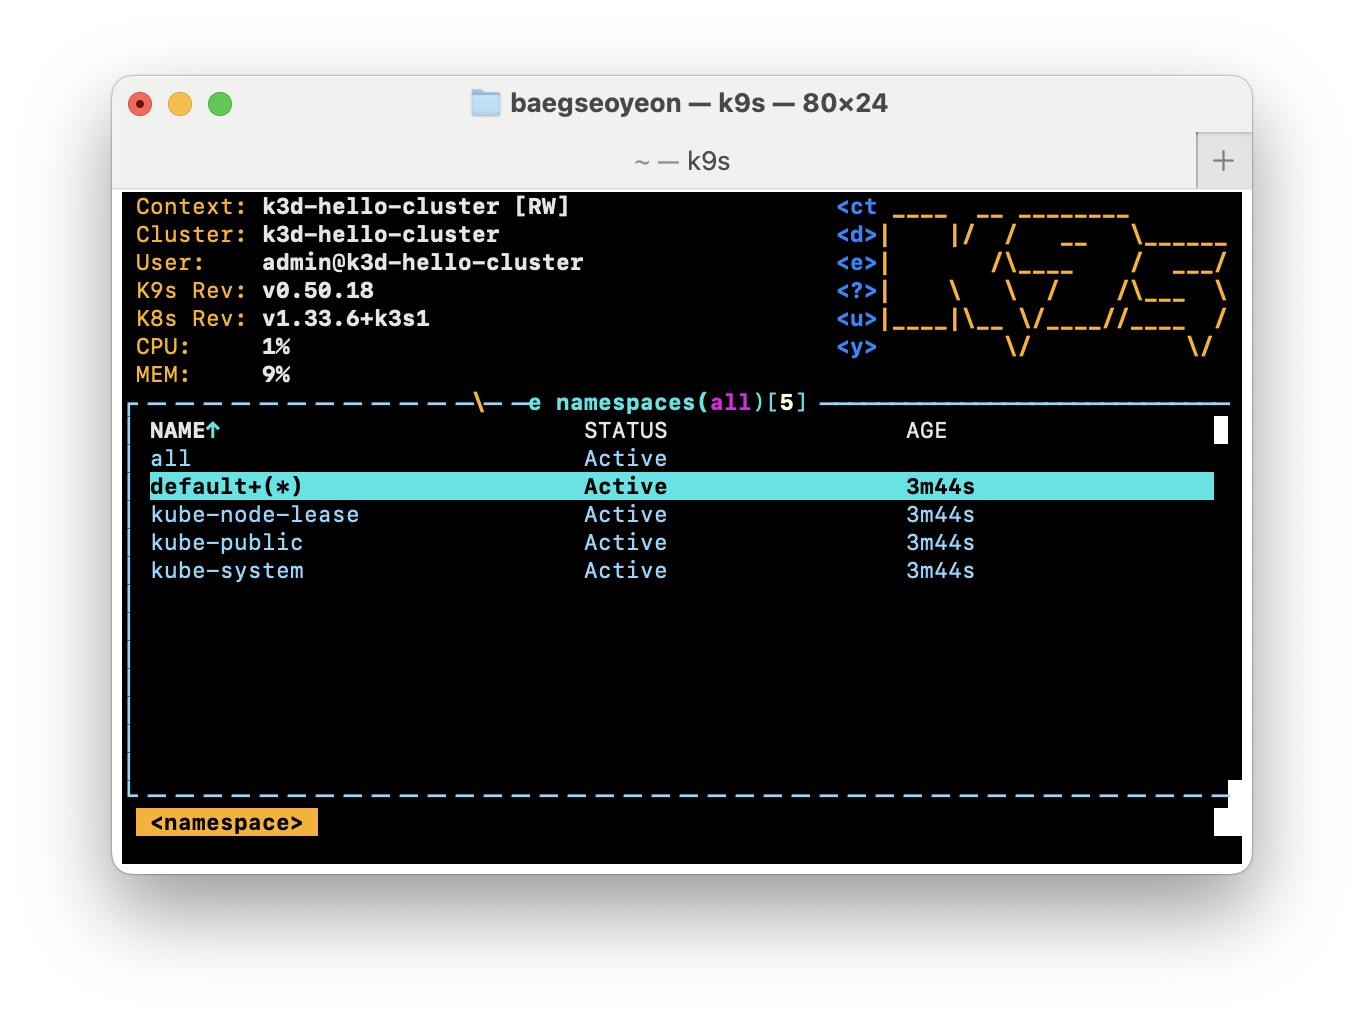
쿠버네티스를 처음 공부하면 보통 kubectl 명령어부터 익힌다. Pod를 보고, Deployment를 보고, Service를 확인하고, 로그를 보고, describe로 이벤트를 확인한다. 그런데 어느 순간부터 이런 생각이 든다. “매번 명령어 치는 거 너무 귀찮은데?
15.[KUBERNETES] kubectx는 뭐고 왜 쓰는 걸까?
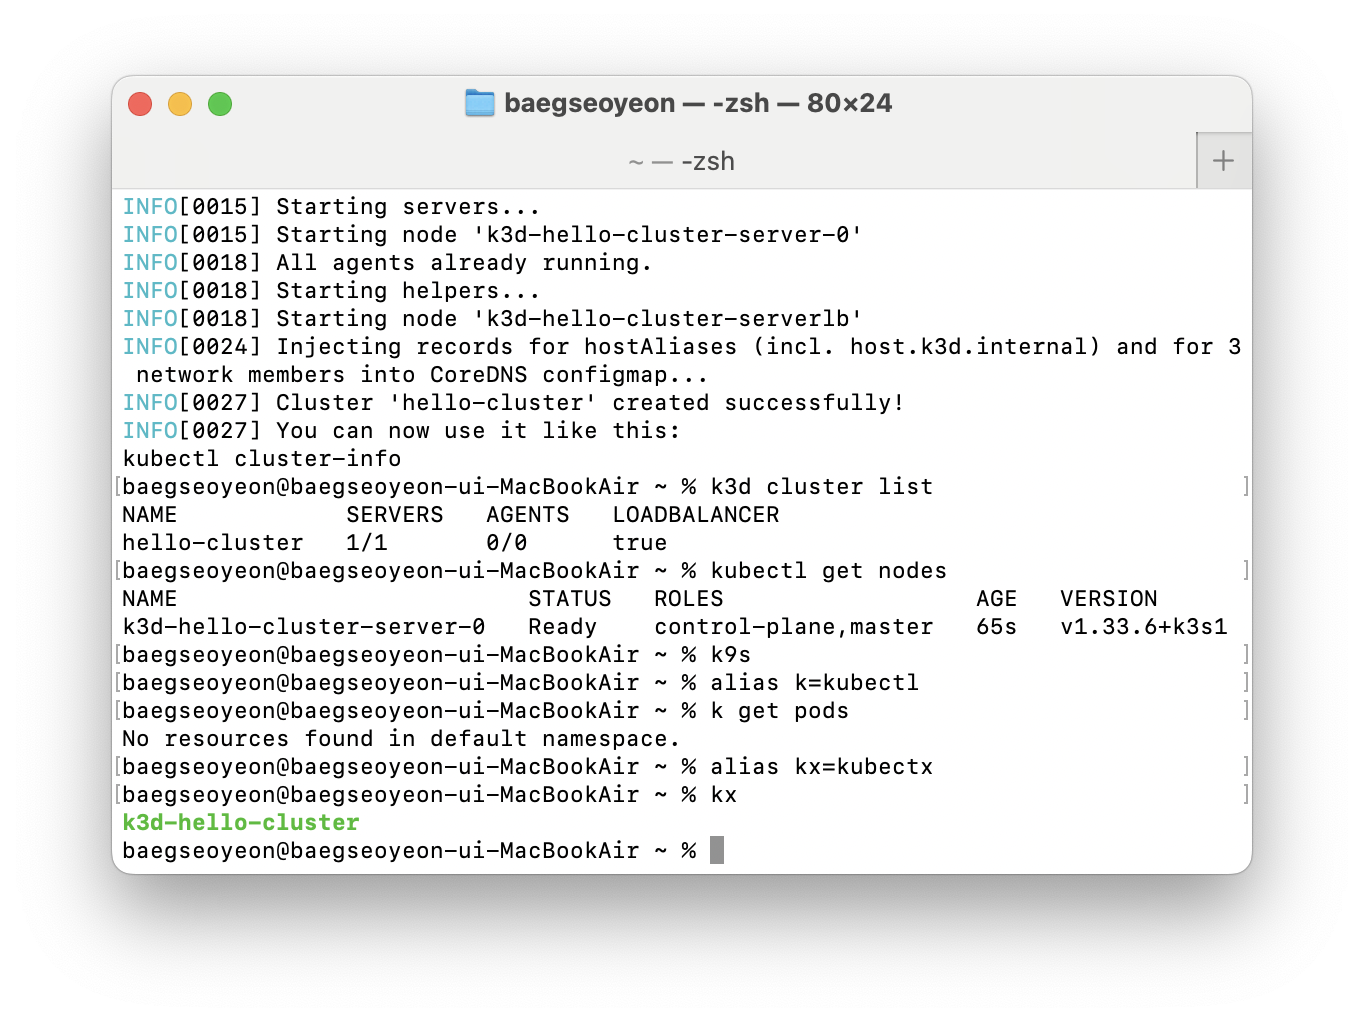
쿠버네티스를 쓰다 보면 kubectl 명령어를 많이 사용하게 된다.처음에는 클러스터가 하나뿐이라 크게 헷갈릴 일이 없다.그런데 쿠버네티스를 계속 쓰다 보면 클러스터가 여러 개가 되는 순간이 온다.예를 들면 이런 식이다.이때 중요한 질문이 생긴다.이걸 쉽게 확인하고 바꿀
16.[KUBERNETES] Helm은 왜 쓰는 걸까?
쿠버네티스를 공부하다 보면 처음에는 Pod, Deployment, Service 같은 YAML을 직접 작성하게 된다.예를 들어 애플리케이션 하나를 배포하려면 보통 이런 리소스들이 필요하다.처음에는 하나씩 작성하면서 배우는 게 좋다. 그런데 실무에서는 앱 하나를 배포할
17.[KUBERNETES] Helm으로 ingress-nginx 설치하다가 namespace 충돌난 이유
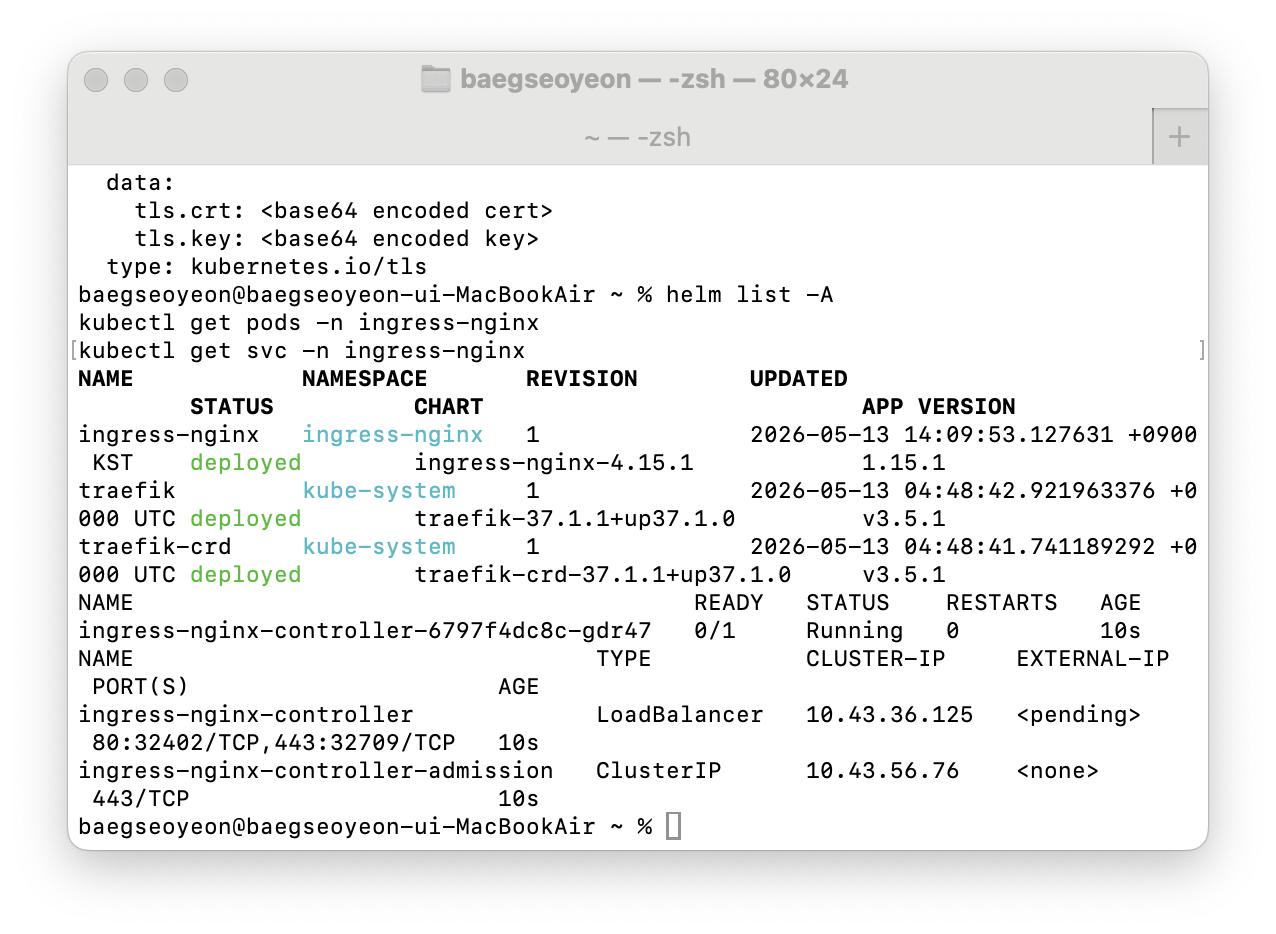
쿠버네티스에서 ingress-nginx를 설치하다 보면 이런 에러를 만날 수 있다.그런데 결과가 이렇게 나온다.처음 보면 꽤 헷갈린다.ingress-nginx 네임스페이스를 새로 만들고 설치하려는 건데, 왜 이미 존재한다고 할까?결론부터 말하면 이 문제는 이미 defa
18.[KUBERNETES] Ingress 적용 후 localhost 접속까지 트러블슈팅 정리
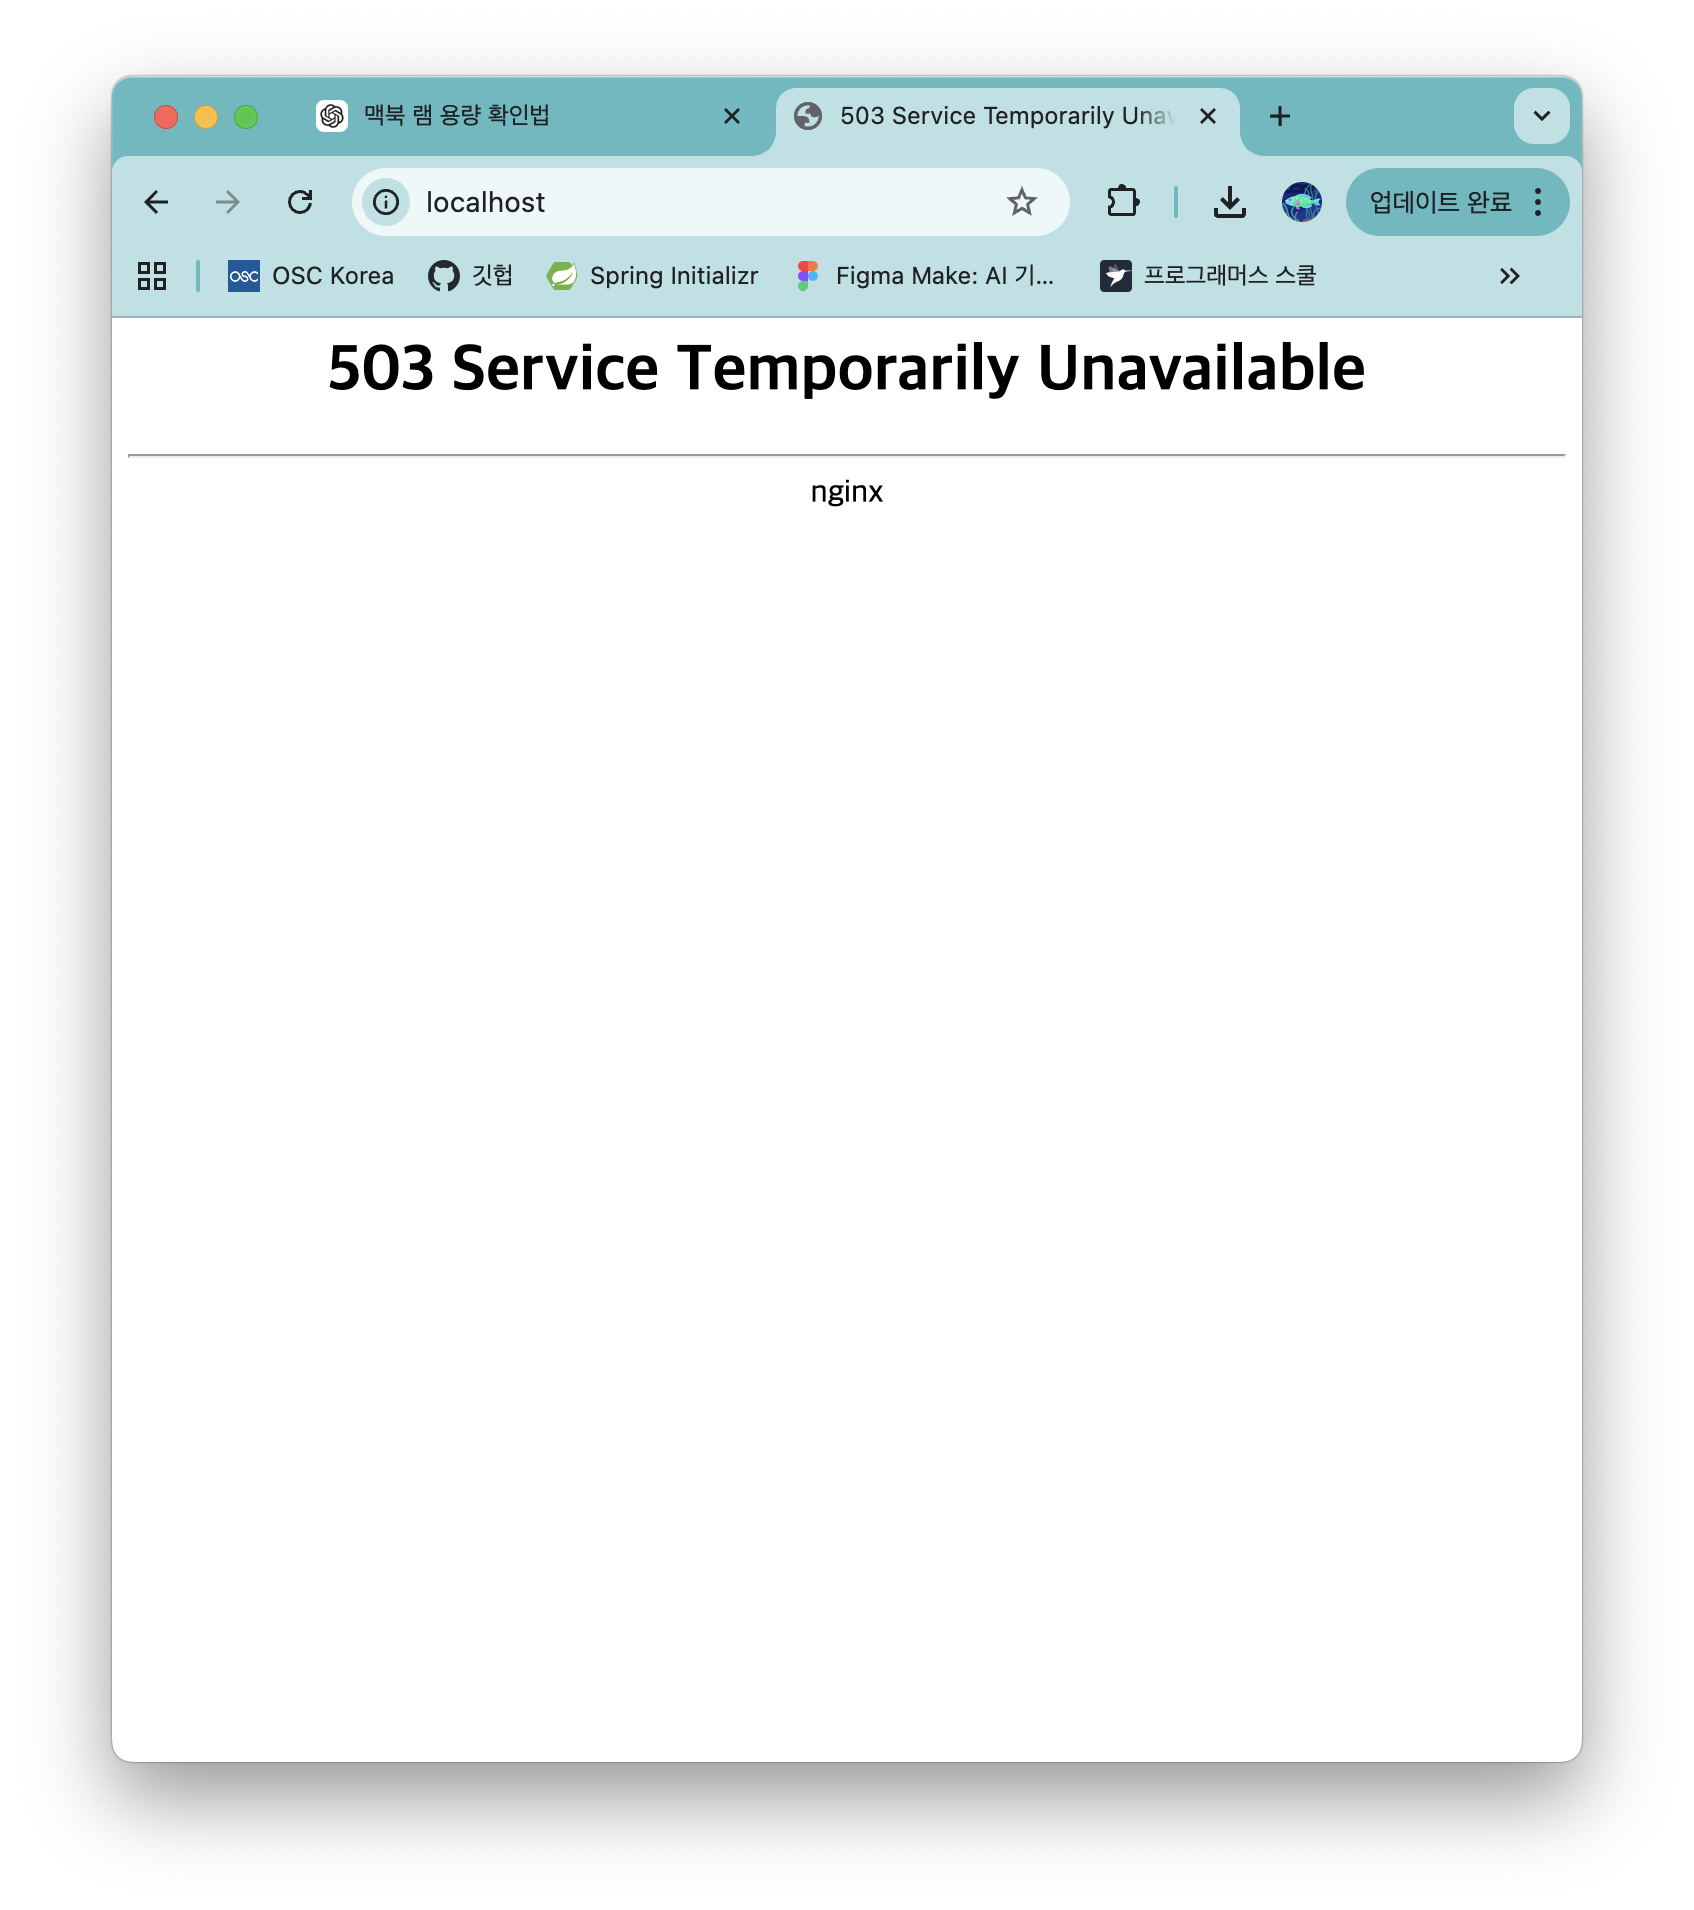
Kubernetes에서 ingress-nginx를 설치하고 Ingress YAML을 적용한 뒤 브라우저에서 localhost로 접속하려고 했다. 그런데 처음에는 YAML 파일을 찾지 못했고, 그다음에는 연결 거부가 났고, 마지막에는 503 Service Temporar
19.[KUBERNETES] kubectl로 Ingress 만드는 것과 Helm으로 ingress-nginx 설치하는 것은 뭐가 다를까?
Kubernetes에서 Ingress를 공부하다 보면 헷갈리는 지점이 있다.이 명령어도 Ingress를 만드는 것 같고,이 명령어도 Ingress 관련 무언가를 설치하는 것 같다.둘 다 Ingress와 관련되어 있지만, 역할은 완전히 다르다.결론부터 말하면 이렇다.즉,
20.[KUBERNETES] 왜 Helm으로 설치하고, 다시 kubectl로 YAML을 apply 했을까?
Kubernetes에서 Ingress를 실습하다 보면 이런 흐름을 만나게 된다.그리고 그다음에 또 이런 명령어를 친다.처음 보면 헷갈린다.“이미 Helm으로 ingress-nginx를 설치했는데, 왜 또 YAML을 kubectl로 apply 하지?”“Helm이랑 kub
21.[KUBERNETES] 앱도 없고 Pod도 없는데 나는 뭘 한 걸까?
Ingress 실습을 하다 보면 이런 순간이 온다.처음에는 헷갈린다.“나는 뭘 만든 거지?”“앱도 없고 Pod도 없는데 왜 Ingress를 만든 거지?”“Service에는 앱이 들어가는 건가?”“Helm으로 설치했으면 다 된 거 아닌가?”결론부터 말하면, 이 상태는 앱
22.[KUBERNETES] Helm으로 ingress-nginx 설치하고, kubectl로 nginx 앱까지 연결하기
Kubernetes에서 Ingress를 처음 실습하면 머리가 복잡해진다.Helm도 나오고, kubectl도 나오고, ingress-nginx도 나오고, nginx-ingress도 나오고, nginx Service와 nginx Pod까지 나온다.처음에는 이런 생각이 든다
23.[Kubernetes] Helm으로 설치한 ingress-nginx에도 Service가 있는데, 왜 nginx Service를 또 만들까?
Kubernetes에서 Ingress를 실습하다 보면 처음에 많이 헷갈리는 부분이 있다.이렇게 Helm으로 ingress-nginx를 설치했는데, 이후에 또 이런 명령어를 친다.처음 보면 이런 생각이 든다.어? Helm으로 ingress-nginx 설치할 때 Servi
24.[Kubernetes] Helm으로 ingress-nginx를 설치하면 어디까지 설치되는 걸까?
Ingress를 처음 실습할 때 가장 헷갈렸던 부분이 있다.이 명령어를 치면 뭔가 Ingress 관련 설정이 다 끝난 것처럼 느껴진다.그래서 이후에 다시 이런 명령어를 치면 헷갈린다.처음에는 이런 생각이 든다.Helm으로 ingress-nginx 설치했는데 왜 ngin
25.[DOCKER] 컨테이너는 왜 설정이 날아갈까?
Docker를 쓰다 보면 이런 상황을 자주 만난다.Nginx 컨테이너 안에 들어간다.설정 파일을 수정한다.처음에는 잘 되는 것처럼 보인다.그런데 컨테이너를 지웠다가 다시 만들면?수정한 설정이 사라진다.이때 많은 사람들이 이렇게 생각한다.“분명히 내가 컨테이너 안에서 수
26.[DOCKER] Docker Volume은 왜 중요한가?
Docker를 쓰다 보면 처음에는 이런 식으로 생각하기 쉽다.“컨테이너 안에 PostgreSQL이 떠 있으니까 데이터도 컨테이너 안에 있겠지?”맞다.그런데 문제는 컨테이너가 영구적인 존재가 아니라는 점이다.컨테이너는 언제든지 꺼질 수 있고, 삭제될 수 있고, 다시 만들
27.[DOCKER] 컨테이너 안에서 vi로 수정하면 왜 위험할까?
Docker를 처음 쓰다 보면 이런 생각을 하게 된다.“컨테이너 안에 들어가서 설정 파일을 직접 고치면 되는 거 아닌가?”예를 들어 Nginx 컨테이너가 떠 있고, 그 안에 nginx.conf나 server.conf 같은 설정 파일이 있다고 해보자.이렇게 컨테이너 안으
28.[DOCKER]Docker Compose 실전 구조
[DOCKER] docker-compose.yml은 단순 실행 파일이 아니다 Docker를 처음 배울 때는 보통 docker run 명령어로 컨테이너를 실행한다. 이렇게 하면 PostgreSQL 컨테이너 하나를 띄울 수 있다. 그런데 실제 개발 환경에서는 컨테이너 하나만 띄우는 경우가 많지 않다. 예를 들어 웹 애플리케이션을 만든다고 하면 보통 이...
29.[Docker] Docker 네트워크와 컨테이너 통신
아래 4편은 그대로 벨로그에 나눠 올리면 된다. 오늘 메모 흐름상 localhost → 같은 네트워크 → host.docker.internal → 외부 DB 접근 방식 순서가 제일 자연스럽다. 수업 메모에서도 컨테이너 내부의 localhost는 자기 컨테이너를 의미하고
30.[Docker] Docker 이미지와 커스텀 빌드
Docker를 쓰다 보면 처음에는 공식 이미지를 그대로 사용한다.예를 들어 PostgreSQL을 띄울 때는 이렇게 쓴다.Nginx를 띄울 때는 이렇게 쓴다.이 방식은 빠르고 편하다.하지만 어느 순간 이런 상황이 생긴다.이때 컨테이너 안에 들어가서 직접 설치하면 안 된다
31.[DOCKER] Docker Compose 실행 순서와 Health Check
Docker Compose로 애플리케이션과 DB를 함께 실행할 때 자주 나오는 구조가 있다.또는이 구조에서 애플리케이션은 혼자 동작하지 않는다.대부분의 백엔드 애플리케이션은 실행될 때 DB에 연결해야 한다.그래서 DB가 먼저 떠 있어야 한다.애플리케이션은 실행 과정에서
32.[KUBERNETES] K3d, Pod 재생성, Event로 이해하는 쿠버네티스 기초
쿠버네티스를 처음 만지면 가장 먼저 드는 생각은 이것이다.“분명 내가 뭔가를 지웠는데 왜 다시 생기지?”“Pod가 죽었는데 왜 또 만들어지지?”“에러가 났는데 어디부터 봐야 하지?”“K3d는 또 뭐고, K3s랑은 뭐가 다른 거지?”이번 글에서는 Kubernetes를 로
33.[Kubernetes] Kubernetes Namespace와 Ingress
Kubernetes를 처음 만지면 Pod, Deployment, Service까지는 어느 정도 감이 온다. 그런데 조금만 더 들어가면 바로 헷갈리는 개념이 나온다.특히 ingress-nginx와 ingress-nginx-controller는 이름이 비슷해서 거의 같은
34.[Kubernetes] Helm과 Kubernetes 운영
Kubernetes를 공부하다 보면 처음에는 kubectl로 직접 리소스를 만든다.이 단계에서는 괜찮다.Pod 하나 만들고, Service 하나 만들고, Ingress 하나 만드는 정도는 직접 해도 된다.그런데 실제 운영 환경으로 가면 리소스가 하나가 아니다.이런 리소
35.[Kubernetes] 원격 클러스터와 인프라 운영 관점
Kubernetes를 처음 배울 때는 보통 서버에 직접 SSH로 들어가서 명령어를 치는 방식이 익숙하다.그런데 실무 관점으로 가면 조금 다른 생각을 해야 한다.이 질문이 바로 Kubernetes 운영, kubeconfig, context, IaC, 자동화 사고로 이어진
36.[KUBERNETES] 쿠버네티스를 이해하기 전에 알아야 할 것들: 온프레미스, VM, 컨테이너, Docker, 그리고 K8s
쿠버네티스를 처음 공부할 때 바로 Pod, Service, Deployment부터 들어가면 헷갈리기 쉽다. 쿠버네티스는 갑자기 튀어나온 기술이 아니라, 서버를 운영하는 방식이 변화하면서 자연스럽게 등장한 기술이기 때문이다.흐름을 크게 보면 다음과 같다.각 기술은 이전
37.[KUBERNETES] Service는 왜 필요할까? ClusterIP, NodePort, LoadBalancer 한 번에 이해하기
쿠버네티스에서 Pod를 띄우는 것까지는 비교적 이해가 쉽다. nginx 이미지를 이용해서 Pod를 만들면 nginx 서버가 뜨고, Deployment를 만들면 여러 개의 Pod가 생성된다. 그런데 여기서 바로 문제가 생긴다. Pod는 계속 같은 자리에 있는 존재가 아니
38.[KUBERNETES] kubectl run으로 만든 curl-test Pod는 어디에 생기는 걸까?
Kubernetes에서 ClusterIP를 테스트하다 보면 이런 명령어를 자주 쓰게 된다.처음 보면 이런 생각이 든다.이게 대체 어디에 설치되는 거지?내 로컬에 curl을 까는 건가?아니면 Kubernetes 클러스터 안에 들어가는 건가?만약 클러스터가 여러 개면 어디
39.[KUBERNETES] ClusterIP Service는 정말 로드밸런싱을 할까?
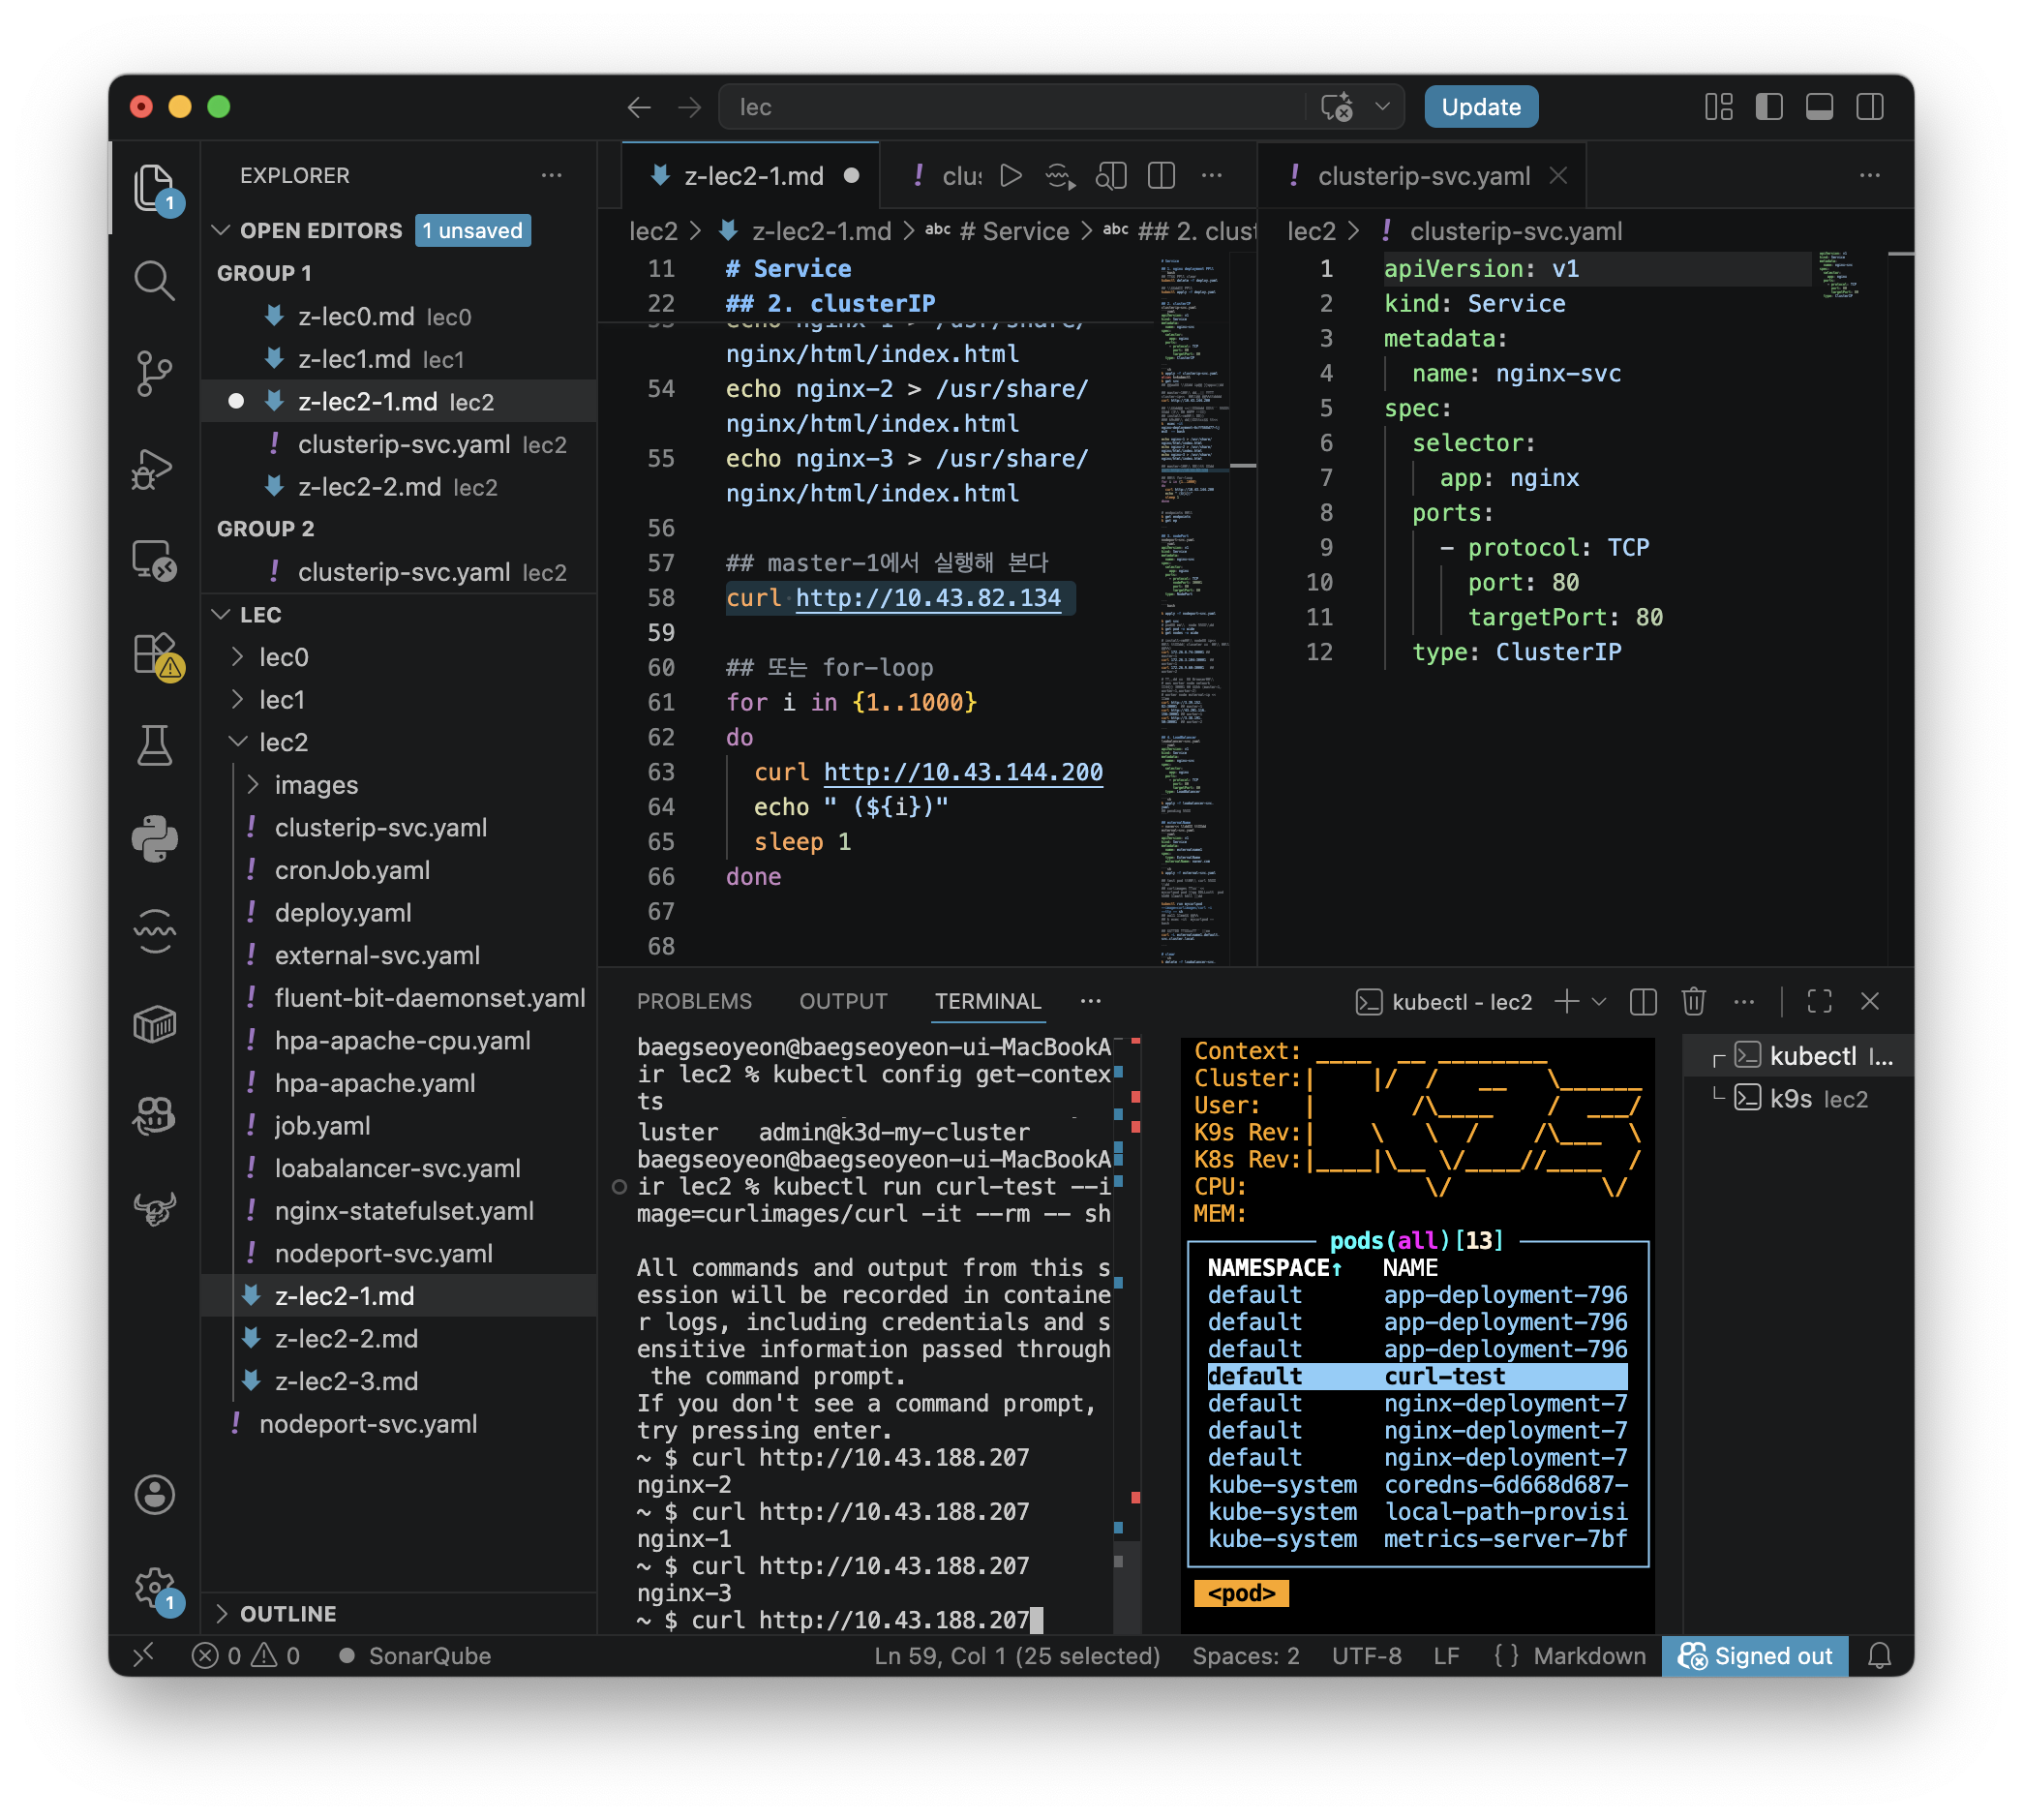
Kubernetes에서 Service를 만들면 Pod에 직접 접근하지 않고 Service를 통해 접근하게 된다. 이때 Service 뒤에 Pod가 여러 개 붙어 있다면, 요청은 여러 Pod 중 하나로 전달된다. 이번 실습에서는 ClusterIP 타입의 Service가
40.[LINUX] bash랑 sh는 뭐가 다를까? Kubernetes curl-test에서 for문이 안 돈 이유
Kubernetes에서 ClusterIP Service가 로드밸런싱을 하는지 확인하려고 curl-test Pod를 띄웠다.그리고 Service IP로 1000번 요청을 보내려고 아래처럼 입력했다.그런데 결과가 이상했다.원래 기대한 결과는 이런 식이었다.그런데 실제로는
41.[LINUX] bash와 sh의 근본적인 차이
리눅스나 컨테이너 안에서 명령어를 치다 보면 bash와 sh를 자주 만나게 된다.예를 들어 Kubernetes에서 curl 테스트용 Pod를 띄울 때 이렇게 실행했다.여기서 마지막에 붙은 sh는 컨테이너 안에서 sh 셸을 실행하겠다는 뜻이다.그런데 문제는 우리가 평소에
42.[KUBERNETES] Endpoint는 Service가 실제로 바라보는 Pod 목록이다
Kubernetes에서 Service를 만들면 우리는 보통 Service IP로 접근한다.예를 들어 nginx-svc라는 Service가 있고, ClusterIP가 10.43.144.200이라고 해보자.그러면 요청은 Service로 들어간다. 그런데 여기서 중요한 질문
43.[K3D/KUBERNETES] NodePort인데 왜 Node IP로 접속이 안 될까?
Kubernetes에서 Service 타입 중 NodePort를 사용하면 외부에서 다음과 같은 형식으로 접근할 수 있다고 배운다.예를 들어 Service가 이렇게 떠 있다고 하자.여기서 중요한 부분은 이것이다.즉, nginx-svc는 NodePort 타입이고, 외부에서
44.[DOCKER/K3D] 포트 매핑에서 앞쪽 포트와 뒤쪽 포트가 헷갈릴 때
Docker나 k3d를 쓰다 보면 이런 문법을 자주 본다.또는 k3d에서는 이런 식으로 쓴다.처음 보면 제일 헷갈리는 부분은 이거다.포트가 두 개 나오는데, 앞쪽 포트가 뭔지, 뒤쪽 포트가 뭔지 잘 안 와닿는다.이번 글에서는 이걸 정말 쉽게 정리해보려고 한다.포트 매핑
45.[K3D/KUBERNETES] k3d 클러스터 두 개를 같은 네트워크로 묶으면 NodePort 접근이 될까?
Kubernetes에서 NodePort를 배우면 보통 이렇게 접근한다고 배운다.예를 들어 Service가 이렇게 떠 있다고 하자.여기서 30001이 NodePort다.일반적인 VM이나 AWS 환경이라면 외부 호스트에서 다음처럼 접근할 수 있다.그런데 k3d 환경에서는
46.[K3D/KUBERNETES] LoadBalancer Service를 쓰려면 왜 클러스터 생성 때 포트 매핑을 해야 할까?
Kubernetes에서 Service 타입 중 LoadBalancer를 만들면 외부에서 바로 접속할 수 있을 것처럼 느껴진다.예를 들어 이런 Service YAML이 있다고 하자.적용하면:Service는 생성된다.그런데 k3d 환경에서는 EXTERNAL-IP가 <
47.[KUBERNETES] LoadBalancer랑 NodePort는 뭐가 다를까? 사실 비슷해 보이는 게 맞다
Kubernetes Service를 공부하다 보면 ClusterIP, NodePort, LoadBalancer가 나온다. 처음에는 셋이 완전히 다른 방식처럼 느껴지는데, 실습을 해보면 이런 생각이 든다.결론부터 말하면, 그렇게 느끼는 게 맞다.NodePort와 Load
48.[KUBERNETES] NodePort랑 LoadBalancer는 어디로 curl 해야 할까?
Kubernetes Service를 공부하다 보면 NodePort와 LoadBalancer가 자주 나온다. 그런데 실습을 하다 보면 둘이 너무 비슷해 보인다.이번 글에서는 Service 타입이 NodePort일 때와 LoadBalancer일 때 각각 어디로 접속해야 하
49.[KUBERNETES] NodePort는 아무 워커 노드로 들어가도 다른 노드의 Pod에 접속될까?
Kubernetes에서 NodePort Service를 배우다 보면 이런 의문이 생긴다.결론부터 말하면 된다.NodePort는 특정 Pod가 떠 있는 노드에서만 열리는 포트가 아니다. Kubernetes 클러스터의 각 Node에 같은 포트를 열어두고, 그 포트로 들어온
50.[K3D/KUBERNETES] k3d에서는 왜 localhost로 접속하고, 서버에서는 Node IP로 접속할까?
Kubernetes Service를 실습하다 보면 접속 주소가 계속 헷갈린다.어떤 글에서는 이렇게 접속하라고 한다.그런데 k3d에서는 이렇게 접속하라고 한다.또 LoadBalancer Service를 만들면 어떤 환경에서는 LoadBalancer 주소로 들어가고, k3
51.[KUBERNETES] cAdvisor는 뭐고, Metrics Server/HPA랑 무슨 관계일까?
Kubernetes에서 리소스 모니터링을 공부하다 보면 cAdvisor, Metrics Server, kubectl top, HPA 같은 단어가 같이 나온다. 처음 보면 다 비슷하게 “CPU랑 Memory 보는 것”처럼 느껴지는데, 실제로는 역할이 조금씩 다르다. 이
52.[Kubernetes] 데몬이 뭐야? DaemonSet은 왜 쓰는 걸까?
쿠버네티스 공부하다 보면 DaemonSet이라는 단어가 나온다.처음 보면 이름부터 좀 무섭다.데몬? 악마? 뭐 하는 애임?근데 어렵게 생각할 필요 없다.쿠버네티스에서 말하는 데몬은 쉽게 말하면 서버 뒤에서 계속 돌아가는 프로그램이다.Daemon은 백그라운드에서 계속 실
53.[Kubernetes] Static Pod란? kubelet이 직접 관리하는 Pod
쿠버네티스에서 Pod는 보통 kubectl apply로 만든다.그러면 일반적인 Pod 생성 흐름은 이렇게 된다.그런데 Static Pod는 이 흐름과 조금 다르다.Static Pod는 한 줄로 말하면 이거다.보통 Pod를 만들 때는 kubectl 명령어를 사용한다.이
54.[Kubernetes] Pod Resource Requests와 Limits 쉽게 이해하기
쿠버네티스에서 Pod를 만들 때 컨테이너가 사용할 CPU, Memory를 지정할 수 있다.이때 나오는 개념이 두 개다.처음 보면 둘 다 “리소스 설정”이라 헷갈리는데, 역할이 다르다.requests는 이 Pod를 실행하기 위해 최소한 이 정도 리소스는 필요하다고 쿠버네
55.[Kubernetes] 로그 수집 패턴 비교: Sidecar 방식 vs Cluster-level 방식
쿠버네티스에서 애플리케이션 로그를 수집하는 방식은 크게 두 가지로 볼 수 있다.둘 다 “로그를 모은다”는 목적은 같지만, 어디에서 로그를 수집하느냐, 누가 로그 수집을 담당하느냐가 다르다.쿠버네티스에서 컨테이너는 보통 표준 출력으로 로그를 남긴다.예를 들면 애플리케이션
56.[Kubernetes] Fluent Bit이 뭔데 로그 수집할 때 자꾸 나올까?
쿠버네티스에서 애플리케이션을 띄우다 보면 처음에는 이런 것만 신경 쓴다.그런데 운영 관점으로 넘어가면 질문이 바뀐다.이때 등장하는 도구가 Fluent Bit이다.Fluent Bit은 한마디로 가벼운 로그 수집기다.흐름은 대충 이렇게 보면 된다.이번 실습에서는 nginx
57.[Kubernetes] apache.192.168.164.4.sslip.io에서 Apache랑 sslip.io는 뭘까?
Kubernetes Ingress 실습을 하다 보면 이런 주소를 만난다.apache는 뭔가 서비스 이름 같고, 192.168.164.4는 IP 주소 같고, sslip.io는 도메인 같은데 이게 왜 한 줄에 붙어 있는 걸까?이번 글에서는 이 주소를 기준으로 Apache가
58.[Kubernetes] PV와 PVC란 무엇일까?
Kubernetes에서 Pod는 기본적으로 언제든지 사라질 수 있는 존재다.Pod가 죽었다가 다시 생성되면 내부 파일도 같이 사라질 수 있다.예를 들어 MySQL Pod를 띄웠다고 해보자.이러면 데이터베이스를 Kubernetes에서 운영할 수 없다.그래서 Kuberne
59.[Kubernetes] 프로비저닝이란 무엇일까?
Kubernetes에서 PV와 PVC를 공부하다 보면 이런 말이 나온다.처음 들으면 단어부터 어렵다.“프로비저닝이 뭔데?”“그냥 생성이랑 다른 건가?”“PV/PVC랑 무슨 관계지?”이번 글에서는 프로비저닝이라는 개념을 쉽게 정리해본다.프로비저닝은 영어로 Provisio
60.[Kubernetes] Ingress란 뭘까? 외부에서 Pod에 접속하는 방법 이해하기
Kubernetes에서 Pod와 Service를 만들었는데 이런 생각이 든다.Kubernetes 안에 nginx나 apache 같은 웹 서버를 띄워도, 그냥 바로 외부에서 접속되는 건 아니다.클러스터 안에 있는 서비스를 외부로 열어주는 입구가 필요하다.이때 사용하는 것
61.[Kubernetes] Helm values.yaml은 왜 쓰는 걸까?
Kubernetes를 공부하다 보면 처음에는 YAML 파일을 직접 작성한다.그런데 Prometheus, Grafana, OpenSearch 같은 도구를 설치하려고 하면 YAML 파일이 너무 많아진다.Deployment, Service, ConfigMap, Secret,
62.[Argo CD] Healthy, Synced가 떴다는 건 무슨 뜻일까?
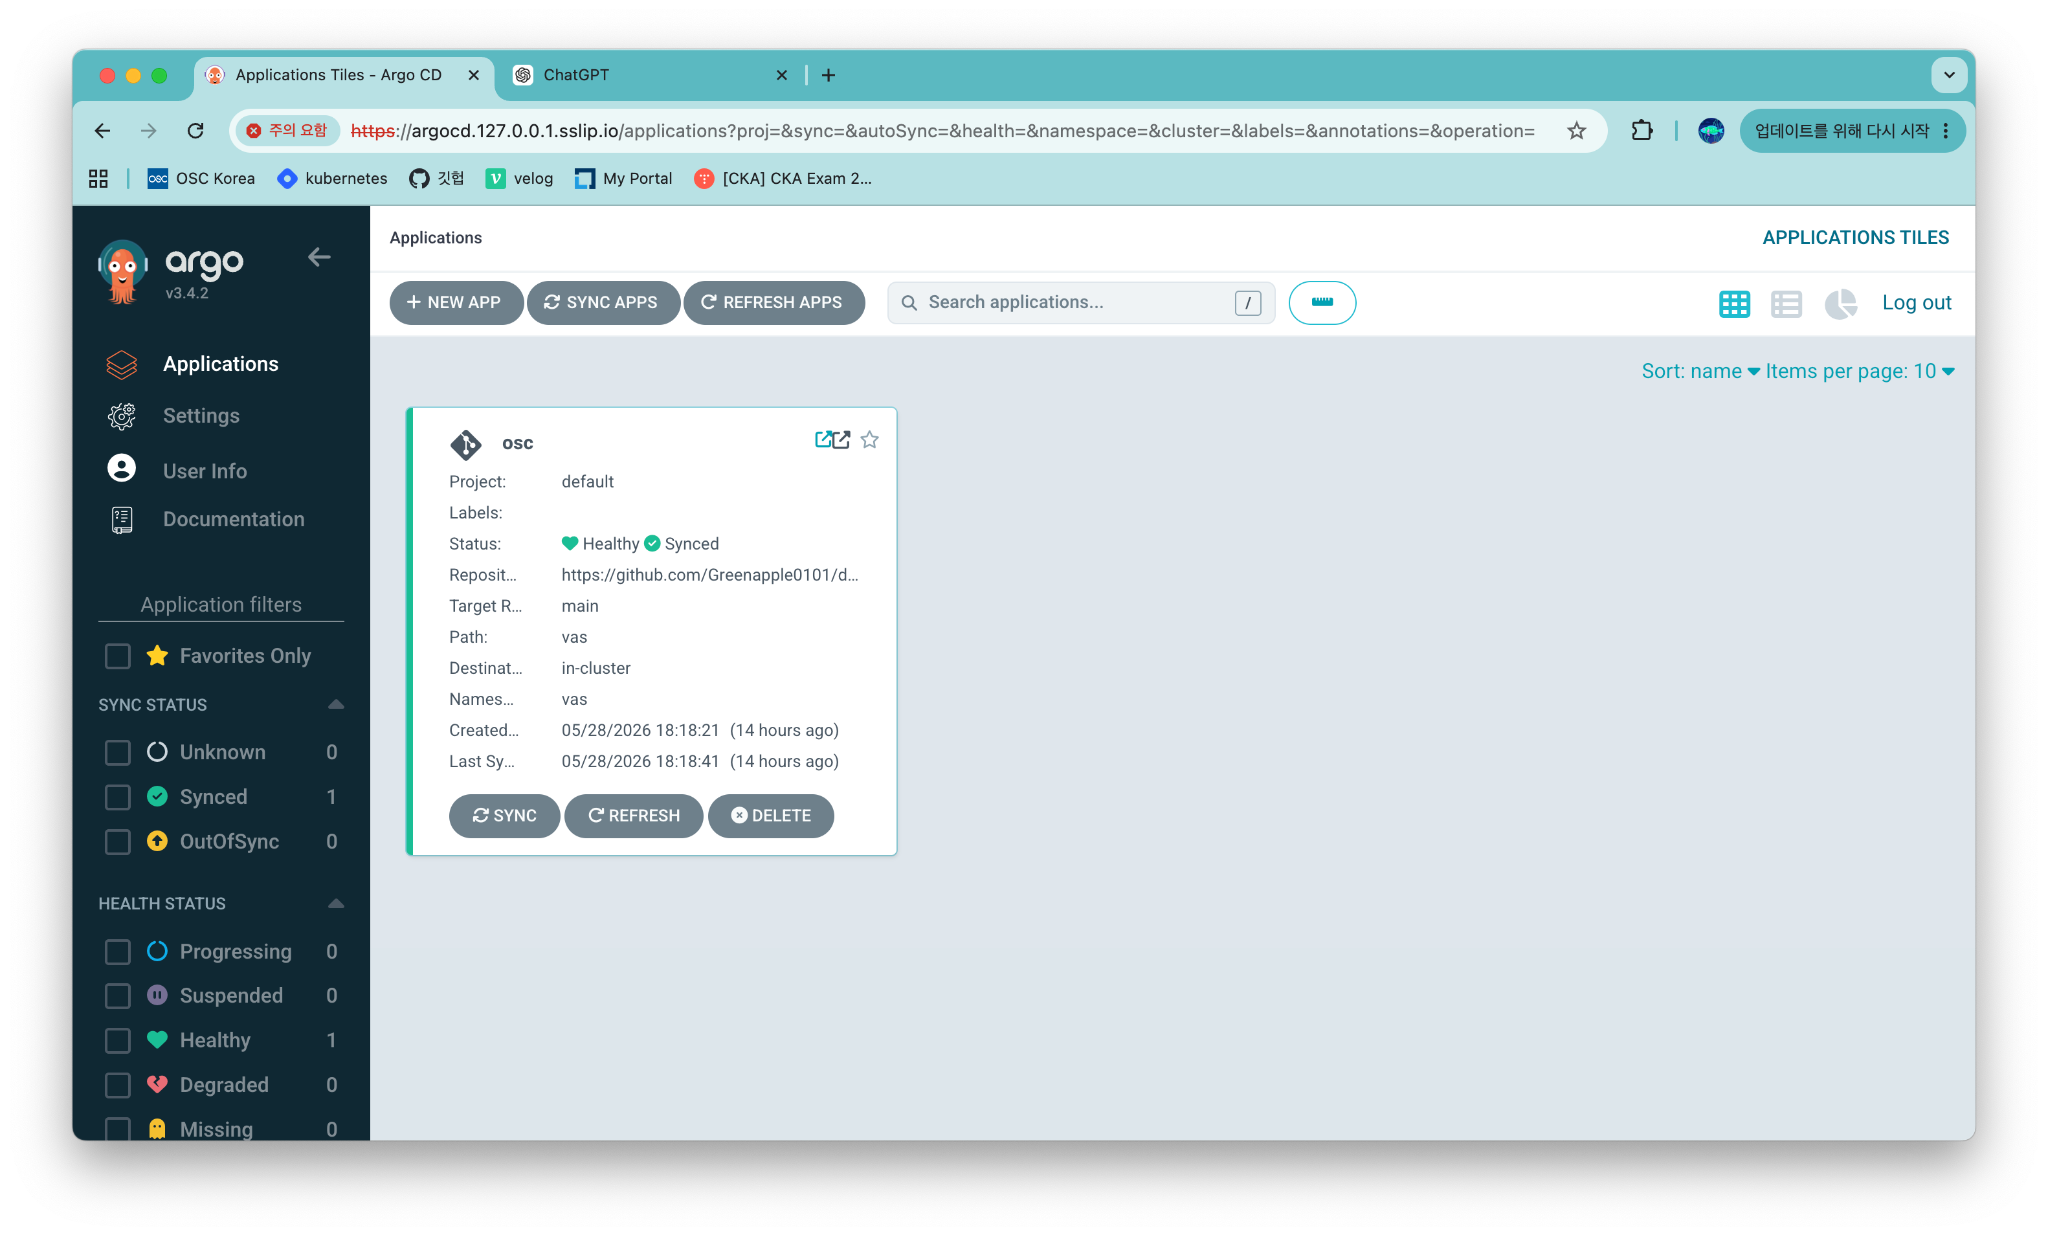
지금 화면은 Argo CD로 Kubernetes 애플리케이션 배포가 성공한 상태라고 보면 된다.한 줄로 요약하면 이거다.GitHub에 있는 Kubernetes manifest를 Argo CD가 읽어서, Kubernetes 클러스터 안에 Service, Deploymen
63.[Kubernetes] Headless Service는 도대체 왜 쓰는 걸까?
쿠버네티스에서 Service를 배우다 보면 보통 이런 식으로 이해한다.Pod는 계속 죽고 다시 생기니까 IP가 바뀐다.그래서 Service가 고정된 주소 역할을 해준다.맞는 말이다.일반적인 Service는 여러 Pod 앞에 하나의 고정된 입구를 만들어준다.그런데 쿠버네
64.[Kubernetes] LivenessProbe로 Self-Healing 이해하기
쿠버네티스를 공부하다 보면 자주 나오는 말이 있다.쿠버네티스는 Self-Healing을 지원한다.처음 들으면 뭔가 엄청 대단한 기능처럼 느껴진다.“쿠버네티스가 알아서 장애를 고쳐준다고?”“그럼 서버가 죽어도 자동으로 살아나는 건가?”반은 맞고, 반은 조심해서 이해해야
65.[Kubernetes] CoreDNS란? 서비스 이름을 IP로 바꿔주는 DNS 서버
쿠버네티스를 공부하다 보면 이런 주소를 자주 보게 된다.또는 파드 안에서 그냥 이렇게 호출하기도 한다.처음 보면 조금 이상하다.“mysql이라는 도메인을 산 적도 없는데 왜 접속이 되지?”“저 이름을 누가 IP로 바꿔주는 거지?”이걸 가능하게 해주는 핵심 컴포넌트가 바
66.[Kubernetes] 쿠버네티스에서 NIC는 도대체 뭘까?
쿠버네티스 네트워크를 공부하다 보면 이런 단어들이 계속 나온다.처음 보면 머리가 복잡해진다.“Pod IP는 뭐고 Service IP는 또 뭐지?”“CNI는 왜 나오고, Ingress는 어디에 붙는 거지?”“Pod는 가상인데 어떻게 IP를 가지는 거지?”그런데 이걸 이해
67.[Kubernetes] Daemon이란? DaemonSet을 이해하기 전에 알아야 할 기본 개념
쿠버네티스에서 DaemonSet을 공부하다 보면 자연스럽게 이런 질문이 생긴다.DaemonSet을 이해하려면 먼저 Daemon이라는 개념부터 잡고 가는 게 좋다.Daemon은 백그라운드에서 계속 실행되는 프로그램이다.일반 프로그램은 사용자가 직접 실행하고, 필요 없으면
68.[Kubernetes] K8s API란? 쿠버네티스가 움직이는 진짜 입구
쿠버네티스를 쓰다 보면 이런 명령어를 자주 입력한다.겉으로 보면 kubectl이 직접 쿠버네티스를 조작하는 것처럼 보인다.그런데 실제로는 kubectl이 직접 Pod를 만들고, Service를 지우고, Deployment를 수정하는 것이 아니다.kubectl은 Kube
69.[Kubernetes] kube-proxy란? Service 트래픽을 Pod로 보내주는 네트워크 관리자
쿠버네티스에서 Service를 공부하다 보면 이런 말을 자주 듣는다.Service는 Pod 앞에 고정된 IP를 만들어준다.클라이언트는 Pod IP를 몰라도 Service IP로 접근하면 된다.처음에는 이렇게 이해하면 된다.그런데 여기서 질문이 생긴다.“Service는
70.[Kubernetes] Ingress가 SSL 인증서를 처리한다는 게 무슨 뜻일까?
쿠버네티스 Ingress를 공부하다 보면 이런 설명이 나온다.그리고 기능으로는 보통 이런 것들이 나온다.처음 보면 여기서 막힌다.“Ingress가 SSL 인증서를 처리한다는 게 뭐지?”“SSL은 HTTPS 붙이는 거 아닌가?”“그럼 Service가 HTTPS를 처리하는
71.[Kubernetes] Ingress Controller란? Ingress랑 뭐가 다르고 왜 NGINX를 많이 쓸까?
쿠버네티스에서 외부 트래픽을 다루다 보면 이런 흐름을 자주 본다.처음에는 이렇게 이해한다.Ingress는 외부에서 들어온 HTTP/HTTPS 요청을클러스터 내부 Service로 보내주는 입구다.그런데 여기서 헷갈리는 지점이 생긴다.결론부터 말하면 이렇다.이 차이를 잡아
72.[Kubernetes] nodeSelector란? Pod를 원하는 노드에 배치하는 가장 단순한 방법
쿠버네티스를 공부하다 보면 이런 말을 자주 듣는다.처음에는 이렇게 이해하면 된다.그런데 여기서 질문이 생긴다.이때 가장 단순하게 사용할 수 있는 방법이 바로 nodeSelector다.nodeSelector는 Pod를 특정 라벨이 붙은 Node에만 배치하도록 지정하는 설
73.[Kubernetes] Taint & Toleration, Cordon & Drain은 왜 필요할까?
쿠버네티스에서 Pod는 기본적으로 Scheduler가 적절한 Node를 골라 배치한다.그런데 운영하다 보면 이런 상황이 생긴다.이때 자주 나오는 개념이 바로 이것들이다.처음 보면 다 비슷해 보인다.하지만 역할이 다르다.큰 그림으로 먼저 보면 이렇다.쿠버네티스에서 Pod