이진분류
- 결과를 0.5 기준으로 잘라서 1, 0으로 변환
- 예측 결과 : 0 ~ 1 사이 확률 값
💡원하는 것 : Survived 0, 1로 예측
sigmoid
model = Sequential([Input(shape = (nfeatures, )),
                    Dense(30, activation='relu'),
                    Dense(15, activation='relu'),
Dense(1, activation='sigmoid')])- 이진 분류
Activation Function - 결과를 0,1로 변환
💡활성 함수 : Node의 결과를 변환해주는 함수
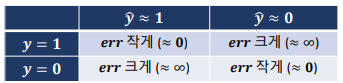
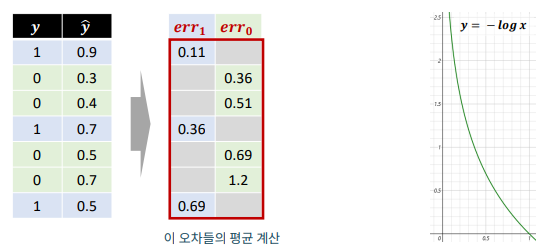
이진 분류 오차 함수
binary_crossentropy
model.compile(optimizer=Adam(learning_rate= 0.01),
loss = 'binary_crossentropy')- 이진 분류
loss function
resampling
loss(오차)를 줄이는 방향으로 학습함 - 평균으로 계산됨
from imblearn.over_sampling import RandomOverSampler

ros = RandomOverSampler()
x_resampled, y_resampled = ros.fit_resample(x_train, y_train)

clear_session()
model3 = Sequential([Input(shape = (nfeatures, )),
                     Dense(32, activation = 'relu'),
                     Dense(16, activation = 'relu'),
                     Dense(8, activation = 'relu'),
                     Dense(1, activation = 'sigmoid')])
model3.summary()
.
.
다중분류
-
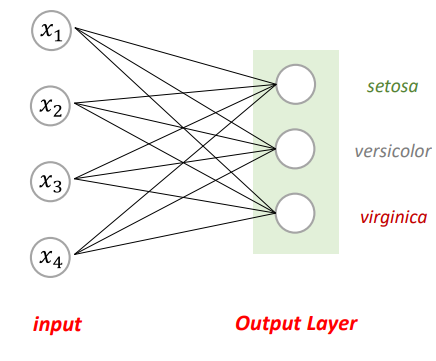
다중분류에서 output layer의 node 수는 y의 범주 수와 같다.
-
① 예측 결과 : 각 클래스별 확률값
-
② 그 중 가장 큰 값의 인덱스로 변환
np.argmax()
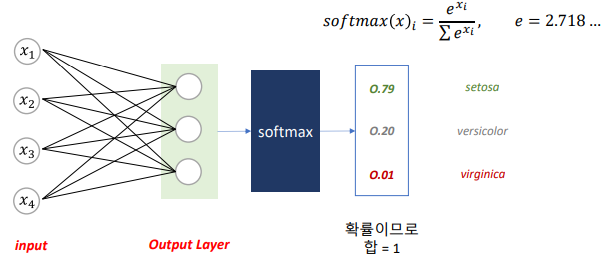
softmax
model = Sequential([Input(shape = (n, )),
Dense(3, activation='softmax')])- 다중 분류
Activation Function - 각 Class별로 예측한 값을, 하나의 확률 값으로 변환
다중 분류 오차 함수
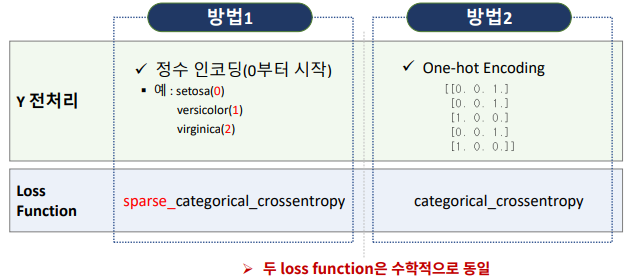
1. sparse_categorical_crossentropy
model.compile(optimizer = Adam( learning_rate = 0.1),
loss = 'sparse_categorical_crossentropy')- 정수 인코딩 +
sparse_categorical_crossentropy
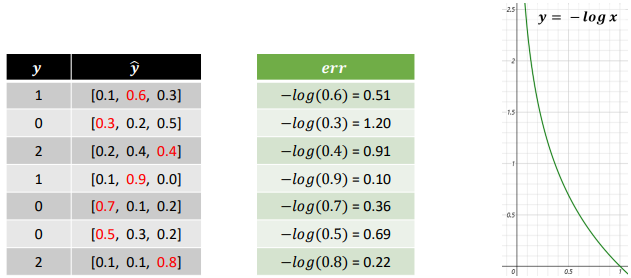
정수 인코딩
from sklearn.preprocessing import LabelEncoder
#선언
int_encoder = LabelEncoder()
#인코딩
data['Species_e'] = int_encoder.fit_trasform(data['Species'])- 인코딩된 범주 조회
int_encoder.classes_➡️ 배열의 인덱스가 인코딩 된 정수
#모델 설계
n = x_train.shape[1]
clear_session()
model = Sequential([Input(shape = (n, )),
					Dense(8, activation='relu'),
                    Dense(3, activation='softmax')])
model.summary()

#compile+학습
model.compile(optimizer = Adam( learning_rate = 0.1),
			  loss = 'sparse_categorical_crossentropy')

history = model.fit(x_train, y_train, epochs = 50,
					validation_split=0.2,).history

#그래프
dl_history_plot(history)

#예측+검증 - 예측결과는 softmax로 변환된 값
pred  = model.predict(x_val)
pred_1 = pred.argmax(axis = 1)
pred_1

print(confusion_matrix(y_val, pred_1))
print(classification_report(y_val, pred_1))
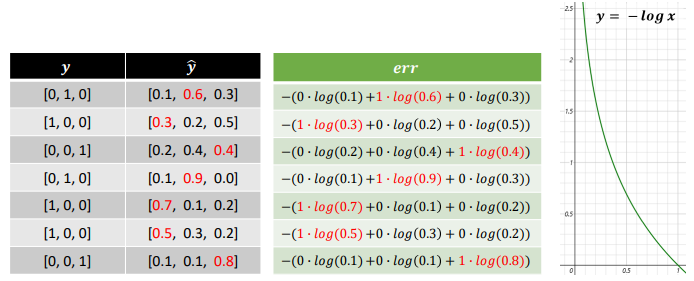
2. categorical_crossentropy
model.compile(optimizer=Adam(learning_rate=0.1),
loss='categorical_crossentropy')- 원핫 인코딩 +
categorical_crossentropy
y 를 one-hot encoding
y 가변수화 :to_categorical
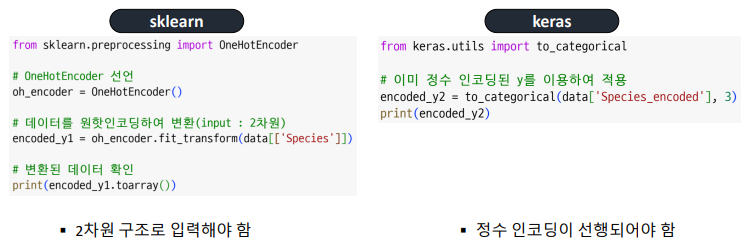
from keras.utils import to_categorical

#가변수화
y_c = to_categorical(y.values, 3)

#데이터 분할, 스케일링 진행 후
#모델 설계
n = x_train.shape[1]
clear_session()
model = Sequential([Input(shape = (n, )),
					Dense(8, activation='relu'),
                    Dense(3, activation='softmax')])
model.summary()

#compile+학습
model.compile(optimizer=Adam(learning_rate=0.1),
			  loss='categorical_crossentropy')

history = model.fit(x_train, y_train, epochs = 100,
					validation_split=0.2).history

#그래프
dl_history_plot(history)

#예측+검증 - 예측결과는 softmax로 변환된 값
pred  = model.predict(x_val)
pred_1 = pred.argmax(axis = 1)
pred_1

print(confusion_matrix(y_val, pred_1))
print(classification_report(y_val, pred_1))
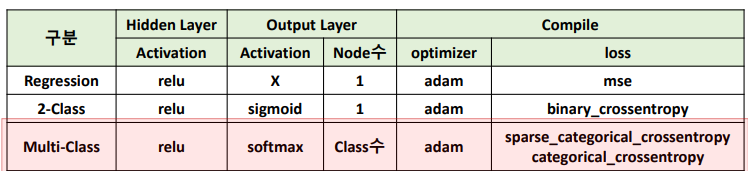
총정리
난 성미다.