1. 전이학습(Transfer Learning)
전이학습이란 이미 학습된 모델을 가져와서 활용하는 방법이다.
딥러닝 모델을 처음 만들다 보면, 레이어를 어떻게 쌓아야 할지 감이 잘 안 온다.
레이어가 많아질수록 조절해야 할 것도 많아지고,
데이터도 그만큼 많아져야 하고,
옵티마이저나 에폭 같은 하이퍼파라미터도 계속 조절해줘야 한다.
그리고 솔직히 말해서, 이런 걸 내 로컬 PC에서 돌리는 것도 꽤 부담스럽다.
게다가 데이터도 그렇게 깔끔하지 않은 경우가 많고,
모델을 잘못 쌓았는지, 아니면 학습이 안 되는 건지 잘 판단이 안 갈 때도 있다.
그런데 이미지 같은 경우는, 필터를 잘 설계해서 특징을 잘 뽑아낼 수 있도록 이미 누군가 만들어 놓은 모델들이 있다.
그리고 실제로 써보면 정확도도 꽤 잘 나온다.
1.1. 사전학습(Pretraining)
전이학습이 가능하려면, 먼저 사전학습이 되어 있어야 한다.
즉, 어떤 모델이 대규모 데이터셋을 가지고 미리 학습된 상태여야 한다는 말이다.
예를 들어 ImageNet이라는 데이터셋은
1000개 클래스에 수백만 장의 이미지가 있는 아주 큰 이미지 데이터셋인데,
이걸로 학습시킨 모델들이 공개되어 있다.
가중치도 같이 저장되어 있고, 구조도 정해져 있다.
이걸 그냥 가져다가 쓰면 된다.
이미 누군가가 잘 만든 모델이기 때문에,
적은 데이터로도 80~90% 정도 정확도가 나오는 경우도 많다.
LSTM 같은 모델을 학습해보면 알겠지만, 처음부터 학습시키는 건 진짜 쉽지 않다.
시간도 오래 걸리고, 모델이 잘 안 맞을 수도 있고, 결국 GPU 없으면 속도도 안 나오고.
그런데 이런 상황에서도, 이미 잘 학습된 모델을 가져다 쓰면
훨씬 더 빠르게, 적은 데이터로도 좋은 성능을 낼 수 있다.
이게 바로 전이학습의 핵심이다.
1.2. 전이학습을 적용 방법
특징 추출 (Feature Extraction)
기존 모델의 가중치를 그대로 사용하고
마지막 출력층만 내가 가진 문제에 맞게 새로 학습하는 방법이다.
파인튜닝 (Fine-tuning)
기존 모델의 일부 또는 전부를 더 학습시키는 방식이다.
보통 마지막 몇 개 레이어만 열어두고(trainable) 나머지는 고정(freeze)한다.
1.3. 대표적인 사전학습 모델
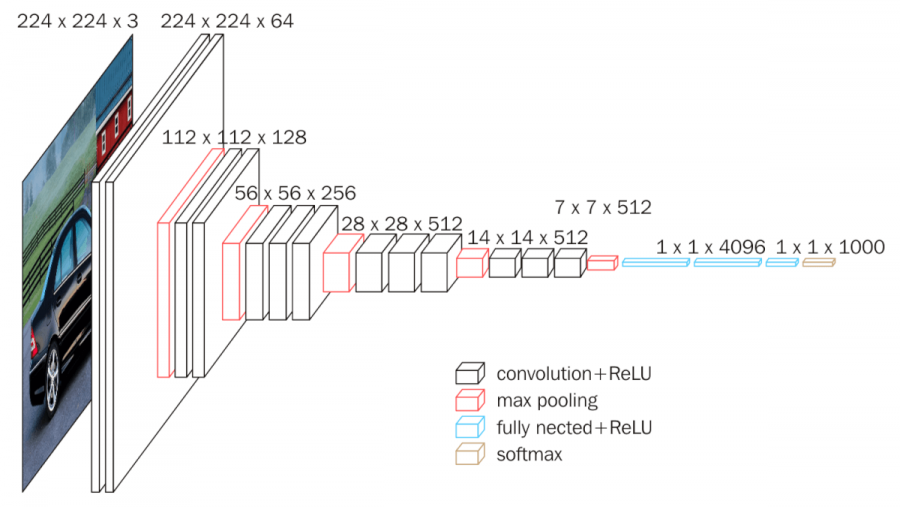
VGG16
VGG는 구조가 단순하고 이해하기 쉬운 모델이다.
필터를 순차적으로 쌓아서 특징을 추출한다.
다만 파라미터 수가 많아서 모델이 좀 무겁긴 하다.
출처: https://hnsuk.tistory.com/30
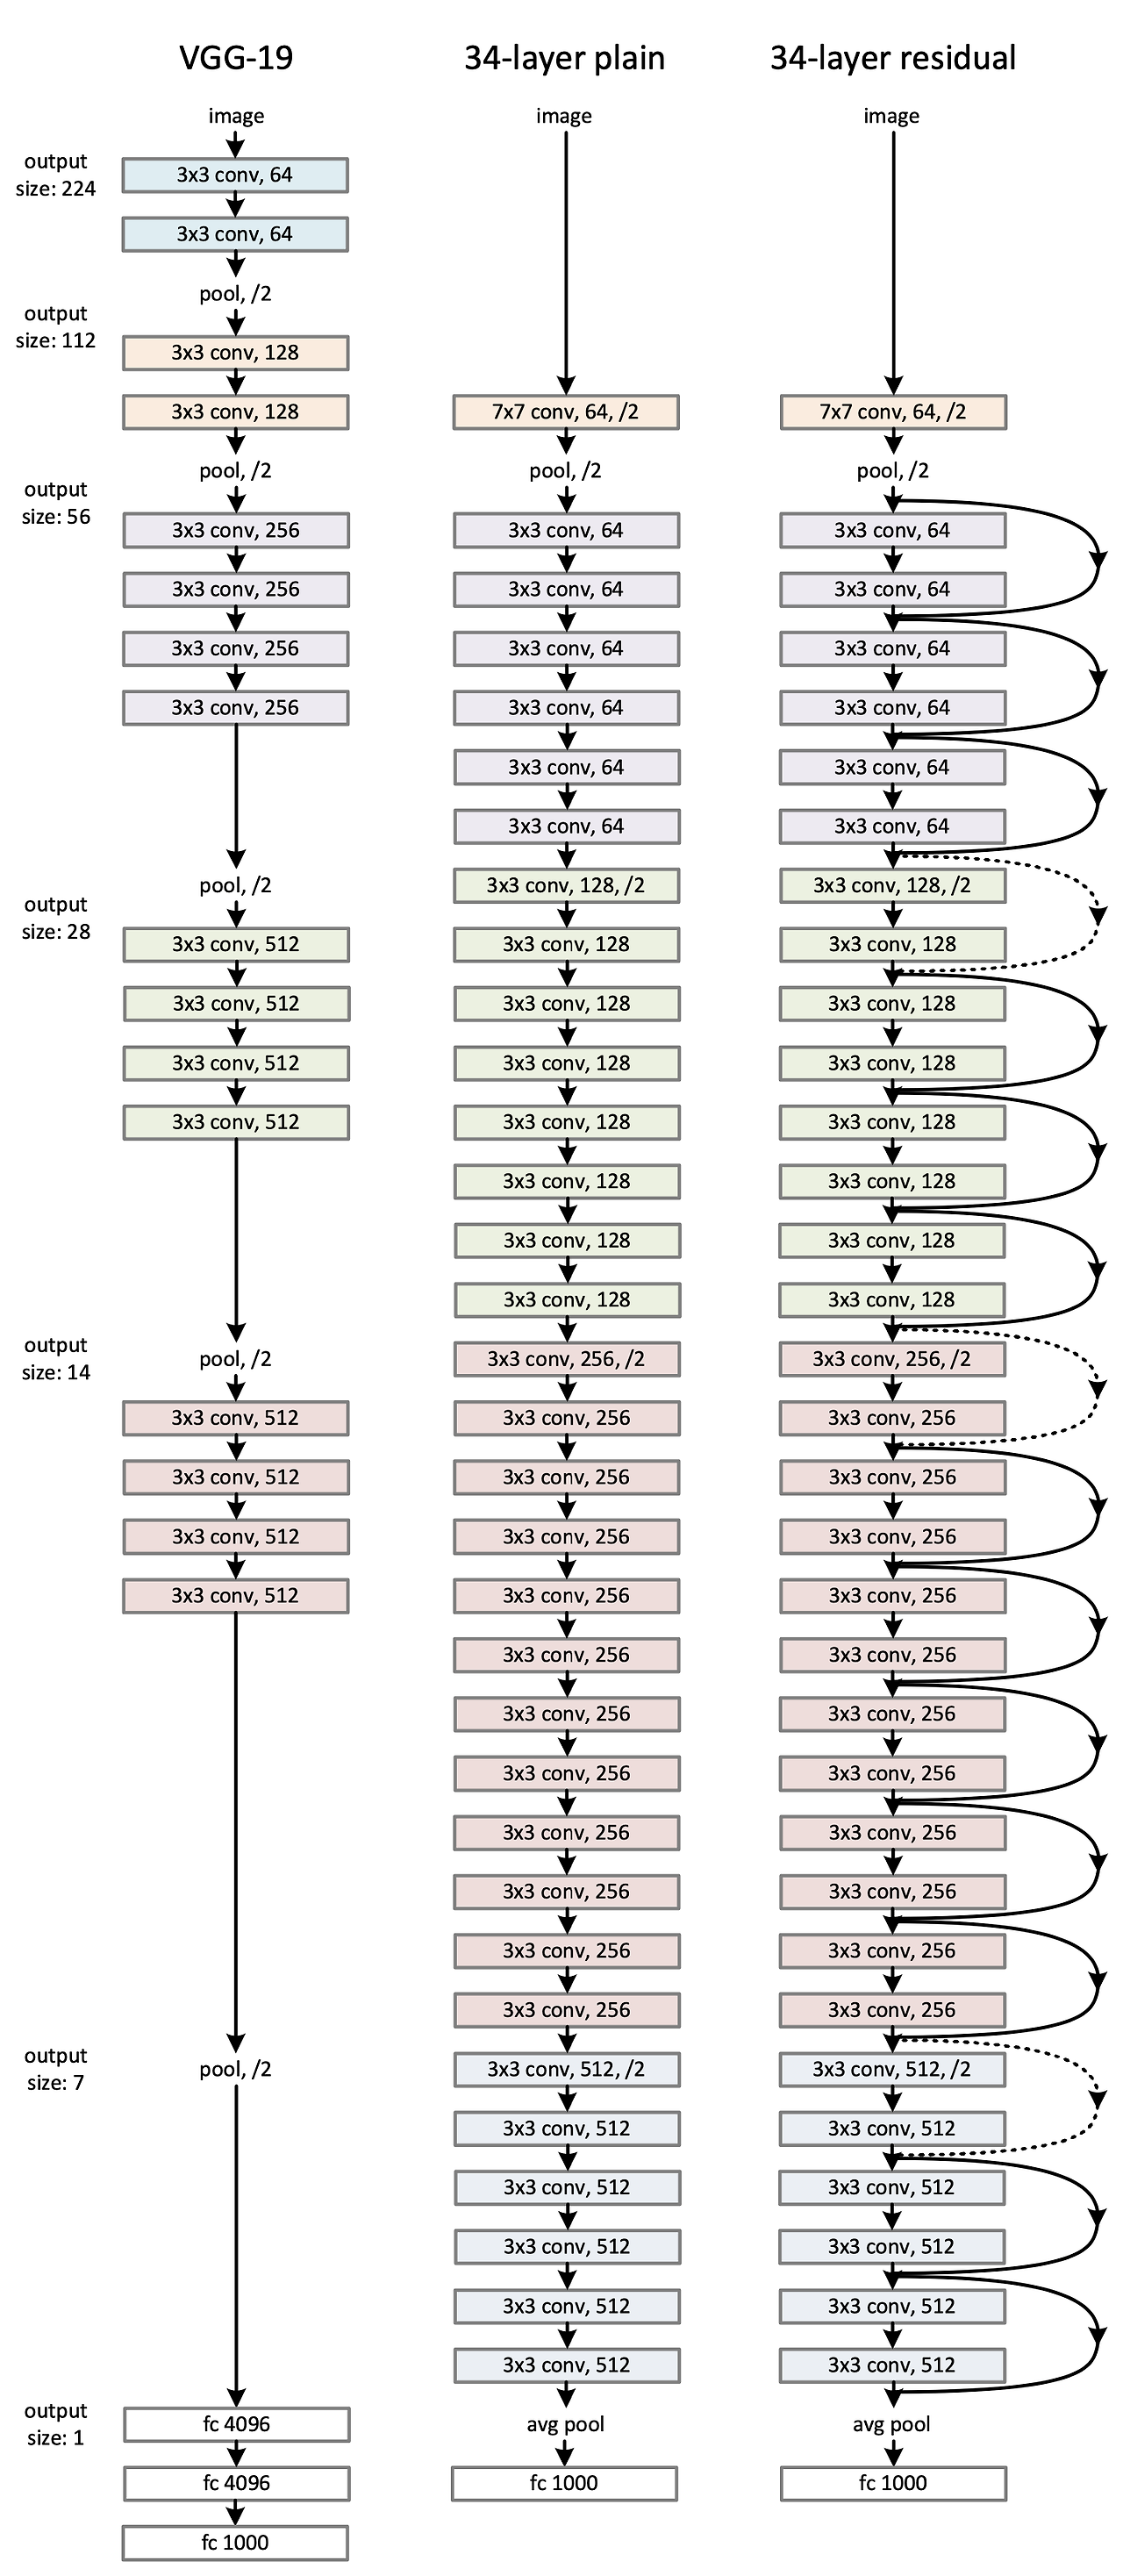
ResNet
ResNet은 기본적으로 VGG-19구조를 뼈대로하여 만들어놓았는데,
층이 깊어지면 생기는 문제를 스킵 커넥션(skip connection) 으로 해결한다.
아래를 보면 굉장히 복잡하긴 하지만, 그만큼 성능도 좋다.
출처: https://wjunsea.tistory.com/99
1.4. 정리
정리하자면 전이학습이란 사전학습된 모델을 가져와서 특정한 문제에 맞게 새로 조정해서 쓰는 방법이며,
내가 가진 데이터가 적거나, 빠르게 정확도를 높이고 싶거나, 실무에서 복잡한 모델을 처음부터 다시 만들기 어려운 상황일때 사용한다.
잘 만든 걸 잘 쓰는 법을 배워야 한다.
그렇다면 이제 VGG16부터 코드로 알아보자.
2. VGG16
2.1. 데이터 전처리 및 증강
# Train Data
# Train Data
train_data_gen=ImageDataGenerator(rescale=1/255.0,       # 정규화
                                horizontal_flip=True,
                                width_shift_range=0.1,
                                height_shift_range=0.1,  # 이미지가 많이 왜곡되면 치매 진단에서 중요한 시각적 정보가 손실될 수 있어, 간단한 이동과 반전만 사용
                                fill_mode='nearest')     # 이동이나 변형으로 인해 생긴 빈 픽셀을 가장 가까운 값으로 채우기

train_generator=train_data_gen.flow_from_directory('data/dementia/train',
                                                target_size=(150,150),  # 불러오는 이미지 사이즈 조정
                                                batch_size=5,           # 한번에 5개씩 가져오기
                                                class_mode='sparse')    # 정수형 라벨 (0, 1, ...) 반환 → sparse_categorical_crossentropy 사용
                                                                        # sparse를 쓸 거면 모델 출력층도 softmax, loss도 sparse_categorical_crossentropy
                                                                        # or one-hot 인코딩 라벨 반환 → categorical_crossentropy 사용
                                                                        # 이진 분류 (0 또는 1만) → sigmoid 출력층 + binary_crossentropy 사용

train_generator.class_indices  # 클래스 구성 확인
Found 161 images belonging to 2 classes.
{'ad': 0, 'normal': 1}# Test Data
test_data_gen=ImageDataGenerator(rescale=1/255.0) # 정규화만
test_generator=test_data_gen.flow_from_directory('data/dementia/test',
target_size=(150,150),
batch_size=5,
class_mode='sparse')
test_generator.class_indicesFound 121 images belonging to 2 classes.
{'ad': 0, 'normal': 1}train_generator: batch_size=5
test_generator: batch_size=5
잘 기억하기!
2.2. VGG16 신경망 모델 불러오기
- https://www.tensorflow.org/api_docs/python/tf/keras/applications/VGG16
- https://www.image-net.org/ (14,197,122 장 학습)
지난 CNN 신경망을 다시 본다면
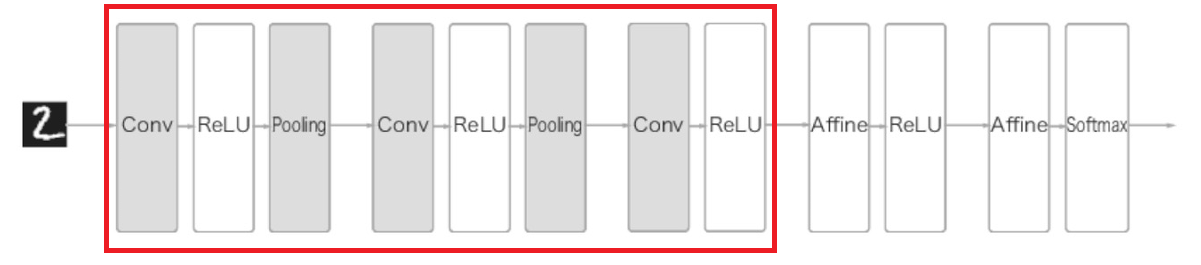
이 앞선 부분이 VGG16인 것이다.
from keras.applications import VGG16

transfer_model=VGG16(weights='imagenet',        # imagenet에서 14,197,122장 정도를 학습한 가중치를 사용한다.
                    include_top=False,          # 새로운 출력층인 완전 연결층(Affine 계층) 3개는 내꺼로 진행한다. → 기존 출력층 제거
                    input_shape=(150, 150, 3))  # 원래는 흑백이여서 1인데, imagenet은 컬러로 학습해서 3으로 사용해야한다.
                                                # 학습에는 문제 없이 잘 나온다.

transfer_model.trainable=False                  # VGG16 모델의 가중치가 변하면 안되기에 False -> 만약 파인튜닝이라면 True
transfer_model.summary()
Downloading data from https://storage.googleapis.com/tensorflow/keras-applications/vgg16/vgg16_weights_tf_dim_ordering_tf_kernels_notop.h5
[1m58889256/58889256[0m [32m━━━━━━━━━━━━━━━━━━━━[0m[37m[0m [1m3s[0m 0us/step
Model: "vgg16"┏━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━┳━━━━━━━━━━━━━━━━━━━━━━━━┳━━━━━━━━━━━━━━━┓ ┃ Layer (type) ┃ Output Shape ┃ Param # ┃ ┡━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━╇━━━━━━━━━━━━━━━━━━━━━━━━╇━━━━━━━━━━━━━━━┩ │ input_layer (InputLayer) │ (None, 150, 150, 3) │ 0 │ ├─────────────────────────────────┼────────────────────────┼───────────────┤ │ block1_conv1 (Conv2D) │ (None, 150, 150, 64) │ 1,792 │ ├─────────────────────────────────┼────────────────────────┼───────────────┤ │ block1_conv2 (Conv2D) │ (None, 150, 150, 64) │ 36,928 │ ├─────────────────────────────────┼────────────────────────┼───────────────┤ │ block1_pool (MaxPooling2D) │ (None, 75, 75, 64) │ 0 │ ├─────────────────────────────────┼────────────────────────┼───────────────┤ │ block2_conv1 (Conv2D) │ (None, 75, 75, 128) │ 73,856 │ ├─────────────────────────────────┼────────────────────────┼───────────────┤ │ block2_conv2 (Conv2D) │ (None, 75, 75, 128) │ 147,584 │ ├─────────────────────────────────┼────────────────────────┼───────────────┤ │ block2_pool (MaxPooling2D) │ (None, 37, 37, 128) │ 0 │ ├─────────────────────────────────┼────────────────────────┼───────────────┤ │ block3_conv1 (Conv2D) │ (None, 37, 37, 256) │ 295,168 │ ├─────────────────────────────────┼────────────────────────┼───────────────┤ │ block3_conv2 (Conv2D) │ (None, 37, 37, 256) │ 590,080 │ ├─────────────────────────────────┼────────────────────────┼───────────────┤ │ block3_conv3 (Conv2D) │ (None, 37, 37, 256) │ 590,080 │ ├─────────────────────────────────┼────────────────────────┼───────────────┤ │ block3_pool (MaxPooling2D) │ (None, 18, 18, 256) │ 0 │ ├─────────────────────────────────┼────────────────────────┼───────────────┤ │ block4_conv1 (Conv2D) │ (None, 18, 18, 512) │ 1,180,160 │ ├─────────────────────────────────┼────────────────────────┼───────────────┤ │ block4_conv2 (Conv2D) │ (None, 18, 18, 512) │ 2,359,808 │ ├─────────────────────────────────┼────────────────────────┼───────────────┤ │ block4_conv3 (Conv2D) │ (None, 18, 18, 512) │ 2,359,808 │ ├─────────────────────────────────┼────────────────────────┼───────────────┤ │ block4_pool (MaxPooling2D) │ (None, 9, 9, 512) │ 0 │ ├─────────────────────────────────┼────────────────────────┼───────────────┤ │ block5_conv1 (Conv2D) │ (None, 9, 9, 512) │ 2,359,808 │ ├─────────────────────────────────┼────────────────────────┼───────────────┤ │ block5_conv2 (Conv2D) │ (None, 9, 9, 512) │ 2,359,808 │ ├─────────────────────────────────┼────────────────────────┼───────────────┤ │ block5_conv3 (Conv2D) │ (None, 9, 9, 512) │ 2,359,808 │ ├─────────────────────────────────┼────────────────────────┼───────────────┤ │ block5_pool (MaxPooling2D) │ (None, 4, 4, 512) │ 0 │ └─────────────────────────────────┴────────────────────────┴───────────────┘
Total params: 14,714,688 (56.13 MB)
Trainable params: 0 (0.00 B)
Non-trainable params: 14,714,688 (56.13 MB)
이제 이 VGG16과 사용자 계층을 붙여줘야한다.
즉 여기만 우리가 건드리면 된다.
model=keras.Sequential()
model.add(transfer_model)

model.add(keras.layers.Flatten())
model.add(keras.layers.Dense(64, activation='relu'))
model.add(keras.layers.Dense(2, activation='softmax'))
model.summary()
Model: "sequential"┏━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━┳━━━━━━━━━━━━━━━━━━━━━━━━┳━━━━━━━━━━━━━━━┓ ┃ Layer (type) ┃ Output Shape ┃ Param # ┃ ┡━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━╇━━━━━━━━━━━━━━━━━━━━━━━━╇━━━━━━━━━━━━━━━┩ │ vgg16 (Functional) │ (None, 4, 4, 512) │ 14,714,688 │ ├─────────────────────────────────┼────────────────────────┼───────────────┤ │ flatten (Flatten) │ (None, 8192) │ 0 │ ├─────────────────────────────────┼────────────────────────┼───────────────┤ │ dense (Dense) │ (None, 64) │ 524,352 │ ├─────────────────────────────────┼────────────────────────┼───────────────┤ │ dense_1 (Dense) │ (None, 2) │ 130 │ └─────────────────────────────────┴────────────────────────┴───────────────┘
Total params: 15,239,170 (58.13 MB)
Trainable params: 524,482 (2.00 MB)
Non-trainable params: 14,714,688 (56.13 MB)
이렇게 내가 쌓은 층까지 추가가 됐다.
이런식으로 다른 VGG뿐만 아닌 다른 것들도 이와 비슷하고 import와 이름만 바뀌는 것이다.
2.3. 모델 학습 및 실행
model.compile(optimizer=Adam(learning_rate=0.0002),
            loss='sparse_categorical_crossentropy',
            metrics=['accuracy'])

early_stopping_callback = EarlyStopping(monitor='val_loss', patience=5)

# batch_size는 이미 train_generator에서 이미 batch_size=5로 설정했기 때문에 5개씩 가져오기 때문에 따로 설정안함
history=model.fit(train_generator,
                epochs=20,
                validation_data=test_generator,  # 아래 설명으로
                validation_steps=24,
                callbacks=[early_stopping_callback])

# 배치 크기는 각각의 generator 안에서 5로 적용했음
# test_generator도 batch_size=5로 설정했었음
# 따라서 validation_steps=24 -> 1 에폭당 검증 데이터 5장 x 24배치 = 120장 사용
# train_generator의 batch_size와는 별개임
Epoch 1/20
33/33 ━━━━━━━━━━━━━━━━━━━━ 19s 521ms/step - accuracy: 0.6099 - loss: 0.6877 - val_accuracy: 0.7333 - val_loss: 0.5071
Epoch 2/20
33/33 ━━━━━━━━━━━━━━━━━━━━ 16s 500ms/step - accuracy: 0.7872 - loss: 0.4430 - val_accuracy: 0.9000 - val_loss: 0.3530
Epoch 3/20
33/33 ━━━━━━━━━━━━━━━━━━━━ 16s 496ms/step - accuracy: 0.9210 - loss: 0.3045 - val_accuracy: 0.9333 - val_loss: 0.2709
...
...
Epoch 19/20
33/33 ━━━━━━━━━━━━━━━━━━━━ 19s 573ms/step - accuracy: 0.9729 - loss: 0.0755 - val_accuracy: 0.9167 - val_loss: 0.2215
Epoch 20/20
33/33 ━━━━━━━━━━━━━━━━━━━━ 16s 498ms/step - accuracy: 0.9651 - loss: 0.0915 - val_accuracy: 0.9667 - val_loss: 0.0935model.evaluate(test_generator) # [loss, accuracy][1m25/25[0m [32m━━━━━━━━━━━━━━━━━━━━[0m[37m[0m [1m7s[0m 290ms/step - accuracy: 0.9430 - loss: 0.1490
[0.09289711713790894, 0.9669421315193176]plt.plot(history.history['accuracy'], label='train accuracy', color='red')
plt.plot(history.history['val_accuracy'], label='validation accuracy', color='lightcoral')
plt.plot(history.history['loss'], label='train loss', color='blue')
plt.plot(history.history['val_loss'], label='validation loss', color='cornflowerblue')
plt.legend()
plt.xlabel('epochs')
plt.ylabel('accuray/loss')
plt.show()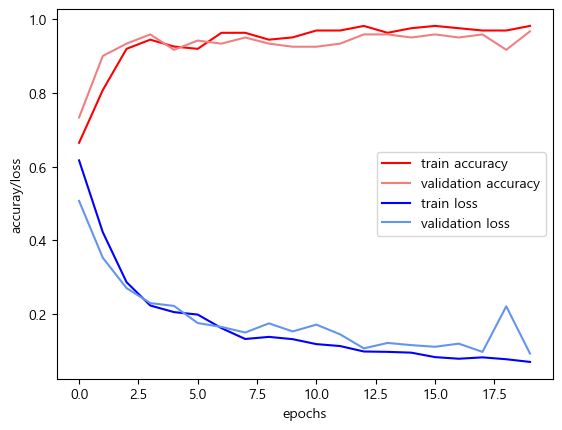
steps=test_generator.n // 5     # 랜덤으로 가져옴 -> 테스트 데이터 전체(test_generator.n) // 5(batch_size)
                                # test_generator.n -> 전체 테스트 이미지 수
                                # 예: 121장 // 5 -> 배치 크기가 5였기 때문에, 총 배치 수는 121 // 5 = 24
                                # 즉, 24번 배치를 꺼내면 테스트 데이터를 거의 모두 가져올 수 있다는 뜻
print(test_generator.n)
print(steps)
121
24images, labels=[], []
for i in range(steps):
image, label=next(test_generator) # test_generator는 flow_from_directory로 만든 generator 객체이기 때문에,
# next(generator)를 호출하면 한 배치(batch_size=5)만큼의 이미지와 라벨을 반환해준다.
# 즉, image.shape -> (5, 150, 150, 3), label.shape -> (5,)
# 그래서 for i in range(steps) 안에서 이걸 반복 호출하면서 전체 데이터를 꺼내는 구조다.
# append -> [o, o, o] / extend -> [[o, o], [o, o], [o, o]]
# 리스트에 하나씩 넣기
images.extend(image)
labels.extend(label)
# 리스트를 다시 numpy 배열로
# image, label을 배치 단위로 꺼냈기 때문에, 리스트에 하나씩 .extend()로 붙여서 전체 데이터로 만들고 있다.
# 이렇게 만든 리스트는 학습용이나 예측용으로 쓰기 전에 넘파이 배열로 변환해야 함
# 모델 입력은 보통 numpy.ndarray 형태를 받음
# .astype(int)는 라벨의 타입이 float여서 정수형으로 맞춰주는 것
images=np.asarray(images)
labels=np.asarray(labels).astype(int)
labels[0]np.int64(1)2.4. 결과 예측
pred_prob=model.predict(images)  # images -> 테스트 이미지 전체 (numpy.ndarray, shape: (120, 150, 150, 3) 정도)
pred_prob[0]
array([0.0400799 , 0.95992005], dtype=float32)softmax이므로 -> 0.95992005 -> 1이므로 둘중에 큰 값 가져오자
pred=np.argmax(pred_prob, axis=1)
pred[0]np.int64(1)1 -> 정상 / 0 -> 비정상(치매)
plt.imshow(images[0])
plt.title(f"Pred:{pred[0]}, Real:{labels[0]}")
plt.show()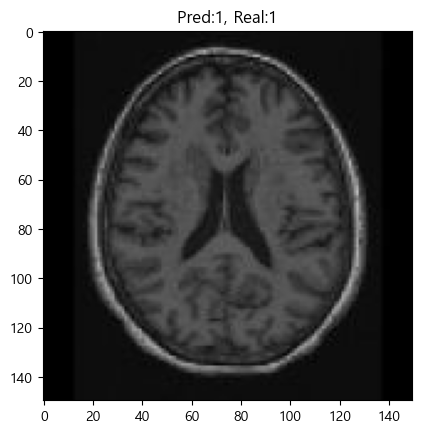
fig, axes=plt.subplots(2,5,figsize=(10,5))

# axes는 2행 5열 subplot 구조 -> 2D 배열 형태
# images[:10]은 1D 리스트니까, 2D인 axes를 맞춰주기 위해 .flat으로 1D로 바꿔야한다.
# -> [axes[0,0], axes[0,1], ..., axes[1,4]]
for ax, image, pre, label in zip(axes.flat, images[:10], pred[:10], labels[:10]):
    ax.imshow(image)
    ax.set_xlabel(f"pred:{pre}, Real:{label}")

    # 문제 발생 -> label까지 다 안나옴
    # ax.axis('off')
    # 따라서 아래꺼로 사용해야함
    ax.set_xticks([])  # x축 눈금 제거
    ax.set_yticks([])  # y축 눈금 제거

plt.tight_layout()
plt.show()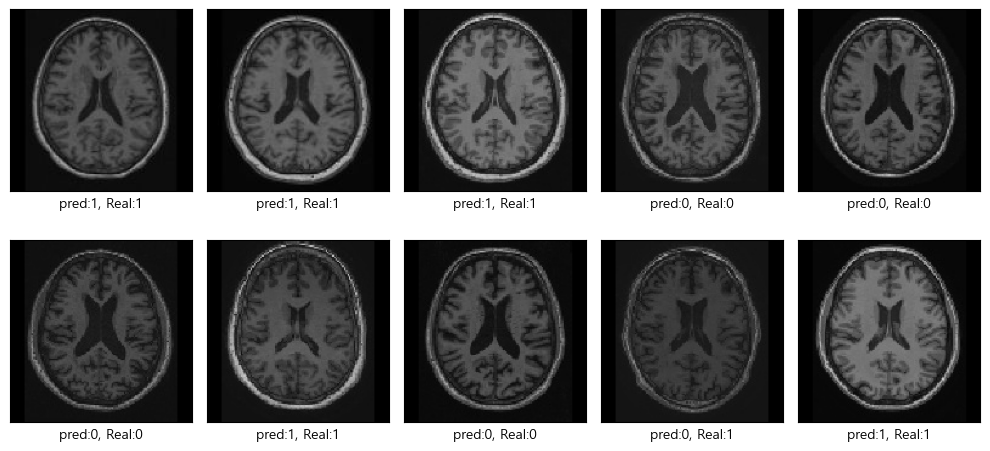
print(metrics.classification_report(labels, pred))precision recall f1-score support
0 0.95 0.98 0.97 60
1 0.98 0.95 0.97 60
accuracy 0.97 120
macro avg 0.97 0.97 0.97 120
weighted avg 0.97 0.97 0.97 1203. ResNet50
그렇다면 이번에는 ResNet50 신경망으로 돌려보자.
VGG와 똑같이 진행하고 클래스만 바꿔서 진행한다.
3.1. 데이터 전처리 및 증강
# Train Data
train_data_gen=ImageDataGenerator(rescale=1/255.0, horizontal_flip=True, width_shift_range=0.1, height_shift_range=0.1, fill_mode='nearest')

# 정수형 라벨 (0, 1, ...) 반환 → sparse_categorical_crossentropy 사용
# sparse를 쓸 거면 모델 출력층도 softmax, loss도 sparse_categorical_crossentropy
train_generator=train_data_gen.flow_from_directory('data/dementia/train', target_size=(150,150), batch_size=5, class_mode='sparse')

train_generator.class_indices  # 클래스 구성 확인
Found 161 images belonging to 2 classes.
{'ad': 0, 'normal': 1}# Test Data
test_data_gen=ImageDataGenerator(rescale=1/255.0) # 정규화만
test_generator=test_data_gen.flow_from_directory('data/dementia/test', target_size=(150,150), batch_size=5, class_mode='sparse')
test_generator.class_indices # 클래스 구성 확인Found 121 images belonging to 2 classes.
{'ad': 0, 'normal': 1}train_generator: batch_size=5
test_generator: batch_size=5
3.2. ResNet50 신경망 모델 불러오기
from keras.applications import ResNet50

transfer_model=ResNet50(weights='imagenet', include_top=False, input_shape=(150, 150, 3))
transfer_model.trainable=False  # ResNet50의 가중치도 학습 중에 변하지 않도록
transfer_model.summary()
Model: "resnet50"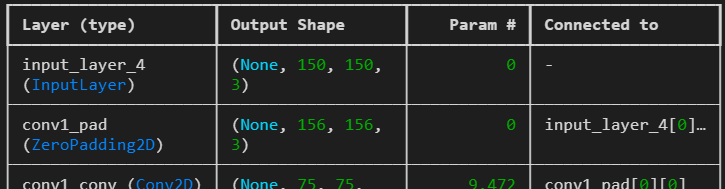
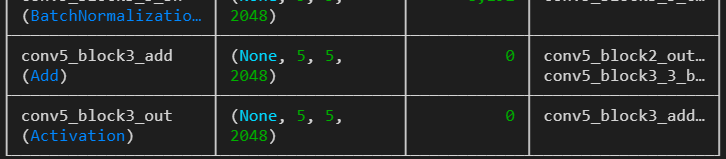
 Total params: 23,587,712 (89.98 MB)
 Trainable params: 0 (0.00 B)
 Non-trainable params: 23,587,712 (89.98 MB)
# ResNet50에 내꺼 추가
model=keras.Sequential()
model.add(transfer_model)
model.add(keras.layers.Flatten())
model.add(keras.layers.Dense(64, activation='relu'))
model.add(keras.layers.Dense(2, activation='softmax'))
model.summary()Model: "sequential_2"┏━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━┳━━━━━━━━━━━━━━━━━━━━━━━━┳━━━━━━━━━━━━━━━┓ ┃ Layer (type) ┃ Output Shape ┃ Param # ┃ ┡━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━╇━━━━━━━━━━━━━━━━━━━━━━━━╇━━━━━━━━━━━━━━━┩ │ resnet50 (Functional) │ (None, 5, 5, 2048) │ 23,587,712 │ ├─────────────────────────────────┼────────────────────────┼───────────────┤ │ flatten_2 (Flatten) │ (None, 51200) │ 0 │ ├─────────────────────────────────┼────────────────────────┼───────────────┤ │ dense_4 (Dense) │ (None, 64) │ 3,276,864 │ ├─────────────────────────────────┼────────────────────────┼───────────────┤ │ dense_5 (Dense) │ (None, 2) │ 130 │ └─────────────────────────────────┴────────────────────────┴───────────────┘
 Total params: 26,864,706 (102.48 MB)
 Trainable params: 3,276,994 (12.50 MB)
 Non-trainable params: 23,587,712 (89.98 MB)
3.3. 모델 학습 및 실행
model.compile(optimizer=Adam(learning_rate=0.0002),
            loss='sparse_categorical_crossentropy',
            metrics=['accuracy'])

early_stopping_callback = EarlyStopping(monitor='val_loss', patience=5)

history=model.fit(train_generator,
                epochs=20,
                validation_data=test_generator,
                validation_steps=24,
                callbacks=[early_stopping_callback])
Epoch 1/20
33/33 ━━━━━━━━━━━━━━━━━━━━ 28s 461ms/step - accuracy: 0.5718 - loss: 0.6938 - val_accuracy: 0.4917 - val_loss: 0.6903
Epoch 2/20
33/33 ━━━━━━━━━━━━━━━━━━━━ 12s 368ms/step - accuracy: 0.4922 - loss: 0.6948 - val_accuracy: 0.5083 - val_loss: 0.6876
Epoch 3/20
33/33 ━━━━━━━━━━━━━━━━━━━━ 11s 327ms/step - accuracy: 0.5076 - loss: 0.6913 - val_accuracy: 0.5083 - val_loss: 0.6854
Epoch 4/20
33/33 ━━━━━━━━━━━━━━━━━━━━ 12s 358ms/step - accuracy: 0.5138 - loss: 0.6987 - val_accuracy: 0.5000 - val_loss: 0.6939
...
...
...
Epoch 19/20
33/33 ━━━━━━━━━━━━━━━━━━━━ 10s 291ms/step - accuracy: 0.5901 - loss: 0.6410 - val_accuracy: 0.5750 - val_loss: 0.6616
Epoch 20/20
33/33 ━━━━━━━━━━━━━━━━━━━━ 9s 287ms/step - accuracy: 0.5725 - loss: 0.6576 - val_accuracy: 0.6667 - val_loss: 0.6536
보면 이전 VGG보다 성능이 더 떨어진다.
좋지는 않지만 일단은 성능을 보면
model.evaluate(test_generator)[1m25/25[0m [32m━━━━━━━━━━━━━━━━━━━━[0m[37m[0m [1m5s[0m 197ms/step - accuracy: 0.6481 - loss: 0.6729
[0.6549509763717651, 0.6611570119857788]plt.plot(history.history['accuracy'], label='train accuracy', color='red')
plt.plot(history.history['val_accuracy'], label='validation accuracy', color='lightcoral')
plt.plot(history.history['loss'], label='train loss', color='blue')
plt.plot(history.history['val_loss'], label='validation loss', color='cornflowerblue')
plt.legend()
plt.xlabel('epochs')
plt.ylabel('accuray/loss')
plt.show()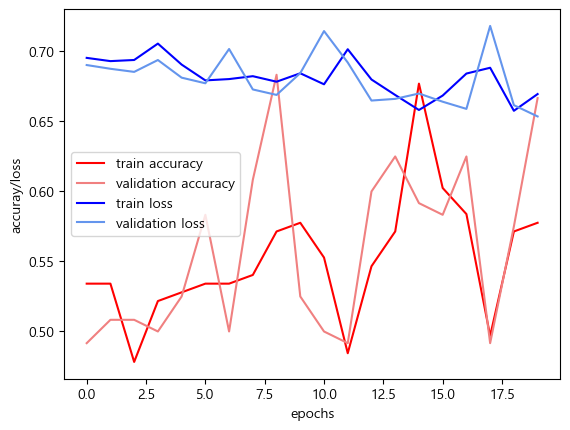
steps=test_generator.n // 5

images, labels=[], []
for i in range(steps):
    image, label=next(test_generator)
    images.extend(image)
    labels.extend(label)
images=np.asarray(images)
labels=np.asarray(labels).astype(int)
labels[0]np.int64(0)랜덤으로 뽑기 때문에 VGG와 결과가 다룰 수 있다.
3.4. 결과 예측
pred_prob=model.predict(images)
pred_prob[0]
array([0.55674314, 0.4432569 ], dtype=float32)pred=np.argmax(pred_prob, axis=1)
pred[0]np.int64(0)plt.imshow(images[0])
plt.title(f"Pred:{pred[0]}, Real:{labels[0]}")
plt.show()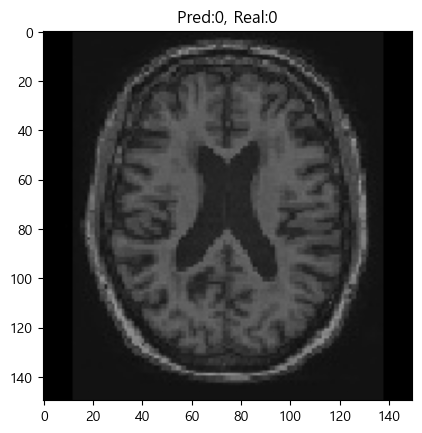
fig, axes=plt.subplots(2,5,figsize=(10,5))

for ax, image, pre, label in zip(axes.flat, images[:10], pred[:10], labels[:10]):
    ax.imshow(image)
    ax.set_xlabel(f"pred:{pre}, Real:{label}")
    ax.set_xticks([])
    ax.set_yticks([])
plt.tight_layout()
plt.show()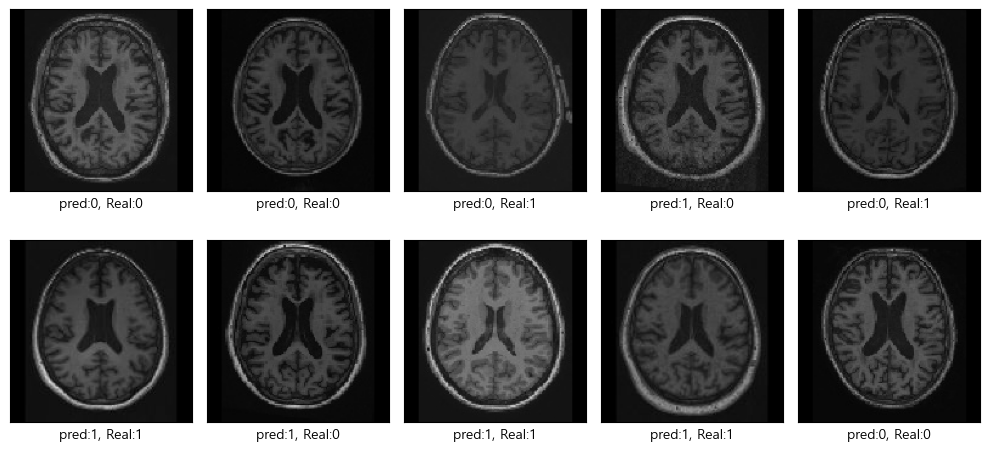
이렇게 예측과 실제가 벗어나는 경우가 꽤 보인다.
print(metrics.classification_report(labels, pred))precision recall f1-score support
0 0.68 0.63 0.66 60
1 0.66 0.70 0.68 60
accuracy 0.67 120
macro avg 0.67 0.67 0.67 120
weighted avg 0.67 0.67 0.67 120