1. 시계열 프로젝트
지난 기간동안 시계열 기반 태양광 발전량 예측 프로젝트를 진행했다.
지난 머신러닝 프로젝트에서는 따로 정리를 하지 못했는데, 이번 5월 연휴에 맞아 시간이 되어 정리하게 되었다.
기상 및 미세먼지 데이터를 활용하여 태양광 발전량을 시계열 모델로 예측하는 프로젝트다.
기상청 ASOS 관측자료, 미세먼지(PM), 발전소 발전량 데이터를 수집하여 SARIMAX와 Deep Learning 모델인 LSTM과 GRU, Machine Learning 모델인 Random Forest, XGBoost, LightGBM 의 다양한 시계열 모델을 실험했다.
- [프로젝트 주제]: 영암 태양광 발전소 발전량 예측 프로젝트
- [프로젝트 기간]: 2025.04.18 ~ 2025.04.30
- [데이터 수집 및 추출]:
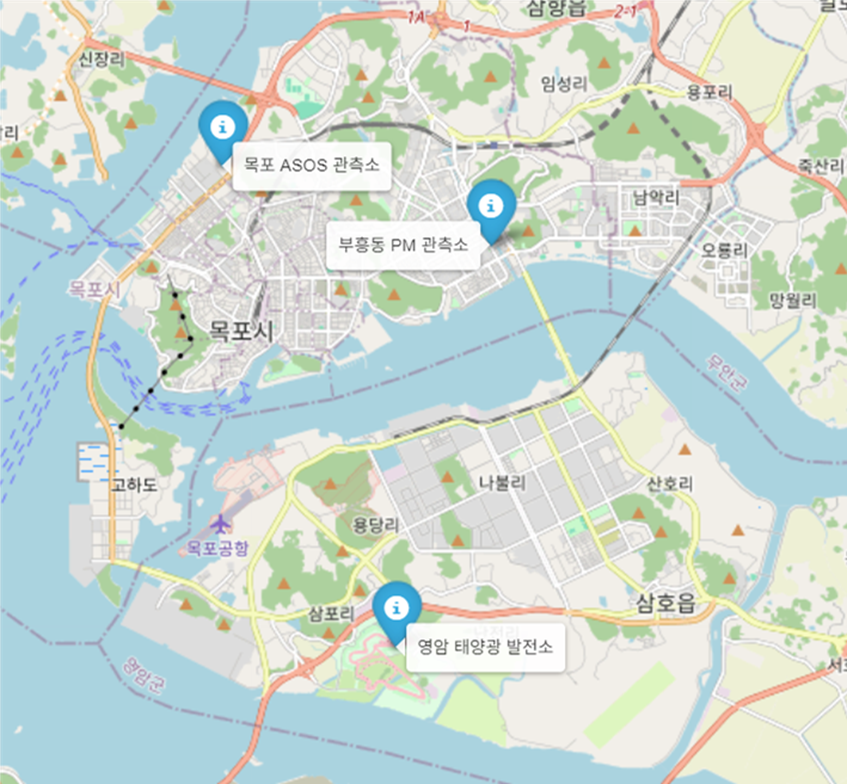
- 태양광 발전량 데이터:
영암 태양광 발전소
공공데이터포털
한국농어촌공사_영암 태양광 발전소 발전량 현황
https://www.data.go.kr/data/15005796/fileData.do - 기상 데이터
- ASOS
목포 ASOS 관측소
기상청 기상자료개방포털
종관기상관측(ASOS) 자료
https://data.kma.go.kr/data/grnd/selectAsosRltmList.do - 미세먼지 (PM10, PM2.5)
부흥동 PM 관측소
에어코리아
최종확정 측정자료 조회
https://www.airkorea.or.kr/web/pastSearch
- ASOS
- 태양광 발전량 데이터:
1.1. 데이터 전처리
먼저 메인 데이터인 영암 태양광 데이터와 목포 ASOS에 대한 전처리 후 병합하고, 마지막에 PM데이터까지 병합한다.
1.1.1. 영암 태양광 데이터 샘플
| datetime | 발전량 | 시간 | |
|---|---|---|---|
| 0 | 2016-01-01 00:00:00 | 0.0 | 0 |
| 1 | 2016-01-01 01:00:00 | 0.0 | 1 |
| 2 | 2016-01-01 02:00:00 | 0.0 | 2 |
| 3 | 2016-01-01 03:00:00 | 0.0 | 3 |
| 4 | 2016-01-01 04:00:00 | 0.0 | 4 |
여기서 발전량에 결측치는 0으로 채우고, 시간 컬럼은 우선 삭제한다.
1.1.2. ASOS 데이터
| 일시 | 기온(°C) | 강수량(mm) | 풍속(m/s) | 풍향(16방위) | 습도(%) | 증기압(hPa) | 이슬점온도(°C) | 현지기압(hPa) | 해면기압(hPa) | ... | 중하층운량(10분위) | 운형(운형약어) | 최저운고(100m ) | 시정(10m) | 현상번호(국내식) | 지면온도(°C) | 5cm 지중온도(°C) | 10cm 지중온도(°C) | 20cm 지중온도(°C) | 30cm 지중온도(°C) | |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 0 | 2016-01-01 00:00 | 3.2 | NaN | 0.2 | 0.0 | 73.0 | 5.6 | -1.1 | 1029.3 | 1034.1 | ... | 7.0 | Sc | 10.0 | 600.0 | 19.0 | 3.9 | 5.5 | 6.1 | 7.2 | 7.7 |
| 1 | 2016-01-01 01:00 | 3.0 | NaN | 0.7 | 160.0 | 78.0 | 5.9 | -0.4 | 1028.8 | 1033.6 | ... | NaN | NaN | NaN | 500.0 | 19.0 | 3.1 | 5.4 | 6.0 | 7.1 | 7.7 |
| 2 | 2016-01-01 02:00 | 2.7 | NaN | 1.0 | 180.0 | 80.0 | 5.9 | -0.4 | 1028.6 | 1033.4 | ... | NaN | NaN | NaN | 460.0 | 19.0 | 2.3 | 5.1 | 5.9 | 7.1 | 7.7 |
| 3 | 2016-01-01 03:00 | 2.2 | NaN | 1.3 | 160.0 | 87.0 | 6.2 | 0.2 | 1028.1 | 1032.9 | ... | 4.0 | Sc | 10.0 | 500.0 | 19.0 | 1.7 | 4.7 | 5.7 | 7.0 | 7.6 |
| 4 | 2016-01-01 04:00 | 1.6 | NaN | 1.7 | 160.0 | 90.0 | 6.2 | 0.1 | 1027.9 | 1032.7 | ... | 0.0 | NaN | NaN | 300.0 | 19.0 | 1.4 | 4.4 | 5.5 | 6.9 | 7.6 |
5 rows × 25 columns
이 ASOS 데이터 전처리 및 결측치 처리 과정은 다음과 같다.
-
시간
일시 → datetime으로 변환 후 제거
datetime → year, month, day, hour 파생# 날짜/시간 변환 및 시간 관련 컬럼 추출 asos_data['datetime'] = pd.to_datetime(asos_data['일시']) asos_data['year'] = asos_data['datetime'].dt.year asos_data['month'] = asos_data['datetime'].dt.month asos_data['day'] = asos_data['datetime'].dt.day asos_data['hour'] = asos_data['datetime'].dt.hour # 불필요한 '일시' 컬럼 제거 asos_data.drop('일시', axis=1, inplace=True) # 7시부터 18시까지만 필터링 asos_filtered = asos_data[(asos_data['hour'] >= 7) & (asos_data['hour'] <= 18)] # 불필요한 '시간' 컬럼 제거 solar_data.drop('시간', axis=1, inplace=True) # 태양광 데이터의 datetime 컬럼을 datetime 타입으로 변환 solar_data['datetime'] = pd.to_datetime(solar_data['datetime']) -
강수량(mm) 및 적설(cm)
강수량 → 겨울철(11월~3월)은 3시간 간격으로 중앙 값 → NaN값은 0으로 채움
적설(cm) → 모든 결측치를 0으로 채움 → is_rain, no_rain, is_snow, no_snow 컬럼 생성
3시간신적설(cm) → 값이 있는 시간의 전후 1시간에만 전파, 나머지는 0으로 채움
(이후 큰 의미 없는 컬럼이여서 삭제)# 겨울철: 11, 12, 1, 2, 3 winter_mask = df['month'].isin([11, 12, 1, 2, 3]) three_hour_mask = df['hour'].isin([0, 3, 6, 9, 12, 15, 18, 21]) # 겨울 + 3시간 단위인데 NaN이면 -1로 마킹 target_mask = winter_mask & three_hour_mask & df['강수량(mm)'].isna() df.loc[target_mask, '강수량(mm)'] = -1 # 날짜별로 처리 for date in df[winter_mask]['date'].unique(): for h in [1, 2, 4, 5, 7, 8, 10, 11, 13, 14, 16, 17, 19, 20, 22, 23]: now_mask = (df['date'] == date) & (df['hour'] == h) prev_hour = h - (h % 3) next_hour = prev_hour + 3 # 마찬가지로 같은 날짜 기준 prev_mask = (df['date'] == date) & (df['hour'] == prev_hour) next_mask = (df['date'] == date) & (df['hour'] == next_hour) prev_val = df.loc[prev_mask, '강수량(mm)'].values next_val = df.loc[next_mask, '강수량(mm)'].values valid_prev = len(prev_val) > 0 and prev_val[0] != -1 valid_next = len(next_val) > 0 and next_val[0] != -1 if valid_prev and valid_next: # 둘 다 값 있음 → 평균으로 fill_val = round((prev_val[0] + next_val[0]) / 3, 1) df.loc[now_mask, '강수량(mm)'] = fill_val elif valid_prev and not valid_next: # 후 값이 -1이면 0으로 간주 fill_val = round((prev_val[0] + 0) / 3, 1) df.loc[now_mask, '강수량(mm)'] = fill_val elif not valid_prev and valid_next: # 전 값이 -1이면 0으로 간주 fill_val = round((0 + next_val[0]) / 3, 1) df.loc[now_mask, '강수량(mm)'] = fill_val else: df.loc[now_mask, '강수량(mm)'] = -1 df['강수량(mm)'].replace(-1, np.nan, inplace=True) df['is_rain'] = (df['강수량(mm)'] >= 0).astype(int) df['no_rain'] = (df['강수량(mm)'].isna()).astype(int) df['강수량(mm)'].fillna(0, inplace=True) # is_snow 만들기 (적설은 겨울철 3시간 단위 X) df['is_snow'] = (df['적설(cm)'] >= 0).astype(int) df['no_snow'] = (df['적설(cm)'].isna()).astype(int) df['적설(cm)'].fillna(0, inplace=True) -
일조(hr), 일사량(MJ/m2)
→ 각 날짜별 첫 유효값 이전과 마지막 유효값 이후는 0으로
→ 그 사이의 결측치는 선형 보간solar_cols = ['일조(hr)', '일사(MJ/m2)'] decimal_places = {'일조(hr)': 1, '일사(MJ/m2)': 2} for col in solar_cols: before = df[col].isna().sum() temp_series = df[col].copy() # 각 날짜별로 처리 for date in df['date'].unique(): day_data = df[df['date'] == date][col] # 첫 유효값 이전과 마지막 유효값 이후는 0으로 first_idx = day_data.first_valid_index() last_idx = day_data.last_valid_index() # 유효값 사이 구간만 보간 if first_idx and last_idx: # 첫 값 이전은 0 before_mask = (day_data.index < first_idx) & day_data.isna() temp_series.loc[before_mask[before_mask].index] = 0 # 마지막 값 이후는 0 after_mask = (day_data.index > last_idx) & day_data.isna() temp_series.loc[after_mask[after_mask].index] = 0 # 중간 값은 선형 보간 day_result = day_data.interpolate(method='linear') between_mask = ~before_mask & ~after_mask & day_data.isna() temp_series.loc[between_mask[between_mask].index] = day_result.loc[between_mask[between_mask].index] # 결과 적용 및 소수점 조정 df[col] = temp_series.round(decimal_places[col]) # print(f"- {col}: 날짜별 처리 완료 (결측치: {before}개 → {df[col].isna().sum()}개)") -
기상 관측값
→ 앞의 값으로 채운 후 남은 결측치는 뒤의 값으로 채움
→ 그래도 남은 결측치는 평균값으로 대체weather_cols = [ '기온(°C)', '습도(%)', '풍속(m/s)', '풍향(16방위)', '증기압(hPa)', '이슬점온도(°C)', '해면기압(hPa)', '지면온도(°C)' ] for col in weather_cols: before = df[col].isna().sum() # 앞뒤 값으로 채우기 for date in df['date'].unique(): day_mask = df['date'] == date df.loc[day_mask, col] = df.loc[day_mask, col].fillna(method='ffill').fillna(method='bfill') # print(f"- {col}: 앞뒤 채우기 적용 (결측치: {before}개 → {df[col].isna().sum()}개)") -
범주형 변수
→ 현상번호, 운형의 결측치는 빈 문자열('')로 변환하고,
→ 현상번호는 짝수 자릿수가 되도록 홀수 자릿수 값에 앞 0 추가for col in categorical_cols: # 결측치 처리 전 개수 before = df[col].isna().sum() # 범주형 변수 결측치는 빈 문자열로 처리 df[col] = df[col].fillna('') # 현상번호(국내식) 특수 처리 if col == '현상번호(국내식)': # 데이터 타입 및 고유값 샘플 출력 (문자열 변환 후) print(f"현상번호 데이터 타입: {df[col].dtype}") # print(f"현상번호 고유값 샘플(처리 전): {sorted(df[col].astype(str).unique())[:10]}") # 빈 문자열이 아닌 값만 필터링 non_empty = df[col] != '' # 문자열로 변환 후 정수형으로 만들고 다시 문자열로 ('.0' 제거용) df.loc[non_empty, col] = df.loc[non_empty, col].astype(int).astype(str) # 혹시 남아 있을 수 있는 '.0' 문자열 제거 (예방 차원에서 추가) for idx in df[non_empty].index: if df.loc[idx, col].endswith('.0'): df.loc[idx, col] = df.loc[idx, col][:-2] # 자릿수 홀수인 경우 앞에 '0' 추가 odd_count = 0 for idx in df[non_empty].index: if len(df.loc[idx, col]) % 2 == 1: df.loc[idx, col] = '0' + df.loc[idx, col] odd_count += 1 # 결과 출력 #print(f"- {col}: 빈 문자열 처리 및 {odd_count}개 홀수 자릿수 값에 0 추가 (결측치: {before}개 → {df[col].isna().sum()}개)") #print(f"처리 후 현상번호 데이터 타입: {df[col].dtype}") #print(f"현상번호 고유값 샘플(처리 후): {sorted(df[col].unique())[:10]}") else: # 일반 카테고리형 변수 처리 결과 출력 #print(f"- {col}: 빈 문자열로 처리 (결측치: {before}개 → {df[col].isna().sum()}개)") from sklearn.preprocessing import MultiLabelBinarizer # 현상번호와 운형을 2자리씩 분리하는 함수 def split_code_into_pairs(code_str): if not code_str or code_str == '': return [] return [code_str[i:i+2] for i in range(0, len(code_str), 2)] # 코드 분리 적용 df['현상번호_코드_리스트'] = df['현상번호(국내식)'].apply(split_code_into_pairs) df['운형_코드_리스트'] = df['운형(운형약어)'].apply(split_code_into_pairs) # MultiLabelBinarizer로 인코딩 및 기존 데이터프레임에 직접 추가 # 현상번호 인코딩 mlb_weather = MultiLabelBinarizer() weather_encoded = mlb_weather.fit_transform(df['현상번호_코드_리스트']) for i, code in enumerate(mlb_weather.classes_): df[f'WP_{code}'] = weather_encoded[:, i] # 운형 인코딩 mlb_cloud = MultiLabelBinarizer() cloud_encoded = mlb_cloud.fit_transform(df['운형_코드_리스트']) for i, code in enumerate(mlb_cloud.classes_): df[f'CT_{code}'] = cloud_encoded[:, i] # 원본 및 임시 컬럼 삭제 df.drop(['현상번호_코드_리스트', '운형_코드_리스트', '현상번호(국내식)', '운형(운형약어)'], axis=1, inplace=True) # 인코딩 결과 확인 encoded_cols = [col for col in df.columns if col.startswith( 'WP_') or col.startswith('CT_')] #print(f"생성된 인코딩 컬럼: {len(encoded_cols)}개") #print(f"샘플 컬럼: {encoded_cols[:5]}") -
불필요 변수
→ 지면상태 변수 삭제# 임시 열 삭제 df.drop(['date'], axis=1, inplace=True) # 불필요 열 삭제 drop_cols = [ '지면상태(지면상태)', '최저운고(100m )', '5cm 지중온도(°C)', '10cm 지중온도(°C)', '20cm 지중온도(°C)', '30cm 지중온도(°C)' ] for col in drop_cols: if col in df.columns: df.drop(col, axis=1, inplace=True) print(f"- {col}: 변수 삭제됨")
1.1.3. 미세먼지 PM 데이터
| 지역 | 망 | 측정소코드 | 측정소명 | 측정일시 | SO2 | CO | O3 | NO2 | PM10 | PM25 | 주소 | |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 0 | 전남 목포시 | 도시대기 | 336112 | 부흥동 | 2015010101 | 0.0030 | 0.40 | 0.0270 | 0.0050 | 3.0 | 2.0 | 전남 목포시 삼향천로 28(옥암동) |
| 1 | 전남 목포시 | 도시대기 | 336112 | 부흥동 | 2015010102 | 0.0030 | 0.40 | 0.0270 | 0.0040 | 4.0 | 7.0 | 전남 목포시 삼향천로 28(옥암동) |
| 2 | 전남 목포시 | 도시대기 | 336112 | 부흥동 | 2015010103 | 0.0030 | 0.40 | 0.0290 | 0.0040 | 10.0 | 6.0 | 전남 목포시 삼향천로 28(옥암동) |
| 3 | 전남 목포시 | 도시대기 | 336112 | 부흥동 | 2015010104 | 0.0030 | 0.40 | 0.0280 | 0.0030 | 10.0 | 8.0 | 전남 목포시 삼향천로 28(옥암동) |
| 4 | 전남 목포시 | 도시대기 | 336112 | 부흥동 | 2015010105 | 0.0030 | 0.40 | 0.0280 | 0.0040 | 25.0 | 6.0 | 전남 목포시 삼향천로 28(옥암동) |
5 rows × 12 columns
부흥동 관측소가 미세먼지(PM) 관측소의 메인이며, PM 데이터의 결측치는 가까운 용당동 값으로 대체 및 시간 기준 보간을 진행했다.
-
측정일시 → 01시~24시 → 00시~23시 형태로 변환
-
PM 데이터 제외 불필요 변수 → 삭제
# 24시 -> 다음날 0시 def fix_hour_24(x): x = str(x).strip() if x[-2:] == '24': return pd.to_datetime(x[:-2], format="%Y%m%d") + timedelta(days=1) else: return pd.to_datetime(x, format="%Y%m%d%H") buheung["측정일시"] = buheung["측정일시"].apply(fix_hour_24) buheung = buheung.set_index("측정일시") # 구간 지정 buheung = buheung["2016":"2023"] buheung = buheung[["PM10", "PM25"]] -
PM 데이터 (PM10, PM2.5)
→ 결측치 가까운 관측소 데이터로
→ 1단계: 용당동 값으로 대체
→ 2단계: 시간 기준 보간 interpolate# PM10 먼저 처리 filled["PM10"] = filled["PM10"].combine_first(yongdang_copy["PM10"]) # 1단계: 용당동 값으로 대체 filled["PM10"] = filled["PM10"].interpolate(method="time") # 2단계: 시간 기준 보간 # PM25도 동일하게 처리 filled["PM25"] = filled["PM25"].combine_first(yongdang_copy["PM25"]) # 1단계: 용당동 값으로 대체 filled["PM25"] = filled["PM25"].interpolate(method="time") # 2단계: 시간 기준 보간
1.1.4. 병합 후 최종 데이터
하루의 측정기간은 값이 어느정도 들어가는 07시~18시(12h)로 조정하여 최종 병합한 데이터는 다음과 같다.
| datetime | 기온(°C) | 강수량(mm) | 풍속(m/s) | 풍향(16방위) | 습도(%) | 증기압(hPa) | 이슬점온도(°C) | 현지기압(hPa) | 해면기압(hPa) | ... | CT_As | CT_Cb | CT_Ci | CT_Cs | CT_Cu | CT_Ns | CT_Sc | CT_St | PM10 | PM25 | |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 0 | 2016-01-01 07:00:00 | 0.9 | 0.0 | 0.9 | 160.0 | 90.0 | 5.9 | -0.5 | 1028.4 | 1033.3 | ... | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 56.0 | 38.0 |
| 1 | 2016-01-01 08:00:00 | 0.6 | 0.0 | 1.5 | 160.0 | 90.0 | 5.8 | -0.8 | 1028.6 | 1033.5 | ... | 0 | 0 | 0 | 0 | 0 | 0 | 1 | 0 | 61.0 | 38.0 |
| 2 | 2016-01-01 09:00:00 | 1.6 | 0.0 | 2.0 | 160.0 | 90.0 | 6.2 | 0.1 | 1029.2 | 1034.1 | ... | 0 | 0 | 0 | 0 | 0 | 0 | 1 | 0 | 55.0 | 38.0 |
| 3 | 2016-01-01 10:00:00 | 2.4 | 0.0 | 1.9 | 160.0 | 85.0 | 6.2 | 0.1 | 1029.8 | 1034.6 | ... | 0 | 0 | 0 | 0 | 0 | 0 | 1 | 0 | 66.0 | 38.0 |
| 4 | 2016-01-01 11:00:00 | 4.1 | 0.0 | 1.8 | 160.0 | 73.0 | 6.0 | -0.3 | 1029.8 | 1034.6 | ... | 0 | 0 | 0 | 0 | 0 | 0 | 1 | 0 | 70.5 | 38.0 |
| ... | ... | ... | ... | ... | ... | ... | ... | ... | ... | ... | ... | ... | ... | ... | ... | ... | ... | ... | ... | ... | ... |
| 35059 | 2023-12-31 14:00:00 | 6.6 | 0.0 | 8.3 | 320.0 | 72.0 | 7.0 | 1.9 | 1014.5 | 1020.0 | ... | 1 | 0 | 0 | 0 | 0 | 0 | 1 | 0 | 27.0 | 16.0 |
| 35060 | 2023-12-31 15:00:00 | 6.5 | 0.0 | 10.3 | 340.0 | 70.0 | 6.8 | 1.4 | 1015.0 | 1020.5 | ... | 1 | 0 | 0 | 0 | 0 | 0 | 1 | 0 | 23.0 | 20.0 |
| 35061 | 2023-12-31 16:00:00 | 6.2 | 0.0 | 7.2 | 340.0 | 76.0 | 7.2 | 2.2 | 1015.8 | 1021.3 | ... | 1 | 0 | 0 | 0 | 0 | 0 | 1 | 0 | 31.0 | 28.0 |
| 35062 | 2023-12-31 17:00:00 | 6.3 | 0.0 | 7.2 | 340.0 | 70.0 | 6.7 | 1.2 | 1016.7 | 1022.2 | ... | 1 | 0 | 0 | 0 | 0 | 0 | 1 | 0 | 32.0 | 34.0 |
| 35063 | 2023-12-31 18:00:00 | 6.1 | 0.0 | 6.2 | 320.0 | 73.0 | 6.9 | 1.6 | 1017.7 | 1023.3 | ... | 1 | 0 | 0 | 0 | 0 | 0 | 1 | 0 | 29.0 | 36.0 |
35064 rows × 53 columns
1.2. 데이터 불러오기 및 EDA
data = pd.read_csv("../data/processed/re_merged_processed_data.csv", encoding="cp949")
filtered_data = data.copy()
# datetime to index
filtered_data.set_index("datetime", inplace=True)
filtered_data.sort_index(inplace=True)

# rename columns
filtered_data.rename(columns={
    "기온(°C)": "기온(C)",
    "이슬점온도(°C)": "이슬점온도(C)",
    "지면온도(°C)": "지면온도(C)",
    "PM25": "PM2.5"
}, inplace=True)

# index col to datetime
filtered_data.index = pd.to_datetime(filtered_data.index)

# check
filtered_data.head(2)| 기온(C) | 강수량(mm) | 풍속(m/s) | 풍향(16방위) | 습도(%) | 증기압(hPa) | 이슬점온도(C) | 현지기압(hPa) | 해면기압(hPa) | 일조(hr) | ... | CT_As | CT_Cb | CT_Ci | CT_Cs | CT_Cu | CT_Ns | CT_Sc | CT_St | PM10 | PM2.5 | |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| datetime | |||||||||||||||||||||
| 2016-01-01 07:00:00 | 0.9 | 0.0 | 0.9 | 160.0 | 90.0 | 5.9 | -0.5 | 1028.4 | 1033.3 | 0.0 | ... | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 56.0 | 38.0 |
| 2016-01-01 08:00:00 | 0.6 | 0.0 | 1.5 | 160.0 | 90.0 | 5.8 | -0.8 | 1028.6 | 1033.5 | 0.0 | ... | 0 | 0 | 0 | 0 | 0 | 0 | 1 | 0 | 61.0 | 38.0 |
2 rows × 52 columns
1.2.1. 기온(C)
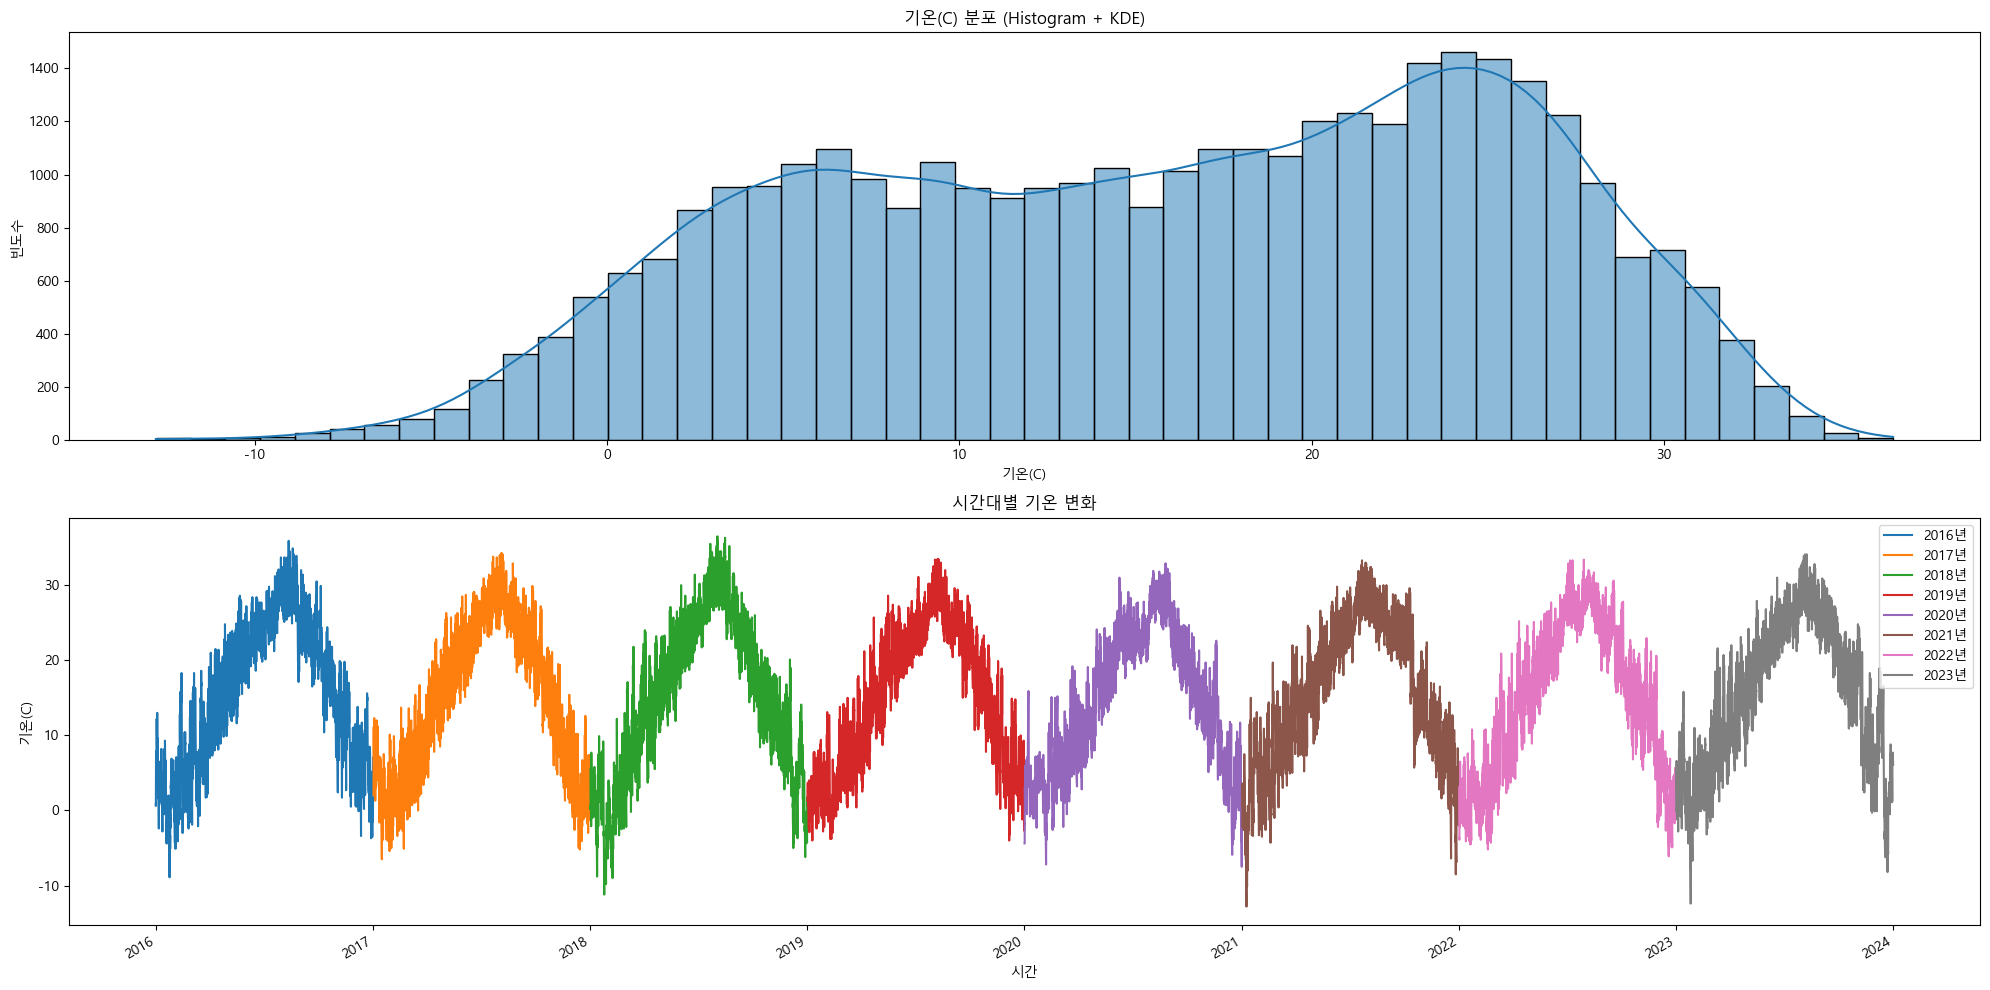
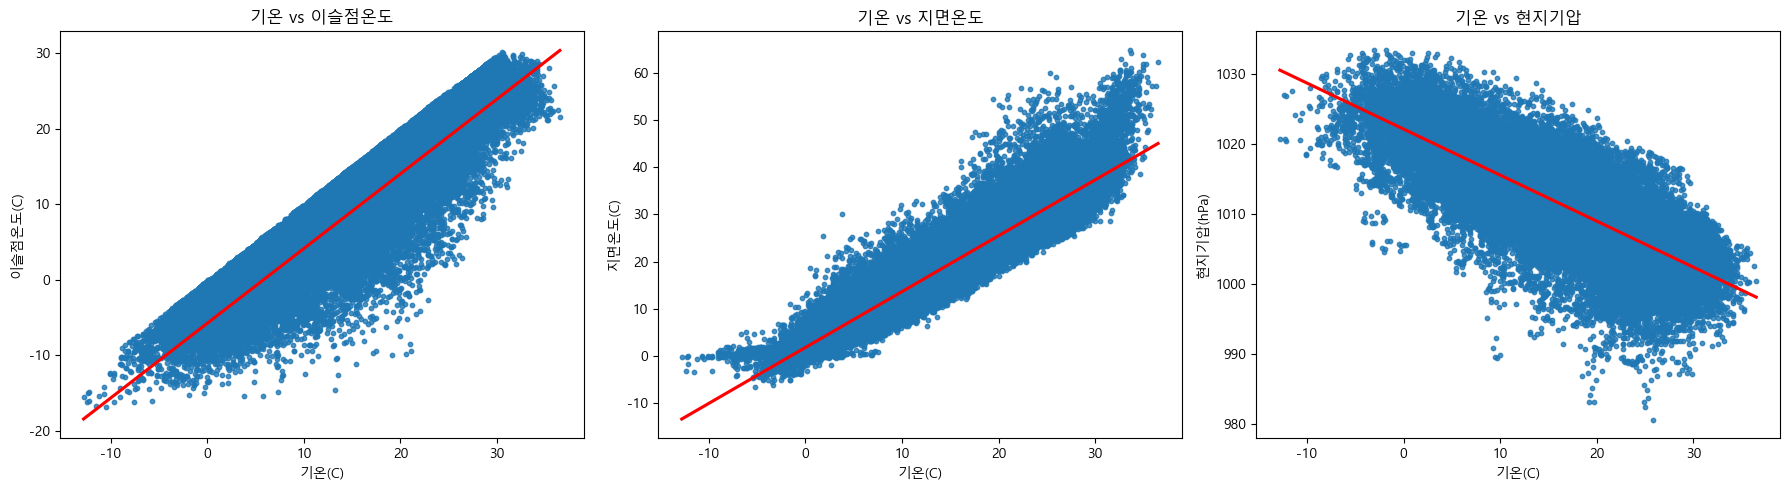
기온과 상관성이 높은 이슬점온도와, 지면온도와, 현지기압을 제외한다.
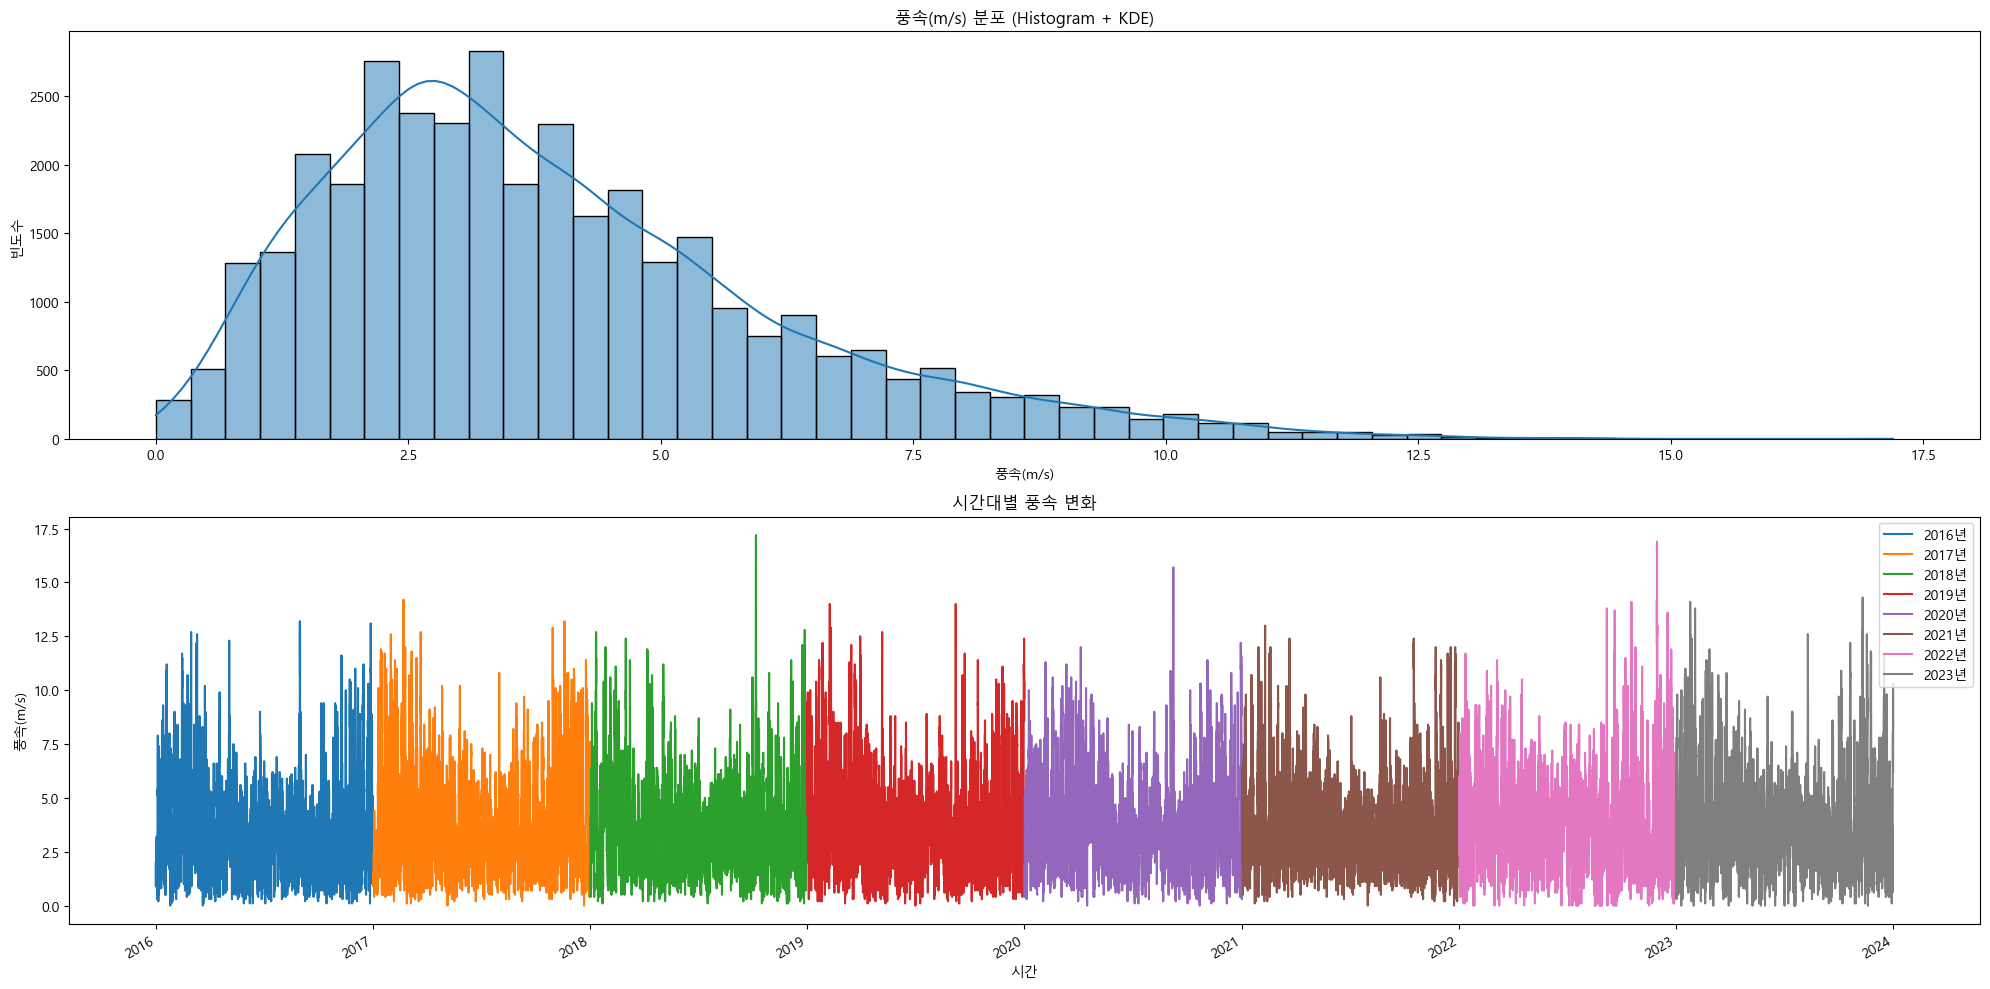
1.2.2. 풍속(m/s)
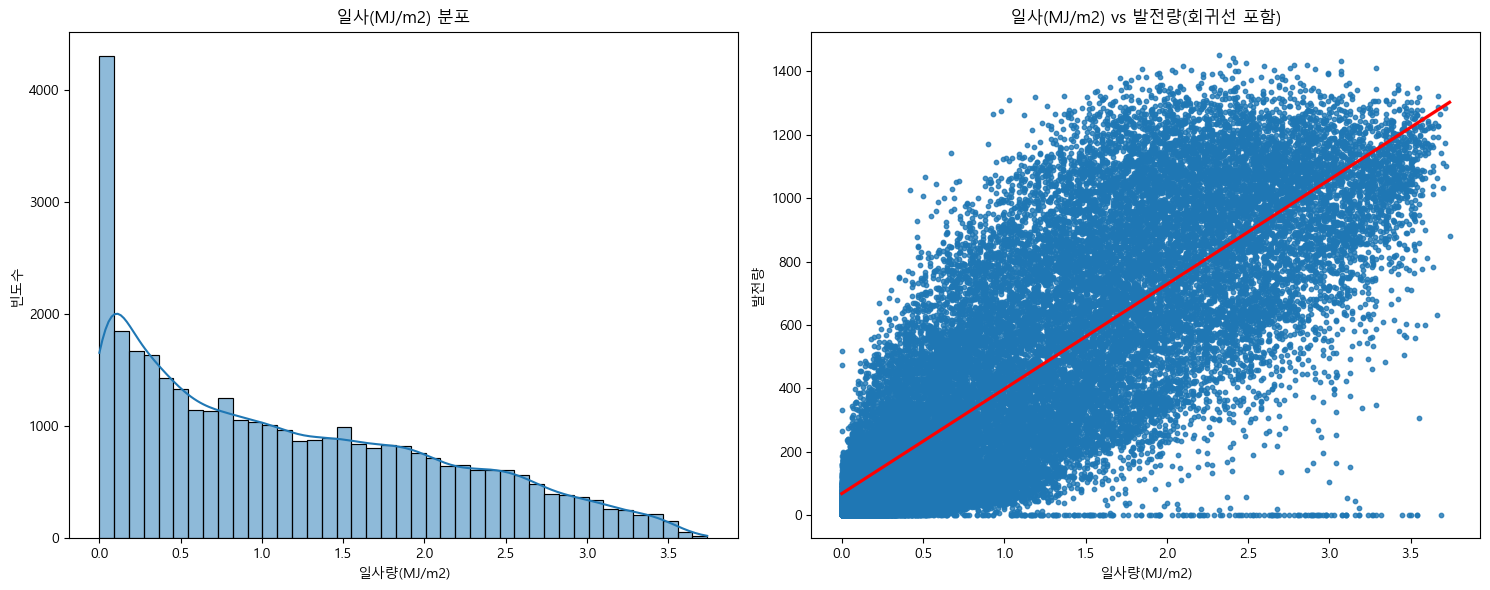
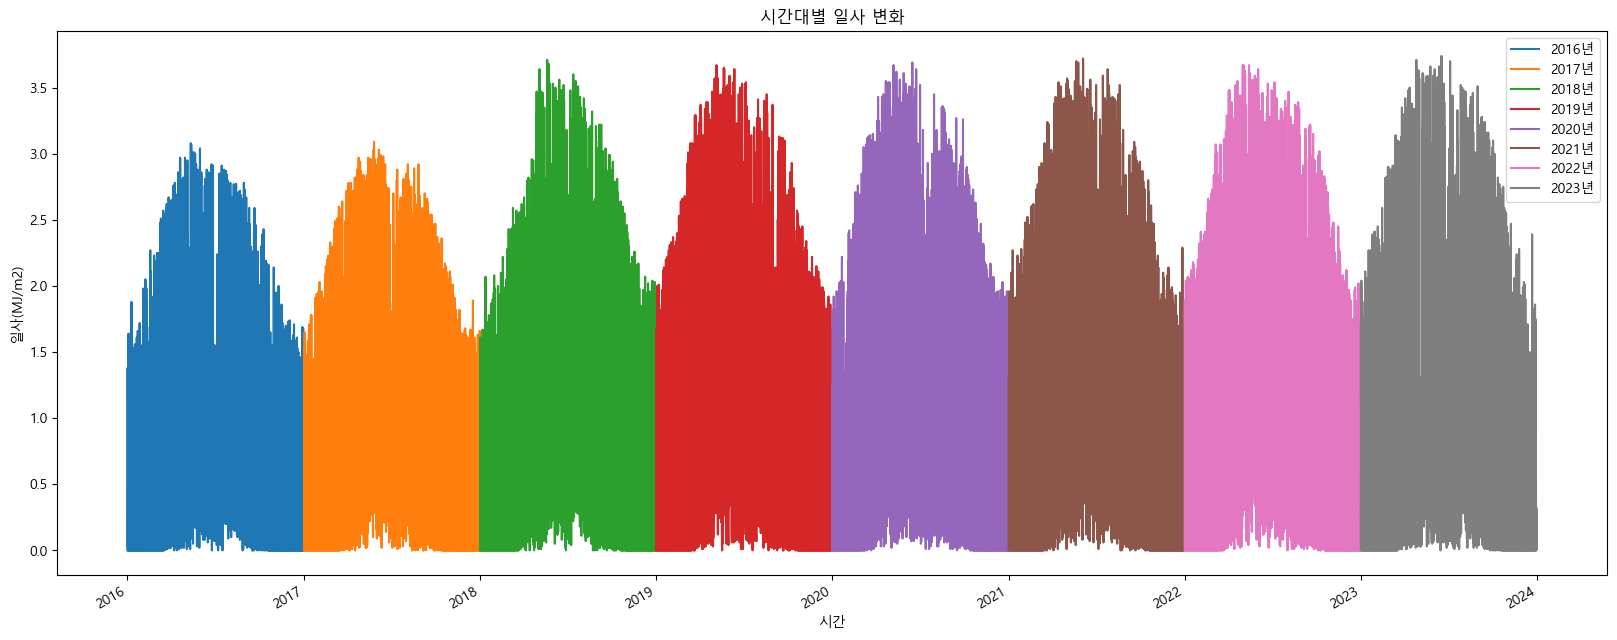
1.2.3. 일사(MJ/m2)
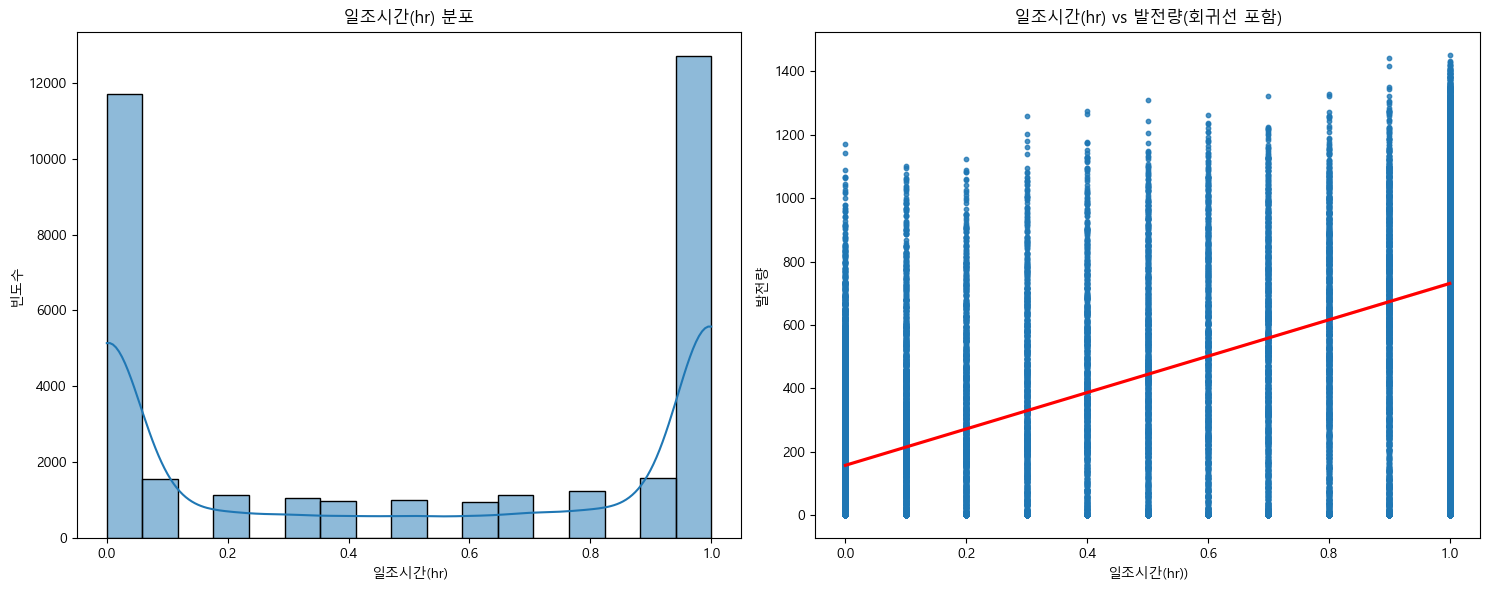
1.2.4. 일조(hr)
1.2.6. PM10, PM2.5
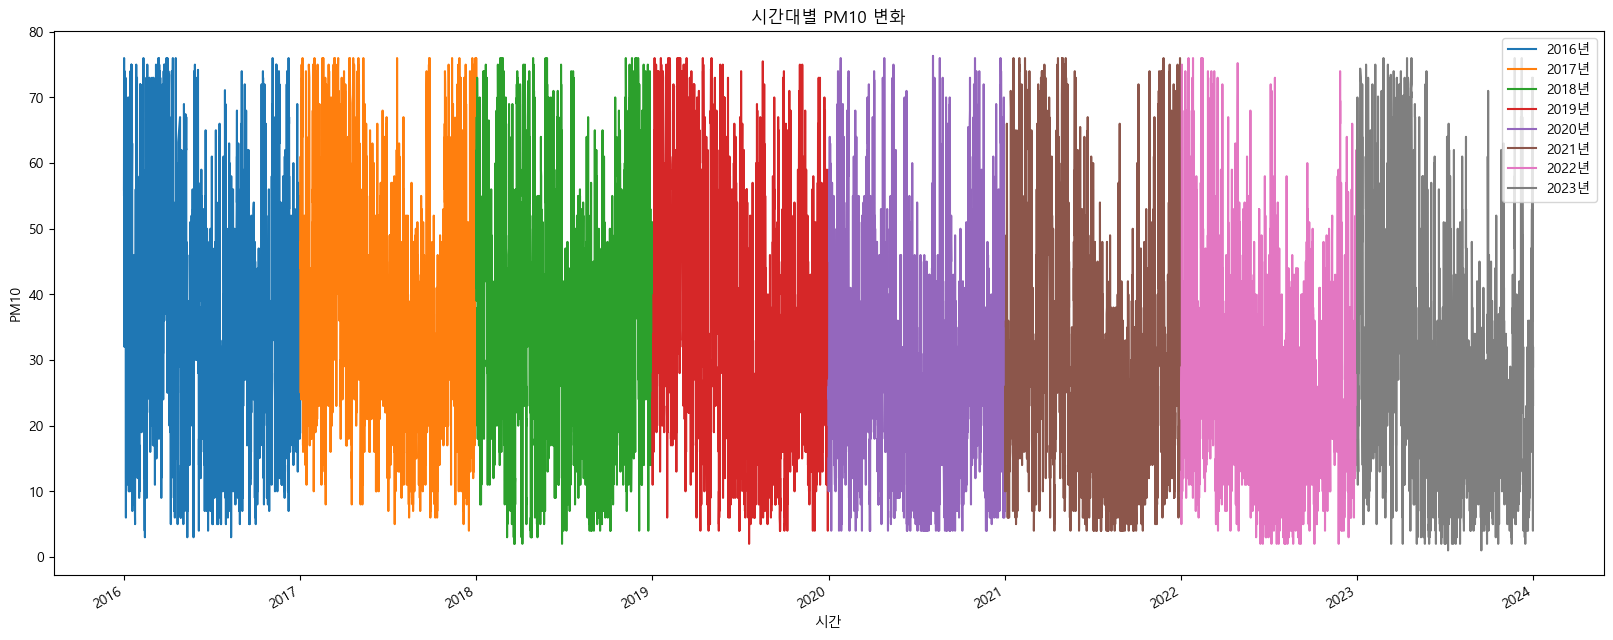
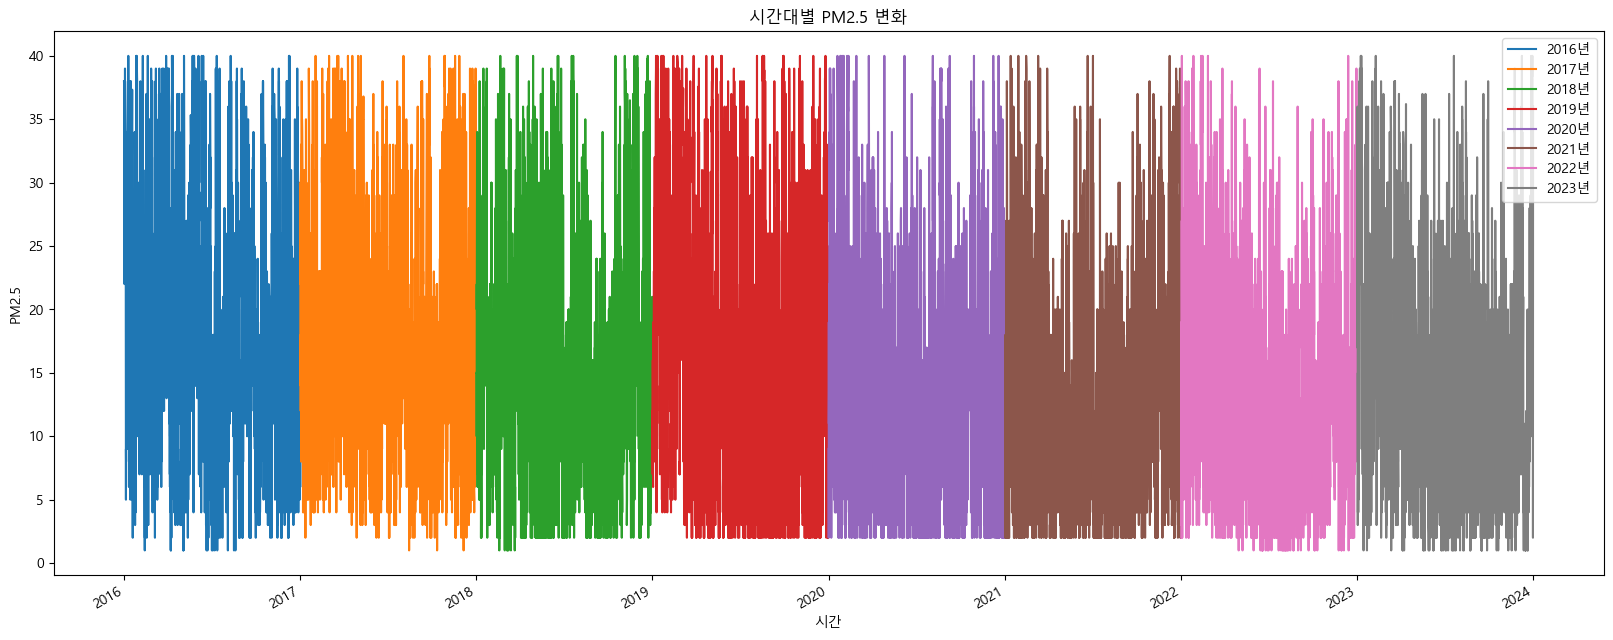
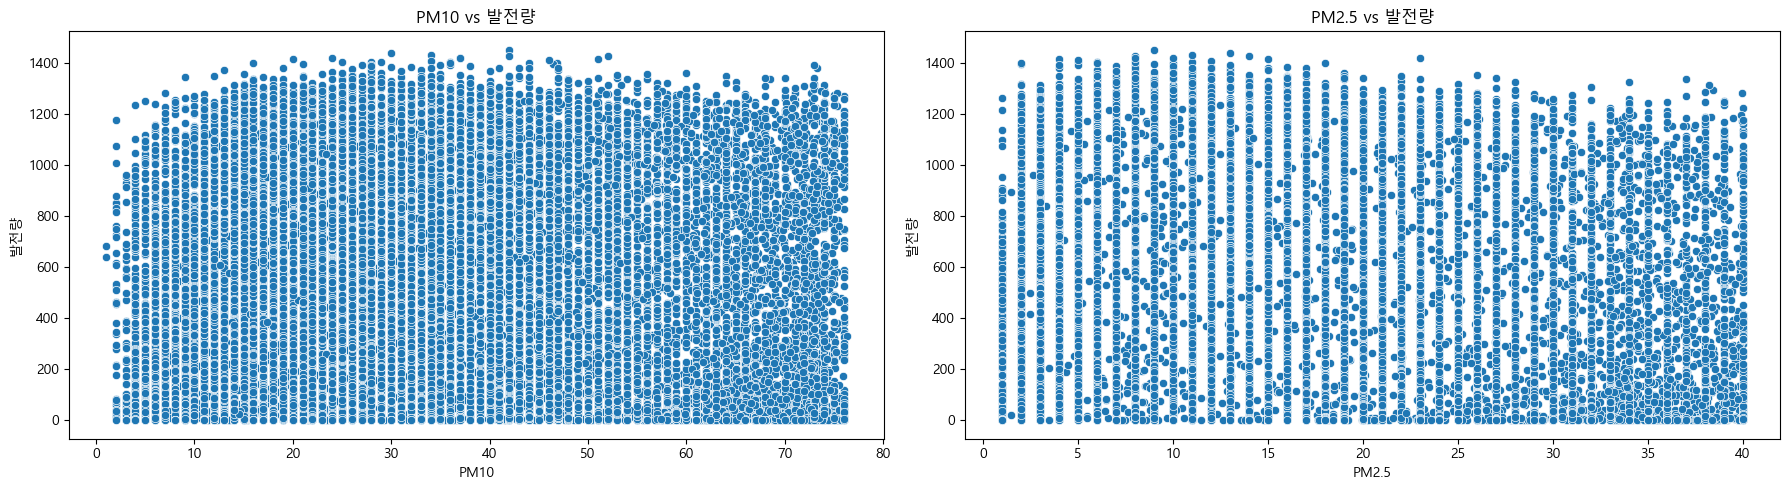
나중에 분석 및 예측을 하며 봤는데 미세먼지 데이터가 생각보다 더 예측에 악영향을 미쳐서 제외했다.
1.2.7. 강수량(mm) 및 적설(cm)
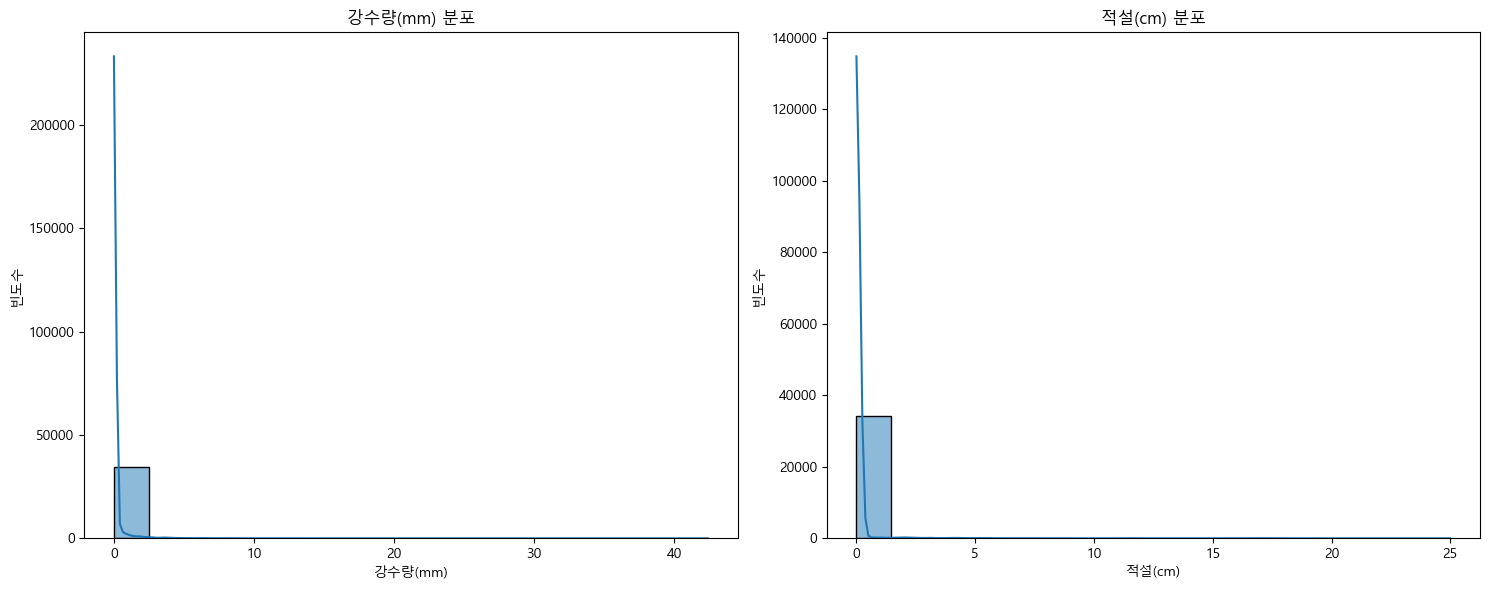
강수량과 적설은 안온날이 너무나도 많기 떄문에 0에 쏠려있고,
이와같이 is, no rain, snow로 보니
<< 비 >>
비가 안올때: 504.5650909336303
비가 올 때: 174.6335581352497
평균 발전량 차이: 329.9315327983806

<< 눈 >>
눈이 안올때: 458.74629044571026
눈이 올 때: 275.8953876739563
평균 발전량 차이: 182.85090277175397
비의 경우는 눈에 띄는 차이가 있기 때문에 사용할 수 있겠다고 판단했다.
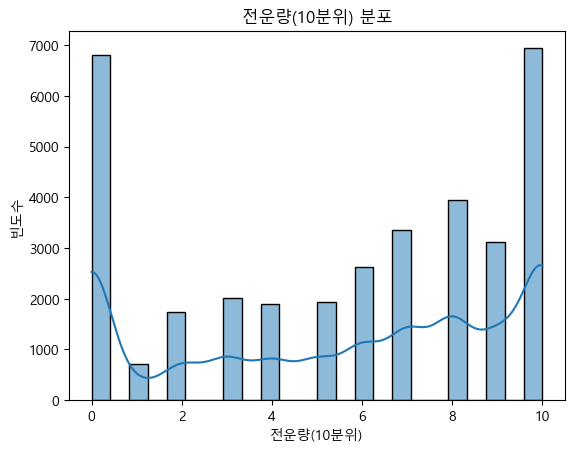
1.2.8. 전운량(10분위)
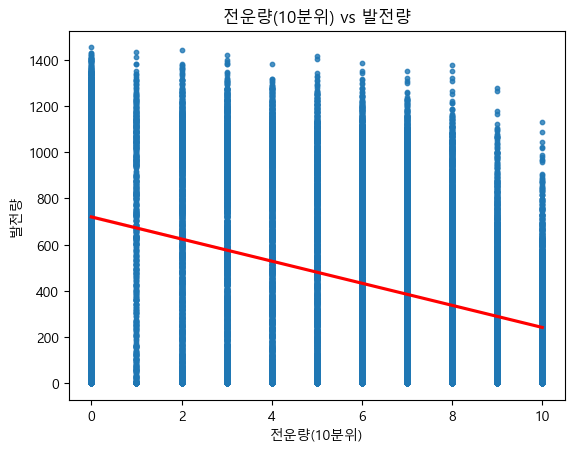
전운량이란 구름의 양으로 더 많아질수록 발전량이 떨어지는 회귀선을 볼 수 있었다.
또한 이를 통해 현상번호(WP_*)와 운형(CT_*)을 대체할 수 있다.
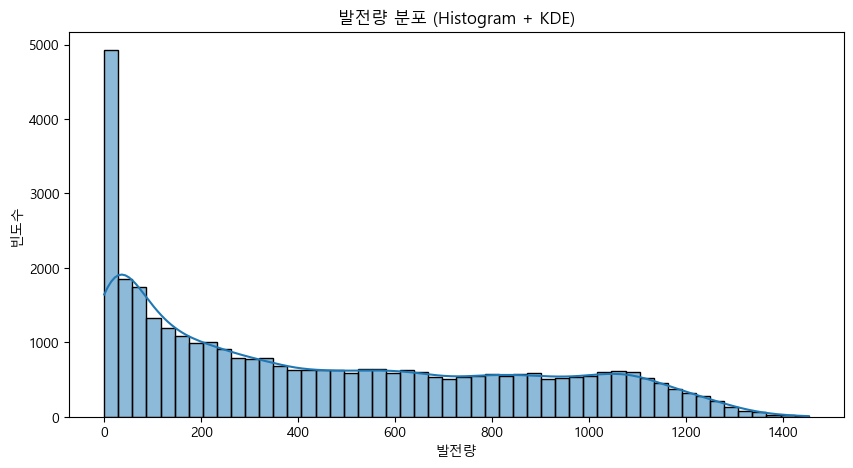
1.2.9. 발전량
# ratio check
for h in range(7, 19):
    hour_data = filtered_data[filtered_data.index.hour == h]
    zero_ratio = (hour_data["발전량"] == 0).mean()
    print(f"{h}시: 발전량 0 비율 = {zero_ratio:.2%}")
7시: 발전량 0 비율 = 11.74%
8시: 발전량 0 비율 = 1.78%
9시: 발전량 0 비율 = 1.10%
10시: 발전량 0 비율 = 0.92%
11시: 발전량 0 비율 = 0.75%
12시: 발전량 0 비율 = 0.89%
13시: 발전량 0 비율 = 1.13%
14시: 발전량 0 비율 = 0.89%
15시: 발전량 0 비율 = 0.68%
16시: 발전량 0 비율 = 0.72%
17시: 발전량 0 비율 = 4.07%
18시: 발전량 0 비율 = 38.77%period=12 로 설정하면 되며
DL Model에서 log값으로 치환 후 결과를 뽑을때 역변환하기로, ML Model에서는 그대로 사용하고자 했다.
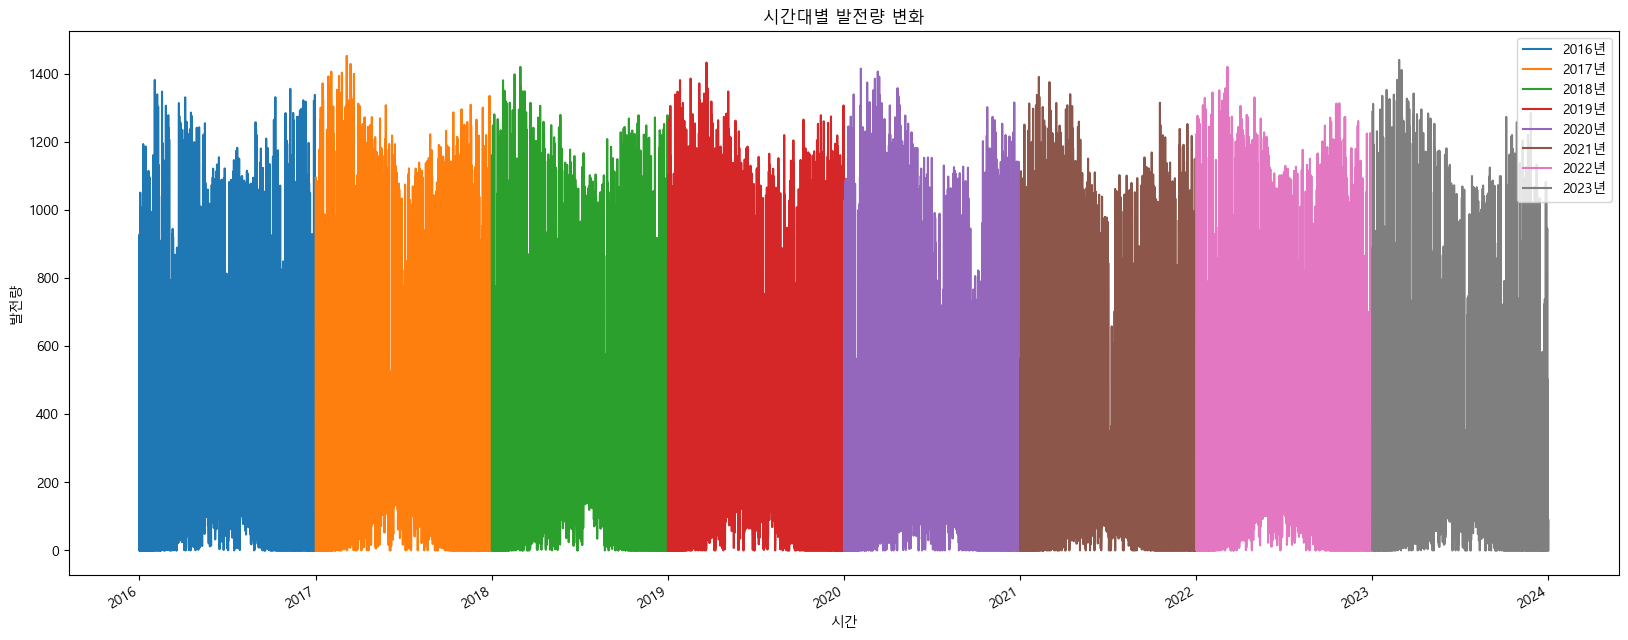
이는 발전량의 시계열 그래프이며
연도별 평균을 보면 아래와 같다.
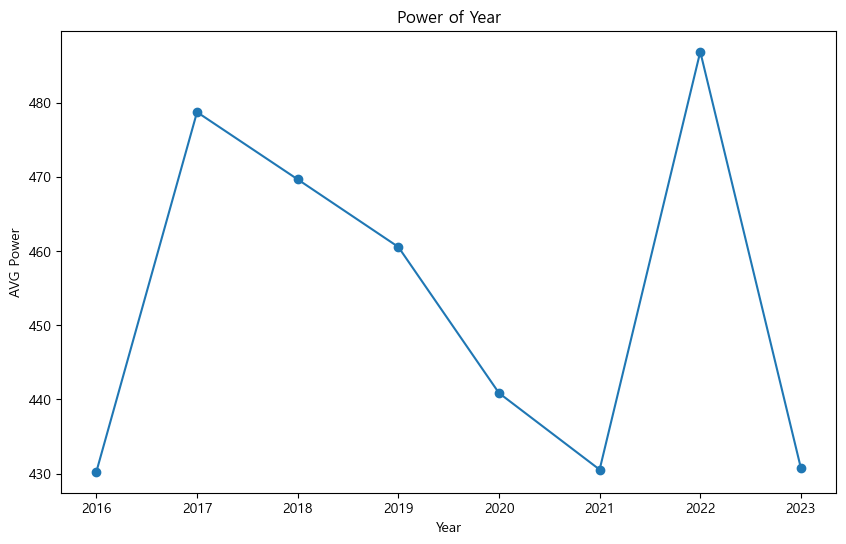
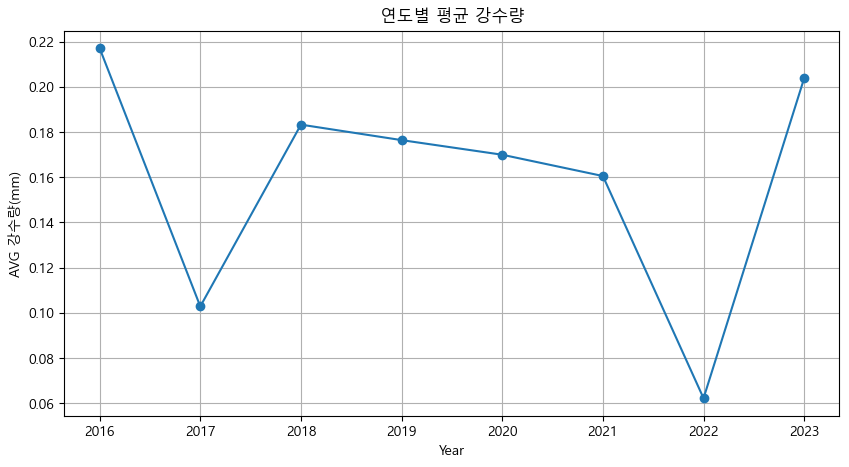
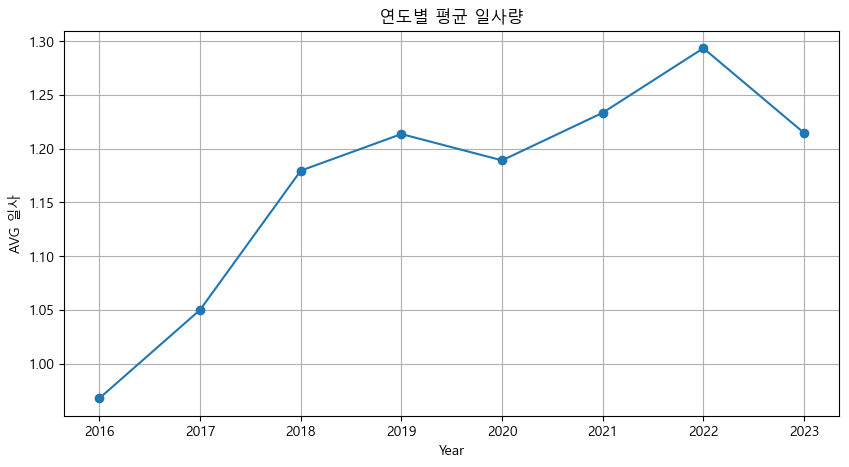
이 떨어지는 구간과 급등하는 구간을 봤을때 강수량과 일사량을 같이 보면 이해가 간다.
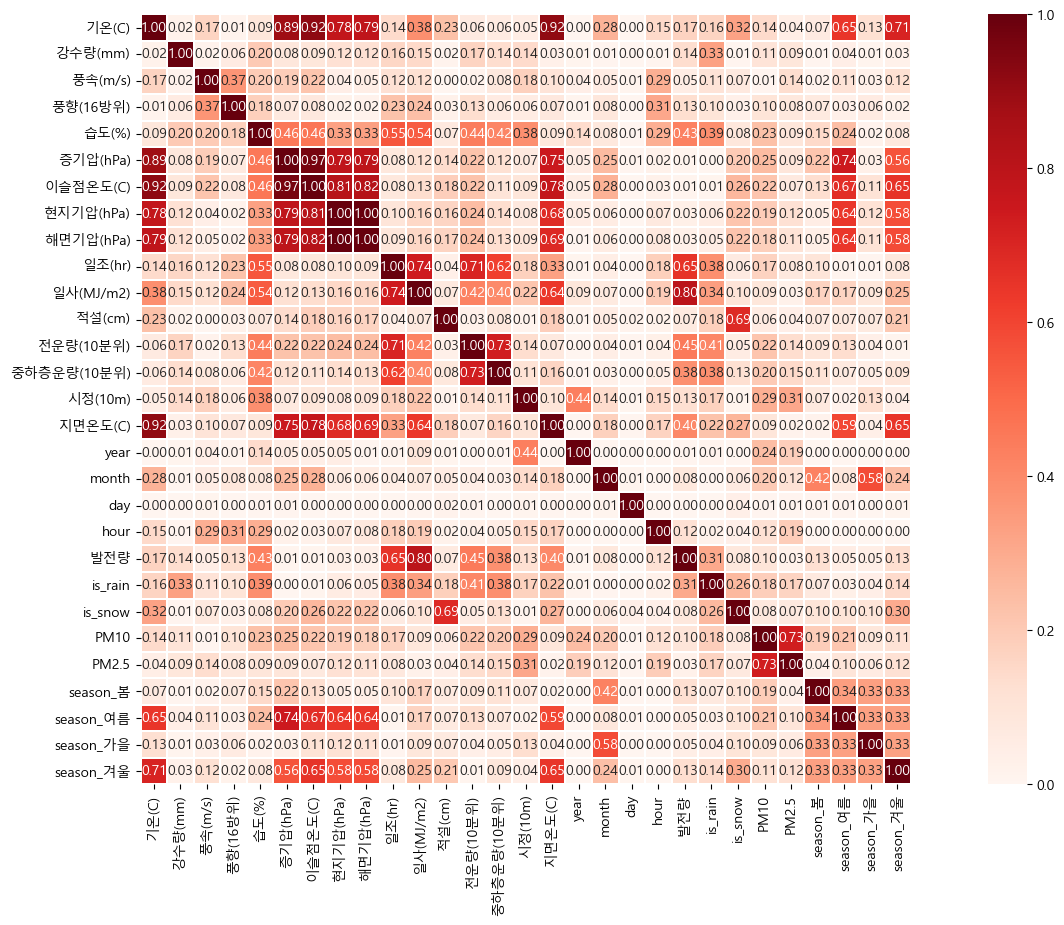
1.2.10. 상관관계 히트맵
그렇게 최종적으로 선택한 컬럼은
filtered_data.columnsIndex(['기온(C)', '강수량(mm)', '풍속(m/s)', '풍향(16방위)', '습도(%)', '증기압(hPa)',
'이슬점온도(C)', '현지기압(hPa)', '해면기압(hPa)', '일조(hr)', '일사(MJ/m2)', '적설(cm)',
'전운량(10분위)', '중하층운량(10분위)', '시정(10m)', '지면온도(C)', 'year', 'month',
'day', 'hour', '발전량', 'is_rain', 'no_rain', 'is_snow', 'no_snow',
'WP_01', 'WP_02', 'WP_04', 'WP_05', 'WP_06', 'WP_08', 'WP_09', 'WP_10',
'WP_12', 'WP_13', 'WP_16', 'WP_19', 'WP_40', 'WP_42', 'WP_70', 'WP_71',
'CT_Ac', 'CT_As', 'CT_Cb', 'CT_Ci', 'CT_Cs', 'CT_Cu', 'CT_Ns', 'CT_Sc',
'CT_St', 'PM10', 'PM2.5', 'weekday', 'season'],
dtype='object')여기서 no_rain과 no_snow는 is와 중복이기 때문에 삭제하고,
weekday는 삭제, season은 원핫인코딩, WP_*와 CT_*는 전운량으로 대체 가능하기에 삭제했다.
그렇게 최종 히트맵을 보면 다음과 같다.
1.3. 모델
훈련데이터는 2016년 01월 01일 00시 ~ 2022년 12월 31일 23시로 정했고,
평가데이터(unseen data)는 2023년 01월 01일 00시 ~ 2023년 12월 31일 23시로 정했다.
DeepLearning과 SARIMAX에서 사용한 변수들은 다음과 같다.
X: 기온(C), 일조(hr), 일사(MJ/m2), 풍속(m/s), 습도(%), 증기압(hPa), 전운량(10분위), 강수량(mm), is_rain, year
(+ feature 추가) month_sin, month_cos, hour_sin, hour_cos, season(0:Spring ~ 3:Winter)
Y: log_발전량
data['month_sin'] = np.sin(2 * np.pi * data['month'] / 12)
data['month_cos'] = np.cos(2 * np.pi * data['month'] / 12)
data['hour_sin'] = np.sin(2 * np.pi * data['hour'] / 24)
data['hour_cos'] = np.cos(2 * np.pi * data['hour'] / 24)

def get_season(month):
    if month in [3, 4, 5]:
        return 0  # Spring
    elif month in [6, 7, 8]:
        return 1  # Summer
    elif month in [9, 10, 11]:
        return 2  # Fall
    else:
        return 3  # Winter

data['season'] = data['month'].apply(get_season)

# feature 컬럼 (입력 feature)
# 성능 가장 best 조합
feature_cols = ['기온(C)', '일조(hr)', '일사(MJ/m2)', '풍속(m/s)', '습도(%)', '증기압(hPa)','전운량(10분위)',
                '강수량(mm)', 'is_rain', 'year', 'month_sin', 'month_cos', 'hour_sin', 'hour_cos', 'season']

X_data = data[feature_cols].copy()
y_data = data['발전량'].copy()

# log변환
y_data = np.log1p(y_data)

X_train = X_data['2016-01-01 00:00:00':'2022-12-31 23:00:00']  # 훈련
y_train = y_data['2016-01-01 00:00:00':'2022-12-31 23:00:00']

X_test = X_data['2023-01-01 00:00:00':'2023-12-31 23:00:00']  # 평가
y_test = y_data['2023-01-01 00:00:00':'2023-12-31 23:00:00']

# feature 스케일링
scaler = MinMaxScaler()
X_train_scaled = scaler.fit_transform(X_train)
X_test_scaled = scaler.transform(X_test)

def make_sample(X, y, window_size=12):
    X_seq = []
    y_seq = []
    for i in range(len(X) - window_size):
        X_seq.append(X[i:i+window_size])
        y_seq.append(y[i+window_size])
    return np.array(X_seq), np.array(y_seq)

window_size = 12
X_train_seq, y_train_seq = make_sample(X_train_scaled, y_train.values, window_size)
X_test_seq, y_test_seq = make_sample(X_test_scaled, y_test.values, window_size)
print(X_train_seq.shape, y_train_seq.shape)
print(X_test_seq.shape, y_test_seq.shape)
(30672, 12, 15) (30672,)
(4368, 12, 15) (4368,)1.3.1. LSTM
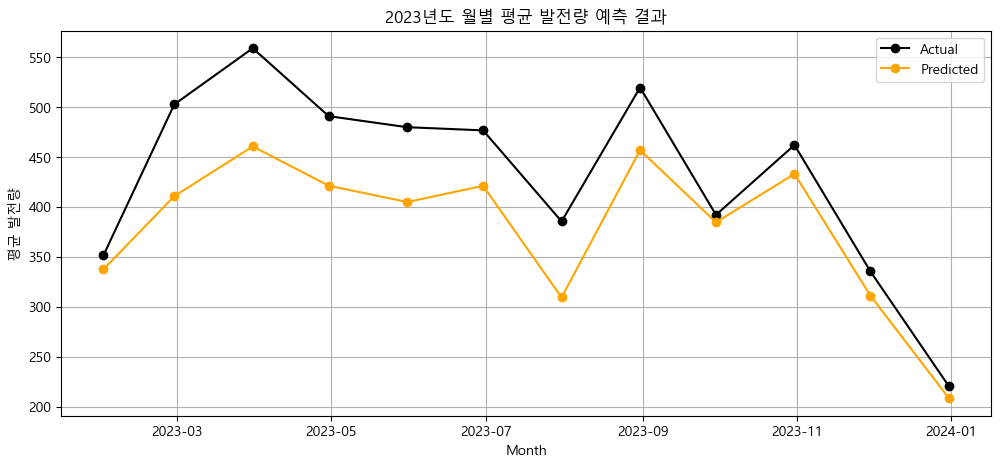
우선 초반 1 layer로 16Units, 50 epochs, 16 batch size로 설정하여 돌린 결과는 다음과 같다.
MAE: 130.4122
RMSE: 190.2636
R2: 0.7554
Normalized RMSE: 0.132028
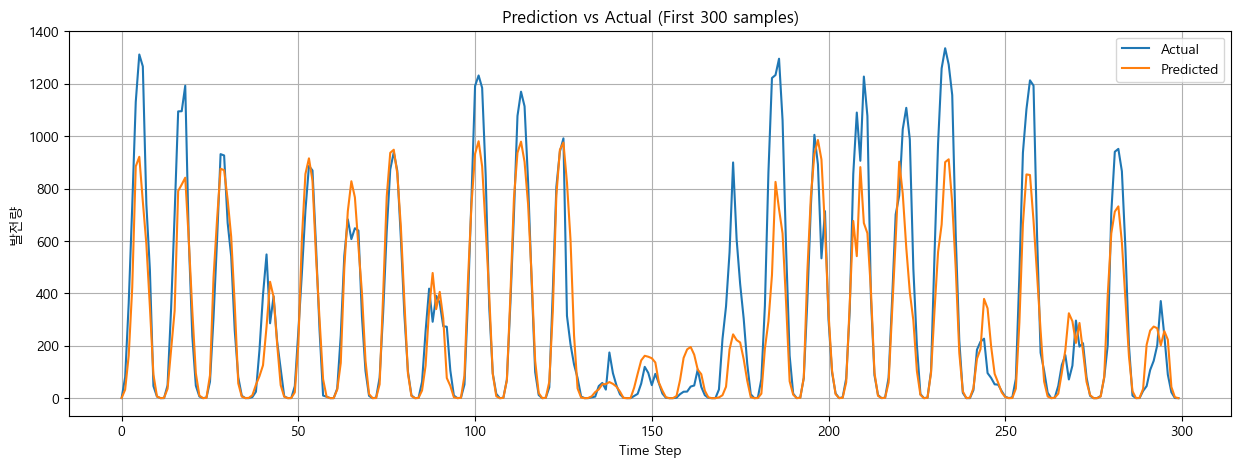
이를 튜닝하여 가장 최적의 값은
1 layer: 128 Units, l2 가중치 정규화(0.001)
Dropout 0.3
2 layer: 64 Units, l2 가중치 정규화(0.001)
Dropout 0.3
epochs: 50, batch_size: 16
MAE: 127.6143
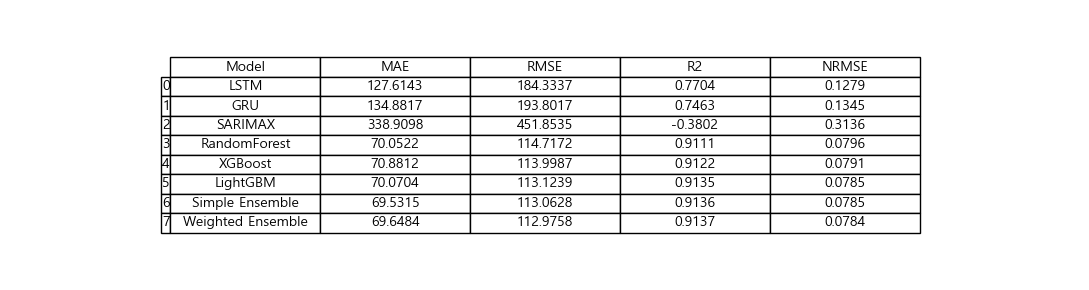
RMSE: 184.3337
R2: 0.7704
Normalized RMSE: 0.1279
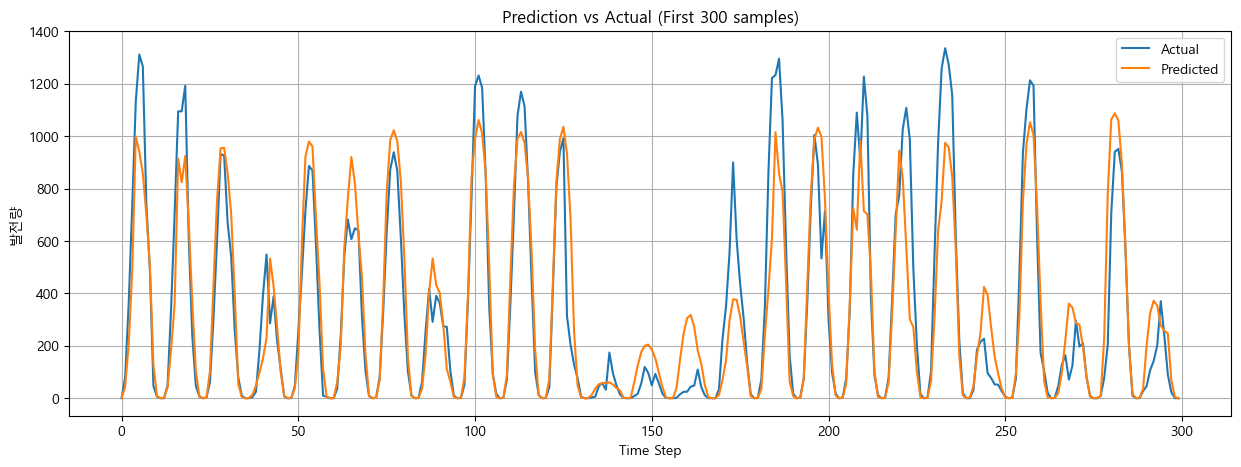
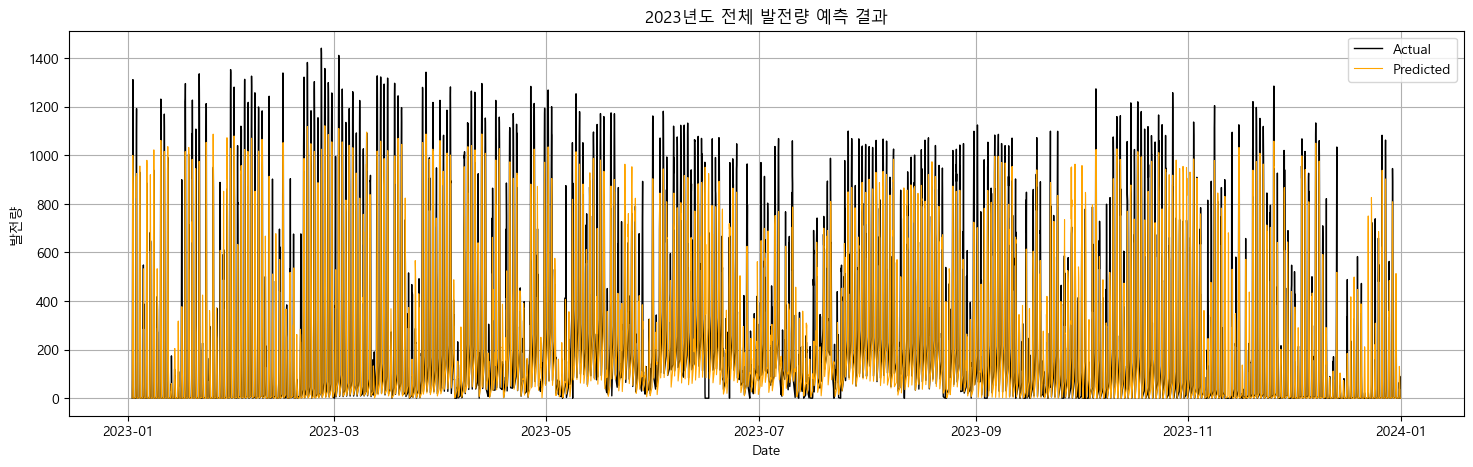
1.3.2. GRU
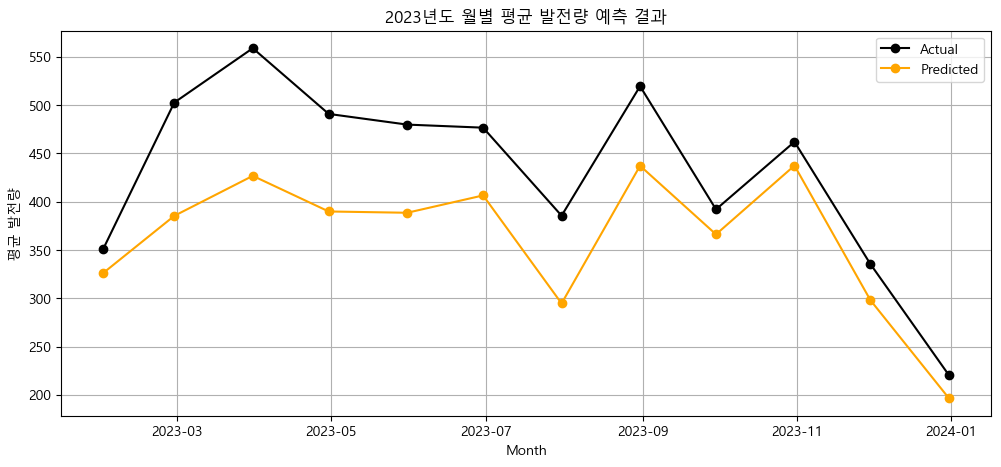
GRU도 똑같이 돌려본 결과
GRU 최종 성능
MAE: 134.8817
RMSE: 193.8017
R2: 0.7463
Normalized RMSE: 0.134484
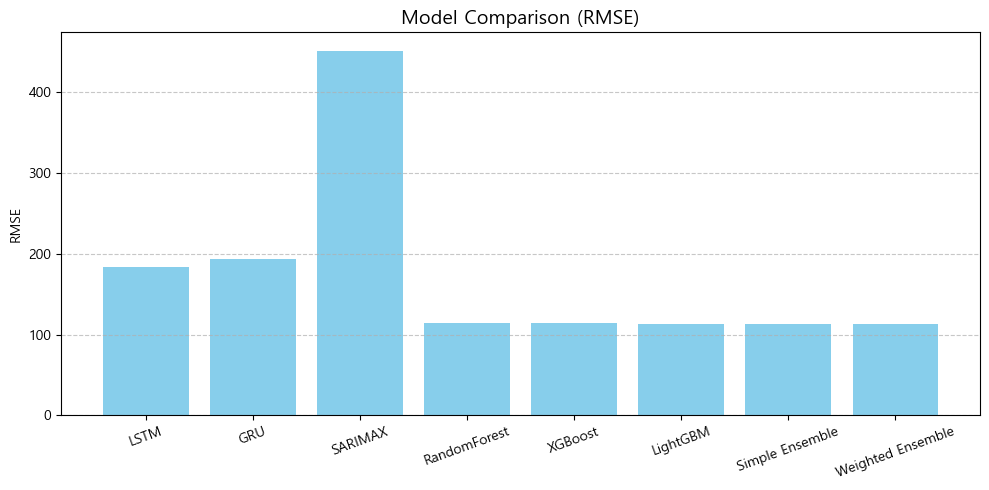
LSTM이 좀 더 우수했다.
1.3.3. 🤢 SARIMAX
프로젝트 기간동안 해결하지 못한 부분이었다.
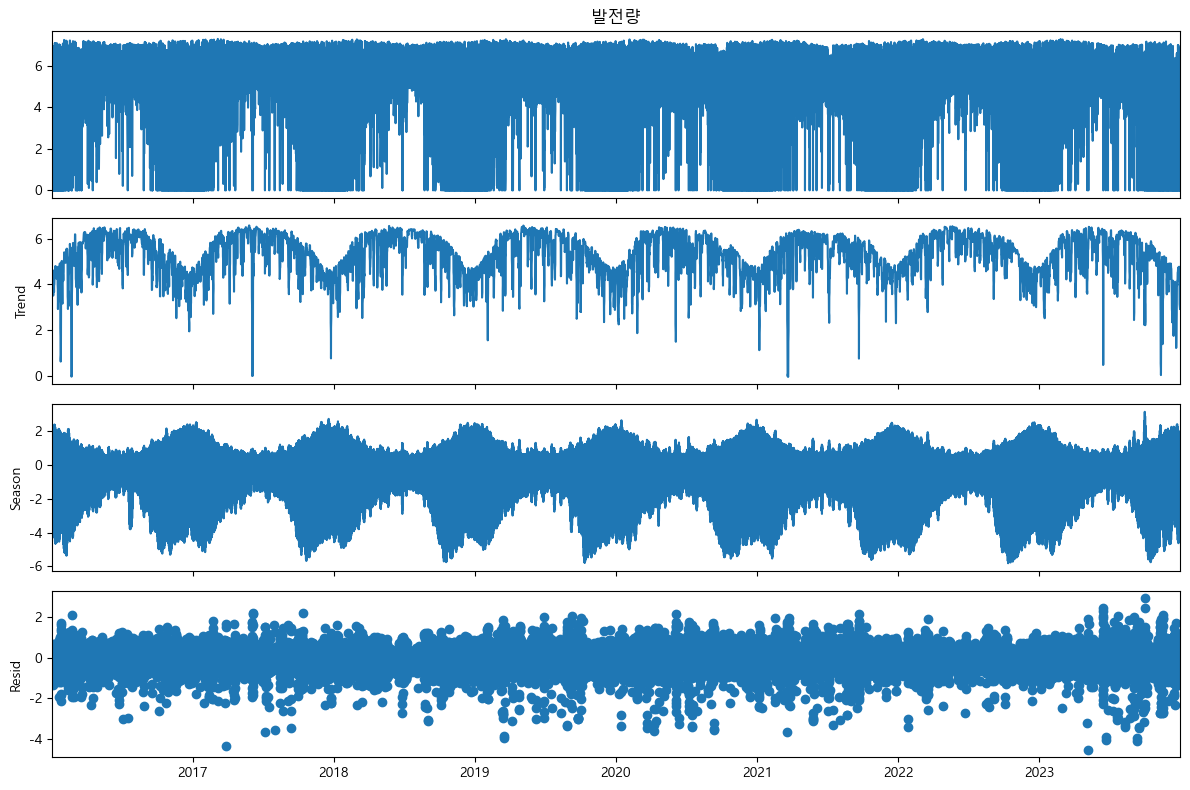
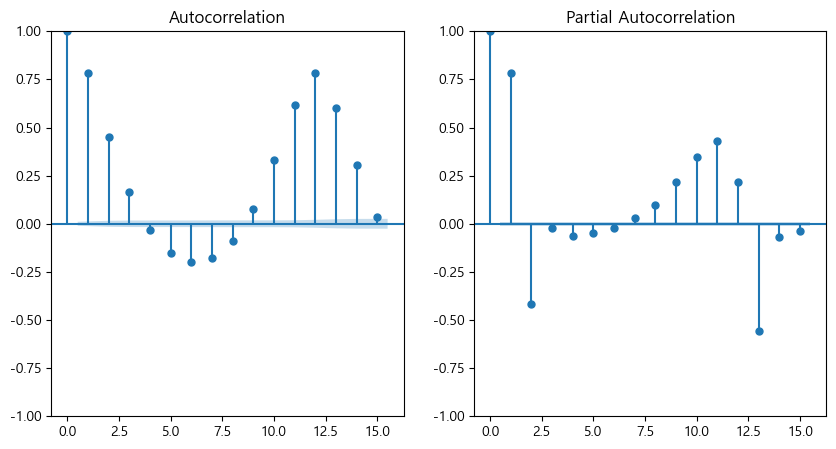
최적의 값을 찾기 위해 auto_arima를 돌릴때마다 메모리가 효율이 꽉차서 PC가 멈추게 되어서 값도 여러번 바꿔봐도 똑같이 터졌다..
프로젝트 제출 기한은 정해져 있었기에 어떻게 방법을 못찾았고, 처리 방법을 몰라 아래 decomposition과 자기상관도표를 보고 임의의 값으로 돌리게 되었다.
# 임의의 값
sarimax_model = SARIMAX(
    y_train,
    exog=X_train,
    order=(2, 1, 1),
    seasonal_order=(1, 1, 1, 12),
    enforce_stationarity=False,
    enforce_invertibility=False
)

# 모델 학습
sarimax_result = sarimax_model.fit(disp=False)
그 결과
MAE: 338.9098
RMSE: 451.8535
R²: -0.3802
Normalized RMSE: 0.3136
이와같이 값이 나왔고 기간 내에 마무리 하지 못한 부분이었다.
1.3.4. Machine Learning
Machine Learning에서 사용한 변수들은 다음과 같다.
X: 기온(C), 일조(hr), 일사(MJ/m2), 풍속(m/s), 습도(%), 증기압(hPa), 전운량(10분위), 강수량(mm), year, month, hour
(+ feature 추가) lag_1 발전량, lag_12 발전량
Y: 발전량
랜덤포레스트와 XGBoost, LightGBM을 사용하였으며 초기 학습에는
n_estimators: 100으로 전체를 돌렸을때 다음과 같았다.
RandomForest 성능:
MAE: 71.7065
RMSE: 116.3974
R2: 0.9084
Normalized RMSE: 0.080771
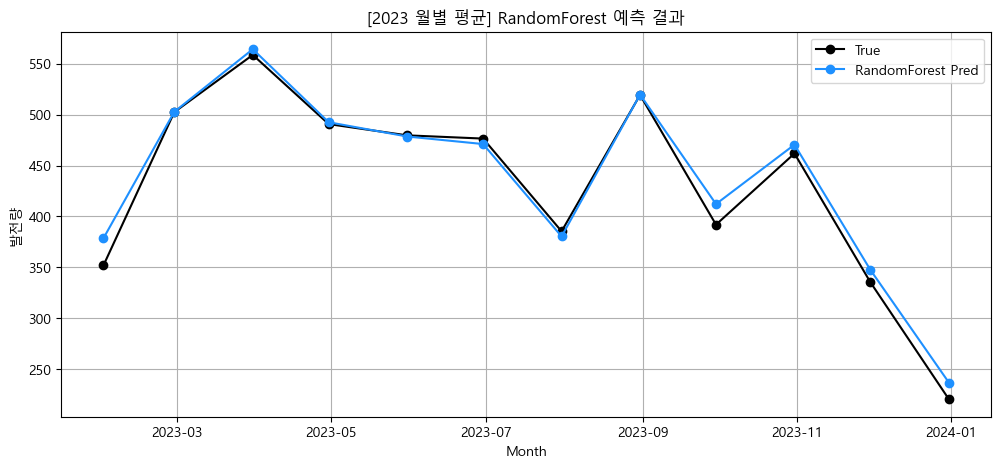
XGBoost 성능:
MAE: 74.0851
RMSE: 117.2792
R2: 0.9071
Normalized RMSE: 0.081383
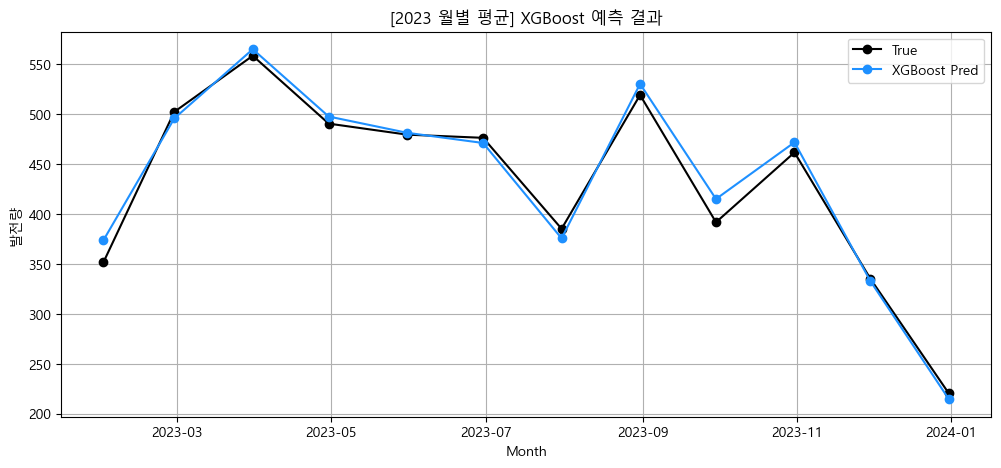
LightGBM 성능:
MAE: 70.7654
RMSE: 113.7274
R2: 0.9126
Normalized RMSE: 0.078918
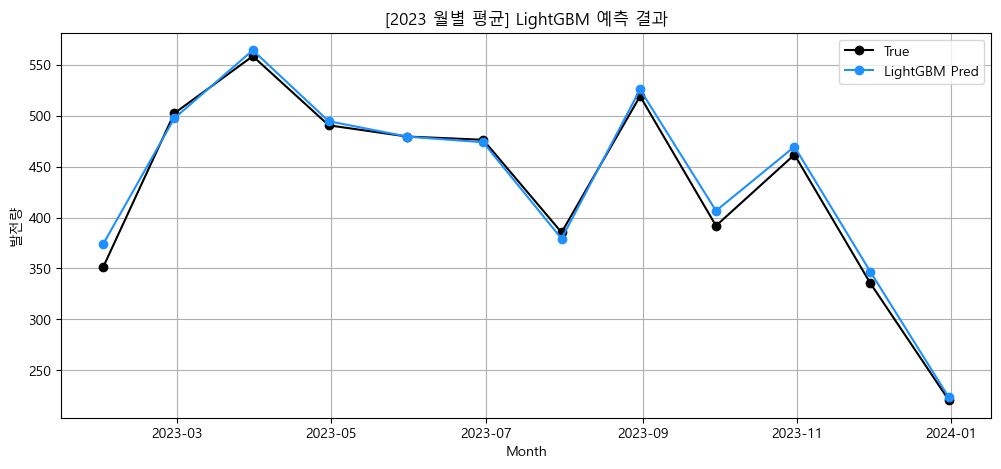
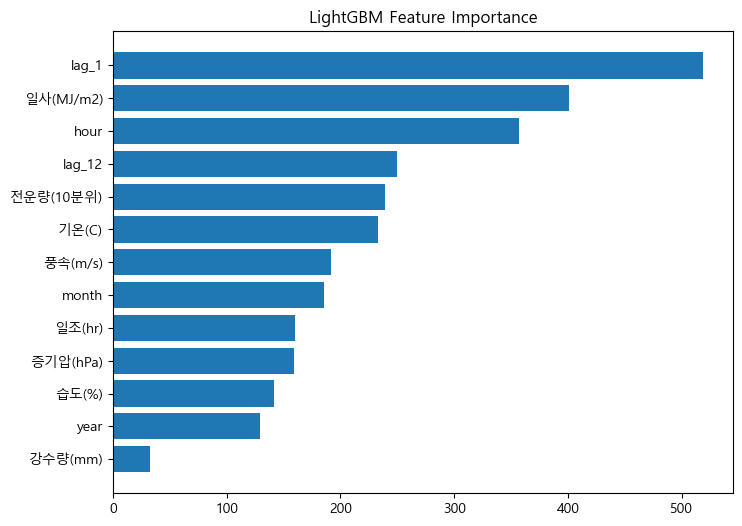
0이 많은 값들에 대해서 잘 잡아냈기에 성능이 매우 좋았고, 특성중요도를 통해 중요도가 많이 떨어졌던 강수량(mm)을 추가로 삭제했다.
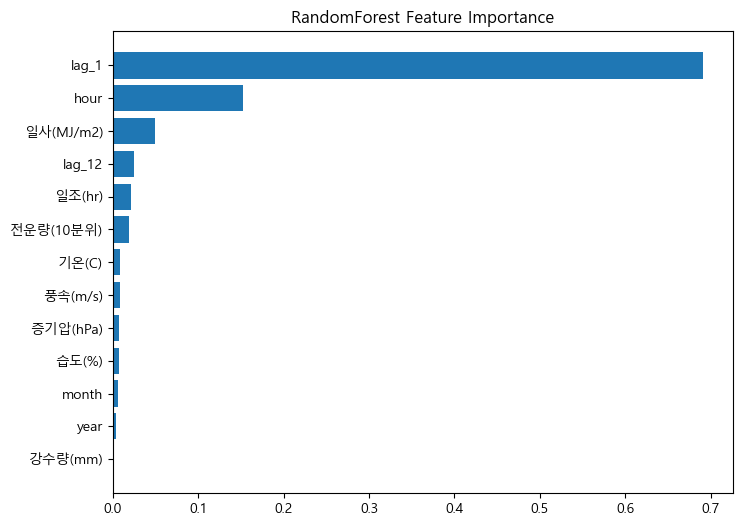
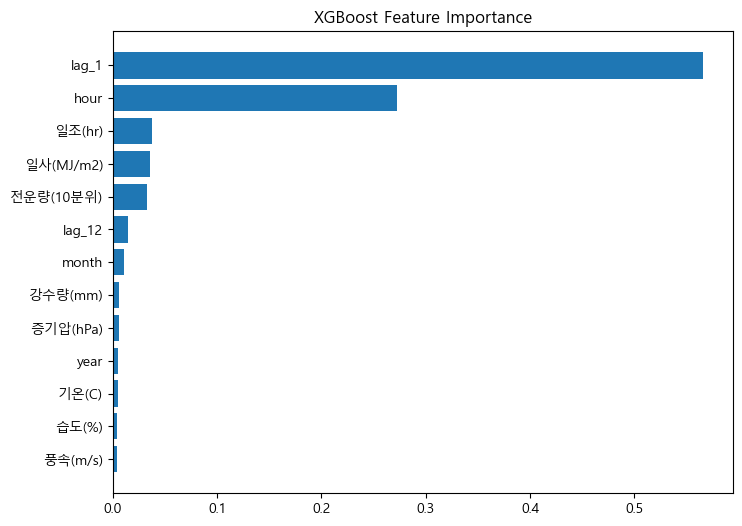
이후 하이퍼 파라미터 튜닝을 통한 최종 성능은 다음과 같았다.
RandomForest 최종 성능 (튜닝 후)
MAE: 70.0522
RMSE: 114.7172
R2: 0.9111
Normalized RMSE: 0.079605
XGBoost 최종 성능 (튜닝 후)
MAE: 70.8812
RMSE: 113.9987
R2: 0.9122
Normalized RMSE: 0.079106
LightGBM 최종 성능 (튜닝 후)
MAE: 70.0704
RMSE: 113.1239
R2: 0.9135
Normalized RMSE: 0.078499
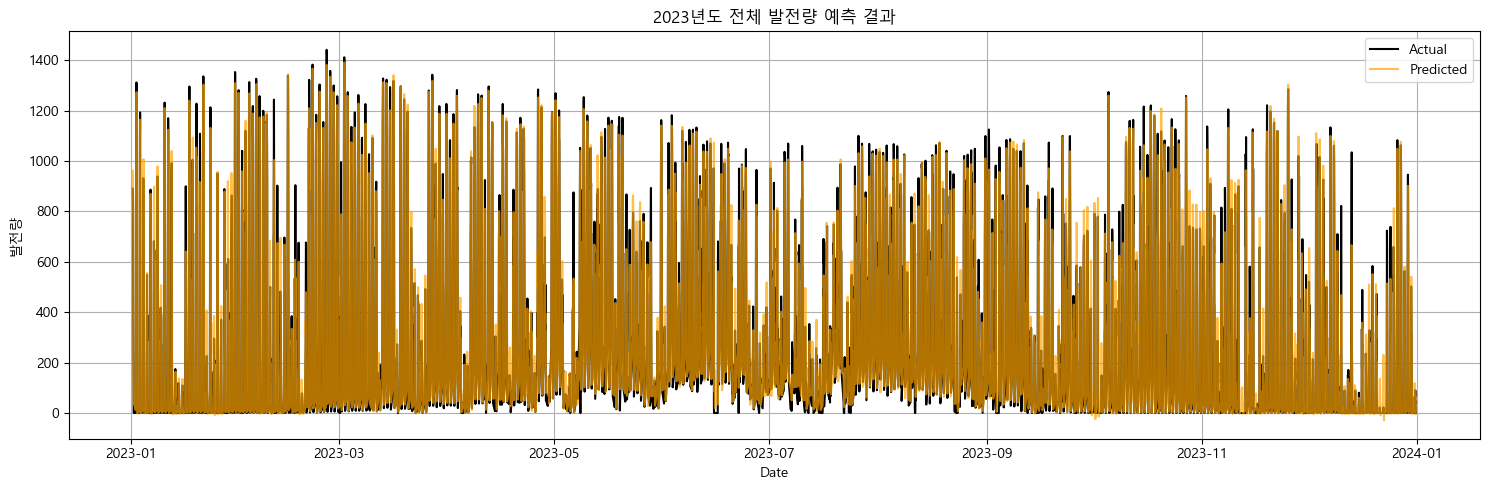
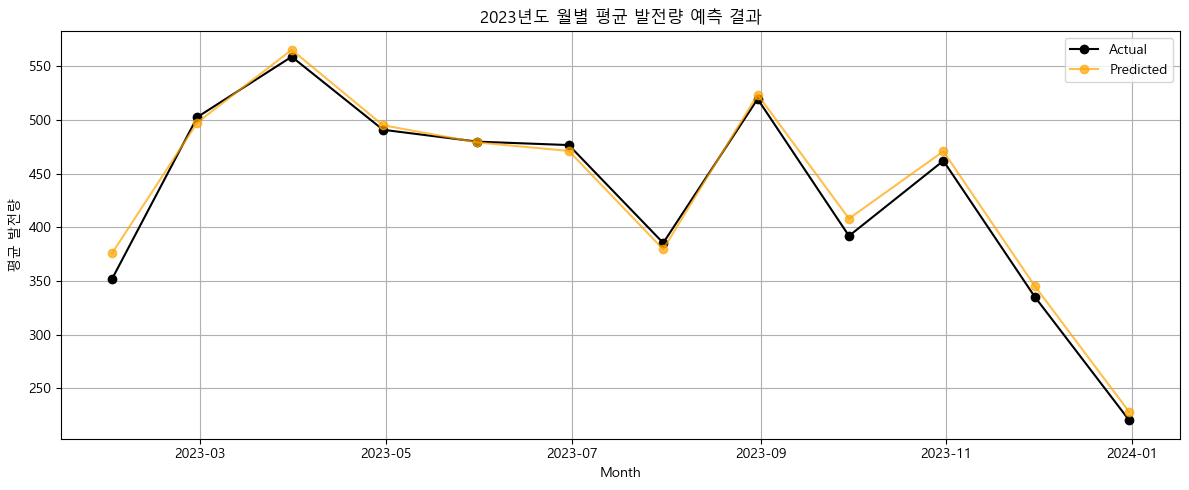
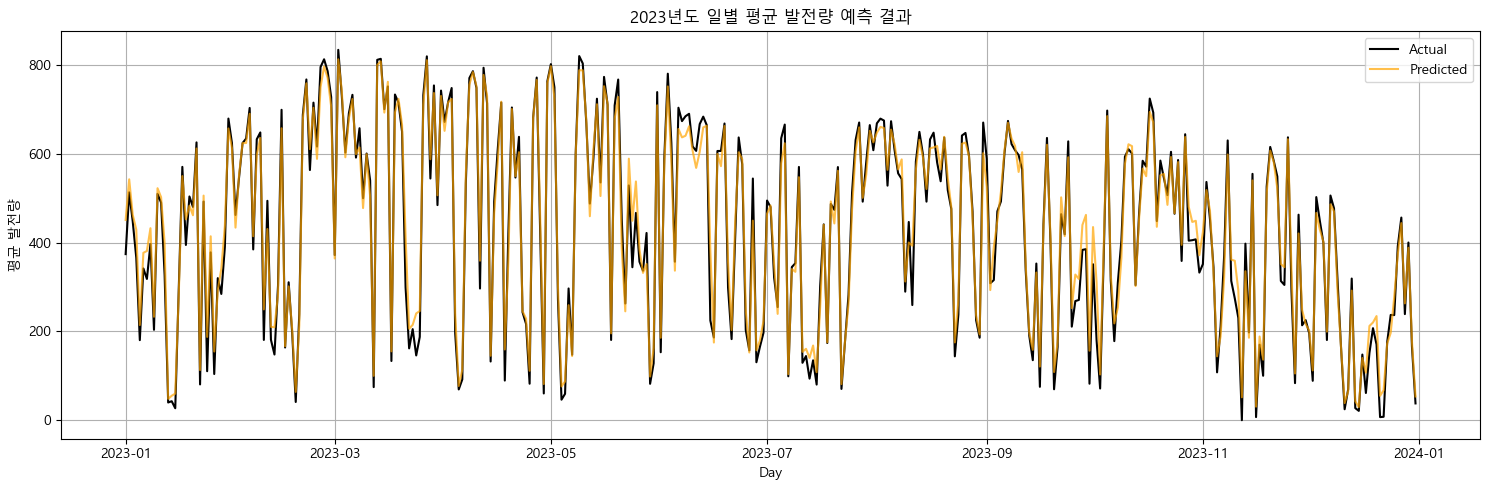
여기서 가중치 앙상블(LGBM 0.5 / XGBoost 0.3 / RandomForest 0.2)의 결과는
가중치 앙상블 결과 (LGBM 50%, XGB 30%, RF 20%)
MAE: 69.6484
RMSE: 112.9758
R2: 0.9137
Normalized RMSE: 0.078397
이와같이 가장 최상의 성능을 뽑아냈다.
1.4. 최종정리
2. 마무리
이와같이 프로젝트를 진행했는데 주제를 잡는데 시간이 너무 오래걸려서 시간에 쫓기며 프로젝트를 진행했다.
모델들에 대한 이해도 조금 부족했고, 한번 실행할 때마다 실행시간이 생각보다 너무 길어져서 다양한 시도를 못해본 부분이 너무 아쉬웠다.
특히 SARIMAX의 경우는 그냥 제외해야할 정도라고 생각이 든다.
이에 대해 해결방법을 찾아서 돌려보는 과정이 필요할 거 같다.