[AIOps Agent 3] Grafana 생태계 연결
이 글에서 다룰 주제
- Grafana 생태계: 수집·저장·조회·알림의 역할을 어떻게 나눌까?
- Agent 연결: webhook으로 조사를 시작하고 어떤 API로 근거를 모을까?
- 사용자 경험: 보고서에서 대시보드·로그·트레이스로 어떻게 돌아갈까?
- 직접 실습: Grafana에서 쿼리를 입력하고 수집 성공과 빈 결과를 어떻게 구분할까?
주요 단어 · Alloy · Prometheus® · Mimir · Loki · Tempo · Pyroscope · PromQL · LogQL · TraceQL
읽기 안내 · HTTP와 메트릭·로그·트레이스의 이름을 아는 독자를 위한 글이다. 먼저 연결 구조와 조회 예제를 이해하고, 7절에서 Grafana·Prometheus를 직접 실행한다. 세 신호의 AIOps 조회는 설계 예시이고, 실제 실행 화면은 Prometheus 자체 수집 실습이다.
가상 장애 inc-42에서 team-a의 checkout 서비스가 느려졌다. 분석 대상은 staging, 시간은 2026-10-04 01:00~01:10 UTC(한국시간 10:00~10:10)다. Grafana 대시보드는 그래프를 보여 주지만, 운영자는 어떤 로그와 배포를 확인할지 판단해야 한다.
이번 편은 이 사이에 조사 에이전트를 넣는 방법을 다룬다. 수집기가 데이터를 보내는 경로와 에이전트가 이미 저장된 데이터를 읽는 경로를 나누어 이해하면 연결이 쉬워진다.
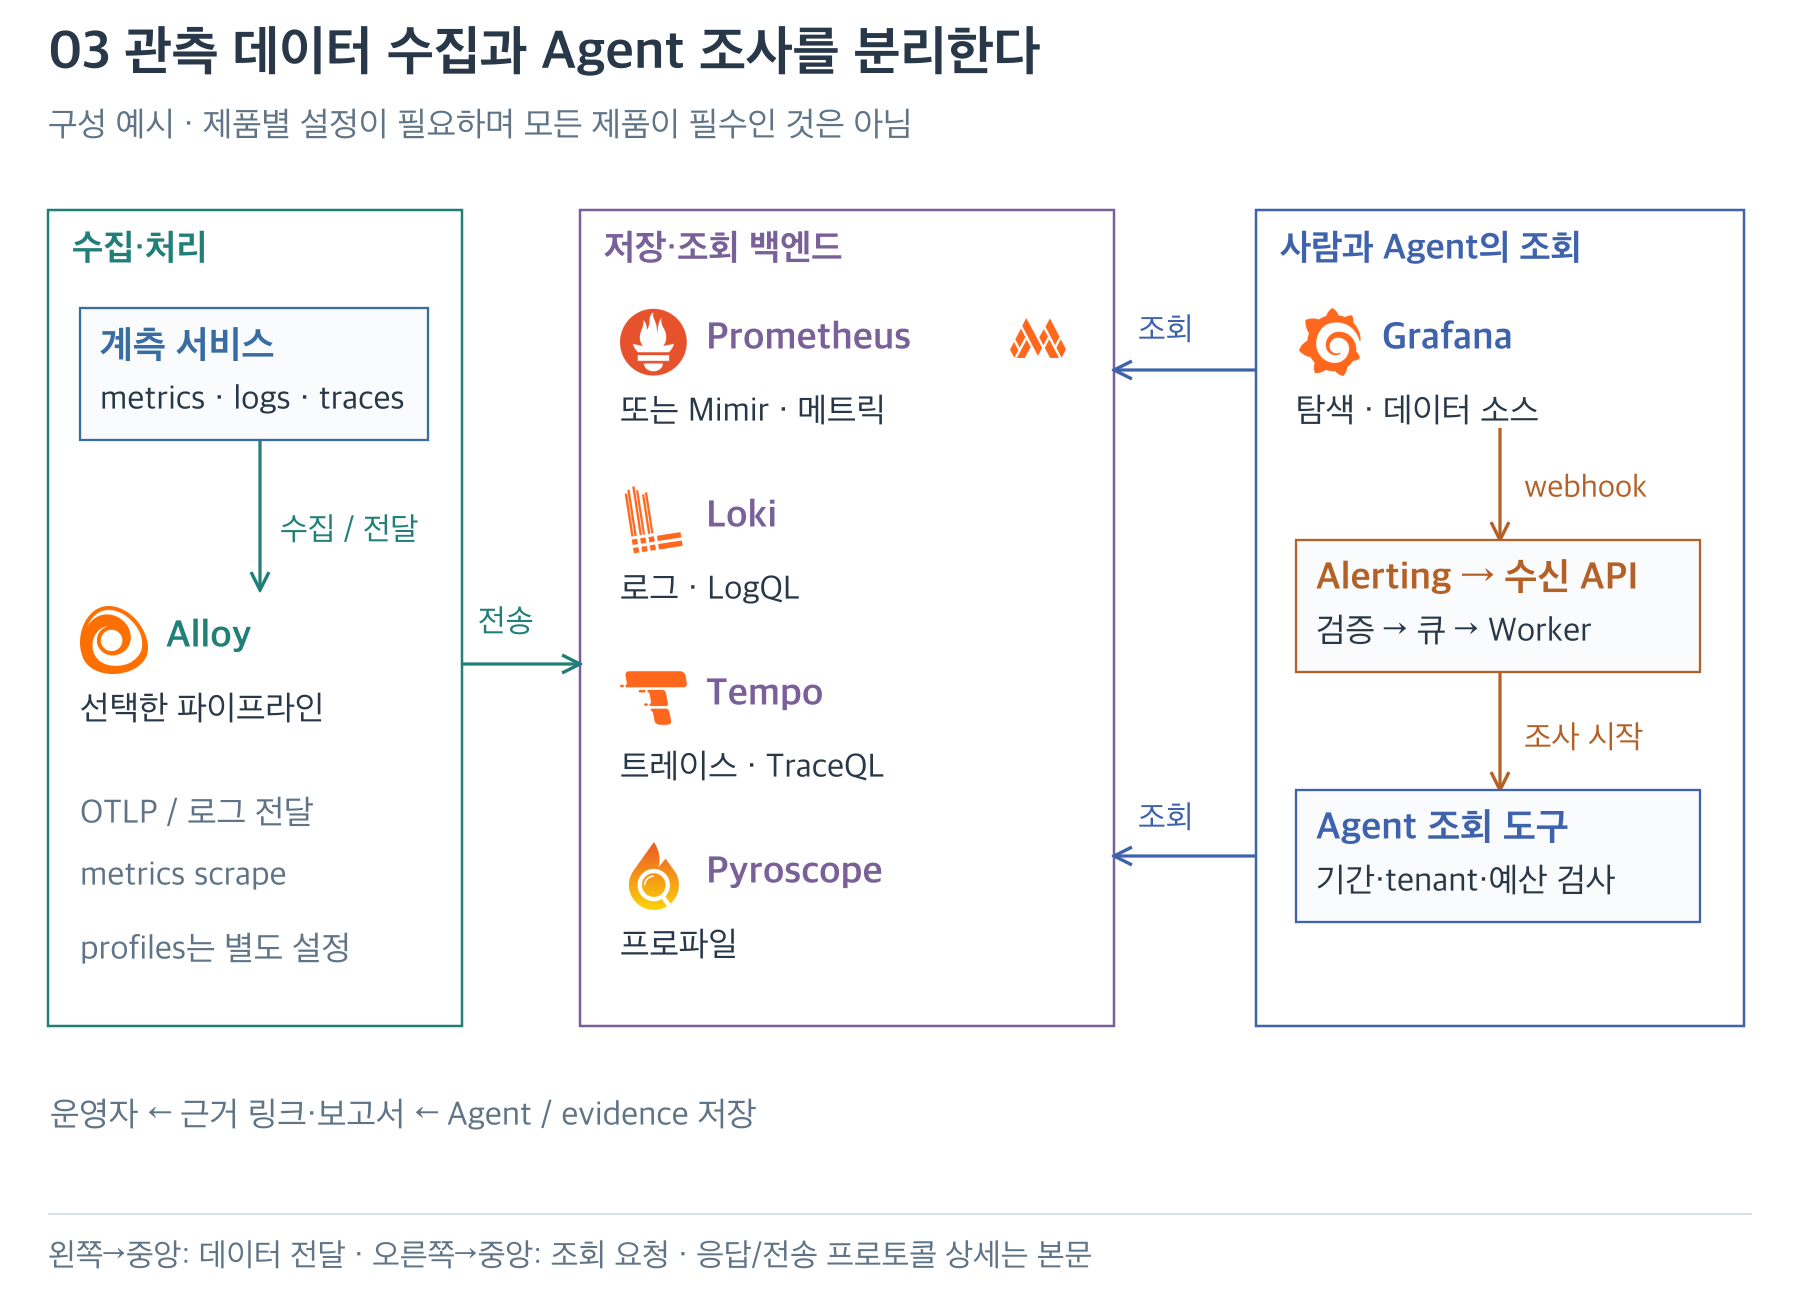
그림 1. 왼쪽은 수집·처리, 가운데는 저장·조회 백엔드, 오른쪽은 사람과 에이전트의 조회다. 데이터는 왼쪽에서 가운데로, 조회 요청은 오른쪽에서 가운데로 향한다. Alerting webhook은 수신 API의 검증·큐·Worker를 거쳐 조사를 시작하는 한 가지 구성 예시다.
1. Grafana 생태계
Grafana는 여러 백엔드의 관측 데이터를 탐색하는 화면을 제공한다. 메트릭·로그·트레이스의 수집과 저장은 아래 구성 요소가 나누어 맡는다.
| 구성 요소 | 역할 | 에이전트와의 연결 |
|---|---|---|
| OpenTelemetry | 계측과 텔레메트리 전송을 위한 표준·도구 | 서비스명·환경·trace 문맥 정렬 |
| Grafana Alloy | 텔레메트리 수집·처리·전달 | 에이전트가 읽을 데이터의 수집 경로 |
| Prometheus | 메트릭 수집·저장·PromQL 조회 | 오류율·요청량·지연 조회 |
| Mimir | 확장 가능한 메트릭 백엔드 | 규모·보존 요구에 따라 도입 |
| Loki | 로그 저장·LogQL 조회 | 오류 메시지·패턴·trace ID 확인 |
| Tempo | 분산 트레이스 저장·조회 | 지연된 요청의 구간 조사 |
| Pyroscope | 지속적 프로파일링 | CPU·메모리 사용 코드 경로 조사 |
| Grafana | 데이터 소스 조회·시각화·알림 | 근거 탐색과 운영 화면 |
모든 구성 요소를 첫날 설치할 필요는 없다. 기존 Prometheus와 Grafana가 있다면 조회 도구부터 붙이고, 로그·트레이스는 실제 데이터가 준비됐을 때 확장한다.
Alloy를 쓴다고 모든 신호가 자동 수집되는 것도 아니다. 수집 대상과 파이프라인 설정이 필요하다. Alloy 소개 · Grafana Data Sources
Grafana Agent는 수집 제품의 이름이며 이 시리즈의 AI Agent와 다르다. 해당 제품은 2025-11-01 EOL에 도달했으므로 신규 수집 설계는 Alloy를 검토한다. Grafana Agent 공식 안내
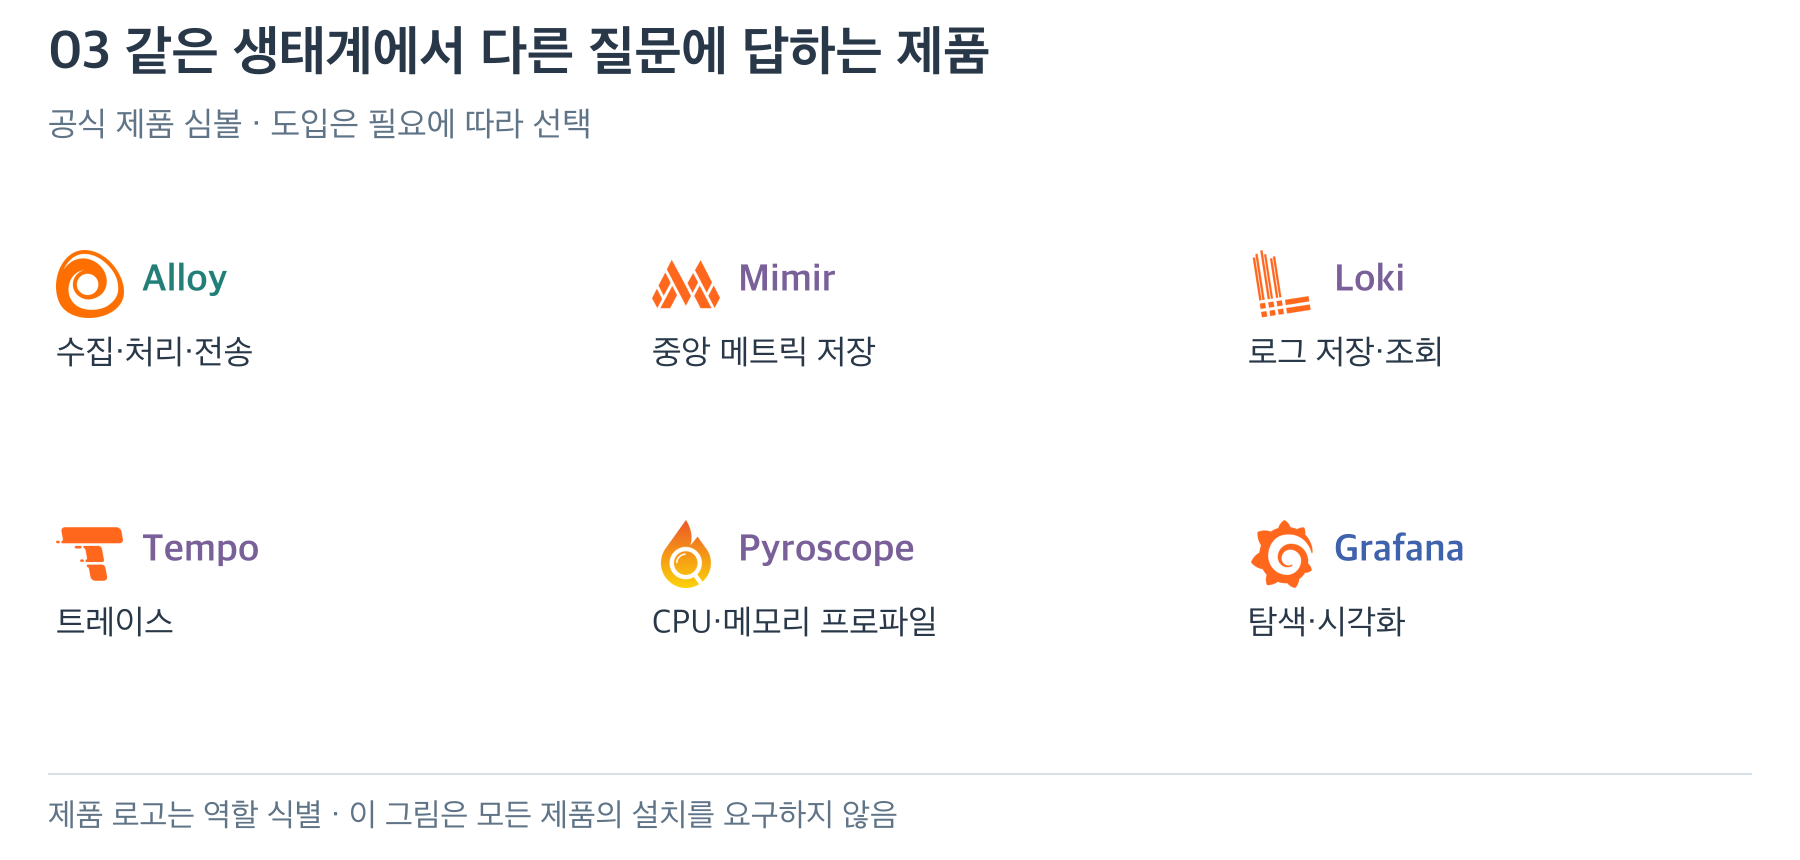
그림 2. 각 제품의 공식 심볼 옆에 역할을 적었다. Alloy는 수집·처리·전송, 나머지 제품은 메트릭·로그·트레이스·프로파일 저장이나 탐색을 맡는다. 필요한 질문에 맞춰 선택하며 여섯 제품을 모두 설치해야 하는 구성은 아니다.
예를 들어 요청 p95가 높다는 사실은 메트릭에서, 특정 요청이 DB 응답을 기다렸다는 단서는 트레이스에서 찾는다. CPU 시간이 어느 함수에 집중되는지까지 파고들 때는 프로파일이 다른 질문에 답한다. 따라서 Pyroscope를 붙인다고 Loki나 Tempo가 불필요해지는 것은 아니다. 제품별 역할: Grafana 공식 OSS 안내
1.1 최소 구성과 확장
checkout을 연결할 최소 설계는 checkout의 /metrics → Prometheus → Grafana, 그리고 Agent → Prometheus 조회 API다. /metrics는 애플리케이션이 메트릭을 노출하는 HTTP 경로이고, Prometheus가 이 내용을 주기적으로 읽는 동작을 scrape라고 한다.
Agent는 이미 저장된 데이터를 질의한다. 수집 주기와 조사 요청 주기는 다르다. 이 글의 7절 실제 실습에서는 먼저 Prometheus가 자기 메트릭을 수집하도록 만든다. checkout 애플리케이션이나 지연·오류 데이터를 생성한 실습과 혼동하지 말자.
중앙 수집이 필요하면 Alloy의 선택한 컴포넌트로 메트릭을 scrape하여 remote_write로 Mimir 같은 백엔드에 전달하는 경로를 구성할 수 있다. 로그는 Loki, 트레이스는 Tempo, 프로파일은 Pyroscope에 맞는 수집 경로를 각각 설정한다. “Alloy → 모두”라는 한 줄은 구성해야 할 실제 파이프라인을 생략한 개념 표현일 뿐이다.
Grafana에서 데이터 소스를 등록하는 일은 저장소에 질문할 연결을 만드는 일이다. 애플리케이션의 계측과 백엔드 적재는 따로 준비해야 한다. 따라서 Grafana에 Tempo를 추가했는데 trace가 없다면 데이터 소스 설정만 반복하지 말고 SDK 계측·export·수집기·적재 상태를 차례로 확인한다.
1.2 OpsLake의 역할
사용자 제공 학습 자료의 OpsLake Provider는 로그·메트릭·트레이스·배포 이력을 제공하는 역할로 이해할 수 있다. 이 시리즈에서 그 역할을 구현하기 위해 기존 저장소를 전부 하나의 DB로 이전할 필요는 없다.
메트릭은 Prometheus나 Mimir, 로그는 Loki, 트레이스는 Tempo, 배포 이력은 Git·배포 API에 남겨 두고 공통 조회 계약으로 연결하는 방식을 선택할 수 있다. 특정 업체의 OpsLake 내부 구조를 단정하는 설명은 아니다.
에이전트가 필요한 것은 “모든 데이터가 한 테이블에 있다”보다 “같은 서비스·환경·시간의 자료를 찾고 출처를 추적할 수 있다”는 조건이다. 반면 Runbook·SOP·검토된 장애 이력은 Knowledge Base에서 검색한다. 현재 운영 관측과 문서 검색을 하나의 원시 데이터 입력으로 섞지 않는다.
2. 알림 수신과 조사
Grafana Alerting의 webhook contact point를 Agent 수신 API에 연결하는 구성을 생각할 수 있다. webhook payload에는 여러 알림이 묶일 수 있으므로 단일 이벤트라고 가정하지 않는다. 사용 버전에서 제공하는 인증·서명 기능을 확인하고 원문 본문 기준 서명을 검증한다. HMAC와 timestamp가 구성된 경우 timestamp 허용 범위도 검사한다. Webhook notifier
수신 API는 오래 걸리는 LLM 조사를 직접 수행하지 않는다. 요청을 검증하고, 영속적인 이벤트 저장 또는 큐 등록이 끝난 뒤 응답한다.
Worker가 run(한 번의 조사 실행)을 만들고 조사한다. HTTP 요청이 끊겨도 조사 상태가 남도록 하기 위해서다.
정규화할 필드는 tenant, service, environment, cluster, alert_fingerprint, startsAt, status, received_at이다. tenant는 신뢰된 인증 문맥으로 확정한다. label에 적힌 tenant를 그대로 권한으로 사용하지 않는다.
중복 키는 예를 들어 tenant + fingerprint + startsAt + status로 설계할 수 있다. 그룹의 개별 알림마다 처리하며 firing 반복·resolved·재발의 의미를 나눈다. 단순히 fingerprint만 저장하면 이후 발생한 새 장애까지 중복으로 버릴 수 있다. DB unique 제약과 처리 상태를 이용해 중복 워커 생성을 막는다.
2.1 중복·유실 방지
- 수신 API가 TLS·인증·본문 크기를 확인한다.
- 신뢰된 문맥에서 tenant를 확정하고 payload 안의 개별 알림을 정규화한다.
- 이벤트와 작업 예정 상태를 영속 저장한다.
- 저장 성공 후 webhook에 응답한다.
- Worker가 작업을 점유하고 조사한다.
DB에 이벤트를 저장한 뒤 큐 발행이 실패하면 이벤트가 있지만 작업은 시작되지 않는 틈이 생긴다. Outbox는 이벤트와 함께 “큐에 전달할 예정”이라는 기록을 같은 DB 트랜잭션에 남기는 방식이다. 별도 발행기가 이 기록을 읽어 큐로 전달한다.
처음부터 DB 기반 작업 큐를 쓰는 대안도 있다. 어떤 방식을 쓰든 같은 이벤트가 여러 번 도착할 때 같은 조사나 변경을 중복 실행하지 않는 멱등성이 필요하다.
알림의 resolved는 알림 규칙이 더 이상 firing이 아니라는 뜻이다. 근본 원인 해결, 모든 사용자 복구, Agent 보고서 검증 완료와 같은 의미로 합치지 않는다.
3. 조회 경로
에이전트의 조회는 백엔드 API를 직접 호출하거나 Grafana 데이터 소스를 거치는 방식으로 구성할 수 있다.
| 경로 | 적합한 상황 | 확인할 점 |
|---|---|---|
| Prometheus·Loki·Tempo 직접 조회 | 백엔드별 계약을 명확히 유지 | 백엔드 인증·tenant·네트워크 정책 |
| Grafana 데이터 소스 경유 | Grafana의 구성된 데이터 소스 활용 | 플러그인별 쿼리 형식, 서비스 계정 권한 |
둘 중 하나가 모든 환경의 정답은 아니다. 이 글은 src/aiops_agent/adapters/가 백엔드 조회 API를 호출하고 Grafana는 사람이 근거를 확인하는 화면으로 사용하는 구성을 기본으로 한다.
예를 들어 tools/metrics.py는 모델에 “지연 요약을 조회할 수 있다”는 도구 계약을 제공한다. policy/는 대상과 조회 범위를 검사하고, adapters/prometheus.py는 실제 HTTP 요청·인증·응답 변환을 수행한다. 모델이 백엔드 주소나 인증 헤더를 직접 만드는 구조가 아니다.
Grafana에서 Viewer 역할을 줬다고 모든 데이터 소스의 행·tenant 격리가 자동 보장되는 것은 아니다. 세밀한 데이터 소스 권한과 RBAC는 OSS·Enterprise·Cloud에서 기능 범위가 다르다. Grafana Roles and permissions
특히 Loki HTTP API 자체는 인가를 제공하지 않으므로 앞단 인증·인가 구성이 필요하다. 멀티테넌트 헤더는 신뢰된 서버가 주입해야 하며 외부 사용자가 임의로 선택하도록 두지 않는다. Loki HTTP API
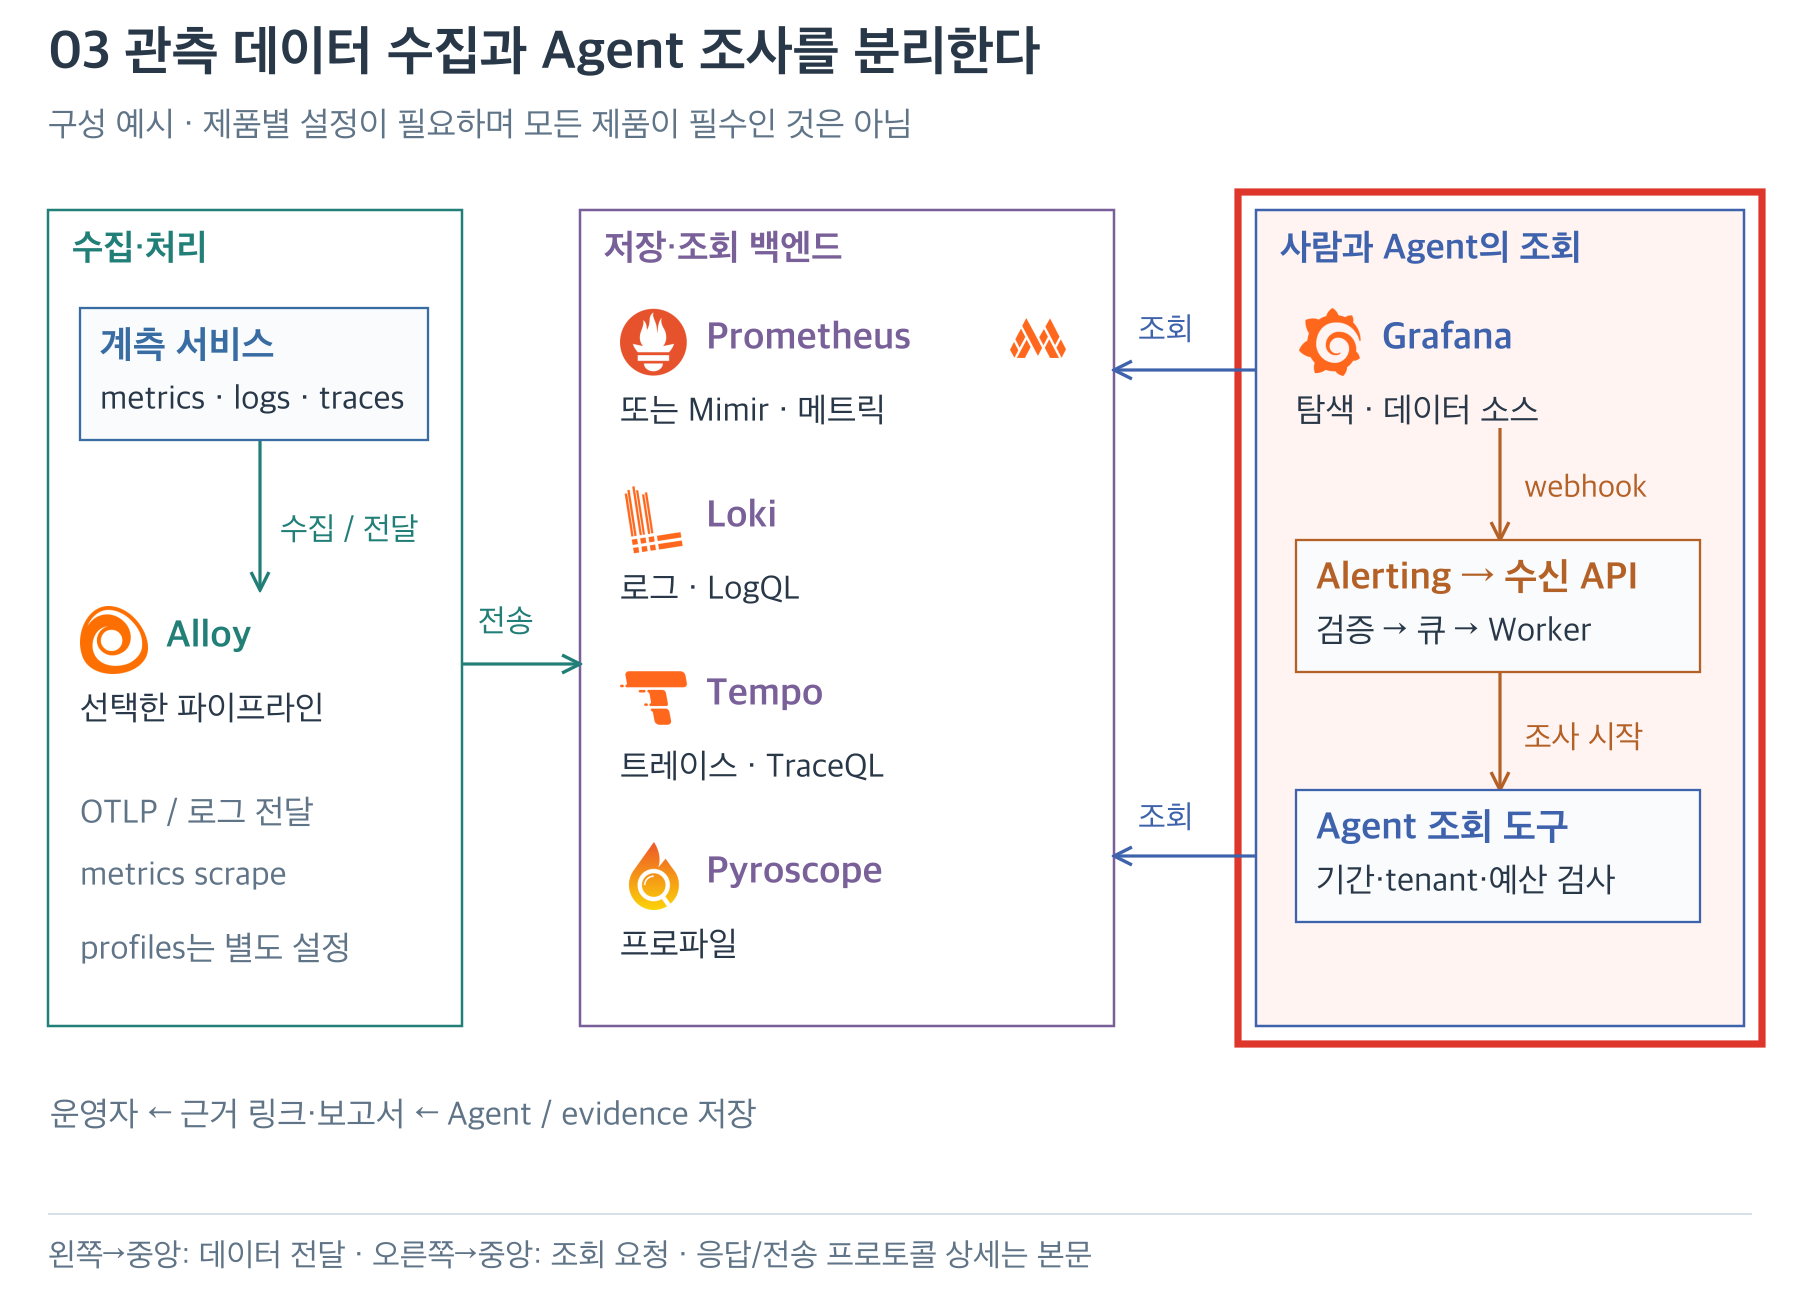
그림 3. 그림 1과 같은 배치에서 오른쪽 조회·알림 영역을 빨간 테두리로 강조했다. 파란 조회 화살표는 백엔드로 향하고, 알림 경로는 수신 API에서 조사를 시작한다. 결과 반환 화살표는 가독성을 위해 생략했다.
3.1 공통 필드 계약
메트릭·로그·트레이스에서 같은 서비스를 찾으려면 백엔드별 필드 이름과 변환 규칙을 먼저 맞춰야 한다.
| 의미 | 이 글의 예제 필드 | 확인할 곳 |
|---|---|---|
| 서비스 이름 | OTel service.name | SDK Resource 설정 |
| 메트릭 필터 | service="checkout" | 실제 metric label |
| Loki 로그 필터 | service_name="checkout" | 적재 후 label·metadata |
| Tempo 필터 | resource.service.name | 저장된 span Resource |
| 실행 환경 | 예제의 environment="staging" | 각 백엔드 변환 규칙 |
Loki의 네이티브 OTLP 적재는 service.name처럼 점이 있는 속성 이름을 service_name으로 정규화한다. 그렇다고 모든 속성이 자동으로 인덱스 라벨이 되는 것은 아니다. 적재 설정에 따라 structured metadata 등에 저장될 수 있다. Loki OTLP 적재
이 글의 environment는 단순화한 예제 라벨이다. 실제 OTel 환경 속성을 무엇으로 쓰고 각 저장소에서 어떻게 조회할지 별도로 매핑한다. tenant 역시 일반 라벨 하나를 붙이는 것만으로 보안 격리가 완성되지 않는다.
3.2 허용 질의 연결
처음에는 run_any_query(query)보다 질문이 분명한 도구를 제공하는 편이 검증하기 쉽다. 모델은 “checkout의 p95를 조회하자”고 요청하고, 서버는 승인된 서비스 매핑과 질의 템플릿을 사용한다.
| 모델에 제공하는 도구 | 서버가 선택하는 템플릿 | 실제 연결 위치 |
|---|---|---|
get_latency_summary | classic histogram p95 | adapters/prometheus.py |
get_error_ratio | 같은 범위의 5xx/전체 요청 비율 | adapters/prometheus.py |
find_timeout_logs | 허용 label + timeout 필터 | adapters/loki.py |
find_slow_traces | 서비스·span duration 조건 | adapters/tempo.py |
예를 들어 입력은 service=checkout, start, end이며 Tenant와 허용 환경은 인증된 실행 문맥에서 가져온다. template_id를 모델에 보여 주더라도 서버의 허용 목록에서만 선택하게 한다. 임의 URL·HTTP 헤더·Tenant를 모델 입력으로 신뢰하지 않는다.
검증 → 매핑 → 조회 → 근거 변환 순서로 읽으면 된다. 먼저 사용자와 서비스 범위를 확인한다. 그다음 서비스 카탈로그에서 실제 라벨을 찾고, 검증한 템플릿에 안전하게 결합한다. Adapter는 시간 초과·권한 오류·빈 결과를 구분하고 단위·질의·조회 범위를 포함한 Evidence로 반환한다.
이 방식은 모든 운영 질문을 처리하지 못할 수 있다. 자유로운 PromQL이 필요해질 때는 별도 분석 기능으로 설계해 질의 비용·허용 데이터·시간창·반환량을 검증한다. 문자열에 금지 단어 몇 개가 없는지만 검사하는 것은 충분한 권한 통제가 아니다.
4. 신호별 조회
아래 네 질의는 가상 checkout 메트릭·라벨을 사용한 설계 예시이며 실제 백엔드에서 실행하지 않았다. 실제 환경의 metric 이름, HTTP status label, histogram 형태에 맞춰 바꿔야 한다. 이 절의 조회 구간은 앞서 정한 01:00~01:10 UTC를 공통으로 사용한다.
① PromQL: 요청 기준 오류 비율
sum(rate(http_requests_total{
  service="checkout", environment="staging", status=~"5.."
}[5m]))
/
sum(rate(http_requests_total{
  service="checkout", environment="staging"
}[5m]))rate는 누적 counter의 초당 증가율을 구한다. 먼저 각 인스턴스의 5xx 요청 증가율을 합하고, 같은 범위의 전체 요청 증가율 합으로 나눈다. 초당 요청 수끼리 나누므로 결과는 단위 없는 비율이며 0.02는 2%다.
분모가 0이거나 시계열이 누락되면 정상 0%라고 해석하지 않는다. 저트래픽 구간은 최소 요청 수 조건을 함께 둔다. 기간별 시계열은 GET /api/v1/query_range에 query, start, end, step을 전달해 조회한다. Prometheus HTTP API
② PromQL: classic histogram의 p95
histogram_quantile(0.95,
  sum by (le) (rate(http_request_duration_seconds_bucket{
    service="checkout", environment="staging"
  }[5m]))
)
단위는 초다. p95는 요청의 약 95%가 그 시간 이내에 끝난다는 분포 요약이며 평균이 아니다.
안쪽 rate는 bucket counter의 증가율을 계산하고 sum by (le)는 bucket 상한별로 인스턴스를 합친다. 바깥 histogram_quantile이 이 분포에서 95번째 백분위수를 추정한다. 위 식은 classic histogram 예시이므로 bucket 설계·샘플 수·수집 형태를 확인한다. 인스턴스별 p95를 단순 평균 내지 않는다. 신규 계측에서는 native histogram 지원도 검토한다. Prometheus Histograms
③ LogQL: 같은 서비스의 timeout 메시지
{service_name="checkout", environment="staging"} |= "timeout"Loki의 GET /loki/api/v1/query_range에서 같은 시간 범위와 제한된 limit를 적용한다. 선택된 로그가 전체 로그를 대표한다고 가정하지 말고 반환 상한과 잘림 여부를 표시한다. 민감한 메시지는 모델에 전달하기 전에 마스킹한다. Loki HTTP API
④ TraceQL: 느린 span을 포함한 트레이스 후보
{ resource.service.name = "checkout" && duration > 1s }위 duration 조건은 span 소요 시간을 기준으로 매칭한다. trace 전체 소요 시간과 혼동하지 않는다. 조회 기간·환경·tenant는 도구에서 추가로 제한한다. Tempo 검색으로 후보를 찾고 trace ID로 상세 span을 확인한다. 배포 버전과 지원 검색 API에 맞춰 adapter를 구현한다. Tempo HTTP API · TraceQL 예시
위 예시는 서로 다른 라벨 표기를 의도적으로 보여 준다. OTel의 service.name, Loki의 service_name, Prometheus의 service가 자동으로 같은 이름이 되는 것은 아니다. 매핑 규칙과 정규화된 서비스 카탈로그가 있어야 교차 조사가 가능하다.
4.1 계산창과 step
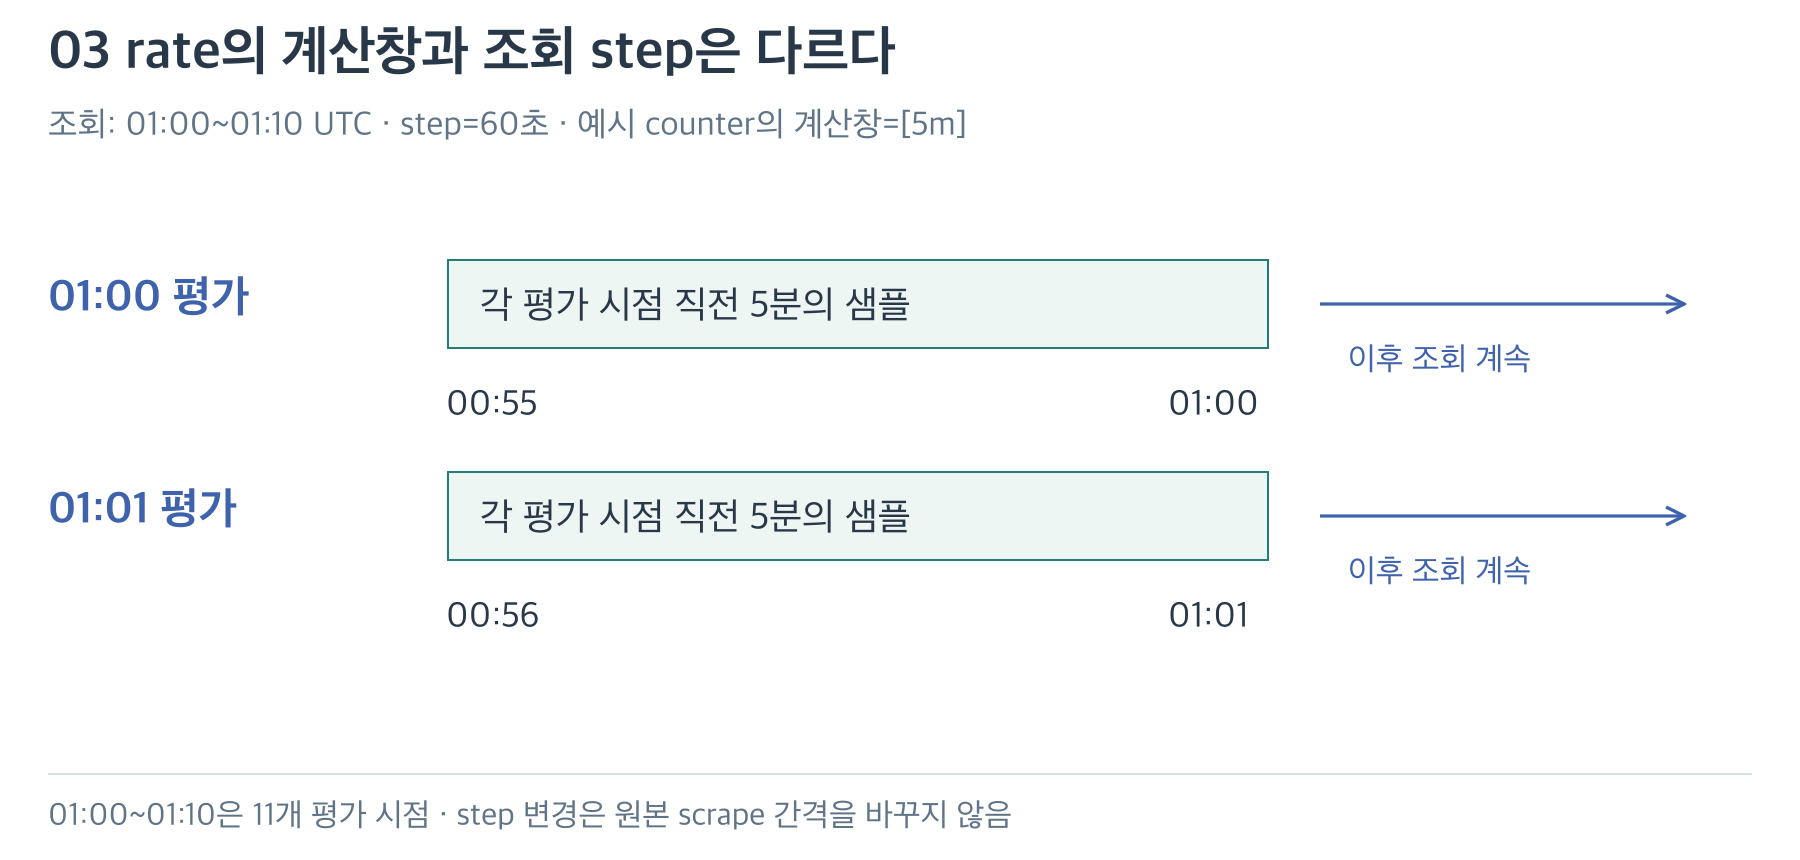
그림 4. 전체 조회 구간은 01:00~01:10 UTC이며 step=60초이면 양 끝을 포함해 11개 평가 시점이 된다. 그림은 처음 두 시점의 계산창을 확대했다. 01:00 계산에는 00:55 이후 샘플이 필요하며, step 변경이 원본 scrape 간격을 바꾸지는 않는다.
start=01:00, end=01:10, step=60s이면 양 끝을 포함해 11개 평가 시점을 요청한다. 각 시점에서 [5m]에 해당하는 직전 5분의 counter 샘플을 읽는다. step을 1분에서 10초로 줄인다고 원본 scrape 주기가 10초로 바뀌지 않는다. 이미 저장된 자료를 더 촘촘하게 평가할 뿐이다. Prometheus Querying basics
1분 step 11개 점에서 얻은 p95의 평균은 10분 전체 요청의 p95가 아니다. 질문이 “시간에 따라 얼마나 변했나?”라면 시계열을 보고, “이 기간의 전체 분포는?”이라면 집계 목적에 맞는 질의를 다시 설계한다.
4.2 오류율 해석
설명용으로 같은 범위에서 5xx 증가율이 초당 2건, 전체 요청 증가율이 초당 100건이라고 하자. 결과는 2/100=0.02, 즉 2%다. Grafana에서 비율을 percent(0–1)로 표시할지, 100을 곱해 percent(0–100)로 표시할지 일치시킨다. 이중으로 100을 곱하면 200% 같은 잘못된 값이 나온다.
sum(rate(...))에서는 각 counter의 reset을 처리한 뒤 합산한다. 서비스 전체 counter를 먼저 합쳐 증가율을 계산하면 인스턴스별 재시작을 잘못 해석할 수 있다. 또한 오류 시계열이 생성되지 않은 것과 실제 오류 0건은 다르므로, 분자 누락을 무조건 0으로 채우기 전에 계측 계약과 수집 상태를 확인한다.
4.3 로그·트레이스 탐색
p95만 증가하고 오류율이 유지되면 “느리지만 성공한 요청”을 조사할 수 있다. timeout 로그가 함께 보이면 trace ID가 있는 예시를 골라 호출 경로를 확인한다.
가령 HTTP span 1.4초 중 DB client span이 1.1초라고 하자. 이 수치는 설명용이며 DB 호출 경로를 주요 지연 후보로 좁혀 준다. 하지만 DB 서버 CPU가 원인이라는 뜻은 아니다. 연결 풀 대기, 네트워크, 락 대기, 느린 SQL을 나눠 확인한다.
로그에 trace ID가 있다고 자동 클릭 연결이 완성되는 것은 아니다. 로그 파싱 위치와 Grafana의 derived field·데이터 소스 링크 설정이 맞아야 한다. 메트릭 exemplar도 계측·저장·데이터 소스 지원과 설정이 필요하다. 연동하지 않은 상태에서는 trace ID를 복사해 Tempo에서 직접 조회하는 최소 경로부터 검증할 수 있다.
트레이스가 샘플링돼 있다면 느린 요청이 저장될 가능성이 편향될 수 있다. trace 목록의 오류 비중을 전체 HTTP 오류율로 사용하지 않는다. 전체 비율은 분모가 정의된 메트릭으로 확인하고 트레이스는 구체적인 실행 경로를 설명하는 데 사용한다.
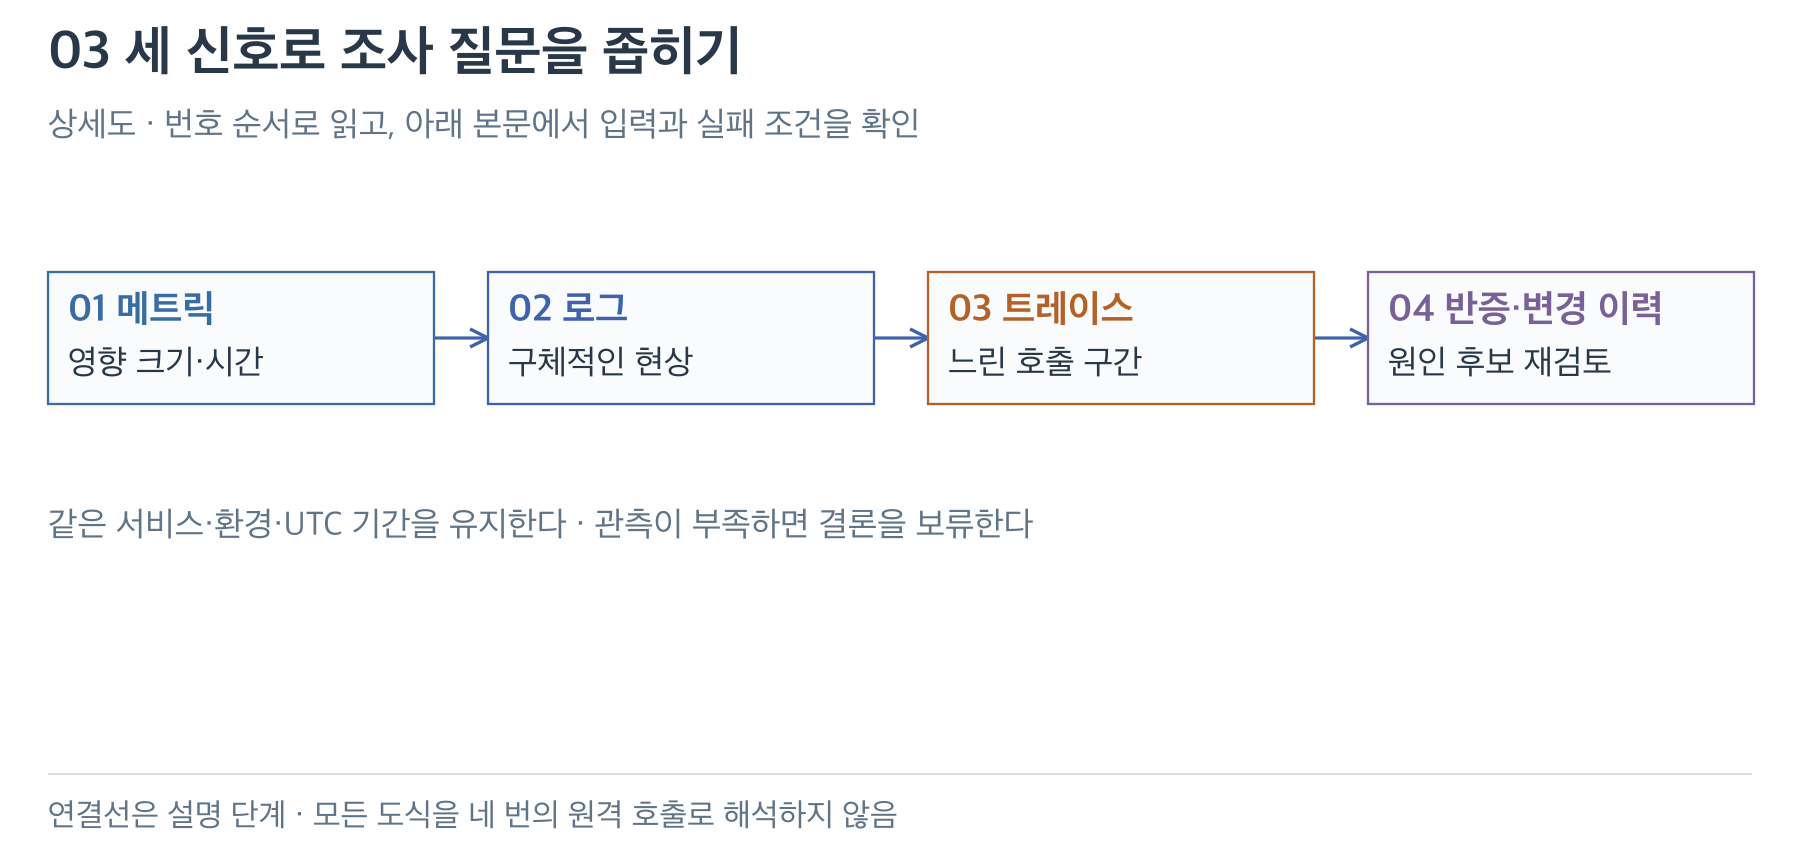
그림 5. 메트릭은 영향 크기와 시간, 로그는 구체적 현상, 트레이스는 느린 호출 구간을 보여 준다. 마지막에는 변경 이력과 반증으로 원인 후보를 재검토한다. 설명 순서이며 증거에 따라 앞 단계로 돌아갈 수 있다.
5. 결측과 조회 실패
Agent는 각 조회에 ok, no_data, stale, timeout, denied를 보존한다. 마지막 샘플 시각, 수집 지연, 조회 step, UTC 범위를 함께 기록한다. 로그·트레이스는 샘플링이나 수집 실패 때문에 일부 요청이 없을 수 있다. “트레이스가 없다”는 사실만으로 해당 문제가 없다고 단정하지 않는다.
배포 직후 지연이 늘었다면 이전 구간과 비교하고, 다른 서비스·리전·버전에서도 같은 변화가 있었는지 확인한다. 공통 의존성 장애와 트래픽 급증을 반증 후보로 둔다. 시간적 상관관계는 원인 확정이 아니다.
에이전트 조회 자체도 운영 부하다. 조회 기간, step의 최소값, 로그 반환량, 동시 조회 수, 재시도 수를 제한한다. 서비스별 큐와 전역 예산을 두면 알림 폭주가 조회 백엔드 장애로 번지는 것을 줄일 수 있다.
6. 조사 카드
조사 카드에는 결론뿐 아니라 원본 근거를 다시 확인할 수 있는 링크와 미확인 항목을 함께 넣는다. 가상 보고서는 다음과 같이 구성한다.
상태: 추가 조사 필요
관측: 01:00~01:10 UTC checkout의 p95가 기준 구간보다 증가했다. [ev-001]
관측: 같은 구간에 DB timeout 로그가 확인됐다. 반환 상한에 도달해 전체 건수는 미확인이다. [ev-002]
후보: DB 연결 대기 또는 하위 서비스 지연. 배포와의 시간적 연관성은 있지만 원인은 확정하지 않았다.
다음 확인: DB pool 사용률, 느린 span, 배포 전후 설정 차이.
각 evidence에는 저장된 정확한 기간과 질의, datasource 식별자, 원문 링크를 붙인다. Grafana dashboard data link 또는 Explore 공유 링크를 사용하되 설치 버전의 링크 형식을 확인한다. URL에 토큰이나 비밀을 넣지 않고, 클릭하는 사용자도 해당 데이터 접근 권한이 있어야 한다.
대시보드에는 조사 상태·대기 시간·성공률 같은 집계 메트릭을 표시한다. run ID나 trace ID를 Prometheus label로 넣으면 카디널리티가 커지므로 상세 ID는 로그·트레이스·보고서에 둔다. 요약 저장과 Grafana annotation 작성도 서로 다른 권한의 작업으로 분리한다.
7. Grafana 조회 실습
이 절은 로컬 Docker의 ARM64 환경에서 Grafana 12.4.0과 Prometheus 3.5.5를 실제 실행하고 Chrome에서 조회한 실습이다. 데이터 소스 선택, PromQL 입력, 실행, 결과 확인을 수행했다. 앞 절의 checkout 지연 메트릭·Loki·Tempo 연결을 실행했다는 뜻은 아니다.
실습 목적은 두 가지다. 먼저 수집된 데이터를 Grafana에서 읽는 경로를 확인한다. 그다음 수집 대상이 없는 질의를 실행해 빈 결과를 정상값 0과 구별한다. Prometheus 자체 수집은 공식 시작 안내에도 소개되는 최소 구성이다. Prometheus 자체 수집 안내
7.1 실습 구성과 주소
| 항목 | 이 실습의 값 | 의미 |
|---|---|---|
| Prometheus | prom/prometheus:v3.5.5 | 자체 메트릭 수집·저장 |
| Grafana | grafana/grafana:12.4.0 | 실제 Explore 조회 화면 |
| 수집 대상 | job="prometheus", localhost:9090 | Prometheus 컨테이너 자기 자신 |
| 수집 간격 | 5초 | 5초마다 scrape 시도 |
| Grafana 접속 | http://127.0.0.1:13044 | 호스트 브라우저에서 사용 |
| Prometheus 접속 | http://127.0.0.1:19044 | 호스트에서 직접 확인할 때 사용 |
| Grafana 내부 연결 | http://prometheus:9090 | Compose 네트워크의 서비스 이름 |
마지막 주소를 http://localhost:19044로 바꾸면 안 된다. Grafana 컨테이너의 localhost는 Grafana 자신이다. 브라우저에서 사용하는 호스트 주소와 컨테이너 사이의 주소를 구별해야 한다.
데이터 소스는 YAML로 미리 등록한다. 이 Provisioning 덕분에 매번 UI에서 주소를 입력하지 않고 같은 구성을 재현할 수 있다. Grafana Provisioning
아래 구성의 익명 Editor는 비민감 데이터만 있는 격리된 localhost 실습을 편하게 진행하기 위한 설정이다. 외부 서버나 운영 Grafana에 적용할 인증 설정이 아니다. 운영 환경에서는 인증·역할·데이터 접근 범위를 별도로 구성한다.
7.2 전체 실행 설정
Docker와 Compose가 사용 가능한 로컬 환경에서 아래 폴더를 만든다. Docker의 현재 context가 원격·운영 서버를 가리키지 않는지 먼저 확인한다. 포트 13044와 19044가 이미 사용 중이면 다른 빈 포트를 고르고 접속 주소도 함께 바꾼다.
docker context show
docker version
docker compose version
mkdir -p lab/grafana/provisioning/datasources
① lab/grafana/compose.yaml
services:
  prometheus:
    image: prom/prometheus:v3.5.5
    command: ["--config.file=/etc/prometheus/prometheus.yml", "--storage.tsdb.retention.time=2h"]
    ports: ["127.0.0.1:19044:9090"]
    volumes: ["./prometheus.yml:/etc/prometheus/prometheus.yml:ro"]
    cpus: 1
    mem_limit: 512m
  grafana:
    image: grafana/grafana:12.4.0
    ports: ["127.0.0.1:13044:3000"]
    volumes: ["./provisioning:/etc/grafana/provisioning:ro"]
    environment:
      GF_AUTH_ANONYMOUS_ENABLED: "true"
      GF_AUTH_ANONYMOUS_ORG_ROLE: Editor
      GF_ANALYTICS_REPORTING_ENABLED: "false"
      GF_ANALYTICS_CHECK_FOR_UPDATES: "false"
      GF_NEWS_NEWS_FEED_ENABLED: "false"
    cpus: 1
    mem_limit: 512m
설정 파일만 읽기 전용으로 마운트한다. 호스트 홈이나 Docker socket은 연결하지 않는다. 서비스별 CPU 1개·메모리 512 MiB 제한과 보존 기간 2시간은 이 작은 실습의 자원 제한이며 제품의 공식 최소 사양이나 운영 용량 기준은 아니다.
② lab/grafana/prometheus.yml
global:
  scrape_interval: 5s
scrape_configs:
  - job_name: prometheus
    static_configs:
- targets: ["localhost:9090"]job_name이 시계열의 job 라벨이 된다. localhost:9090은 Prometheus 컨테이너 안에서 자기 HTTP 서버를 가리킨다. 이 파일에는 checkout 수집 대상이 없다.
③ lab/grafana/provisioning/datasources/prometheus.yaml
apiVersion: 1
datasources:
  - name: AIOps Lab Prometheus
    uid: aiops-lab
    type: prometheus
    access: proxy
    url: http://prometheus:9090
    isDefault: true
    jsonData:
      timeInterval: 5s
파일이 모두 저장됐으면 lab/의 부모 디렉터리에서 실행한다. LAB_PROJECT는 기존 프로젝트와 겹치지 않는 실습 전용 이름이며, 모든 명령에 같은 이름과 파일을 지정한다.
LAB_PROJECT=aiops-blog-grafana
LAB_DIR="$(pwd)/lab/grafana"
docker compose -p "$LAB_PROJECT" -f "$LAB_DIR/compose.yaml" config --quiet
docker compose -p "$LAB_PROJECT" -f "$LAB_DIR/compose.yaml" up -d
docker compose -p "$LAB_PROJECT" -f "$LAB_DIR/compose.yaml" ps
컨테이너가 실행됐어도 첫 scrape 전에는 데이터가 없을 수 있다. 준비 상태와 수집 결과를 구별하자. 필요하면 다음 명령으로 Prometheus가 요청을 받을 준비가 되었는지와 현재 질의 결과를 각각 확인할 수 있다.
curl -f http://127.0.0.1:19044/-/ready
curl -fsS --get http://127.0.0.1:19044/api/v1/query \
  --data-urlencode 'query=up{job="prometheus"}'
두 번째 응답은 HTTP 성공 여부뿐 아니라 data.result에 실제 시계열이 있는지 확인한다. API 응답 확인은 아래 UI 입력·실행 절차를 대신하지 않는다.
7.3 수집 성공 확인
- 브라우저에서
http://127.0.0.1:13044를 열고 Explore로 이동한다. - 데이터 소스로 AIOps Lab Prometheus를 선택한다.
- 쿼리 편집기를 Code로 전환하고 아래 식을 입력한다.
- 시간 범위를 Last 5 minutes로 선택한다.
- Run query를 눌러 새 결과가 나오는지 확인한다.
up{job="prometheus"}Grafana는 Prometheus 질의를 Builder와 Code 방식으로 편집할 수 있다. 이 실습은 복사한 질의를 그대로 확인하기 위해 Code를 사용했다. Prometheus 쿼리 편집기
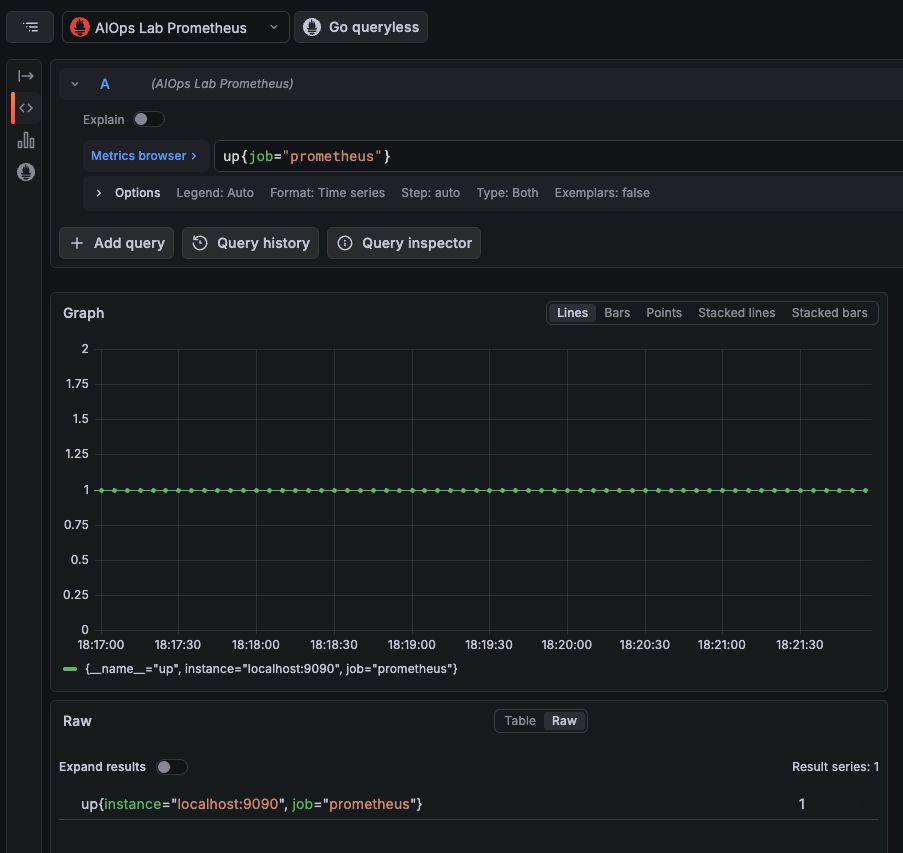
그림 6. 2026-10-04 로컬 실습의 실제 Grafana 조회 화면을 부분 확대했다. Last 5 minutes, step은 Auto, scrape 간격은 5초다. 캡처의 시간 표시는 한국시간이며 가상 장애 inc-42의 고정 분석 구간과 다르다.
실제 화면에서는 job="prometheus"의 시계열이 1로 표시됐다. up은 단위 없는 scrape 성공 지표다. 1은 해당 대상의 scrape 성공, 0은 구성된 대상에 대한 scrape 실패를 뜻한다. 이 값으로 checkout 응답 시간이나 사용자 결제 성공 여부를 판단할 수는 없다.
그래프 시작 부분이 비어 있다면 컨테이너 실행 전 수집 이력이 없는 구간인지 먼저 확인한다. 이번 캡처에서도 Last 5 minutes 범위 전체를 컨테이너가 실행한 것은 아니므로 앞부분의 공백을 장애로 해석하지 않는다.
여기서 Last 5 minutes는 화면의 조회 범위이고 scrape_interval: 5s는 원본 수집 간격이다. Grafana의 Auto step은 화면과 데이터 소스 설정에 따라 질의 평가 간격을 정한다. 이 세 가지는 같은 설정이 아니다. 앞 절의 rate(...[5m]) 계산창과도 구별한다.
7.4 No data 재현
같은 데이터 소스와 Last 5 minutes를 유지한 채 쿼리를 아래처럼 바꾸고 Run query를 다시 누른다. 입력만 바꾸고 남아 있는 이전 그래프를 새 결과로 읽지 않도록 주의한다.
up{job="checkout"}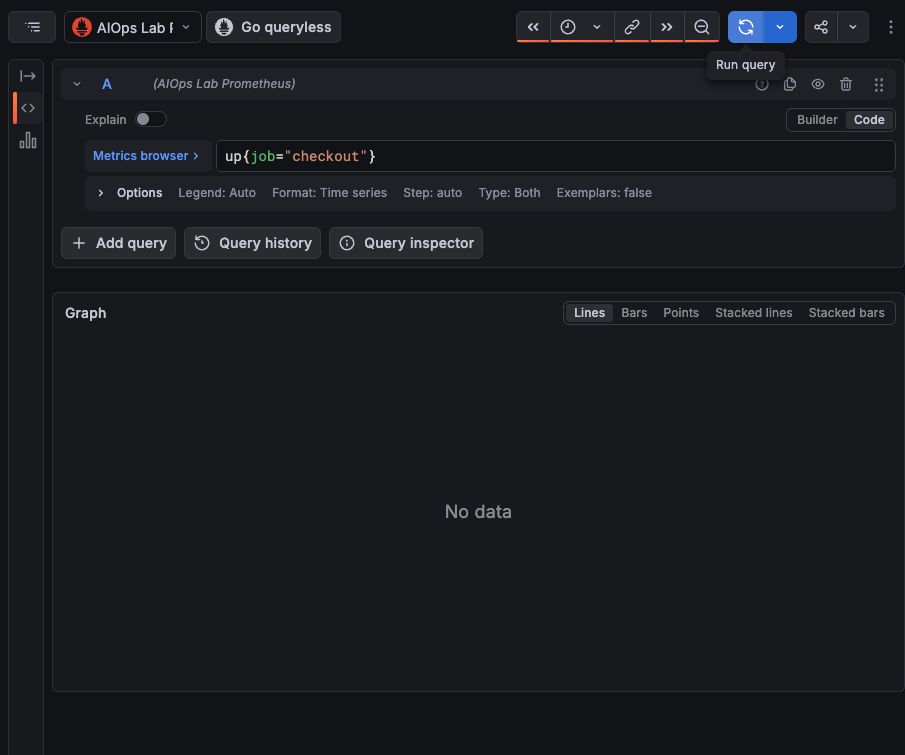
그림 7. 같은 로컬 실습에서 실제로 확인한 No data 결과다. 질의 파싱 오류가 없었지만 조건에 맞는 시계열이 없다. 이 구성에는 checkout 수집 job을 등록하지 않았다.
이 결과는 “checkout이 정상이다”도 “checkout이 중단됐다”도 아니다. 이 실습 저장소에는 그 라벨에 맞는 관측이 없다. 특정 운영 환경에서는 잘못된 라벨, 시간 범위, 수집 누락, 데이터 소스 선택 오류 등도 같은 빈 결과를 만들 수 있다.
| 반환 상황 | 말할 수 있는 내용 | 말하면 안 되는 내용 |
|---|---|---|
up=1 | 그 대상 scrape가 성공했다 | 서비스의 모든 기능이 정상이다 |
up=0 | 구성된 대상 scrape가 실패했다 | 애플리케이션 원인이 확정됐다 |
No data | 조건에 맞는 시계열을 얻지 못했다 | 오류가 없으므로 정상이다 |
에이전트 Adapter도 이 차이를 유지해야 한다. 비어 있는 응답 배열을 숫자 0으로 바꾸지 않고 status="no_data"로 정규화한다. 모델은 “현재 자료로 판단할 수 없음”과 다음 확인 항목을 보고한다. 이 작은 실습이 근거 없는 정상 판정을 막는 도구 계약의 출발점이다.
7.5 종료와 검증 범위
필요한 화면과 결과를 확인했으면 위에서 사용한 동일한 변수로 이번 프로젝트만 정리한다. 아래 명령은 이 실습의 컨테이너·네트워크와 임시 볼륨을 삭제한다. 다른 프로젝트에 적용하지 않는다.
docker compose -p "$LAB_PROJECT" -f "$LAB_DIR/compose.yaml" down --volumes이번 실행으로 확인한 것은 Grafana 데이터 소스 연결, Code 입력·실행, 실제 수집값 1, 미등록 job의 No data다. checkout 애플리케이션 지연, Loki 로그 조회, Tempo 트레이스 조회, Alerting webhook, LLM 연동은 이 실습에서 실행하지 않았다. 이 경계를 유지해야 실제 확인한 부분과 다음 구현 과제를 구별할 수 있다.
이 글의 화면을 캡처한 뒤 aiops-blog-v2 프로젝트의 두 컨테이너와 전용 네트워크를 실제로 정리했다. 재현용 설정과 캡처만 보관했다.
8. 구현 과제
첫째, 고정된 알림 fixture로 webhook 정규화와 중복 방지를 검증한다. 둘째, 읽기 전용 Prometheus 도구 하나를 붙인다. 셋째, Loki와 Tempo를 연결해 같은 서비스·환경·UTC 구간을 조회한다. 마지막으로 보고서에서 원본 링크가 실제 같은 근거를 여는지 확인한다.
No Data, 권한 거부, 백엔드 시간 초과가 발생해도 보고서가 남아야 한다. 알림 규칙과 기존 운영 연락망은 Agent 가용성과 독립적으로 동작하도록 유지한다.
자료 기준: 2026-10-04. 7절의 Grafana 12.4.0·Prometheus 3.5.5 로컬 Docker 실습은 실제 실행과 Chrome 입력·결과 확인을 수행했다. 그 밖의 checkout 메트릭·로그·트레이스·Agent·Alerting 연결은 설계 예시이며 실제 클러스터에서 실행하지 않았다. 공식 문서는 연결한 해당 기능·구문 범위만 참고했으며 모든 버전의 전체 동작을 검증한 것은 아니다.
그림 자산 출처: Grafana 공식 OSS 제품 페이지의 제품별 원본 로고를 색·비율을 유지해 사용했다. 연결선·구획·설명은 자체 제작이며 제품의 공식 아키텍처 도면이 아니다. 상표 사용 정책에 따른 표기: The Grafana Labs Marks are trademarks of Grafana Labs, and are used with Grafana Labs’ permission. We are not affiliated with, endorsed or sponsored by Grafana Labs or its affiliates.
추가 그림 자산 출처
Prometheus® 로고는 프로젝트 공식 저장소의 원본을 사용했다. Prometheus는 The Linux Foundation의 등록 상표이며 상표 사용 정책에 따른 제품 식별이다.

AIOps 에이전트 개발 시리즈
