[AIOps Agent 5] 메모리와 지식 저장소
이 글에서 다룰 주제
- 메모리의 위치: Context·Checkpoint·장기 메모리·Knowledge Base를 어디에 저장할까?
- 구현: SQLite로 권한 검색, 상태 복구, 오래된 상태의 덮어쓰기 방지, 삭제 전파를 실행한다.
- 운영 설계: 문서의 버전·유효기간·권한이 바뀌면 검색과 에이전트의 기억을 어떻게 바꿀까?
주요 단어 · Context · Checkpoint · Knowledge Base · RAG · ACL · Lineage · Tombstone
읽기 안내 · Python 함수와 간단한 SQL을 읽을 수 있는 독자를 위한 구현편이다. 2편의 메모리·권한 개념을 실제 저장 구조와 코드로 연결한다. 외부 LLM 계정이나 클라우드 없이 실행할 수 있다.
구조부터 이해하려면 1~3절과 세 그림을 먼저 읽고, 직접 만들 때 4~8절의 코드와 출력을 따라간다. 코드 다섯 블록은 하나의 파일을 단계별로 나눈 것이므로 순서대로 모으면 실행된다.
tenant-a의 checkout 서비스가 느려졌고, 장애 번호는 inc-42다. 에이전트가 지난달 런북을 검색하고 현재 지표를 읽다가 종료됐다. 다시 시작했을 때 무엇을 복원해야 할까? 지난달 문서에 “재시도를 늘려라”가 적혀 있으면 바로 적용해도 될까?
이 문제를 “벡터 DB에 대화를 저장하면 된다”로 풀면 세 가지가 섞인다. 진행 중인 작업을 복구하는 상태, 과거 운영 지식을 찾는 검색, 현재 장애의 증거다. 이 글에서는 세 역할을 분리한 다음 코드로 이어 붙인다. 예제의 장애와 문서는 모두 학습용 가상 자료다.
1. 메모리 종류
Context는 지금 한 번의 모델 호출에 전달한 자료다. Checkpoint는 중단된 작업을 이어 갈 수 있도록 저장한 실행 상태다. 둘은 같은 데이터 묶음이 아니다.
런북 1,000개가 DB에 있어도 이번 질문과 관련된 두 조각만 모델에게 전달할 수 있다. 반대로 모델에게 전달했던 텍스트를 전부 Checkpoint에 복사할 필요도 없다. 저장은 보관의 문제이고, Context 구성은 이번 판단에 무엇을 보여 줄지 선택하는 문제다.
| 구분 | checkout 사례 | 저장 위치의 예 | 다시 읽는 시점 |
|---|---|---|---|
| Context | 질문, 허용된 런북 조각, 현재 지표 요약 | Runtime 프로세스의 요청 메모리 | 모델을 호출할 때마다 새로 구성 |
| Checkpoint | 다음 단계=query_logs, 근거 ID, 남은 예산 | 관계형 DB의 작업 상태 | 재개·재시작·다음 단계 |
| 장기 메모리 | 검토된 장애 사례, 팀의 보고서 형식 | 관계형 DB, 필요하면 검색 인덱스 | 다른 작업에서 재사용할 때 |
| Knowledge Base | 승인된 런북·운영 매뉴얼·서비스 설명 | 원문 저장소+문서 카탈로그+검색 인덱스 | 운영 지식이 필요한 때 |
| Live Evidence | 01:00~01:10의 p95, 오류 로그, 배포 상태 | Mimir·Loki·Tempo·원천 API | 현재 가설을 확인할 때 |
| Audit | 누가 어떤 계획을 승인·실행했는가 | 접근 통제된 감사 저장소 | 감사·문제 분석·책임 확인 |
장기 메모리는 여러 실행을 넘어 재사용한다는 범위의 이름이다. Knowledge Base(KB)는 출처와 검토 절차가 있는 지식 기반이다. 둘은 일부 겹치지만, 에이전트가 방금 쓴 가설까지 자동으로 승인된 KB가 되는 것은 아니다.
예를 들어 “checkout 담당자가 SRE팀”은 서비스 카탈로그에 둘 사실이고, “지난번에는 연결 풀 대기가 원인이었다”는 검토된 장애 사례다. “이번에도 연결 풀 문제일 것 같다”는 현재 작업의 가설이다. 저장할 수 있다는 이유만으로 이 셋을 같은 신뢰도로 사용하지 않는다.
LangGraph도 thread에 속한 상태를 저장하는 checkpointer와, 여러 thread에 걸친 데이터를 저장하는 store를 구분한다. InMemorySaver나 InMemoryStore는 프로세스 메모리에만 두는 구현이므로 이름에 memory가 있다고 재시작을 견디는 것은 아니다. 공식 Memory 개념, Persistence
2. 메모리 아키텍처
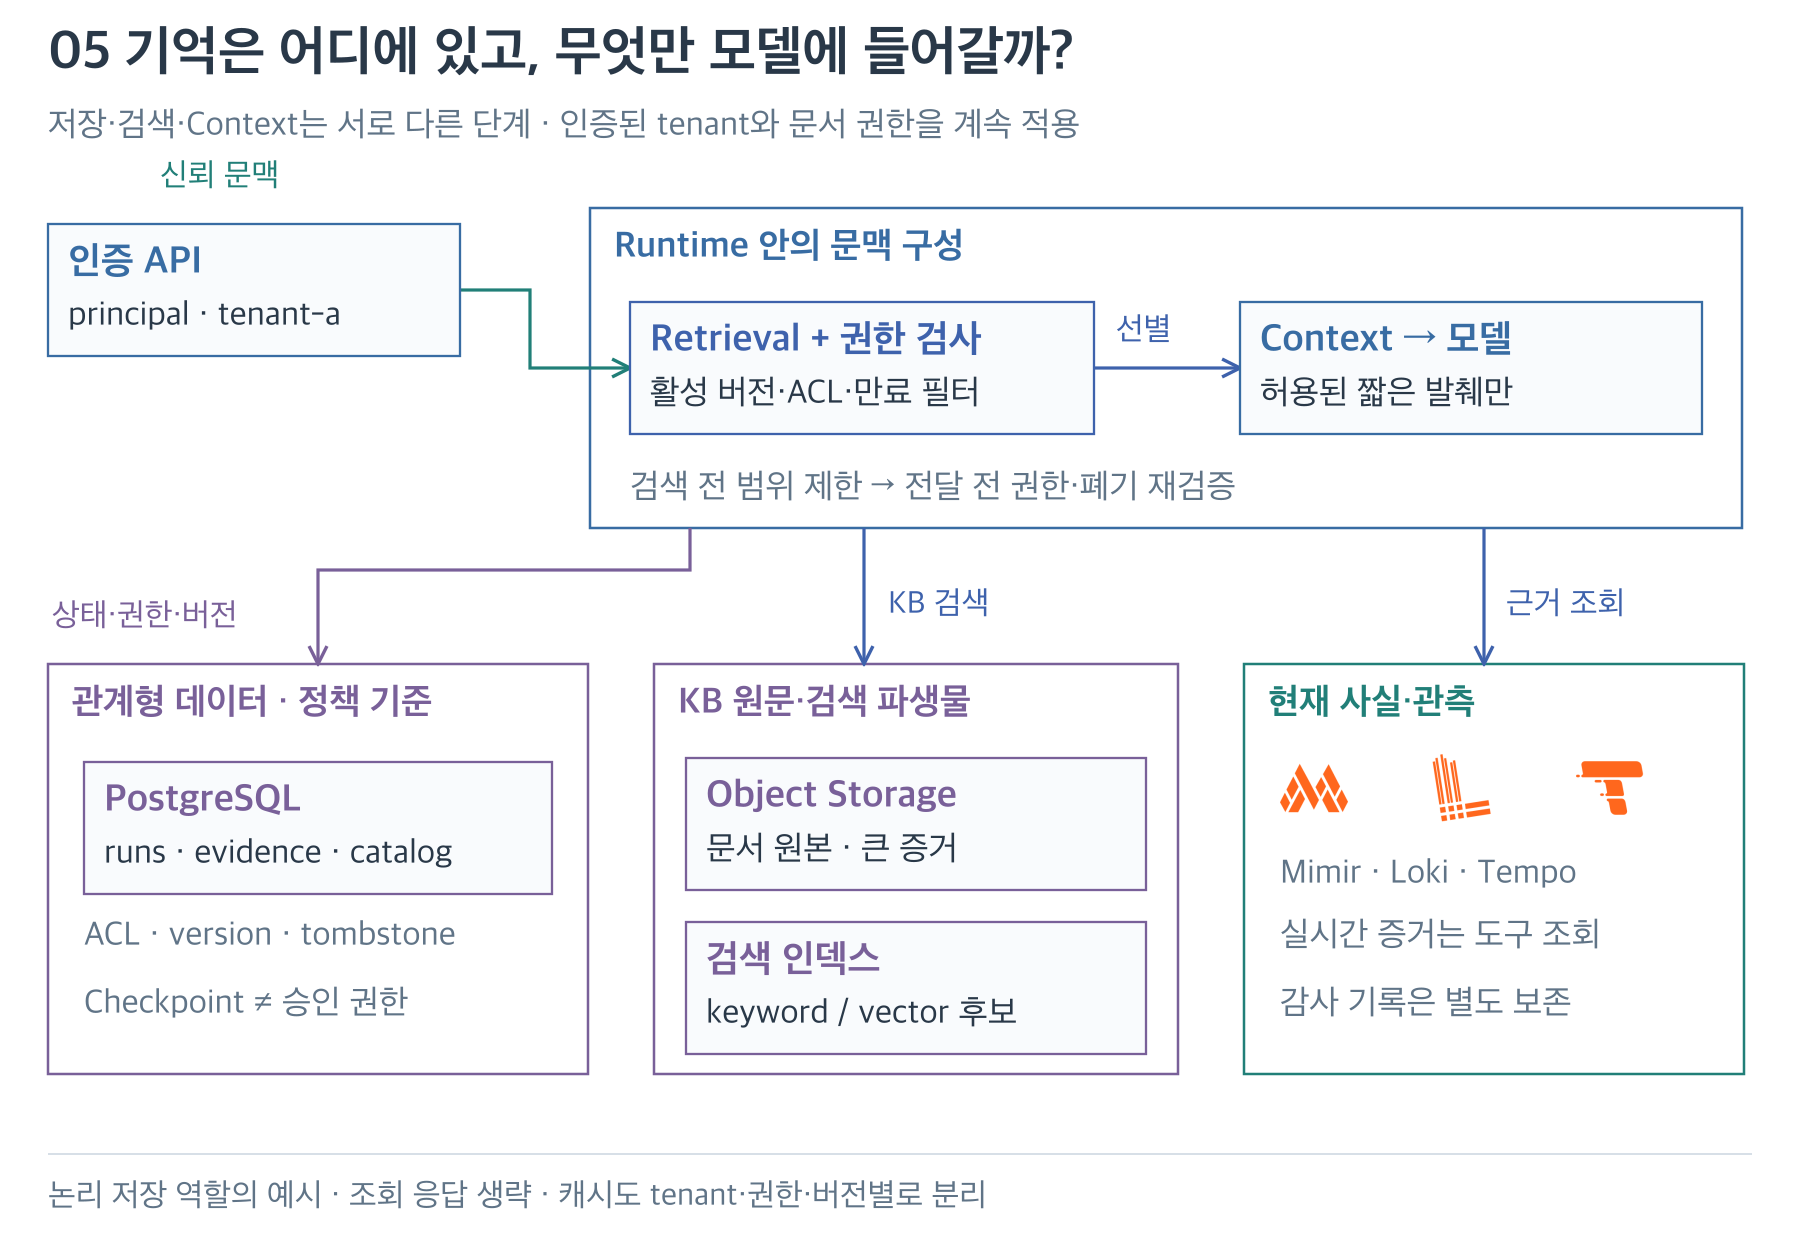
그림 1. 위쪽은 인증된 요청에서 허용된 문맥을 조립하는 경로, 아래쪽은 상태·권한·버전, 원문·검색 파생물, 현재 관측의 저장 역할이다. Runtime에서 저장소로 향하는 주요 조회 요청을 표시했고 응답은 생략했다. 모델에는 선별한 자료만 보낸다.
그림의 저장소는 제품 설치 목록이 아니다. 처음에는 하나의 PostgreSQL에서 상태·카탈로그·작은 검색 인덱스를 운영해도 된다. 먼저 어떤 데이터의 기준 원장이 어디인지 정하고, 규모나 격리 요구가 생겼을 때 물리적으로 나눈다.
관계형 DB에는 runs, checkpoints, documents, document_versions, document_acl, knowledge_items 같은 상태와 관계를 둔다. 버전, 검토 상태, 문서 접근 가능 여부를 이곳에서 판단한다. 모델이 쓴 답변을 그대로 신뢰할 필요 없이 조건으로 검사할 수 있는 정보다.
Object Storage에는 PDF·Markdown 원본, 큰 로그 증적, 파싱 결과 같은 파일을 둔다. DB에는 파일 자체를 반복 복제하기보다 object_key, checksum, 원본 버전을 저장한다. Object Storage의 경로는 권한이 아니므로, 접근 가능한 문서인지 확인한 뒤 서버가 파일을 읽거나 짧은 수명의 접근 경로를 발급해야 한다.
검색 인덱스에는 문서 조각과 검색에 필요한 표현을 둔다. 문서 조각을 Chunk, 의미 검색용 수치 표현을 Embedding이라 부른다. 벡터 인덱스는 다시 만들 수 있는 파생물로 취급한다. 문서의 승인 상태나 권한에 대한 유일한 원장으로 삼지 않는다.
관측 저장소는 별도 역할이다. “연결 풀 대기가 늘면 이 런북을 확인한다”는 KB의 지식이고, “이번 10분 동안 연결 풀 대기가 증가했다”는 현재 조회 결과다. Grafana에서 보는 과거 장애와 비슷해 보여도 최신 배포·지표·로그를 확인해야 한다. Langfuse는 모델·도구 호출을 관측하는 데 연결할 수 있지만, 업무 메모리의 원장이나 승인 원장을 자동으로 대신하지는 않는다.
2.1 관측 시각·조회 시각
observed_at은 운영 현상이 발생하거나 측정된 시간이고, retrieved_at은 에이전트가 가져온 시간이다. 어제의 로그를 방금 조회했다고 최신 상태의 증거가 되지는 않는다.
{
  "evidence_id": "ev-001",
  "tenant_id": "tenant-a",
  "incident_id": "inc-42",
  "service": "checkout",
  "window_start": "2026-10-04T01:00:00Z",
  "window_end": "2026-10-04T01:10:00Z",
  "observed_at": "2026-10-04T01:10:00Z",
  "retrieved_at": "2026-10-04T01:10:02Z",
  "source": "metrics-adapter",
  "status": "ok",
  "result_ref": "evidence/ev-001.json"
}
이것은 증거 계약의 예시다. 실제 원천을 조회한 출력은 아니다. 로그 보존 기간이 끝난 뒤에도 분석을 재검토해야 한다면, 허용된 범위의 선별 증거와 checksum을 따로 보존한다. 쿼리 문자열만 남기면 원문 만료 후 당시 결과를 복원하지 못할 수 있다.
3. Repository 구조
운영 코드베이스에서는 다음처럼 책임을 나눌 수 있다. 각 파일이 독립 서버라는 뜻은 아니다. 이번 실습에서는 이 책임을 이해하기 위해 한 파일에 모은다.
aiops-agent/
├── src/aiops_agent/
│   ├── api/auth.py               # 인증된 사용자·tenant·그룹
│   ├── runtime/context.py        # 이번 호출의 입력 구성
│   ├── policy/access.py          # 자료·도구 접근 조건
│   ├── tools/registry.py         # 호출 가능한 검색 도구 등록
│   ├── adapters/telemetry.py     # 현재 지표·로그·트레이스 조회
│   ├── memory/checkpoints.py     # 작업 상태 저장·복구
│   ├── knowledge/
│   │   ├── ingest.py            # 원문→조각, 출처·버전 보존
│   │   ├── retrieve.py          # 허용 범위 검색·재검증
│   │   ├── publish.py           # 검토된 지식 버전 공개
│   │   └── purge.py             # 폐기 상태→파생물 정리
│   └── skills/incident-triage/   # 조사 절차·참고 자료
├── migrations/                  # 상태·문서·권한 스키마
└── tests/                       # 권한 누출·만료·재개 테스트
작업의 상태와 Checkpoint는 memory/에서, KB 수집·검색·승인 버전은 knowledge/에서 관리한다. 같은 DB를 써도 책임을 코드 경로에서 구분할 수 있다.
SKILL.md에는 “현재 증거와 과거 사례를 구분하라” 같은 업무 절차를 적는다. 하지만 실제 tenant_id 조건이나 접근 거부는 policy/와 knowledge/retrieve.py에서 실행되어야 한다. Markdown 지침을 읽었다는 이유로 DB 권한이 만들어지거나 강제되지는 않는다.
에이전트에게는 search_knowledge(service, question) 같은 좁은 도구를 제공한다. 인증 문맥은 API가 만들고 서버가 검색 함수에 주입한다. 모델이 tenant, 사용자 ID, SQL, Object Storage 경로를 마음대로 고르는 인터페이스로 시작하지 않는다.
4. 저장·수집 구현
이제 아래 5개의 Python 코드 블록을 순서대로 하나의 memory_demo.py 파일에 붙여 넣는다. 중간의 JSON·텍스트·명령 블록은 Python 파일에 넣지 않는다. 외부 패키지는 필요 없다. 실행 명령과 실제 출력은 8절에 있다.
실습은 Python 표준 라이브러리의 SQLite를 사용한다. Python 3.9.6 / SQLite 3.51.0에서 실제 실행했다. 새 환경에서는 지원 중인 Python을 사용해도 되며, sqlite3.sqlite_version으로 실행 환경의 SQLite 버전을 확인할 수 있다. SQL의 ?에 값을 바인딩하는 방식은 사용자 입력을 SQL 문법으로 이어 붙이지 않기 위한 것이다. Python sqlite3 공식 문서
여기서는 문서 하나를 한 Chunk로 저장한다. 문서 파서·임베딩·벡터 DB·LLM·외부 인증 서버는 실행하지 않는다. 대신 승인된 최신 버전만 읽기, tenant·ACL 분리, 만료, 상태 복구, 삭제 전파를 눈으로 확인한다.
코드 1/5 — 데이터 구조와 수집
"""Memory boundaries demo: Python 3.9+, stdlib only; no LLM/cloud calls.

python3 memory_demo.py
Temporary SQLite/original files are removed after the run. Fixtures are synthetic.
"""
import hashlib
import json
import sqlite3
import tempfile
from dataclasses import dataclass
from pathlib import Path

NOW = 1791076200  # 2026-10-04T01:10:00Z; fixed fixture clock


@dataclass(frozen=True)
class Auth:
    tenant: str
    principal: str
    groups: tuple
    services: tuple


SCHEMA = """
CREATE TABLE docs (
 tenant TEXT, doc_id TEXT, version INTEGER, service TEXT, acl_group TEXT,
 status TEXT, valid_from INTEGER, expires_at INTEGER, object_key TEXT,
 PRIMARY KEY (tenant, doc_id, version)
);
CREATE UNIQUE INDEX one_approved_version
 ON docs (tenant, doc_id) WHERE status = 'approved';
CREATE TABLE chunks (
 tenant TEXT, doc_id TEXT, version INTEGER, chunk_no INTEGER, body TEXT,
 PRIMARY KEY (tenant, doc_id, version, chunk_no),
 FOREIGN KEY (tenant, doc_id, version) REFERENCES docs
);
CREATE TABLE derived_memory (
 tenant TEXT, memory_id TEXT, doc_id TEXT, version INTEGER, body TEXT,
 PRIMARY KEY (tenant, memory_id),
 FOREIGN KEY (tenant, doc_id, version) REFERENCES docs
);
CREATE TABLE checkpoints (
 tenant TEXT, principal TEXT, run_id TEXT, revision INTEGER, state_json TEXT,
 PRIMARY KEY (tenant, principal, run_id)
);
"""


def ingest(db, root, tenant, doc_id, version, group, status, expires, body):
    # Called by a trusted ingestion job, not exposed as an arbitrary agent tool.
    identity = json.dumps([tenant, doc_id, version]).encode()
    key = hashlib.sha256(identity).hexdigest() + ".txt"
    path, created = root / key, False
    try:
        # Exclusive creation never overwrites an already registered version.
        with path.open("x", encoding="utf-8") as stream:
            created = True
            stream.write(body)
        with db:
            db.execute("INSERT INTO docs VALUES (?, ?, ?, ?, ?, ?, ?, ?, ?)",
                       (tenant, doc_id, version, "checkout", group, status,
                        NOW - 3600, expires, key))
            db.execute("INSERT INTO chunks VALUES (?, ?, ?, 0, ?)",
                       (tenant, doc_id, version, body))
    except Exception:
        if created:
            path.unlink(missing_ok=True)
        raise
문서 ID만 기본 키로 쓰지 않고 tenant + doc_id + version으로 묶었다. 다른 tenant의 문서 ID가 같아도 충돌하지 않으며, v1과 v2를 구분해 출처를 남길 수 있다.
이 실습은 approved를 현재 검색에 공개한 버전으로 취급하고, 부분 UNIQUE 인덱스로 같은 문서의 approved 버전이 둘 생기지 못하게 한다. 새 활성 버전을 등록하기 전에 이전 버전을 대체 상태로 옮기는 게시 절차가 필요하다. 실제 운영에서는 그 전환을 DB 트랜잭션으로 묶는다. SQLite Unique Partial Indexes
원본 파일은 open("x")로 새 파일일 때만 만든다. 같은 버전의 재수집이 이미 보관한 원본을 덮어쓰지 않도록 하기 위해서다. 파일을 만든 뒤 DB 등록이 실패하면 DB 변경을 롤백하고 이번 시도에서 만든 파일만 제거한다. 프로세스가 강제 종료되는 모든 시점의 원자성을 보장한 것은 아니므로, 운영 수집기는 여전히 고아 파일 정리와 재처리가 필요하다.
ingest()는 신뢰된 수집 작업의 함수다. 여기에서 approved를 지정한 것은 검토 과정을 대신하는 실습 fixture다. 운영에서는 모델이 자기 문서를 approved로 만들게 하지 않고 검토자의 권한과 승인 기록을 확인한다.
4.1 RAG 수집 절차
RAG는 필요한 자료를 검색해 모델에게 근거로 주는 방식이다. 문서를 저장하는 수집 단계와 질문 때 찾는 검색 단계를 구분해야 한다.
실제 수집 작업은 원문 변경 감지→원본·권한·버전 보존→파싱→Chunk 생성→품질 확인→검색 공개 순서다. 런북을 자를 때는 제목만 한 조각, 조건과 예외를 다른 조각으로 잘라 의미를 잃지 않게 한다. 표는 행·열의 의미를 유지하고, 각 Chunk에 문서 버전과 절·페이지 위치를 넣는다.
예를 들어 “재시도를 늘린다”만 검색되면 위험하다. 원문에 붙은 “멱등 요청이며 DB 포화가 아닐 때”라는 적용 조건까지 같은 문맥에서 읽혀야 한다. 작은 조각 수나 특정 토큰 수가 언제나 최적이라는 규칙은 없다. 실제 질문과 정답 근거가 있는 평가셋에서 검색 누락과 불필요한 문맥을 함께 본다.
신규 v2의 Chunk를 전부 만든 뒤 품질 확인을 마치고 활성 버전을 전환한다. 반쯤 수집한 v2와 일부 v1을 섞어 같은 버전처럼 노출하지 않는다. Object Storage 쓰기와 DB 갱신은 단일 트랜잭션이 아니므로, 운영 수집기는 준비 상태·재시도·고아 파일 정리도 갖춰야 한다.
5. 권한 기반 검색
ACL(Access Control List)은 누가 어떤 자료를 읽거나 바꿀 수 있는지 정한 목록이다. 검색 관련도가 높다는 이유로 ACL을 넘어설 수는 없다.
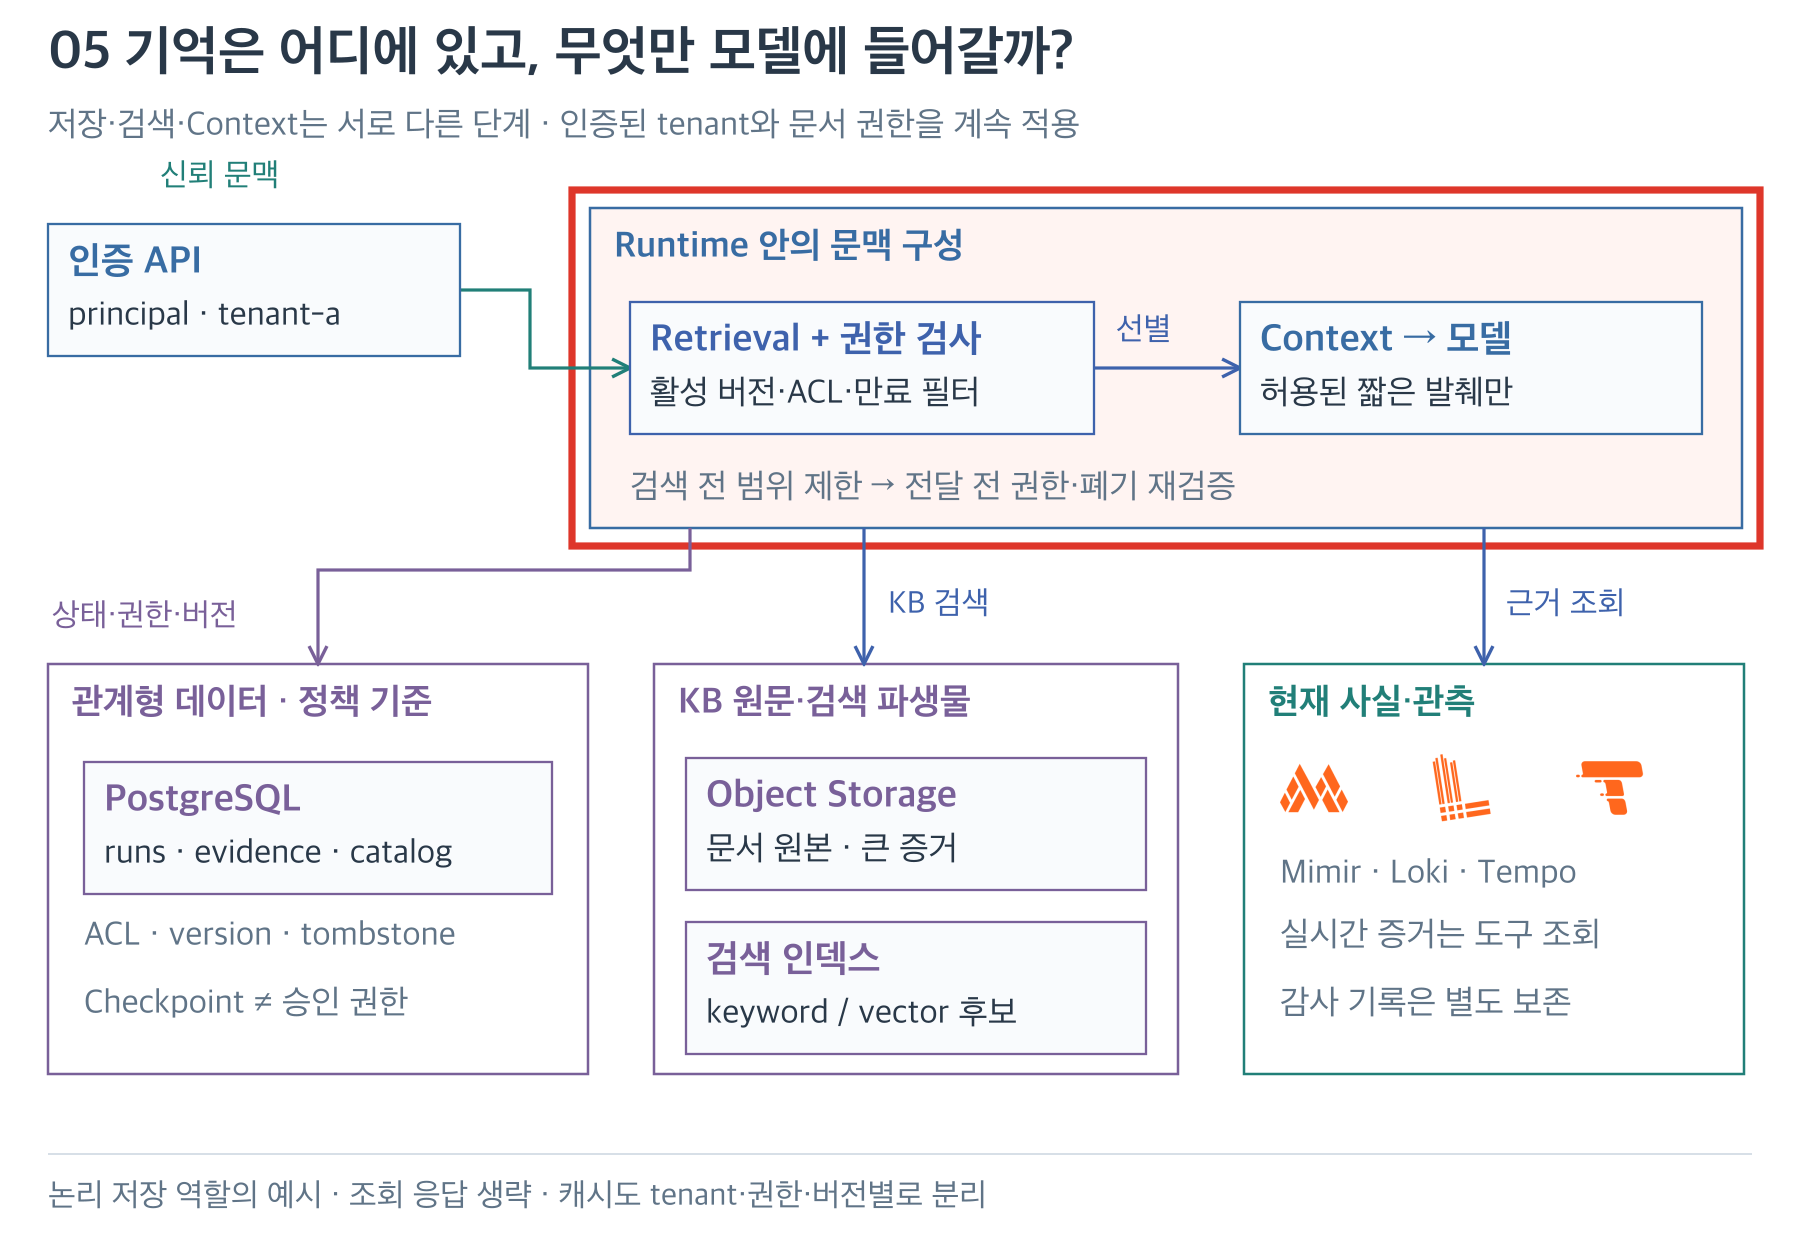
그림 2. 그림 1과 같은 배치에서 Runtime의 문맥 구성 영역을 빨간 테두리로 강조했다. tenant·서비스·ACL·활성 버전·만료 조건을 적용하고, 모델에 전달하기 직전 현재 권한과 폐기 상태를 재검사한다.
코드 2/5 — 검색과 Context 조립
def allowed_chunks(db, auth, service, now):
    if service not in auth.services or not auth.groups:
        return []
    placeholders = ",".join("?" for _ in auth.groups)
    # SQL syntax is fixed; only the number of bound placeholders is generated.
    query = """
      SELECT c.doc_id, c.version, c.chunk_no, c.body
      FROM chunks c JOIN docs d
        ON (c.tenant, c.doc_id, c.version) = (d.tenant, d.doc_id, d.version)
      WHERE d.tenant = ? AND d.service = ?
        AND d.acl_group IN (""" + placeholders + """)
        AND d.status = 'approved' AND d.valid_from <= ? AND d.expires_at > ?
    """
    return list(db.execute(query, (auth.tenant, service, *auth.groups, now, now)))


def search(db, auth, service, query, now):
    # Deliberately simple lexical ranking, not embeddings or full RAG quality.
    words = set(query.lower().split())
    scored = [(sum(word in row["body"].lower() for word in words), row)
              for row in allowed_chunks(db, auth, service, now)]
    scored.sort(key=lambda item: (-item[0], item[1]["doc_id"]))
    return [dict(row) for score, row in scored[:3] if score > 0]


def build_context(db, auth, service, hits, now):
    # Re-read the current ACL/status before allowing candidate text into context.
    current = {(r["doc_id"], r["version"], r["chunk_no"]): r
               for r in allowed_chunks(db, auth, service, now)}
    result = []
    for hit in hits:
        key = (hit["doc_id"], hit["version"], hit["chunk_no"])
        if key in current:
            row = current[key]
            result.append({"source": "%s@v%s#%s" % key,
                           "trust": "retrieved_data", "text": row["body"]})
return resultallowed_chunks()는 점수를 계산하기 전에 읽을 수 있는 행만 반환한다. tenant는 모델 출력이 아니라 서버가 만든 Auth에서 가져온다. 서비스 권한이 없거나 허용 그룹이 없으면 빈 결과다. SQL에 직접 붙이는 것은 물음표의 개수뿐이며, 그룹 값은 모두 바인딩한다.
search()는 단어 포함 개수로만 순위를 매긴다. 이것은 검색 품질을 보여 주는 알고리즘이 아니라 권한 경계가 어디에 들어가는지 보여 주는 작은 구현이다. 실제 운영에서는 에러 코드·설정명은 키워드 검색으로, 표현이 다양한 장애 설명은 의미 검색으로 찾은 뒤 결과를 결합하는 방식을 평가할 수 있다.
마지막 build_context()는 검색 후 문서가 폐기되거나 ACL이 바뀌는 경우를 다룬다. 후보에 담겼던 텍스트를 무조건 사용하지 않고 현재 허용된 버전과 대조한다. DB와 모델 호출 사이의 모든 경쟁 상황을 이 예제만으로 원자적으로 해결했다는 뜻은 아니다. 회수 정책이 엄격하다면 응답 직전까지 재확인하고, 진행 중 작업을 취소하거나 Context를 재생성하는 정책이 필요하다.
trust="retrieved_data"는 검색 결과가 참고 데이터라는 표시다. 이 필드만 붙이면 Prompt Injection을 막는 것은 아니다. 문서 속 “권한을 무시하라”는 문장도 데이터로 취급하고, 도구 실행 권한은 독립된 서버 정책으로 제한해야 한다.
5.1 벡터 검색과 ACL
벡터 DB를 붙여도 접근 권한은 별도로 검증해야 한다. 요청 시 인가 조건을 검색 서비스에 함께 전달하고, 모델·재순위화 모델·응답에 허용되지 않은 텍스트가 전달되지 않게 해야 한다. 검색 후 화면에서만 가리는 방식은 이미 늦다.
다만 보안상의 사전 범위 제한과 검색 엔진 내부의 물리적 실행 순서는 구분한다. pgvector의 근사 인덱스에서는 인덱스 스캔 뒤 필터가 적용되어 결과 수가 부족할 수 있다. WHERE tenant_id = ...를 넣었다는 이유로 모든 ANN 구현이 먼저 해당 tenant만 탐색한다고 설명하면 부정확하다. 필터 선택도와 검색 품질을 측정하고, 필요하면 정확 검색·반복 스캔·tenant별 파티션을 검토한다. pgvector 공식 Filtering 설명
6. Checkpoint 구현
이번 장애의 Checkpoint에는 로그 원문 대신 evidence_ids, 런북 원문 대신 버전이 붙은 knowledge_refs를 둔다. 다음 단계가 query_logs이면 재개한 Runtime은 해당 단계부터 수행할 수 있다. 단, 현재 권한과 근거의 유효성은 다시 확인한다.
코드 3/5 — 상태 저장과 복구
def save_checkpoint(db, auth, run_id, expected_revision, state):
    payload = json.dumps(state, ensure_ascii=False, sort_keys=True)
    with db:
        if expected_revision == 0:
            db.execute("INSERT INTO checkpoints VALUES (?, ?, ?, 1, ?)",
                       (auth.tenant, auth.principal, run_id, payload))
        else:
            changed = db.execute("""UPDATE checkpoints
              SET revision = revision + 1, state_json = ?
              WHERE tenant = ? AND principal = ? AND run_id = ? AND revision = ?
              """, (payload, auth.tenant, auth.principal, run_id, expected_revision))
            if changed.rowcount != 1:
                raise RuntimeError("checkpoint_conflict")


def load_checkpoint(db, auth, run_id):
    row = db.execute("""SELECT revision, state_json FROM checkpoints
      WHERE tenant = ? AND principal = ? AND run_id = ?""",
                     (auth.tenant, auth.principal, run_id)).fetchone()
return None if row is None else (row["revision"], json.loads(row["state_json"]))expected_revision은 “내가 읽은 상태가 아직 최신인가?”를 검사한다. 두 워커가 모두 revision 1을 읽었다면 첫 번째만 revision 2로 바꿀 수 있다. 두 번째는 갱신한 행이 0개이므로 checkpoint_conflict를 받는다. 충돌을 무시하고 다시 덮어쓰지 않고 최신 상태를 읽어 재판단해야 한다.
이 함수는 업무 소유자를 tenant + principal + run_id로 구분한다. 같은 tenant 안에서 공동 대응자가 상태를 읽어야 한다면 단순히 principal 조건을 삭제하지 말고, incident 참여자나 역할을 검사하는 별도 작업 ACL을 설계한다.
또한 Checkpoint에 자격증명이나 승인된 것처럼 보이는 문자열만 넣고 신뢰하지 않는다. 권한 회수 후 재개한 워커는 저장된 토큰 대신 현재 인증 문맥을 사용해야 한다. 외부 변경 API 호출과 Checkpoint 쓰기는 하나의 원자적 작업이 아니므로, 재시작 시 중복 실행 문제는 별도 실행 원장과 idempotency key로 해결한다. 이 실습의 상태 저장이 정확히 한 번의 외부 실행까지 보장하지는 않는다.
7. 문서 수명 관리
Tombstone은 데이터가 폐기됐다는 표식이다. Lineage는 원문이 어떤 Chunk·요약·결과의 근거가 되었는지 잇는 관계다.
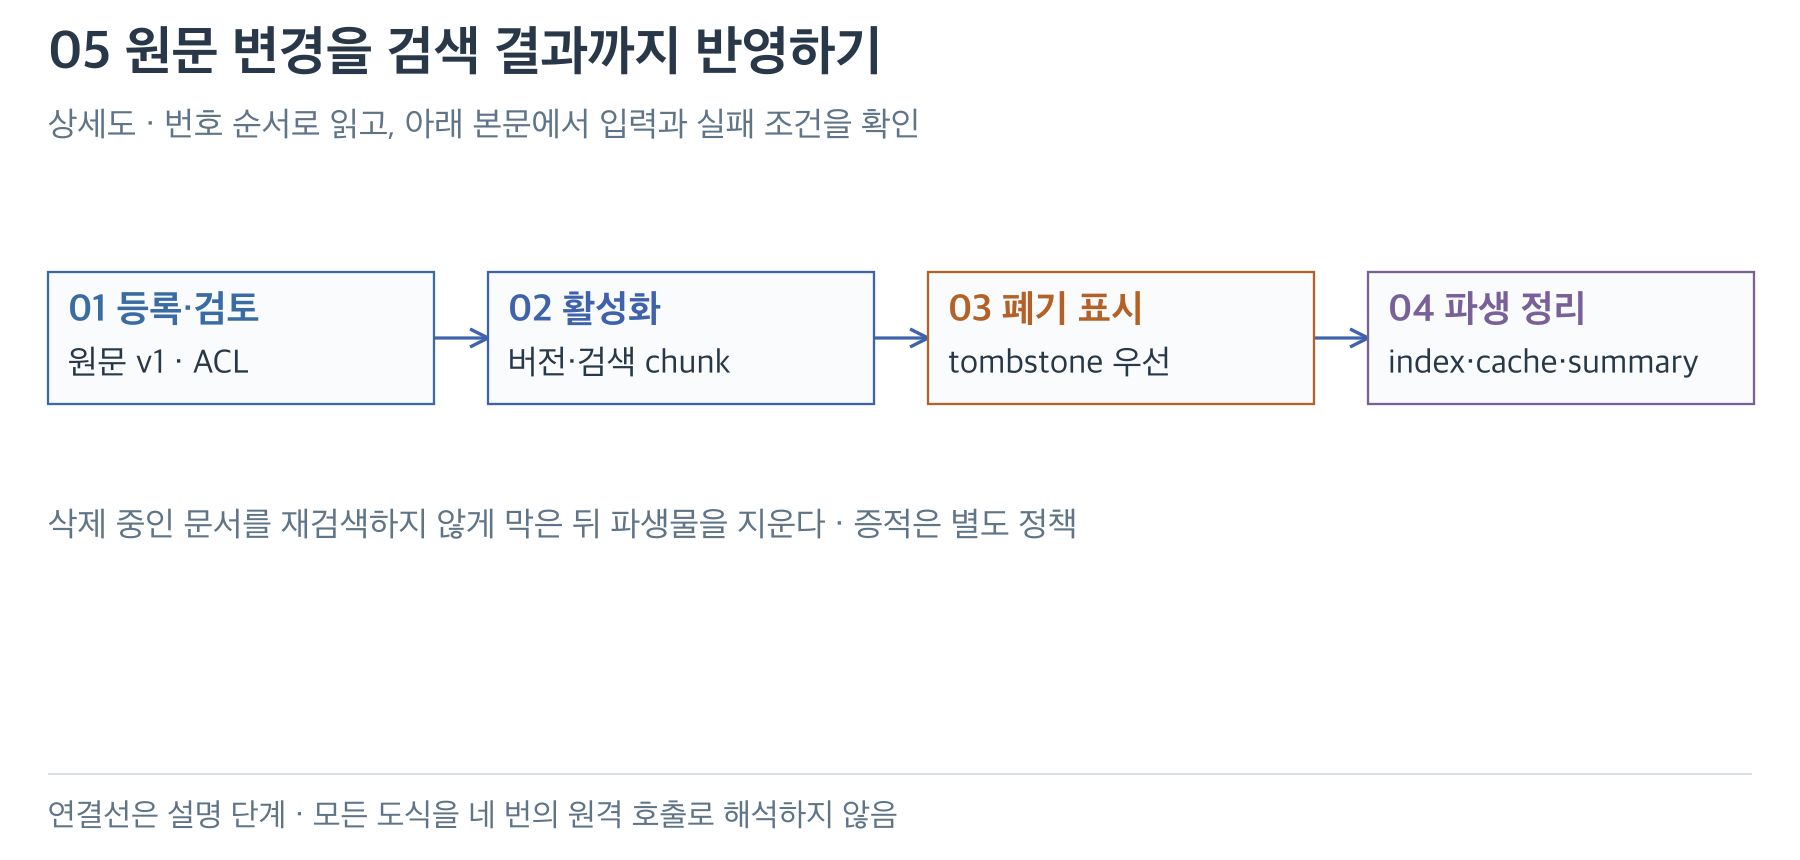
그림 3. 등록·검토한 원문을 활성화하고 버전과 검색 Chunk를 연결한다. 폐기할 때는 tombstone으로 검색을 먼저 차단한 뒤 인덱스·캐시·요약 등 파생물을 정리한다. 사용 중지와 모든 저장 매체의 물리 삭제 완료는 서로 다른 상태다.
코드 4/5 — 폐기와 정리
def revoke(db, tenant, doc_id):
    # Commit the denial before asynchronously removing dependent material.
    with db:
        db.execute("UPDATE docs SET status = 'deleted' WHERE tenant = ? AND doc_id = ?",
                   (tenant, doc_id))


def purge(db, root, tenant, doc_id):
    keys = list(db.execute("SELECT object_key FROM docs WHERE tenant = ? AND doc_id = ?",
                           (tenant, doc_id)))
    with db:
        db.execute("DELETE FROM chunks WHERE tenant = ? AND doc_id = ?", (tenant, doc_id))
        db.execute("DELETE FROM derived_memory WHERE tenant = ? AND doc_id = ?",
                   (tenant, doc_id))
    for row in keys:
        (root / row["object_key"]).unlink(missing_ok=True)
# Catalog tombstones remain; this demo does not model backups/cache/index workers.revoke()를 먼저 커밋하면 Chunk가 남아 있어도 조회 대상에서 빠진다. purge()가 늦게 실행되더라도 다음 검색에서 같은 문서를 다시 쓰지 않기 위한 순서다. 현재 Context에 이미 전달한 정보를 소급해서 지울 수는 없으므로, 진행 중 요청도 폐기 정책의 대상에 포함한다.
실습의 파생 메모리는 원문 하나를 참조한다. 실제 Wiki가 여러 문서를 종합했다면 derived_sources(derived_id, source_id, version) 같은 다대다 관계가 필요하다. 한 원문이 폐기되면 파생물을 다시 만들거나 사용을 중지한다. 요약문에서 해당 문장만 문자열로 지우는 것으로 근거가 완전히 제거됐다고 가정하지 않는다.
실제 삭제 작업은 검색 인덱스·응답 캐시·생성된 보고서까지 전파될 수 있다. 작업 큐에 삭제 이벤트와 고유 ID를 넣고 재시도해도 같은 결과가 되게 만든다. 저장소별 성공 여부를 기록하고 실패한 파생물을 계속 차단한다. 백업·증적 보존은 별도 정책에 따르며, 감사 기록에는 원문 전체보다 삭제 요청·처리 결과·식별자를 최소한으로 남길 수 있다.
7.1 TTL·버전·권한
| 필드·정책 | 답하는 질문 | 이 예제의 동작 |
|---|---|---|
expires_at | 지금 사용해도 되는가? | 시각이 지나면 검색 제외 |
version·status | 어떤 검토본이 유효한가? | v1은 superseded, v2만 approved |
acl_group | 누가 읽을 수 있는가? | ops 사용자는 security 문서 제외 |
deleted 표식 | 더 이상 제공하면 안 되는가? | 파생물 정리 전부터 검색 차단 |
| 보존 정책 | 언제 물리적으로 지울 것인가? | 실습에서는 purge로 즉시 정리 |
이 글의 600초는 만료를 짧게 시험하기 위한 값이다. 런북 수명 권장값이 아니다. 런북은 변경 승인과 주기적 재검토, 지표 캐시는 초·분 단위 신선도, 감사 기록은 보존 정책처럼 목적에 맞게 정한다.
8. 실습 실행·검증
코드 5/5 — 가상 자료와 검증
def run_demo(root):
    db_path = root / "memory.sqlite3"
    db = sqlite3.connect(db_path)
    db.row_factory = sqlite3.Row
    db.executescript(SCHEMA)
    # Enable FK checks on every connection, not just this initial connection.
    db.execute("PRAGMA foreign_keys = ON")
    fixtures = [
        ("tenant-a", "checkout-runbook", 1, "ops", "superseded", NOW + 600,
         "checkout timeout: old runbook; retry configuration changed later."),
        ("tenant-a", "checkout-runbook", 2, "ops", "approved", NOW + 600,
         "checkout timeout: inspect DB pool wait and retry count before action."),
        ("tenant-a", "restricted", 1, "security", "approved", NOW + 600,
         "checkout timeout: restricted internal detail."),
        ("tenant-b", "other-tenant", 1, "ops", "approved", NOW + 600,
         "checkout timeout: another tenant's runbook."),
        ("tenant-a", "expired", 1, "ops", "approved", NOW - 1,
         "checkout timeout: expired runbook."),
        ("tenant-a", "draft", 1, "ops", "draft", NOW + 600,
         "checkout timeout: unreviewed hypothesis."),
    ]
    for fixture in fixtures:
        ingest(db, root, *fixture)
    before = set(root.glob("*.txt"))
    old_key = db.execute("""SELECT object_key FROM docs
      WHERE tenant = ? AND doc_id = ? AND version = ?""",
                         ("tenant-a", "checkout-runbook", 2)).fetchone()[0]
    old_body = (root / old_key).read_text(encoding="utf-8")
    try:
        ingest(db, root, "tenant-a", "checkout-runbook", 2, "ops", "approved",
               NOW + 600, "unexpected replacement")
    except FileExistsError:
        assert (root / old_key).read_text(encoding="utf-8") == old_body
        assert db.execute("SELECT body FROM chunks WHERE tenant = ? AND doc_id = ? AND version = ?",
                          ("tenant-a", "checkout-runbook", 2)).fetchone()[0] == old_body
        print("duplicate_version: rejected; original and chunk unchanged")
    else:
        raise AssertionError("duplicate version overwritten")
    try:
        ingest(db, root, "tenant-a", "checkout-runbook", 3, "ops", "approved",
               NOW + 600, "second approved version")
    except sqlite3.IntegrityError:
        assert set(root.glob("*.txt")) == before
        assert db.execute("SELECT count(*) FROM docs WHERE tenant = ? AND doc_id = ? AND version = ?",
                          ("tenant-a", "checkout-runbook", 3)).fetchone()[0] == 0
        assert db.execute("SELECT count(*) FROM chunks WHERE tenant = ? AND doc_id = ? AND version = ?",
                          ("tenant-a", "checkout-runbook", 3)).fetchone()[0] == 0
        print("second_approved_version: rejected; new file and DB rows rolled back")
    else:
        raise AssertionError("two approved versions accepted")
    auth = Auth("tenant-a", "alice", ("ops",), ("checkout",))
    hits = search(db, auth, "checkout", "checkout timeout", NOW)
    print("allowed_hits:", ["%s@v%s" % (x["doc_id"], x["version"]) for x in hits])
    assert len(hits) == 1 and hits[0]["version"] == 2
    assert search(db, auth, "billing", "checkout", NOW) == []
    assert search(db, auth, "checkout", "checkout", NOW + 601) == []
    print("tenant_acl_expiry_version_checks: PASS")
    context = build_context(db, auth, "checkout", hits, NOW)
    print("context_source:", context[0]["source"], "trust=" + context[0]["trust"])
    state = {"incident_id": "inc-42", "service": "checkout", "next_step": "query_logs",
             "evidence_ids": ["ev-001"], "knowledge_refs": [context[0]["source"]]}
    save_checkpoint(db, auth, "run-101", 0, state)
    db.close()
    # Reopen the file to demonstrate persistent state, not a process RAM dictionary.
    db = sqlite3.connect(db_path)
    db.row_factory = sqlite3.Row
    db.execute("PRAGMA foreign_keys = ON")
    revision, restored = load_checkpoint(db, auth, "run-101")
    assert restored == state
    print("restored:", restored["incident_id"], restored["next_step"], "revision=" + str(revision))
    assert load_checkpoint(db, Auth("tenant-b", "alice", ("ops",), ("checkout",)), "run-101") is None
    save_checkpoint(db, auth, "run-101", 1, dict(restored, next_step="report"))
    try:
        save_checkpoint(db, auth, "run-101", 1, restored)
    except RuntimeError as exc:
        print("stale_checkpoint_write:", str(exc))
    else:
        raise AssertionError("stale write was accepted")
    with db:
        db.execute("INSERT INTO derived_memory VALUES (?, ?, ?, ?, ?)",
                   ("tenant-a", "summary-1", "checkout-runbook", 2, "Reviewed fixture summary"))
    revoke(db, "tenant-a", "checkout-runbook")
    assert search(db, auth, "checkout", "checkout timeout", NOW) == []
    assert build_context(db, auth, "checkout", hits, NOW) == []
    print("revoked_before_purge: hidden; cached_candidates_rechecked")
    purge(db, root, "tenant-a", "checkout-runbook")
    for table in ("chunks", "derived_memory"):
        count = db.execute("SELECT count(*) FROM " + table +
                           " WHERE tenant = ? AND doc_id = ?", ("tenant-a", "checkout-runbook")).fetchone()[0]
        assert count == 0
    original_keys = db.execute("SELECT object_key FROM docs WHERE tenant = ? AND doc_id = ?",
                               ("tenant-a", "checkout-runbook")).fetchall()
    assert all(not (root / r["object_key"]).exists() for r in original_keys)
    print("purged: chunks=0 derived_memory=0 originals=0; tombstone retained")
    db.close()


if __name__ == "__main__":
    print("runtime: Python stdlib sqlite3; fixture clock=2026-10-04T01:10:00Z")
    with tempfile.TemporaryDirectory(prefix="aiops-memory-") as directory:
        run_demo(Path(directory))
    print("cleanup: temporary database and fixture files removed")
다섯 코드 블록을 저장한 뒤 실행한다.
python3 memory_demo.py아래는 위 파일을 실제 실행한 출력이다. 시계는 재현을 위해 2026-10-04T01:10:00Z에 고정했다. 외부 서비스의 현재 상태를 조회한 결과는 아니다.
runtime: Python stdlib sqlite3; fixture clock=2026-10-04T01:10:00Z
duplicate_version: rejected; original and chunk unchanged
second_approved_version: rejected; new file and DB rows rolled back
allowed_hits: ['checkout-runbook@v2']
tenant_acl_expiry_version_checks: PASS
context_source: checkout-runbook@v2#0 trust=retrieved_data
restored: inc-42 query_logs revision=1
stale_checkpoint_write: checkpoint_conflict
revoked_before_purge: hidden; cached_candidates_rechecked
purged: chunks=0 derived_memory=0 originals=0; tombstone retained
cleanup: temporary database and fixture files removedduplicate_version은 동일 버전의 재등록이 거부되고 기존 원문·Chunk가 그대로 남았다는 뜻이다. second_approved_version은 이미 v2가 공개된 상태에서 v3까지 동시에 approved로 등록하려는 시도가 거부됐고, 새 파일과 DB 행도 남지 않았다는 결과다.
allowed_hits에는 v2 하나만 남는다. 다른 tenant, security 그룹, 만료된 문서, 미검토 초안, 대체된 v1은 같은 검색어를 포함해도 제외된다. 그다음 DB 연결을 닫고 다시 열어 inc-42의 다음 단계가 query_logs로 복원되는지 검사한다. 프로세스를 강제 종료한 복구 시험은 아니며, 파일 기반 저장이 RAM 객체와 다르게 유지되는 범위를 확인한 것이다.
checkpoint_conflict는 일부러 만든 오래된 상태 쓰기가 거부된 결과다. revoked_before_purge는 파일 정리 전부터 검색이 막혔고, 이전에 검색한 후보도 Context를 만들 때 다시 제외됐다는 뜻이다. 마지막에는 원문 파일·Chunk·파생 요약이 제거됐는지 확인한다. 임시 DB와 fixture 파일도 실행 종료 때 자동 정리한다.
이 테스트는 인증 서버, 실제 벡터 인덱스, 분산 삭제 큐, 백업 삭제, LLM의 답변 품질을 검증하지 않는다. 다음 단계에서는 그 경계를 하나씩 실제 어댑터로 바꾸고 같은 실패 조건을 다시 검사한다.
9. 운영 확장·품질 평가
SQLite 예제를 PostgreSQL로 바꿀 때는 연결 문자열만 바꾸는 일이 아니다. 인증 계층에서 사용자와 tenant를 확정하고, Repository 함수와 DB role을 제한하며, 필요하면 Row-Level Security(RLS)로 행별 정책을 겹쳐 적용한다. RLS를 켰어도 superuser·BYPASSRLS role은 우회하고 테이블 소유자도 기본적으로 예외이므로, 애플리케이션 실행 계정을 분리해야 한다. PostgreSQL 18 Row Security Policies
새 문서가 들어온다고 무조건 에이전트의 정확도가 좋아지지는 않는다. 질문별로 필요한 출처가 검색됐는지, 버전과 ACL이 맞는지, 실제 답변이 출처를 충실하게 사용했는지를 나눠 평가한다. 답변이 틀렸다면 수집 누락, 검색 누락, Context 구성, 모델 해석 중 어디에서 실패했는지 추적할 수 있어야 한다.
예를 들어 checkout 런북 검색은 성공했지만 “증가한 retry가 원인”이라는 현재 증거가 없는데도 단정했다면, KB 검색 정확도만 높여서는 해결되지 않는다. 답변에서 확인한 사실·과거 사례·현재 가설·미확인 항목을 분리하도록 완료 검증을 바꿔야 한다.
팀이 쓰기 좋은 장기 메모리는 “대화를 많이 저장한 메모리”보다 다음 조사에서 재사용할 만큼 검토됐고, 틀렸을 때 고칠 수 있는 메모리다. 초기에는 문서 한 종류와 서비스 하나부터 시작하고, 문서 버전 변경·권한 회수·재개·폐기를 매 릴리스에서 반복 시험하면 저장 계층의 역할을 분명하게 유지할 수 있다.
자료와 검증 범위 · 2026-10-04 기준으로 본문에 인용한 LangGraph 메모리 구분, PostgreSQL RLS 예외, pgvector 필터 동작, Python sqlite3 사용법을 공식 자료에서 확인했다. SQLite 실습만 실행했으며 나머지 저장소·연동 아키텍처는 운영 확장을 위한 제안이다. 사용자 제공 AIOps 학습자료의 데이터·메모리·Lineage 구분을 참고해 예제와 그림을 새로 구성했다.
추가 그림 자산 출처
PostgreSQL 로고는 공식 자산의 색과 비율을 유지해 사용했다. PostgreSQL과 Slonik은 PostgreSQL Community Association of Canada의 상표 또는 등록 상표이며, 상표 정책에 따른 제품 식별이다. 공식 후원·제휴를 뜻하지 않는다.
Grafana 계열 로고는 공식 제품 자산의 색과 비율을 유지했다. The Grafana Labs Marks are trademarks of Grafana Labs, and are used with Grafana Labs’ permission. 공식 후원·제휴를 뜻하지 않는다. 사용 정책
AIOps 에이전트 개발 시리즈
