[AIOps Agent 6] 에이전트 유형과 Deep Agents
이 글에서 다룰 주제
- 실행 구조 선택: 고정 Workflow, 도구 호출 루프, 계획·실행, Router, Supervisor는 무엇이 다른가?
- Deep Agents: 긴 작업에 필요한 기능은 무엇이며 어떤 경우에 도입할 가치가 있는가?
- 구현 경계: Subagent·Skill·MCP·하네스를 Repository에서 어떻게 나누는가?
- 실패와 비용: 에이전트를 여러 개 만들면 무엇이 좋아지고 무엇을 더 관리해야 하는가?
주요 단어 · Workflow · Tool calling · ReAct · Plan-and-execute · Router · Supervisor · Subagent · Deep Agents · Harness
Python 함수와 API 호출을 알고, 앞선 글에서 도구·메모리·권한의 역할을 살펴본 독자를 위한 글이다. 읽고 나면 자신의 첫 AIOps 업무를 어떤 실행 구조로 만들지 선택하고, 구조를 바꾸어도 공통으로 유지해야 할 인터페이스를 설명할 수 있다.
“RCA Agent를 만들려면 멀티에이전트부터 해야 하나요? Deep Agent가 더 고급이니까 처음부터 그걸 쓰면 되나요?”
이 질문에서 먼저 정할 것은 모델이나 프레임워크가 아니다. 작업 중 다음 행동을 누가 정하는지, 작업을 얼마나 오래 이어 가야 하는지, 실패했을 때 무엇을 남겨야 하는지다. 에이전트 종류는 시험의 초급·중급·고급 등급처럼 일렬로 놓이지 않는다. 단순한 구조가 더 정확하고 운영하기 쉬운 업무도 많다.
이 글에서는 tenant-a에 속한 운영팀 team-a의 staging 환경에 있는 가상의 checkout 서비스 장애 inc-42를 끝까지 사용한다. 기본 조사 구간은 2026-10-04 01:00~01:10 UTC(한국시간 10:00~10:10)다. 알림이 발생했고, 운영자는 “지연 증가 원인을 조사해 근거와 함께 보고하라”고 요청했다. 운영 변경은 이번 조사 업무에 포함하지 않는다. 아래 장애 내용과 수치는 설계 설명을 위한 가정이며 실제 서비스에서 수집한 결과가 아니다.
1. 업무와 실행 구조
에이전트 실행 구조 — 모델 호출, 도구 실행, 분기, 위임, 검증을 어떤 순서와 책임으로 연결하는지 정한 방식이다.
RCA Agent, Cost Agent, Report Agent는 업무 이름이다. 반면 Workflow, 도구 호출 루프, Supervisor는 실행 구조다. RCA라는 같은 업무를 고정 절차로 구현할 수도 있고, 하나의 모델이 조회를 선택하도록 구현할 수도 있다.
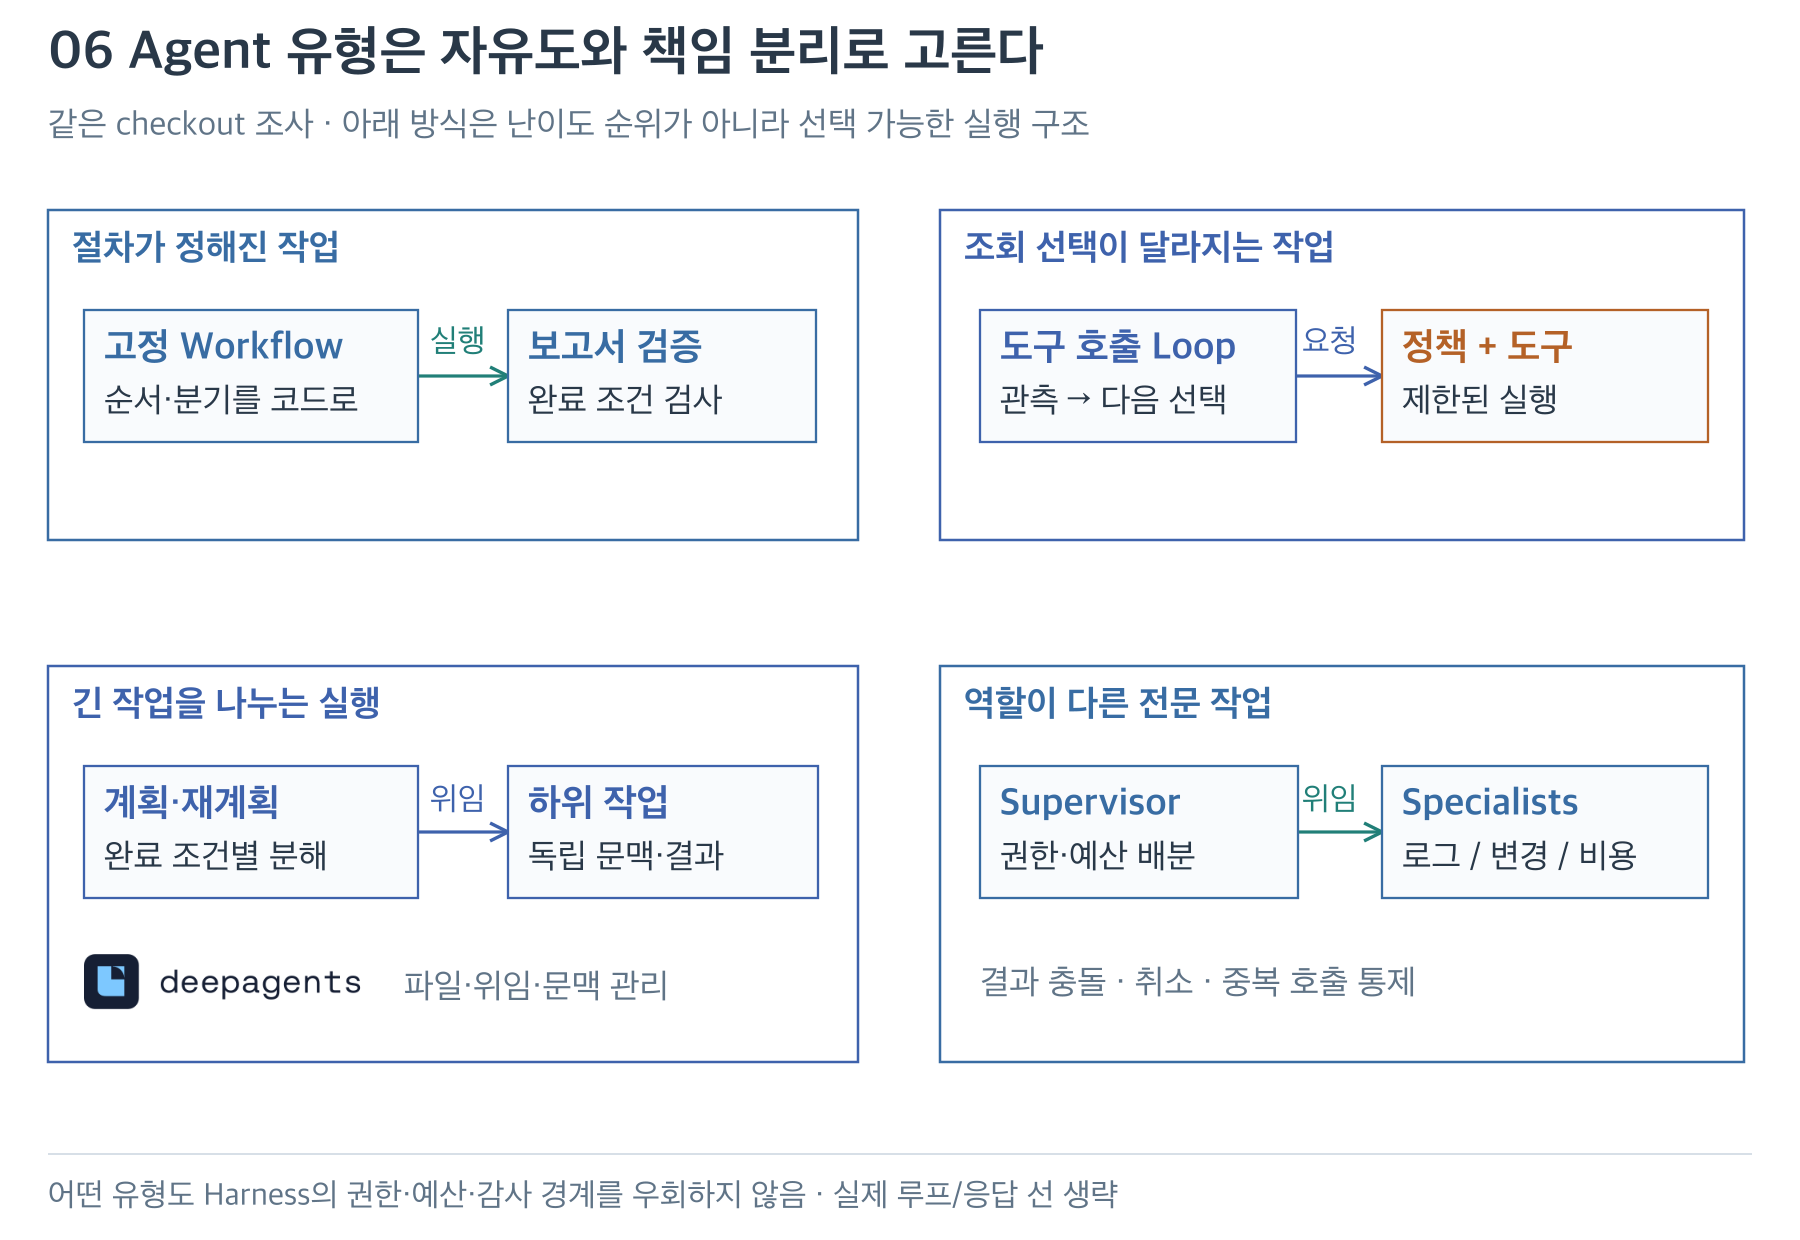
그림 1. 왼쪽 위는 정해진 절차, 오른쪽 위는 동적인 도구 선택, 왼쪽 아래는 긴 작업의 계획·하위 작업, 오른쪽 아래는 전문 역할 위임을 보여 준다. 네 영역은 난이도 순위나 반드시 통과할 단계가 아니다. 모든 유형에 공통 하네스의 권한·예산·감사 경계를 적용한다.
그림의 네 영역에 같은 inc-42 조사를 대입해 보자. 기본 절차가 정해져 있다면 왼쪽 위, 근거에 따라 다음 조회가 달라진다면 오른쪽 위가 출발점이다. 긴 자료 조사나 독립적인 전문 역할이 필요할 때 아래쪽 구조를 검토한다. 배포 담당자가 목적에 맞는 실행 구성을 정하며, 모델이 자기 실행기를 무제한으로 교체하는 설계는 아니다.
또한 에이전트 하나가 반드시 서버 하나라는 뜻은 아니다. 한 Python 프로세스에 서로 다른 지침과 도구를 가진 조사자 세 개를 둘 수 있다. 반대로 보안·배포·소유 팀이 다르면 각 에이전트를 별도 서비스로 분리할 수 있다. 논리적 역할 분리와 물리적 배포 분리는 별도 결정이다.
| 먼저 정할 질문 | inc-42의 예 | 구현에 미치는 영향 |
|---|---|---|
| 무엇을 완료해야 하나? | 근거가 연결된 조사 보고서 | 출력 계약과 검증기 |
| 다음 단계가 미리 정해지나? | 기본 조회는 고정, 추가 조회는 변동 | Workflow 안의 탐색 루프 |
| 작업을 나누어도 독립적인가? | 로그·변경 이력 조사는 일부 독립 | 선택적 병렬 위임 |
| 중단 후 이어서 해야 하나? | 조회 대기·사람 확인 이후 재개 | 상태 저장과 작업 ID |
| 어디까지 변경 가능한가? | 이번 업무는 조회만 허용 | 서버 정책과 자격증명 범위 |
Anthropic의 구조 구분도 코드가 정한 경로를 따르는 Workflow와 모델이 다음 행동을 선택하는 Agent를 구별한다. 이 정의를 사용하되, 제품·SDK 사용법은 오래된 글에서 가져오지 않는다. 해당 글 자체도 초기 게시 이후 도구 환경이 달라졌다고 안내한다. Anthropic의 에이전트 설계 패턴
2. 고정 Workflow
고정 Workflow — 다음 단계와 분기 조건을 개발자가 코드로 정한다. 일부 단계에서 LLM을 사용해도 전체 경로가 고정되어 있으면 Workflow로 볼 수 있다.
checkout 지연 알림마다 다음 네 가지를 반드시 확인하기로 운영팀이 합의했다고 하자.
- 알림의 서비스·환경·시간 범위를 검증한다.
- 지연과 오류율, 최근 배포, 대표 로그를 조회한다.
- 조회 결과를 같은 보고서 형식으로 정리한다.
- 근거 누락과 조회 실패를 검사한 뒤 결과를 반환한다.
이 업무는 처음부터 동적인 에이전트일 필요가 없다. 두 번째 단계의 API 조회 세 개는 일반 비동기 함수로 병렬 실행하고, 세 번째 단계의 문장 정리에만 LLM을 쓸 수 있다.
아래는 설명용 의사코드다. collect_required_evidence와 validate_report 등은 이 글의 애플리케이션 함수이며 특정 프레임워크 API가 아니다.
async def investigate(request, context):
    scope = validate_scope(request, context)
    evidence = await collect_required_evidence(scope)

    if evidence.has_required_failure:
        return incomplete_report(evidence)

    draft = await summarize_with_model(evidence)
    return validate_report(draft, evidence)
장점은 관찰하기 쉽다는 것이다. “로그 조회에서 실패했다”, “보고서 생성에서 시간이 오래 걸렸다”처럼 실패 위치가 분명하다. 필수 조회를 건너뛰지 않으며 최대 호출 수를 예상하기도 쉽다.
약점은 예외다. 기본 조회에서 데이터베이스 대기 신호가 보여도, 데이터베이스 조회 단계가 구현되어 있지 않으면 더 조사하지 못한다. 모든 가능성을 if문으로 추가하면 분기가 점점 복잡해진다. 이때 전체를 자율화하기보다 변동이 많은 추가 조사 부분에만 도구 호출 루프를 넣는 선택이 가능하다.
고정 Workflow의 성공을 “무조건 근본 원인을 찾았다”로 정하면 안 된다. 필수 자료가 부족할 때 INCOMPLETE와 미확인 범위를 올바르게 반환하는 것도 정상 동작이다. 코드로 경로를 고정했다고 데이터의 정확성까지 보장되는 것은 아니다.
3. 단일 에이전트 루프
도구 호출 루프 — 모델이 현재 근거를 읽고 도구 호출을 요청하면, 실행기가 검증 후 호출하고 결과를 다시 모델에게 전달하는 반복 구조다.
inc-42 조사에서 모델이 처음에 지연 지표를 선택했다고 하자. 지표는 이상 발생 시점을 좁혀 주지만 원인은 말해 주지 않는다. 이어서 대표 트레이스를 조회하고, 지연이 payment 호출에 집중되면 해당 의존성의 상태를 확인한다. 조회 순서가 이전 결과에 따라 달라진다.
현재 목표·근거 읽기
        ↓
모델: 다음 조회 또는 최종 답변 요청
        ↓
하네스: 입력·권한·실행 한도 검사
        ↓
도구: 실제 조회 → 구조화된 결과
        ↓
상태 갱신 → 충분하지 않으면 다음 반복
이 반복을 ReAct와 함께 설명하는 경우가 많다. 여기서는 ReAct의 모든 연구 세부를 구현한다는 의미로 쓰지 않고, 추론에 따라 행동을 선택하고 관찰 결과로 다음 행동을 바꾸는 방식을 이해하기 위한 이름으로 사용한다. 운영 기록에 필요한 것은 내부 생각의 전사본보다 목표, 선택한 도구, 입력 범위, 근거, 판단 요약이다.
LangGraph의 공식 예제도 모델이 도구 호출을 요청했는지에 따라 도구 노드로 돌아가거나 종료하는 흐름을 보여 준다. 그래프 라이브러리 자체가 필수인 것은 아니며 같은 논리를 일반 코드로 작성할 수도 있다. LangGraph의 Workflow와 Agent 예제
3.1 루프 종료 조건
처음 만들 때 흔히 “원인을 찾을 때까지 조사하라”고 지시한다. 그러나 원인이 관측 데이터에 없으면 끝나지 않을 수 있다. 데이터가 없는 도구를 계속 호출하거나, 같은 로그를 다른 표현으로 반복해서 검색할 수 있다.
inc-42의 실행기는 다음 상태를 구별해야 한다.
| 상태 | 의미 | 다음 행동 |
|---|---|---|
COMPLETED | 정한 조사 범위와 결과 검증을 충족 | 보고서 반환 |
INCOMPLETE | 필요한 자료가 없거나 한도에 도달 | 확보한 근거와 부족한 자료 반환 |
WAITING_APPROVAL | 별도 승인이 필요한 행동을 제안 | 실행하지 않고 승인 대기 |
DENIED | 해당 요청의 권한이 없음 | 같은 권한 문제를 우회 재시도하지 않음 |
CANCELLED | 운영자나 상위 작업이 취소 | 미완료 작업 정리와 기록 |
반복 횟수 제한만으로는 충분하지 않다. 한 번의 도구 호출이 무기한 대기할 수 있기 때문이다. 실행 전체의 마감 시각, 도구별 Timeout, 누적 모델 비용, 중복 조회 감지를 함께 둔다. 이 값들은 예제에서 임의로 정한 횟수를 그대로 운영 기준으로 복사하지 말고 실제 업무의 응답 시간과 비용 목표에 맞춘다.
단일 루프는 처음 구현하기 좋지만, 대화가 길어질수록 자료가 섞이기 쉽다. 모델이 열 개의 도구 중 하나를 고르는 데 계속 실수한다면 도구 설명·출력 크기·검색 범위부터 확인하자. 즉시 에이전트를 열 개 만드는 것이 첫 해결책은 아니다.
4. 계획·실행 분리
Plan-and-execute — 목표를 하위 작업으로 나누는 계획 단계와 각 작업을 수행하는 실행 단계를 구별하는 구조다. 계획은 새 증거에 따라 수정할 수 있다.
단일 루프가 매 순간 “다음에 무엇을 하지?”를 결정한다면, 계획·실행 구조는 먼저 조사 지도를 만든다. inc-42에서는 다음처럼 기록할 수 있다.
P1 영향 범위와 시작 시각 확인
P2 시작 시각 주변의 배포·설정 변경 확인
P3 느린 요청의 공통 의존성 확인
P4 후보 원인별 지지 근거와 반증 정리
P5 미확인 항목을 포함한 보고서 검증
여기서 계획은 작업 목록이지 사실의 목록이 아니다. P2에 “최근 배포 확인”이 있다고 배포가 원인이라는 뜻은 없다. 새 트레이스가 데이터베이스 연결 대기를 보여 주면 P3 아래에 풀 사용량과 연결 오류 확인을 추가할 수 있다.
4.1 계획·근거 상태
계획에는 task_id, 상태, 의존 작업, 완료 조건을 둔다. 근거에는 evidence_id, 조회 범위, 시각, 출처와 조회 성공 여부를 둔다. P2=completed라고 기록하는 행위와 “배포 원인설이 확인됐다”고 기록하는 행위를 분리하는 것이다.
{
  "task_id": "P2",
  "status": "completed",
  "question": "이상 발생 전후 변경이 있었는가?",
  "evidence_ids": ["ev-deploy-07"],
  "finding": "시간상 가까운 변경이 있으나 인과관계는 미확인"
}
위 값은 설명용 기록이다. 운영 보고서에서는 completed의 정의도 구체적으로 정해야 한다. “조회 함수가 끝났다”인지, “필수 자료를 모두 확보했다”인지가 섞이면 잘못된 진행률이 나온다.
계획·실행 분리는 하루 동안 여러 저장소와 장애 기록을 조사하는 작업에 유용하다. 반면 지표 하나를 조회하는 요청에 계획 작성, 실행, 재계획, 평가 모델을 각각 호출하면 응답만 느려질 수 있다. 계획을 별도 모델 호출로 만들지, 같은 에이전트의 상태 도구로 관리할지도 선택 사항이다.
실패 조건은 잘못된 첫 계획에 대한 집착이다. “배포 문제일 것이다”라는 계획을 세우고 그 주장에 맞는 자료만 찾을 수 있다. 완료 조건에 지지 근거뿐 아니라 반증·대안 가설·미확인 항목을 넣고, 재계획 횟수에도 한도를 두어야 한다.
5. 분기·조정·전문 역할
Router·Supervisor·Specialist를 모두 “여러 에이전트를 부르는 기능”으로 외우면 구조가 혼란스러워진다. 언제 분기하고 누가 결과를 책임지는지로 구별하자.
5.1 Router의 요청 분기
Router는 요청을 분류해 적절한 작업으로 보낸다. “지난달 비용을 정리해 줘”는 비용 분석으로, “장애 원인을 조사해 줘”는 장애 조사로 보낸다. 분류가 명확하면 규칙 코드만으로도 충분하며 반드시 LLM일 필요는 없다.
inc-42를 RCA 업무로 보낸 후 Router가 모든 조회 단계에 계속 참여할 필요는 없다. 다만 오분류 시 돌아올 경로가 필요하다. 서비스 식별도 되지 않은 요청을 모델의 자신감 점수만 믿고 특정 운영 환경으로 보내면 안 된다. 필수 입력이 없으면 NEEDS_CONTEXT로 반환하거나 안전한 조회 경로로 제한한다.
LangChain의 Router 문서도 입력 분류, 하나 이상의 전문 처리 경로 선택, 결과 종합을 다룬다. 이 글의 NEEDS_CONTEXT는 공식 상수가 아니라 애플리케이션에서 정하는 상태다. Router 패턴
5.2 Supervisor의 조정
Supervisor는 inc-42를 해결하기 위해 어떤 하위 조사가 필요한지 결정한다. 예를 들어 지표 분석자에게 영향 범위를, 변경 분석자에게 최근 배포를 조사하도록 요청한다. 결과가 서로 충돌하면 추가 확인을 지시하거나 충돌을 남긴 채 보고한다.
Supervisor가 모든 도구를 직접 사용하면서 하위 에이전트까지 부를 수도 있지만, 이 시리즈의 예시 설계에서는 조정과 최종 보고에 집중시킨다. 전문 조회 권한을 조사자에 좁혀 주면 도구 선택과 감사 기록이 명확해진다.
여기서 Supervisor라는 이름은 관리자 권한을 뜻하지 않는다. 작업을 나눌 수 있다는 사실이 Kubernetes 변경 권한을 주지 않는다. 호출자가 조회만 허용받았다면 하위 에이전트도 조회 범위 안에서 일해야 한다.
5.3 Specialist의 전문 역할
Specialist는 전문 지침·도구·출력 형식을 가진 역할이다. telemetry-analyst는 지표와 트레이스를 해석하고, change-reviewer는 배포·설정 변경을 비교한다. 둘이 다른 모델을 사용해야 하는 것은 아니다. 같은 모델이라도 입력 범위와 도구가 다르면 역할 분리의 효과가 생긴다.
| 패턴 | 누구에게 무엇을 맡기나? | 가장 먼저 볼 실패 |
|---|---|---|
| Router | 요청을 적절한 업무로 전달 | 오분류·필수 입력 누락 |
| Supervisor | 여러 하위 작업의 범위·순서·종합 | 중복 위임·결과 충돌·조정 비용 |
| Specialist | 좁은 분야의 조사와 근거 반환 | 전문 범위 밖 추측·근거 요약 손실 |
하위 결과는 “배포가 원인입니다” 한 문장보다 다음 계약으로 받는 편이 유용하다.
{
  "task_id": "inc-42/change-review",
  "status": "COMPLETE_WITH_UNCERTAINTY",
  "claims": [
    {
      "text": "이상 시작 전후에 checkout 배포 변경이 존재함",
      "evidence_ids": ["ev-deploy-07"],
      "confidence_label": "observed"
    }
  ],
  "unresolved": ["변경 전후 트래픽 조건의 차이는 미확인"]
}
이 계약도 자체 설계 예시다. 최종 보고를 쓰는 Supervisor는 evidence_ids가 실제로 존재하고 현재 작업에서 접근 가능한지 확인한다. 필요하면 원문 근거를 다시 읽는다. 하위 에이전트가 확신한다고 사실 검증을 생략하지 않는다.
6. 멀티에이전트의 장단점
멀티에이전트 — 별도의 역할이나 실행 문맥을 가진 여러 에이전트를 조정해 하나의 작업을 처리하는 방식이다. 하나의 도구가 내부에서 API 세 개를 병렬 조회하는 것과는 구별한다.
멀티에이전트의 실용적인 이유는 “AI끼리 토론하면 똑똑해진다”보다 구체적이어야 한다. 자료가 너무 많아 문맥을 분리해야 하거나, 독립적인 조사를 동시에 진행할 수 있거나, 팀마다 전문 도구를 관리하는 경우다. LangChain도 이런 목적과 함께 단일 에이전트로 충분한 경우를 설명한다. 멀티에이전트 개요
6.1 조사 결과 종합
telemetry-analyst는 “payment 호출 지연이 전체 요청 지연의 큰 부분을 차지한다”고 반환했다. change-reviewer는 “checkout 배포가 이상 시작 시점과 가깝다”고 반환했다. 두 결과는 서로 모순일 수도, 같은 원인의 다른 면일 수도 있다.
Supervisor는 다수결로 원인을 정하지 않는다. 배포에서 결제 호출의 Timeout이나 재시도 설정이 달라졌는지 확인하고, 트레이스의 지연 구간과 변경 시점을 연결한다. 추가 자료가 없다면 “시간상 연관은 있으나 원인 확정 불가”로 남긴다.
이 과정에서 두 에이전트가 같은 로그를 반복 조회했다면 병렬화 이득이 줄어든다. 작업을 나눌 때 질문, 대상 서비스, 시간 범위, 도구, 예상 산출물을 함께 전달해야 한다. “너는 최고의 전문가이니 조사해라”만으로는 경계가 생기지 않는다.
6.2 병렬 처리와 비용
설명용으로 세 조사가 각각 8초, 11초, 7초 걸리고, 마지막 종합에 4초가 걸린다고 가정하자. 순차 처리 시간은 단순 합계로 30초다. 세 조사가 완전히 독립적이고 즉시 병렬 시작된다면 대기 시간은 가장 긴 11초에 종합 4초를 더한 약 15초가 될 수 있다.
그러나 총 작업량은 사라지지 않는다. 각 조사자가 같은 배경 설명을 읽고 결과를 작성하며, Supervisor도 결과를 다시 읽는다. 모델 비용은 호출별 입력·출력 사용량과 가격을 합산해야 한다. 실제 운영에서는 큐 대기, 도구 제한, 스트리밍, 캐시, 재시도로 결과가 달라진다. 위 수치는 제품 성능 측정이나 비용 절감 보장이 아니다.
컨텍스트 분리도 보안 격리와 같지 않다. 서로 다른 메시지 기록을 가진 에이전트라도 같은 파일 저장소·토큰·네트워크에 접근하면 같은 데이터를 읽을 수 있다. 별도 권한이 필요하면 서버가 자격증명과 데이터 범위를 분리해야 한다.
6.3 구조 단순화 기준
같은 자료를 조금 다른 말로 세 번 요약한다면 한 번의 구조화된 호출로 합칠 수 있다. 하위 에이전트 호출의 대부분이 단일 API 조회라면 일반 Tool로 바꾸는 편이 단순하다. 상위 에이전트가 항상 같은 세 작업을 부른다면 동적 Supervisor 대신 고정 병렬 Workflow도 후보가 된다.
반대로 한 조사자가 대용량 로그와 여러 문서를 깊게 탐색하고, 다른 조사자가 독립적으로 변경 내용을 검토한다면 역할 분리 가치가 있다. 판단 기준은 에이전트 숫자가 아니라 단일 구조에서 실제로 발생한 실패를 줄이는지다.
7. Deep Agents
“deep agent”라는 말은 긴 조사·계획·도구 사용을 수행하는 에이전트를 느슨하게 가리키기도 한다. 하나의 엄격한 업계 표준 분류로 받아들이면 혼란스럽다. 이 절의 Deep Agents는 LangChain의 deepagents 라이브러리를 뜻한다.
LangChain은 Deep Agents를 에이전트 하네스로 설명한다. 기본 도구 호출 루프 위에 파일 기반 작업, 컨텍스트 관리, 하위 에이전트 등의 기능을 제공하며 LangGraph 실행 기반을 사용한다. 따라서 “일반 에이전트보다 지능이 높은 다른 모델”로 이해하면 안 된다. Deep Agents 공식 개요
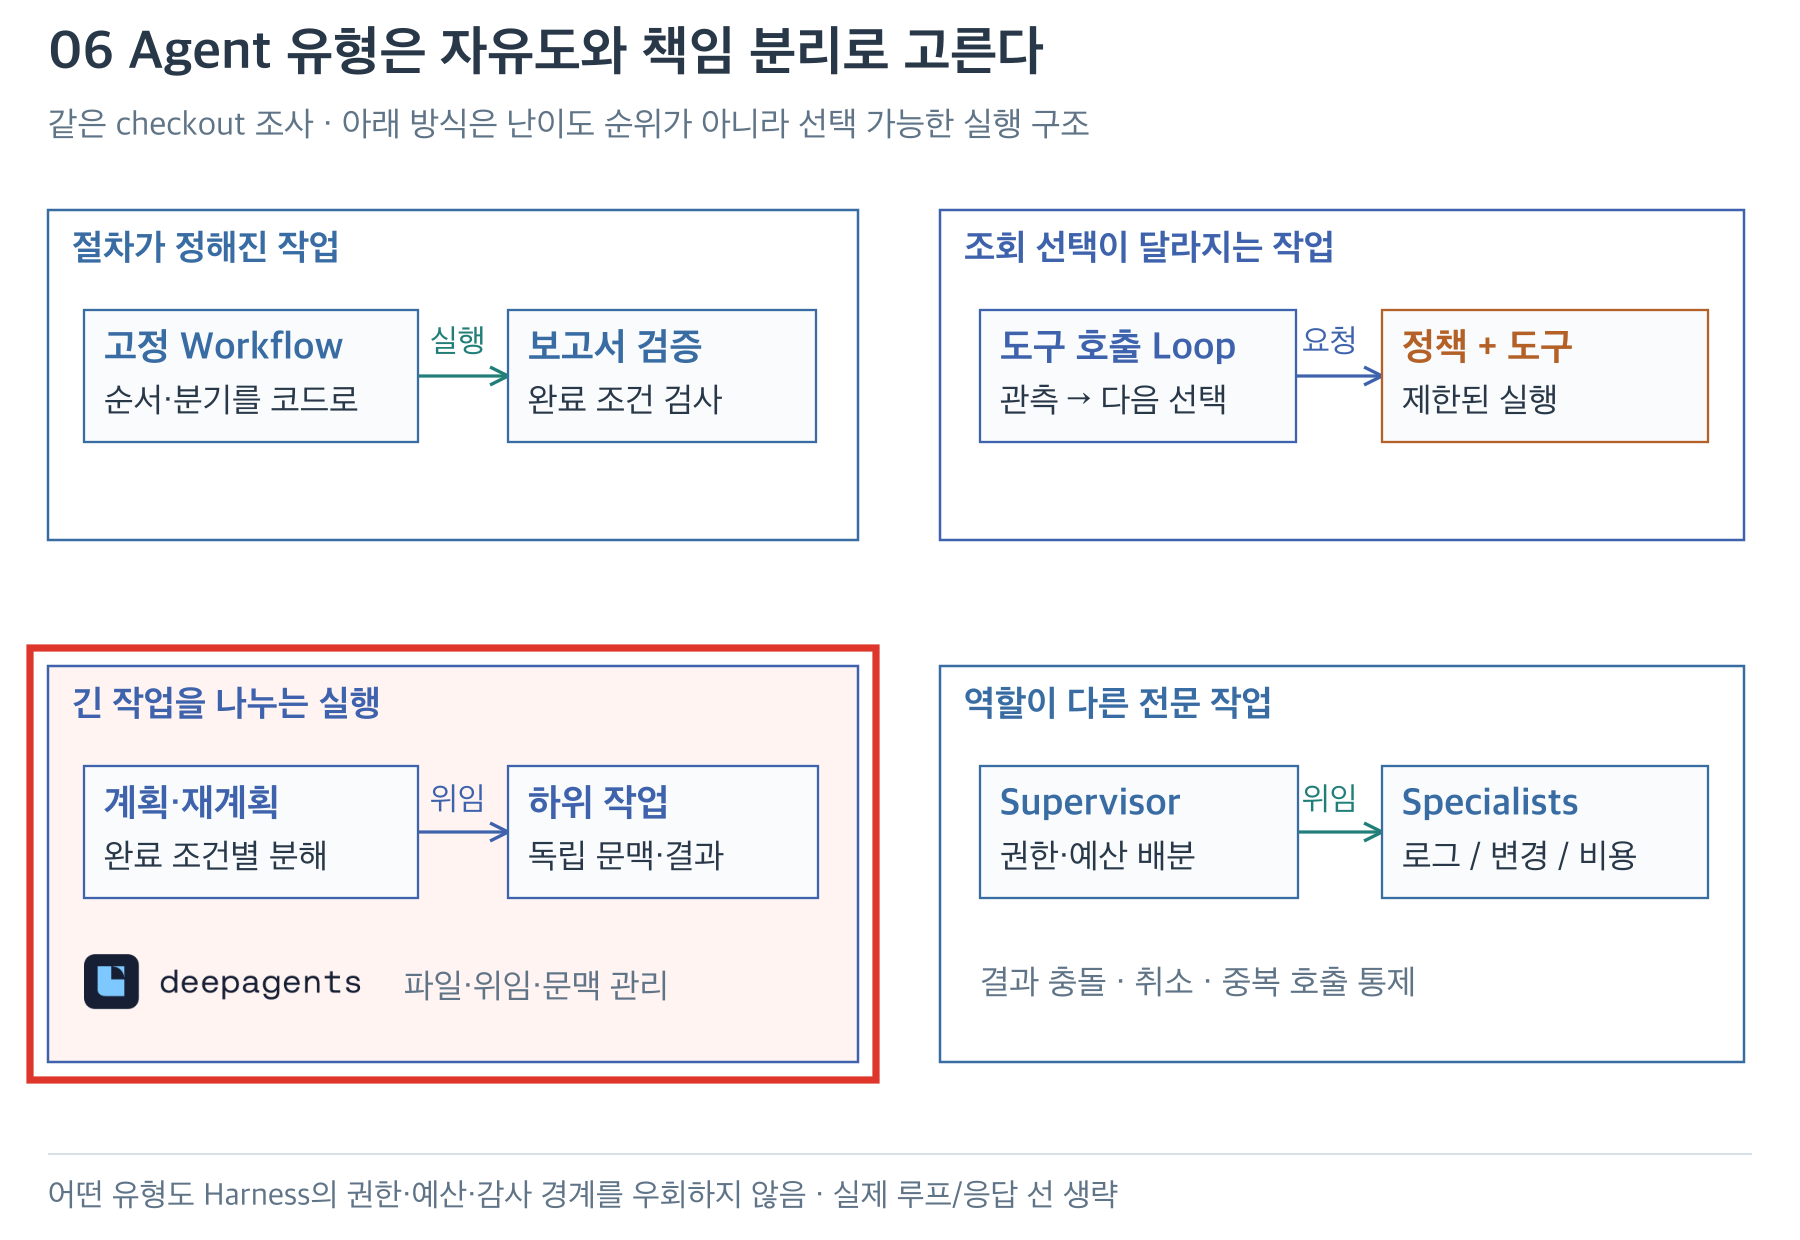
그림 2. 그림 1과 같은 배치에서 왼쪽 아래의 긴 작업 영역을 빨간 테두리로 강조했다. 계획·재계획과 독립된 하위 작업, 파일·위임·문맥 관리의 관계를 읽는다. Deep Agents 공식 로고는 라이브러리를 식별하며 더 높은 등급의 모델을 뜻하지 않는다.
7.1 기능과 적용 범위
inc-42의 짧은 실시간 조사를 넘어, 지난 한 달의 유사 장애를 비교하고 Runbook 개선안을 작성한다고 하자. 자료를 한 번에 모두 프롬프트에 넣기는 어렵다. 조사 계획, 중간 근거 파일, 비교 표, 미해결 질문을 보관하며 작업을 이어 갈 필요가 있다.
이때 Deep Agents의 기능을 다음 요구에 대응시킬 수 있다.
| 요구 | 활용할 기능 | 별도로 결정할 것 |
|---|---|---|
| 큰 결과를 나중에 다시 읽기 | 가상 파일시스템과 컨텍스트 분리 | 저장소·보존 기간·접근 범위 |
| 긴 작업의 진행 상태 관리 | 선택적으로 추가하는 계획 도구 | 완료 조건과 재계획 한도 |
| 독립적인 조사 위임 | Subagent | 전달 자료·도구 범위·결과 계약 |
| 업무별 절차 재사용 | Skill | 승인된 버전과 로딩 방식 |
| 위험한 도구 호출 전 멈춤 | Interrupt와 승인 처리 | 승인 주체·유효 기간·재개 검증 |
특히 계획 도구의 기본값에 주의하자. 확인한 현재 문서는 v0.7부터 작업 계획을 선택 기능으로 설명하며 TodoListMiddleware를 명시적으로 추가하도록 안내한다. 오래된 예제의 기본 동작을 새 버전에 그대로 적용하지 말자. 아래 코드는 이 확인 범위를 전제로 한다. Deep Agents 작업 계획 설정
7.2 구성 코드
다음은 공식 API 예제 기반·미실행 구성 예시다. create_deep_agent, subagents, TodoListMiddleware의 조합을 공식 문서에서 확인했으며, AIOps 함수와 지침은 이 글에 맞춰 바꿨다. 실제 모델 API, Grafana, 저장소에 연결해 실행하지 않았다.
model은 사전에 초기화한 호환 모델 객체다. query_evidence와 search_runbooks는 인증된 실행 문맥을 서버에서 적용하는 자체 어댑터이며, 이 코드 조각에 그 구현은 포함하지 않는다. 패키지의 검증된 정확한 버전은 프로젝트의 잠금 파일에 고정해야 한다.
from deepagents import create_deep_agent
from langchain.agents.middleware import TodoListMiddleware

telemetry_analyst = {
    "name": "telemetry-analyst",
    "description": "checkout 장애의 지표·로그·트레이스 근거를 조사",
    "system_prompt": (
        "위임된 시간·서비스 범위를 지킨다. "
        "근거 ID와 미확인 항목을 반환한다. "
        "조회 실패를 정상 상태로 해석하지 않는다."
    ),
    "tools": [query_evidence],
}

agent = create_deep_agent(
    model=model,
    tools=[search_runbooks],
    system_prompt="장애 조사를 조정하고 근거가 연결된 보고서를 작성한다.",
    middleware=[TodoListMiddleware()],
    subagents=[telemetry_analyst],
)
읽는 순서는 tools, subagents, middleware다. 메인 에이전트의 업무 도구는 Runbook 검색이고, 전문 조사자의 업무 도구는 관측 근거 조회다. 계획 기능은 명시적으로 추가했다. 공식 문서는 사용자 정의 Subagent의 도구·지침·미들웨어가 어떻게 구성되는지 구별하므로, 모든 설정이 자동 상속된다고 가정하지 말아야 한다. Deep Agents Subagent 구성
이 코드의 tools 목록이 에이전트가 사용할 수 있는 전체 기능 목록은 아니다. Deep Agents의 기본 파일 도구와 일반 목적 Subagent가 추가될 수 있다. 실제 적용 전에는 최종 모델에 노출된 도구 목록을 확인하고, 필요 없는 기본 기능의 제거·제한을 해당 버전 문서에 따라 적용해야 한다. 따라서 이 코드만 복사해 “조회 전용 운영 에이전트가 완성됐다”고 판단하면 안 된다.
7.3 파일·메모리·권한
Deep Agents의 파일 경로는 항상 실제 서버 디스크 경로를 뜻하지 않는다. StateBackend는 현재 Thread 상태에 파일을 저장하고, StoreBackend는 별도 Store를 통해 실행을 넘는 저장을 구성하며, FilesystemBackend는 실제 파일에 접근한다. 선택에 따라 보존 범위와 접근 위험이 달라진다. Backend 종류와 저장 범위
예를 들어 /workspace/inc-42/notes.md는 이번 조사 메모로, 검토된 장기 지식은 별도 저장 경로로 나누는 편이 좋다. 같은 이름의 폴더를 만들었다고 Thread 간 격리나 장기 보존이 자동으로 생기는 것은 아니다. Tenant·사용자·작업 ID를 어떤 저장소 키에 넣을지는 애플리케이션의 책임이다.
내장 파일 권한 규칙에도 범위가 있다. 공식 문서는 해당 규칙이 내장 파일 도구에 적용되며 사용자 정의 도구·MCP 도구·Sandbox의 임의 셸 실행을 모두 통제하는 규칙은 아니라고 설명한다. 규칙 미일치 시 허용되는 기본 동작과 적용 순서도 확인해야 한다. 제품의 파일 권한 설정을 조직 전체의 인가 정책으로 확대 해석하지 말자. Deep Agents 파일 권한의 적용 범위
8. Subagent·Skill·MCP
첨부된 학습 자료처럼 .claude/agents/와 .claude/skills/에 Markdown을 두는 방식은 특정 실행기의 설정 예다. 모든 에이전트가 그 경로를 자동으로 읽는 보편 규칙은 아니다. 자체 Python Runtime은 발견·로딩·검증·실행 코드를 직접 제공하거나 이를 지원하는 프레임워크와 연결해야 한다.
| 구성 | 답하는 질문 | inc-42의 예 |
|---|---|---|
| Subagent | 이 하위 작업을 누가 맡나? | 지표·트레이스 조사자 |
| Skill | 이 업무를 어떤 절차로 하나? | 장애 초기 조사 절차와 보고서 양식 |
| Tool | 실제로 어떤 동작을 호출하나? | 제한된 시간 범위의 지표 조회 |
| MCP | 도구·자료를 어떤 연결 규약으로 제공하나? | 여러 클라이언트가 공통 조회 서버 이용 |
| Harness | 호출·상태·권한·중단·검증을 누가 관리하나? | 애플리케이션 실행기와 정책 계층 |
하나의 Subagent가 여러 Skill을 읽고 MCP를 통해 Tool을 사용할 수 있다. 반대로 Skill 하나를 로드하는 데 별도 Subagent나 MCP 서버가 반드시 필요한 것은 아니다.
Agent Skills 명세는 SKILL.md와 선택적인 스크립트·참고 자료 구조를 정의한다. 이는 재사용할 업무 지식을 패키징하는 방법이다. 실행기가 지원하는 항목을 확인해야 하며 Markdown의 도구 이름이나 allowed-tools 선언만으로 데이터베이스·Kubernetes의 실행 권한이 강제되는 것은 아니다. Agent Skills 명세
MCP는 Host, Client, Server가 도구·리소스 등의 기능을 주고받는 연결 구조를 제공한다. “RCA Agent → MCP → Copilot”이라는 한 줄 그림만 보면 MCP가 추론이나 정책 결정을 대신하는 중앙 서비스처럼 보일 수 있다. 실제로는 어느 앱이 Host이고, 어느 서버가 어떤 Tool을 제공하며, 인가를 어디서 확인하는지를 표시해야 한다. MCP 아키텍처
inc-42 예시에서 Copilot이 Host라면, Host의 MCP Client가 조회 MCP Server에 요청하고 서버가 승인된 관측 API를 호출한다. RCA 분석을 하나의 도구로 제공할 수도 있다. 이 경우 Tool 내부에 다시 에이전트 루프가 있다는 점을 Timeout·취소·비용 계약에 반영해야 한다. “MCP로 연결했다”는 사실만으로 긴 분석이 즉시 응답하는 것은 아니다.
9. Repository와 하네스
하네스는 에이전트 주변에서 작업을 안전하고 재현 가능하게 실행시키는 기반이다. 프로젝트에 따라 범위가 다르지만, 이 시리즈에서는 실행 상태, 모델·도구 호출, 비용 한도, 승인·권한 확인, 결과 검증을 포함하는 애플리케이션 계층으로 사용한다.
다음 트리는 자체 애플리케이션의 논리적 구조 예시다. 이 파일들이 현재 서버에 구현·배포되어 있다는 뜻은 아니다. 1편과 같은 경로를 사용하며, 여기서는 유형 선택과 관련된 부분만 표시한다. 하네스는 별도 서버 이름이 아니라 runtime/, policy/, 도구·상태·검증을 묶은 책임이다. 업무 패키지의 Markdown 자산은 로딩 설정에 따라 다른 경로에 둘 수도 있다.
aiops-agent/
├─ src/aiops_agent/
│  ├─ api/                 # 인증된 요청과 취소 입력
│  ├─ workflows/
│  │  ├─ triage.py         # 고정 경로와 제한된 탐색
│  │  └─ supervisor.py     # 필요한 경우 위임·종합
│  ├─ runtime/
│  │  ├─ runner.py         # 마감·한도·상태 전이
│  │  └─ dispatcher.py     # 검증 후 도구 호출
│  ├─ policy/              # 서버 인가·승인 검사
│  ├─ tools/               # 모델에 제공하는 도구 계약
│  ├─ domain/              # Run·Evidence·Report·위임 계약
│  ├─ memory/              # 실행 상태·장기 기억
│  ├─ knowledge/           # 권한·최신성을 반영한 검색
│  ├─ adapters/            # 실제 외부 API·프레임워크 연결
│  └─ skills/incident-triage/SKILL.md
└─ evals/                  # 정상·실패·권한 경계 사례
9.1 실행·권한 인터페이스
Orchestrator는 “어떤 도구를 호출하고 싶은가”를 결정한다. Dispatcher는 “이 호출을 실제로 수행해도 되는가”를 결정한다. 둘을 합치면 프레임워크를 교체할 때 권한 확인까지 새로 구현하게 되거나, 일부 경로에서 정책 검사가 빠질 수 있다.
아래는 설명용 인터페이스 의사코드이며 외부 라이브러리의 클래스가 아니다.
class Orchestrator:
    async def propose_next(self, state, visible_tools):
        """ToolCall, Delegate, FinalReport 중 하나를 제안한다."""
        ...

class Dispatcher:
    async def execute(self, proposal, authenticated_context):
        """입력·인가·승인·한도를 검사한 뒤 실제 도구를 호출한다."""
        ...

class RunStore:
    async def checkpoint(self, run_id, state, event):
        """재개에 필요한 상태와 실행 이벤트를 저장한다."""
...authenticated_context는 로그인 세션이나 서버가 검증한 요청에서 얻는다. 모델이 도구 인자로 임의의 tenant_id, 역할, 승인 여부를 넣어 권한을 얻지 않도록 한다. 모델이 볼 도구 목록을 먼저 좁히고 실행 시 다시 검사하는 두 단계가 필요하다.
위임에도 같은 원칙을 적용한다. 부모가 가진 모든 권한을 통째로 복사하기보다 사용자에게 허용된 범위, 현재 작업 범위, 하위 역할의 범위가 겹치는 부분을 자식 실행 문맥으로 만든다. telemetry-analyst가 장애 조사 중 배포 Tool을 요청하면 프롬프트의 선의와 관계없이 거절한다.
9.2 재개와 중복 실행
Checkpoint로 상태를 저장하면 중단 후 재개할 수 있지만, 도구 실행 직후 프로세스가 종료되면 “도구는 성공했는데 완료 상태는 저장하지 못한” 상황이 생길 수 있다. 읽기 조회라면 비용 낭비로 끝날 수 있지만, 변경 Tool이라면 같은 작업이 두 번 실행될 수 있다.
LangGraph의 Interrupt 설명도 재개 시 노드 코드가 다시 실행될 수 있으므로 중단 전 부수효과와 재실행을 고려하도록 안내한다. LangGraph 중단과 재개
따라서 변경 요청에는 안정적인 작업 ID와 대상·인자에 결합된 멱등성 키를 사용하고, 재개 전에 외부 시스템의 실제 결과를 확인한다. 승인 역시 “언젠가 이 사용자가 승인했다”가 아니라 특정 작업·대상·인자·유효 기간에 연결되어야 한다. 구체적인 Dispatcher와 승인 상태 머신은 하네스·거버넌스 편에서 이어 다룬다.
10. 유형 선택 기준
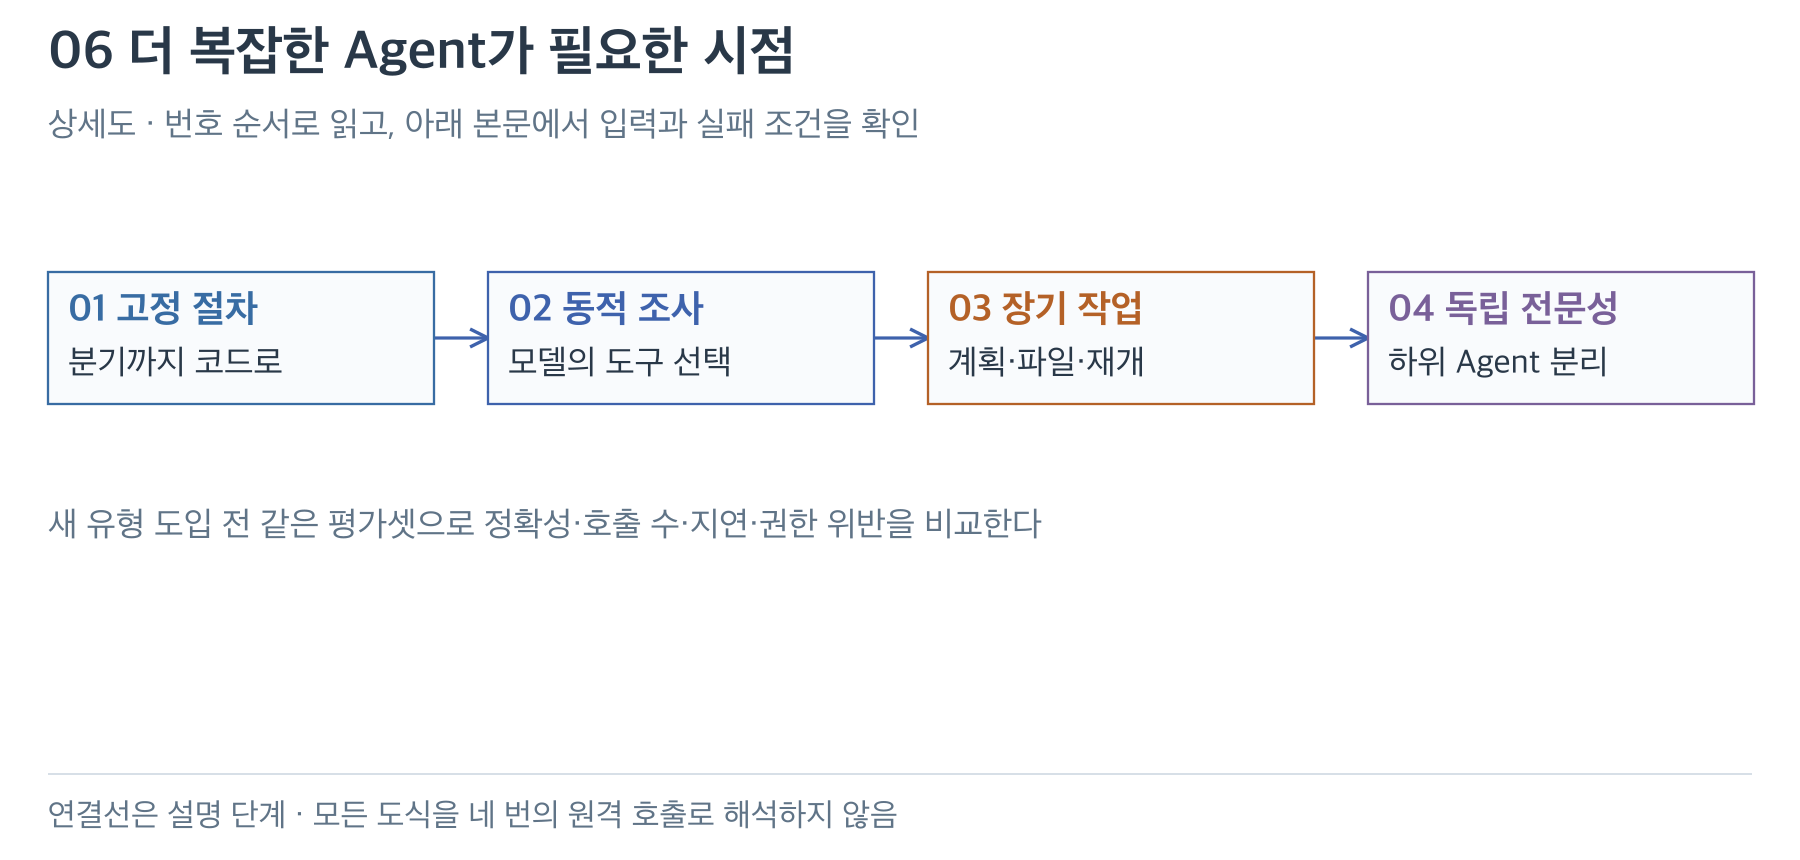
그림 3. 왼쪽부터 어떤 요구가 추가되는지 읽는다. 정해진 절차에 동적 탐색, 장기 상태 관리, 독립적인 전문 역할이 필요한지 차례로 검토한다. 오른쪽으로 갈수록 무조건 좋은 구조라는 뜻은 아니며 같은 평가셋으로 정확성·호출 수·지연·권한 위반을 비교한다.
| 업무의 실제 조건 | 시작할 구조 | 추가하기 전에 확인할 것 |
|---|---|---|
| 같은 입력에 같은 점검 순서 | 고정 Workflow | 누락된 분기와 필수 데이터 |
| 조회 결과에 따라 다음 탐색 변경 | 제한된 단일 Tool loop | 도구 설명·반복·종료 품질 |
| 여러 단계의 진행과 재계획 필요 | 계획·실행 분리 | 계획이 실제 누락을 줄이는지 |
| 요청 종류에 따라 도구와 지침이 다름 | Router + 업무별 실행기 | 오분류 시 복귀와 입력 확인 |
| 독립적인 대량 조사·다른 전문 문맥 | Supervisor + Specialist | 중복 작업·통합 비용·권한 분리 |
| 파일·긴 문맥·위임·재개가 반복 요구 | Deep Agents 같은 하네스 검토 | 기본 도구·Backend·버전·운영 통제 |
inc-42의 첫 구현은 필수 조회를 고정한 Workflow + 제한된 추가 조사 루프 + 코드 검증기로 제안한다. 기본 신호를 놓치지 않으면서 예외적인 탐색을 허용하기 쉽기 때문이다. 이것은 모든 회사의 정답이 아니라 이 글의 조회 중심 장애 조사 요구에 대한 설계 선택이다.
그다음 운영 기록을 보고 구조를 바꾼다. 추가 탐색이 계속 같은 순서라면 Workflow로 고정할 수 있다. 서로 다른 자료를 독립적으로 오래 읽는 작업이 병목이면 Specialist를 추가한다. 여러 세션에 걸친 분석 파일과 진행 상태가 반복적으로 필요하면 Deep Agents 또는 자체 장기 실행 하네스를 비교한다.
11. 장애 조사 흐름
이제 개념을 한 번의 실행에 연결해 보자. 아래는 inc-42의 가상 처리 시나리오이며 실제 RCA 결과가 아니다.
① 진입과 범위 확정. 서버는 인증된 사용자가 checkout의 해당 환경을 조회할 수 있는지 확인한다. 장애 ID와 조사 시간 범위를 실행 상태에 고정한다. 환경이 빠져 있다면 모델이 추측해서 운영 클러스터를 선택하지 않는다.
② 필수 조회. Workflow가 지연, 오류율, 최근 변경, 대표 트레이스를 수집한다. 한 조회가 실패하면 실패 상태를 근거 묶음에 남긴다. 전체 조회가 성공한 것처럼 요약하지 않는다.
③ 제한된 탐색. 단일 에이전트는 payment 호출 지연이 보인다는 근거를 읽고 관련 Runbook을 검색한다. 검색 결과가 과거 버전용이라면 그대로 조치하지 않고 현재 구성과 맞는지 확인한다. 도구를 세 번 더 호출할지, 여기서 불확실성을 보고할지는 남은 한도와 완료 기준 안에서 결정한다.
④ 필요한 경우 위임. 변경 비교가 길어지면 Supervisor가 change-reviewer에게 특정 배포 구간만 맡긴다. 메인 실행의 모든 대화나 다른 Tenant 자료를 보내지 않는다. 하위 실행의 도구 호출도 같은 Dispatcher와 감사 기록을 통과한다.
⑤ 근거 종합. 두 조사 결과의 시간 범위와 서비스 라벨이 같은지 확인한다. 근거 ID가 있다는 사실만 검사하면 서로 다른 환경의 자료를 잘못 연결할 수 있다. “같은 시각의 배포”와 “지연을 일으킨 설정”을 구별해 판단한다.
⑥ 완료와 다음 행동. 보고서는 관측 사실, 원인 후보, 반증, 미확인 자료, 다음 확인 순서로 나누어 반환한다. 모델이 재시작을 제안해도 이번 실행은 조회 업무이므로 직접 재시작하지 않는다. 변경 실행은 별도의 권한·승인·검증 절차로 이어진다.
이 흐름에서 메모리는 조사 상태를 이어 주고, Knowledge Base는 검토된 절차와 과거 사실을 제공한다. Grafana 생태계의 저장·조회 시스템은 현재 운영 신호의 근거를 제공한다. Langfuse 같은 LLM 관측 체계에는 모델·도구·위임의 실행 정보를 연결할 수 있다. 각각의 역할을 합쳐 “에이전트의 기억”이라고 부르면 무엇을 검증해야 하는지 불분명해진다.
12. 비교 평가와 연습
프레임워크 데모가 한 번 성공했다고 구조를 결정하지 말자. 같은 입력·데이터 스냅샷·완료 기준을 놓고 Workflow, 단일 루프, 위임 구조를 비교한다. 모델이나 검색 데이터를 동시에 바꾸면 구조 차이 때문인지 판단하기 어렵다.
| 평가 질문 | 기록할 값 | 해석할 때 주의할 점 |
|---|---|---|
| 근거가 맞는가? | 주장별 근거 적합성·대상 일치 | 출처 개수만 세지 않기 |
| 모를 때 멈추는가? | 자료 누락 시 올바른 보류 비율 | 짧은 답변을 실패로 단정하지 않기 |
| 작업이 불필요하게 반복되나? | 중복 조회·하위 작업 수 | 캐시가 가린 반복도 확인 |
| 시간이 얼마나 걸리나? | 전체·도구·모델 지연 분포 | 평균뿐 아니라 느린 사례 확인 |
| 비용이 늘어난 이유는? | 호출·입출력 사용량·위임량 | 호출 수만으로 비용 비교하지 않기 |
| 권한이 유지되나? | 금지 대상 호출 차단 결과 | 프롬프트 준수와 서버 차단 구별 |
예를 들어 멀티에이전트가 원인 후보를 더 많이 제시해도, 근거 없는 후보가 함께 늘었다면 품질이 좋아졌다고 보기 어렵다. 단일 에이전트가 조금 느리더라도 같은 근거 품질을 더 낮은 운영 복잡도로 제공할 수 있다. 반대로 전문 자료가 많은 작업에서는 문맥 분리로 누락이 줄어드는지 평가할 가치가 있다.
다음 세 요청을 직접 분류해 보면 개념이 정리된다.
- “어제 checkout 오류율과 가장 많이 발생한 오류 세 개를 정해진 양식으로 써 줘.” — 조회와 집계가 명확하므로 고정 Workflow부터 검토한다.
- “지연 원인을 조사하되 추가로 어떤 자료가 필요한지도 판단해 줘.” — 기본 조회 이후 제한된 탐색 루프가 필요하다.
- “한 달의 장애를 서비스별로 비교하고 Runbook 개선 초안을 만들어 줘.” — 계획, 장기 상태, 자료 분리와 선택적 위임을 검토한다.
마지막 요청에서도 처음부터 모든 서비스를 동시에 자율 운영하게 만들 필요는 없다. 서비스별 입력 스냅샷과 완료 기준을 준비하고, 조사 결과의 품질을 확인한 뒤 병렬 수를 늘리면 된다. 자동화할 판단을 좁게 정의하고, 실행 범위와 완료 증거를 코드로 유지하는 것이 유형 선택보다 먼저다.
자료와 검증 범위
2026-10-04 기준으로 위에 연결한 공식 문서의 실행 패턴·Deep Agents 구성·저장 범위·권한 적용 범위를 확인했다. 본문의 AIOps 배치·상태 이름·Repository·장애 사례는 설명을 위한 자체 설계다. 프레임워크 코드는 공식 예제 기반 미실행이며 실제 모델·Grafana·운영 환경 연동 검증을 뜻하지 않는다.
기존 학습 인계 자료의 “공통 Runtime + 업무별 지침 + 제한된 Tool + 검증” 구성을 확장했다. 사용자 제공 발표 이미지는 개념 비교의 참고로 사용했고, 특정 제품 구성이 우리 환경에 설치되어 있다는 근거로 사용하지 않았다.
추가 그림 자산 출처
Deep Agents 로고는 LangChain 공식 브랜드 자산의 제품 마크와 wordmark 전체를 사용했다. 원본 색상·비율·간격을 유지한 제품 식별이며 공식 후원을 뜻하지 않는다.
AIOps 에이전트 개발 시리즈
