[AIOps Agent 1] 개발 기본기와 코드 구조
이 글에서 다룰 주제
- Agent의 기본기: 모델 호출과 운영 에이전트는 무엇이 다른가?
- 개발 순서: 무엇부터 공부하고 어떤 MVP를 만들까?
- 전체 구조: Copilot·운영 데이터·Knowledge Base·하네스는 어디에 놓일까?
- 저장소 구조: 프롬프트·도구·정책·상태·평가를 어떤 파일로 나눌까?
주요 단어 · AIOps · Tool Calling · Runtime · Workflow · State · Evidence · Repository
읽기 안내 · Python 함수와 JSON을 본 적이 있는 입문자를 위한 글입니다. 읽고 나면 모델·Runtime·도구의 책임을 구분하고, 근거 검증기를 직접 실행할 수 있습니다.
결제 서비스가 느려졌다는 알림이 왔다. 담당자는 지표, 로그, 트레이스, 배포 이력을 차례로 살펴본다. AIOps 에이전트의 첫 목표는 이 조사 과정을 대신 수행하고 확인한 사실과 아직 모르는 부분을 근거와 함께 정리하는 것이다.
이 시리즈는 기초 → 메모리·권한 → Grafana 연동 → 운영·Langfuse로 이어진다. 이 글에서는 먼저 전체 구조와 작은 실습을 익힌다. 메모리 구현·에이전트 유형·하네스 구현은 후속 심화 편에서 연결한다.
모든 서비스명·수치·정책은 학습용 가상 예시다. 실제 운영 환경에서 배포하거나 성능을 측정한 결과는 아니다.
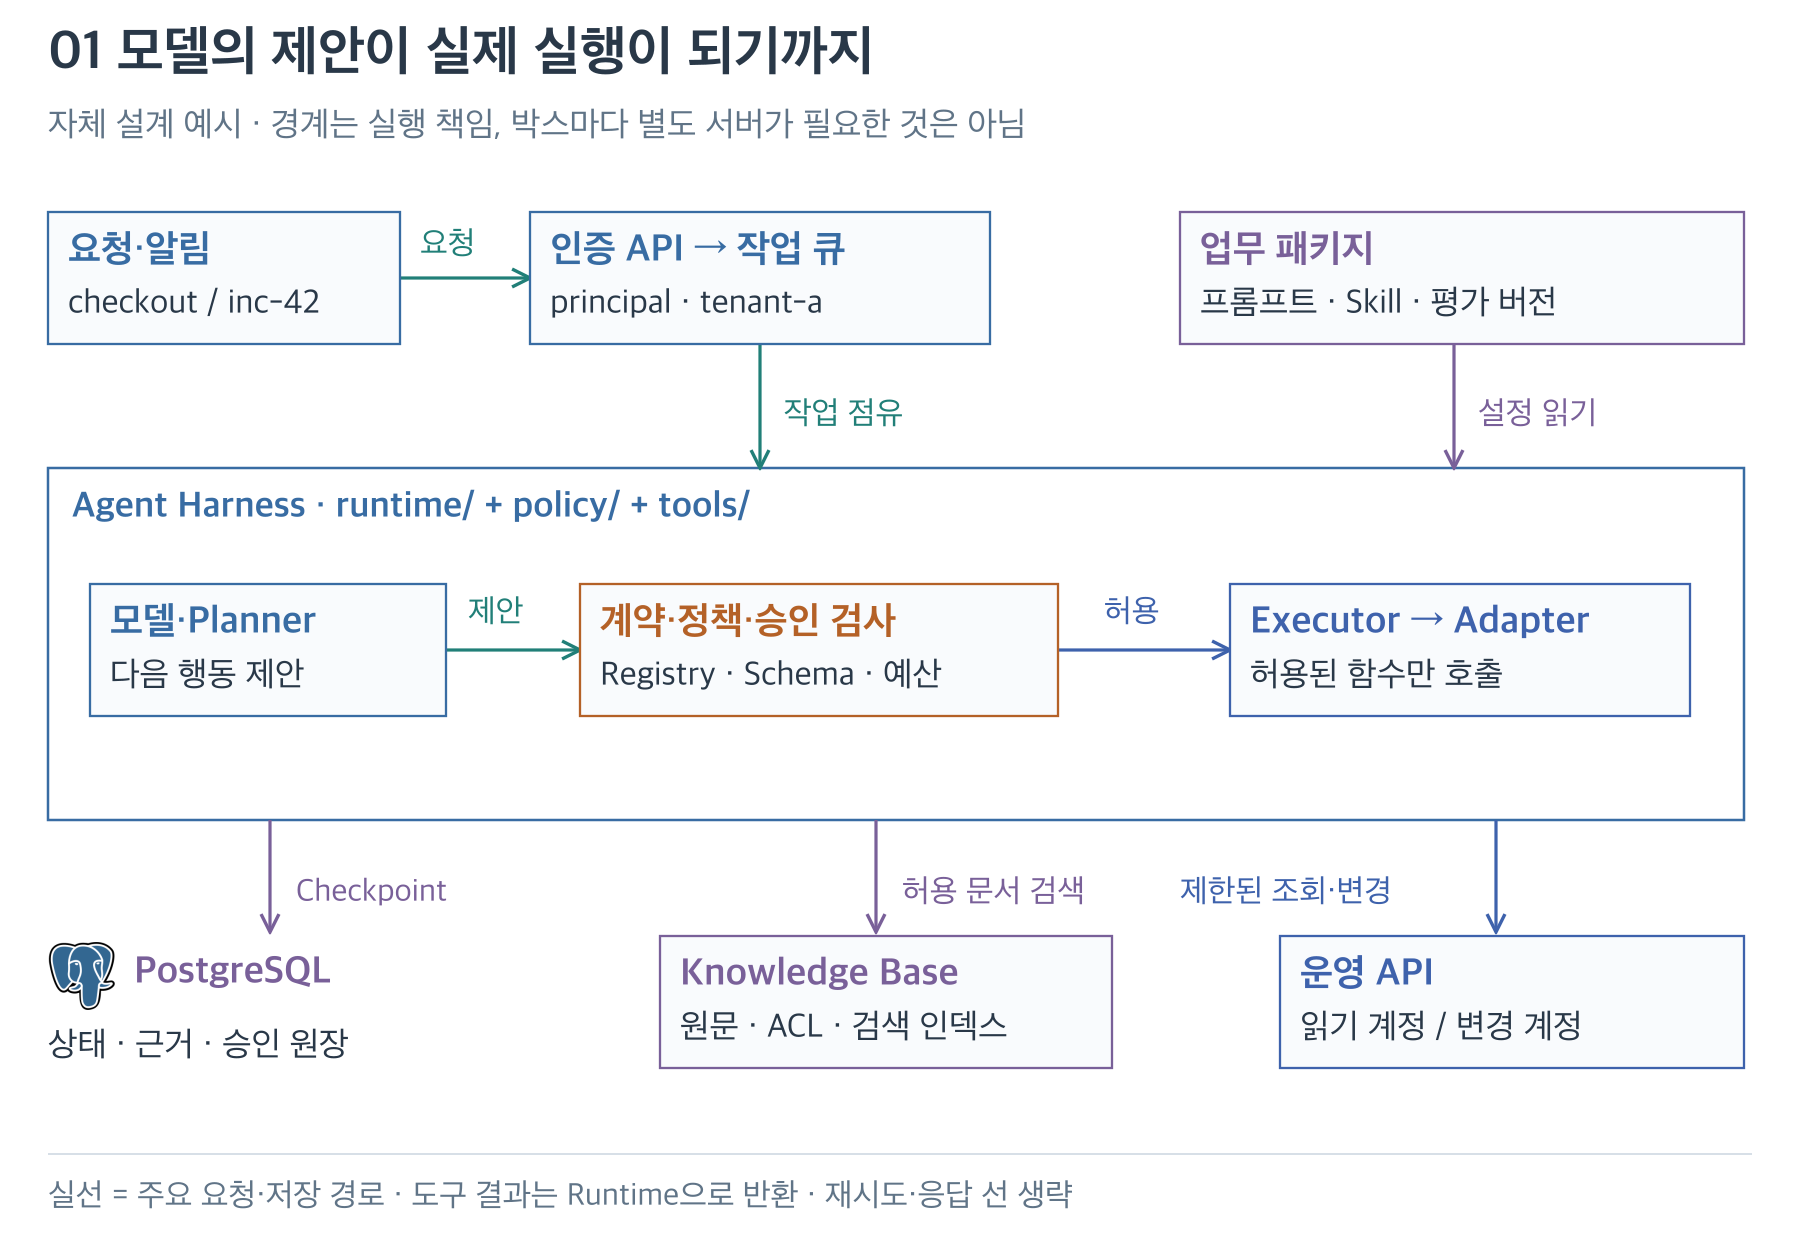
그림 1. 모델은 다음 행동을 제안하고, 하네스는 계약·정책·승인·예산을 검사한 뒤 허용된 도구만 호출한다. 아래에는 상태·근거·승인 원장, Knowledge Base, 운영 API를 나눴다. 실선은 주요 요청·저장 경로이며 결과 반환과 반복 선은 생략했다.
공통 장애 사례
tenant는 tenant-a, 장애 ID는 inc-42, 서비스는 checkout, 환경은 staging, 담당 팀은 team-a다. 분석 시간은 2026-10-04 01:00~01:10 UTC(한국시간 10:00~10:10)로 고정한다. 목표는 “왜 느린가?”를 곧바로 맞히는 것이 아니라 다음 네 질문에 답하는 것이다.
- 실제로 사용자 응답이 느려졌는가?
- 어떤 구간이 느리고, 어떤 증거가 있는가?
- 현재 후보를 반박하는 증거 또는 아직 없는 자료는 무엇인가?
- 사람이 다음에 확인하거나 승인할 일은 무엇인가?
설명을 위해 기준 p95는 0.3초, 현재 p95는 1.2초라고 가정한다. 4배 증가지만 원인을 알려 주는 숫자는 아니다. 트래픽 증가, DB 대기, 외부 API 지연, 배포 문제 모두 가능하다. 이 구분을 놓치면 Agent가 “이상 탐지”를 “원인 확정”으로 건너뛴다.
1. Agent와 Runtime
Agent는 목표와 현재 상태를 바탕으로 필요한 도구를 선택하고, 결과를 확인하며 다음 행동을 결정하는 시스템이다. Runtime은 그 과정의 실행·상태·제한·실패 처리를 맡는 프로그램이다.
LLM은 문맥을 입력받아 응답을 생성하는 모델이다. Tool Calling은 모델이 get_latency(service="checkout") 같은 구조화된 도구 호출 요청을 출력하는 기능이다.
외부 API 호출은 모델 자체가 아니라 애플리케이션이 수행한다. JSON 형식이 맞아도 서비스·시간 범위·권한이 올바르다는 뜻은 아니다. 사용자의 질문과 모델의 도구 요청 사이에는 실행 여부를 확인하는 프로그램이 필요하다.
| 구성 | 맡는 일 | 결제 서비스 조사 예시 |
|---|---|---|
| 입력 계약 | 요청의 범위 정의 | tenant, 환경, 서비스, 시작·종료 시각 |
| 모델 | 조사할 항목·가설·설명 생성 | DB 지연을 더 확인하자 |
| 도구 | 검증 가능한 데이터 조회 | 승인된 PromQL 실행 |
| 상태 | 이번 작업의 진행 상황 보관 | 완료한 조회, 증거 ID, 남은 예산 |
| 정책 | 허용되는 행동 판정 | production 변경은 승인 필요 |
| 검증기 | 결과의 형식과 근거 확인 | 모든 사실에 유효한 evidence_id가 있는가 |
프롬프트는 행동 지침이고, 권한은 실행 코드와 인프라가 강제하는 경계다. 이 구분이 전체 설계의 출발점이다.
1.1 도구 호출 흐름
모델에게 “checkout의 지연을 조사해 줘”라고 말해도 모델은 회사의 Prometheus 주소나 현재 지표를 저절로 알지 못한다. 개발자가 사용 가능한 도구의 설명과 입력 스키마를 전달해야 한다.
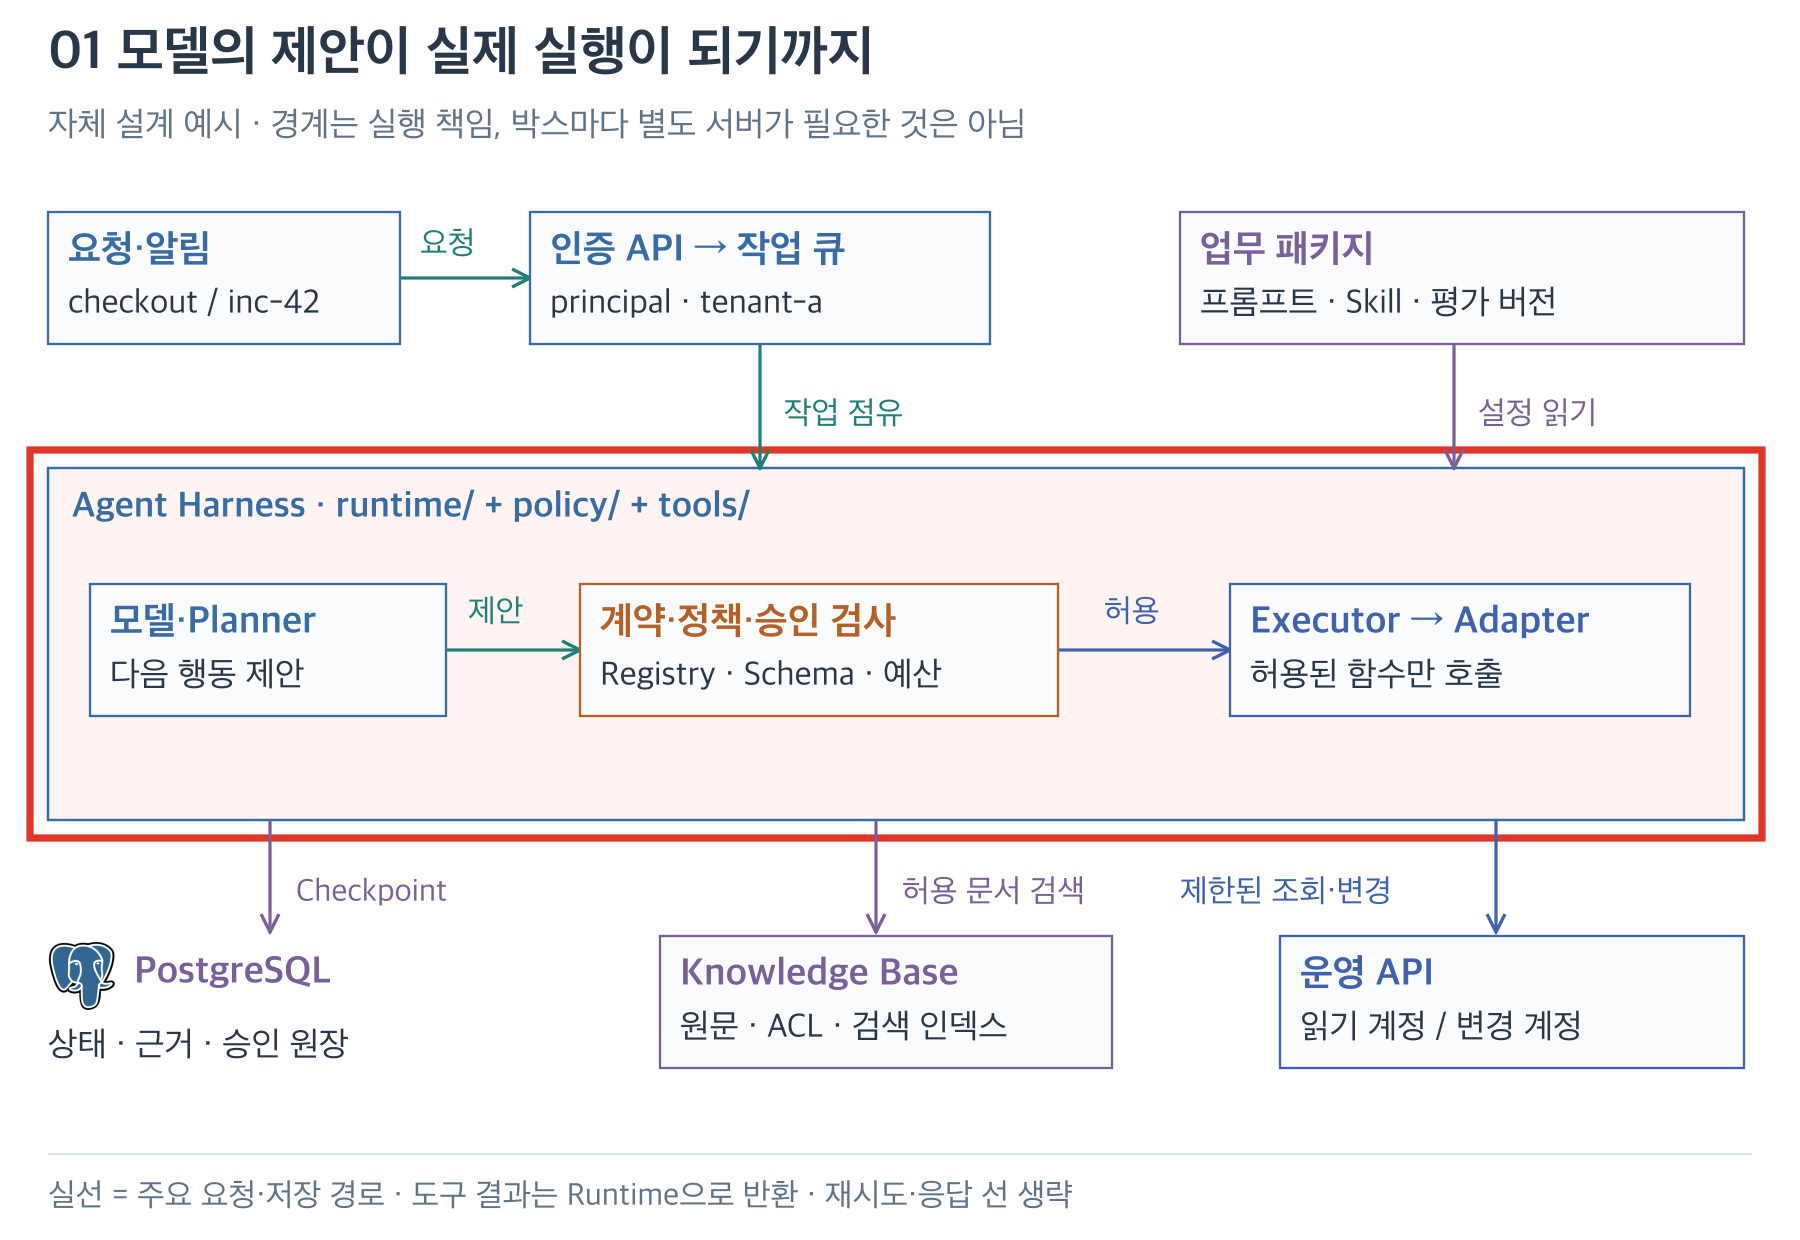
그림 2. 그림 1과 같은 배치에서 빨간 테두리가 하네스의 책임 범위를 강조한다. Registry에서 계약을 찾고 입력과 정책을 검사한 뒤 실행기로 넘긴다. 강조 영역은 오류 표시가 아니며, 모델이 운영 API를 직접 호출하는 우회 경로를 두지 않는다.
| 순서 | 전달되는 내용 | 누가 책임지는가 |
|---|---|---|
| 1 | 질문 + 조회 가능한 서비스 + 도구 목록 | API·Runtime |
| 2 | 도구 이름과 인자 선택 | 모델 |
| 3 | 서비스·기간·권한·예산 검증 | Runtime·정책 코드 |
| 4 | 고정 질의로 실제 백엔드 호출 | Adapter |
| 5 | 출처·시각을 포함한 증거 저장 | Evidence 계층 |
| 6 | 증거를 읽고 다음 조회 또는 보고서 선택 | 모델·검증기 |
예를 들어 2단계에서 모델이 24시간 조회를 요청해도 정책이 30분까지만 허용하면 3단계에서 거부한다. 프롬프트를 잘 썼는지와 무관하게 동작해야 한다. 반대로 도구가 timeout을 반환하면 모델은 수치가 없음을 보고해야 하며, 이전의 1.2초를 새 측정값처럼 사용하면 안 된다.
1.2 주요 개념의 관계
LLM은 설명을 만드는 모델이고, RAG는 질문과 관련된 자료를 검색해 모델 입력에 함께 제공하는 방법이다. Workflow는 실행 순서를 정하고, Agent는 그중 일부 다음 행동을 선택한다. 서로 대체 제품 네 개를 고르는 문제가 아니다.
하나의 고정 Workflow 안에서 RAG로 런북을 찾고 LLM으로 보고서를 작성할 수 있다. 여기에 “근거가 부족할 때 허용된 추가 도구를 선택”하는 단계가 생기면 Agent 성격이 커진다. Runbook(런북)은 특정 상황을 점검하고 대응하는 절차를 정리한 운영 문서다.
처음에는 도구 선택 없이도 개발할 것이 많다. 서비스 이름을 정확히 연결하고, 빈 결과를 구분하고, 보고서에 근거를 붙이는 작업이 끝나야 모델의 자유도가 실제 가치를 내는지 평가할 수 있다.
1.3 플랫폼 역할 매핑
전체 구성도에 큰 상자 다섯 개가 있다고 서버 다섯 개를 설치해야 하는 것은 아니다. 각 상자가 무엇을 보관하고 어떤 요청을 받는지부터 읽어 보자. 아래는 사용자 제공 학습 자료의 개념을 이 시리즈의 제안 구조에 대응시킨 표다. 특정 업체 제품의 내부 구현을 확인했다는 뜻은 아니다.
| 자료에 등장한 이름 | 이 글에서 이해할 역할 | inc-42에서 묻는 질문 |
|---|---|---|
| Copilot·Web·CLI | 사용자가 요청하고 결과를 보는 입구 | “checkout 지연을 조사해 줘” |
| OpsLake Provider | 운영 데이터에 접근하는 계층 | “그 시간에 어떤 신호가 있었나?” |
| Ops Knowledge Base | 검토된 운영 문서와 과거 사례 | “이 상황은 어떤 절차로 조사하나?” |
| RCA Agent | 현재 자료를 연결해 원인 후보 조사 | “현재 근거가 어떤 가설을 지지하나?” |
| Harness·Governance | 실행과 정책, 승인, 감사 관리 | “이 사용자가 이 도구를 호출해도 되나?” |
이 시리즈에서는 운영 신호를 Prometheus·Mimir, Loki, Tempo 등의 API로 조회하고 이를 Adapter로 감싼다. 기존 저장소를 모두 하나의 물리적 데이터 레이크로 합쳐야 하는 것은 아니다. 공통 서비스명·시간 범위·출처 계약으로 연결할 수 있다.
Knowledge Base에는 Runbook과 검토된 장애 기록을 둔다. 현재 장애의 임시 가설과 계획은 실행 상태에 둔다. 모델이 방금 쓴 “DB가 원인 같다”를 검토된 운영 지식으로 자동 저장하면 다음 장애에서도 같은 추측이 사실처럼 검색될 수 있다.
하네스(Harness)는 모델을 감싸는 실행 기반이다. 이 글의 Repository에서는 runtime/, policy/, tools/, 상태 저장과 검증기가 함께 그 역할을 한다. “운영 변경을 하지 말라”는 Markdown 지침은 판단에 도움을 주지만, 변경을 막는 실제 경계는 서버 정책과 인프라 권한이다.
MCP를 사용한다면 어느 클라이언트가 어떤 서버의 도구를 호출하는지도 그려야 한다. MCP 자체가 원인 분석가나 승인 담당자는 아니다. 자체 Runtime이 직접 Python 함수를 호출하는 첫 구현도 가능하며, 여러 클라이언트가 같은 도구를 공유할 때 표준 연결을 검토한다. MCP 아키텍처
2. Workflow 설계
Workflow는 개발자가 정한 순서와 분기를 실행하는 흐름이다. Agent는 일부 다음 단계를 모델이 고를 수 있어 자유도가 커진다.
첫 버전은 알림 정규화 → 지표 조회 → 로그 조회 → 변경 이력 조회 → 보고서 검증으로 고정해도 충분하다. 이 방식이면 필수 조회를 누락했는지, 어느 단계가 실패했는지 확인하기 쉽다.
예를 들어 “지표와 로그를 조사한 뒤 관련 Runbook을 더 찾을지”가 매번 달라진다면 그 부분만 모델에 위임한다. 전체 업무를 자율화하는 것보다 오류 위치와 추가된 가치를 비교하기 쉽다.
| 상황 | 시작할 구조 | 추가로 관리할 것 |
|---|---|---|
| 조회 순서와 보고서가 정해짐 | 고정 Workflow | 필수 조회 실패·출력 검증 |
| 중간 결과에 따라 다음 조회가 달라짐 | 제한된 도구 호출 루프 | 반복·시간·비용 한도 |
| 독립적인 대량 조사가 여러 개 | 선택적 하위 에이전트 | 위임 범위·결과 통합·권한 |
| 파일과 상태를 오래 유지하며 조사 | 장기 실행 하네스 검토 | 저장·재개·기본 도구 통제 |
Deep Agents도 마지막 요구를 해결하는 구현 후보다. 에이전트 종류의 우열 순위가 아니다. 유형별 장단점과 선택 기준은 6편에서 같은 장애 예제로 비교한다.
학습용 Runtime 의사코드는 다음과 같다. 완성된 SDK 예제나 보안 구현은 아니다.
state = create_run(authenticated_context, validated_request)
for step in range(MAX_STEPS):
    if state.deadline_exceeded() or state.cost_exceeded():
        break
    proposal = planner.choose_next(public_view(state))
    if proposal.kind == "finish":
        report = validate_report(proposal.report, state.evidence)
        return save_report(report)
    args = validate_tool_args(proposal)
    decision = policy.authorize(state.auth_context, proposal.tool, args)
    if not decision.allowed:
        state.record_denial(decision)
        return save_partial_report(state, reason="permission_denied")
    result = tools.call(proposal.tool, args, timeout=TOOL_TIMEOUT)
    state.add_evidence(normalize_and_redact(result))
    if state.deadline_exceeded() or state.cost_exceeded():
        break
return save_partial_report(state, reason="budget_exhausted")
위 의사코드는 권한 거절이 나면 같은 요청을 반복하지 않고 부분 보고서로 끝낸다. 정책이 명시적으로 허용한 다른 조회 경로를 제공할지는 별도로 설계한다.
실제 구현에서는 취소 전파, 체크포인트, 감사 기록, 오류 분류, 권한 재검증을 추가한다. 단계 제한에 걸렸을 때 정상 완료로 꾸미지 않고 partial 또는 needs_human으로 끝낸다. 고정 워크플로라면 위 planner 없이 정해진 함수를 호출하면 된다.
3. 학습 순서
프레임워크를 고르기 전에 API·데이터 계약·권한·관측의 기본기를 익힌다. 아래 순서는 각 주제를 이해했는지 작은 결과물로 확인하는 학습 경로다.
| 난이도 | 공부할 내용 | 이해했는지 확인할 결과물 |
|---|---|---|
| 기초 1 | Python 타입, 함수, 예외, pytest, HTTP·JSON | API 응답을 타입 모델로 검증 |
| 기초 2 | Linux, 컨테이너, Git, 환경변수, TLS | 로컬 API와 테스트 실행 |
| 기초 3 | 토큰·문맥 길이, 구조화 출력, Tool Calling | 잘못된 도구 인자 거부 |
| 기초 4 | RED 지표, SLI/SLO, 로그·트레이스 | 같은 장애를 세 신호로 설명 |
| 중급 | async, DB 트랜잭션, 큐, RAG, 체크포인트 | 워커 재시작 후 조사 재개 |
| 중급 | RBAC, 멀티테넌시, 인증·인가 | 다른 팀 데이터 접근 차단 |
| 고급 | 멱등성, 분산 잠금, 장애 격리, 평가 설계 | 중복 알림·부분 실패 재현 |
| 고급 | OTel, Langfuse, 회귀 평가, 점진 배포 | 변경 전후 품질·비용 비교 |
RED는 요청량(Rate), 오류(Errors), 소요 시간(Duration)을 보는 관점이다. SLI는 서비스 품질을 측정하는 지표, SLO는 그 지표의 목표다. CPU가 높다는 사실과 사용자가 결제를 못 한다는 영향은 다르므로, 자원 지표만 공부하지 말고 서비스 품질의 정의를 함께 공부한다.
4. Repository 구조
코드는 바뀌는 이유와 책임에 따라 나눈다. 아래는 Python 기반 단일 저장소의 제안 예시이며, 폴더마다 별도 서버를 만들라는 뜻은 아니다. 이 시리즈는 업무 패키지를 src/aiops_agent/skills/에 두지만 실행기의 로딩 설정에 따라 Markdown 자산을 별도 저장소나 다른 경로에 둘 수도 있다.
aiops-agent/
├── pyproject.toml              # 의존성 정의
├── uv.lock                    # 선택한 패키지 도구의 잠금 파일
├── .env.example               # 이름·예시만, 실제 비밀 없음
├── src/aiops_agent/
│   ├── api/                   # 인증, webhook, 요청 검증
│   ├── workflows/             # incident_triage 흐름
│   ├── runtime/               # 하네스 실행: 상태·예산·취소·dispatcher
│   ├── domain/                # Run, Evidence, Report, ActionPlan
│   ├── tools/                 # 도구 스키마와 registry
│   ├── adapters/              # Prometheus, Loki, Tempo, Git
│   ├── policy/                # tenant·resource·action 권한
│   ├── memory/                # checkpoint, 검토된 장기 기억
│   ├── knowledge/             # Runbook·장애 기록 검색, 출처·ACL
│   ├── observability/         # OTel, masking, 선택적 Langfuse
│   ├── prompts/               # 프롬프트와 출력 계약 버전
│   └── skills/                # 승인된 업무 절차·예시·참고 자료
├── migrations/                # DB 스키마 이력
├── evals/
│   ├── cases/                 # 비식별 고정 사례
│   ├── graders/               # 근거·정책·정답 평가
│   └── baselines/             # 비교 대상과 설정
├── tests/
│   ├── unit/                  # 상태·정책 단위 검증
│   ├── contract/              # 외부 API 응답 계약
│   └── integration/           # 큐·DB·도구 경계
├── deploy/                    # 로컬 compose, 필요 시 Helm
└── docs/ # ADR, 위협 모델, 운영 런북tools/는 모델이 볼 인터페이스이고 adapters/는 실제 API 연결 구현이다. 예를 들어 도구 이름이 get_latency_summary로 유지되면, 뒤에서 Prometheus를 Mimir로 바꾸더라도 워크플로 변경을 줄일 수 있다.
policy/를 프롬프트 폴더에 넣지 않는 이유는 정책이 실행 강제 로직이기 때문이다. 모델에 보이는 도구 목록을 줄여도 실제 호출에서 권한을 다시 검사해야 한다.
memory/는 “이번 실행을 어디까지 했나, 어떤 기억을 유지하나”를 담당하고, knowledge/는 “어떤 문서를 근거로 가져올 수 있나”를 담당한다. 같은 PostgreSQL을 사용해도 테이블·권한·보존 기간은 역할별로 나눌 수 있다.
evals/를 일반 테스트와 나누는 이유는 도구가 정상 동작하는 것과 보고서가 유용한 것이 서로 다른 품질이기 때문이다. 프롬프트·모델·도구 스키마·정책 버전을 실행 기록에 남겨야 품질 변화의 원인을 찾을 수 있다.
4.1 요청 처리 경로
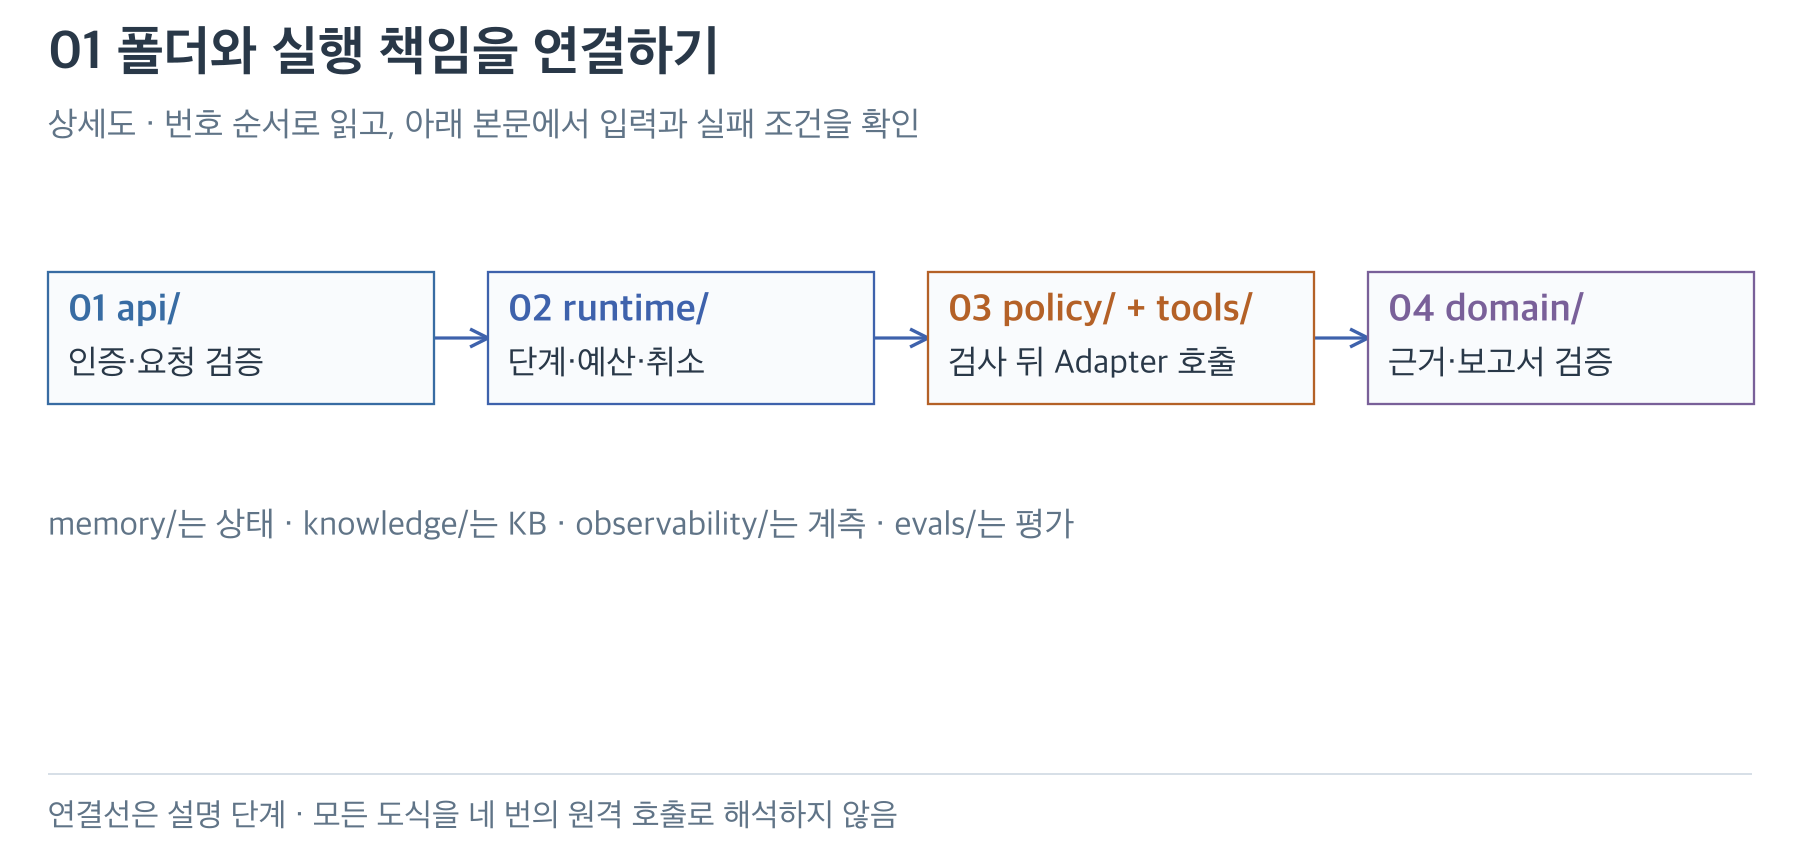
그림 3. 왼쪽부터 인증·요청 검증, 단계·예산·취소, 정책 검사 뒤 Adapter 호출, 근거·보고서 검증을 읽는다. 폴더는 src/aiops_agent/ 아래의 논리적 책임이며, 화살표가 반드시 네 번의 원격 호출을 뜻하지는 않는다.
가령 Prometheus 인증 방식이 바뀌면 adapters/prometheus.py를 수정한다. 사용자별 허용 서비스가 바뀌면 policy/authorize.py를 바꾼다. 보고서 문체를 바꾸려면 prompts/triage.md를 바꾼다. 세 변경이 한 파일에 뒤섞이면 보안 변경이 프롬프트 수정처럼 배포되거나, 테스트하기 어려운 거대한 함수가 생기기 쉽다.
의존성의 방향도 정한다. domain/의 Evidence는 Grafana SDK를 몰라도 표현할 수 있어야 한다. Adapter가 외부 응답을 Evidence로 바꾸고, Workflow는 그 공통 계약만 읽는다. 외부 API를 호출하지 않는 fake adapter로 Workflow를 시험할 수 있게 만드는 것이 분리의 실질적인 이득이다.
실제 요청의 통과 순서는 api → workflows/runtime → policy → tools/adapters → evidence 저장 → 검증/보고다. 메모리는 Runtime이 상태를 읽고 쓸 때, Knowledge Base는 검색 Tool이 승인된 문서를 가져올 때 연결된다. 메모리와 지식 저장소가 모델 바깥의 서버 경계에 있다는 점을 기억하면 배치가 쉬워진다.
작은 MVP에서는 domain.py, policy.py, tools.py, workflow.py 네 파일로 시작해도 된다. 기능이 자랄 때 위 폴더로 분리한다. 처음부터 Kafka·Vector DB·여러 마이크로서비스를 의무적으로 추가하지 않는다.
5. 근거 데이터 계약
Evidence는 도구가 관측한 결과와 출처·시각·범위를 묶은 증거 레코드다.
{
  "evidence_id": "ev-001",
  "source": "prometheus",
  "service": "checkout",
  "environment": "staging",
  "window": {"start": "2026-10-04T01:00:00Z", "end": "2026-10-04T01:10:00Z"},
  "query_template": "latency_p95_v1",
  "unit": "seconds",
  "status": "ok",
  "value": 1.2,
  "fetched_at": "2026-10-04T01:10:05Z"
}1.2는 가상의 설명용 값이다. 실제 계약에는 tenant, cluster, 데이터 최신 시각, 샘플 수, 잘림 여부, 원문 참조, 질의 버전도 포함한다. fetched_at은 조회 시각일 뿐 데이터가 최신이라는 증명이 아니다.
보고서는 관측 사실 → 원인 후보 → 반증·누락 → 다음 조사 순서로 만든다. “배포 직후 지연 증가”는 사실일 수 있지만 “배포가 원인”은 추가 검증이 필요한 가설이다. 모델이 임의로 붙인 95% 확신도를 실제 원인 확률처럼 보여 주지 않는다.
5.1 근거 검증 실습
다음 코드는 Python 3.9.6에서 실제 실행 확인한 예제다. 이번 개정에서는 격리 경계의 예시 이름을 tenant-a/b로 통일하고 다시 실행해 같은 결과를 확인했다. 표준 라이브러리만 사용하며 API 키·LLM·Grafana 설치가 필요 없다. evidence_lab.py로 저장해 python3 evidence_lab.py를 실행한다. 원격 시스템 연동이 아니라 증거 검증 규칙을 익히는 실습이다.
"""Python 표준 라이브러리 실습: 외부 API·LLM 호출 없음."""
from __future__ import annotations
from dataclasses import dataclass
from datetime import datetime

@dataclass(frozen=True)
class Scope:
    tenant: str
    service: str
    environment: str
    start: str
    end: str

@dataclass(frozen=True)
class Evidence:
    id: str
    scope: Scope
    status: str
    value: float | None
    unit: str
    observed_at: str


def validate(request: Scope, evidence: Evidence) -> str:
    if evidence.scope != request:
        return "rejected: scope_mismatch"
    if evidence.status != "ok":
        return f"partial: {evidence.status}"
    if evidence.unit != "seconds" or evidence.value is None:
        return "rejected: invalid_value_or_unit"
    age = (datetime.fromisoformat(request.end) -
           datetime.fromisoformat(evidence.observed_at)).total_seconds()
    if not 0 <= age <= 60:
        return "partial: stale_or_future_sample"
    return f"observed: p95={evidence.value:.1f}s [{evidence.id}]"

scope = Scope("tenant-a", "checkout", "staging",
              "2026-10-04T01:00:00+00:00", "2026-10-04T01:10:00+00:00")
other = Scope("tenant-b", "checkout", "staging", scope.start, scope.end)
cases = [
    Evidence("ev-1", scope, "ok", 1.2, "seconds", "2026-10-04T01:09:50+00:00"),
    Evidence("ev-2", scope, "no_data", None, "seconds", scope.end),
    Evidence("ev-3", other, "ok", 1.2, "seconds", scope.end),
    Evidence("ev-4", scope, "ok", 1.2, "seconds", "2026-10-04T01:05:00+00:00"),
]
for case in cases:
    print(validate(scope, case))
실행 결과:
observed: p95=1.2s [ev-1]
partial: no_data
rejected: scope_mismatch
partial: stale_or_future_sample
첫 결과만 해당 요청 범위의 최신 관측으로 받아들였다. 두 번째는 데이터가 없어서 보류했고, 세 번째는 다른 tenant의 데이터라 거부했다. 네 번째는 최신 샘플이 분석 종료 시각보다 5분 오래되어 보류했다. 여기서 신선도 60초는 설명용 정책이다.
observed_at은 최신 원본 샘플 시각이어야 한다. Adapter가 현재 서버 시각을 넣으면 오래된 데이터도 새 데이터처럼 통과한다. 또한 이 간단한 함수는 숫자의 유한성, timezone 유효성, 샘플 완전성, 권한 DB 조회까지 검증하지 않는다. Production에서는 별도로 추가한다. 검증기가 있다고 보안 전체가 완성된 것은 아니며, 검증할 범위를 명시하는 것이 중요하다.
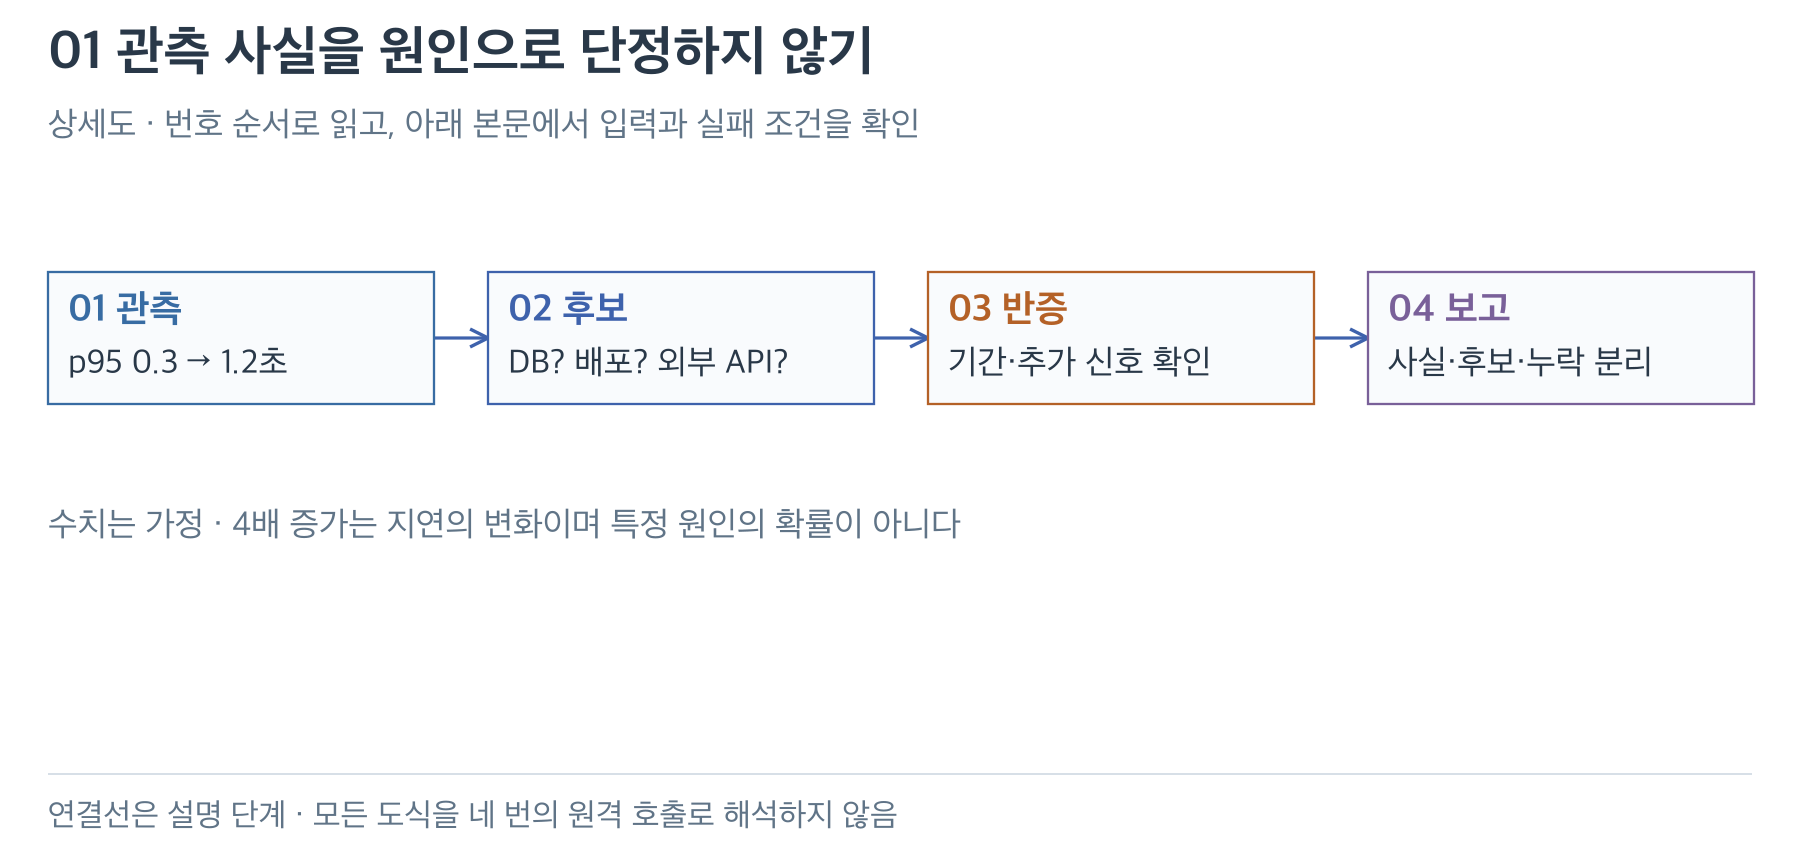
그림 4. 가정한 p95 변화는 0.3초에서 1.2초다. 4배라는 지연 변화만으로 DB를 원인으로 확정하지 않고, 후보별 추가 신호와 반증을 확인한 만큼만 결론을 말한다.
6. MVP 완료 기준
입력은 알림 하나, 대상은 staging 서비스 하나, 도구는 읽기 전용 3개로 제한한다. 출력은 근거 링크가 달린 조사 보고서다. 자동 재시작·롤백은 후속 단계다.
성공 사례뿐 아니라 빈 데이터, 시간 초과, 다른 tenant 요청, 잘못된 서비스명도 처리해야 한다. 사람에게 기존 대시보드를 열어 보라고 안내하는 것에서 끝나지 않고, 어떤 기간의 어떤 쿼리를 보고 무엇을 확인했는지 남겨야 조사 시간을 줄일 수 있다.
프레임워크는 이 작은 흐름을 구현한 뒤 선택한다. 단순 흐름은 일반 Python으로도 충분하다. 중단·승인·재개가 중요한 시점에는 LangGraph 같은 상태 중심 도구를 검토한다. LangGraph의 체크포인트는 상태 저장을 제공하지만 업무 권한과 외부 API의 중복 실행까지 자동 해결하지는 않는다. LangGraph Persistence
자료 기준: 2026-10-04. 표준 라이브러리 실습은 tenant 이름을 통일해 다시 실행했고, 개념과 Repository의 책임 분리를 보강했다. SDK·운영 환경을 새로 실행한 것은 아니다. 본문에 연결한 공식 문서의 해당 범위만 참고했으며 모든 버전의 전체 동작을 검증한 것은 아니다. 아키텍처와 저장소는 학습용 제안이다.
심화 학습 연결 · 5편은 메모리·Knowledge Base를 어디에 어떻게 저장하는지, 6편은 Workflow부터 Deep Agents까지 어떤 유형을 고르는지, 7편은 하네스·도구·승인·거버넌스를 어떤 코드로 강제하는지 다룬다. 아래 시리즈 목록에서 원하는 구현 주제로 이어 읽을 수 있다.
함께 읽기: 기존 AIOps 시리즈 · Prometheus HTTP API
추가 그림 자산 출처
PostgreSQL 로고는 공식 자산의 색과 비율을 유지해 사용했다. PostgreSQL과 Slonik은 PostgreSQL Community Association of Canada의 상표 또는 등록 상표이며, 상표 정책에 따른 제품 식별이다. 공식 후원·제휴를 뜻하지 않는다.
AIOps 에이전트 개발 시리즈
