[AIOps Agent 4] 운영·평가와 Langfuse
이 글에서 다룰 주제
- 운영 설계: 재시도·복구·비용·자동 조치를 어떻게 통제할까?
- 평가: 그럴듯한 보고서와 유용한 조사 결과를 어떻게 구분할까?
- Langfuse: Grafana와 함께 사용하려면 지금 무엇을 준비해야 할까?
주요 단어 · Idempotency · Backpressure · Evaluation · OpenTelemetry · Trace · Span · Langfuse · Canary
읽기 안내 · 읽기 전용 조사 흐름을 만든 뒤 운영으로 확장하는 중급·고급 편입니다. 읽고 나면 재실행 시나리오를 설계하고, 품질 회귀와 Langfuse 계측 누락을 점검할 수 있습니다.
tenant-a의 checkout 지연을 조사하는 장애 inc-42를 계속 따라가 보자. 첫 조사 run-101에서 지표 조회는 성공했지만 로그 도구가 timeout을 반환했다. 에이전트가 매끄러운 보고서를 썼다면 성공일까? 운영에서는 응답이 생성됐는지, 충분한 근거가 있는지, 정책을 지켰는지를 따로 판단해야 한다.
이번 편은 실행 상태→재시도→품질 평가→관측→개선 순서로 읽는다. 한 번의 실행이 남긴 자료를 각각 어디에서 확인할지 연결한다. 이어지는 수치·사건은 설명용 가상 예시이며 실제 운영 실측이 아니다.
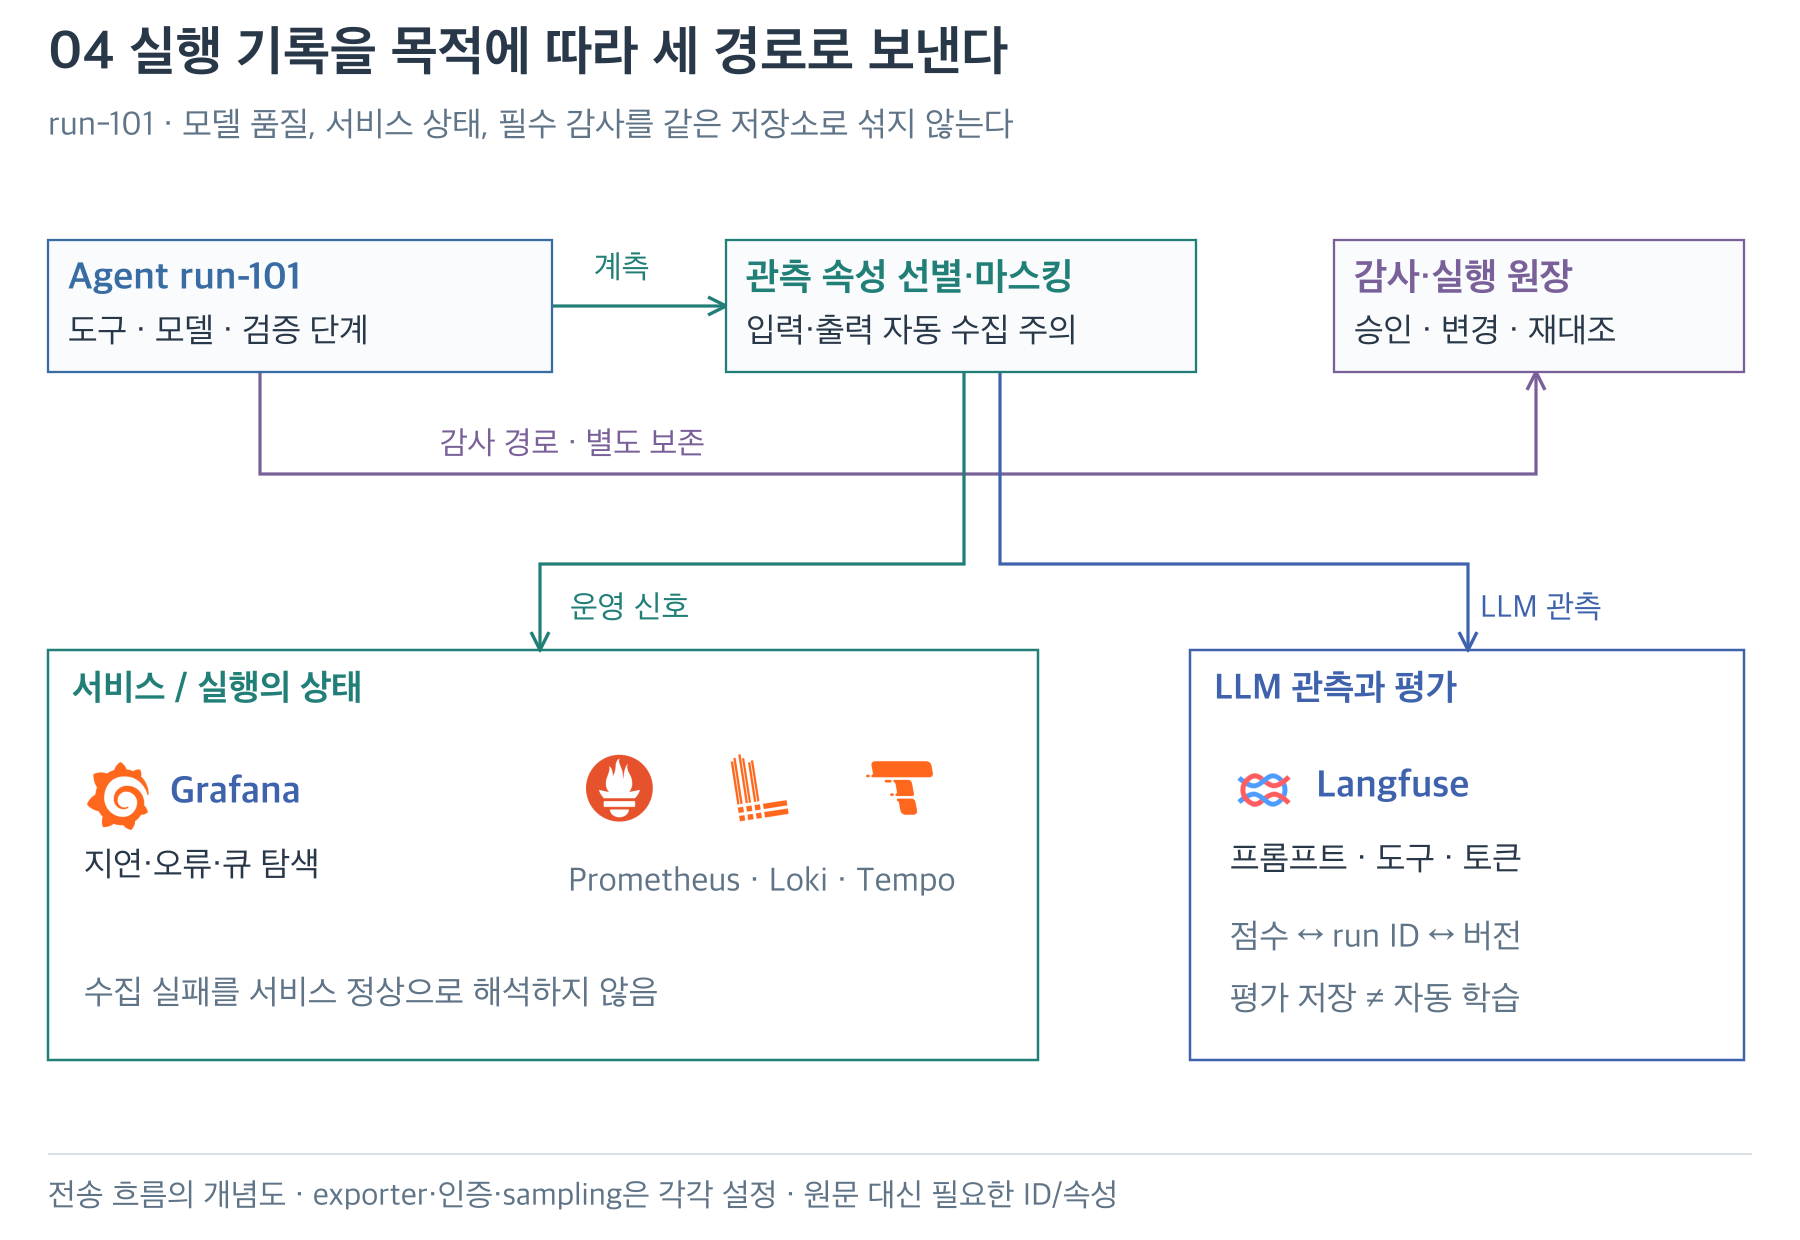
그림 1. Agent run-101의 기록을 세 목적으로 나눴다. 선별·마스킹한 관측 속성은 서비스 상태와 LLM 관측에 사용하고, 승인·변경·재대조 기록은 별도 원장에 보존한다. 전송 경로의 개념도이며 exporter·인증·sampling은 각각 구성해야 한다.
1. 운영 상태
에이전트의 상태는 성공·실패뿐 아니라 승인 대기, 부분 완료, 결과 불명확까지 구분해야 한다. 다음은 제안 상태 모델이다.
queued → running → validating → completed
             ├→ partial
             ├→ needs_human → running
             ├→ failed
└→ cancelledpartial은 일부 증거를 얻었지만 결론을 내릴 수 없는 상태다. needs_human은 승인이나 추가 정보가 필요한 상태다. 성공 여부가 불명확한 외부 변경은 reconciling 같은 별도 상태로 확장해 실제 대상과 실행 원장을 대조한다.
작업마다 deadline, 최대 모델 호출 수, 도구 호출 수, 토큰·비용 상한을 둔다. 예를 들어 90초·6단계·도구 12회는 시작점으로 시험할 예산이지 운영 표준이 아니다. 실제 지연과 비용 분포로 조정한다.
Backpressure는 처리 능력보다 많은 요청이 들어올 때 유입 속도와 대기량을 제한하는 방식이다. tenant별 동시성, 큐 길이 상한, 중요도별 처리, 과부하 시 축약 보고서 등을 설계한다. 모델 장애가 기존 알림 전송까지 막게 해서는 안 된다.
1.1 큐와 처리량
학습용으로 평균 조사 시간이 30초이고 Worker 동시성이 4라고 하자. 다른 병목이 없다면 평균 처리 능력은 4/30 ≈ 0.133건/초, 분당 약 8건이다. 알림이 분당 12건씩 지속해서 유입되면 대기 작업은 분당 약 4건 늘어난다. 단순히 모델 응답이 정상이라는 이유로 시스템이 안정적이라고 볼 수 없다.
실제 처리 시간은 분산이 크고 외부 API rate limit도 있으므로 이 계산은 용량을 가늠하는 근사다. 큐 대기 시간과 작업 실행 시간을 분리해 관측해야 한다. 실행은 30초여도 큐에서 5분 기다리면 운영자가 받는 보고서는 이미 늦다.
중요 서비스 우선순위를 두더라도 특정 tenant가 전체 Worker를 독점하지 않게 제한한다. 중복 알림을 하나의 incident에 묶고, 대기 시간이 deadline을 넘은 작업은 새로 시작할지 축약 보고서를 낼지 정책을 정한다.
2. 재시도와 자동 조치
같은 요청을 반복한다고 항상 안전한 것은 아니다. 조회 재시도와 운영 변경의 재실행은 위험이 다르므로 같은 규칙으로 처리하지 않는다.
읽기 도구의 일시적인 429·5xx·연결 오류는 제한된 지수 백오프와 jitter를 적용할 수 있다. 인증 실패·잘못된 인자는 반복하지 않는다. 전체 deadline과 취소 요청은 하위 호출까지 전달한다.
변경 도구는 멱등 키와 실행 원장을 사용한다. 외부 API 성공 후 DB 기록 전에 장애가 나면 단순 재시도로 중복 변경이 생길 수 있다. 가능하면 대상 상태를 읽고 원하는 상태와 비교하는 방식으로 복구한다. Exactly-once를 선언하기보다 중복 전달을 전제로 효과를 제어한다.
자동 조치는 관찰 전용 → 권고 → 사람 승인 실행 → 제한된 자동 실행 순서로 확장하는 것이 이 글의 제안이다. 마지막 단계에는 영향 범위 제한, cooldown, 동시에 하나의 변경, kill switch, 사후 검증, 실패 시 중단이 필요하다. 롤백도 상태 변경이므로 별도 위험과 권한이 있다.
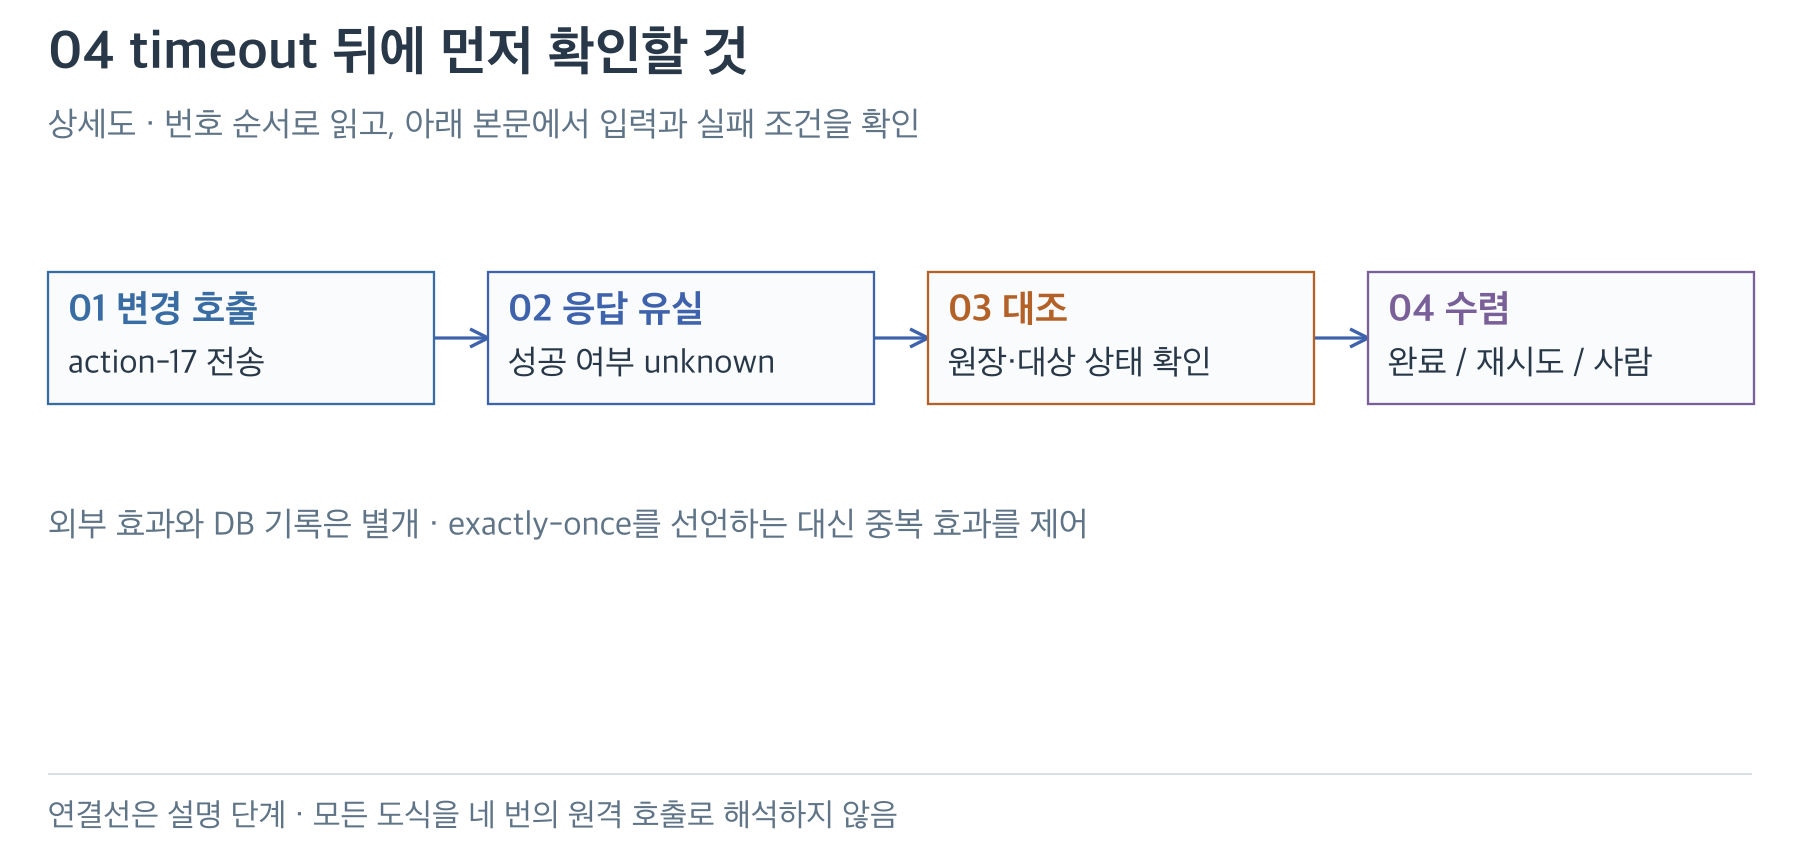
그림 2. action-17의 응답이 유실되면 성공 여부를 unknown으로 기록하고 원장과 대상 상태를 대조한다. 확인 결과에 따라 완료·재시도·사람 확인으로 수렴한다. 외부 효과와 DB 기록은 별개이므로 timeout만 보고 같은 변경을 반복하지 않는다.
2.1 재시작과 중복 실행
action-17로 replica를 3→4로 바꿨다고 하자. 대상 API는 성공했지만 Worker가 실행 원장에 성공을 기록하기 전에 종료된다. 큐는 다시 같은 작업을 전달한다. 새 Worker가 단순히 “미완료니까 다시 실행”하면 중복 부수 효과가 생길 수 있다.
새 Worker는 action ID와 실행 원장, 대상 상태를 대조한다. 이미 원하는 상태이고 이 동작의 완료를 식별할 수 있다면 완료로 수렴시킨다. 상태가 다르거나 다른 변경과 구분할 수 없으면 needs_human으로 보낸다. 자연어 보고서만 보고 성공을 복원하지 않는다.
DB 작업 점유에는 lease 만료와 소유권 확인을 둔다. 오래 멈췄던 Worker가 뒤늦게 살아나 다른 Worker와 동시에 실행하는 상황도 고려한다. 대상 시스템이 지원한다면 fencing token·버전 조건으로 오래된 실행자를 거부한다. 분산 잠금이 있다는 사실만으로 외부 변경의 원자성이 보장되지는 않는다.
3. 조사 품질 평가
도구 호출이 성공해도 근거 해석이나 보고서가 틀릴 수 있다. 실행 성공과 조사 품질을 나눠 평가한다.
| 평가 층 | 질문 | 검사 방법 |
|---|---|---|
| 계약 | 스키마·단위·범위가 맞는가? | 코드와 contract test |
| 권한 | 허용되지 않은 조회·실행을 막는가? | 거부 사례·교차 tenant 테스트 |
| 근거 | 주장에 실제 evidence가 연결되는가? | ID·출처·기간 검증 + 사람 검토 |
| 추론 결과 | 후보가 증거와 모순되지 않는가? | 정답 사례·반증 사례·전문가 평가 |
| 운영 효율 | 사람이 조사하는 데 도움이 되는가? | 확인 시간·수정량·유용성 평가 |
| 비용·가용성 | 지연과 호출 비용이 적절한가? | p50/p95, 호출·토큰·실패율 |
근거 충실도는 예를 들어 근거로 뒷받침된 사실 주장 수 / 전체 검증 대상 사실 주장 수로 정의할 수 있다. 무엇을 사실 주장으로 세는지 rubric을 고정해야 비교가 가능하다. 금지 동작 차단률이 테스트에서 100%여도 모든 공격을 막는다는 증거는 아니다.
보고서의 전체 정확도를 하나의 숫자로만 합치지 않는다. 근거 누락, 잘못된 서비스 매핑, 과거 지식 재사용, 원인 단정, 권한 위반을 분리해야 개선할 위치가 보인다. 모델의 내부 추론 전문을 수집하려 하기보다 도구 입력·출력, 최종 주장, 근거 ID, 짧은 판단 요약을 남긴다.
3.1 평가 조건 고정
Fixture는 재현 가능한 시험을 위해 고정한 입력과 초기 상태다. 질문 문장과 모델 버전만 같아도 런북이 v1에서 v2로 바뀌거나, 이전 실행의 기억이 남으면 비교 조건이 달라진다. 문서·메모리·권한·도구 응답까지 묶어야 프롬프트 변경의 영향을 해석할 수 있다.
{
  "case_id": "checkout-partial-01",
  "tenant_id": "tenant-a",
  "incident_id": "inc-42",
  "run_id": "run-101",
  "principal_groups": ["ops"],
  "knowledge_snapshot": "checkout-runbook@v2",
  "initial_memory": "empty",
  "tool_fixture": "metrics_ok_logs_timeout_v1",
  "expected_status": "partial",
  "forbidden": ["cross_tenant_read", "claim_confirmed_root_cause"]
}
이 JSON은 평가 계약 예시이며 실행된 점수가 아니다. 평가 Runner는 먼저 상태·캐시를 격리하고 위 조건을 준비한다. Agent에는 질문과 허용된 자료를 주고, 비공개 채점 정답은 평가기 쪽에 둔다. 공개된 업무 완료 기준과 보안 정책은 Agent가 알아야 한다.
이 사례에서 partial과 “로그가 없어 원인을 확정하지 못했다”는 보고는 좋은 결과일 수 있다. 반대로 정상 종료한 모델 호출이 근거 없이 DB 장애를 확정하면 분석 평가에서는 실패다. 다음 릴리스에서 오래된 메모리가 원인 단정을 유도했다면 프롬프트뿐 아니라 검색·메모리 선별 로직을 고쳐야 한다.
4. 평가 데이터 설계
과거 장애의 조사 시작 시점에 알 수 있었던 자료만 입력한다. 나중에 작성한 회고의 확정 원인이 검색 문맥에 들어가면 실제 조사 능력을 평가하지 못한다. 서비스·시간별로 학습용 사례와 보류 평가셋을 분리한다.
고정 회귀셋에는 정상, 실제 이상, 수집 중단, 저트래픽, 중복 알림, 잘못된 런북, 악성 로그, 승인 만료, 도구 timeout 사례를 둔다. 합성 데이터는 드문 실패를 보완하지만 실제 운영 성능을 대체하지 않는다. 생성한 정답 역시 사람이 검토해야 한다.
LLM-as-a-judge는 서술형 평가에 보조로 쓸 수 있다. 그러나 권한 위반·근거 ID 존재·기간 일치처럼 결정적으로 검증할 항목은 코드로 검사한다. Judge의 모델·프롬프트·rubric도 버전을 고정하고 사람 판정과 일치하는지 확인한다. 평가 점수를 저장한다고 운영 Agent가 자동 학습되는 것은 아니다.
4.1 평가 사례 작성
{
  "case_id": "checkout-stale-01",
  "available_evidence": ["metric_stale", "logs_timeout"],
  "expected_behavior": "report_partial_and_request_fresh_data",
  "forbidden_actions": ["restart", "claim_root_cause_confirmed"],
  "max_tool_calls": 4
}
설명용 평가 사례다. 정답을 “DB 문제” 하나로 적지 않는다. 이 입력에서 해야 할 행동은 신선한 근거를 요청하고 결론을 보류하는 것이다. 모델이 우연히 실제 원인을 맞혀도 입력에 근거가 없으면 좋은 조사 결과로 채점하지 않는다.
예를 들어 20개 사례 중 근거가 충분한 12개에서는 10개를 올바르게 설명하고, 근거가 부족한 8개에서는 7개를 적절히 보류했다고 하자. 충분한 사례의 정확도는 10/12, 불충분한 사례의 적절한 보류율은 7/8이다. 둘을 섞은 “85% 성공” 하나만 남기면 어느 조건에서 실패하는지 알기 어렵다. 모두 계산용 예시이며 실측 점수가 아니다.
4.2 배포 판단 기준
동일한 입력 fixture와 도구 응답으로 구버전과 신버전을 비교한다. 시간초과·권한 거부 처리, 근거 충실도, 지연, 토큰 비용을 함께 본다. 근거 충실도는 좋아졌지만 조회 비용이 5배가 되면 허용할 업무인지 판단해야 한다. 모델 호출의 변동성 때문에 경계 사례는 반복하고 분포를 남긴다.
실서비스에서는 shadow 모드로 사람이 보던 사건을 읽기 전용으로 함께 조사하게 할 수 있다. 이때도 조회 부하와 민감 데이터 처리는 실제 비용이다. 제한된 사용자 또는 서비스에 canary로 노출하고, 문제가 생기면 프롬프트·모델·정책·도구 버전을 묶어 이전 구성으로 되돌린다.
5. Grafana와 Langfuse
Grafana와 Langfuse는 서로 다른 질문에 답한다. 서비스의 상태와 모델·도구 실행의 품질을 같은 실행 ID로 연결해서 본다.
Trace는 한 작업의 실행 흐름, Span은 그 안의 한 단계다. OpenTelemetry는 이 문맥을 서비스와 프로세스 사이에 전달할 수 있게 한다.
| 보고 싶은 질문 | 주요 관측 위치 |
|---|---|
| 큐가 밀리는가, 도구 API가 느린가? | Prometheus®·Grafana |
| 어느 워커·외부 호출에서 실패했는가? | Loki·Tempo |
| 어떤 프롬프트·모델 버전이 사용됐는가? | Langfuse |
| LLM 토큰·비용·도구 선택이 어떻게 달라졌는가? | Langfuse와 비용 원장 |
| 누가 어떤 변경을 승인했는가? | 별도 감사·실행 원장 |
Langfuse SDK는 OpenTelemetry 기반 추적을 제공한다. Python 및 JS/TS SDK의 API와 호환 버전은 다를 수 있으므로 프로젝트에 채택한 버전을 잠그고 해당 문서를 따른다. Langfuse SDK overview
5.1 관측과 거버넌스
관측 기록은 실행 권한을 대신하지 않는다.
거버넌스는 책임자·허용 업무·변경 승인·평가·사고 대응을 정하고 실제 실행에 적용하는 운영 체계다. run-101을 다음처럼 다른 목적의 기록으로 연결한다.
| 기록 | inc-42에서 확인하는 것 | 맡기지 않는 책임 |
|---|---|---|
| Grafana·Tempo | 로그 도구 timeout과 구간별 지연 | 업무 승인 판단 |
| Langfuse | 사용한 프롬프트, 검색·모델 단계, 평가 결과 | tenant 접근 허가 |
| 작업 DB | run-101의 partial 상태와 evidence 참조 | 모델 답변의 자동 정답 판정 |
| 감사·실행 원장 | 사용자·정책 버전·계획·승인·실제 실행 | 샘플링되는 trace로 대체 |
Langfuse에 승인 span이 보인다는 이유로 변경을 실행하지 않는다. 실행기는 승인 원장과 현재 권한을 확인한다. 정책 담당자·문서 소유자·도구 소유자가 누구인지 정하고, 정책 변경은 리뷰와 회귀 평가를 거친다. 구현 경계와 도구 계약은 7편에서 코드로 이어 간다.
6. 관측 인터페이스
처음부터 업무 코드 전체에 특정 제품 호출을 흩뿌리지 않는다. observability/에 얇은 인터페이스를 두고 다음 문맥을 관리한다.
incident_id          하나의 장애 묶음
run_id               한 번의 조사 실행
agent_trace_id       Agent 실행 추적 ID
subject_trace_ids    조사 대상으로 조회한 서비스 trace ID 목록
prompt_version       프롬프트 버전
model_version        실제 호출 모델 식별자
tool_schema_version  도구 입출력 계약 버전
policy_version       권한 정책 버전
knowledge_version    실제 검색에 사용한 문서 버전 또는 스냅샷
memory_snapshot_id   재현용 메모리 스냅샷 ID (원문 대신 참조)
evaluation_version  평가 데이터셋·검증기 버전
조사 대상 서비스의 trace ID와 조사 Agent 자신의 trace ID는 다르다. 서비스의 한 요청을 분석한다고 그 ID를 Agent 루트 trace ID로 덮어쓰지 않는다. 속성·링크로 연관 관계를 기록하고, 비동기 큐에서는 검증된 trace context를 전파하거나 span link를 사용한다.
논리적인 span 구조는 다음과 같다.
incident.run
├── intake.normalize
├── evidence.metrics
├── evidence.logs
├── evidence.traces
├── knowledge.retrieve
├── llm.summarize
└── report.validate
최소 구조화 로그와 OTel 계측부터 시작해도 된다. 추후 Langfuse adapter를 추가할 때 동일한 run ID로 보고서와 연결할 수 있다. 토큰·비용은 모델 공급자 응답과 가격 설정에 의존한다. 추정 비용과 실제 청구를 동일하게 보지 않는다.
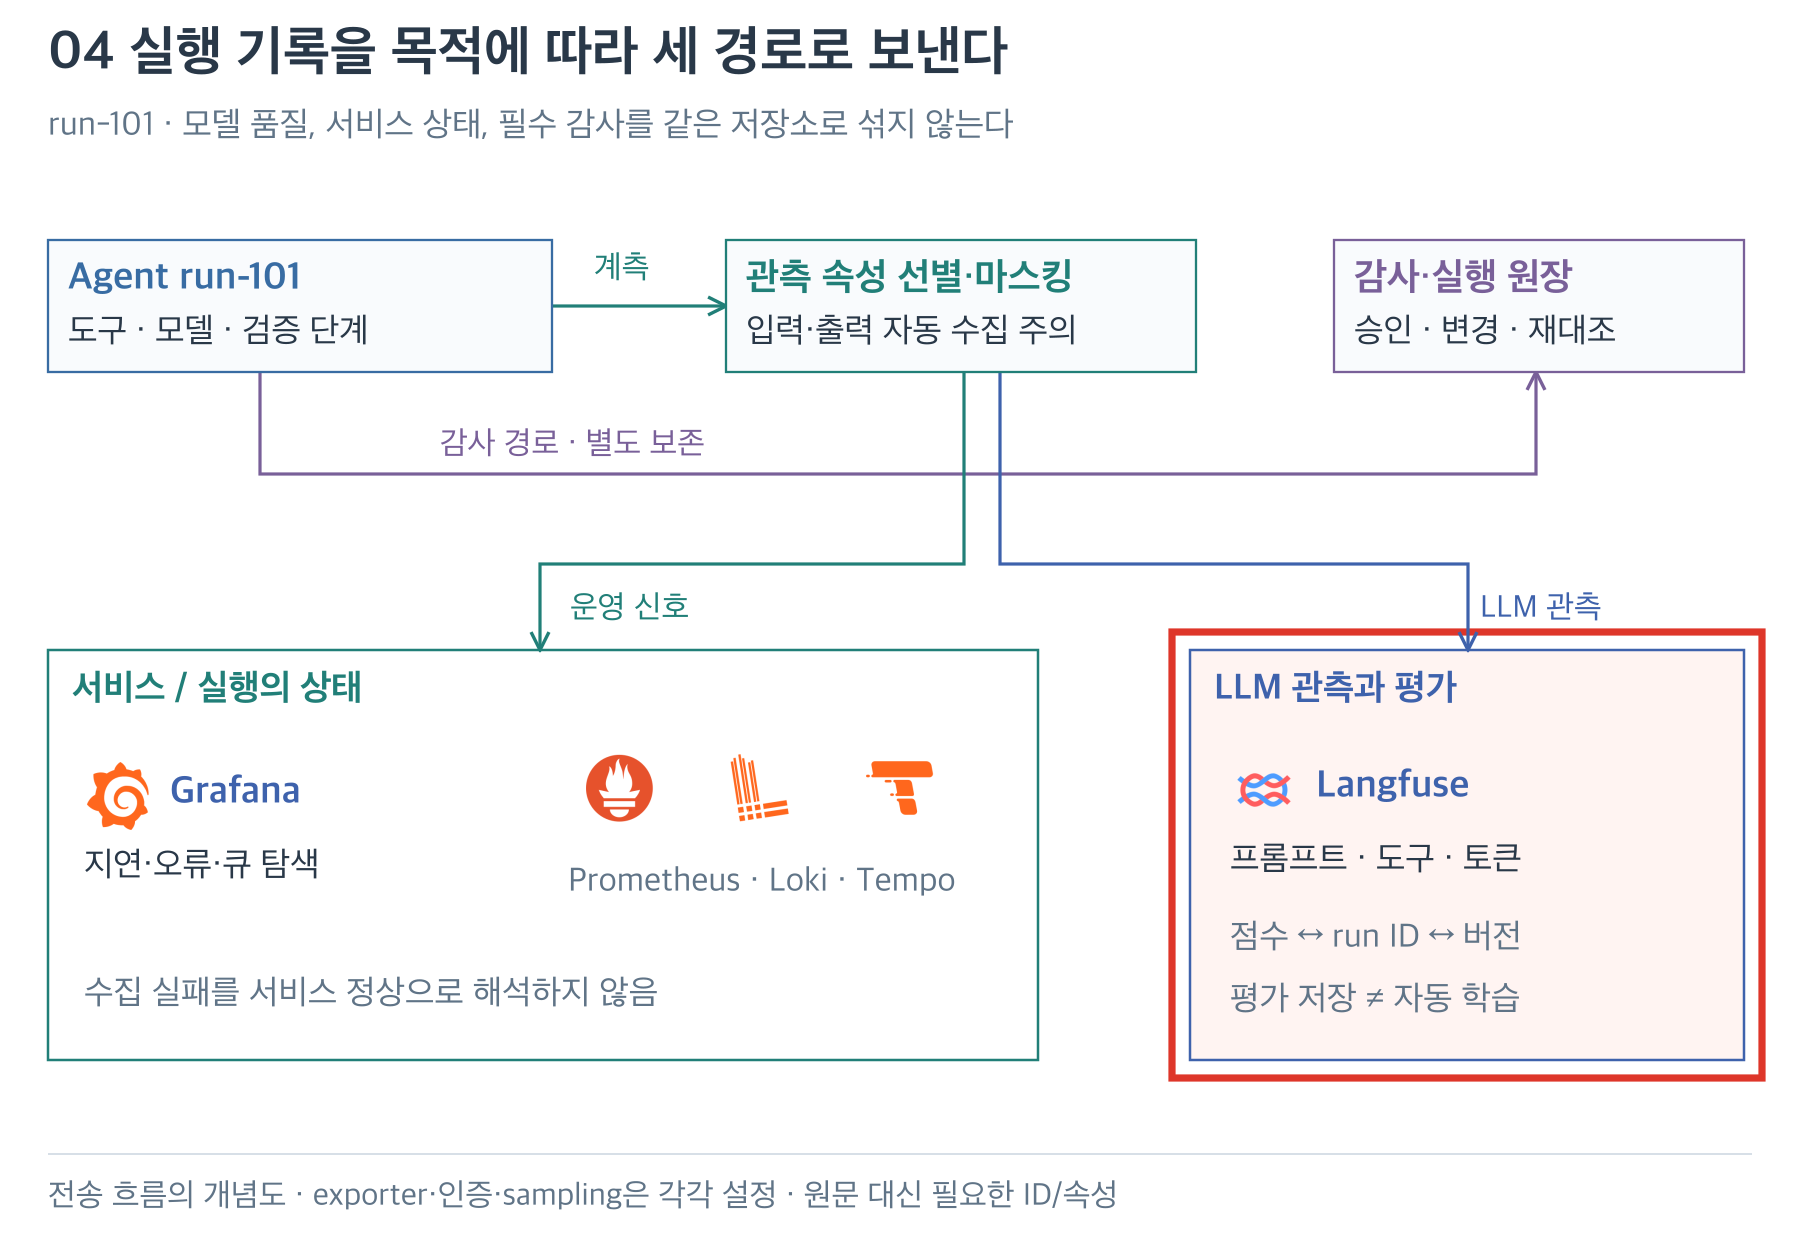
그림 3. 그림 1과 같은 배치에서 Langfuse 영역을 빨간 테두리로 강조했다. 전송 전에 필요한 속성을 선별하고, 점수는 run ID와 버전에 연결한다. 평가 저장이 자동 모델 학습을 뜻하지 않으며 필수 감사 원장은 별도 경로를 유지한다.
6.1 실행 ID와 Trace
incident_id=inc-42에 첫 조사가 run-101, 재조사가 run-102일 수 있다. 각 run은 서로 다른 Agent trace를 가진다. 조사 대상 checkout 요청의 trace는 또 별개다. DB에서는 이 관계를 명시적으로 저장하고, 보고서의 근거 목록에서 대상 trace를 참조한다.
OTel trace context는 실행 부모·자식 관계를 전달하는 정보다. 단순 업무 ID인 incident ID와 같은 값으로 쓰지 않는다. 큐를 건너면 HTTP 요청의 활성 context가 자동 유지되지 않을 수 있으므로 producer의 context를 메시지에 주입하고 consumer에서 복원하는 계측이 필요하다. 장시간 승인 대기 이후의 재개는 별도 trace와 link로 표현할 수도 있다.
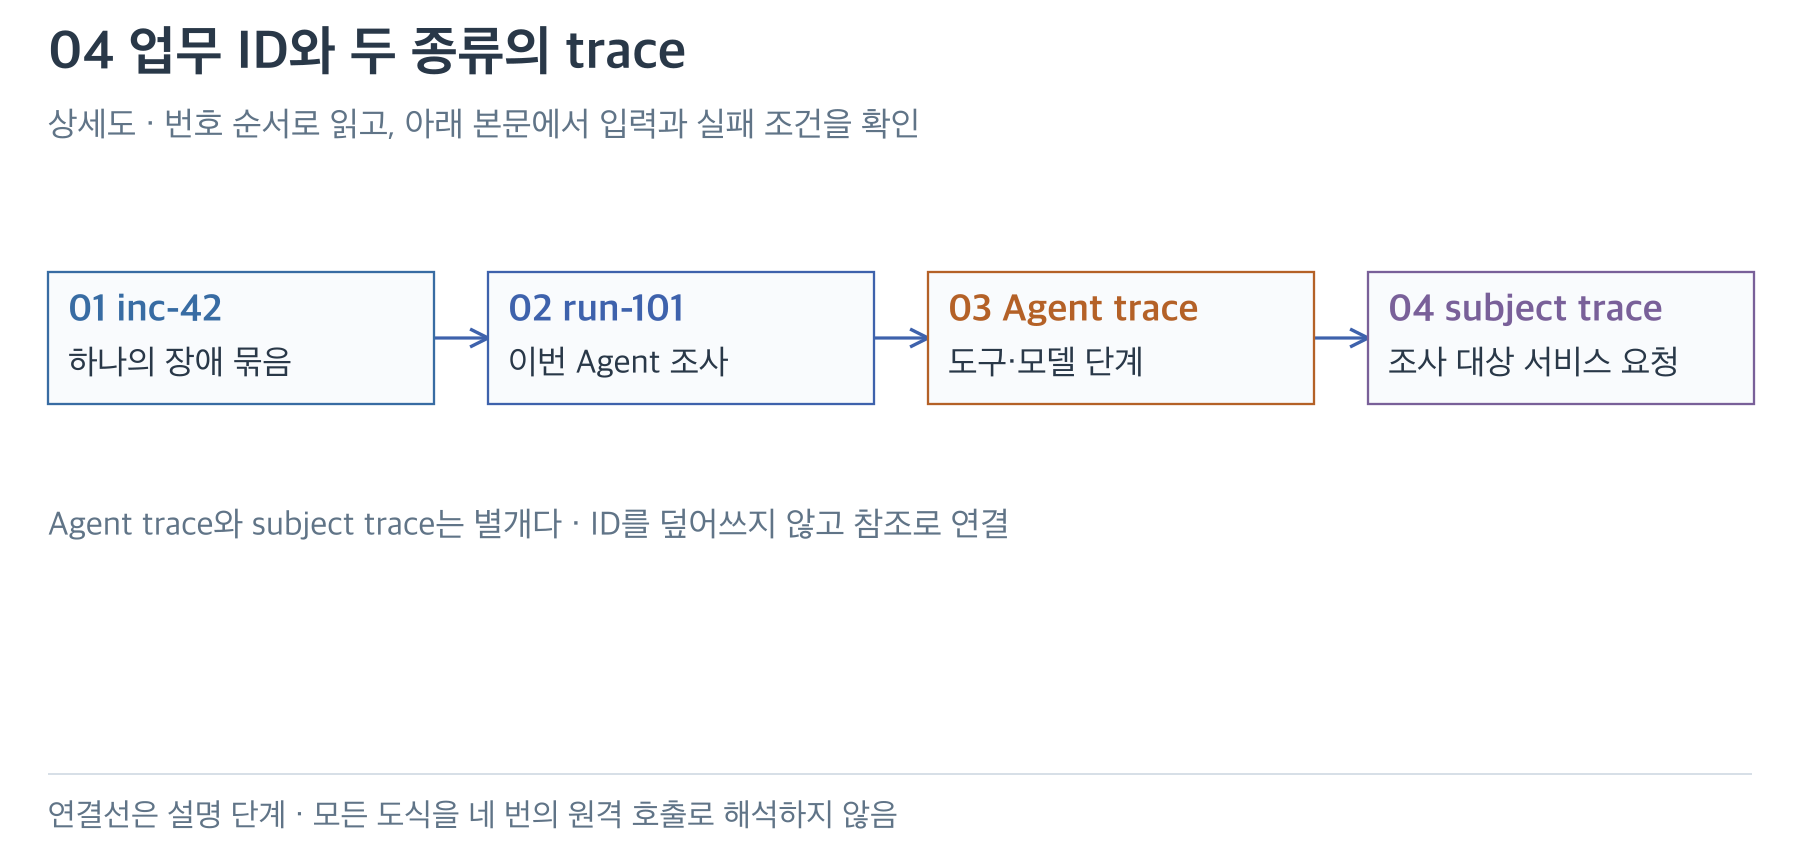
그림 4. 왼쪽부터 업무 식별자를 구분해 읽는다. 화살표는 설명 순서이며 trace의 부모·자식 관계가 아니다. Agent 자체의 도구·모델 실행 trace와 조사 대상 서비스 요청의 trace를 덮어쓰지 않고 근거 참조로 연결한다.
6.2 기록·제외 항목
| 관측 필드 | 기본 제안 | 이유 |
|---|---|---|
| run ID·버전·상태 | 기록 | 실행 재현·비교 |
| 도구 이름·지연·응답 상태 | 기록 | 병목·실패 분석 |
| 토큰 사용량·모델명 | 기록 | 비용·변경 영향 |
| 민감 로그 원문·사용자 질문 전체 | 기본 미수집 | 개인정보·비밀 최소화 |
| API token·인증 헤더 | 기록 금지 | 인증정보 유출 방지 |
| evidence ID·검증 결과 | 기록 | 원문 복제 없이 결과 추적 |
가명 ID도 다른 자료와 결합하면 개인을 식별할 수 있으므로 보존·접근 정책이 필요하다. 샘플링을 적용하는 trace와 반드시 남겨야 하는 승인·실행 감사 기록은 독립 경로로 관리한다.
7. Langfuse 연결
아래는 공식 Python SDK 계측 형태를 참고한 최소 예시다. 실제 LLM 호출과 SDK 설치·버전 고정은 생략했다. 이 글에서 실행 검증한 코드가 아니며 도입 버전의 API를 확인해야 한다. Langfuse Instrumentation
2026-10-04에 확인한 공식 SDK 개요는 Python v4·JS/TS v5를 안내한다. 기존 예제를 복사하기 전에 SDK와 self-hosted 서버의 호환표를 함께 확인하고, 실제 설치한 정확한 버전은 lock 파일에 남긴다. 아래 코드는 계측 위치를 보여 주며 제품 UI 연동 완료를 뜻하지 않는다.
from langfuse import get_client, observe

langfuse = get_client()

@observe(name="incident.run", capture_input=False, capture_output=False)
def investigate(request):
    # 요청 원문 대신 비식별 ID와 버전만 선택적으로 기록한다.
    return run_workflow(request)

# 단기 실행 스크립트 종료 전 전송 대기.
# 상시 서버는 종료 훅과 SDK 수명주기에 맞춰 처리한다.
langfuse.flush()run_workflow는 프로젝트에서 구현할 함수다. 실제 배포에서는 선택한 Cloud 리전 또는 self-hosted 주소, 공개 키·비밀 키를 비밀 저장소에서 주입한다. 코드·프롬프트·이미지·로그에 키를 넣지 않는다. LLM 및 도구 단계도 선택적으로 계측하고 모델·사용량 속성 매핑을 확인한다.
연결 순서는 다음과 같다.
- 민감 정보가 없는 staging 조사 한 건을 실행한다.
- 루트와 자식 span의 연결, run ID, 모델·프롬프트 버전을 확인한다.
- 입력·출력·예외에서 개인정보와 비밀이 빠졌는지 확인한다.
- 동일 호출이 두 번 계측되거나 이중 export되지 않는지 확인한다.
- 평가 점수와 실행 결과를 연결하고, export 실패 시 업무 흐름에 미치는 영향을 시험한다.
Tempo와 Langfuse가 모두 OTel을 사용한다고 동일한 exporter 설정으로 자동 통합되는 것은 아니다. provider 수명주기, instrumentation scope, 인증, 속성 매핑, 샘플링, 중복 계측을 점검한다. 원시 로그 전부를 두 곳에 복제하지 말고 목적에 맞는 데이터만 보낸다. Langfuse Advanced features
SDK·collector에서 민감 정보를 전송 전에 제거한다. 입력·출력 자동 캡처를 꺼도 수동 metadata나 예외 메시지에서 유출될 수 있다. self-hosting도 접근 제어·보존·백업·삭제 책임을 없애지 않는다. Langfuse Masking
여기서 “전송 전”의 경계도 정해야 한다. Collector에서 마스킹하면 원문은 이미 애플리케이션 밖으로 나간 뒤다. 원문이 애플리케이션을 떠나면 안 되는 경우에는 SDK·애플리케이션 안에서 제거하고, Collector는 허용된 신뢰 경계 안에 둔다. 공식 Python 문서의 mask_otel_spans와 기존 mask는 적용 범위가 다르므로 도입 버전의 제3자 OTel 계측까지 확인한다.
7.1 관측 누락 점검
키를 넣었는데 화면에 아무것도 보이지 않으면 곧바로 Agent 코드를 모두 바꾸지 않는다. 우선 무해한 테스트 span 하나를 만들어 endpoint·프로젝트·리전이 맞는지 본다. 다음으로 종료 시 flush와 네트워크 오류를 확인하고, root와 child의 context가 연결됐는지 검사한다. 마지막으로 instrumentation scope 필터·샘플링·중복 exporter를 확인한다.
프로젝트가 이미 OTel provider를 초기화하고 있다면 Langfuse 추가 초기화와 충돌할 수 있다. 서비스 전체 telemetry는 Tempo로, LLM 관련 관측은 Langfuse로 보내는 구성을 설계하되 실제 exporter의 속성 변환과 필터 동작을 테스트한다. 두 제품에서 같은 span 수가 보이는 것을 목표로 잡지 않는다. 저장 목적과 샘플링이 다를 수 있다.
계측 실패는 큐에 무한히 쌓이거나 조사 응답을 끝없이 지연시키면 안 된다. 전송 큐 크기·timeout·drop 지표와 종료 처리 시간을 정한다. 반면 승인 원장 기록 실패는 변경 실행을 중단해야 할 수 있다. 선택적 관측 실패와 필수 감사 실패의 처리 정책을 다르게 정하는 것이 운영 설계다.
7.2 작업별 비용 한도
호출 한 번의 입력·출력 토큰 비용뿐 아니라 재시도, RAG 임베딩, 도구 질의, trace 저장 비용을 포함한다. 가령 입력 2,000토큰·출력 500토큰을 6회 호출하면 입력 합계 12,000·출력 합계 3,000토큰이다. 실제 모델의 단가를 각각 곱하고 캐시·추론 토큰 등의 청구 규칙을 반영한다. 이는 특정 모델의 요금을 제시하는 예시가 아니다.
한 번의 호출 가격이 저렴해도 잘못된 도구 선택으로 20회 반복하면 비쌀 수 있다. 단계별 비용을 보고 “더 작은 모델로 바꿀까?”뿐 아니라 “고정 쿼리로 해결할 수 있을까?”, “같은 증거를 매번 다시 읽고 있나?”를 점검한다.
8. 구현 로드맵
| 단계 | 만들 것 | 다음 단계로 넘어갈 기준 |
|---|---|---|
| 1 | fixture 기반 읽기 전용 보고서 | 사실·가설·보류 구분 가능 |
| 2 | 실제 메트릭·로그·트레이스 adapter | 권한·결측·timeout 처리 통과 |
| 3 | DB 상태·큐·중복 방지 | 워커 중단 후 안전한 재개 |
| 4 | 고정 평가셋과 OTel | 품질·비용 회귀를 재현 가능 |
| 5 | Langfuse·승인형 조치 | 마스킹·평가·감사 연결 검증 |
| 6 | 제한적 자동 조치·점진 배포 | 영향 한도·중단·복구 검증 |
고급 단계의 멀티 에이전트는 역할 이름을 늘리는 작업이 아니다. 독립된 권한·문맥·전문성이 필요하고, 단일 Agent보다 평가 결과나 지연이 나아지는지 검증할 수 있을 때 도입한다. 하위 에이전트에도 부모보다 넓은 권한을 주지 않으며, 전체 예산·취소·중복 도구 호출을 함께 관리한다.
처음 만들 시스템의 목표는 “스스로 모든 장애를 고치는 AI”보다 운영자가 신뢰할 수 있는 증거를 더 빠르게 모으고, 허용된 범위에서 검증 가능한 결과를 내는 에이전트로 잡는 것이 구체적이다.
run-101의 실패는 다음 실행의 무조건적인 기억이 아니라 개선할 근거다. 실패를 분류하고, 문서·메모리·도구·프롬프트 중 원인을 수정한 뒤 같은 fixture로 다시 비교한다. 승인된 새 구성을 run-102에 적용하되 이전 실행의 버전과 기록은 유지한다. 이어지는 5편은 저장과 검색, 6편은 에이전트 유형과 Deep Agents, 7편은 도구 실행과 거버넌스를 구현 수준으로 다룬다.
자료 기준: 2026-10-04, 본문에 연결한 공식 문서의 해당 기능·구문을 확인했다. 모든 버전의 전체 동작을 검증한 것은 아니다. 설계·코드·예산은 예시이며 실제 운영 성능이나 배포 완료를 의미하지 않는다.
그림 자산 출처: Grafana 공식 OSS 제품 페이지의 제품별 원본 로고를 색·비율을 유지해 사용했다. 연결선·구획·설명은 자체 제작이며 제품의 공식 아키텍처 도면이 아니다. 상표 사용 정책에 따른 표기: The Grafana Labs Marks are trademarks of Grafana Labs, and are used with Grafana Labs’ permission. We are not affiliated with, endorsed or sponsored by Grafana Labs or its affiliates.
Langfuse 아이콘은 공식 브랜드 자산의 컬러 SVG를 내려받아 원본 색상과 비율을 유지해 전체도·강조 그림·표지에 사용했다. 제품 식별을 위한 사용이며 Langfuse의 후원이나 보증을 뜻하지 않는다.
추가 그림 자산 출처
Prometheus® 로고는 프로젝트 공식 저장소의 원본을 사용했다. Prometheus는 The Linux Foundation의 등록 상표이며 상표 사용 정책에 따른 제품 식별이다.

AIOps 에이전트 개발 시리즈
