- 전체보기(19)
- DeepLearning(7)
- DL(7)
- ML(2)
- EDA(2)
- 데이터(2)
- MachineLearning(2)
- ensemble(2)
- 배깅(1)
- VAE(1)
- adam(1)
- 신뢰구간(1)
- 부트스트랩(1)
- 표본분포(1)
- 통계(1)
- Varitional AutoEncoder(1)
- SSD(1)
- 푸아송 분포(1)
- Inception-v1(1)
- yolov3(1)
- AE(1)
- 제약(1)
- PyTorch(1)
- RMSProp(1)
- AutoEncoder(1)
- F분포(1)
- 정형데이터(1)
- 바운딩박스(1)
- GoogleNet(1)
- AdaGrad(1)
- 데이터과학(1)
- SSDLite320(1)
- Panoptic Segmentation(1)
- 카이제곱분포(1)
- model(1)
- dropout(1)
- Algorithms(1)
- 이항분포(1)
- Oxford-IIIT Pet(1)
- QQ그림(1)
- momentum(1)
- 데이터 분석통계(1)
- YOLOv8n(1)
- Optimizer(1)
- 경사하강법(1)
- 지수분포(1)
- semantic segmentation(1)
- YOLOv2(1)
- 분포(1)
- 옵티마이저(1)
- DAE(1)
- residual network(1)
- YOLOv1(1)
- 확률적 경사 하강법(1)
- AlexNet(1)
- VGGNet(1)
- 표준분포(1)
- Bagging(1)
- 베이불 분포(1)
- 객체탐지(1)
- Denoising AutoEncoder(1)
- instance segmentation(1)
- 능력(1)
- image segmentation(1)
- YOLO(1)
- Resnet(1)
- Gradient Descent(1)
- 정규분포(1)
- 표준오차(1)
- Mini batch(1)
- 중심극한정리(1)
- 탐색적(1)
- 탐색적 데이터 분석(1)
- extra trees(1)
- Random Forest(1)
- SGD(1)
알약 검출 프로젝트 1일차 기록: 문제 정의와 협업 기반 구축
프로젝트 첫날에는 알약 인식 기반 복용 기록 서비스의 문제를 정의하고, 팀 개발 환경과 협업 기반을 마련했다. 오전에는 서비스의 핵심 사용자 경험을 논의했고, 오후에는 환경 설정 문제를 해결한 뒤 EDA를 진행했다. 마무리 회의에서는 데이터 보완 결과와 접근 방법에 대
데이터 과학을 위한 통계(5)
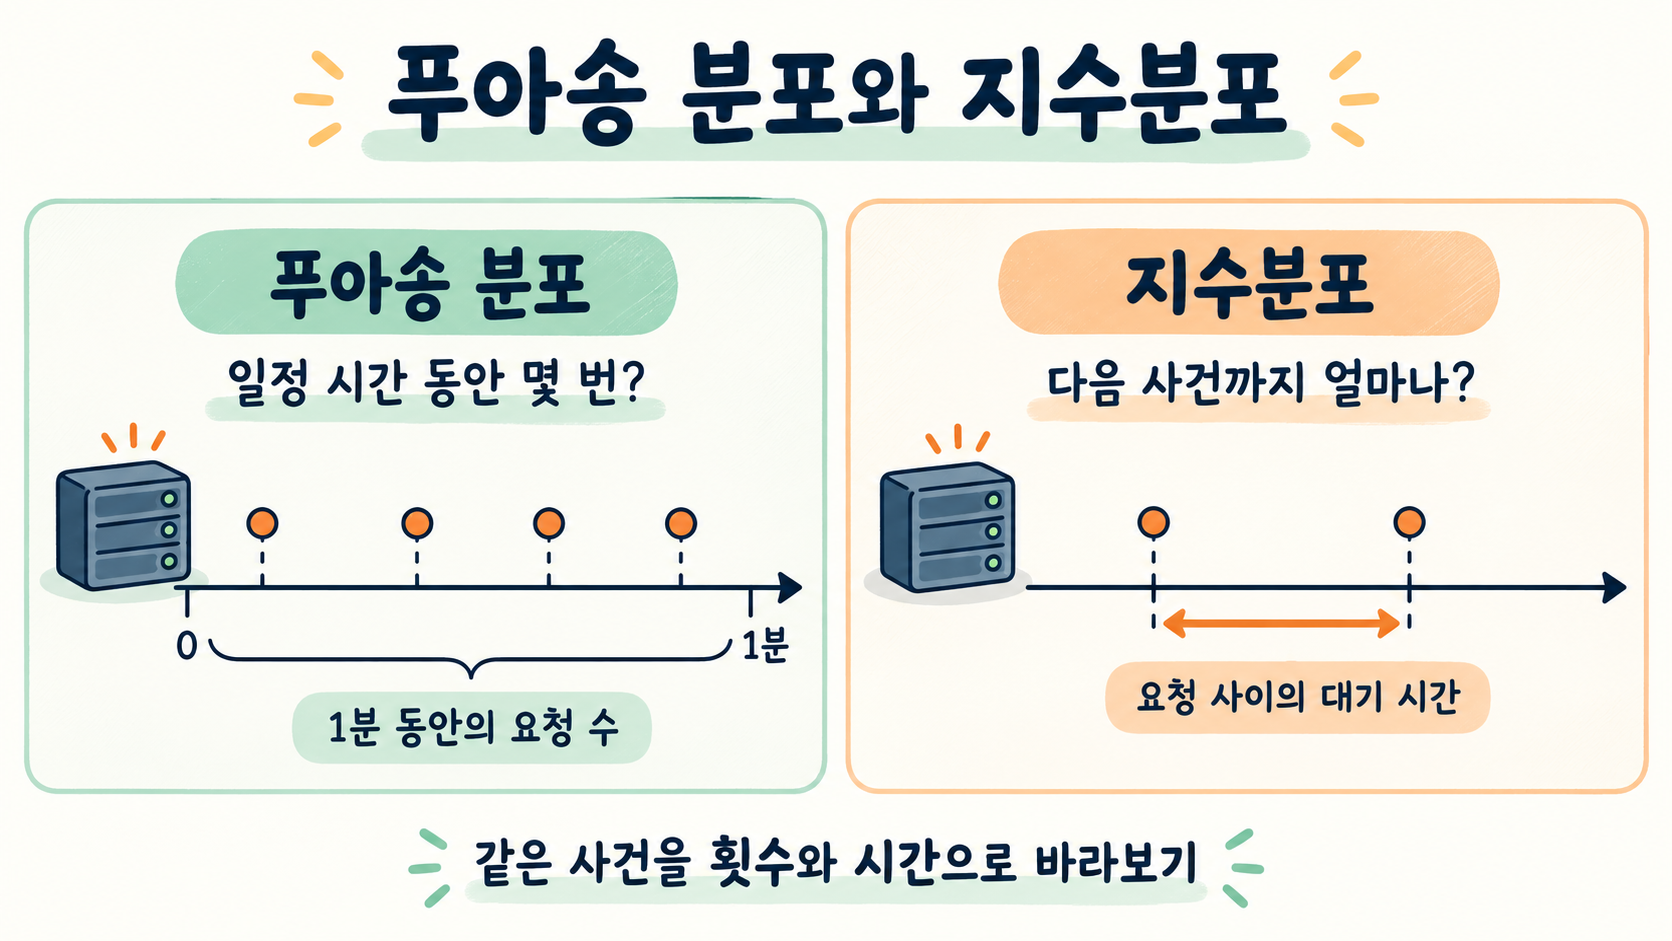
구매 여부, 클릭 여부처럼 두 가지 결과를 갖는 시행을 반복할 때, 성공한 횟수가 따르는 분포를 이항분포라고 한다.시행 : 하나의 결과를 만들어 내는 실험이나 관찰성공 : 시행에서 관심을 두는 결과이진 결과 : 예/아니요, 0/1처럼 두 가지로 나뉘는 결과베르누이 시행
Fashion-MNIST 조건부 이미지 생성: cGAN에 VAE 학습 신호를 더하면 나아질까? (cGAN vs cVAE-GAN)
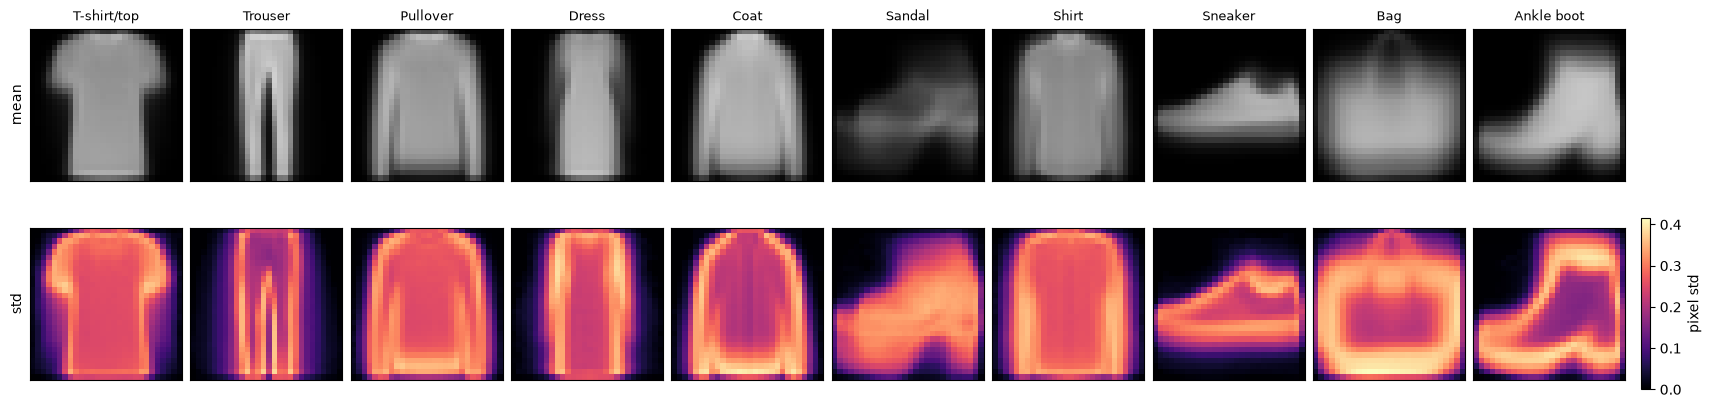
문제 정의: 같은 구조의 생성자에 VAE식 학습 신호(Encoder + 재구성 손실)를 더하면, 조건부 이미지 생성이 더 좋아지는가?Fashion-MNIST에서 라벨을 주면 그 클래스의 옷 이미지를 만드는 모델을 두 가지 방식으로 학습해 비교했다. 두 모델은 생성 경로
데이터 과학을 위한 통계(4)
표본으로 계산한 평균이 100이라고 해서 모집단의 평균도 정확히 100이라고 말할 수는 없다. 다른 표본을 뽑았다면 다른 평균이 나왔을 수 있기 때문이다.이때 추정값 하나만 제시하는 대신, 추정의 불확실성을 구간으로 나타내는 방법이 신뢰구간이다.점추정 : 모평균처럼 알
개·고양이 얼굴 탐지: SSDLite320과 YOLOv8n을 같은 조건에서 비교하기
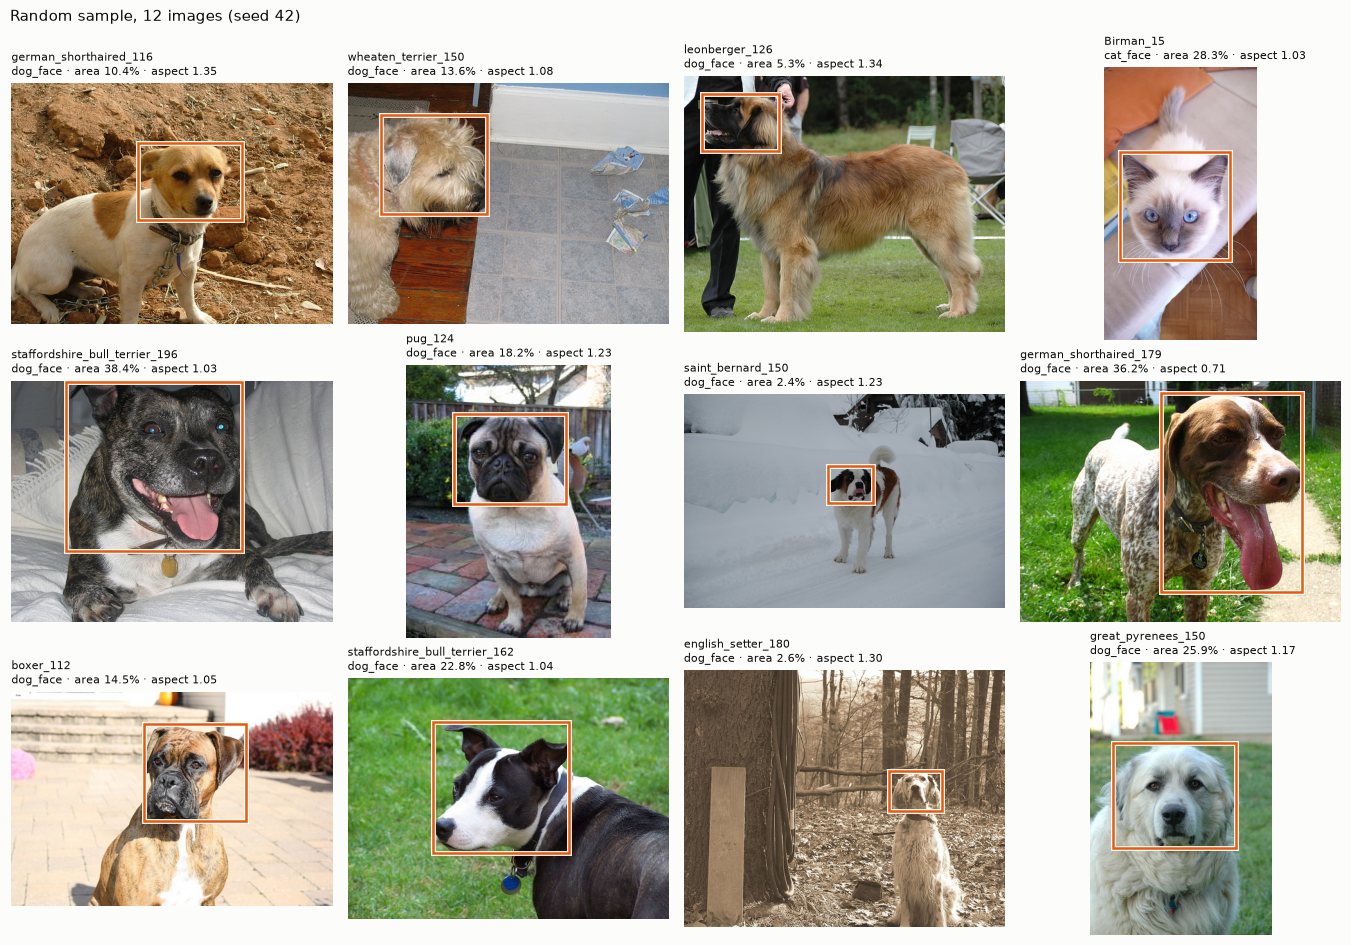
같은 Oxford-IIIT Pet 얼굴 박스 데이터에서 SSDLite320과 YOLOv8n 중 어떤 모델이 얼굴을 더 정확하고 빠르게 찾는가?품종 37개를 맞히는 분류 문제가 아니라, 사진 속 동물의 얼굴(head ROI) 위치를 cat_face, dog_face 두
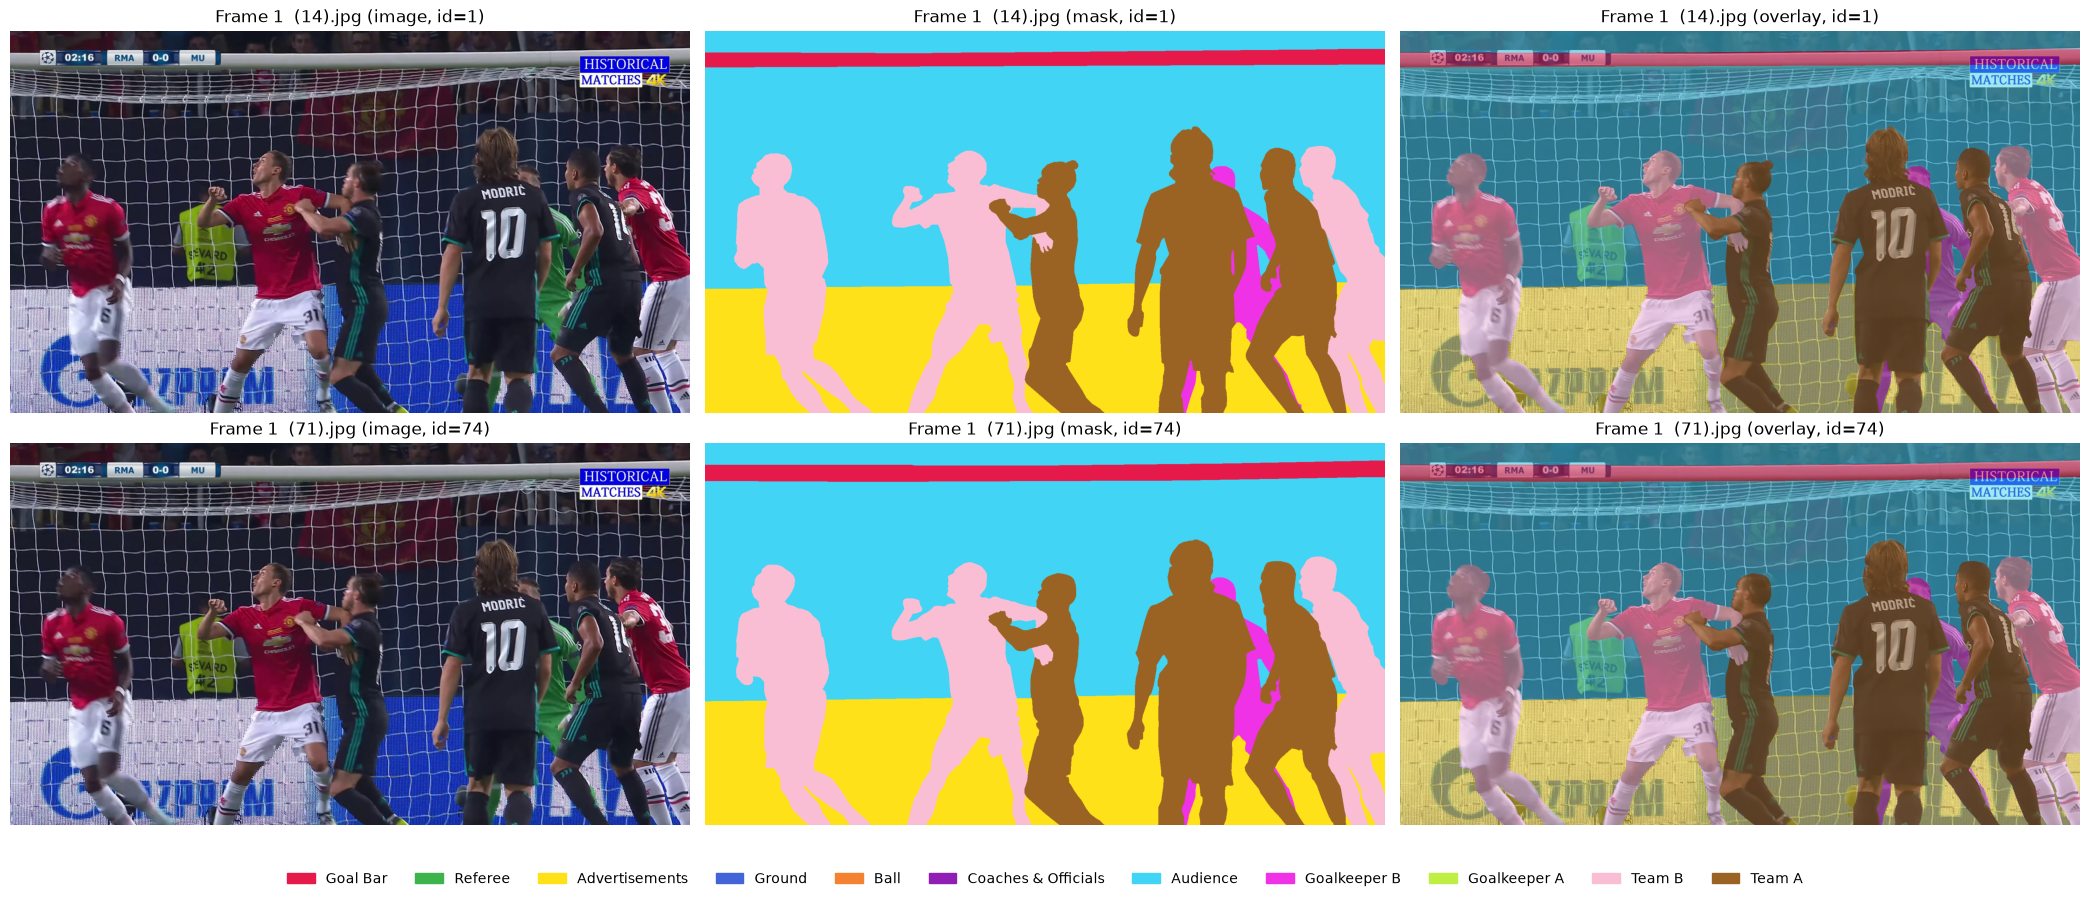
축구 경기 Semantic Segmentation에서 클래스 불균형 다루기 (U-Net++)
문제 정의: 이미지 세그멘테이션에서 클래스 불균형은 어떻게 해결해야 할까?축구 중계 화면 100장으로 픽셀 단위 분할 모델을 학습시키면서, 픽셀 비율 1%도 안 되는 작은 클래스(공, 심판, 골키퍼 B) 가 왜 잘 안 잡히는지, 원인이 무엇인지 실험으로 좁혀 간 기록입
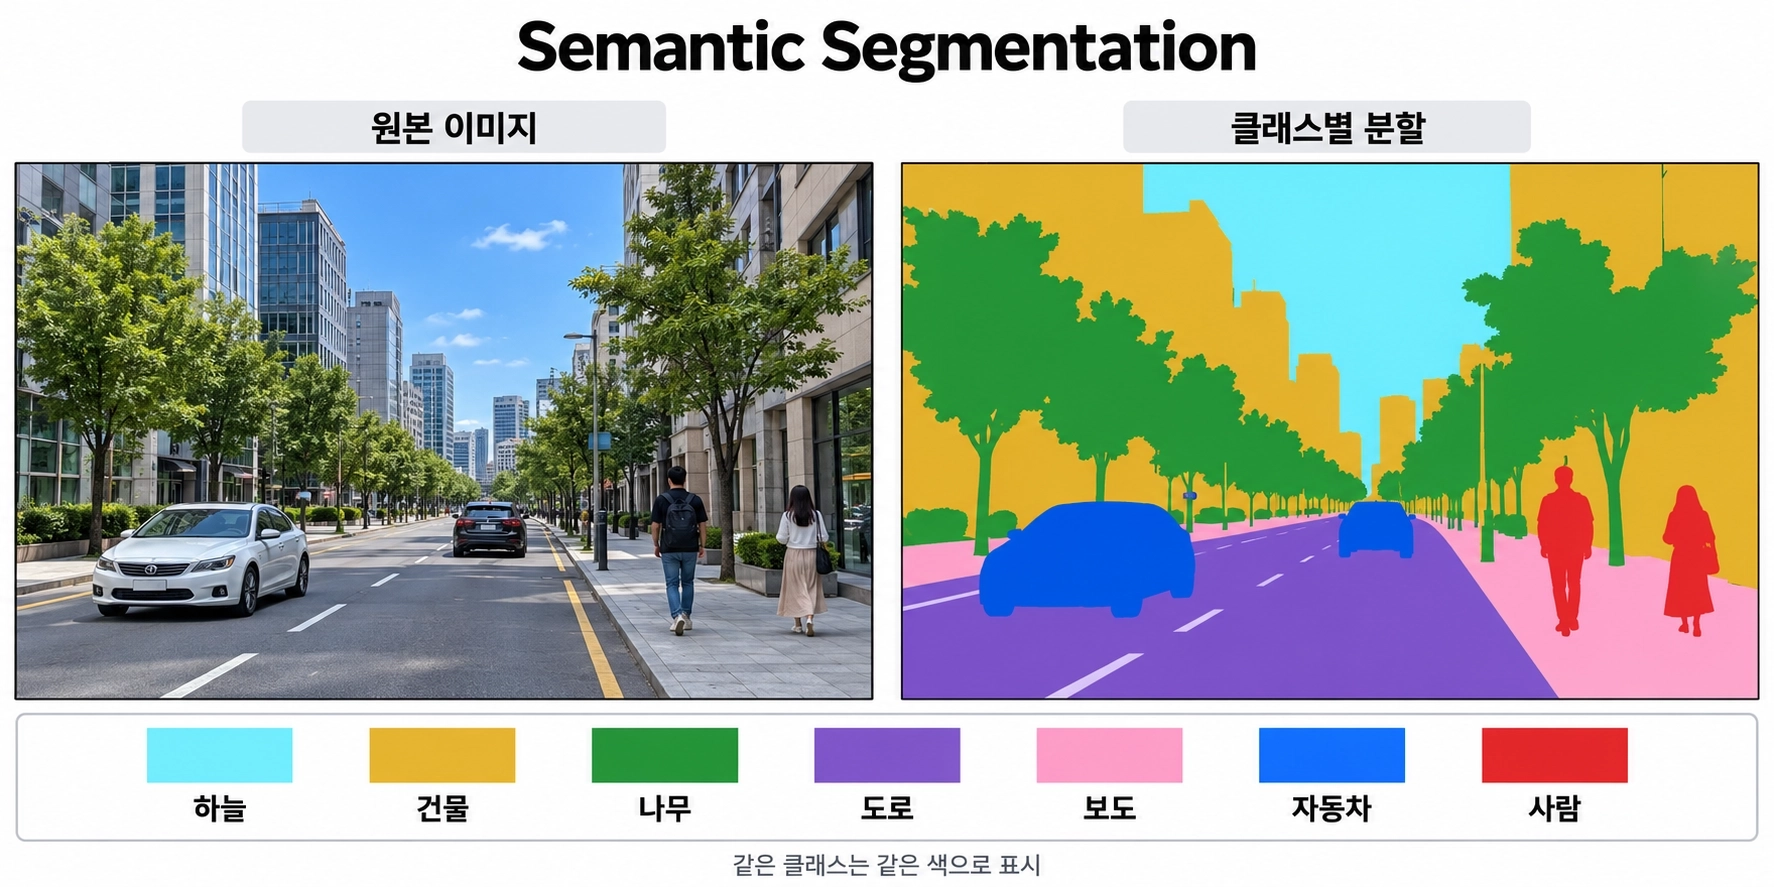
자율주행 차량은 어떻게 주변 장면을 이해할까요?
자율주행 차량은 주변의 자동차와 보행자를 구분하는 동시에 도로와 인도 같은 영역도 파악해야 합니다. 이러한 장면 이해에 활용할 수 있는 기술 중 하나가 Panoptic Segmentation입니다.Segmentation은 ‘분할’이라는 뜻입니다. Image Segmen
데이터 과학을 위한 통계(3)
데이터와 표본분포 빅데이터 시대가 되면서 표본추출(표집, 샘플)이 필요 없을 거라고 오해하는 사람들이 많다. 데이터 질과 적합성을 일정수준 담보할 수 없으면서 데이터의 크기만 늘어나는 것이 오늘날 상황이다. 오히려 데이터를 효과적으로 다루고 편향을 최화하기 위한 방법
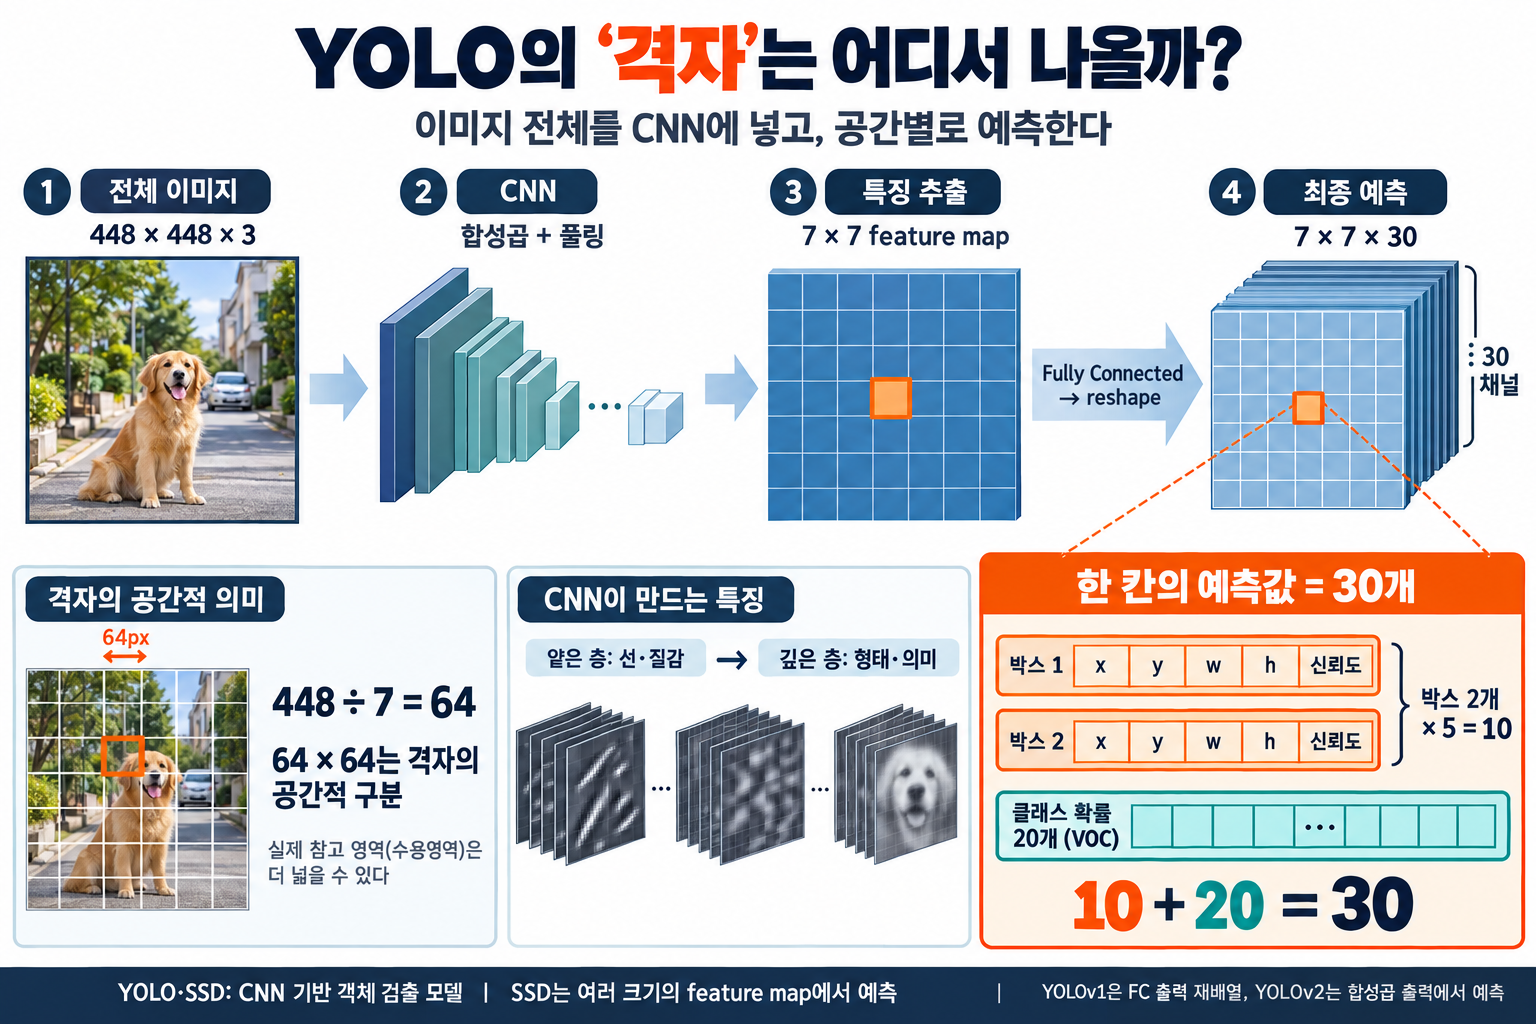
SSD300과 YOLO
SSD300과 YOLO는 모두 이미지를 한 번만 보고 물체를 찾는 1-stage 탐지기다. 둘의 차이는 결국 두 가지로 정리된다. 격자를 몇 개, 어떤 해상도로 쓰는가, 그리고 박스를 처음부터 그리는가, 미리 놓인 틀을 고치는가다.이 글은 이 두 축으로 SSD300과
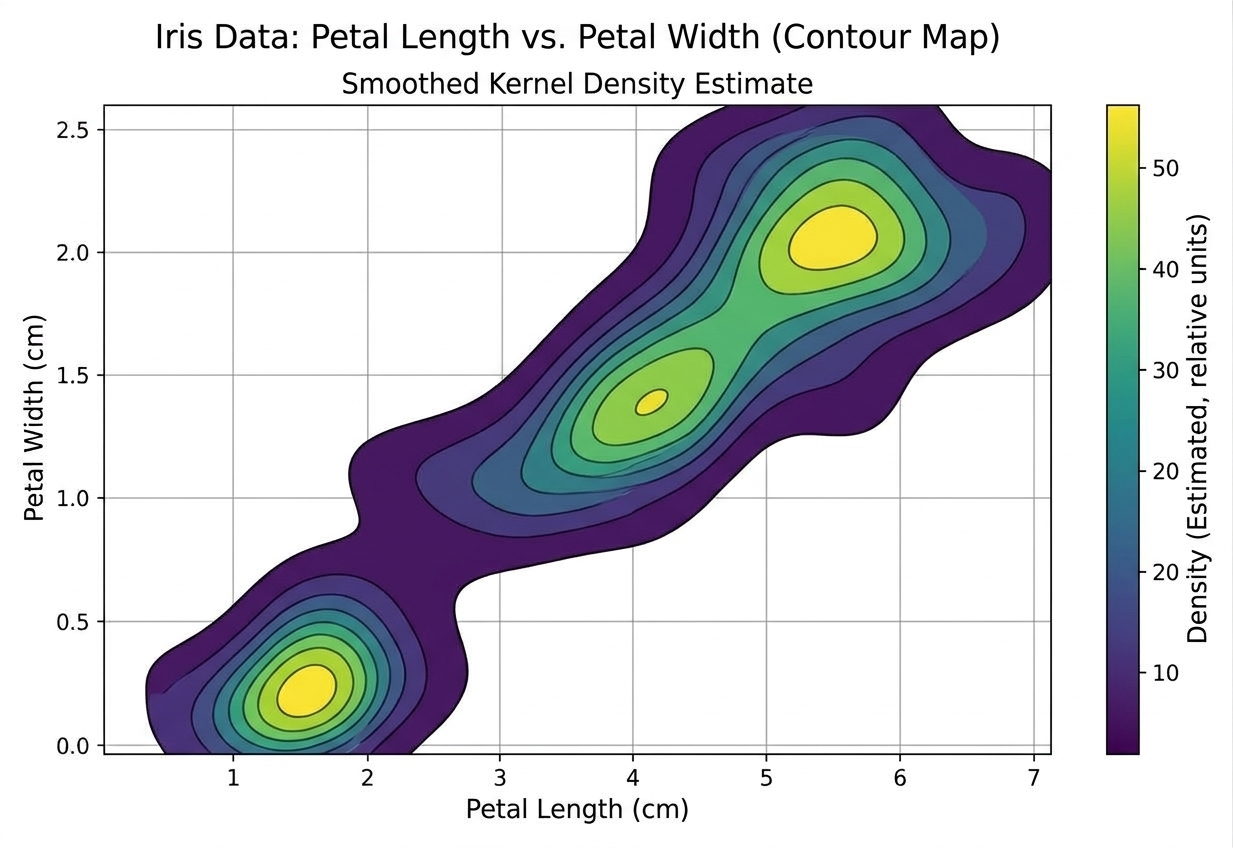
데이터 과학을 위한 통계(2)
데이터분포 탐색하기 백분위수와 상자그림 백분위수 전체 분포를 알아보는데 보통 사용하는 것이 백분위수이다. 주로 사용되는 것은 사분위수(25, 50, 75번째 백분위수)나 십분위수(10, 20, 30,...,90번째 백분위수)아다. 이것은 꼬리 부분(외측 범위)를 묘사하
ResNet (Residual Network)
He et al., Deep Residual Learning for Image Recognition, 2015 (ILSVRC 2015 우승)VGG 이후로 "층을 깊게 쌓을수록 성능이 좋아진다"는 게 거의 정설이었다. 그런데 실제로 계속 쌓아보니 이상한 일이 생겼다.56
GoogLeNet (Inception v1)
2014, Google (Szegedy et al.) · ILSVRC 2014 분류 부문 우승 (Top-5 error 6.67%)2012년 AlexNet 이후 CNN 연구의 흐름은 "네트워크를 더 깊고 넓게 만들면 성능이 오른다" 였다. 하지만 이 방식에는 분명한 한계
VGGNet
2012년 AlexNet이 ImageNet에서 큰 성공을 거두면서, 연구자들은 "CNN을 어떻게 설계해야 성능이 더 좋아질까?"를 고민하기 시작했다.당시에는 필터 크기, stride, 층 수 등을 이것저것 바꿔보는 식이어서, 어떤 요소가 성능을 결정하는지 명확하지 않았
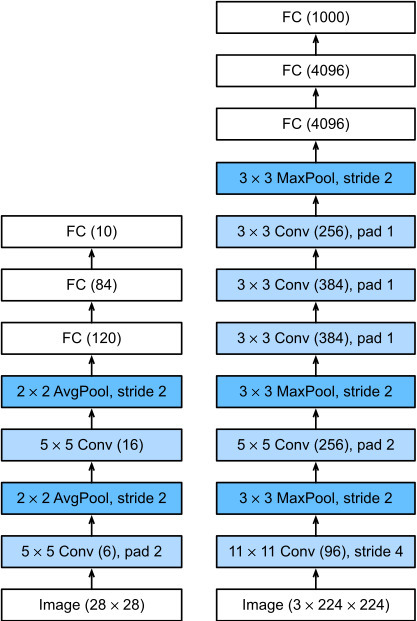
AlexNet
Krizhevsky, Sutskever, Hinton. ImageNet Classification with Deep Convolutional Neural Networks. NeurIPS 2012.2012년 이전의 이미지 분류는 사람이 특징을 설계하는 방식이었다. SIF
데이터 과학을 위한 통계(1)
정형화된 데이터의 요소 센서 측정, 이미지, 비디오, 텍스트, 이벤트 등을 통해 졍형화되어 있지 않은 데이터를 받는다. 데이터 과학은 이러한 데이터들의 폭발적인 양의 원시(가공되지 않은) 데이터를 활용 가능하도록 정형화된 형태로 변환해야 한다. 정형 데이터 중 가장 일
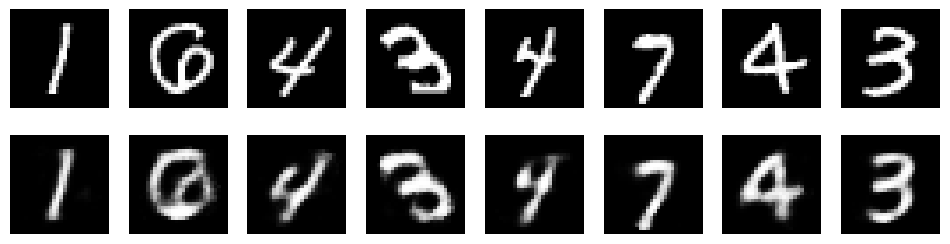
제약이 능력을 만든다: PyTorch로 이해하는 AE, DAE, VAE
오토인코더를 처음 접하면 목표부터 이상하게 느껴진다. 입력한 이미지를 그대로 출력하도록 학습한다니, return x 한 줄이면 끝나는 것 아닐까?하지만 입력이 좁은 통로를 지나야 한다면 이야기가 달라진다. 784개 픽셀을 더 적은 수의 값으로 표현하고 다시 복원하려면,
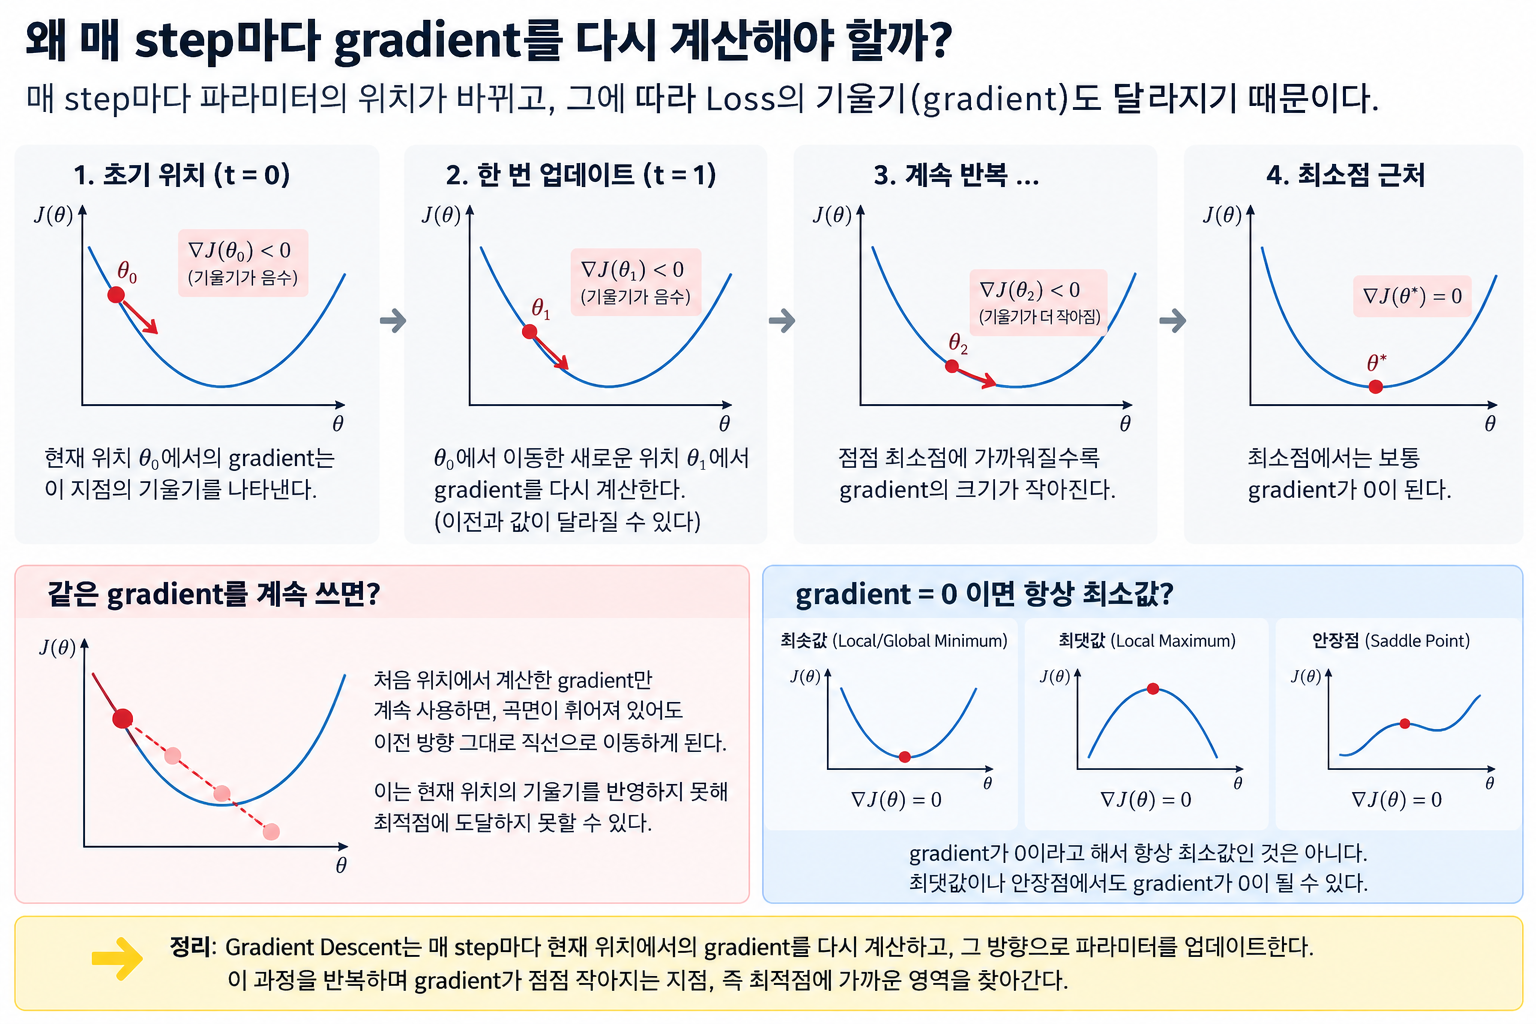
Optimizer는 무엇을 보완해 왔는가?
$Optimizer의 발전은 단순히 "더 빨리 내려가는 알고리즘"의 역사가 아니라, Gradient Descent가 가진 서로 다른 문제를 보완해 온 과정이다.$ > ## 목차 Gradient Descent 란? Problem - 기본 Gradient Descent에
Random Forest와 Extra Trees
Bagging은 서로 다른 Bootstrap 표본을 사용해 Tree의 흔들림을 평균낸다. > → 그러나 강력한 Feature 때문에 Tree들이 계속 비슷한 분할을 고를 수 있다. > → 각 노드에서 볼 Feature 후보를 제한해 Tree들을 덜 닮게 만든다: Ran
Decision Tree, Bagging과 OOB
Decision Tree는 강력하지만 학습 데이터가 조금만 달라져도 크게 흔들릴 수 있다. > → 서로 다른 Bootstrap 표본을 본 Tree들을 만든다. > → 예측을 평균하거나 투표해 개별 Tree의 흔들림을 상쇄한다: Bagging > → 각 Tree가 보지