- 전체보기(48)
- python(15)
- 알고리즘(12)
- AI(10)
- 개념(5)
- 기계학습(4)
- web(4)
- Springboot(3)
- LLM(3)
- http(2)
- OOP(2)
- Backend(2)
- CSS(2)
- BFS(2)
- List(2)
- Java(2)
- 데이터 구조(2)
- 딥러닝(2)
- decoder(1)
- XML(1)
- JavaScript(1)
- UIUX(1)
- frontend(1)
- tomcat(1)
- transformer(1)
- kruskal(1)
- json(1)
- 사전학습(1)
- 제어문(1)
- bootstrap(1)
- String(1)
- tree(1)
- war(1)
- union(1)
- jquery(1)
- 함수(1)
- 예외처리(1)
- html(1)
- JVM(1)
- 백트래킹(1)
- 객체지향(1)
- RNN(1)
- Embedding(1)
- DFS(1)
- 그래프(1)
- pandas(1)
- 완전 탐색(1)
- 데이터 시각화(1)
- 시각화(1)
- jar(1)
- numpy(1)
- encoder(1)
- API(1)
- greedy(1)
- stack(1)
- queue(1)
- 모듈(1)
- prim(1)
- dijkstra(1)
- 데이터(1)
- 정리(1)
- annotation(1)
- LSTM(1)
[Algorithm] 그래프2
1. 최소 신장 트리 > 무방향 가중치 그래프에서 신장 트리를 구성하는 간선들의 가중치 합이 최소인 신장 트리이다. > 대표적인 트리 문제 보통 최소 신장 트리(MST) 문제는 아래 형태로 많이 나온다. 모든 정점을 최소 비용으로 연결 도시들을 도로로 연
[Algorithm] 그래프1
정점들의 집합과 이들을 연결하는 간선들의 집합으로 구성된 자료 구조이다.무향 (무방향) 그래프유향 (방향) 그래프가중치 그래프사이클 없는 방향 그래프간선의 정보를 저장하는 방식, 메모리나 성능을 고려해서 결정한다.인접 행렬N x N 크기의 2차원 배열을 이용해서 간선
[Algorithm] 백트레킹
백트래킹은 여러 가지 선택지가 존재하는 상황에서 하나를 선택하고, 그 선택을 기반으로 다음 선택을 이어가며 정답을 찾는 방식이다.탐색을 진행하다가 하나의 경로가 끝나면 이전 상태로 돌아가 다른 선택지를 다시 탐색한다.즉, 백트래킹의 핵심은 다음과 같다.예를 들어 \[1
[Algorithm] 탐욕 알고리즘
이번에는 완전탐색에서 자주 사용하는 부분집합, 조합과현재 상황에서 가장 좋은 선택을 하는 Greedy 알고리즘을 정리한다.주어진 집합에서 일부 원소를 선택하여 만든 집합이다.아무것도 선택하지 않은 공집합도 포함한다.원소가 N개라면 부분집합의 개수는 2^N개이다.예를 들
[Algorithm] 완전 탐색
반복과 재귀는 유사한 작업을 수행할 수 있다.반복은 수행하는 작업이 완료될 때 까지 계속 반복한다.루프 for , while재귀는 주어진 문제의 해를 구하기 위해 동일하면서 더 작은 문제의 해를 이용하는 방법이다.하나의 큰 문제를 해결할 수 있는 더 작은 문제로 쪼개고
[Algorithm] BFS
그래프를 탐색하는 방법에는 두가지가 있다. 너비 우선탐색과 깊이 우선 탐색이 있다.탐색 시작 정점에 인접한 정점들을 모두 차례로 방문한 후에, 방문했던 정점을 시작점으로 하여 다시 인접한 정점들을 차례로 방문하는 방식이다.입력 파라미터: 그래프 G와 탐색 시작점 v
[Algorithm] Tree
1. 트리란? 비선형 자료구조이다. 원소들 간에 1:N 관계를 가지는 자료구조이다. 원소들 간에 계층관계를 가지는 계층형 자료구조이다. 상위 원소에서 하위원소로 내려가면서 확장되는 트리모양의 구조이다. 용어정리 노드 (node): 트리의 원소 간선 (edge):
[Algorithm] Queue
1. 큐 (Queue) > 먼저 들어온 데이터가 먼저 나가는 선형 자료구조 > 큐의 구조 선입선출, FIFO (First In First Out), 가장 먼저 넣은 자료가 가장 먼저 나오는 것이다. 큐의 기본 연산 삽입은 enqueue() , 삭제는 deque
[Algorithm] Stack
대표적인 선형 자료 구조 중 하나로 물건을 쌓아 올리듯 자료를 쌓아 올린 형태의 자료구조배열을 이용해 구현할 수 있다.파이썬에서는 리스트 를 이용해서 구현할 수 있다.저장소 자체를 스택이라고 부르기도 한다.용도에 따라 메모리 일부를 스택으로 부른다.스택에서 마지막 삽입
[Algorithm] String
코드 체계문자열Python 문자열 입력과 기본 처리문자열 연산패턴 매칭고지식한 패턴 검색 (Brute Force)KMP 알고리즘보이어-무어 알고리즘문자열 암호화문자열 압축코드체계는 문자에 대응되는 숫자를 정한 것이다.바이트(Byte): 주소가 부여되는 최소 단위컴퓨터는
[Algorithm] List 2 — 정렬 · 완전 검색 · 탐욕 알고리즘
2개 이상의 자료를 특정 기준에 의해 작은 값부터 큰 값 순서 또는 그 반대 순서로 재배열하는 것이다.교재에서 소개하는 대표적인 정렬:버블 정렬(Bubble Sort)카운팅 정렬(Counting Sort)선택 정렬(Selection Sort)퀵 정렬(Quick Sort
[Algorithm] List 1 — 알고리즘 · 시간 복잡도 · 배열
문제를 해결하기 위한 절차나 방법이다.컴퓨터가 어떤 일을 수행하기 위한 단계적인 방법을 의미한다.의사코드(Pseudocode)순서도(Flowchart)좋은 알고리즘인지 판단할 때 다음 기준을 볼 수 있다.정확성얼마나 정확하게 동작하는가작업량얼마나 적은 연산으로 원하는
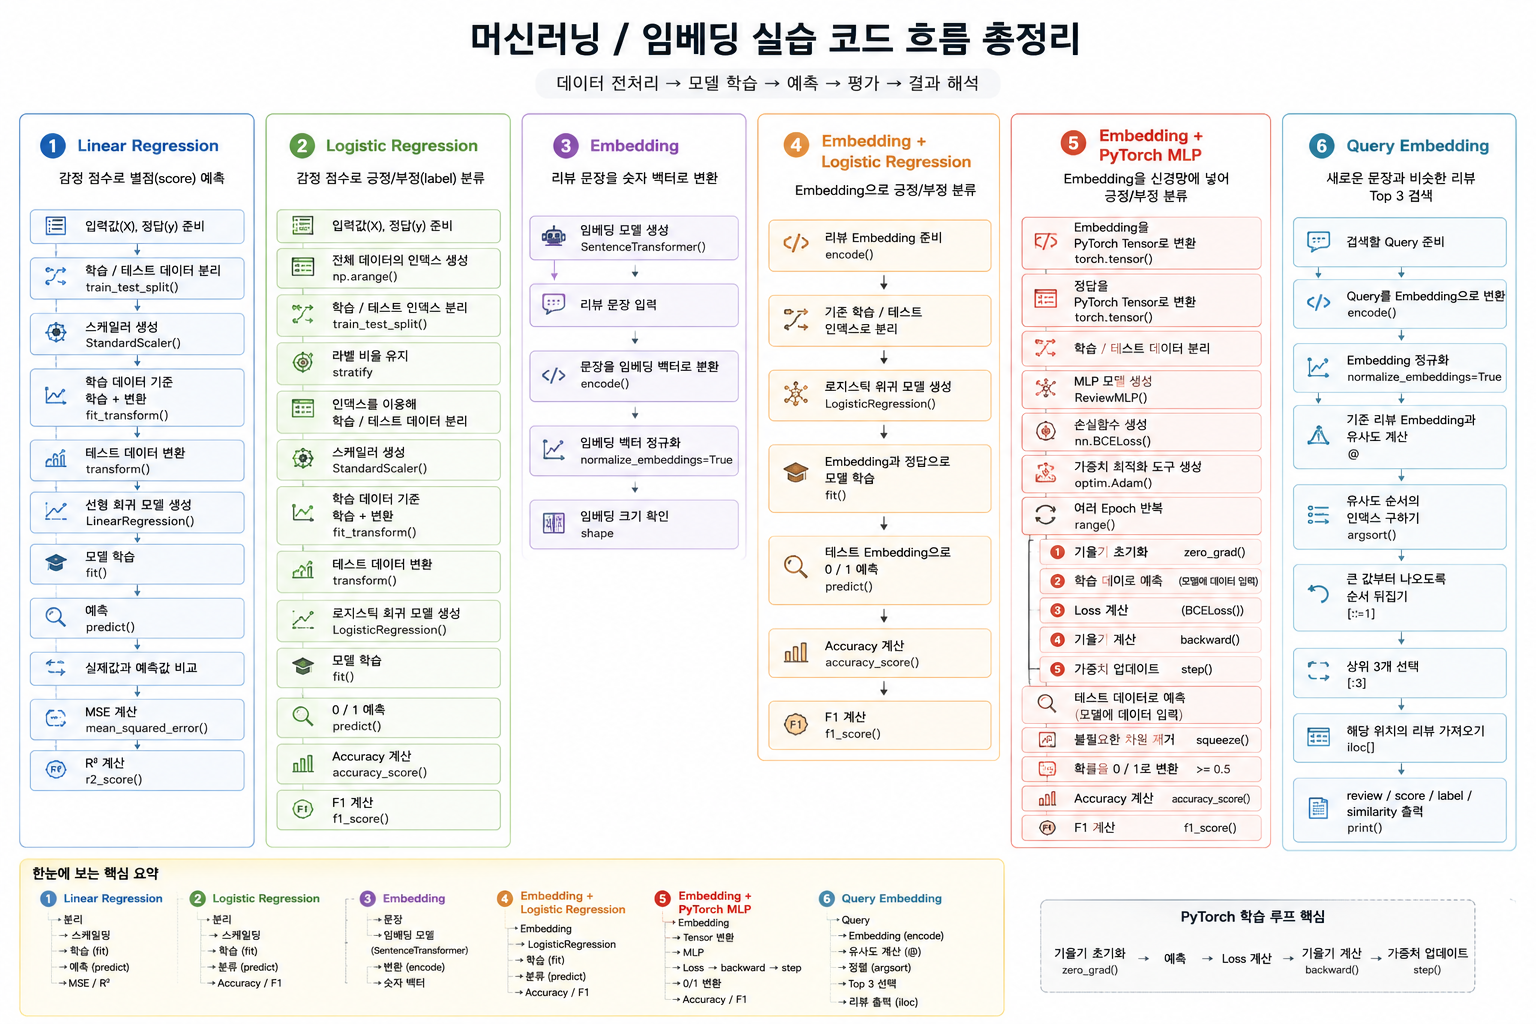
머신러닝 / 임베딩 실습 흐름 요약 (내가 보려고 만듬)
감정 점수를 이용해 별점(score)을 예측감정 점수를 이용해 긍정 / 부정(label)을 분류리뷰 문장을 의미를 나타내는 숫자 벡터로 변환감정 점수 대신 리뷰의 Embedding을 이용해 긍정 / 부정 분류Embedding을 신경망에 넣어 긍정 / 부정 분류새로운 문
파운데이션 모델과 거대 언어 모델(LLM)
파운데이션 모델은 \*\*\*\*대량의 데이터를 기반으로 사전학습된 대규모 AI 모델로, 다양한 작업에 범용적으로 활용할 수 있는 기초 역할을 한다.새로운 태스크를 해결할 때 자세한 설명(프롬프트)을 입력하는 것만으로도 별도의 학습 없이 다양한 작업을 수행할 수 있다.
사전 학습 기반 언어 모델
사전학습은 대규모 데이터 셋을 이용해, 모델이 데이터의 일반적인 특징과 표현을 학습하도록 하는 과정이다.양방향 문맥을 모두 활용하기 때문에, 전통적인 언어모델과는 차이점이 있다.입력 토큰의 15%를 무작위로 선택한다.MASK 토큰 치환 (80%), 랜덤 토큰 치환 (1
트랜스포머(Transformer)란??
RNN은 이전 시점의 hidden state를 다음 시점으로 전달하면서 단어를 순서대로 처리한다.하지만 Attention을 사용하면 멀리 떨어진 단어의 정보도 직접 참고할 수 있다.그렇다면 RNN처럼 정보를 순서대로 전달하지 않고,Attention만으로 단어 간 관계를
자연어 생성 모델
1. 언어 모델이란? > 언어 모델은 인간의 두뇌가 자연어를 생성하는 능력을 모방한 모델이다. > 앞의 문맥을 바탕으로 다음 단어(토큰)를 예측한다. 이러한 예측을 반복하여 자연스러운 문장을 생성한다. 예시 위와 같이 가장 가능성이 높은 단어를 골라서 문장을 이어갈 수 있다. N-gram 언어모델은? > N-gram은 문장에서 연속된 N개의 단어(...
워드 임베딩과 순환신경망 기반 모델(RNN & LSTM)
문자로 된 범주형 데이터를 머신러닝이 이해할 수 있도록 0과 1로 바꾸는 방법이다.예시) 웹 검색갤럭시 핸드폰 == 갤럭시 스마트폰차원의 저주차원이 커지면 커질수록 데이터가 점점 더 희소해져 활용이 어렵다.고차원의 희소 벡터를 다루기 위해서는 많은 메모리가 필요하
AI & 기계학습 기초④
정의: 레이블 (정답) 없이 데이터의 구조/패턴/집단을 찾아내는 학습이다.대표 과제: 군집화, 차원축소, 밀도추정/이상치 탐지 등등출력: 정답 예측이 아니라 구조/요약/표현이다.지도 학습: 입력 + 라벨 (정답)로 예측 모델을 학습한다.가격 예측, 악성 종양 예측 등비
AI & 기계학습 기초③
훈련 오류: 모델을 학습시킨 같은 데이터에 다시 적용해 계산한 오류이다.테스트 오류: 학습에 쓰지 않은 새 관측치에 대해 모델을 적용했을 때의 평균 예측오류이다.파란색 선 : 훈련 오류빨간색 선 : 테스트 오류모델의 복잡도가 증가할수록 훈련 오류는 일반적으로 계속 감소